AI 가시성 트래커는 단순해 보입니다. 어시스턴트에게 카테고리 질문을 던지고, 자사 브랜드가 나타나는지 기록하고, 시계열로 그래프를 그립니다. 그게 전부입니다.
문제는 기록보다 더 상류에 있습니다. 측정하려는 대상이 가만히 있지 않습니다. 같은 프롬프트를 같은 모델에 두 번 보내면 부분적으로만 겹치는 두 개의 답이 돌아옵니다. 그중 하나를 기록하면, 분포에서 뽑은 표본 하나를 사실로 제시한 셈이 됩니다.
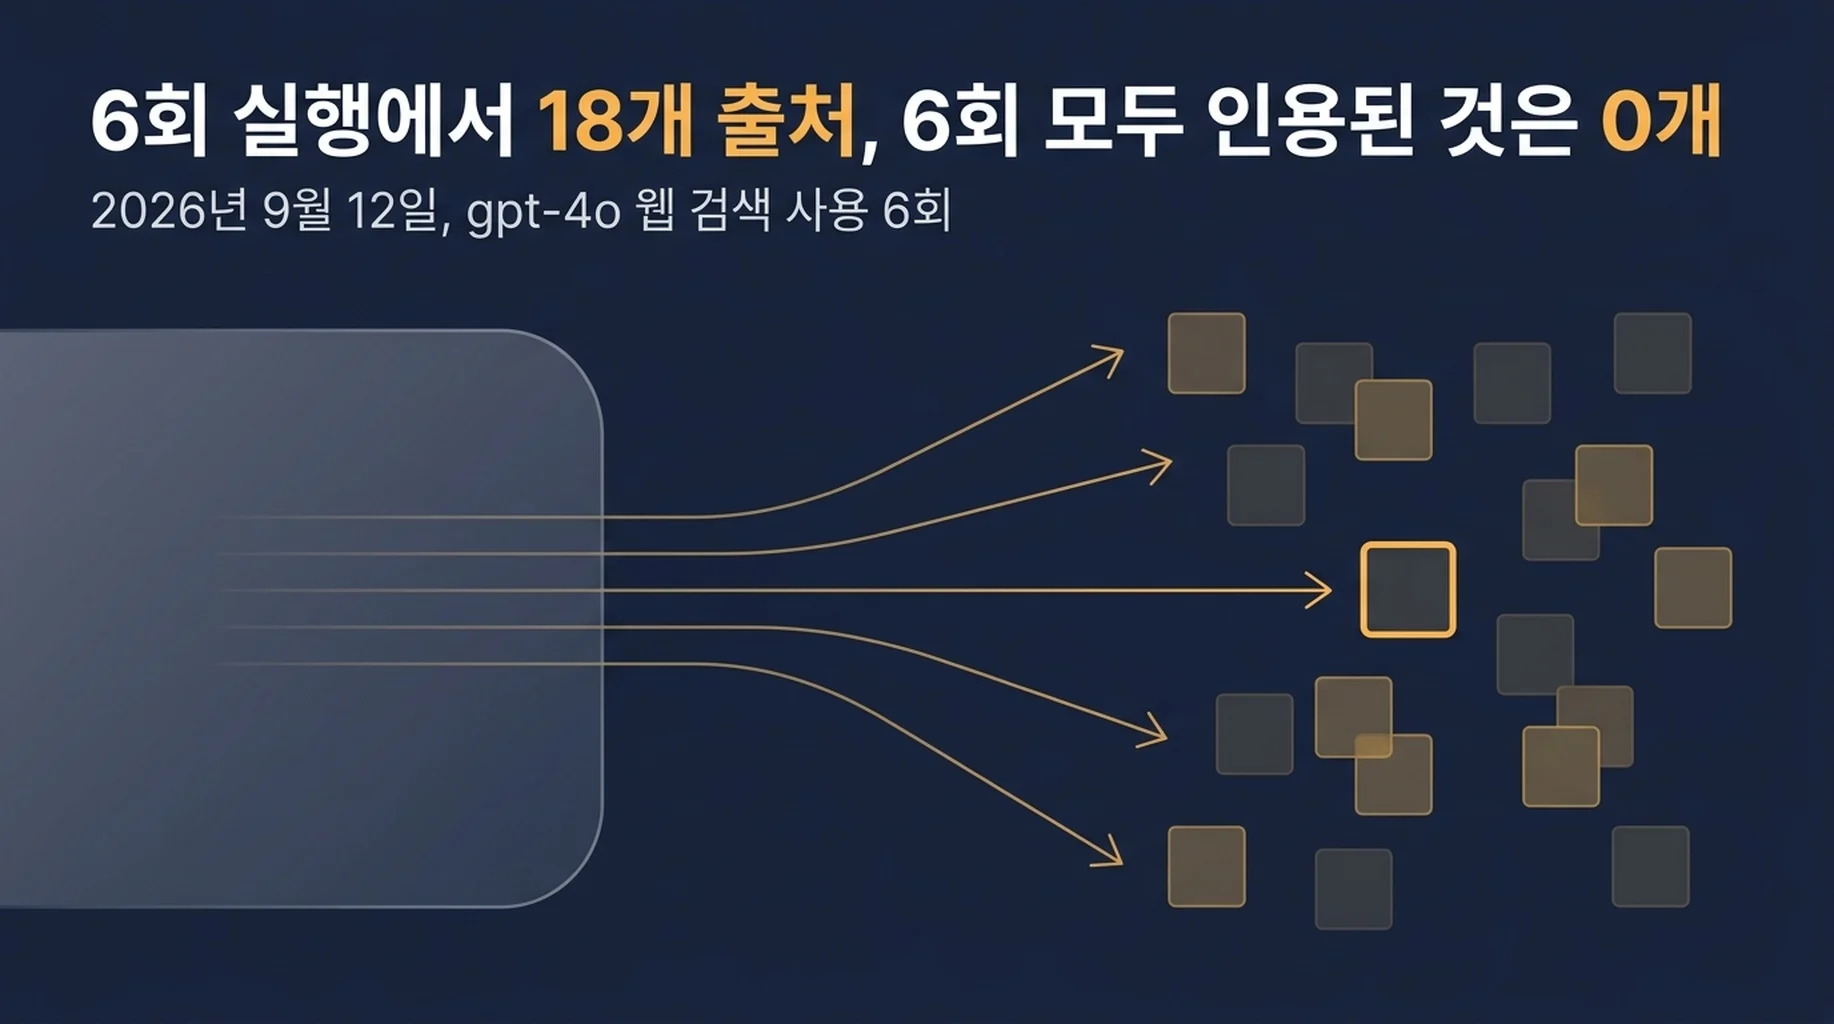
산포가 실제로 얼마나 큰지 알고 싶었기에 가정하지 않고 실험했습니다. 요약하면, 동일한 요청 6회에서 18개의 인용 출처가 나왔고, 6회 모두에서 인용된 출처는 하나도 없었습니다.
이 글은 무엇을 돌렸고 무엇이 돌아왔는지, 그리고 다음 달에도 볼 만한 숫자로 만들기 위해 AI 가시성 트래커가 저장해야 하는 네 개의 필드를 다룹니다.
무엇을 돌렸는가
실험은 두 개입니다. 둘 다 SaaS 팀이 카테고리 조사에 실제로 쓸 법한 프롬프트입니다.
실험 1: 프롬프트 하나, 모델 하나, 6회. 모델은 gpt-4o, 웹 검색 활성화, 미국, 영어. 프롬프트는 "2026년에 작은 SaaS 팀을 위한 최고의 순위 추적 도구는 무엇인가요? 출처와 함께 짧은 목록으로 알려주세요."입니다. 같은 세션 창 안에서 연달아 실행한 6회의 개별 라이브 호출입니다.
실험 2: 모델 둘, 같은 프롬프트, 각 3회. 동일한 프롬프트를 Claude Sonnet 5와 Gemini 3.8 Flash에 각 3회, 웹 검색 없이 보냈습니다. 검색 없이 측정하는 것은 모델이 자기 지식에서 이름을 대는 제품이며, 이는 어떤 출처를 인용하는지와는 별개의 신호입니다.
또한 질문 유형이 달라져도 인용 행동이 일관되는지 보려고 두 번째 프롬프트를 웹 검색 경로로 4회 보냈습니다. "내 웹사이트의 AI Overview를 어떻게 추적하나요? 출처와 함께 구체적인 방법을 알려주세요."
6회는 큰 표본이 아니며 그렇게 취급합니다. 방향과 분산의 대략적인 크기를 보여주기에는 충분하고, 그게 요점입니다.
결과 1: 출처 18개, 6회 모두가 공유한 것은 0개
웹 검색 6회는 합쳐서 18개의 서로 다른 URL을 인용했습니다. 다음은 도메인별 등장 횟수입니다.
인용 횟수(6회 중) | 도메인 |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
6회 모두에서 인용된 도메인은 하나도 없습니다. 6회 모두에서 인용된 URL도 하나도 없습니다.
여기서 중요한 숫자는 회차 간 겹침입니다. 모든 회차 쌍을 비교했을 때, 인용 URL의 평균 자카드 겹침은 0.167이었습니다. 15개 쌍 중 2개는 겹침이 정확히 0이었습니다. 즉 그 두 답은 출처를 전혀 공유하지 않았습니다.
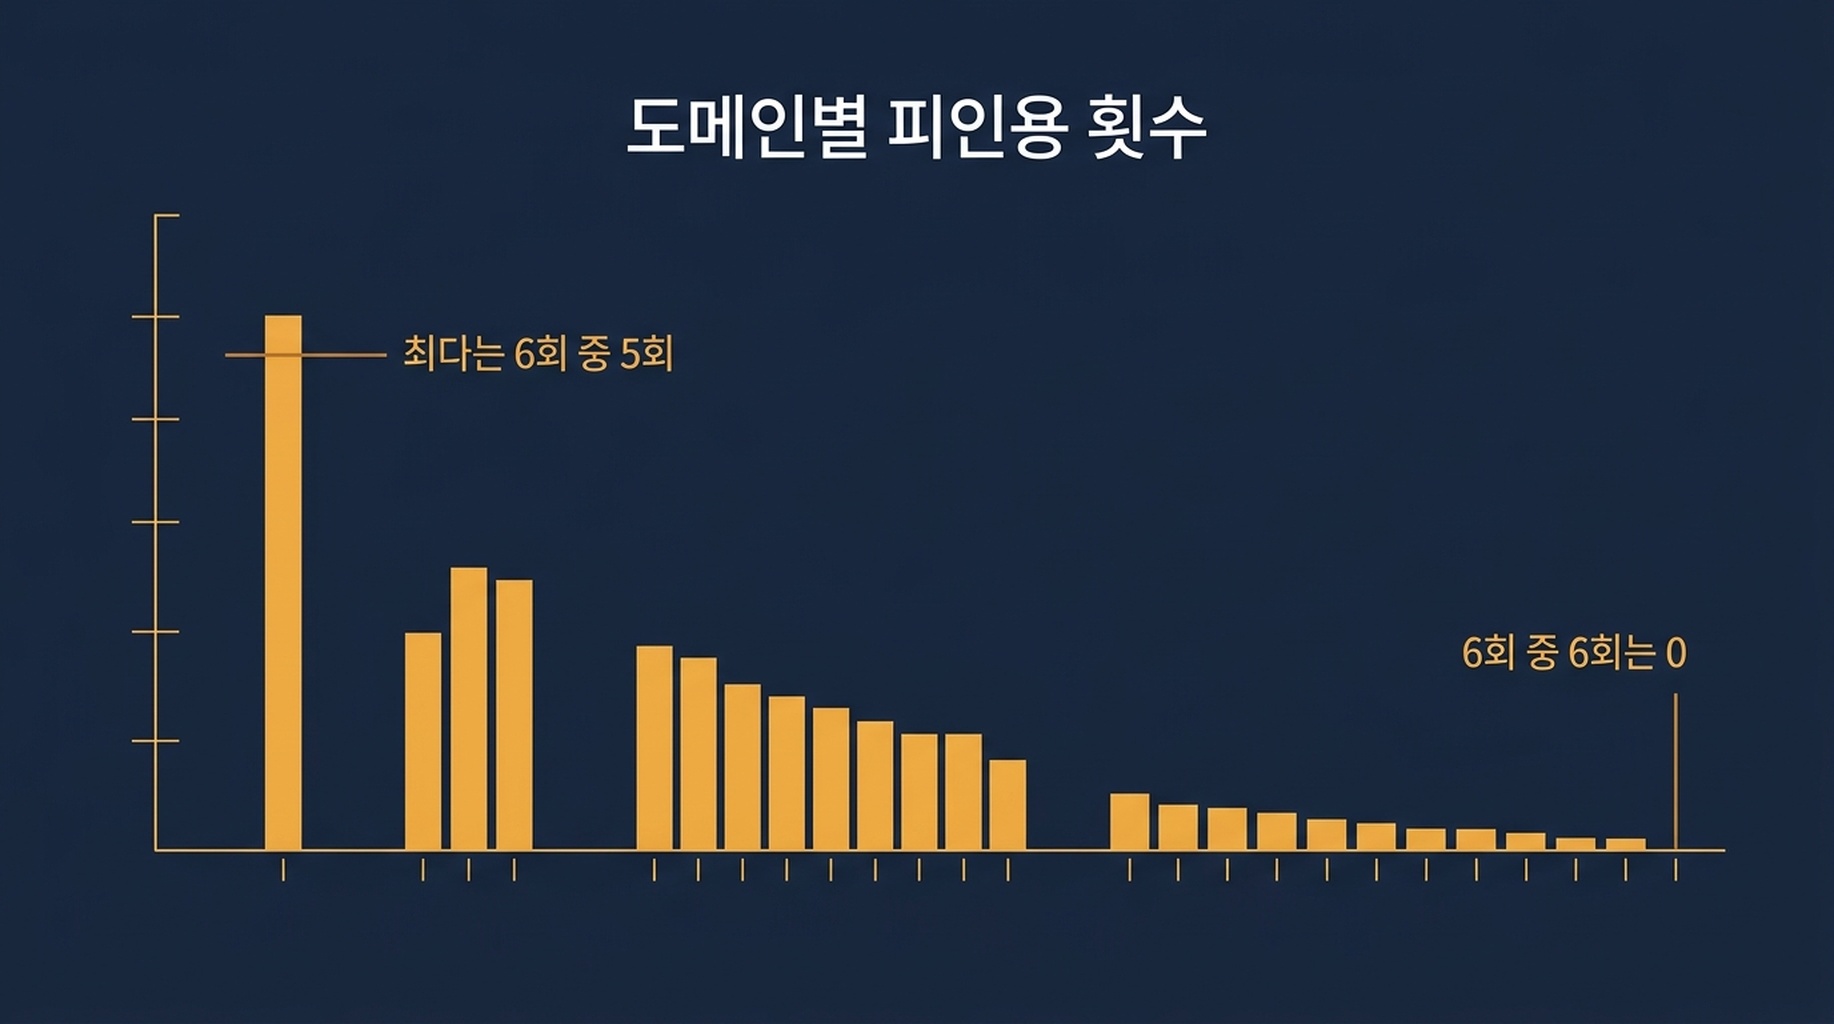
6회 중 5회 인용된 출처가 우리가 관측한 상한입니다. 매번 인용된 것은 없었습니다.
이 표에는 또 하나의 발견이 묻혀 있습니다. 모델이 손을 뻗은 도메인은 이 카테고리에서 잘 알려진 비교 사이트가 아닙니다. 18개 도메인 중 9개는 정확히 한 번만 등장했고, 그중 몇몇은 보도된 내용이라기보다 쿼리에 맞춰 조립된 듯 읽히는 콘텐츠를 가진 소규모 사이트입니다. 브랜드 입장에서는 양날의 검입니다. 전통적인 "최고의 도구" 순위보다 인용 자리를 차지하기 쉽다는 뜻에서는 유리합니다. 동시에 그 자리는 그 회차의 쿼리 형태에 맞는 페이지를 만든 누군가가 채우고 있으며, 다음 회차에는 다시 채워질 것이라는 뜻이기도 합니다.
결과 2: 답 자체의 크기가 변한다
인용이 움직였고, 답의 길이도 움직였습니다.
실행 | 출력 토큰 | 답변 길이 | 실행 비용 |
|---|---|---|---|
1 | 505 | 2,153자 | $0.0735 |
2 | 860 | 3,728자 | $0.0770 |
3 | 1,108 | 4,746자 | $0.0797 |
4 | 832 | 3,555자 | $0.0765 |
5 | 870 | 3,547자 | $0.0772 |
6 | 813 | 3,544자 | $0.0768 |
출력 길이는 505에서 1,108 토큰까지, 폭이 603 토큰으로 평균의 약 73퍼센트에 달했습니다. 가장 긴 답은 가장 짧은 답의 두 배가 넘습니다. 6회 중 5회는 813~1,108 토큰의 비교적 좁은 띠에 들어갔고, 한 회는 505에서 일찍 멈춰 9~14개가 아니라 5개의 출처를 인용했습니다.
측정에는 이것이 특정한 방식으로 영향을 줍니다. 트래커가 "답에 브랜드가 나타나는지, 나타난다면 몇 번째인지"를 기록한다면, 짧은 회차에는 나타날 자리가 더 적습니다. 주 1회 표본을 뽑다가 우연히 짧은 회차를 뽑은 팀은, 긴 회차를 뽑은 팀보다 더 나쁜 결과를 기록합니다. 웹사이트에는 아무 변화가 없는데도 말입니다.
결과 3: 인용이 전혀 붙지 않는 프롬프트도 있다
AI Overview 추적에 관한 두 번째 프롬프트는 같은 웹 검색 경로를 4회 통과해 매번 인용 0건을 반환했습니다.
실행 | 출력 토큰 | 답변 길이 | 인용 수 |
|---|---|---|---|
1 | 479 | 2,135자 | 0 |
2 | 522 | 2,240자 | 0 |
3 | 534 | 2,312자 | 0 |
4 | 497 | 2,228자 | 0 |
답변 길이는 안정적이어서 4회에 걸쳐 8퍼센트밖에 변하지 않았습니다. 하지만 모델은 자기 지식에서 답했고 출처를 하나도 대지 않았기에, 인용 열에 기록할 것이 없었습니다.
여기서 특정하고도 오해를 부르는 트래커 판독이 나옵니다. 인용률 대시보드는 이 질문에 0을 표시하고, 그것은 가시성 실패처럼 보입니다. 아닙니다. 출처 조회를 촉발하지 않는 질문 형태일 뿐입니다. 올바른 판독은 "인용 해당 없음"이며, 이를 "인용을 확인했지만 부재했다"와 구분하지 못하는 트래커는 존재하지 않는 문제를 쫓게 만듭니다.
결과 4: 모델을 바꾸는 것은 반복이 아니라 다른 측정
웹 검색을 끈 상태에서 각 모델이 어떤 제품을 대는지 측정했습니다. 이렇게 하면 그 시각 검색 인덱스가 돌려준 것과 모델 자체의 추천 집합을 분리할 수 있습니다.
Claude Sonnet 5는 회차당 4~5개 제품을 댔습니다. 3회에 걸쳐 6개의 서로 다른 제품을 댔습니다. AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat, SerpWatcher입니다. 이 중 3개, AccuRanker, Ahrefs, SEMrush는 3회 모두에 나타났습니다. 평균 쌍별 겹침은 0.587입니다.
Gemini 3.8 Flash는 회차당 2~5개 제품을 댔습니다. 3회에 걸쳐 7개의 서로 다른 제품을 댔습니다. AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush, Wincher입니다. 이 중 SE Ranking만이 3회 모두에 나타났습니다. 평균 쌍별 겹침은 0.306입니다.
두 모델 사이에서는 4개 제품이 양쪽에 모두 언급되었고, 5개 제품은 한쪽에만 언급되었습니다.
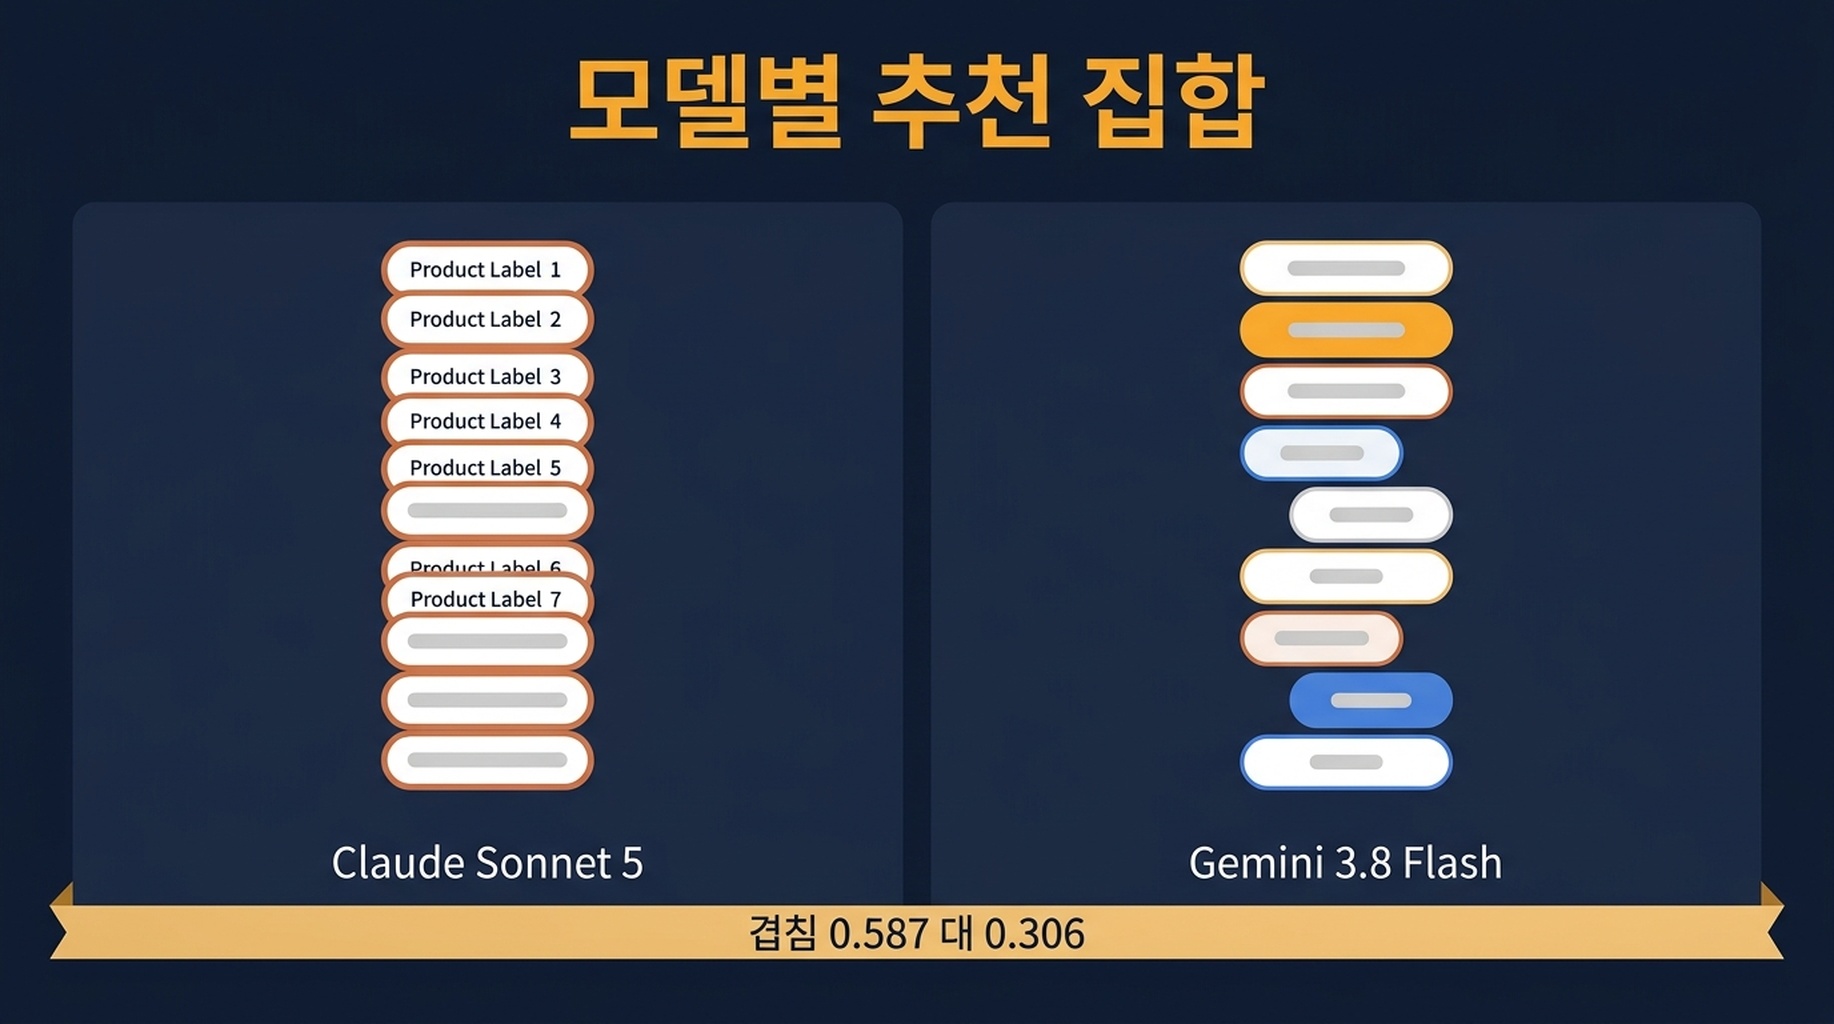
같은 질문이 모델마다, 회차마다 부분적으로 다른 추천 집합을 만들어냅니다.
실무적 결론은 이렇습니다. "AI 가시성"을 하나의 숫자로 추적한다면, 최소한 두 개의 독립적인 변동 원인, 즉 회차와 모델을 평균하고 있는 것입니다. 한 어시스턴트에는 안정적으로 나타나고 다른 어시스턴트에는 나타나지 않는 브랜드는 실제의, 행동으로 이어지는 발견입니다. 단일 표본 측정이 두 칸 움직인 브랜드는 잡음입니다.
AI 가시성 트래커가 기록해야 할 것
네 개의 필드가 스크린샷을 측정으로 바꿉니다.
실행 결과가 아니라 실행 횟수. 모든 실행을 저장하고 범위를 보고하세요. "6회 중 4회 인용"은 사실입니다. "인용됨, 3위"는 우연입니다. 작은 프로그램이라면 6회가 합리적인 하한이고, 그 프롬프트가 상업적으로 중요하다면 12회가 더 낫습니다.
언급 필드와 별도로 인용 필드를. "모델이 우리를 추천했다"와 "모델이 우리에게 링크했다"는 대응 방법이 다른 별개의 결과입니다. 우리의 6회는 18개의 서로 다른 URL에서 18건의 인용을 만들었습니다. 브랜드 언급만 기록하는 트래커는 그 변동을 하나도 담지 못했을 것입니다.
답변 채널 상태. 그 실행이 웹 검색을 썼는지 여부와 답변 길이를 기록하세요. 인용 0인 회차와 언급 0인 회차는 대시보드에서 똑같이 보이지만 정반대를 뜻합니다.
프롬프트 원문을 버전과 함께 그대로. 프롬프트 문구가 어떤 출처가 끌려오는지를 좌우합니다. 월이 바뀌며 프롬프트가 바뀌면 추세선은 끊깁니다. 추적 스크립트를 버전 관리하듯 프롬프트를 버전 관리하세요.
실행 루프 만들기
수동 확인은 달력과 맞닥뜨리는 순간 무너집니다. 루프란 프롬프트를 N회 실행하고, 각 원본 응답을 그 인용과 함께 저장하고, 현재 구간과 직전 구간을 비교하는 스크립트입니다.
이 작업은 에이전트에 잘 맞습니다. 반복적이고, 규칙에 묶여 있고, 기록을 남겨야 하기 때문입니다. Claude Code나 Codex에서는 "원본 실행을 디스크에 남기고 절대 덮어쓰지 말며, 단일 수치가 아니라 요약 표를 보고하라"는 지시가 유용합니다. 이미 MCP 서버를 통해 Search Console과 Bing 데이터를 가져오고 있다면, 같은 세션에서 인용 로그를 노출 데이터 옆에 둘 수 있습니다. 두 숫자가 함께 쓸모를 갖기 시작하는 지점이 바로 거기입니다. 이 서버들이 무엇을 노출하는지는 네 개의 SEO MCP 서버가 실제로 하는 일에, 같은 문제의 존재 쪽은 40개 쿼리 AI Overview 스냅샷에 정리해 두었습니다.
설계 규칙 하나가 나머지보다 중요합니다. 트래커의 출력은 분포여야 합니다. "인용됨"이 아니라 "6회 중 4회 인용"을 보고하세요. 최상위 출처가 아니라 출처 목록을 보고하세요. 6회를 하나의 숫자로 압축하는 대시보드는 추가 실행이 사온 유일한 정보를 버린 것입니다.
모니터링이 아니라 경쟁사 비교가 목적이라면, 시계열 순위 추적 루프가 더 맞는 도구이고, 데이터 소스 간 트레이드오프는 두 소스로 순위 트래커 만들기에 있습니다.
6회 표본의 한계
정직한 단서 세 가지.
표본이 작습니다. 6회는 산포를 느슨하게만 규정합니다. 회차 간 겹침이 부분적이고 겹침 0인 쌍이 발생한다는 것은 보여주지만, 당신 카테고리의 신뢰구간을 주지는 않습니다.
결과는 시점에 묶여 있습니다. 이 실행들은 2026년 9월 12일에 라이브 모델을 상대로 이루어졌습니다. 모델도, 그 밑에 깔린 검색 결과도 변합니다.
인용된 도메인은 하나의 상업적 프롬프트 표본입니다. 비교 질문이나 방법 질문 같은 다른 질문 형태는 다른 인용 패턴을 만듭니다. 유용한 움직임은 같은 설계를 당신에게 상업적으로 가장 중요한 10개 프롬프트에 돌려서 당신 카테고리가 어떻게 행동하는지 기록하는 것입니다.
자주 묻는 질문
AI 가시성 숫자가 의미를 가지려면 몇 회를 돌려야 하나요? 단일 프롬프트라면 6회가 실용적 하한이고, 숫자는 순위가 아니라 실행 횟수 대비 건수로 보고해야 합니다. 그 프롬프트가 매출 결정을 좌우한다면 12회가 몇 달러로 더 촘촘한 판독을 줍니다.
그러면 AI 가시성 추적은 할 가치가 없다는 건가요? 단일 표본 추적이 그렇다는 뜻입니다. 분산이 바로 발견입니다. "6회 중 4회 인용, 출처는 지난달 이후 12개 도메인 변경"을 보고하는 트래커는 경쟁사가 겨루고 있는 실제 시스템을 기술하고 있습니다.
왜 한 프롬프트는 인용 0을 반환했나요? 모델이 출처 조회를 하지 않고 자기 지식에서 답했기 때문입니다. 그것은 질문의 속성이지 당신 사이트의 실패가 아닙니다. 0이 아니라 해당 없음으로 추적하세요.
ChatGPT, Claude, Gemini를 따로 추적해야 하나요? 네. 우리의 3회 비교에서 두 모델은 9개 제품 중 4개만 겹쳤습니다. 평균을 내면 어떤 어시스턴트를 먼저 최적화할지에 대한 프로그램 차원의 결정이 가려집니다.
모델 온도를 낮추면 분산을 줄일 수 있나요? 부분적으로, 그리고 자기 프롬프트로 시험해 볼 가치가 있습니다. 다만 인용 집합은 검색 인덱스에도 좌우되며 그것은 당신이 통제하지 못합니다. 더 믿을 만한 지렛대는 실행 횟수입니다.
Auspia 견해: 이번 분기에 AI 가시성 추적을 만든다면 대시보드보다 실행 로그를 먼저 만드세요. 대시보드는 렌더링 선택입니다. 실행 로그가 측정입니다. 프롬프트 10개를 각 6회, 원문 그대로 저장하는 것에서 시작하면, 단일 표본 확인을 1년 하는 것보다 일주일에 더 많은 것을 배웁니다.
저자: Ethan Marlowe, Auspia에서 500개 이상의 프롬프트에 걸친 GEO 측정을 담당. 프롬프트 추적, 인용 리포트, 그리고 실제 측정 주기를 견디는 가시성 대시보드에 대해 씁니다.