AI可視性トラッカーは単純に聞こえます。アシスタントにカテゴリの質問を投げ、自社ブランドが現れるかを記録し、時系列でグラフにする。それだけです。
問題は記録のさらに上流にあります。測ろうとしているものがじっとしていないのです。同じプロンプトを同じモデルに二度送れば、部分的にしか重ならない二つの回答が返ります。片方を記録すれば、それは分布から取った一つの標本を、事実として提示したことになります。
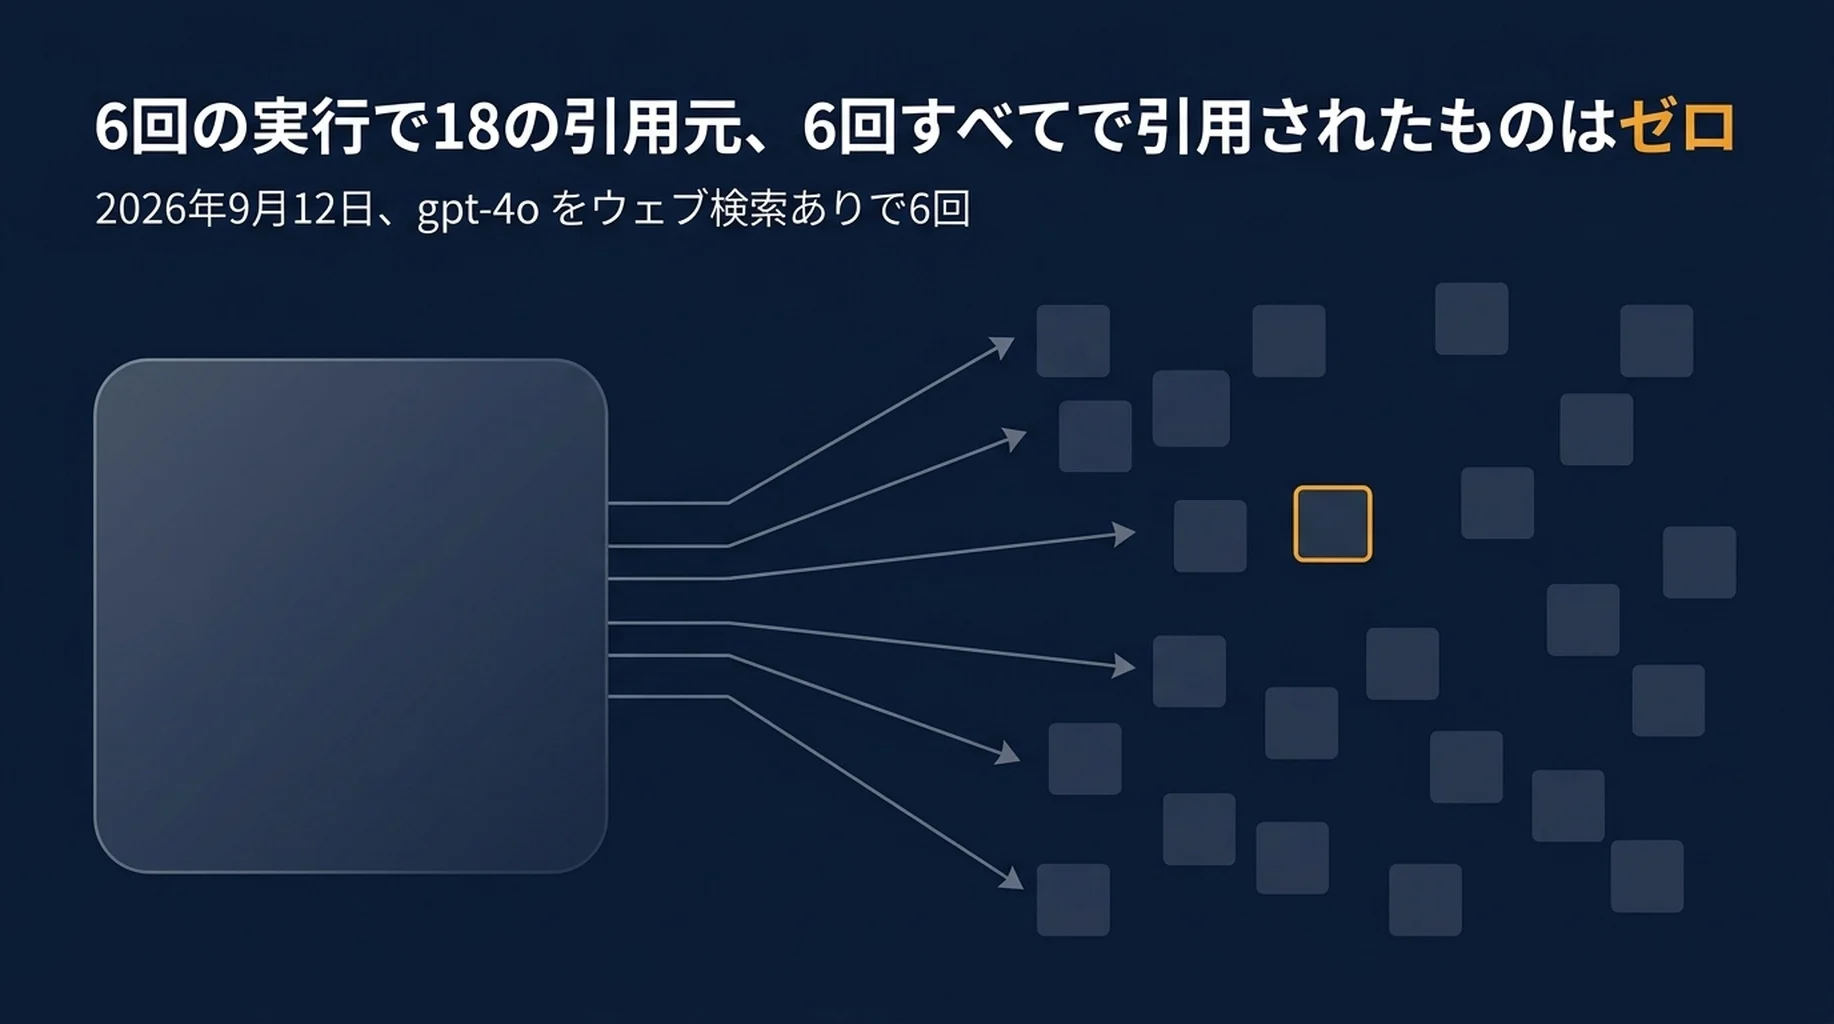
ばらつきが実際どれくらい大きいのかを知りたかったので、仮定せずに実験しました。結論を先に言うと、同一のリクエスト6回から18個の引用ソースが生まれ、6回すべてで引用されたソースは一つもありませんでした。
本記事では、何を走らせ、何が返ってきたか、そして来月も見る価値のある数字にするためにAI可視性トラッカーが保存すべき4つのフィールドを扱います。
何を走らせたか
実験は二つ。どちらもSaaSチームがカテゴリ調査で実際に使いそうなプロンプトです。
実験1:1プロンプト、1モデル、6回。 モデルは gpt-4o、ウェブ検索を有効化、米国、英語。プロンプトは「2026年に小規模SaaSチーム向けの最高のランク追跡ツールは何ですか。出典付きの短いリストで示してください」。同一セッション枠内で連続して実行した6回の独立したライブ呼び出しです。
実験2:2モデル、同一プロンプト、各3回。 同じプロンプトを Claude Sonnet 5 と Gemini 3.8 Flash に各3回、ウェブ検索なしで送りました。検索なしで測っているのは、モデルが自分の知識から名前を挙げる製品であり、これはどのソースを引用するかとは別のシグナルです。
さらに、質問タイプを変えても引用の挙動が一貫するかを見るため、二つ目のプロンプトをウェブ検索経路で4回送りました。「自分のウェブサイトのAI Overviewを追跡するにはどうすればよいですか。具体的な方法を出典付きで示してください」。
6回は大きな標本ではありませんし、そのように扱います。方向性とばらつきのおおよその大きさを示すには十分で、そこが要点です。
結果1:18のソース、6回すべてで共有されたものはゼロ
ウェブ検索の6回は合わせて18種類のURLを引用しました。以下はドメインごとの出現回数です。
引用回数(6回中) | ドメイン |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital、techradar.com |
2 | thesharpdigital.com、piperocket.digital、digiinte.com、tajo.io、gtm.help、softwaresift.com |
1 | impressivemagazine.com、theguidex.com、gtmonly.com、honeyb.ai、seo.com、blog.contentforce.ai、crowdreply.io、seomonster.ai、rankpy.com |
6回すべてで引用されたドメインは一つもありません。6回すべてで引用されたURLも一つもありません。
ここで重要なのは回をまたぐ重なりの数値です。すべての回の組を比較したところ、引用URLの平均Jaccard重複度は0.167でした。15組のうち2組は重複がちょうどゼロで、それら二つの回答はソースを一切共有していませんでした。
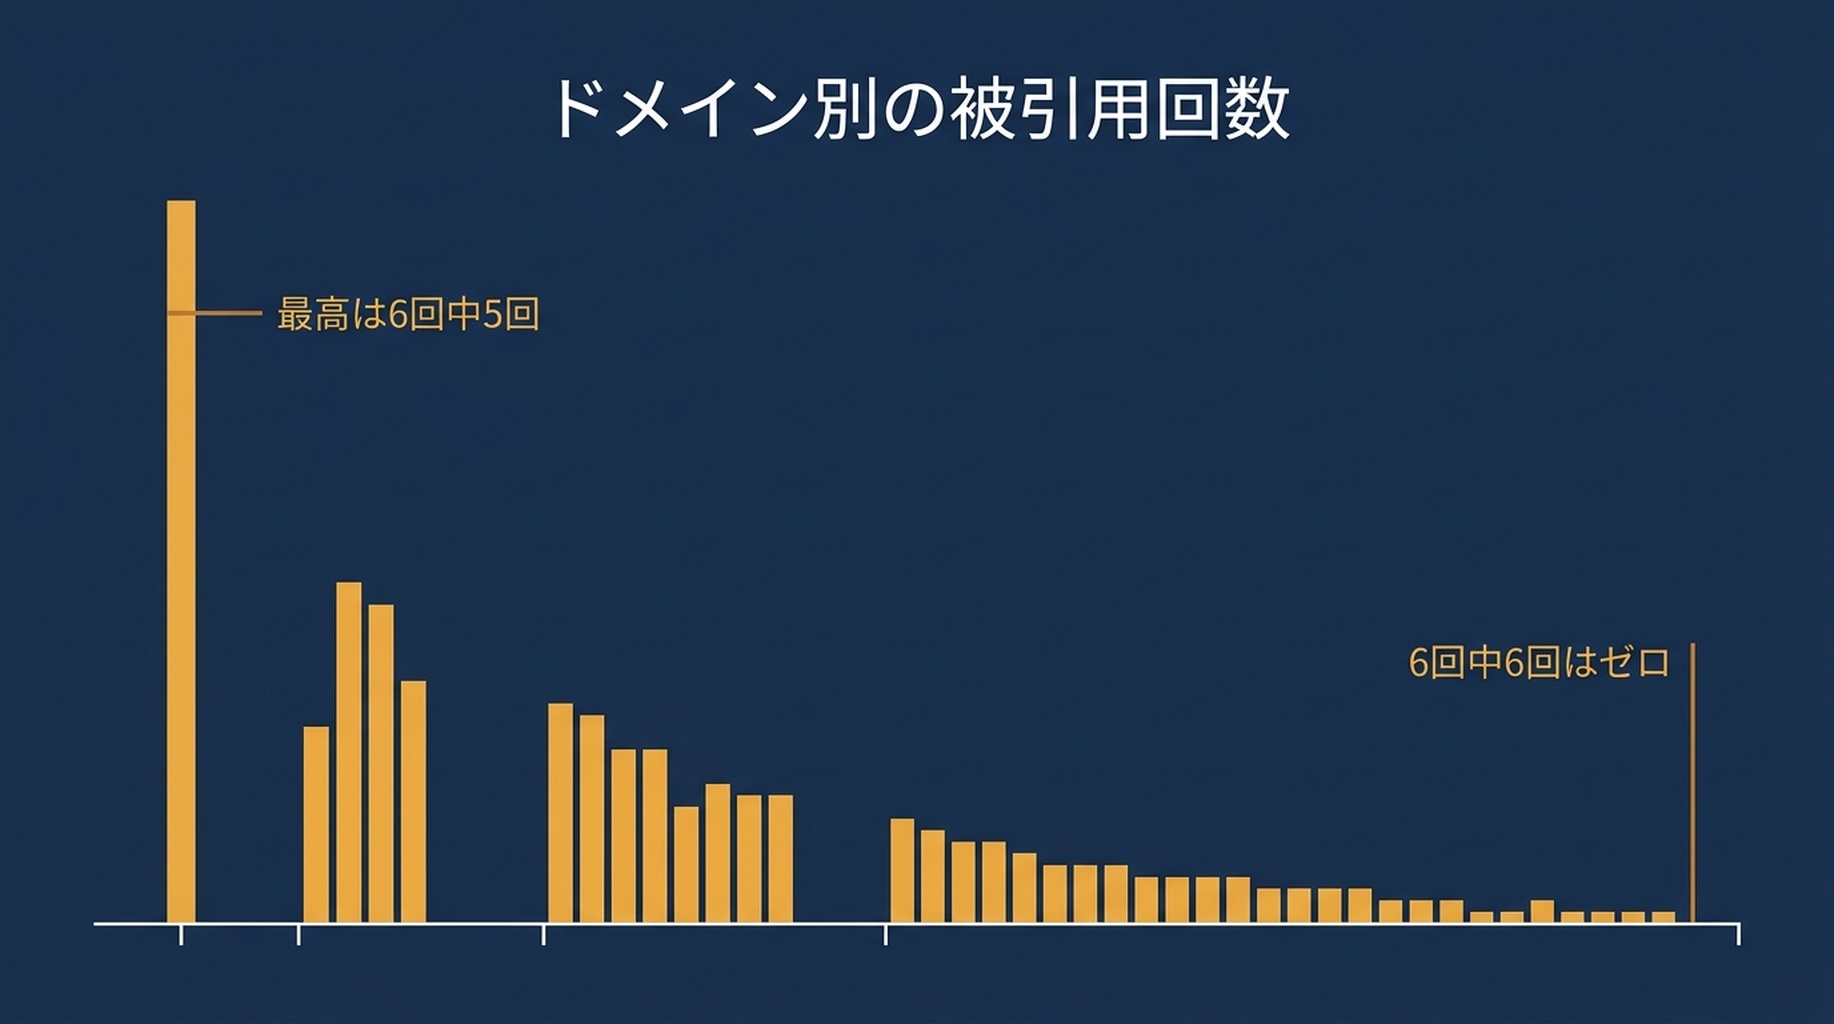
6回中5回で引用されたソースが、私たちが観測した上限です。毎回引用されたものはありませんでした。
この表にはもう一つの発見が埋まっています。モデルが手を伸ばしたドメインは、このカテゴリでよく知られた比較サイトではありません。18ドメインのうち9つはちょうど1回だけ出現し、そのいくつかは、報道された内容というよりクエリに合わせて組み立てられたように読めるコンテンツを持つ小規模サイトです。ブランドにとっては諸刃の剣です。従来の「ベストツール」ランキングより引用枠を取りやすいという意味では有利です。同時に、その枠はその回のクエリ形状に合ったページを作った誰かが埋めており、次の回には別の誰かが埋め直すということでもあります。
結果2:回答そのものの大きさが変わる
引用が動き、回答の長さも動きました。
実行 | 出力トークン | 回答の長さ | 実行コスト |
|---|---|---|---|
1 | 505 | 2,153文字 | $0.0735 |
2 | 860 | 3,728文字 | $0.0770 |
3 | 1,108 | 4,746文字 | $0.0797 |
4 | 832 | 3,555文字 | $0.0765 |
5 | 870 | 3,547文字 | $0.0772 |
6 | 813 | 3,544文字 | $0.0768 |
出力の長さは505から1,108トークンまで、幅は603トークン、平均のおよそ73パーセントに達しました。最長の回答は最短の二倍以上です。6回のうち5回は813から1,108トークンのかなり狭い帯に収まり、1回だけ505で早く止まり、9〜14個ではなく5個のソースを引用しました。
測定にとって、これは特定の形で効いてきます。トラッカーが「回答にブランドが現れるか、現れるなら何番目か」を記録するなら、短い回には現れる枠が少なくなります。週に一度サンプリングしてたまたま短い回を引いたチームは、長い回を引いたチームより悪い結果を記録します。ウェブサイトには何も変わっていないのに、です。
結果3:引用がまったく付かないプロンプトもある
AI Overviewの追跡に関する二つ目のプロンプトは、同じウェブ検索経路を4回通って、毎回ゼロ件の引用を返しました。
実行 | 出力トークン | 回答の長さ | 引用数 |
|---|---|---|---|
1 | 479 | 2,135文字 | 0 |
2 | 522 | 2,240文字 | 0 |
3 | 534 | 2,312文字 | 0 |
4 | 497 | 2,228文字 | 0 |
回答の長さは安定しており、4回を通じてわずか8パーセントしか変わりませんでした。しかしモデルは自分の知識から答えてソースを一つも挙げなかったため、引用の列に記録するものがありませんでした。
ここから特定の、そして誤解を招くトラッカーの読みが生まれます。引用率のダッシュボードはこの質問に対してゼロを表示し、それは可視性の失敗に見えます。そうではありません。ソース参照を起動しない質問形状なのです。正しい読みは「引用は該当なし」であり、「引用を確認したが不在だった」と区別できないトラッカーは、存在しない問題を追わせることになります。
結果4:モデルを替えるのは反復ではなく別の測定
ウェブ検索を切った状態で、各モデルがどの製品を挙げるかを測りました。これにより、その分に検索インデックスが返したものから、モデル自身の推薦集合を切り離せます。
Claude Sonnet 5 は1回あたり4〜5製品を挙げました。3回を通じて6つの異なる製品を挙げています。AccuRanker、Ahrefs、SEMrush、SE Ranking、Serpstat、SerpWatcher です。このうち3つ、AccuRanker、Ahrefs、SEMrush は3回すべてに現れました。平均ペアワイズ重複度は0.587です。
Gemini 3.8 Flash は1回あたり2〜5製品を挙げました。3回を通じて7つの異なる製品を挙げています。AccuRanker、Ahrefs、Looker Studio、Nightwatch、SE Ranking、SEMrush、Wincher です。このうち SE Ranking だけが3回すべてに現れました。平均ペアワイズ重複度は0.306です。
2モデル間では、4製品が両方に挙げられ、5製品がどちらか一方にのみ挙げられました。
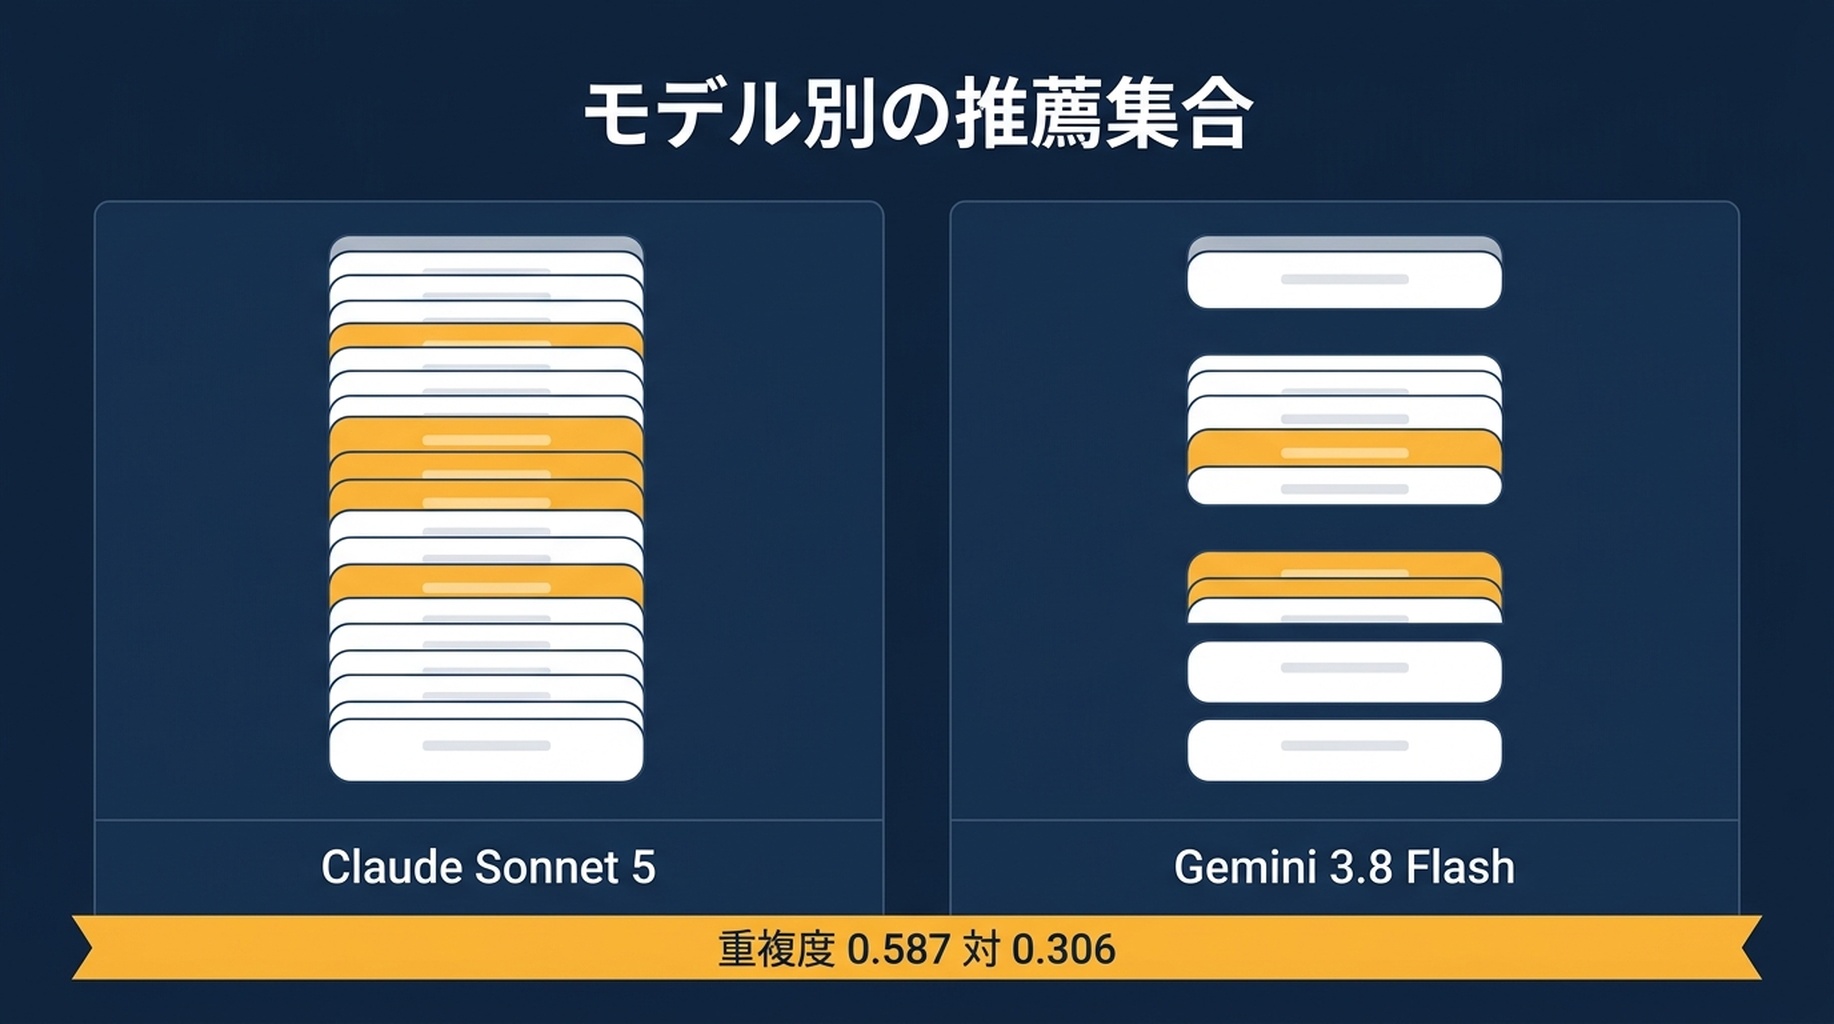
同じ質問でも、モデルごと、実行ごとに部分的に異なる推薦集合が生まれます。
実務上の帰結はこうです。「AI可視性」を一つの数字として追うなら、少なくとも二つの独立した変動源、つまり回とモデルを平均していることになります。あるアシスタントには安定して現れ、別のアシスタントには現れないブランドは、現実の、行動につながる発見です。単一標本の測定が二つ動いたブランドは、ノイズです。
AI可視性トラッカーが記録すべきもの
4つのフィールドが、スクリーンショットを測定に変えます。
実行の結果ではなく、実行回数。 すべての実行を保存し、幅を報告します。「6回中4回で引用」は事実です。「引用あり、3番目」は偶然です。小規模な取り組みなら6回が妥当な下限で、そのプロンプトが商業的に重要なら12回がより良いです。
言及フィールドとは別に、引用フィールドを。 「モデルが自社を推薦した」と「モデルが自社にリンクした」は、対処法の異なる別の結果です。私たちの6回は18種類の異なるURLから18件の引用を生みました。ブランドの言及だけを記録するトラッカーは、この変動を一件も捉えられなかったでしょう。
回答チャネルの状態。 その実行がウェブ検索を使ったかどうか、そして回答の長さを記録します。引用ゼロの回と言及ゼロの回はダッシュボード上では同じに見え、正反対の意味を持ちます。
プロンプト本文を、版番号とともに一字一句。 プロンプトの文言が、どのソースが引かれるかを左右します。月をまたいでプロンプトが変われば、トレンドラインは壊れます。追跡スクリプトを版管理するのと同じようにプロンプトを版管理してください。
実行ループを組む
手作業の確認はカレンダーに触れた瞬間に破綻します。ループとは、プロンプトをN回実行し、各生回答をその引用とともに保存し、現在のウィンドウと直前のウィンドウを差分比較するスクリプトです。
これはエージェントに向いています。作業が反復的で、規則に縛られ、書かれた記録を必要とするからです。Claude Code や Codex では、「生の実行をディスクに残し、決して上書きしない。単一の数値ではなく要約表を報告する」という指示が役立ちます。すでにMCPサーバー経由で Search Console と Bing のデータを取得しているなら、同じセッションで引用ログをインプレッション・データの隣に置けます。二つの数字が一緒に役立ち始めるのはそこです。これらのサーバーが何を公開するかは4つのSEO MCPサーバーが実際に何をするかに、同じ問題の出現側は40クエリのAI Overviewスナップショットにまとめています。
設計上のルールが一つ、他より重要です。トラッカーの出力は分布であるべきです。「引用あり」ではなく「6回中4回で引用」を報告する。トップソースではなくソース一覧を報告する。6回を一つの数値に圧縮するダッシュボードは、追加の実行がもたらした唯一の情報を捨てています。
監視ではなく競合比較が目的なら、時系列のランク追跡ループのほうが適した道具です。データソースのトレードオフは2つのソースからランクトラッカーを組むにあります。
6回サンプルの限界
正直な但し書きを三つ。
標本が小さい。6回ではばらつきの上限を緩く押さえられるだけです。実行間の重なりが部分的であること、重なりゼロの組が生じることは示せますが、あなたのカテゴリの信頼区間は与えません。
結果は時点に縛られます。これらの実行は2026年9月12日にライブのモデルに対して行われました。モデルも、その背後にある検索結果も変わります。
引用されたドメインは、一つの商用プロンプトの標本です。比較質問やハウツー質問など別の質問形状では、別の引用パターンが生まれます。有益なのは、同じ設計を自分にとって商業的に最も重要な10個のプロンプトで走らせ、自分のカテゴリがどう振る舞うかを記録することです。
よくある質問
AI可視性の数字が意味を持つには何回の実行が必要ですか。 単一プロンプトなら6回が実用的な下限で、数字は順位ではなく実行回数に対する件数として報告すべきです。そのプロンプトが収益判断を左右するなら、12回で数ドル払えばより締まった読みが得られます。
つまりAI可視性の追跡はやる価値がないのですか。 単一標本の追跡に価値がないという意味です。ばらつきこそが発見です。「6回中4回で引用、ソースは先月から12ドメイン変わった」と報告するトラッカーは、競合が競っている現実のシステムを記述しています。
なぜ一つのプロンプトは引用ゼロを返したのですか。 モデルがソース参照を行わず自分の知識から答えたからです。それは質問の性質であり、あなたのサイトの失敗ではありません。ゼロではなく該当なしとして追跡してください。
ChatGPT、Claude、Gemini は別々に追跡すべきですか。 はい。私たちの3回比較では、2モデルは9製品のうち4つしか重なりませんでした。平均すると、どのアシスタントを先に最適化するかというプログラム上の判断が隠れてしまいます。
モデルの温度を下げればばらつきを減らせますか。 部分的には、そして自分のプロンプトで試す価値があります。ただし引用集合は検索インデックスにも左右され、それはあなたが制御できません。より信頼できるレバーは実行回数です。
Auspiaの見解:今四半期にAI可視性トラッキングを作るなら、ダッシュボードより先に実行ログを作ってください。ダッシュボードは描画の選択です。実行ログが測定です。10個のプロンプトを各6回、一字一句そのまま保存するところから始めれば、単一標本の確認を一年続けるより一週間で多くを学べます。
著者:Ethan Marlowe、Auspia で500以上のプロンプトにわたるGEO測定を担当。プロンプト追跡、引用レポート、そして実際の測定サイクルに耐える可視性ダッシュボードについて書いています。