この記事を読み終えると手に入るもの
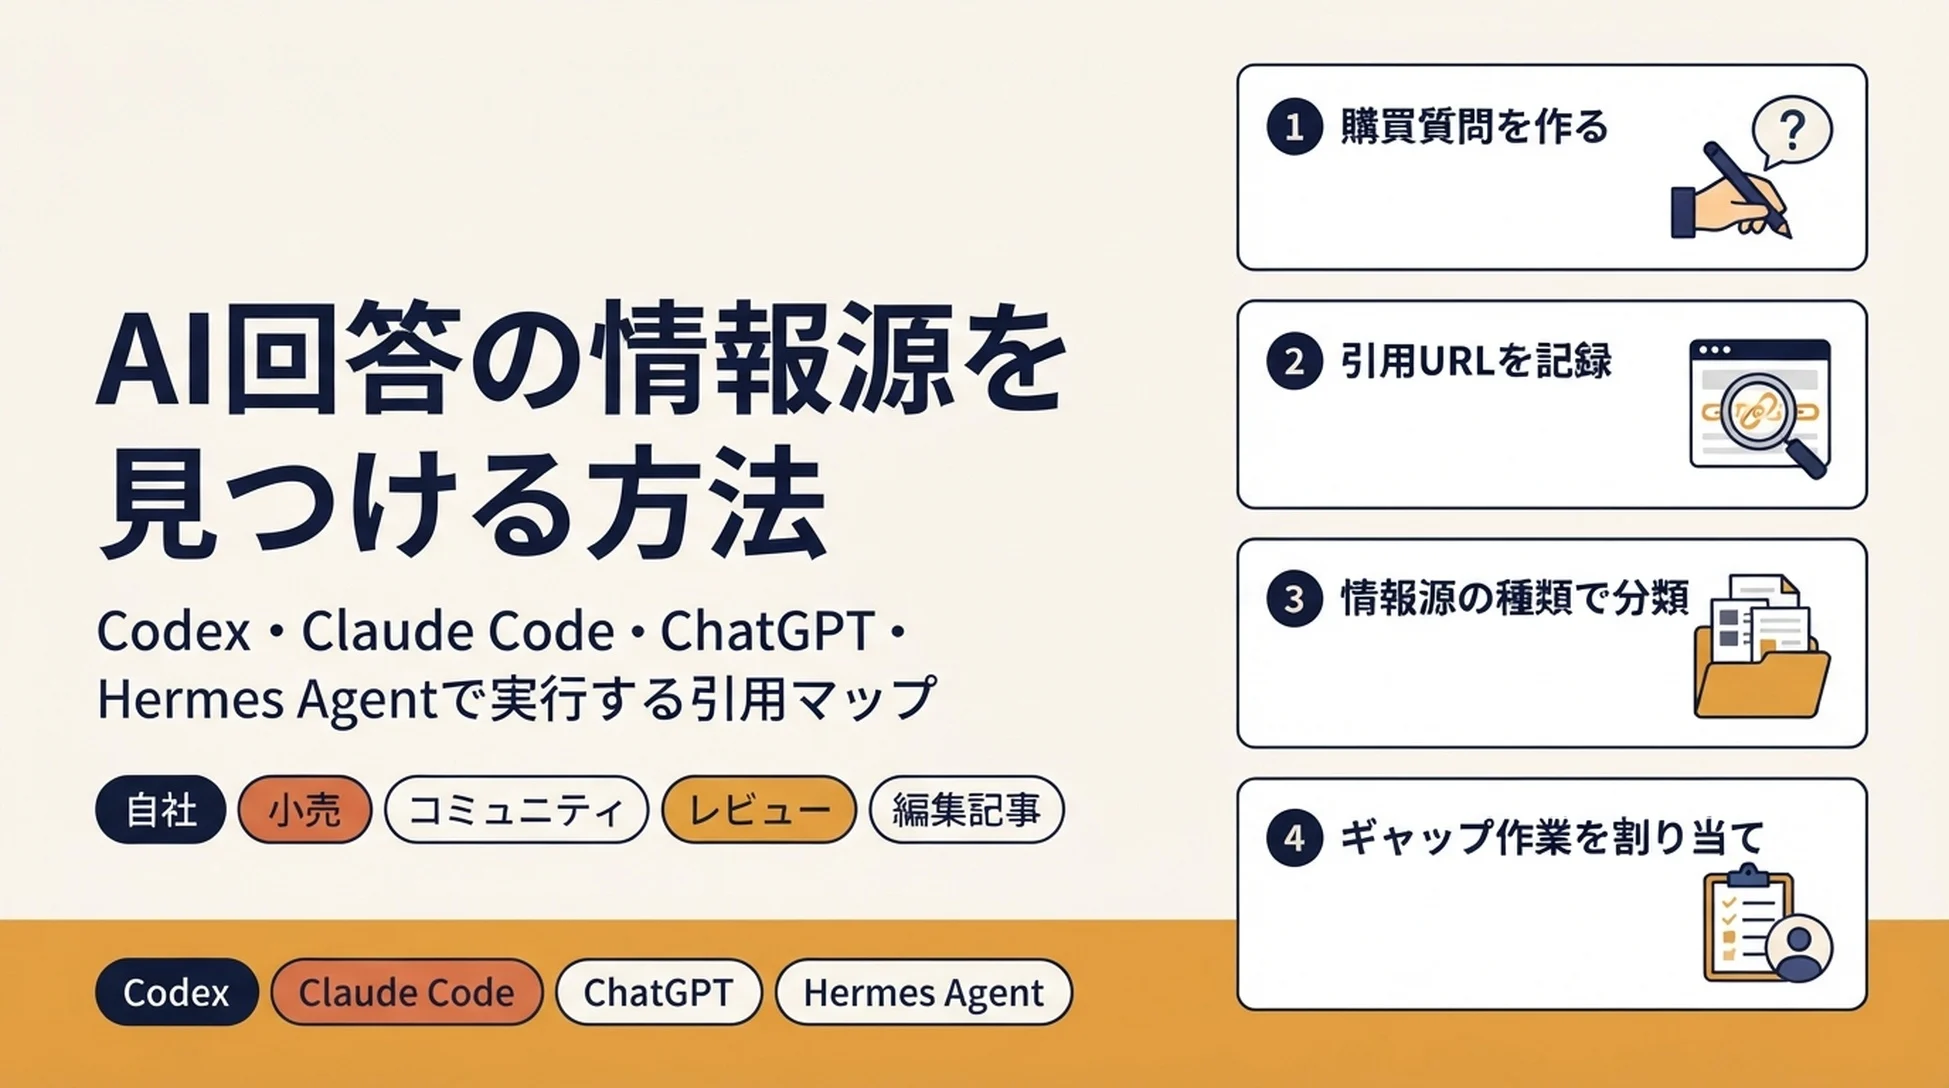
引用マップとは、AI エンジンがあなたの見込み客の質問に答えるときに、実際にどのページを引いてきたかの記録です。あなたのブランドが回答に出たかどうかではありません。その回答がどの情報源から組み立てられたかです。
私はこれを十分な数のカテゴリで走らせてきたので、最初の結果がたいてい気まずいものになることは分かっています。チームは自社サイトが回答を支えていると思い込んでいます。実際にはそうでないことのほうが多い。ある B2B カテゴリでは、ベンダー自身のページはごくわずかで、誰も申請していなかったレビューサイトが作業の大半を担っていました。
だからこれをやる意味があります。推測をやめて、実際のページを見始めるのです。
この手順を終えると、次のものが揃います。
- 1 つの製品またはサービスカテゴリについて、顧客が実際に使う言い回しで書かれた 10〜20 個の本物の購買質問
- 各質問を買い手が実際に使う AI エンジンで実行し、引用された情報源を日付つきで記録したもの
- その情報源を種類別に並べ替えたもの。あなたのカテゴリの回答がどこから来ているかが見えます
- 競合が引用されていて自社が引用されていないページの短いリスト。それぞれに正当な次の一手がついています
- 担当者とレビュー日。マップが共有ドライブの中で腐らないようにするためです
対象読者: 社内の SEO、GEO、コンテンツ担当リード、または実装は他者が行う場合でも改善提案を出せる代理店のストラテジスト。有料ツールは必須ではありませんが、規模が大きくなれば役に立ちます。
前提条件: ブラウザ、表計算ソフト、自社サイトへの閲覧権限。エージェント版を使う場合は、選んだエージェントの動作するインストールと、それを向けるフォルダ。
所要時間: 1 カテゴリの初回パスで約 2 時間。そのうち約 45 分はプロンプトの実行と情報源のコピーです。この 45 分こそエージェントに渡す価値のある部分で、残りはあなたの判断が必要な部分です。
完了の定義: あなたのカテゴリで回答を支えている 3〜4 種類の情報源を挙げられ、自社が不在で競合が存在する具体的なページを指し示し、URL つきのタスクを誰かに渡せる状態。ドメインのリストと「Reddit が大事らしい」という漠然とした感覚しかないなら、まだ完了していません。
Auspia の見解: ほとんどのチームは、回答が実際に何から組み立てられたかを見ていないために、「もっとブランド言及が必要だ」に一直線に向かいます。マップは、その漠然とした直感を、行動できるページに変えるものです。
始める前に: すべてを決める 2 つの選択
この後の成果物は、この 2 つの選択で決まります。どちらも間違えやすく、どちらも後から戻すのが面倒です。
1 カテゴリを選び、事業全体を対象にしない。 ソフトウェアを売りながらサービス部門も持つ会社には、2 つの異なる情報源エコシステムがあります。両方を同時にマッピングすると、どちらも説明しない平均値が出てきます。最も売上に効くカテゴリを選び、残りは次の四半期に回してください。
エンジンは意識して選ぶ。 Google AI Overview、ChatGPT、Perplexity、Gemini は同じプールから引いてくるわけではありません。あるエンジンで存在感を失った情報源が、別のエンジンでは依然として重みを持っていることがあります。最低 2 つは実行してください。どれを選ぶか分からない場合は、営業チームに顧客がどの画面の話をするか聞くか、AI 系ドメインからの参照トラフィックを確認してください。
ここで 1 つ境界を引いておきます。これは観察の作業であり、証明の作業ではありません。ある日にエンジンが返したものを記録しているだけです。回答は実行ごとに変わります。つまり 1 回の観察はデータ点であって、トレンドではありません。すべてに日付をつけてください。そうしないとファイル全体が 1 か月で使い物にならなくなります。
ステップ 1: 質問セットを作る
顧客が選ぶときに聞くであろう質問を 10〜20 個書きます。キーワードではありません。質問です。顧客自身の言葉で。
ここは多くの人が急いで通り過ぎるステップであり、残りをやる価値があるかどうかを決めるステップでもあります。キーワードの書き出しから作った質問セットは、人がどう検索するかのマップを生みます。商談メモから作った質問セットは、人がどう買うかのマップを生みます。この 2 つは同じリストではありません。
リストの材料として使えるもの:
- 営業チームが最もよく受ける購入前の質問
- 購入後 30 日以内のサポートチケット
- 主要な商用クエリの「他の人はこちらも質問」欄
- 自分のキーワード調査を質問の形に書き直したもの
- 買い手が実行する競合比較検索
質問の形を混ぜてください。それぞれ違う情報源を引いてきます。
質問の形 | 例 | 出てきやすい情報源 |
|---|---|---|
カテゴリ適合 | 「中規模の物流企業が配送ルートツールを選ぶとき、何を見るべきか?」 | 編集記事のまとめ、レビューサイト |
直接比較 | 「20 人チームならツール A とツール B のどちらか」 | 比較ページ、コミュニティのスレッド |
リスクと反論 | 「ツール A は医療データに使えるほど本当に安全か?」 | フォーラム、コンプライアンス解説、ベンダーのドキュメント |
価格と価値 | 「ツール A の 1 席あたりの実際のコストは?」 | 料金ページ、コミュニティのスレッド、レビューサイト |
導入 | 「ツール B から移行するのにどれくらいかかるか?」 | ドキュメント、YouTube の解説動画、フォーラム |
期待される成果物: 質問ごとに 1 行、質問の形の列、実行するエンジンの列がある表計算ファイル。
品質チェック: リストを読み返し、それぞれを実際の買い手が入力するか自問してください。すでに自社の製品分類を知っている人にしか意味をなさない質問なら、書き直します。買い手が実際に聞く 10 個の質問は、キーワードの書き出しのように聞こえる 50 個より優れています。
復旧手順: 10 個に届かないなら、それはマッピングではなく調査の問題です。直近 20 件の商談メモか直近 50 件のサポートチケットから質問を抽出してから続けてください。
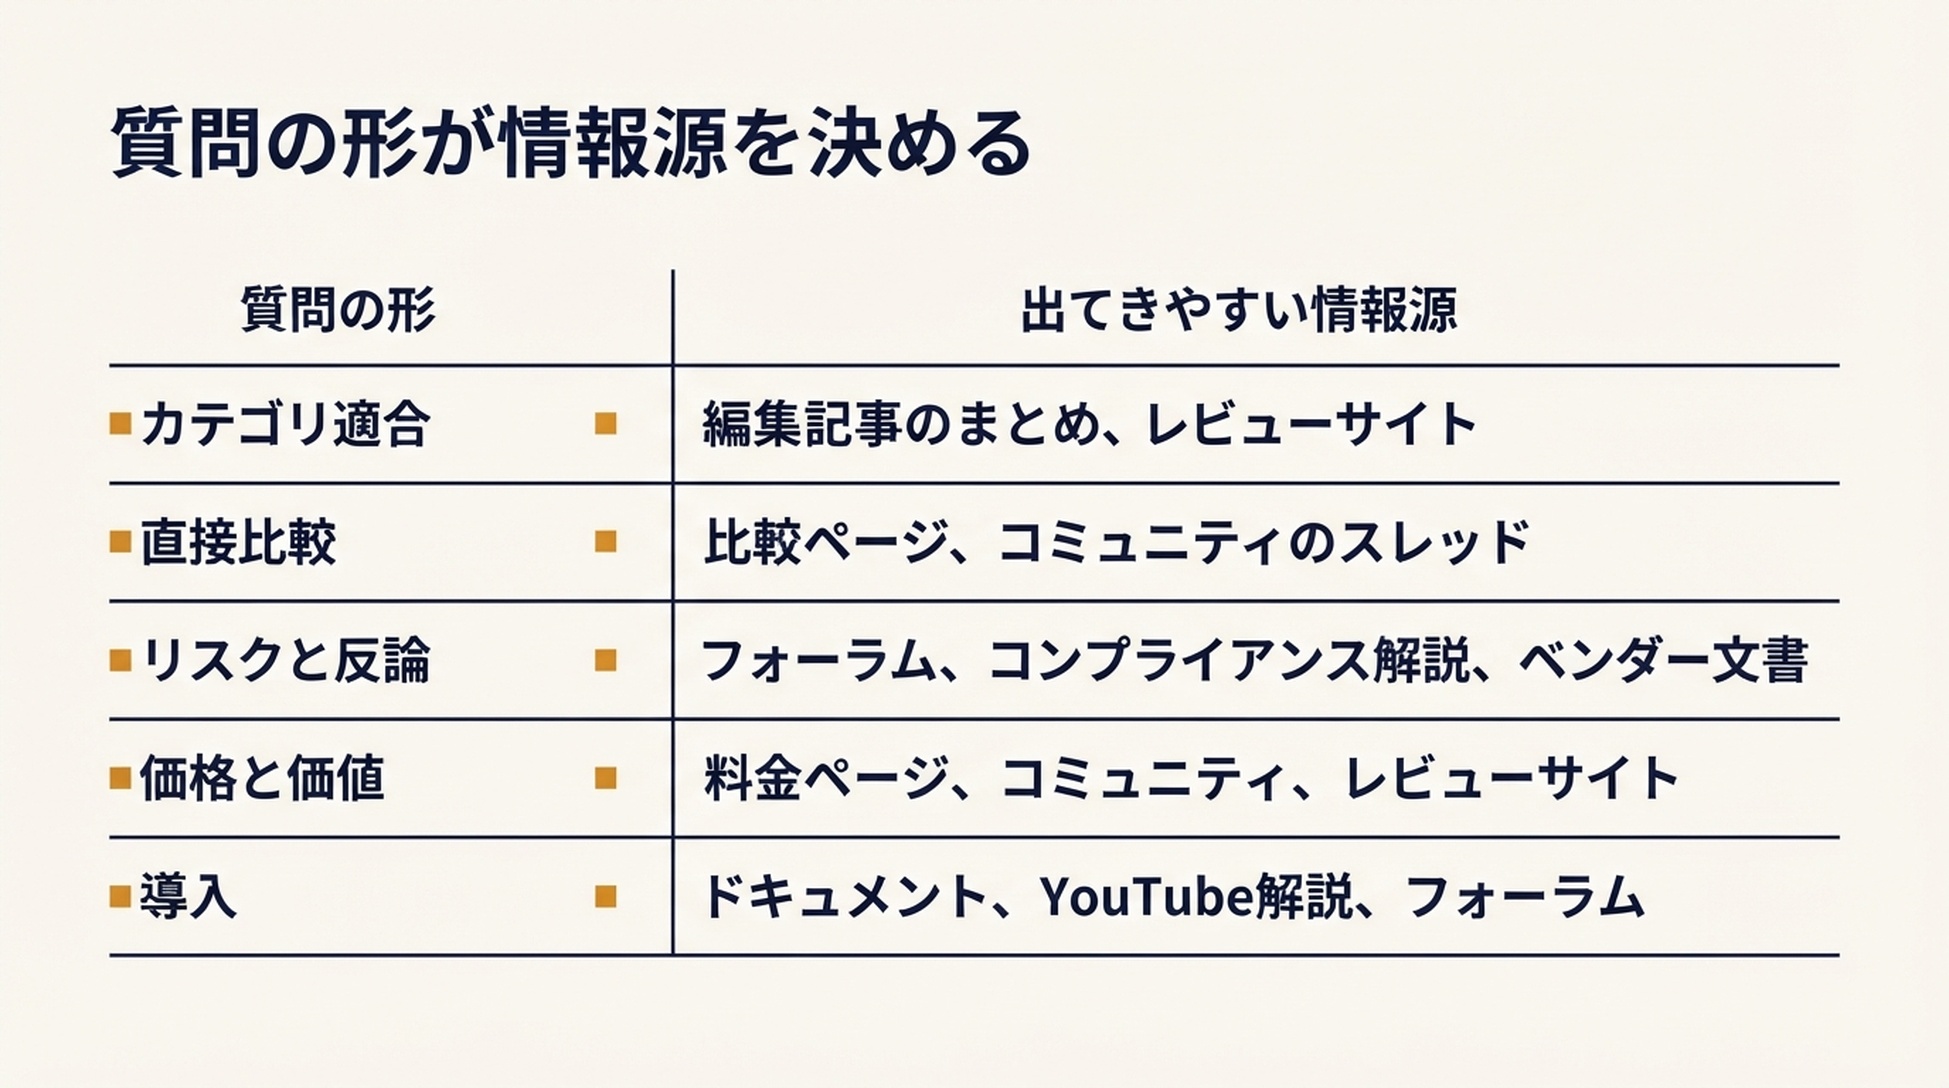
質問の形は隠れた変数です。同じ製品についての直接比較の質問とリスクの質問では、返ってくる情報源が違います。
ステップ 2: 質問を実行し、情報源を記録する
ここが機械的な中核であり、手作業が破綻する場所です。出力がどうあるべきかを理解するために 5 問は手でやってください。そのうえで残りを自動化します。
各質問について、各エンジンで:
- 新しい会話を始める。以前の文脈はエンジンが何を取得するかを変えてしまいます。
- 書いたとおりの質問をそのまま尋ねる。
- 引用パネルまたは情報源リストを開く。多くのエンジンでは、回答の近くにある小さなアイコンで、目に見えるリストにはなっていません。
- 引用された URL をすべて記録し、あわせてドメインと情報源の種類も記録する。
- 日付、エンジン、そもそも引用があったかどうかを記録する。
この形で記録します。
フィールド | 重要な理由 |
|---|---|
質問 ID | すべての観察を購買質問に結びつける |
エンジン | 後でエンジン単位の傾向を分離できる |
日付と時刻 | 回答は変動する。日付のない行は 1 か月後に使えない |
引用 URL | ドメインだけでなく実際のページ |
ドメイン | グルーピングと頻度集計のため |
情報源の種類 | 自社、小売・マーケットプレイス、コミュニティ、レビューサイト、編集記事 |
競合の有無 | はい / いいえ、およびどの競合か |
自社の有無 | 回答に登場、情報源に登場、両方、またはどちらもなし |
最後の行は立ち止まって考える価値があります。ブランドは、自社ページが 1 つも引用されなくても回答の中で名指しされることがあります。逆に、目立って名指しされなくても引用されることがあります。これは 2 つの別のシグナルで、「出たかどうか」だけを追っていると両方を読み違えます。自社に不利な主張をしているページからの言及をチームが喜んでいたのを見たことがあります。
期待される成果物: 長い表。質問 1 件・エンジン 1 件につき、引用された情報源 1 行。
品質チェック: 少なくとも 3 行について、引用ページを開き、引用された理由の主張をそのページが実際に支えているか確認します。エンジンはときどき、質問に答えずに話題に触れているだけのページを引用します。そうした行はノイズなので印をつけてください。
復旧手順: あるエンジンがある質問に対して引用を返さない場合、それは失敗ではなく発見です。情報源ゼロとして記録し、先に進みます。取得なしで回答される質問は、自社コンテンツでは影響を与えられない質問です。
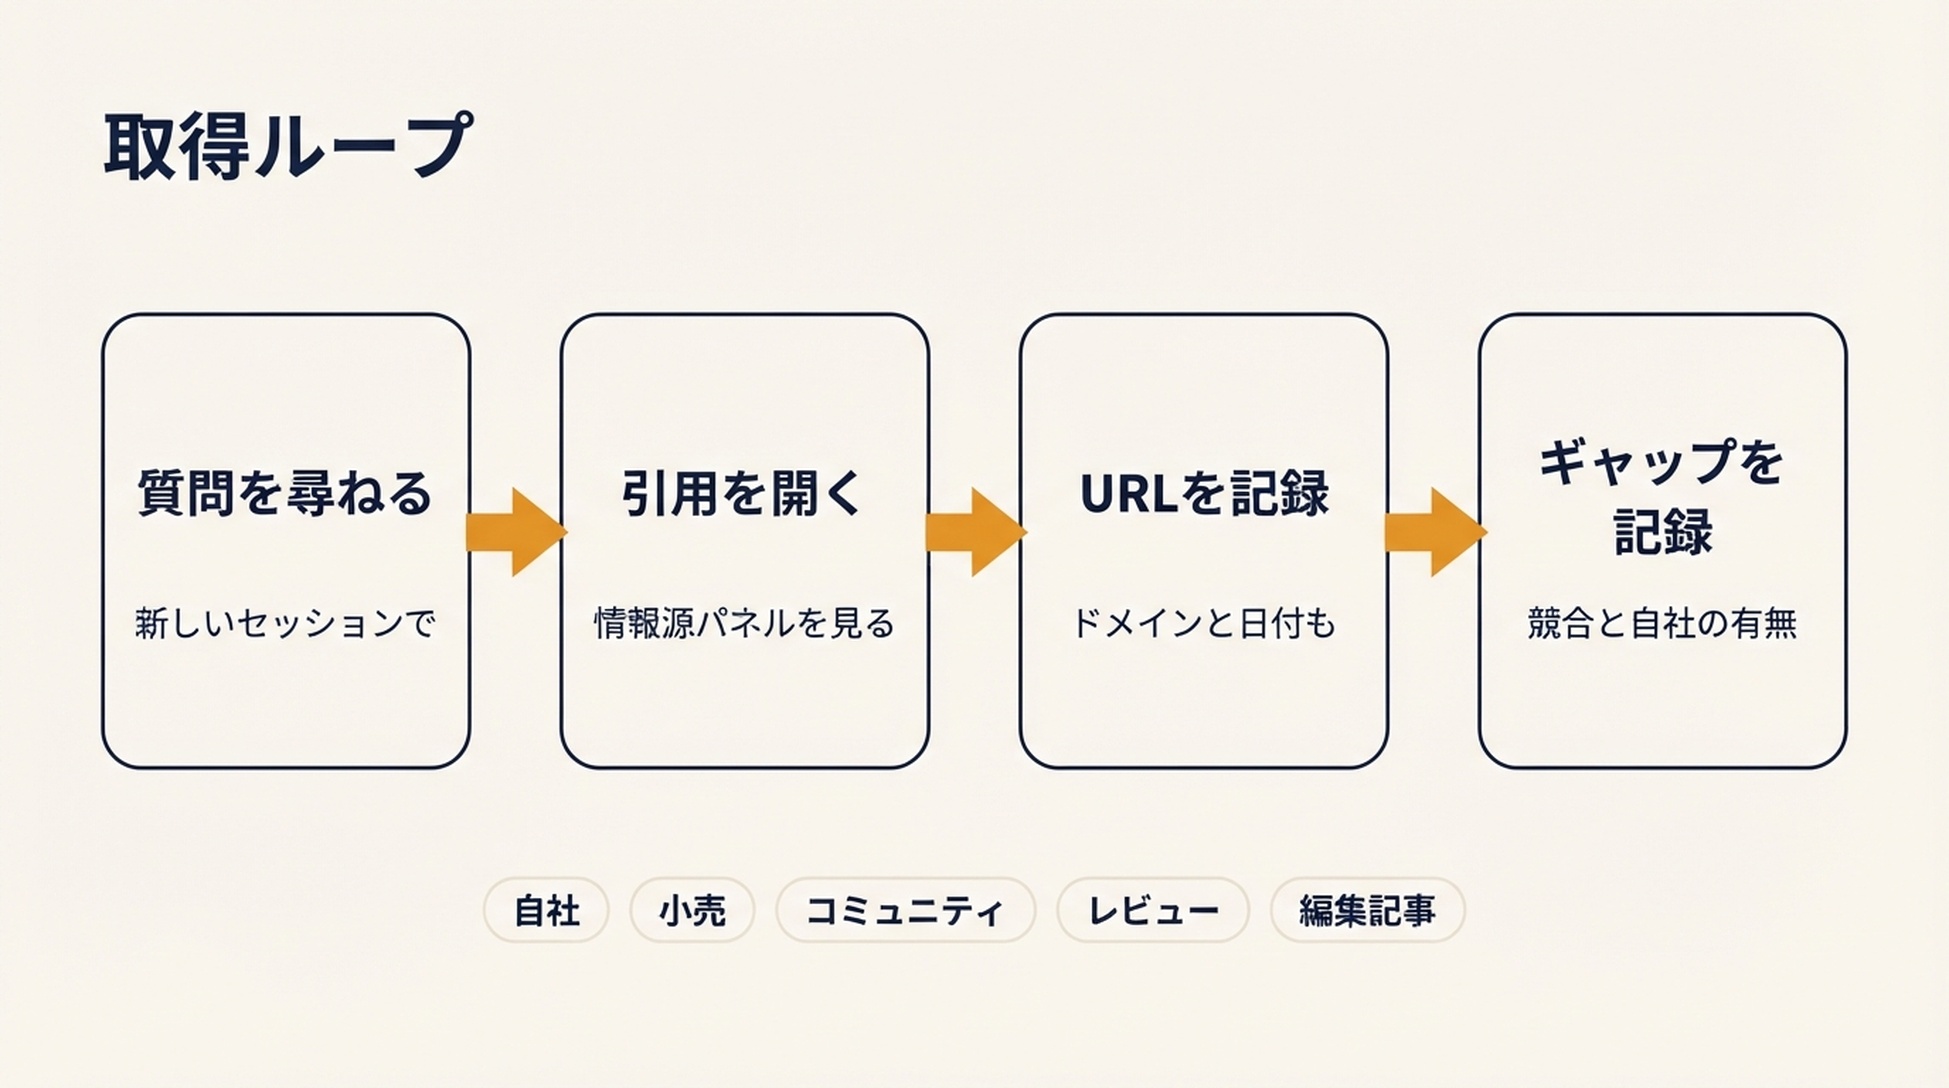
ループは単純で退屈です。その組み合わせこそ、エージェントに渡すのに向いている証拠です。
ステップ 3: 情報源を種類別に並べ替える
ここで長い表を、あなたのカテゴリの全体像に畳み込みます。引用された URL をすべて 5 つのバケツのいずれかに分類します。
- 自社: 自社サイト、または競合のサイト
- 小売とマーケットプレイス: 製品リスト、価格比較ページ、アプリストア
- コミュニティと UGC: Reddit、YouTube、Quora、フォーラム、インデックスされた Discord スレッド
- レビューサイトと B2B プラットフォーム: G2、Capterra、Clutch、Trustpilot、業界特化のディレクトリ
- 独立系の編集記事とリファレンス: 業界誌、ニュース、Wikipedia、アナリストの解説、独立系ブログ
バケツごと、エンジンごとに数を数えれば、引用マップの完成です。
見るべきものは単一の数値ではありません。形です。あるカテゴリはほぼコミュニティのスレッドと業界誌で支えられ、ブランド自身のサイトはほとんど寄与していません。別のカテゴリは製品リストが支配的で、リストそのものに答えが入っています。この配合は、誰かのサイトがどれだけ優れているかではなく、買い手が何を尋ねるかによって決まります。サイトに 2 年かけてきた身には受け入れがたい話です。
期待される成果物: 小さな表。情報源の種類ごとに 1 行、エンジンごとに 1 列、引用された情報源のシェアを示す。
品質チェック: 1 つのバケツが引用の約 70% を超えるなら、その中の URL を 5 つ抜き出し、本当にその種類かを確認します。1 つの高トラフィックなアグリゲータが、実際にはディレクトリなのに編集記事の顔をしていることがあります。
復旧手順: 数がランダムに見えるなら、おそらく質問の形を混ぜたことでパターンが隠れています。表を質問の形で分割して見直してください。価格の質問とリスクの質問では、情報源の構成がまったく違うことがよくあります。
ステップ 4: 競合が引用され自社が引用されていないギャップを探す
長い表を、競合が登場し自社が登場しない行だけに絞り込みます。その絞り込んだリストが作業リストです。「もっと言及が必要だ」という漠然とした指令よりはるかに有用です。各行にはすでに URL と顧客の質問が紐づいているからです。月曜日に誰かに渡せば、そのまま始められます。
各行について、引用ページを開き 3 つの質問に答えます。
- 自社製品は本当にこのページに載るべきか?
- 載るべきなら、何が欠けているのか。まだ申請していないリストか、不在の比較か、誰も自社に触れていないスレッドか、依頼していないレビューか?
- そこに自社を載せるための、最小の正当な行動は何か?
3 つ目の質問が規律の要です。行動はバケツごとに違います。ここを間違えると、SEO 担当が Reddit のスレッドについて記者にコールドピッチする羽目になります。
情報源の種類 | 正当な行動 | やってはいけないこと |
|---|---|---|
レビューサイト | プロフィールを申請して完成させ、顧客にレビューを依頼する | レビューを買う、偽のレビューを仕込む |
コミュニティのスレッド | 実名の社員として質問に正直に答え、所属を開示する | ステマをする、貢献なしにリンクだけ置く |
編集記事 | その媒体が扱っていない、本当に有用な切り口を提案する | 同じプレスリリースを 200 ドメインに一斉送信する |
マーケットプレイスや小売のリスト | 仕様、画像、説明を修正し、事実を取得可能にする | リストにキーワードを詰め込む |
自社ページ | 特定の事実が見つけやすく引用しやすいよう再構成する | 何も答えない FAQ ブロックを足す |
期待される成果物: 絞り込まれ優先順位づけされたリスト。ドメインがどれだけ権威的に聞こえるかではなく、質問セット全体でその情報源がどれだけ頻繁に現れるかで並べます。20 問中 6 問で引用されるフォーラムのスレッドは、1 回だけ引用される業界誌より上位です。しかも手を打つのがずっと簡単です。
品質チェック: 残す各行について、対応する顧客の質問を言えるか確認します。言えないならその行は外します。パイプラインの誰も聞かない質問で引用されているページは、注意をそらすだけです。
復旧手順: 絞り込んだリストが膨大なら、絞り込みが足りません。初回パスは引用頻度順に 10 行までに抑え、それらを片付けてから全体のリストを開き直してください。
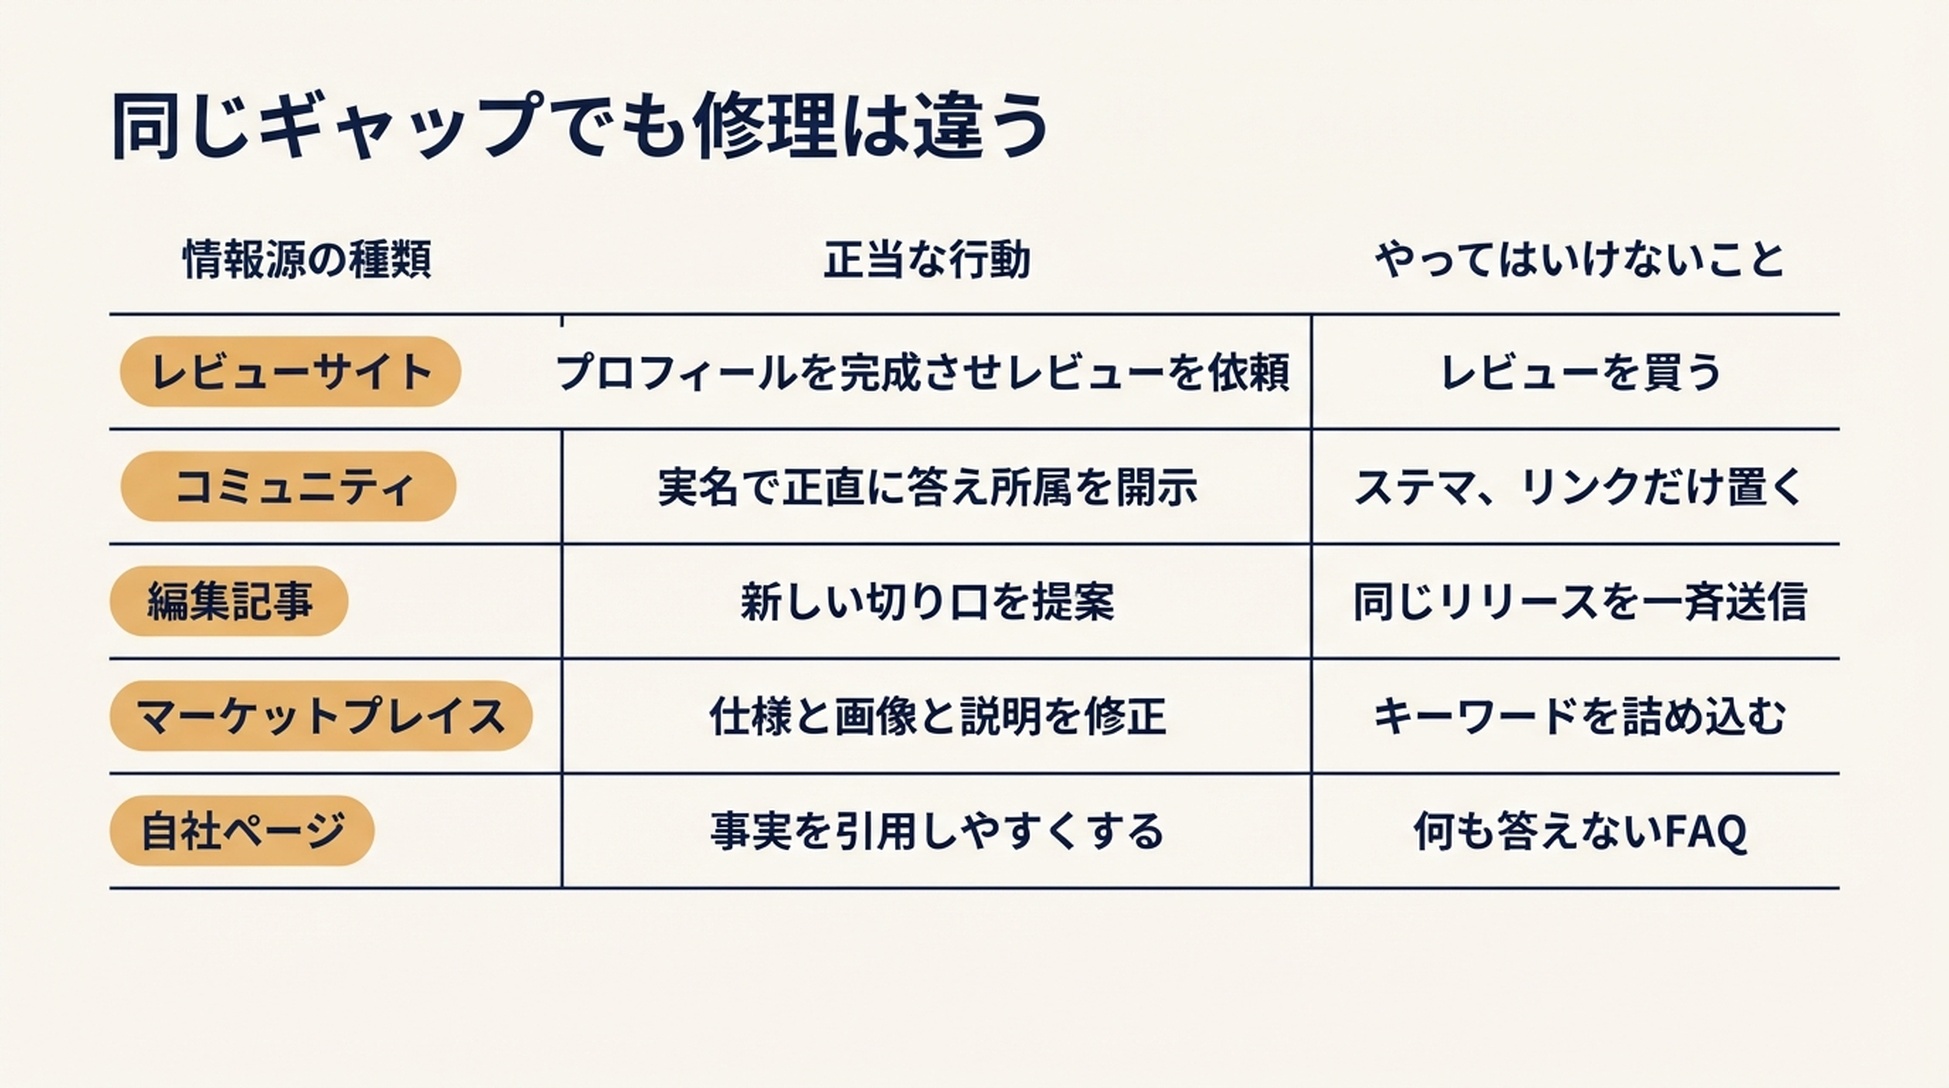
同じギャップでも修理の仕方は違います。引用漏れをすべてアウトリーチの問題として扱うと、チームは Reddit のスレッドについて編集者に売り込みをかけることになります。
ステップ 5: 機械的な半分をエージェントに渡す
ステップ 2 と 3 は、最も時間を食い、最も判断を要さない部分です。これが委任する価値のある作業の定義です。質問セットと優先順位づけは人が持ちます。ここは判断を誤ると演習全体が無駄になる 2 か所だからです。
以下の 4 つのエージェントはすべて同じ方法を実行できます。変わるのは、方法がどこに住み、出力がどう戻ってくるかです。今月ベンチマークで勝ったモデルではなく、それで選んでください。
Codex
マップをリポジトリに置き、実行ごとにレビュー済みの成果物を出したい場合に最適です。サイトがすでに git にあるなら、摩擦が最も少なくなります。
プロジェクトフォルダに citation-map/ ディレクトリ、質問セットを入れた questions.csv、方法を記述した SKILL.md を用意します。SKILL.md には、どのエンジンを確認するか、どのフィールドを記録するか、情報源をどう分類するか、出力ファイルがどうあるべきかを書きます。実行ごとに 1 ファイル、日付を名前にして、上書きせず履歴を蓄積します。
Codex に質問を実行させ、現在の実行ファイルに行を追記させ、エンジン別の情報源シェアのサマリー表を出させます。出力がリポジトリ内のファイルなので、最終版として扱う前にレビューできる差分が得られます。このレビュー段階が要点です。取得をやり直すのではなく、分類を確認しているのです。
どんな場合でも SKILL.md に入れるべきルールが 1 つあります。エージェントは観察したものを記録し、見ていない引用を推測してはならない。存在しない情報源の捏造は、このワークフローで最も有害な失敗モードです。明文化したルールと 3 行の抜き取り確認で大半は防げます。確認する 3 行は毎回変えてください。
Claude Code
方法を明示的な文書化されたポリシーに対して読み合わせる必要があり、取得したページを長い文脈でレビューしたい場合に最適です。
方法を CLAUDE.md またはプロジェクトスキルに置きます。情報源の種類の定義と、正確な出力スキーマを含めます。Claude Code を実行フォルダに向け、引用 URL を 1 つずつ分類させ、ページ内容が引用を実際に支えていない行にフラグを立てさせます。
2 つ目の仕事こそ、お金を払う価値のある部分です。引用された 200 ページを読み、それぞれが本当に質問に答えているか判断するのは、人には苦痛で、書かれた基準を持つエージェントには妥当な作業です。すべての行に信頼度フラグを出させ、低信頼度の行だけを自分でレビューしてください。
ChatGPT
セットアップのコストを最も低く抑えたい場合、また作業が定期的な実行ではなく 1 回の作業セッションである場合に最適です。
方法をカスタム指示または保存したプロジェクトプロンプトとして貼り付け、質問リストを添付し、エンジンごとにバッチで処理します。出力はステップ 2 と同じ列を持つ表として求めれば、そのまま表計算に貼り付けられます。
注意点は、ChatGPT もまた測定対象の画面の 1 つだということです。ChatGPT 自身の引用をマッピングする場合は、方法を読み込んでいないクリーンなセッションで行ってください。そうしないと観察が汚染されます。取得は 1 つのセッション、整理は別のセッションで行います。
Hermes Agent
方法をスキルとして永続化し、毎回説明し直さずに実行を重ねて改善したい場合に最適です。
引用マップの方法を、質問セットと出力スキーマとともに Hermes スキルとしてインストールし、定期的に実行します。月次が通常は適切です。スキルとそのメモリが永続するので、1 か月目に加えた修正が 2 か月目に引き継がれます。エージェントがディレクトリを編集記事と誤分類したなら、ルールを一度直せば済みます。
トレードオフは、永続メモリには定期的なレビューが必要だということです。数回実行するごとにスキルファイルを読み、蓄積された修正が、説明のつかない一回限りの例外の山にならず、望む方法をまだ記述しているか確認してください。
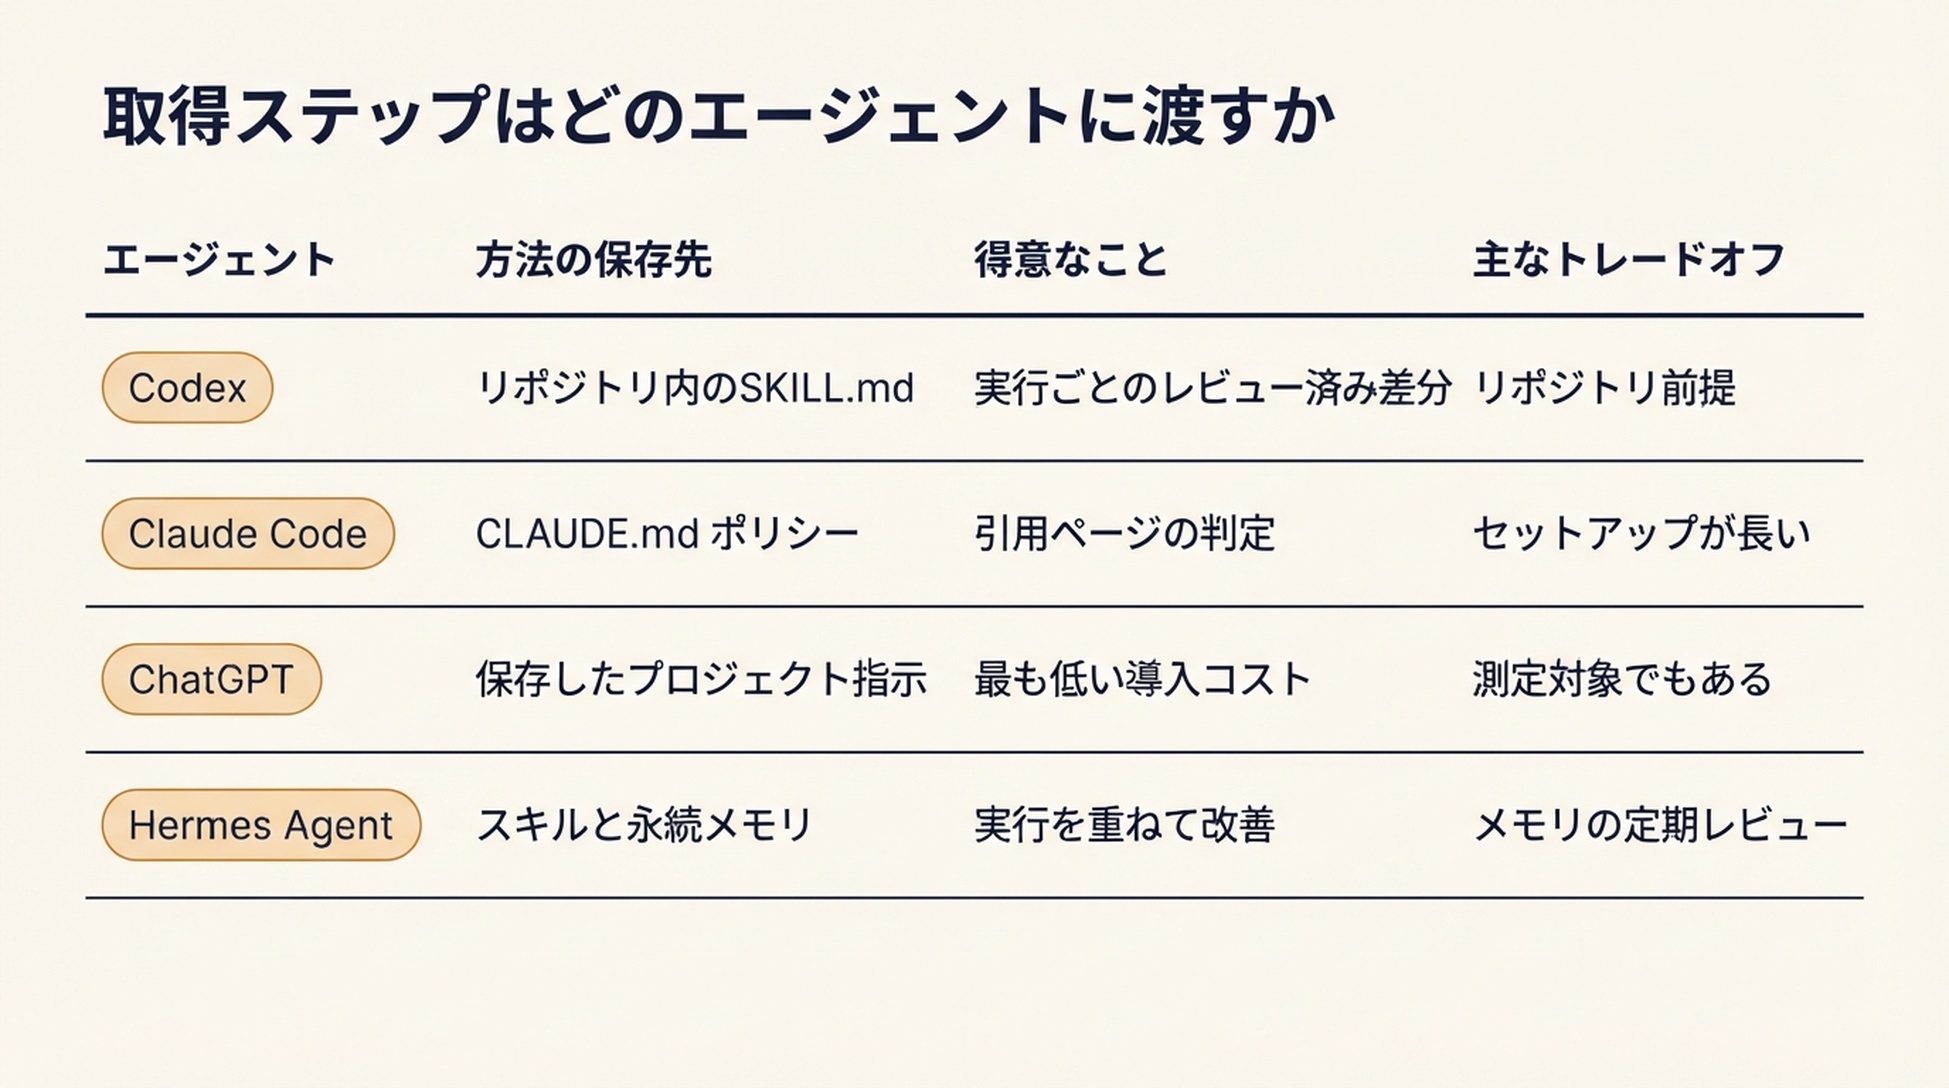
4 つとも同じ 5 ステップを実行します。ベンチマークで最高得点のモデルではなく、方法をどこに置くべきかで選んでください。
ステップ 6: 行動する前にマップを検証する
検証していないマップで作業を割り当てないでください。まずこのチェックを実行します。ここでの 5 分が四半期分の方向違いの努力を節約します。
- 1 週間後に 3 つの質問を再実行する。 情報源の構成が完全に変わったなら、質問セットが不安定すぎるか、サンプルが小さすぎます。初回を正解として扱わず、変動を記録してください。ある程度の変動は正常です。全面的な入れ替わりは警告です。
- 回答だけでなくエンジンも確認する。 Perplexity に出た情報源が、同じ質問の ChatGPT では出ないことがあります。サマリーではエンジンの列を分けておいてください。合算値は、まさに必要なシグナルを隠します。
- 自社の引用も確認する。 自社が引用されているなら、そのページを開きます。エンジンが、自社を批判的に扱っているページや、自社が管理していないページを引用することがあります。それは有用な情報であり、勝利ではありません。
- すべての行の日付を確認する。 日付のない引用マップは、後で何とも比較できません。
- 情報源の数を確認する。 1 つの質問が 40 件、残りが 3 件を返したなら、実際の引用ではなく「関連」パネルを取得していないか確認してください。
完了の定義: サマリー表と絞り込んだ作業リスト 1 つを同僚に渡し、どの行の意味も聞き返さずに行動できる状態。
マップを維持する
同じ質問セットで四半期ごとに全体パスを実行し、商業的価値が最も高い 5 問については月次で軽いパスを回します。過去の実行結果は残してください。興味深いシグナルはスナップショットであることはまれです。ドリフトです。静かに伸びている情報源の種類、あるいはかつて不在だったバケツに現れ始めた競合。
質問セットは年に 2 回見直します。購買質問は製品と市場とともに変わります。古い質問セットは、もう売っていないカテゴリのマップを生みます。
抵抗すべきことの 1 つ。これをダッシュボードに変えないでください。成果物は、担当者と URL がついた作業リストです。最後に誰もタスクを持っていないなら、マップは役割を果たしていません。
FAQ
これをやるのに有料の AI 可視性ツールは必要ですか?いいえ。手作業版は 1 カテゴリなら機能し、半日で終わります。ツールは、多数のカテゴリや市場を追跡する場合、あるいは表計算を自分で維持せずに履歴のトレンドラインが欲しい場合にコストに見合います。
質問は何個あれば十分ですか?カテゴリごとに 10〜20 個です。10 個未満ではパターンと偶然を区別できません。初回パスで 20 個を超えると分析が終わりません。分析こそが作業リストを生む部分です。
すでに自社が出ている質問も含めるべきですか?はい。どの情報源が自社を支えているかを知ることは、どこで外しているかを知るのと同じくらい有用です。コンテンツを書き換えるときに何を守るべきかも分かります。
毎回違う回答が返ってきたらどうすればよいですか?それは正常であり、記録する価値があります。同じ質問を 3 回実行し、変動を記録します。情報源の集合が毎回まったく違うなら、その質問は低信頼度として扱い、優先順位づけでの重みを下げてください。
エンジンの情報源リストを開かずにそのまま使えますか?初回の取得なら構いません。実際に手を打つ行については、いいえ。自社が本当にそこに載るべきか、有用な貢献とは何かを判断するにはページを読む必要があります。
ランク追跡とはどう違いますか?ランク追跡は、結果リストの中で自社ページがどこに出るかを示します。引用マップは、回答がどのページから組み立てられたかを示します。1 位でも引用されないページはあります。どこにもランクしないページが回答の背骨になることもあります。この差こそ、半日をかける価値がある理由です。
著者: Ethan Marlowe(Auspia の GEO 計測リード、500 以上のプロンプトを担当)。プロンプト追跡、引用レポート、可視性ダッシュボード、そして本物の AI 可視性の変化と実行ごとのノイズの見分け方について執筆しています。