Aturan yang baru saja ditulis Google
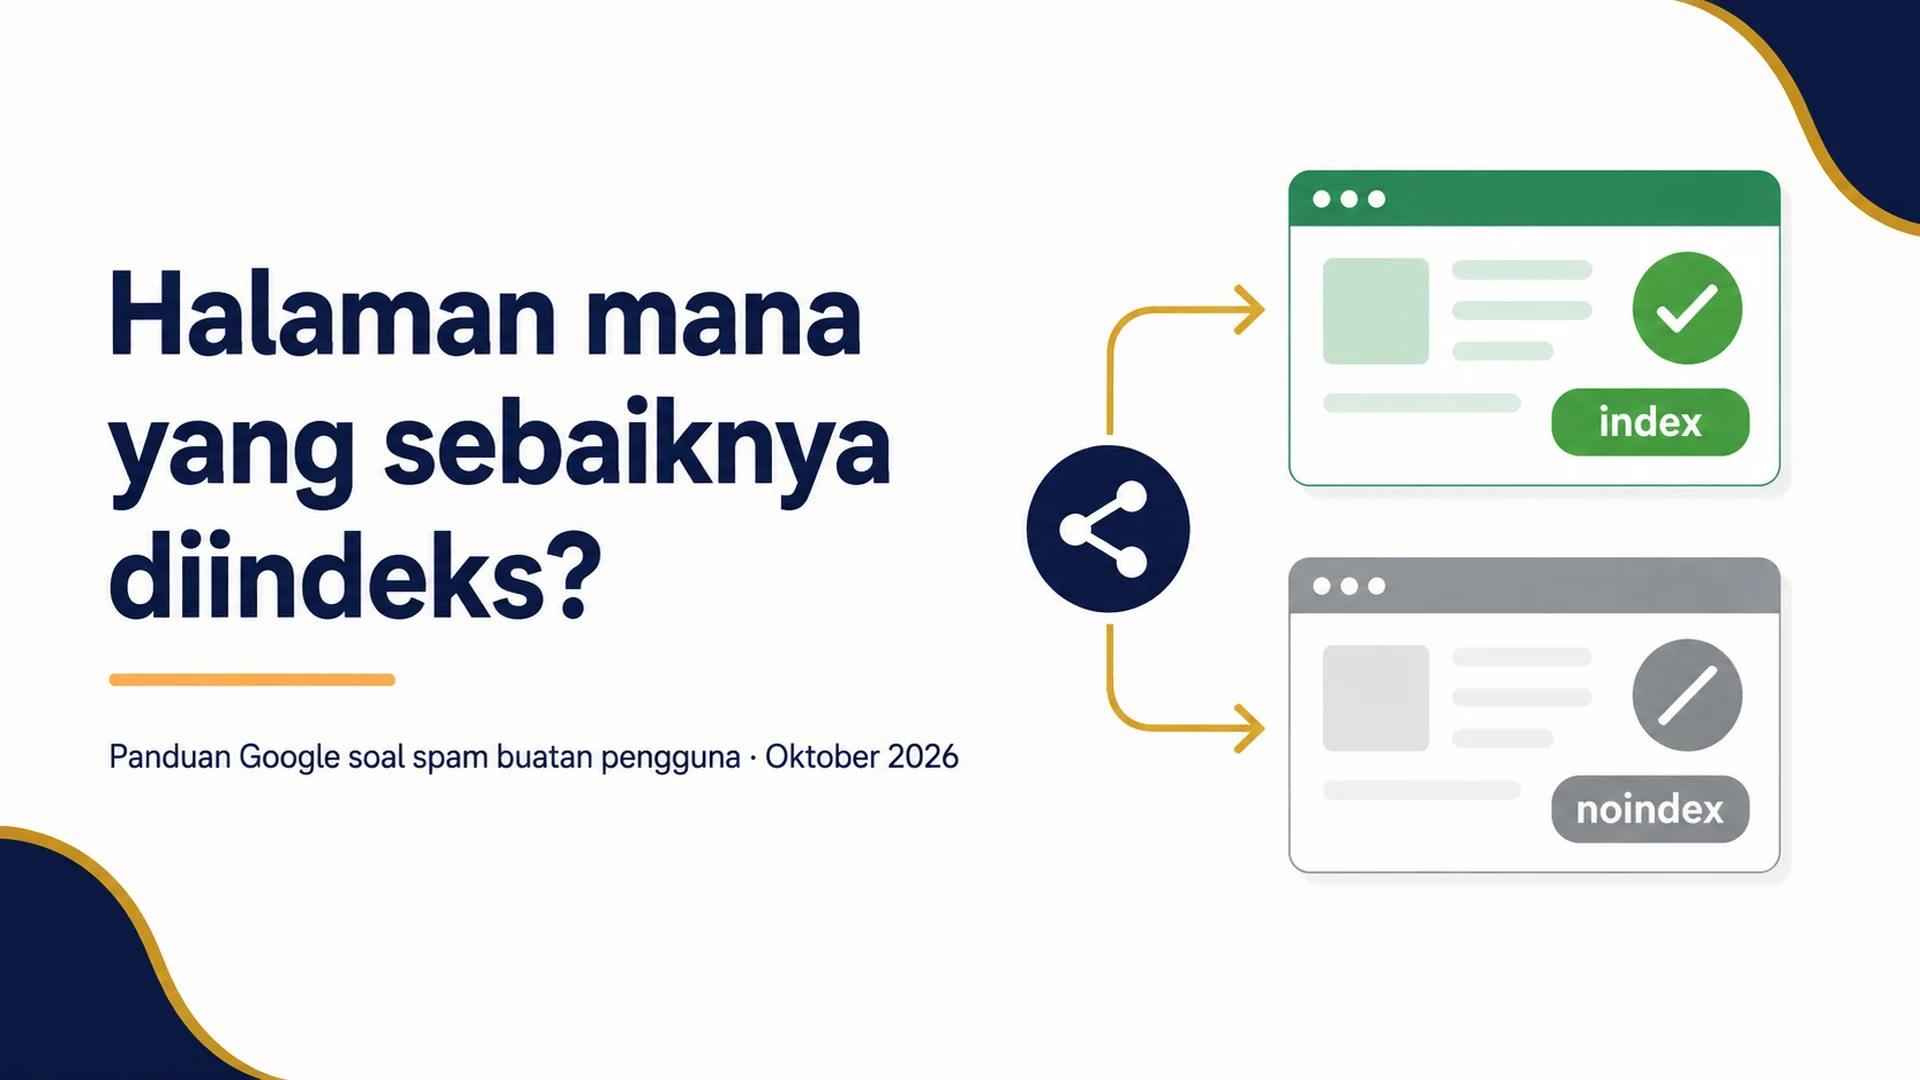
Pada 26 Oktober 2026, Google menambahkan bagian dua paragraf ke panduannya tentang cara menghindari spam yang dihasilkan pengguna. Itu bagian terpendek di halaman tersebut dan mungkin yang paling banyak mengubah peta jalan produk, karena mengajukan pertanyaan yang jarang masuk ke slide mana pun: apakah URL ini seharusnya ada di indeks Google?
Bagian itu berjudul "Only index content meant for Search" — indeks hanya konten yang memang ditujukan untuk Penelusuran. Diterjemahkan, isinya begini:
Jika layanan Anda memungkinkan pengguna membuat halaman yang bisa dibagikan, keluaran yang dihasilkan, atau alat interaktif, pertimbangkan apakah konten tersebut dibuat untuk ditemukan mesin pencari atau hanya untuk dibuka langsung oleh orang yang memiliki tautannya.
Ketika halaman dibuat untuk dibagikan langsung, untuk kolaborasi, atau untuk kegunaan, dan bukan untuk ditemukan dalam penelusuran publik, terapkan aturan noindex secara default (dengan tag meta robots atau header HTTP X-Robots-Tag) atau blokir perayapan di robots.txt secara default.
Catatan perubahan Google di hari yang sama lebih tegas soal maksudnya: panduan diperbarui dengan "panduan tentang cara memblokir pengindeksan konten yang dibagikan lewat tautan dan cara memantau penyalahgunaan di Search Console", supaya platform bisa "menjaga halaman buatan pengguna yang tidak ditujukan untuk Penelusuran tetap di luar indeks dan mendeteksi spam lebih awal".
Itu saja. Tidak ada tindakan manual baru, tidak ada pengumuman sistem peringkat, tidak ada daftar hukuman. Yang ada adalah rekomendasi nilai default — dan hampir semua kecelakaan pengindeksan lahir dari nilai default.
Untuk siapa ini. Tim yang menayangkan URL apa pun yang bisa dibuat pengguna: tautan berbagi, percakapan tersimpan, dasbor publik, pratinjau model, build aplikasi, laporan hasil generasi, utas forum, halaman profil, halaman ulasan, halaman iklan.
Hasil akhirnya. Satu putusan per rute untuk tiap jenis URL hasil generasi, kontrol yang benar-benar mencabut halaman dari indeks, dan aturan pemantauan yang menangkap pola penyalahgunaan yang disebut Google.
Waktu. 45 sampai 90 menit untuk lintasan pertama di satu produk. Satu hari kalau Anda punya beberapa pembuat URL dan tidak punya inventaris rute.
Tanda selesai. Setiap rute hasil generasi bertanda index, noindex, atau privat. Rute noindex mengirim direktifnya dari server, bukan setelah JavaScript berjalan. Search Console menampilkan URL tersebut sebagai dikecualikan karena noindex, bukan sebagai "Diindeks, meskipun diblokir oleh robots.txt".
Apa yang berubah, dan apa yang hanya tampak baru
Ada empat perubahan yang penting. Sisa halamannya tidak bergerak, termasuk panduan Desember 2025 yang masih berlaku.
Yang diubah Google | Teks aslinya | Kenapa penting bagi Anda |
|---|---|---|
Cakupan panduan | Kini menyebut platform hosting "dan alat yang memungkinkan pengguna menerbitkan halaman berbagi, konten hasil generasi, atau aplikasi web" | Dibaca harfiah, ini mencakup ekspor obrolan AI, halaman artefak, pembuat aplikasi, dan alat no-code, bukan cuma forum dan komentar |
Satuan penyalahgunaan | Spammer bisa membuat "sejumlah besar halaman atau situs" | Google bicara soal volume, bukan kecerdikan. Satu akun abusif bisa mencetak ribuan URL |
Bagian baru | "Only index content meant for Search" | Pernyataan paling jelas sejauh ini bahwa noindex adalah default yang wajar untuk konten yang hanya bisa diakses lewat tautan |
Pemantauan | Verifikasi situs atau subdomain di Search Console, pantau lonjakan di Pengindeksan halaman dan Performa Penelusuran, beri peringatan bila "segelintir pengguna" menghasilkan "sebagian besar URL yang dapat diindeks" | Penggelembungan indeks sekarang punya metode deteksi bernama — dan biasanya itulah yang mendahului suatu bentuk peninjauan |
Yang tidak berubah: noindex pada kiriman pengguna baru sampai mereka membangun reputasi, dan nofollow atau ugc pada tautan di dalam konten yang tidak tepercaya. Kalau Anda sudah melakukan keduanya, Anda sudah di depan pembaruan ini.
Perlu dinyatakan terang, karena reaksi di X mendahului dokumennya: ini panduan untuk platform soal stok URL mereka sendiri. Bukan pelanggaran baru bagi situs pemasaran biasa dan tidak mengubah peringkat halaman mana pun. Yang berubah adalah apa yang seharusnya ada di dalam indeks.
Satu keping konteks lain menjelaskan waktunya. Pada akhir Juli 2026, tautan berbagi dan halaman artefak Claude muncul di indeks Google, dan liputan saat itu menyebut rekam medis, kunci API, serta materi privat lain yang terbuka sebelum Anthropic menutup celahnya dalam beberapa hari. Liputan yang sama juga mencatat URL aplikasi publik di pembuat seperti Replit dan Lovable. Google jarang menulis bagian baru untuk sebuah hipotesis. Yang ini sudah terjadi.
Pertanyaan yang menentukan setiap URL hasil generasi
Uji dari Google muat dalam satu kalimat, dan bisa diterapkan tanpa menebak niat: konten ini dibuat untuk ditemukan mesin pencari, atau hanya untuk dibuka oleh orang yang memiliki tautannya?
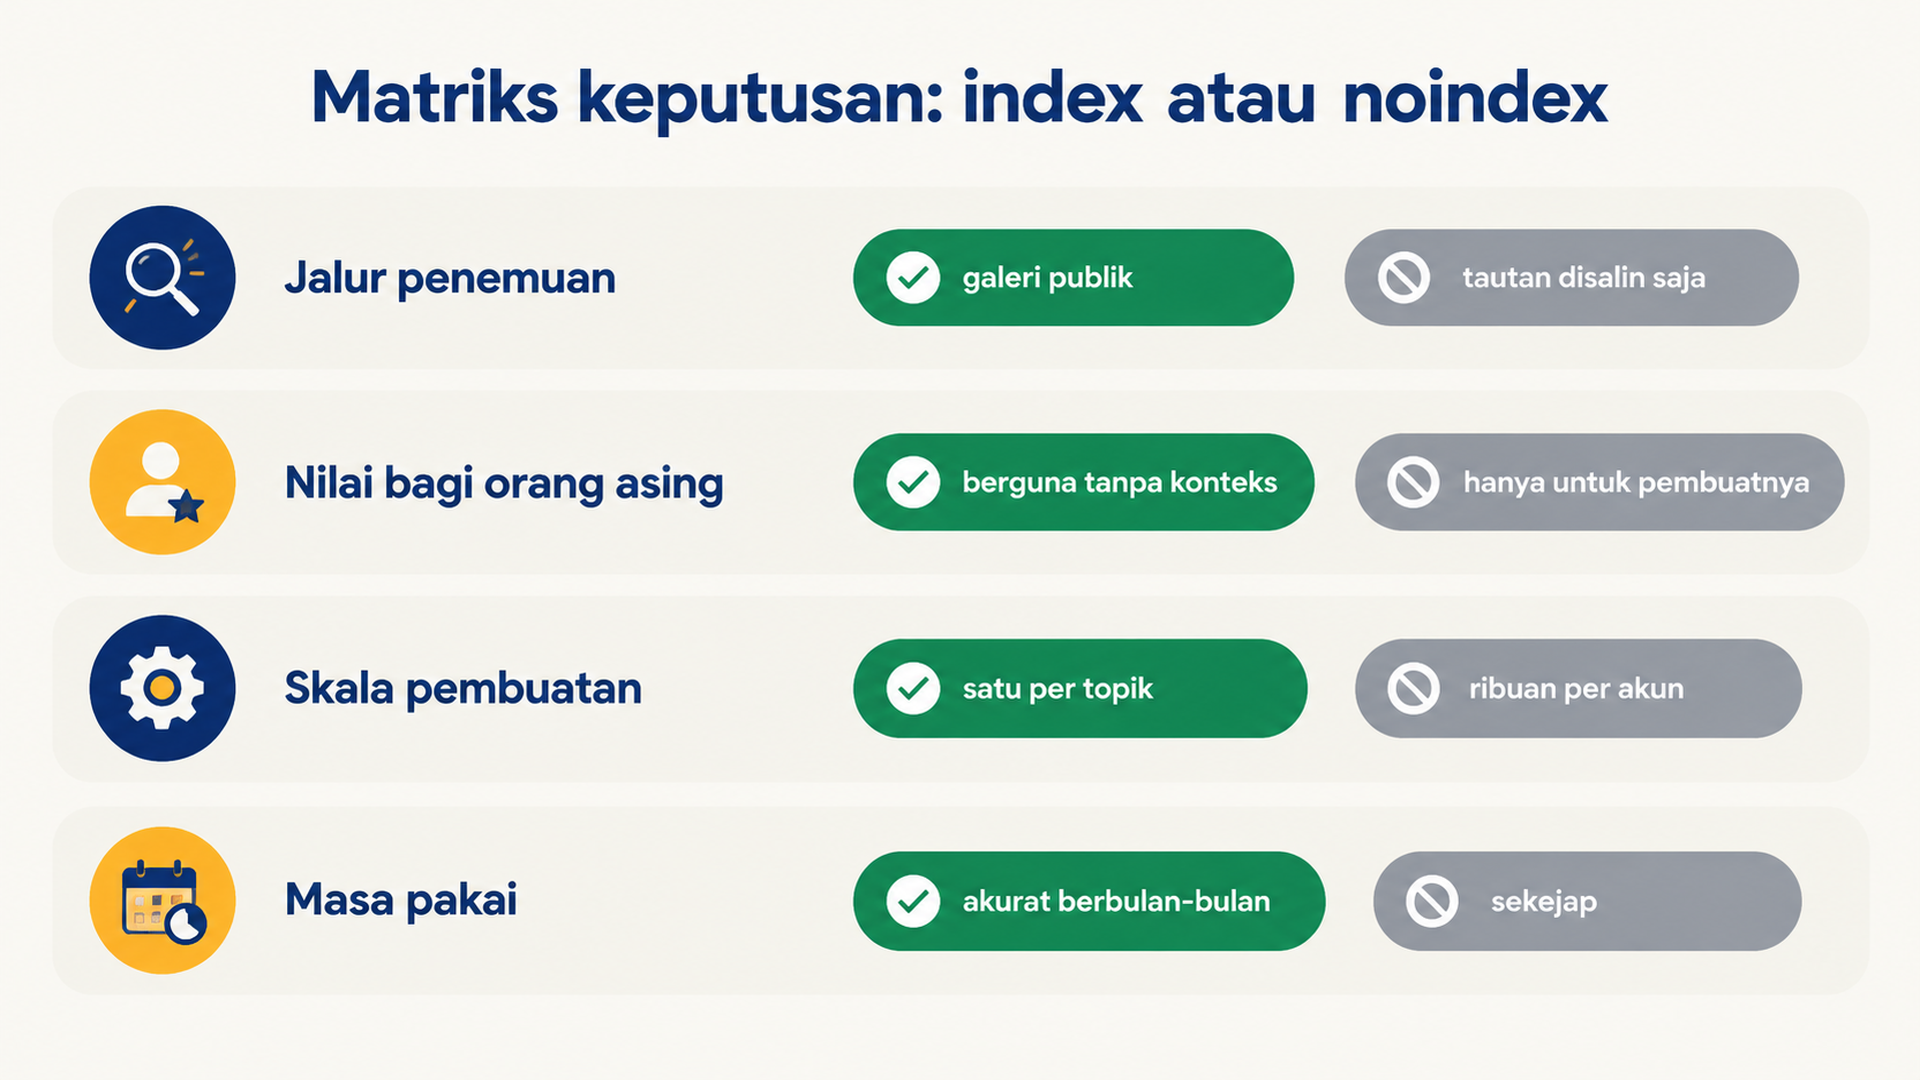
Dalam praktik, empat sinyal menjawabnya. Nilai rutenya, bukan halaman satuannya.
Sinyal | Mengarah ke index | Mengarah ke noindex |
|---|---|---|
Jalur penemuan | Ditautkan dari galeri publik, sitemap, halaman kategori, atau profil | Hanya bisa dicapai dari tautan yang disalin atau tombol bagikan |
Nilai bagi orang asing | Berguna tanpa mengenal pembuatnya | Hanya masuk akal bagi pembuat, timnya, atau penerima |
Skala pembuatan | Satu halaman per topik, atau kumpulan terkurasi | Ribuan URL dari satu akun, sebagian besar nyaris duplikat |
Masa pakai | Tetap akurat berbulan-bulan | Sekejap: satu obrolan, satu build, satu draf, satu ekspor sementara |
Tiga dari empat mengarah ke noindex berarti putusannya jelas. Hasil campuran biasanya berarti rutenya perlu dipisah: satu galeri publik yang boleh diindeks plus keluaran satuannya di bawahnya yang tidak. Pemisahan itu jawaban benar yang paling sering muncul dan juga yang paling sering dilewatkan, karena menuntut dua templat ketimbang satu flag.
Uji penolakan yang berguna: kalau orang asing melihat URL ini di hasil pencarian tanpa konteks, apakah judul dan cuplikannya masuk akal? "Obrolan dengan Sam, 24 Okt" tidak. "Templat faktur untuk desainer lepas" masuk akal. Penolakannya bukan soal kualitas. Ini soal apakah halaman itu dibuat untuk ditemukan atau dibuat untuk dikirim.
Pilih kontrol yang benar-benar mencabut URL
Di sinilah orang bisa mengikuti panduan baru secara harfiah dan tetap gagal. Google menawarkan dua opsi di kalimat yang sama, dan keduanya tidak setara.
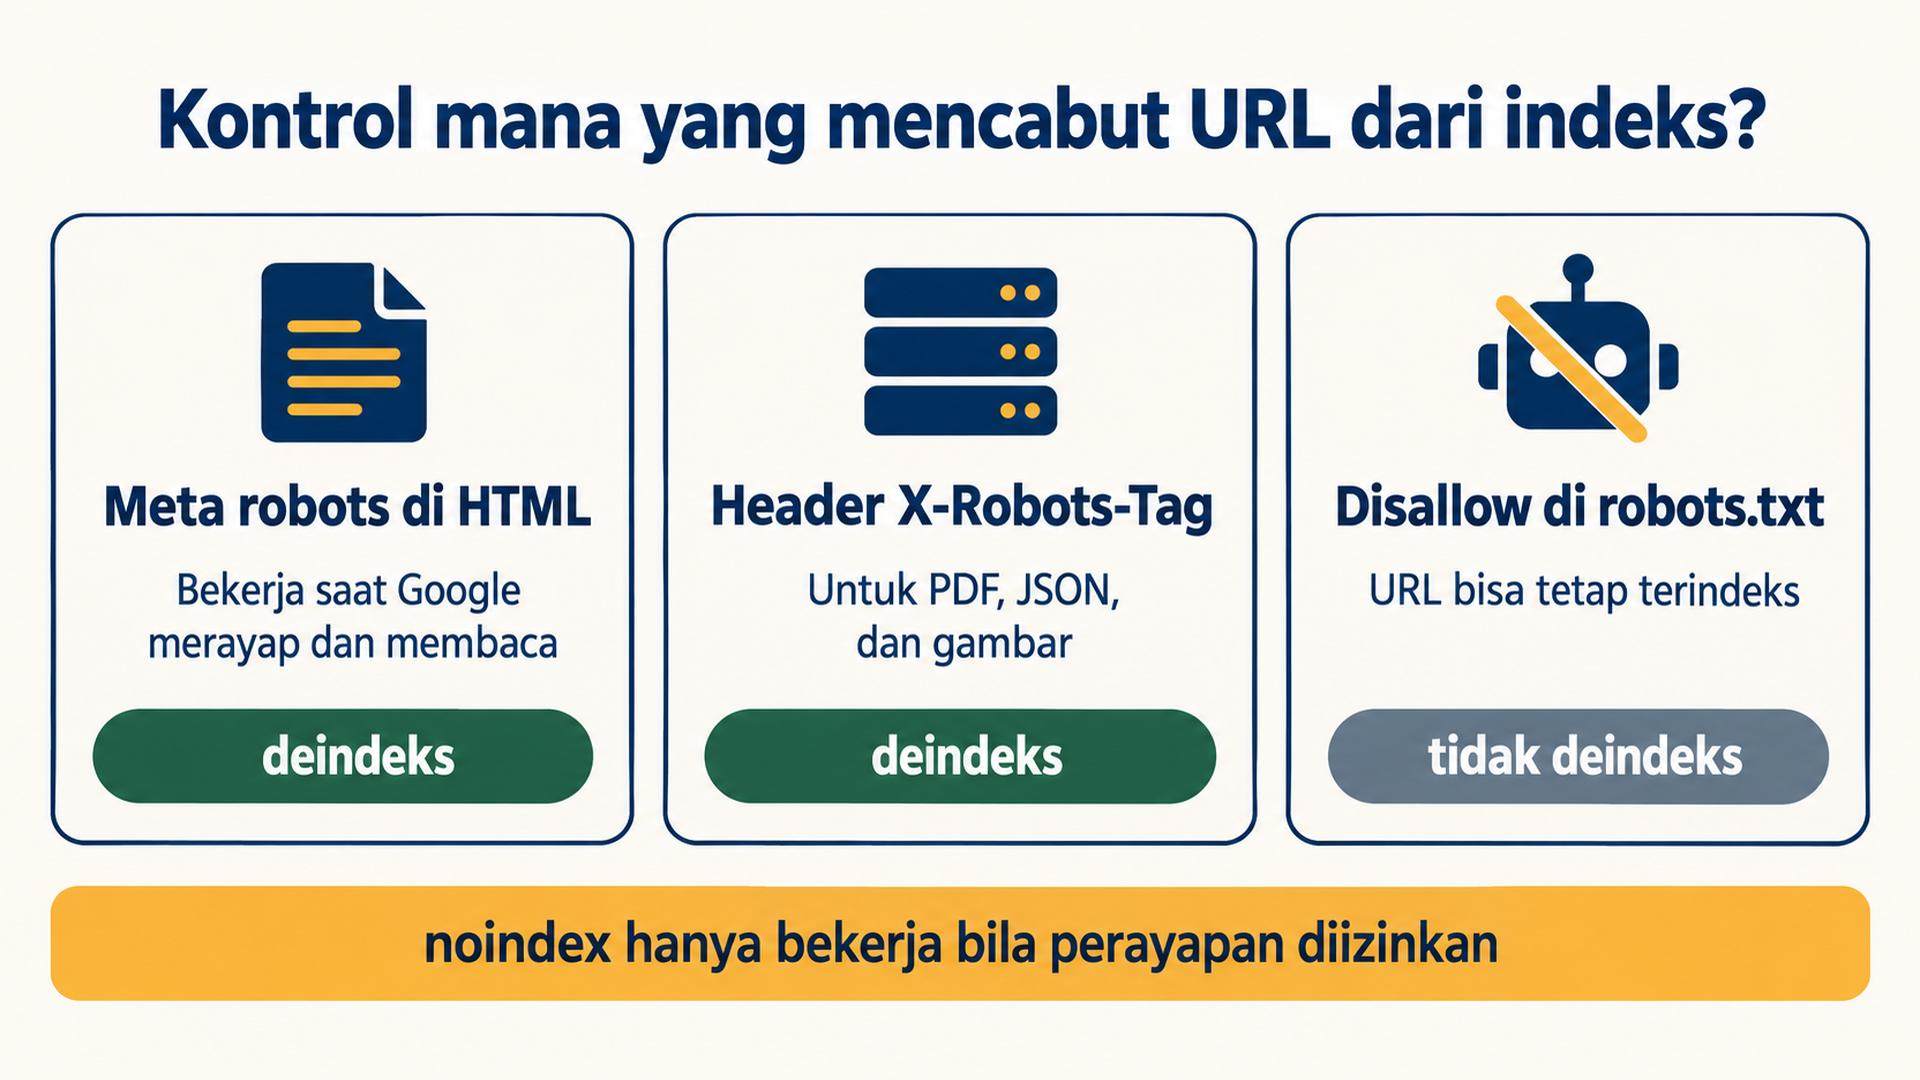
robots.txt mengatur perayapan. Itu tidak mencabut URL dari indeks, dan Google sendiri mengatakannya di pengantar robots.txt: halaman yang diblokir di sana "masih bisa terindeks jika ada tautan dari situs lain yang mengarah ke sana" — dan dalam kasus itu, URL serta mungkin teks jangkarnya bisa muncul di hasil tanpa deskripsi.
noindex mengatur pengindeksan, tapi hanya kalau Google bisa merayap halaman itu dan membaca direktifnya. Dokumentasi noindex Google tegas: agar aturannya bekerja, halaman tidak boleh diblokir robots.txt, karena kalau begitu "perayap tidak akan pernah melihat aturan noindex".
Gabungkan kedua fakta itu, dan urutannya jadi penting.
Kontrol | Mencabut URL dari indeks | Di mana gagalnya | Dipakai untuk |
|---|---|---|---|
Header respons | Ya, setelah Google merayap dan membaca | Apa pun yang diblokir robots.txt atau ada di balik login | Respons non-HTML (PDF, JSON, gambar) dan aturan edge atau CDN untuk banyak rute |
| Ya, setelah Google merayap dan membaca | Tag yang disuntikkan JavaScript setelah halaman dimuat; halaman yang diblokir robots.txt | Halaman berbagi HTML yang dirender di server |
Disallow di | Tidak | URL yang ditautkan bisa tetap terindeks tanpa cuplikan | Menurunkan beban perayapan, bukan privasi |
Login atau URL bertanda tangan | Ya, dengan mencegah akses | Menuntut halamannya benar-benar privat | Segala hal yang memuat data orang lain |
410 setelah kedaluwarsa | Ya, seiring waktu | Lebih lambat dari 404; tidak berefek selama URL masih merespons | Berbagi dan build yang sekejap |
Satu jalan pintas yang perlu dihindari: X-Robots-Tag: none bukan nilai netral. Google memperlakukannya sebagai noindex plus nofollow. Kadang itu memang yang Anda mau, tapi tim sering menyalinnya dari konfigurasi proxy tanpa tahu.
Jalan pintas kedua yang perlu dihindari: tag canonical. Canonical itu petunjuk. Kalau halaman tidak seharusnya ada di indeks, tulis noindex.
Langkah 1: inventarisasi rute yang mencetak URL
Tidak bisa mengklasifikasikan yang tidak masuk daftar, dan sebagian besar tim meremehkan hitungannya karena berpikir dalam fitur, bukan pola rute.
Buka router, atau peta URL, lalu daftar setiap segmen dinamis. Tersangka yang biasa muncul seperti ini:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Lalu cocokkan dengan yang sudah diketahui Google, karena kode dan indeks akan berselisih.
Lewat sitemap. Unduh dan hitung:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
Perintah kedua memberi histogram kasar per prefiks jalur. Kalau ada rute hasil generasi di sitemap Anda, itu sudah bug: sitemap adalah daftar halaman yang Anda minta Google indeks.
Lewat Search Console. Buka laporan Pengindeksan halaman, filter per prefiks URL untuk tiap rute kandidat, dan catat angkanya. Itu satu-satunya sumber yang menyebut apa yang benar-benar dilakukan Google terhadap URL tersebut.
Lewat log server. Kelompokkan permintaan Googlebot per prefiks:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Keluaran yang diharapkan. Daftar pola rute dengan jumlah URL di sampingnya, berasal dari minimal dua sumber.
Pemeriksaan mutu. Setiap rute yang bisa membalas 200 kepada pengunjung non-tim harus masuk daftar. Kalau hitungan sitemap dan Search Console berbeda lebih dari beberapa persen pada prefiks yang sama, cari tahu sebabnya sebelum mengubah apa pun.
Kalau tidak menemukan apa-apa. Kemungkinan besar router Anda berjalan di sisi klien. Cari definisi rute di frontend, bukan backend, dan lihat tab jaringan pada tautan berbagi yang asli.
Langkah 2: klasifikasikan tiap rute di tabel, bukan di rapat
Tulis putusannya di tempat yang bisa ditinjau. Satu baris per pola rute cukup.
Rute | Dibuat oleh | Jalur penemuan | Nilai bagi orang asing | Putusan | Kontrol | Penanggung jawab |
|---|---|---|---|---|---|---|
| Pengguna mana pun | Tautan saja | Tidak ada | noindex | Header | Platform |
| Kurasi | Tautan internal, sitemap | Tinggi | index | Tidak ada | Konten |
| Pengguna mana pun | Tautan profil | Rendah sampai aktif | noindex sampai bereputasi | Meta | Kepercayaan dan keamanan |
| Pengguna mana pun | Tautan saja | Tidak ada | noindex | Header | Platform |
| Editor | Sitemap | Tinggi | index | Tidak ada | Konten |
Tabelnya hanya bekerja kalau tiga hal benar.
Satu penanggung jawab per baris. Kepemilikan yang kabur adalah alasan rute hasil generasi tetap bisa diindeks bertahun-tahun.
Tulis kontrolnya di samping putusan, bukan sesudahnya. "Noindex" belum jadi keputusan sampai ada yang tahu apakah itu berarti header, perubahan templat, atau aturan CDN.
Catat pengecualiannya. Kalau sebuah rute noindex tapi sebagian kecil seharusnya publik, tulis syarat bagian kecil itu sekarang. Memotongnya enam bulan kemudian adalah cara sebuah aturan noindex akhirnya dicabut seluruhnya, diam-diam.
Langkah 3: terapkan kontrolnya di tingkat templat
Perbaikan halaman per halaman tidak bertahan sampai deploy berikutnya. Terapkan kontrolnya di tempat rute dirender.
Untuk halaman HTML, taruh tag di head yang dirender server. Di App Router Next.js itu metadata; di Astro, head layout; di Rails atau Django, templat layout. Sintaks persisnya kurang penting dibanding tempatnya: harus ada di HTML yang diterima Google, bukan ditambahkan oleh efek di sisi klien.
<meta name="robots" content="noindex">Untuk semua yang bukan HTML, tidak ada tag meta, jadi pakai header:
X-Robots-Tag: noindexIni mencakup ekspor PDF, respons JSON, gambar hasil generasi, dan unduhan CSV. Kalau berkas itu disajikan CDN, setel header-nya di edge supaya rute baru mewarisi aturannya.
Untuk satu keluarga rute sekaligus, aturan middleware biasanya lebih rapi daripada menyentuh tiap templat:
// Contoh Express: noindex di semua URL berbagi hasil generasi
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Keluaran yang diharapkan. Satu deploy di mana setiap rute bertanda noindex mengirim direktifnya pada byte pertama, untuk permintaan anonim.
Pemeriksaan mutu. Jalankan curl -sI pada URL yang sudah tayang. Anda harus melihat x-robots-tag: noindex di header respons, dan curl -s harus menunjukkan tag meta di kode sumber, sebelum skrip apa pun berjalan.
Jalur pemulihan. Kalau tag baru muncul setelah JavaScript dijalankan, pindahkan ke rendering sisi server. Kalau framework tidak merender tag head per rute, pakai header. Jangan menayangkan noindex yang disuntikkan JS lalu menganggapnya bekerja: Google menyebut perilaku noindex yang dirender sebagai tidak jelas.
Ada dua hal lain yang masuk ke pull request yang sama. Keluarkan rute noindex dari sitemap, karena mengirim URL yang tidak ingin Anda indeks adalah kontradiksi yang Google selesaikan untuk kepentingannya sendiri. Dan tambahkan aturan kedaluwarsa: saat tautan berbagi mati, balas 410 alih-alih menyimpan halaman 200 dengan keadaan kosong.
Langkah 4: pastikan Googlebot bisa melihat direktifnya
Semua di atas belum terverifikasi sampai Anda memeriksanya dengan cara Google memeriksa.
Lihat dulu header respons:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagLalu HTML awalnya, sebelum skrip sempat berjalan:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Terakhir, pastikan robots.txt tidak memblokir jalurnya. Kalau diblokir, Google tidak akan pernah merayap halaman itu dan tidak akan pernah membaca direktifnya:
curl -s https://example.com/robots.txtSearch Console adalah pemeriksaan akhirnya. Minta inspeksi URL di Inspeksi URL dan baca putusannya.
Hasil yang benar adalah "Halaman tidak diindeks: Dikecualikan oleh tag 'noindex'". Hasil yang menunjukkan Anda jatuh ke perangkap adalah "Diindeks, meskipun diblokir oleh robots.txt" — Google punya URL-nya, tidak bisa membaca direktifnya, dan mungkin tetap menampilkannya. Kalau itu muncul, hapus aturan robots.txt dan biarkan noindex bekerja.
Anda juga bisa mengambil halaman sebagaimana dilihat Googlebot dengan simulator perayap, yang lebih cepat daripada menunggu perayapan baru ketika Anda memeriksa dua puluh rute: Googlebot Spider Simulator.
Keluaran yang diharapkan. Setiap rute noindex memperlihatkan status dikecualikan karena noindex beberapa hari setelah perayapan berikutnya. Rute yang dibuat setelah perubahan tidak boleh muncul di indeks sama sekali.
Jalur pemulihan. Kalau URL masih terindeks setelah dua minggu, periksa apakah Google bisa merayapnya, apakah halaman membalas 200 kepada Googlebot, dan apakah ada tag canonical atau hreflang yang mengarahkan mesin pencari ke tempat lain. Pakai alat Penghapusan hanya sebagai blokir sementara selama Anda memperbaiki penyebabnya; itu bukan pengganti direktif.
Ketika halaman berbagi justru kanal pertumbuhan
Sebagian halaman hasil generasi memang harus diindeks, dan noindex untuk semuanya justru menembak kaki sendiri. Ini yang layak dilindungi:
Pola | Kenapa layak masuk indeks | Pagar pengaman |
|---|---|---|
Galeri templat publik | Pengguna menerbitkan desain, orang lain memakainya lagi; keluarannya unik dan tahan lama | Moderasi kiriman baru |
Pembuat dengan halaman etalase publik | Hasil nyata dengan kredit "built with" adalah kanal distribusi | Jaga templat etalase terpisah dari halaman pemasaran |
Dokumentasi yang tumbuh dari utas pengguna | Pertanyaan berulang layak mendapat jawaban permanen yang disunting | Indeks jawaban terkurasi, bukan percakapan mentahnya |
Kalau Anda ada di salah satu kategori ini, panduan Google yang lebih lama masih berlaku dan justru tuas terbaiknya: noindex pada konten pengguna tanpa reputasi, lalu buka ketika akun punya riwayat. Itu memberi ketahanan terhadap spam tanpa meninggalkan lingkar akuisisi, dan itulah pola yang dianjurkan panduan sebelum pembaruan ini.
Ujinya sama untuk ketiganya. Kalau halaman mendapat tayangan di Performa Penelusuran untuk kueri yang akan diketik orang asing, ia berhak masuk indeks. Kalau tayangannya hanya datang dari string URL-nya sendiri dan tidak dari yang lain, tidak.
Ada efek orde kedua yang perlu disebut. URL berbagi publik selama bertahun-tahun menjadi permukaan tautan murah: buat satu halaman di platform berdomain kuat, arahkan tautan ke situs sendiri, ulangi di dua puluh properti. Patrick Stox menghitung lebih dari 20 tautan dari platform berbeda dalam satu utas. Kalau platform mengikuti panduan ini, permukaannya menyusut. Kalau tidak, Google sekarang punya dokumen untuk dikutip saat berikutnya memutuskan halaman-halaman itu spam.
Langkah 5: pasang instrumen untuk pola yang disebut Google
Bagian pemantauan adalah bagian pembaruan yang paling sering dilewati tim, padahal justru itu yang menangkap insiden nyata sebelum menjadi tindakan manual.
Empat pemeriksaan, masing-masing dengan tempat untuk dilihat.
Properti di Search Console. Verifikasi situs atau subdomain supaya peringatan tindakan manual dan keamanan masuk lewat email. Kalau Anda menjalankan platform dengan subdomain per penyewa, verifikasi induknya dan minimal satu sampel anaknya; peringatan yang tidak sampai ke mana-mana bukan pemantauan.
Tren pengindeksan halaman. Tetapkan baseline hari ini untuk URL terindeks per rute hasil generasi dan pantau perubahan berbentuk tangga, bukan derau. Dua kali lipat jumlah URL terindeks dalam seminggu pada rute yang seharusnya statis adalah sinyalnya.
Anomali Performa Penelusuran. Saring untuk kueri yang tidak berhubungan dengan produk. Halaman spam menarik kueri spam jauh sebelum ada yang mengeluh.
Rasio pembuatan terhadap pengindeksan. Ini metrik yang disebut Google dan hampir tidak diukur siapa pun: berapa banyak URL yang dapat diindeks bisa dihasilkan satu akun per hari, dan berapa porsi URL baru yang dapat diindeks berasal dari 1% akun teratas. Peringatan awal pada 3 kali median tujuh hari terakhir untuk satu akun memang sembarang, tapi berhasil; setel ulang dengan trafik Anda.
Rasio yang sama berguna sebagai pagar produk. Kalau sebuah fitur memungkinkan satu pengguna membuat seribu URL dapat diindeks per hari, itu fitur penggelembungan indeks, meski belum ada yang menyalahgunakannya.
Apa yang sebenarnya dikatakan pembaruan ini
Lepaskan kalimatnya, dan Google sedang berargumen soal pasokan.
Selama dua puluh tahun, kebijakan spam mendeskripsikan halaman: tipis, disedot, disamarkan, ditumpuk kata kunci. Kategori itu berasumsi ada manusia atau skrip yang memutuskan memproduksi halaman dan Google memutuskan apakah layak diperingkat. Keluaran hasil generasi mematahkan model itu. Satu keputusan produk bisa membuat sejuta URL, semuanya teknis unik, semuanya teknis 200, kebanyakan tanpa nilai bagi yang tidak membuatnya. Google tidak bisa menilainya satu per satu dan berhenti berpura-pura bisa.
Reaksinya terbelah dua kubu. Kubu pertama membacanya sebagai tembakan peringatan: Marie Haynes bertanya apakah akan ada tindakan manual baru untuk alat AI dan pembuat aplikasi, dan Lily Ray memperlakukan bagian itu sebagai tanda apa yang sudah Google lawan dalam skala besar, dengan menyebut artefak Claude, halaman berbagi ChatGPT, dan unggahan media sosial. Kubu kedua mengangkat bahu. Tim yang cermat sudah menaruh laporan hasil generasi pengguna di noindex bertahun-tahun, begitu argumen beberapa balasan, dan halaman hasil generasi Google sendiri adalah masalah yang lebih besar. Kedua bacaan bisa benar. Yang membuat panduan ini relevan bukan nasihatnya yang baru, tapi karena sekarang tertulis di tempat yang bisa dirujuk saat kebijakan ditegakkan.
Jadi panduan ini memindahkan keputusan ke hulu rantai. Platform diharapkan memutuskan, di tingkat templat, apakah satu kelas URL berhak masuk indeks. Itu soal tata kelola, bukan SEO, dan karena itulah nasihatnya ada di panduan spam, bukan di dokumentasi pengindeksan.
Untuk penelusuran AI, logika yang sama bekerja ke dua arah. Fitur AI Google menyedot dari indeks Google, jadi direktif noindex mencabut halaman dari kumpulan sekaligus dari tautan biru. Kalau halaman hasil generasi tadinya mulai mendapat kutipan di AI Overviews, siap-siap kutipan itu berhenti. Untuk tautan berbagi itu biasanya tepat, untuk halaman templat itu keliru. Perayap AI lain punya aturannya sendiri, jadi putuskan terpisah mana yang Anda izinkan merayap halaman tersebut.
Pelajaran praktisnya satu kalimat yang bisa dibawa ke reviu desain: setiap URL yang bisa dibuat pengguna adalah permukaan produk atau liabilitas indeks, dan templatnya yang menentukan yang mana.
Pertanyaan umum
Apakah ini berlaku untuk situs pemasaran biasa?
Tidak, kecuali situs Anda mencetak URL dari masukan pengguna. Situs pemasaran menerbitkan sekumpulan halaman yang diputuskan seseorang seharusnya ada, kebalikan dari masalah yang dijelaskan panduan. Baris cakupannya menyebut platform hosting dan alat yang memungkinkan pengguna menerbitkan halaman berbagi, konten hasil generasi, atau aplikasi web. Kalau Anda punya komentar, forum, atau profil anggota, panduan lama berlaku: nofollow atau ugc pada tautan dari akun tidak tepercaya dan noindex untuk pengguna baru sampai reputasinya terbangun.
Sebaiknya pakai robots.txt atau tag noindex?
noindex, dan hanya satu dari keduanya per rute. Kalimat Google menyebut dua opsi, tapi keduanya melakukan hal berbeda. Disallow di robots.txt memblokir perayapan, dan URL yang diblokir tapi ditautkan dari tempat lain bisa tetap muncul di hasil tanpa cuplikan. noindex hanya bekerja ketika Google bisa merayap halaman itu dan membacanya. Dalam praktik itu berarti tag meta atau header respons, dan tidak pernah aturan robots.txt pada jalur yang sama.
Apakah noindex pada halaman berbagi akan menghilangkan trafik?
Periksa rutenya sebelum memutuskan, bukan sesudahnya. Kalau halaman mendapat tayangan hanya dari string URL-nya sendiri, ia tidak mendatangkan trafik organik dan mencabutnya tidak merugikan. Pola yang kehilangan trafik adalah merobohkan galeri publik bersama keluaran di dalamnya. Biarkan galeri tetap dapat diindeks, taruh noindex pada yang ada di baliknya, dan pantau performa penelusuran untuk kueri galeri sebelum dan sesudahnya.
Apakah mesin pencari AI menghormati noindex?
Fitur AI Google menghormati, karena AI Overviews dan AI Mode menyedot dari indeks yang sama, jadi direktifnya mencabut halaman dari tautan biru sekaligus dari jawaban AI. Perayap AI lain adalah keputusan terpisah. Perilaku tiap vendor berbeda-beda dan berubah tanpa catatan perubahan, jadi baca dokumentasi masing-masing perayap dan ambil halamannya dengan user agent perayap itu, bukan menganggap satu direktif mencakup semuanya.
Penulis: Grace Miller, analis risiko AI Search di Auspia. Memantau lebih dari 200 perubahan kebijakan. Menulis tentang aturan platform, risiko konten, dan optimasi yang sadar kebijakan.