Pelacak visibilitas AI terdengar lugas. Ajukan beberapa pertanyaan kategori ke asisten, catat apakah merek Anda muncul, lalu gambar grafiknya sepanjang waktu.
Masalahnya ada di bagian hulu dari pencatatan. Hal yang Anda ukur tidak diam di tempat. Kirim prompt yang sama ke model yang sama dua kali dan Anda akan mendapat dua jawaban yang hanya tumpang tindih sebagian. Catat salah satunya dan Anda telah mencatat satu sampel dari sebuah distribusi, lalu menyajikannya sebagai fakta.
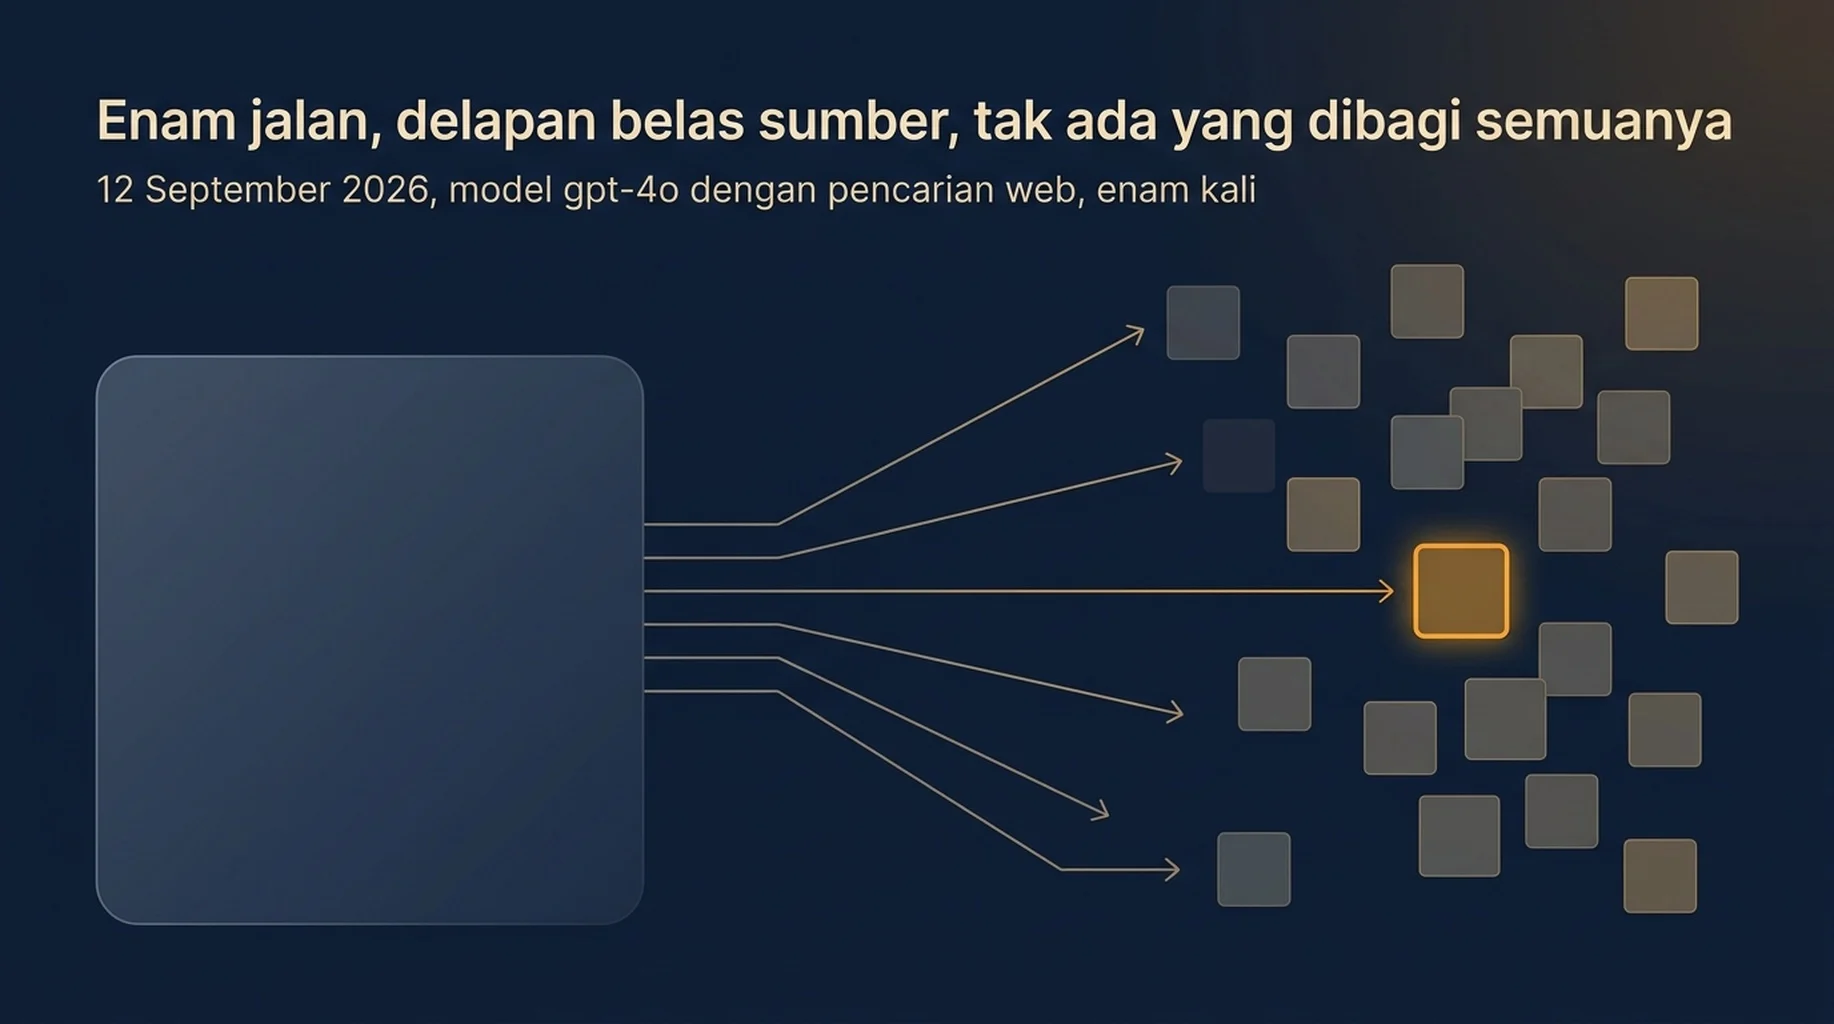
Kami ingin tahu seberapa besar sebaran itu sebenarnya, jadi kami menjalankan eksperimennya alih-alih mengasumsikannya. Versi singkatnya: enam permintaan identik menghasilkan delapan belas sumber yang dikutip, dan tidak ada satu sumber pun yang dikutip di keenamnya.
Artikel ini membahas apa yang kami jalankan, apa yang kembali, dan empat bidang yang harus disimpan pelacak visibilitas AI agar angkanya layak dilihat lagi bulan depan.
Apa yang kami jalankan
Dua eksperimen, keduanya memakai prompt yang benar-benar akan dipakai tim SaaS dalam riset kategori.
Eksperimen 1: satu prompt, satu model, enam kali jalan. Model gpt-4o, pencarian web aktif, Amerika Serikat, bahasa Inggris. Promptnya: "Apa alat pelacak peringkat terbaik untuk tim SaaS kecil pada 2026? Berikan daftar singkat beserta sumbernya." Enam panggilan langsung terpisah, dijalankan berurutan dalam jendela sesi yang sama.
Eksperimen 2: dua model, prompt yang sama, masing-masing tiga kali jalan. Prompt yang sama dikirim ke Claude Sonnet 5 dan Gemini 3.8 Flash, masing-masing tiga kali, tanpa pencarian web. Tanpa pencarian, yang kami ukur adalah produk mana yang disebut model dari pengetahuannya sendiri, dan itu sinyal yang berbeda dari sumber mana yang dikutipnya.
Kami juga mengirim prompt kedua lewat jalur pencarian web yang sama empat kali, untuk melihat apakah perilaku pengutipan konsisten antar jenis pertanyaan: "Bagaimana cara melacak AI Overviews untuk situs saya? Berikan metode konkret beserta sumbernya."
Enam kali jalan bukan sampel besar, dan kami memperlakukannya begitu. Itu cukup untuk menunjukkan arah dan kisaran kasar variasi, dan itulah intinya.
Hasil 1: delapan belas sumber, nol yang dibagi keenam jalan
Enam jalan pencarian web itu bersama-sama mengutip 18 URL berbeda. Berikut seberapa sering setiap domain muncul.
Jumlah kutipan (dari 6 jalan) | Domain |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Tidak ada domain yang dikutip di keenam jalan. Tidak ada URL yang dikutip di keenam jalan.
Angka yang penting di sini adalah tumpang tindih antar jalan. Saat membandingkan setiap pasangan jalan, rata-rata tumpang tindih Jaccard pada URL yang dikutip adalah 0,167. Di dua dari lima belas pasangan, tumpang tindihnya tepat nol, artinya dua jawaban itu tidak berbagi satu sumber pun.
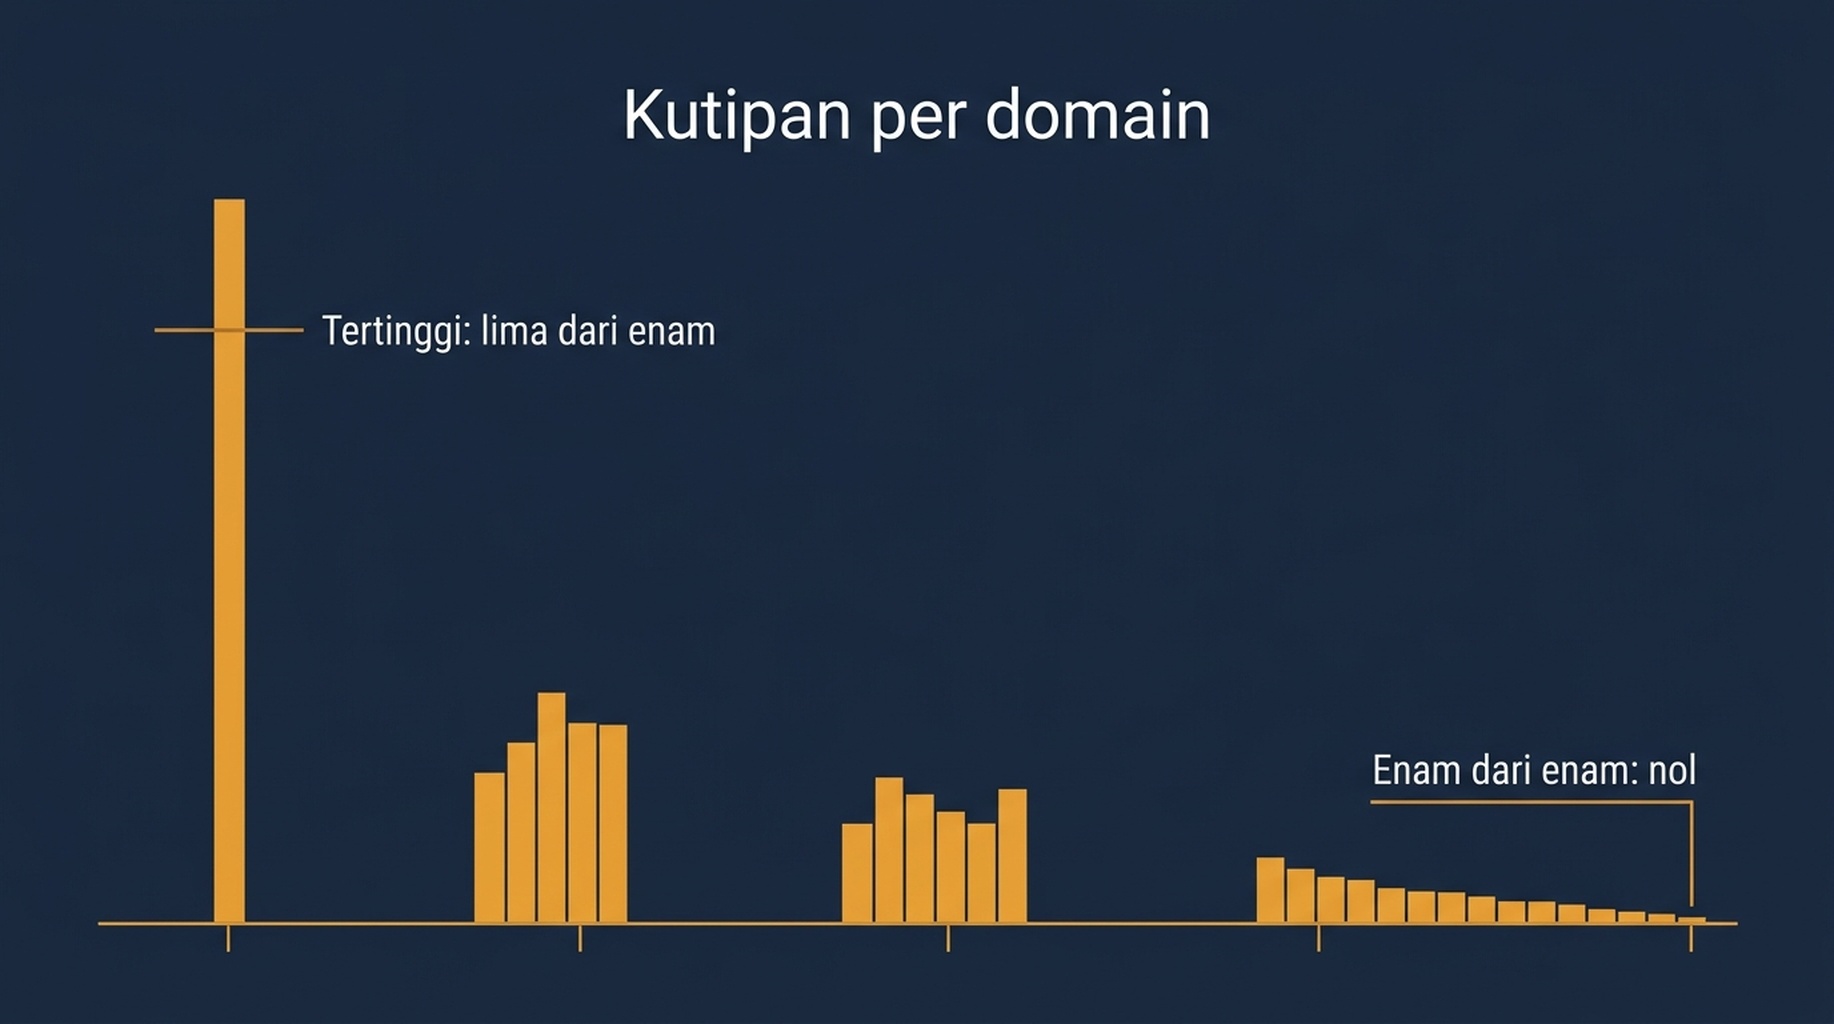
Sumber yang dikutip di lima dari enam jalan adalah plafon yang kami amati. Tidak ada yang dikutip setiap kali.
Ada temuan kedua yang terkubur di tabel itu. Domain yang dijangkau model sebagian besar bukan situs perbandingan ternama di kategori ini. Sembilan dari delapan belas domain muncul tepat satu kali, dan beberapa di antaranya situs kecil yang isinya terbaca seperti sesuatu yang dirakit untuk kueri itu, bukan seperti hasil peliputan. Bagi sebuah merek, ini pedang bermata dua. Artinya slot kutipan lebih mudah direbut daripada peringkat "alat terbaik" konvensional. Artinya juga slot itu sedang diisi oleh pihak yang membuat halaman yang cocok dengan bentuk kueri pada jalan itu, dan akan terisi ulang pada jalan berikutnya.
Hasil 2: jawabannya sendiri berubah ukuran
Kutipannya bergerak, dan panjang jawabannya ikut bergerak.
Jalan | Token keluaran | Panjang jawaban | Biaya per jalan |
|---|---|---|---|
1 | 505 | 2.153 karakter | $0,0735 |
2 | 860 | 3.728 karakter | $0,0770 |
3 | 1.108 | 4.746 karakter | $0,0797 |
4 | 832 | 3.555 karakter | $0,0765 |
5 | 870 | 3.547 karakter | $0,0772 |
6 | 813 | 3.544 karakter | $0,0768 |
Panjang keluaran berkisar dari 505 hingga 1.108 token, rentang 603 token, sekitar 73 persen dari rata-rata. Jawaban terpanjang lebih dari dua kali jawaban terpendek. Lima dari enam jalan masuk ke pita yang cukup sempit antara 813 dan 1.108 token; satu jalan berhenti lebih awal di 505 dan mengutip lima sumber alih-alih sembilan sampai empat belas.
Bagi pengukuran, ini penting secara spesifik. Jika pelacak Anda menangkap "apakah merek muncul di jawaban, dan di posisi berapa", jalan yang pendek punya lebih sedikit slot untuk muncul. Tim yang mengambil sampel sekali seminggu dan kebetulan mendapat jalan pendek akan mencatat hasil yang lebih buruk daripada tim yang mendapat jalan panjang, tanpa ada yang berubah di situs.
Hasil 3: sebagian prompt tidak mendapat kutipan sama sekali
Prompt kedua, tentang melacak AI Overviews, melewati jalur pencarian web yang sama empat kali dan kembali dengan nol kutipan di setiap jalan.
Jalan | Token keluaran | Panjang jawaban | Kutipan |
|---|---|---|---|
1 | 479 | 2.135 karakter | 0 |
2 | 522 | 2.240 karakter | 0 |
3 | 534 | 2.312 karakter | 0 |
4 | 497 | 2.228 karakter | 0 |
Jawabannya stabil panjangnya, hanya berubah 8 persen di empat jalan. Tapi model menjawab dari pengetahuannya sendiri dan tidak menyebut satu sumber pun, jadi tidak ada yang bisa dicatat di kolom kutipan.
Dari situ muncul pembacaan pelacak yang spesifik dan menyesatkan. Dasbor tingkat kutipan akan menampilkan nol untuk pertanyaan ini, dan itu terlihat seperti kegagalan visibilitas. Bukan. Ini bentuk pertanyaan yang tidak memicu pencarian sumber. Pembacaan yang benar adalah "kutipan tidak berlaku", dan pelacak yang tidak bisa membedakannya dari "kutipan diperiksa dan Anda absen" akan membuat Anda mengejar masalah yang tidak ada.
Hasil 4: mengganti model adalah pengukuran lain, bukan pengulangan
Dengan pencarian web dimatikan, kami mengukur produk mana yang disebut setiap model. Ini mengisolasi himpunan rekomendasi model itu sendiri dari apa pun yang dikembalikan indeks pencarian pada menit itu.
Claude Sonnet 5 menyebut empat sampai lima produk per jalan. Sepanjang tiga jalan, ia menyebut enam produk berbeda: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat, dan SerpWatcher. Tiga di antaranya muncul di ketiga jalan: AccuRanker, Ahrefs, dan SEMrush. Rata-rata tumpang tindih berpasangan 0,587.
Gemini 3.8 Flash menyebut dua sampai lima produk per jalan. Sepanjang tiga jalan, ia menyebut tujuh produk berbeda: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush, dan Wincher. Hanya satu di antaranya, SE Ranking, muncul di ketiga jalan. Rata-rata tumpang tindih berpasangan 0,306.
Antara kedua model, empat produk disebut keduanya dan lima produk disebut hanya salah satunya.
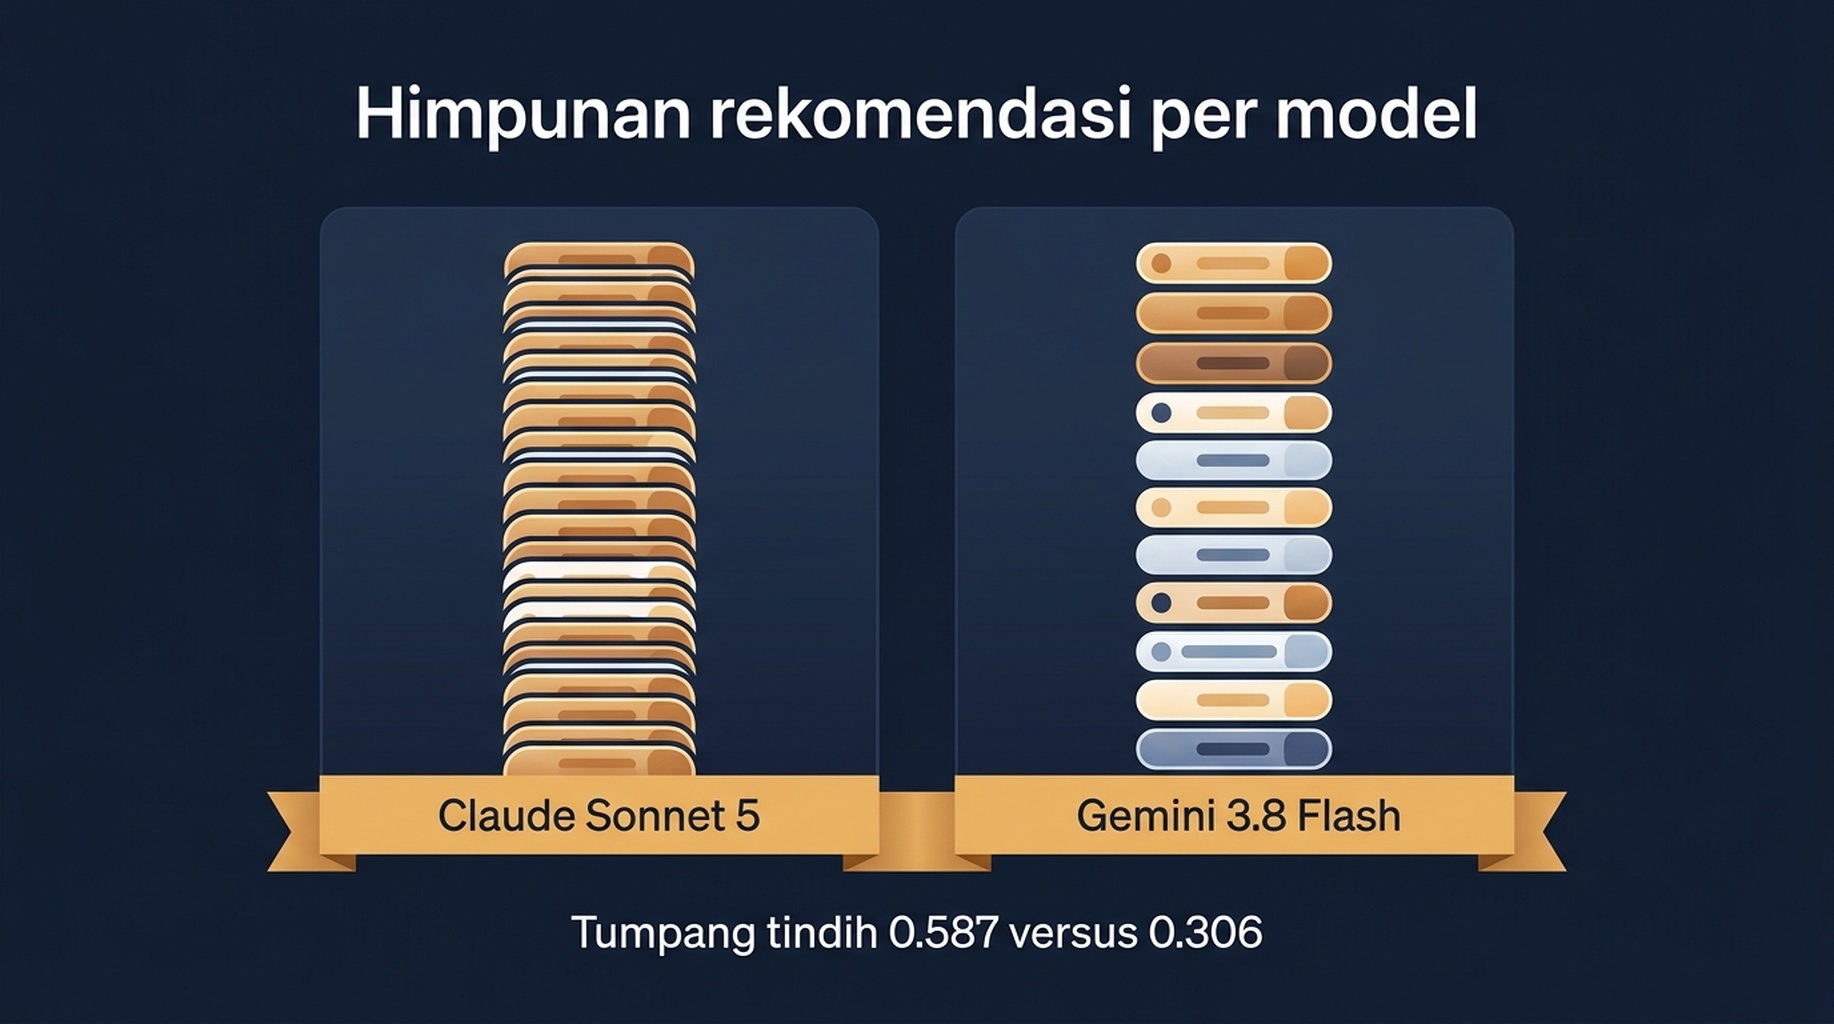
Pertanyaan yang sama menghasilkan himpunan rekomendasi yang berbeda sebagian di setiap model dan setiap jalan.
Konsekuensi praktisnya: jika Anda melacak "visibilitas AI" sebagai satu angka, Anda merata-ratakan setidaknya dua sumber variasi yang independen, yaitu jalan dan model. Merek yang muncul konsisten di satu asisten dan tidak muncul di asisten lain adalah temuan nyata yang bisa ditindaklanjuti. Merek yang pengukuran sampel tunggalnya bergeser dua posisi adalah derau.
Apa yang harus dicatat pelacak visibilitas AI
Empat bidang mengubah tangkapan layar menjadi sebuah pengukuran.
Jumlah jalan, bukan hasil satu jalan. Simpan setiap jalan dan laporkan rentangnya. "Dikutip di 4 dari 6 jalan" adalah fakta. "Dikutip, posisi 3" adalah kebetulan. Enam jalan adalah lantai yang wajar untuk program kecil; dua belas lebih baik jika prompt itu penting secara komersial.
Bidang kutipan terpisah dari bidang penyebutan. "Model merekomendasikan kami" dan "model menautkan ke kami" adalah dua hasil berbeda dengan penanganan berbeda. Enam jalan kami menghasilkan 18 kutipan dari 18 URL berbeda; pelacak yang hanya mencatat penyebutan merek tidak akan menangkap apa pun dari gejolak itu.
Status kanal jawaban. Catat apakah jalan itu memakai pencarian web, dan catat panjang jawabannya. Jalan dengan nol kutipan dan jalan dengan nol penyebutan terlihat identik di dasbor dan bermakna kebalikannya.
Teks prompt kata per kata, dengan nomor versi. Susunan kata prompt menentukan sumber mana yang ditarik masuk. Jika prompt berubah antar bulan, garis trennya putus. Beri versi pada prompt seperti Anda memberi versi pada skrip pelacak.
Membangun lingkar jalan
Pemeriksaan manual tidak bertahan menghadapi satu pertemuan dengan kalender. Lingkarnya adalah skrip yang menjalankan prompt N kali, menyimpan setiap respons mentah beserta kutipannya, lalu membandingkan jendela saat ini dengan jendela sebelumnya.
Ini cocok untuk agen karena pekerjaannya berulang, terikat aturan, dan butuh catatan tertulis. Di Claude Code atau Codex, instruksi yang berguna adalah biarkan jalan mentah tetap di disk dan jangan pernah menimpanya, lalu laporkan tabel ringkasan alih-alih satu angka. Jika Anda sudah menarik data Search Console dan Bing lewat server MCP, sesi yang sama bisa menyimpan catatan kutipan di samping data tayangan, dan di situlah kedua angka mulai berguna bersama. Catatan kami tentang apa yang diungkap server-server itu ada di apa yang sebenarnya dilakukan empat server SEO MCP, dan sisi keberadaan dari masalah yang sama ada di snapshot AI Overview empat puluh kueri kami.
Satu aturan desain lebih penting dari yang lain: keluaran pelacak harus berupa distribusi. Laporkan "dikutip di 4 dari 6", bukan "dikutip". Laporkan daftar sumbernya, bukan sumber nomor satu. Dasbor apa pun yang memadatkan enam jalan menjadi satu angka sudah membuang satu-satunya informasi yang dibeli oleh jalan tambahan itu.
Jika tujuannya membandingkan pesaing dan bukan memantau, lingkar pelacakan peringkat sepanjang waktu adalah alat yang lebih pas, dan pertukaran antar sumber data ada di membangun pelacak peringkat dari dua sumber.
Batas sampel enam jalan
Tiga catatan jujur.
Sampelnya kecil. Enam jalan hanya membingkai sebarannya secara longgar. Itu menetapkan bahwa tumpang tindih antar jalan bersifat sebagian dan bahwa pasangan tanpa tumpang tindih memang terjadi; itu tidak memberi Anda selang kepercayaan untuk kategori Anda.
Hasilnya terikat waktu. Jalan-jalan ini dijalankan pada 12 September 2026 terhadap model yang aktif saat itu. Modelnya maupun hasil pencarian di bawahnya sama-sama berubah.
Domain yang dikutip adalah sampel dari satu prompt komersial. Bentuk pertanyaan yang berbeda, seperti pertanyaan perbandingan atau pertanyaan cara, akan menghasilkan pola kutipan yang berbeda. Langkah yang berguna adalah menjalankan desain yang sama pada sepuluh prompt Anda yang paling penting secara komersial dan mencatat bagaimana kategori Anda berperilaku.
Pertanyaan umum
Berapa kali jalan yang saya butuhkan sebelum angka visibilitas AI bermakna? Enam adalah lantai praktis untuk satu prompt, dan angkanya harus dilaporkan sebagai hitungan dari jumlah jalan, bukan sebagai posisi. Jika prompt itu mengarahkan keputusan pendapatan, dua belas jalan memberi bacaan yang lebih rapat dengan biaya beberapa dolar.
Apakah ini berarti melacak visibilitas AI tidak layak dilakukan? Artinya melacak dengan sampel tunggal tidak layak. Variasinya itulah temuannya. Pelacak yang melaporkan "dikutip di 4 dari 6 jalan, sumbernya bergeser 12 domain sejak bulan lalu" sedang menggambarkan sistem nyata yang diperebutkan pesaing.
Mengapa satu prompt kembali dengan nol kutipan? Model menjawab dari pengetahuannya sendiri alih-alih mencari sumber. Itu sifat pertanyaannya, bukan kegagalan situs Anda. Lacak sebagai tidak berlaku, bukan sebagai nol.
Haruskah saya melacak ChatGPT, Claude, dan Gemini secara terpisah? Ya. Dalam perbandingan tiga jalan kami, kedua model hanya tumpang tindih pada empat dari sembilan produk yang disebut. Perataan akan menyembunyikan keputusan tingkat program tentang asisten mana yang dioptimalkan lebih dulu.
Bisakah variasi dikurangi dengan menurunkan suhu model? Sebagian bisa, dan layak diuji pada prompt Anda. Tapi himpunan kutipan juga digerakkan indeks pencarian, dan itu di luar kendali Anda. Jumlah jalan adalah tuas yang lebih andal.
Pandangan Auspia: jika Anda membangun pelacakan visibilitas AI kuartal ini, bangun catatan jalan sebelum dasbor. Dasbor adalah pilihan tampilan. Catatan jalan adalah pengukurannya. Mulailah dengan sepuluh prompt, masing-masing enam jalan, disimpan kata per kata, dan dalam satu minggu Anda akan belajar lebih banyak daripada yang bisa diberitahu oleh pemeriksaan sampel tunggal selama setahun.
Penulis: Ethan Marlowe, memimpin pengukuran GEO atas lebih dari 500 prompt di Auspia. Menulis tentang pelacakan prompt, laporan kutipan, dan dasbor visibilitas yang bertahan menghadapi siklus pengukuran nyata.