Un rastreador de visibilidad en IA suena directo. Haces unas cuantas preguntas de categoría a un asistente, anotas si tu marca apareció y lo dibujas en un gráfico a lo largo del tiempo.
El problema está aguas arriba del registro. Lo que mides no se queda quieto. Envía el mismo prompt al mismo modelo dos veces y obtendrás dos respuestas que se solapan solo en parte. Registra una de ellas y habrás registrado una muestra de una distribución, para luego presentarla como un hecho.
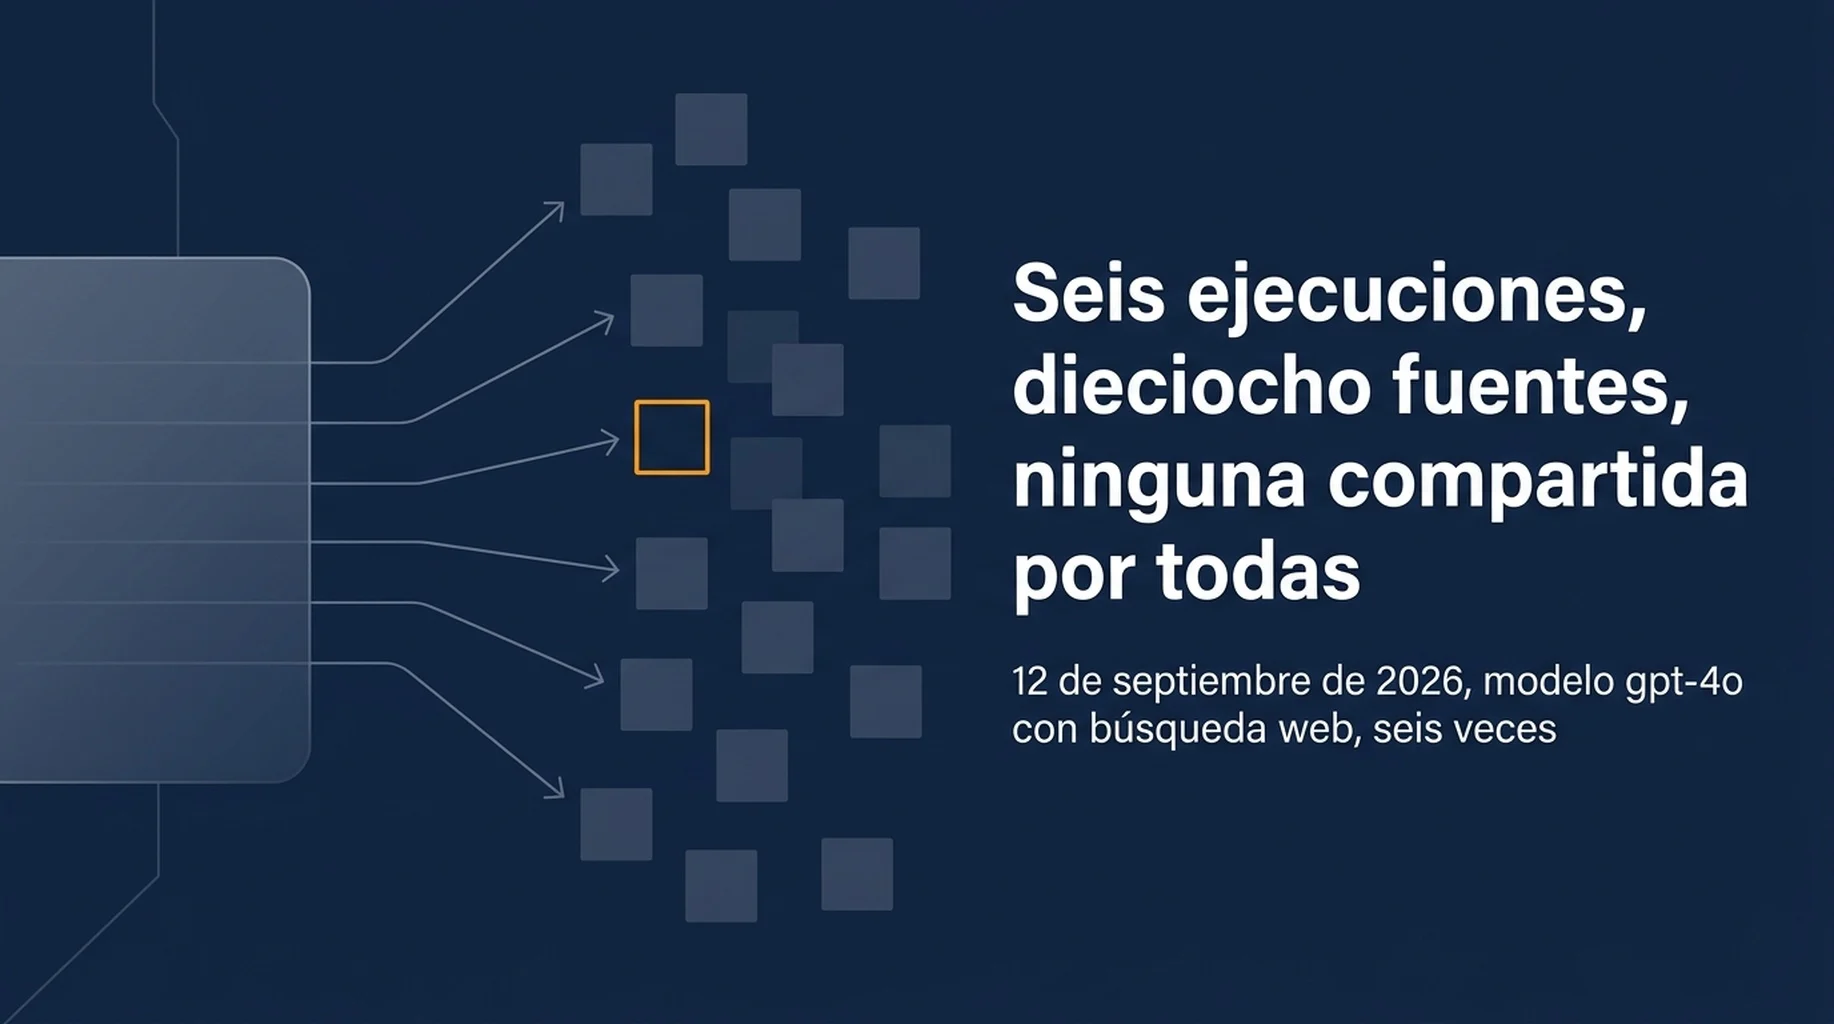
Queríamos saber cuán grande es realmente esa dispersión, así que hicimos el experimento en lugar de suponerlo. La versión corta: seis solicitudes idénticas devolvieron dieciocho fuentes citadas, y ninguna fuente fue citada en las seis.
Este artículo trata de lo que ejecutamos, de lo que volvió y de los cuatro campos que un rastreador de visibilidad en IA tiene que almacenar para que el número merezca una segunda mirada el mes que viene.
Qué ejecutamos
Dos experimentos, ambos con prompts que un equipo de SaaS usaría de verdad en una investigación de categoría.
Experimento 1: un prompt, un modelo, seis ejecuciones. El modelo gpt-4o, búsqueda web activada, Estados Unidos, inglés. El prompt: "¿Cuáles son las mejores herramientas de seguimiento de posiciones para un equipo de SaaS pequeño en 2026? Da una lista corta con fuentes". Seis llamadas en vivo separadas, ejecutadas en secuencia dentro de la misma ventana de sesión.
Experimento 2: dos modelos, el mismo prompt, tres ejecuciones cada uno. El mismo prompt se envió a Claude Sonnet 5 y a Gemini 3.8 Flash, tres veces cada uno, sin búsqueda web. Sin búsqueda medimos qué productos nombra el modelo de memoria propia, que es una señal distinta de qué fuentes cita.
También enviamos un segundo prompt por la misma ruta de búsqueda web cuatro veces, para ver si el comportamiento de cita es consistente entre tipos de pregunta: "¿Cómo hago seguimiento de los AI Overviews de mi sitio? Da métodos concretos con fuentes".
Seis ejecuciones no son una muestra grande, y las tratamos como tal. Bastan para mostrar la dirección y el orden de magnitud aproximado de la variación, y de eso se trata.
Resultado 1: dieciocho fuentes, cero compartidas por las seis ejecuciones
Las seis ejecuciones de búsqueda web citaron, en conjunto, 18 URL distintas. Aquí está la frecuencia con la que apareció cada dominio.
Número de citas (de 6 ejecuciones) | Dominios |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Ningún dominio fue citado en las seis ejecuciones. Ninguna URL fue citada en las seis ejecuciones.
El número que importa aquí es el solapamiento entre ejecuciones. Comparando cada par de ejecuciones, el solapamiento de Jaccard medio sobre las URL citadas fue de 0,167. En dos de los quince pares el solapamiento fue exactamente cero, es decir, esas dos respuestas no compartieron ninguna fuente.
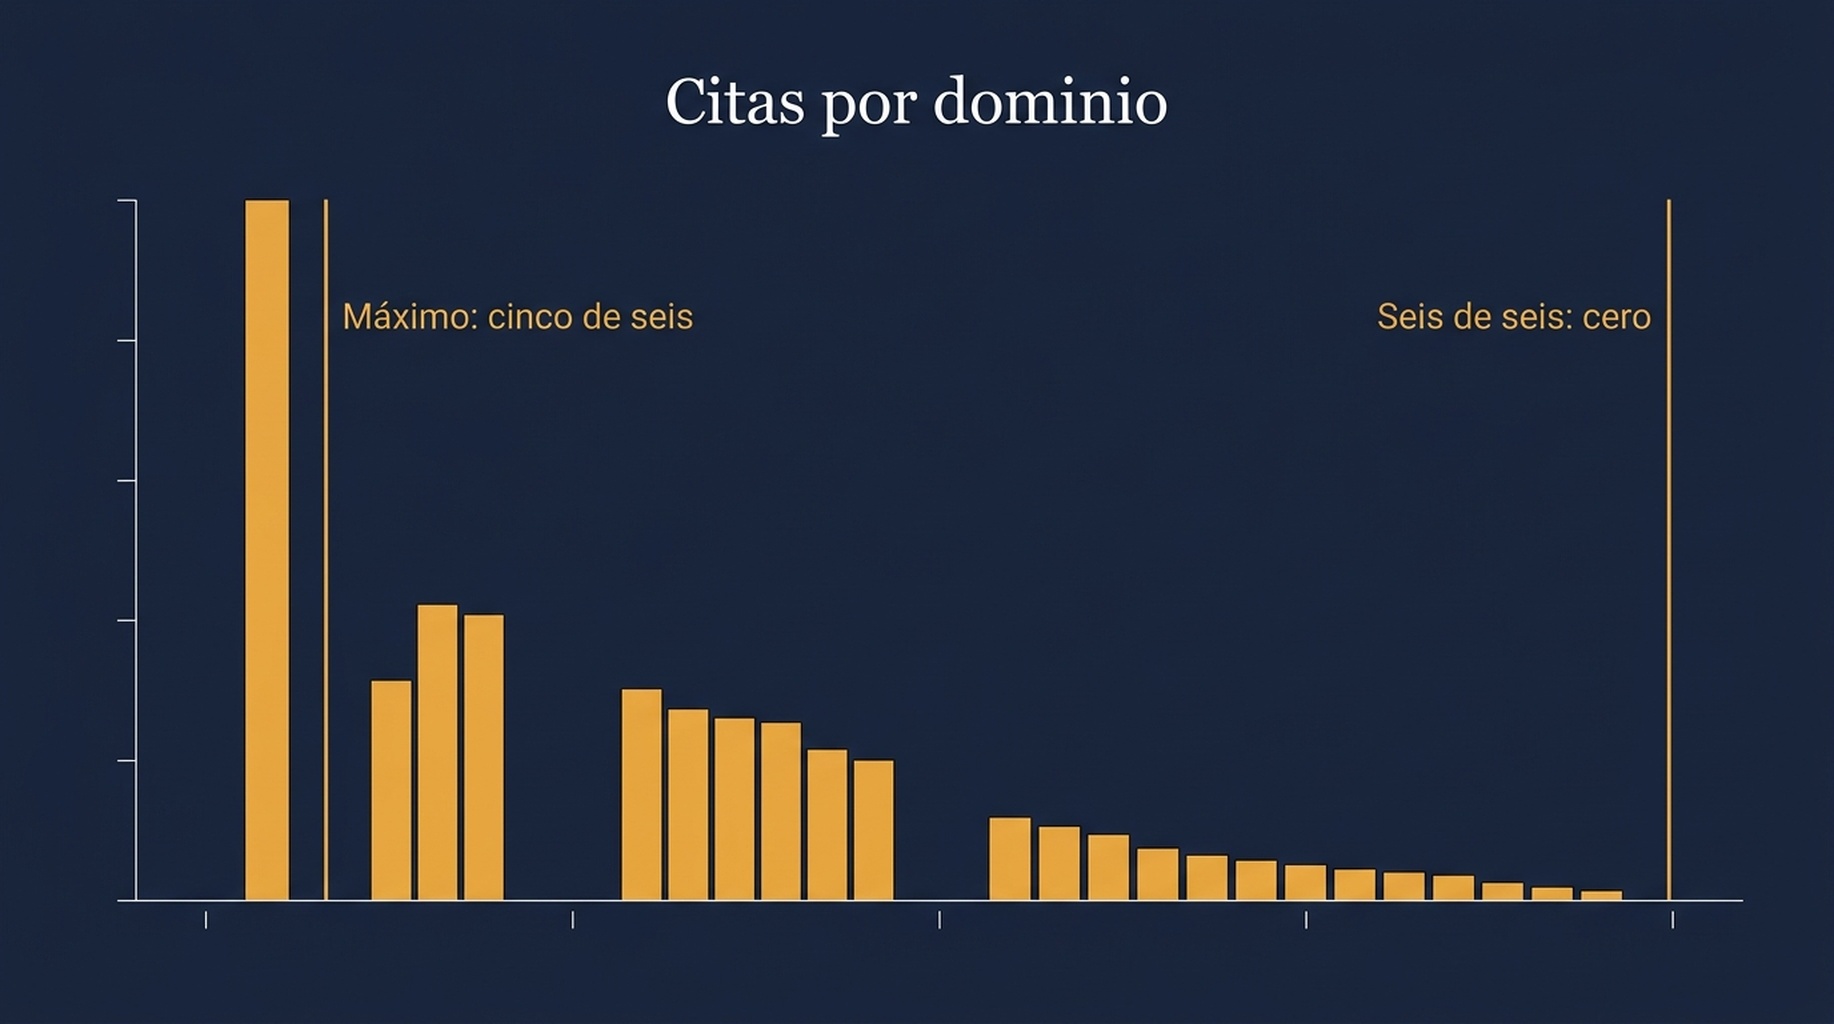
Una fuente citada en cinco de las seis ejecuciones es el techo que observamos. Nada se citó todas las veces.
Hay un segundo hallazgo enterrado en esa tabla. Los dominios a los que el modelo estiró la mano, en su mayoría, no son los sitios de comparación conocidos de la categoría. Nueve de los dieciocho dominios aparecieron exactamente una vez, y algunos son sitios pequeños cuyo contenido se lee como algo armado para esa consulta y no como el resultado de una investigación. Para una marca, esto es un arma de doble filo. Significa que la casilla de cita es más fácil de ganar que un ranking tradicional de "mejores herramientas". También significa que la casilla la ocupa quien produjo una página que encajó con la forma de la consulta en esa ejecución, y que volverá a llenarse en la siguiente.
Resultado 2: la propia respuesta cambia de tamaño
Las citas se movieron, y la longitud de la respuesta se movió con ellas.
Ejecución | Tokens de salida | Longitud de la respuesta | Coste de la ejecución |
|---|---|---|---|
1 | 505 | 2.153 caracteres | $0,0735 |
2 | 860 | 3.728 caracteres | $0,0770 |
3 | 1.108 | 4.746 caracteres | $0,0797 |
4 | 832 | 3.555 caracteres | $0,0765 |
5 | 870 | 3.547 caracteres | $0,0772 |
6 | 813 | 3.544 caracteres | $0,0768 |
La longitud de salida fue de 505 a 1.108 tokens, una amplitud de 603 tokens, cerca del 73 por ciento de la media. La respuesta más larga superó el doble de la más corta. Cinco de las seis ejecuciones cayeron en una franja bastante estrecha, entre 813 y 1.108 tokens; una ejecución se detuvo antes, en 505, y citó cinco fuentes en lugar de nueve a catorce.
Para la medición esto importa de una forma concreta. Si tu rastreador captura "¿aparece la marca en la respuesta y en qué posición?", una ejecución corta tiene menos casillas donde aparecer. Un equipo que muestrea una vez por semana y por casualidad sacó una ejecución corta registrará un resultado peor que el de un equipo que sacó una ejecución larga, sin que nada haya cambiado en el sitio.
Resultado 3: algunos prompts no reciben ninguna cita
El segundo prompt, sobre hacer seguimiento de los AI Overviews, pasó por la misma ruta de búsqueda web cuatro veces y volvió con cero citas en todas ellas.
Ejecución | Tokens de salida | Longitud de la respuesta | Citas |
|---|---|---|---|
1 | 479 | 2.135 caracteres | 0 |
2 | 522 | 2.240 caracteres | 0 |
3 | 534 | 2.312 caracteres | 0 |
4 | 497 | 2.228 caracteres | 0 |
Las respuestas fueron estables en longitud, con una variación de solo el 8 por ciento a lo largo de las cuatro ejecuciones. Pero el modelo respondió de memoria propia y no nombró ninguna fuente, así que no había nada que registrar en la columna de citas.
De ahí sale una lectura concreta y engañosa del rastreador. Un panel de tasa de citas mostrará cero para esta pregunta, y eso parece un fallo de visibilidad. No lo es. Es una forma de pregunta que no dispara la búsqueda de fuentes. La lectura correcta es "cita no aplicable", y un rastreador que no distingue eso de "se comprobó la cita y estabas ausente" te va a mandar a perseguir un problema que no existe.
Resultado 4: cambiar de modelo es otra medición, no una repetición
Con la búsqueda web desactivada medimos qué productos nombra cada modelo. Esto aísla el conjunto de recomendaciones del propio modelo de todo lo que devolvió el índice de búsqueda en ese minuto.
Claude Sonnet 5 nombró de cuatro a cinco productos por ejecución. A lo largo de tres ejecuciones nombró seis productos distintos: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat y SerpWatcher. Tres de ellos aparecieron en las tres ejecuciones: AccuRanker, Ahrefs y SEMrush. Solapamiento medio por pares de 0,587.
Gemini 3.8 Flash nombró de dos a cinco productos por ejecución. A lo largo de tres ejecuciones nombró siete productos distintos: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush y Wincher. Solo uno de ellos, SE Ranking, apareció en las tres ejecuciones. Solapamiento medio por pares de 0,306.
Entre los dos modelos, cuatro productos fueron nombrados por ambos y cinco fueron nombrados por uno solo.
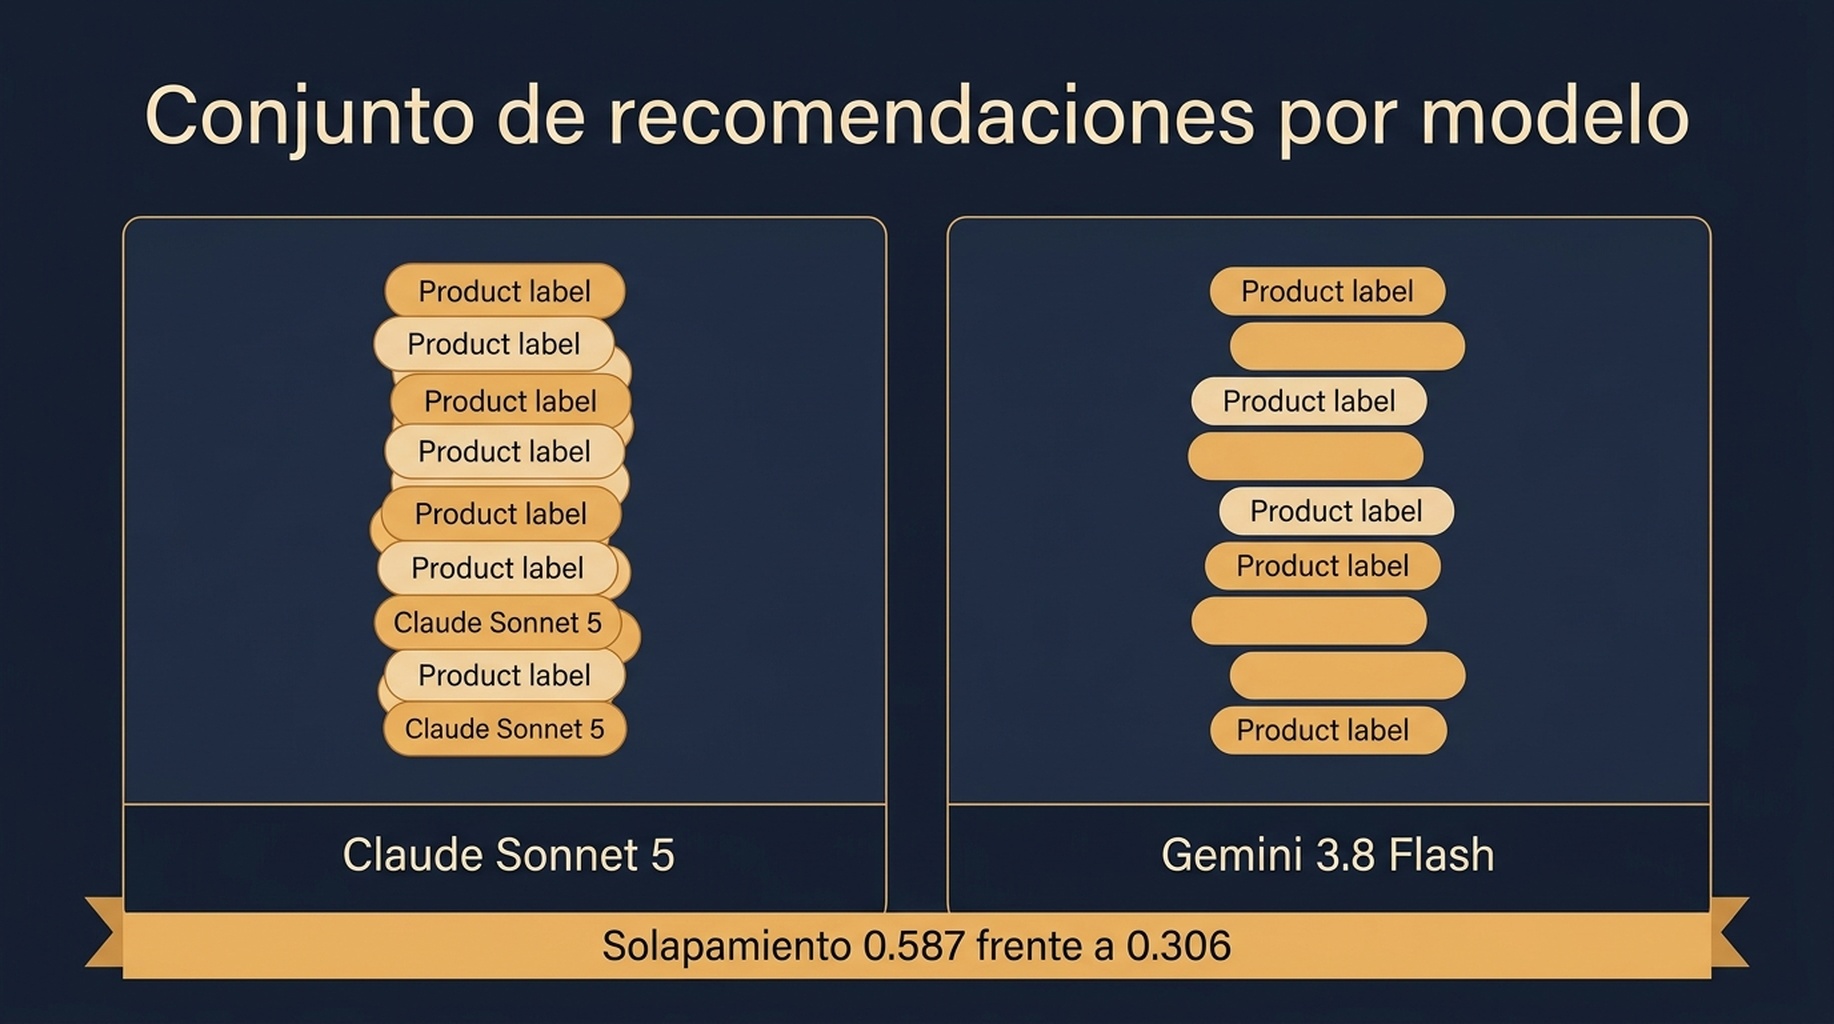
La misma pregunta produce un conjunto de recomendaciones parcialmente distinto en cada modelo y en cada ejecución.
La consecuencia práctica: si rastreas la "visibilidad en IA" como un número único, estás promediando al menos dos fuentes independientes de variación, la ejecución y el modelo. Una marca que aparece de forma consistente en un asistente y no aparece en otro es un hallazgo real y accionable. Una marca cuya medición de muestra única se movió dos posiciones es ruido.
Qué debería registrar un rastreador de visibilidad en IA
Cuatro campos convierten una captura de pantalla en una medición.
El número de ejecuciones, no el resultado de la ejecución. Almacena cada ejecución e informa el rango. "Citado en 4 de 6 ejecuciones" es un hecho. "Citado, posición 3" es una coincidencia. Seis ejecuciones es un suelo razonable para un programa pequeño; doce es mejor si el prompt importa comercialmente.
El campo de cita separado del campo de mención. "El modelo nos recomendó" y "el modelo enlazó a nosotros" son resultados distintos, con arreglos distintos. Nuestras seis ejecuciones produjeron 18 citas de 18 URL distintas; un rastreador que solo registra menciones de marca no habría capturado nada de ese vaivén.
El estado del canal de respuesta. Registra si la ejecución usó búsqueda web y registra la longitud de la respuesta. Una ejecución con cero citas y una ejecución con cero menciones se ven idénticas en el panel y significan lo contrario.
El texto del prompt, palabra por palabra, con número de versión. La redacción del prompt determina qué fuentes se arrastran. Si el prompt cambia entre meses, la línea de tendencia se rompe. Versiona el prompt igual que versionas un script de seguimiento.
Construir el bucle de ejecución
La comprobación manual no sobrevive a un encuentro con el calendario. El bucle es un script que ejecuta un prompt N veces, almacena cada respuesta cruda con sus citas y compara la ventana actual con la anterior.
Esto le sienta bien a un agente, porque el trabajo es repetitivo, está limitado por reglas y necesita un registro escrito. En Claude Code o Codex, la instrucción útil es dejar las ejecuciones crudas en el disco y no sobrescribirlas nunca, y luego informar una tabla resumen en lugar de un número único. Si ya extraes datos de Search Console y de Bing mediante servidores MCP, la misma sesión puede mantener el registro de citas junto a los datos de impresiones, y ahí es donde los dos números empiezan a ser útiles juntos. Nuestras notas sobre lo que exponen esos servidores están en qué hacen realmente cuatro servidores de SEO MCP, y el lado de la presencia del mismo problema está en nuestra instantánea de AI Overview con cuarenta consultas.
Una regla de diseño importa más que las demás: la salida del rastreador debería ser una distribución. Informa "citado en 4 de 6", no "citado". Informa la lista de fuentes, no la fuente número uno. Cualquier panel que comprima seis ejecuciones en un número ha tirado la única información que compraron las ejecuciones extra.
Si el objetivo es la comparación con competidores y no el monitoreo, un bucle de seguimiento de posiciones en el tiempo es la herramienta más adecuada, y los trade-offs entre fuentes de datos están en construir un rastreador de posiciones con dos fuentes.
Límites de una muestra de seis ejecuciones
Tres salvedades honestas.
La muestra es pequeña. Seis ejecuciones delimitan la dispersión de forma holgada. Establecen que el solapamiento entre ejecuciones es parcial y que los pares con solapamiento cero ocurren; no te dan un intervalo de confianza para tu categoría.
Los resultados están atados al tiempo. Estas ejecuciones se hicieron el 12 de septiembre de 2026 contra modelos en vivo. Tanto los modelos como los resultados de búsqueda por debajo cambian.
Los dominios citados son una muestra de un único prompt comercial. Una forma de pregunta distinta, como una pregunta de comparación o una de "cómo hacer", producirá un patrón de cita distinto. El movimiento útil es ejecutar el mismo diseño sobre tus diez prompts comercialmente más importantes y registrar cómo se comporta tu categoría.
Preguntas frecuentes
¿Cuántas ejecuciones necesito antes de que el número de visibilidad en IA signifique algo? Seis es el suelo práctico para un solo prompt, y el número debería informarse como un recuento de ejecuciones y no como una posición. Si el prompt guía decisiones de ingresos, doce ejecuciones dan una lectura más estrecha por unos pocos dólares.
¿Eso significa que rastrear visibilidad en IA no vale la pena? Significa que rastrear con muestra única no vale. La variación es el hallazgo. Un rastreador que informa "citado en 4 de 6 ejecuciones, las fuentes cambiaron en 12 dominios desde el mes pasado" está describiendo un sistema real en el que un competidor está disputando espacio.
¿Por qué un prompt devolvió cero citas? El modelo respondió de memoria propia en lugar de buscar fuentes. Eso es una propiedad de la pregunta, no un fallo de tu sitio. Rastréalo como no aplicable, no como cero.
¿Debería rastrear ChatGPT, Claude y Gemini por separado? Sí. En nuestra comparación de tres ejecuciones, los dos modelos coincidieron en solo cuatro de los nueve productos nombrados. Promediar esconde una decisión de nivel de programa sobre qué asistente optimizar primero.
¿Se puede reducir la variación bajando la temperatura del modelo? En parte, y vale la pena probarlo con tus prompts. Pero el conjunto de citas también lo mueve el índice de búsqueda, y ese no lo controlas. El número de ejecuciones es la palanca más fiable.
Visión de Auspia: si vas a construir seguimiento de visibilidad en IA este trimestre, construye el registro de ejecuciones antes que el panel. El panel es una elección de presentación. El registro de ejecuciones es la medición. Empieza con diez prompts, seis ejecuciones cada uno, almacenados palabra por palabra, y aprenderás en una semana más de lo que te diría un año entero de comprobación con muestra única.
Autoría: Ethan Marlowe, liderazgo de medición de GEO en más de 500 prompts en Auspia. Escribe sobre seguimiento de prompts, informes de citas y paneles de visibilidad que sobreviven al contacto con un ciclo real de medición.