AI 可见性追踪器听起来很直接。向助手提几个品类问题,记录你的品牌是否出现,再按时间画成图表。
问题出在记录的上游。你要测的东西根本不会静止。把同一个提示词发给同一个模型两次,你会得到两个只部分重叠的答案。记录其中之一,你就等于把从某个分布中抽出的一个样本当成了事实。
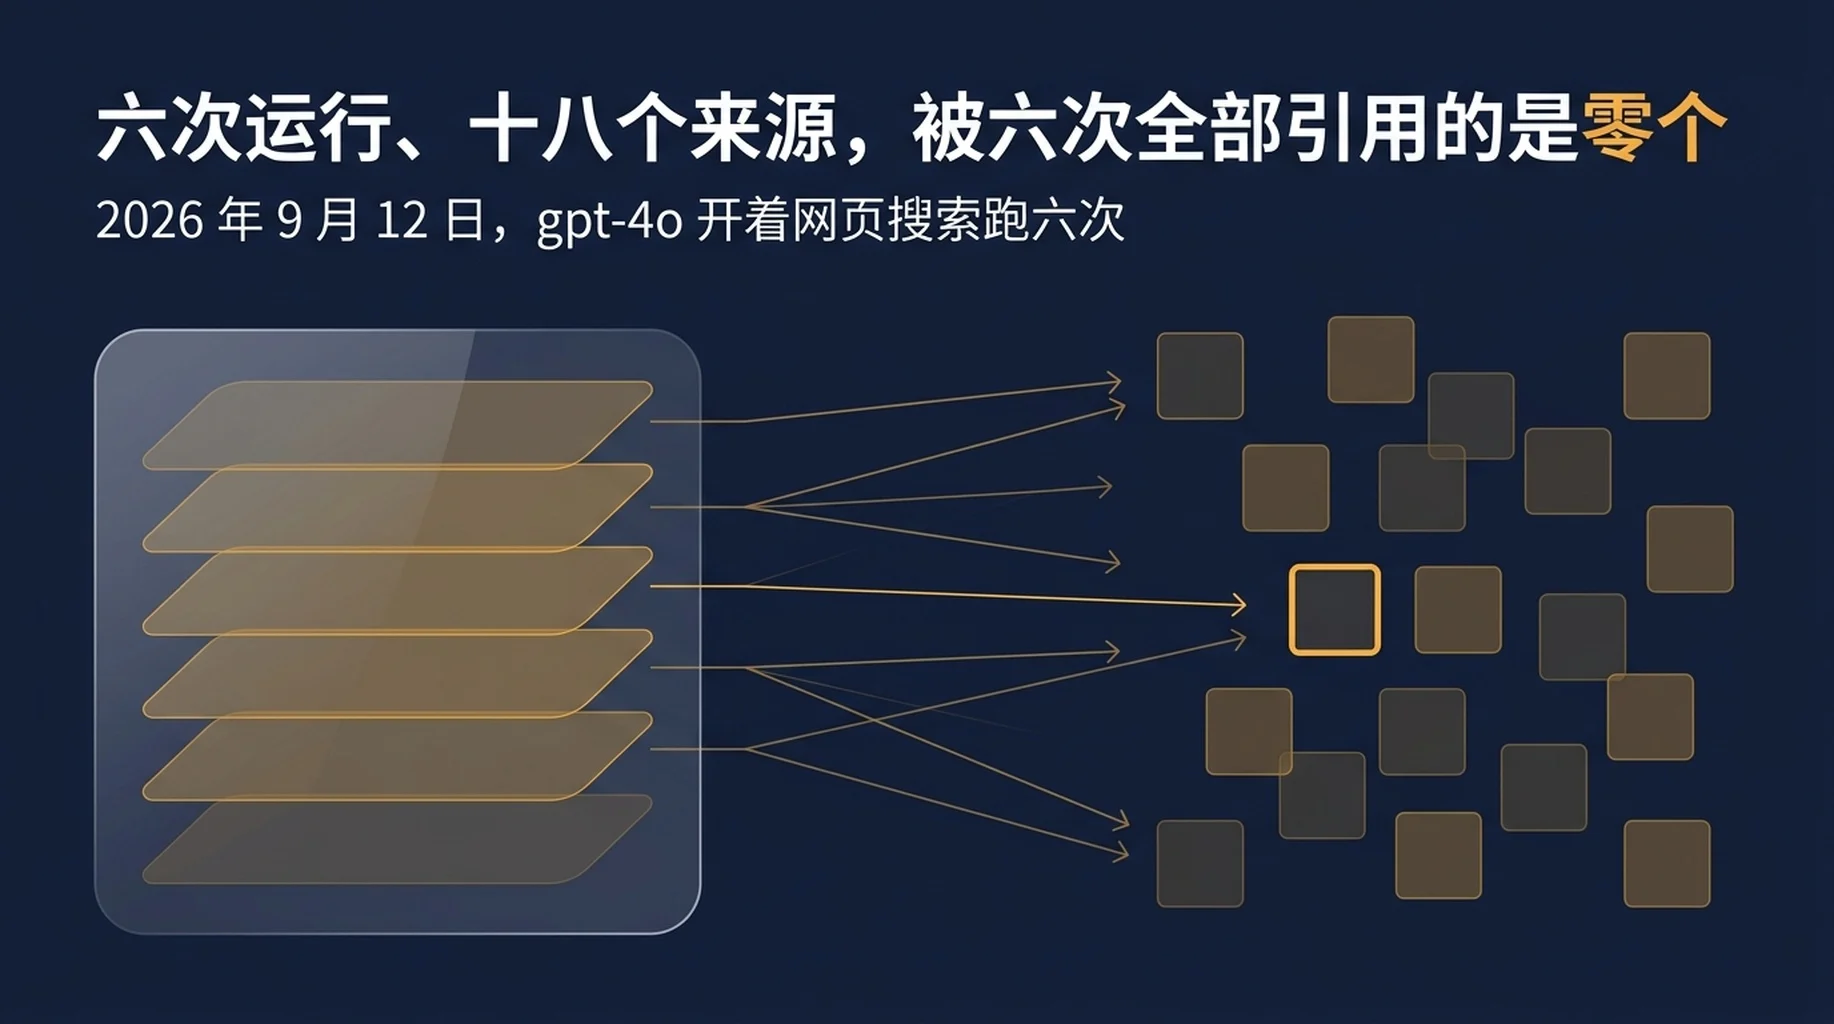
我们想知道这个离散度到底有多大,所以没有假设,而是直接做了实验。简短版本:六次完全相同的请求产生了十八个被引用的来源,而没有任何一个来源被六次全部引用。
本文讲我们跑了什么、返回了什么,以及一个 AI 可见性追踪器必须存储哪四个字段,这个数字下个月才值得再看一眼。
我们跑了什么
两个实验,用的都是 SaaS 团队在做品类调研时真的会用的提示词。
实验 1:一个提示词、一个模型、六次运行。 模型 gpt-4o,开启网页搜索,美国,英语。提示词:"2026 年最适合小型 SaaS 团队的排名追踪工具有哪些?请给出简短清单并附来源。" 六次独立的实时调用,在同一会话窗口内连续执行。
实验 2:两个模型、同一提示词、各三次。 同一个提示词分别发给 Claude Sonnet 5 和 Gemini 3.8 Flash,各三次,不开网页搜索。不开搜索时,我们测的是模型凭自身知识说出了哪些产品,这与它引用了哪些来源是两回事。
我们还把第二个提示词走网页搜索路径发了四次,看看引用行为在不同问题类型之间是否一致:"我该如何为自己的网站追踪 AI Overview?请给出带来源的具体方法。"
六次不是大样本,我们也按这个前提处理。它足以显示方差的方向和大致量级,而这正是重点。
结果 1:十八个来源,六次运行共享的为零
六次网页搜索运行合计引用了 18 个不同的 URL。以下是每个域名的出现次数。
被引次数(6 次运行中) | 域名 |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital、techradar.com |
2 | thesharpdigital.com、piperocket.digital、digiinte.com、tajo.io、gtm.help、softwaresift.com |
1 | impressivemagazine.com、theguidex.com、gtmonly.com、honeyb.ai、seo.com、blog.contentforce.ai、crowdreply.io、seomonster.ai、rankpy.com |
没有任何一个域名被六次运行全部引用。也没有任何一个 URL 被六次运行全部引用。
真正重要的是运行之间的重叠度。比较每一对运行,被引 URL 的平均 Jaccard 重叠度为 0.167。十五对中有两对的重叠度恰好为零,也就是说那两个答案完全没有共享来源。
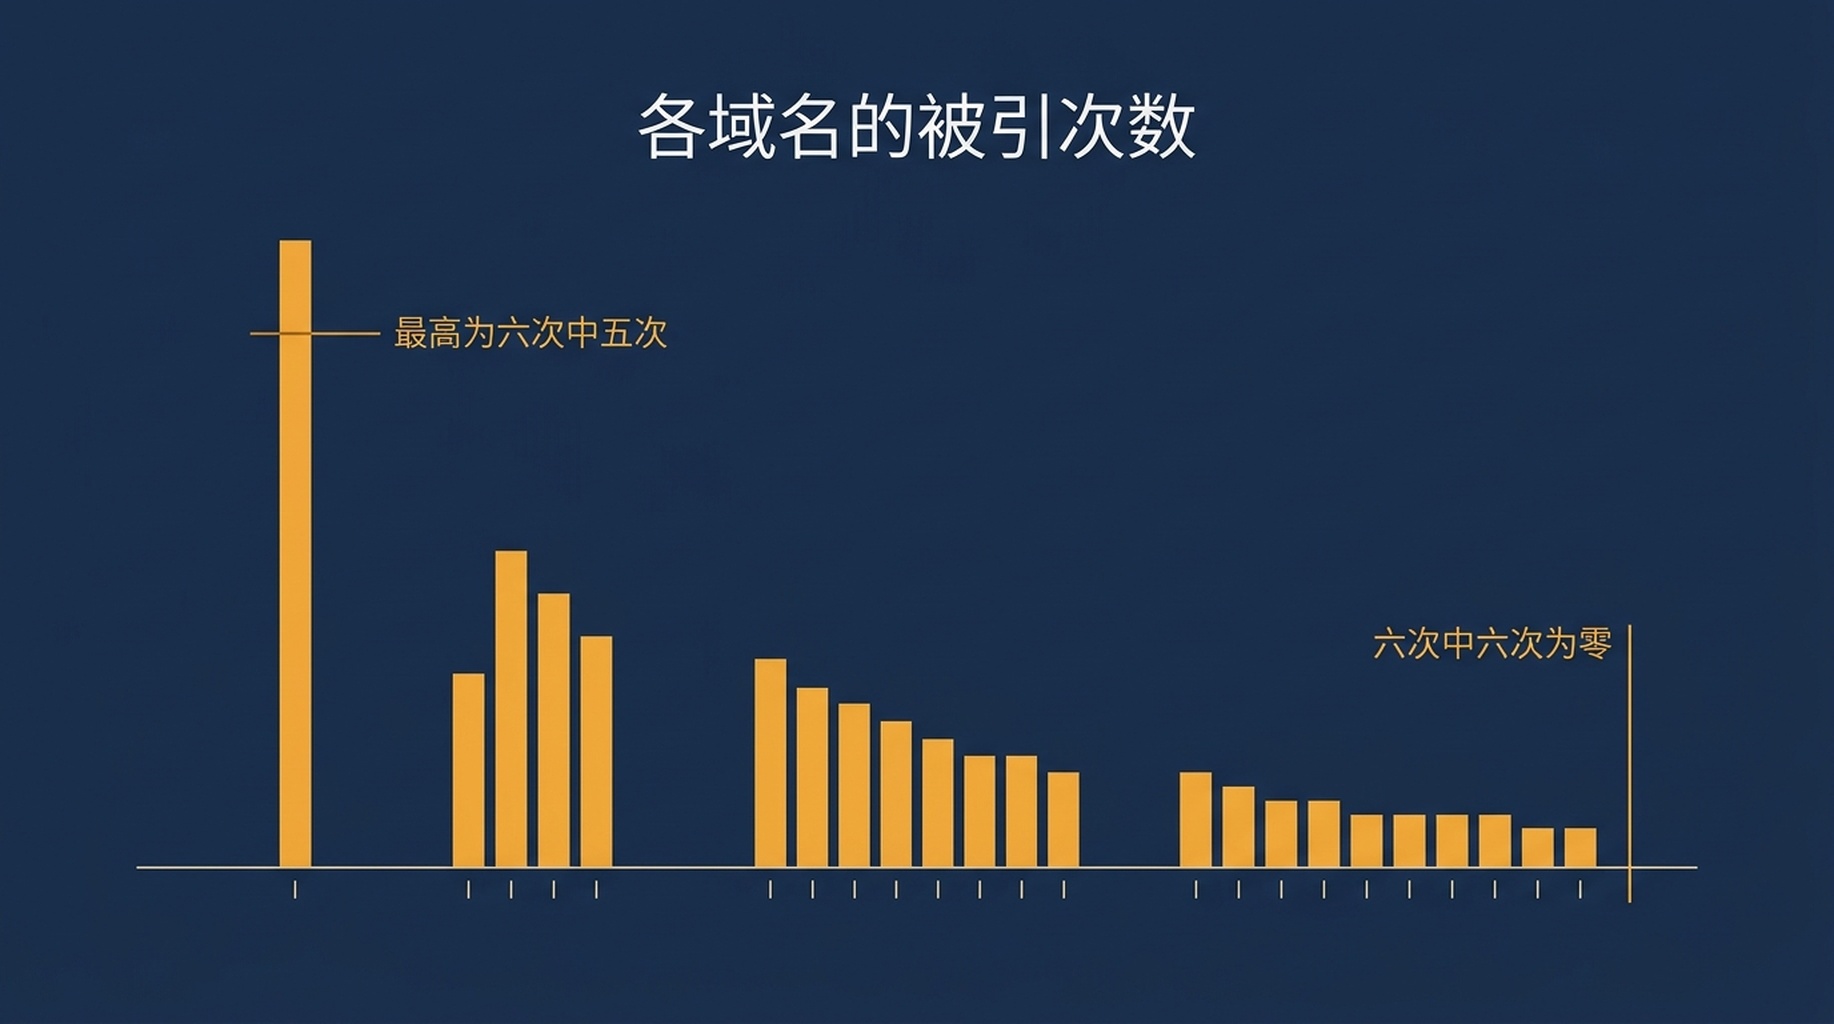
六次中五次被引用,是我们观测到的上限。没有任何东西每次都出现。
那张表里还藏着第二个发现。模型伸手去够的域名,大多不是这个品类里知名的对比站点。十八个域名中有九个只出现过一次,其中几个是小型站点,其内容读起来像是为这个查询拼装出来的,而非报道所得。对品牌来说这是把双刃剑。它意味着引用位比传统的"最佳工具"排名更容易拿下。它同时也意味着,这个位子正被那个当初做出了符合该次查询形态的页面的人占着,而下一次又会被重新填上。
结果 2:答案本身的体量会变
引用在动,答案长度也在动。
运行 | 输出 token | 答案长度 | 运行成本 |
|---|---|---|---|
1 | 505 | 2,153 字符 | $0.0735 |
2 | 860 | 3,728 字符 | $0.0770 |
3 | 1,108 | 4,746 字符 | $0.0797 |
4 | 832 | 3,555 字符 | $0.0765 |
5 | 870 | 3,547 字符 | $0.0772 |
6 | 813 | 3,544 字符 | $0.0768 |
输出长度从 505 到 1,108 个 token,跨度 603 个 token,约为均值的 73%。最长答案是最短答案的两倍多。六次中有五次落在 813 到 1,108 这个相当窄的区间内;有一次在 505 处提前停住,只引用了五个来源,而不是九到十四个。
对测量来说,这一点的影响很具体。如果你的追踪器捕捉的是"品牌是否出现在答案中、出现在第几位",那么一次短的运行可供出现的位子就更少。每周采样一次、恰好抽到短运行的团队,会记录到比抽到长运行的团队更差的结果——而网站上什么都没变。
结果 3:有些提示词根本没有任何引用
第二个关于追踪 AI Overview 的提示词,走同一条网页搜索路径四次,每次都返回零引用。
运行 | 输出 token | 答案长度 | 引用数 |
|---|---|---|---|
1 | 479 | 2,135 字符 | 0 |
2 | 522 | 2,240 字符 | 0 |
3 | 534 | 2,312 字符 | 0 |
4 | 497 | 2,228 字符 | 0 |
答案长度很稳定,四次之间只变化了 8%。但模型是凭自身知识作答的,没有点名任何来源,所以引用那一列根本无物可记。
这就产生了一种特定且具有误导性的追踪器读数。引用率仪表盘会对这个问题显示零,看起来像一次可见性失败。并不是。这是一种不会触发来源查找的问题形态。正确的读数是"引用不适用",而一个无法把它与"已检查引用但你不存在"区分开的追踪器,会让你去追一个根本不存在的问题。
结果 4:换模型是另一次测量,而不是一次重复
在关闭网页搜索的情况下,我们测了每个模型说出了哪些产品。这样就把模型自身的推荐集合,与那一分钟搜索索引返回的东西隔离开来。
Claude Sonnet 5 每次说出四到五个产品。三次运行合计说出六个不同产品:AccuRanker、Ahrefs、SEMrush、SE Ranking、Serpstat 和 SerpWatcher。其中三个在三次运行中都出现过:AccuRanker、Ahrefs 和 SEMrush。平均两两重叠度 0.587。
Gemini 3.8 Flash 每次说出两到五个产品。三次运行合计说出七个不同产品:AccuRanker、Ahrefs、Looker Studio、Nightwatch、SE Ranking、SEMrush 和 Wincher。其中只有 SE Ranking 在三次运行中都出现。平均两两重叠度 0.306。
在两个模型之间,有四个产品被双方同时提到,五个产品只被其中一方提到。
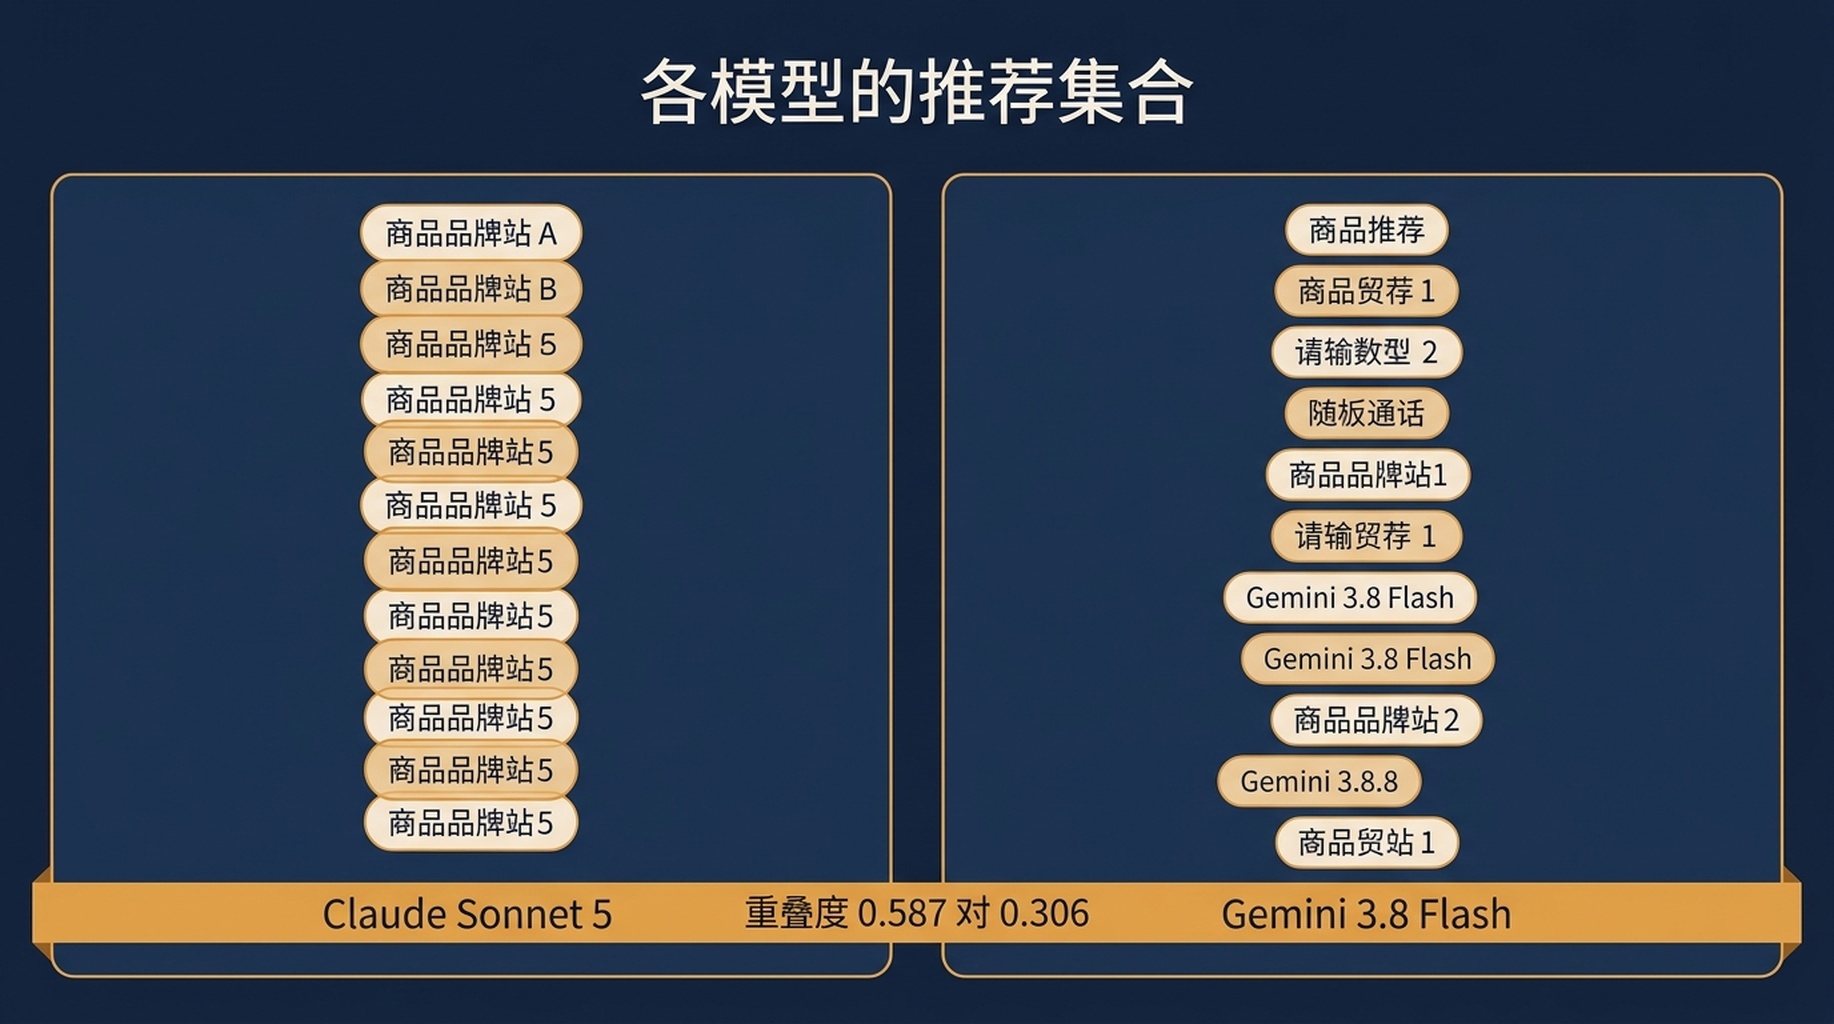
同一个问题,在每个模型、每次运行上都会产生部分不同的推荐集合。
实际后果是:如果你把"AI 可见性"当作一个数字来追踪,你就是在对至少两个独立的变异来源取平均——运行和模型。一个在某个助手里稳定出现、在另一个里不出现的品牌,是一个真实的、可据以行动的发见。而一个单样本测量移动了两个位置的品牌,是噪声。
AI 可见性追踪器应该记录什么
四个字段能把一张截图变成一次测量。
运行次数,而不是运行结果。 存储每一次运行并报告区间。"六次中四次被引用"是事实。"被引用,第三位"是巧合。小型项目六次是合理的下限;如果这个提示词有商业价值,十二次更好。
把引用字段和提及字段分开。 "模型推荐了我们"和"模型链接了我们"是两种不同的结果,修法也不同。我们这六次运行从 18 个不同 URL 产生了 18 条引用;只记录品牌提及的追踪器,一条这样的变动都捕捉不到。
答案通道状态。 记录该次运行是否使用了网页搜索,以及答案长度。零引用的一次运行和零提及的一次运行在仪表盘上看起来一模一样,含义却相反。
逐字记录提示词文本,并带上版本号。 提示词措辞决定哪些来源会被拉进来。如果提示词在月份之间变了,趋势线就断了。像给追踪脚本做版本管理那样给提示词做版本管理。
搭建运行循环
人工检查撑不过一次和日历的接触。这个循环是一个脚本:把提示词运行 N 次,把每次原始响应连同引用存下来,再把当前窗口与上一个窗口做差分。
这很适合交给智能体,因为工作重复、受规则约束,而且需要书面记录。在 Claude Code 或 Codex 里,有用的指令是:把原始运行留在磁盘上、永不覆盖,然后报告一张汇总表而不是单一数字。如果你已经在通过 MCP 服务器拉取 Search Console 和 Bing 数据,同一个会话就能把引用日志放在曝光数据旁边——两个数字开始产生合力正是在那里。关于这些服务器暴露了什么,我们的笔记在四个 SEO MCP 服务器实际做了什么,同一个问题的"存在"一侧则在我们的四十查询 AI Overview 快照。
有一条设计规则比其余都重要:追踪器的输出应该是一个分布。报告"六次中四次被引用",而不是"被引用"。报告来源列表,而不是头号来源。任何把六次运行压成一个数字的仪表盘,都已经扔掉了额外运行买来的唯一信息。
如果目标是竞品对比而非监控,那么一条按时间推进的排名追踪循环是更趁手的工具,数据源之间的取舍见用两个来源搭建排名追踪器。
六次样本的局限
三条诚实的说明。
样本很小。六次只能松散地框定离散度。它能确立运行之间的重叠是部分的、并且会出现零重叠的对子;它给不了你自己品类的置信区间。
结果是受时间约束的。这些运行是在 2026 年 9 月 12 日针对当时的线上模型做的。模型和底层搜索结果都会变。
被引域名是一个商业提示词的样本。不同的问题形态,比如对比类问题或操作类问题,会产生不同的引用模式。有用的做法是把同样的设计跑在你自己最有商业价值的十个提示词上,记录你这个品类会怎么表现。
常见问题
AI 可见性数字要有意义,需要跑多少次? 单个提示词的实用下限是六次,而且这个数字应当报告为"运行次数中的计数"而不是排名。如果某个提示词驱动营收决策,十二次只需几美元就能得到更紧的读数。
这是否意味着 AI 可见性追踪不值得做? 它意味着单样本追踪不值得。方差本身就是发现。一个报告"六次中四次被引用,来源较上月变动了 12 个域名"的追踪器,描述的正是竞争对手正在其中角逐的真实系统。
为什么有一个提示词返回了零引用? 模型凭自身知识作答,而没有做来源查找。那是问题的属性,不是你网站的失败。请把它记为不适用,而不是零。
我应该分开追踪 ChatGPT、Claude 和 Gemini 吗? 应该。在我们的三次对比中,两个模型在九个被点名产品上只重叠了四个。取平均会掩盖一个项目层面的决策:先优化哪个助手。
降低模型温度能减少方差吗? 部分能,值得在你自己的提示词上测一测。但引用集合还受搜索索引驱动,而那个你控制不了。运行次数是更可靠的杠杆。
Auspia 观点:如果你这个季度要搭建 AI 可见性追踪,先建运行日志,再建仪表盘。仪表盘是渲染选择,运行日志才是测量。从十个提示词、各六次、逐字存储开始,你一周学到的东西会比单样本检查一年告诉你的还多。
作者:Ethan Marlowe,在 Auspia 负责覆盖 500 多个提示词的 GEO 测量。撰写关于提示词追踪、引用报告,以及能经受真实测量周期考验的可见性仪表盘的文章。