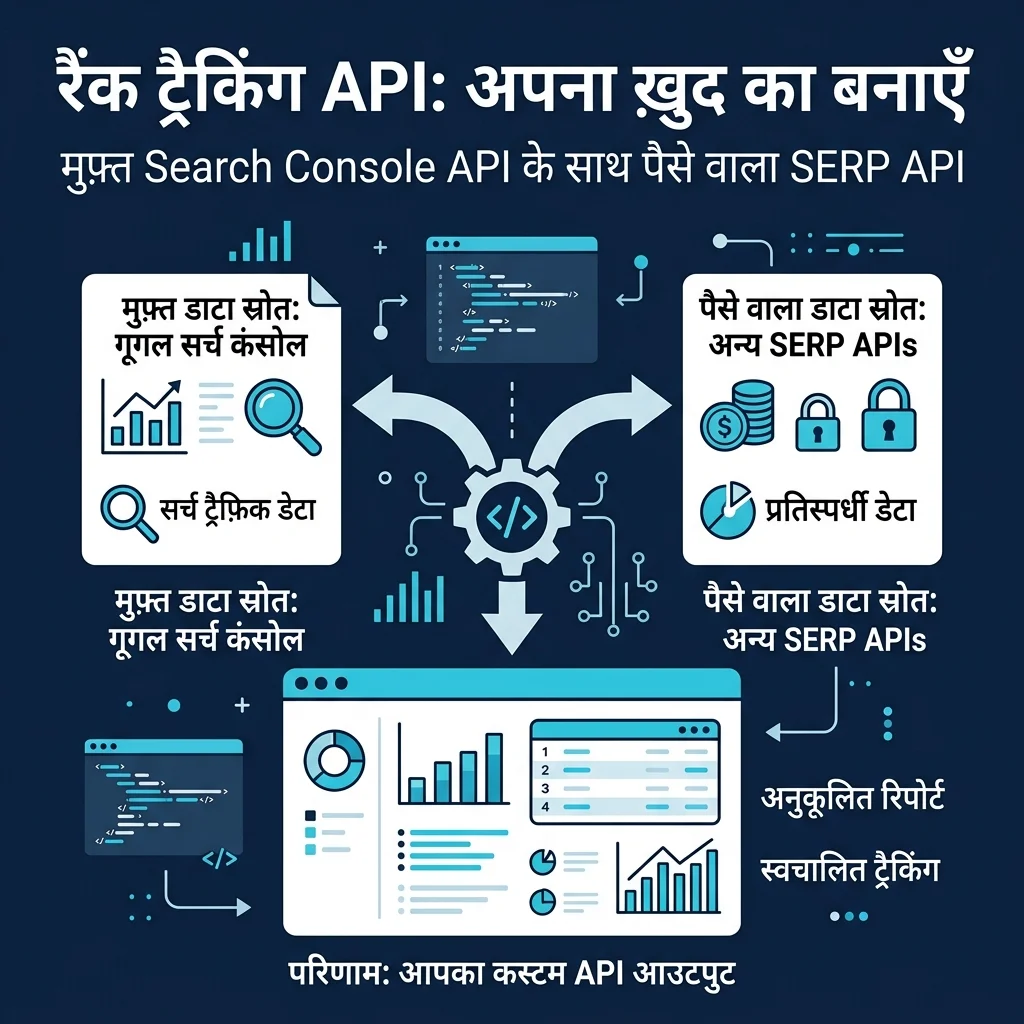
रैंक ट्रैकिंग API कोई एक चीज़ नहीं है। "rank tracking API" खोजने वाला डेवलपर आम तौर पर एक ऐसा एंडपॉइंट चाहता है जो रैंकिंग लौटाए, और बाज़ार उसे विक्रेताओं की सूची थमा देता है। ईमानदार जवाब यह है: आपको दो स्रोत चाहिए, और वे अलग-अलग सवालों का जवाब देते हैं।
Search Console API मुफ़्त है, आधिकारिक है, और हमेशा के लिए उन प्रॉपर्टी तक सीमित है जिन्हें आप सत्यापित कर सकते हैं। SERP API पैसे वाला है, अनौपचारिक है, और किसी भी कीवर्ड को कहीं भी जाँच सकता है — उन कीवर्ड सहित जिन पर आपने कभी रैंक ही नहीं किया। इनमें से कोई अकेला रैंक ट्रैकर नहीं है। दोनों मिलकर लगभग 120 लाइन Python और cron की एक लाइन हैं।
यह उसी सेटअप की विधि है। यह मानती है कि आप स्क्रिप्ट चला सकते हैं और फ़ाइल सहेज सकते हैं। यह नहीं मानती कि आपको कोई प्रोडक्ट बनाना है।
अंत में आपके पास क्या होगा
किसके लिए: ऐसे डेवलपर या तकनीकी मार्केटर के लिए जिसके पास Search Console की पहुँच पहले से है और जो प्रति सीट भुगतान किए बिना तय समय पर रैंकिंग चाहता है।
पूरा होने पर आपके हाथ में: दो चलते हुए फ़ेच फ़ंक्शन, हर रन पर एक मर्ज की गई आउटपुट फ़ाइल, और एक तुलना नियम जो आंकड़ों को आपसे झूठ बोलने नहीं देता।
समय: पहली बार जोड़ने में लगभग 90 मिनट, उसके बाद हर रन की समीक्षा में करीब 10 मिनट।
तैयार होने पर कैसा दिखता है: क्वेरी और डिवाइस के हिसाब से आपकी रैंकिंग वाली तारीखित JSON फ़ाइल, साथ में जमे हुए कीवर्ड सेट के ताज़ा SERP स्नैपशॉट, और पिछले रन के मुक़ाबले एक छोटा diff।
शुरू करने से पहले: हर स्रोत क्या कर सकता है और क्या नहीं
यह बँटवारा ठीक कर लें तो बाक़ी सेटअप यंत्रवत हो जाता है। ग़लत कर लें तो एक महीना या तो बेकार चीज़ पर जाएगा या महँगी चीज़ पर।
Search Console API | SERP API | |
|---|---|---|
किसकी रैंकिंग | सिर्फ़ आपकी सत्यापित प्रॉपर्टी | कोई भी, प्रतिस्पर्धियों सहित |
कीवर्ड | जिन क्वेरी पर आप पहले से दिखते हैं | कोई भी कीवर्ड जो आप लिखें |
लागत | मुफ़्त | प्रति रिक्वेस्ट बिल |
डिवाइस विभाजन | है, एक आयाम के रूप में | है, प्रति रिक्वेस्ट |
स्थान | जिन देशों में आप रैंक करते हैं | विक्रेता जो भी स्थान समर्थित करता है |
डेटा का प्रकार | कुल क्लिक, इंप्रेशन, स्थान | किसी एक क्षण का परिणाम पृष्ठ |
इतिहास की गहराई | जो अवधि आप माँगें | सिर्फ़ जिस दिन से सहेजना शुरू किया |
आधिकारिक दर्जा | Google का अपना डेटा | किसी तीसरे पक्ष का सार्वजनिक पृष्ठ पढ़ना |
दोनों स्रोत टकराएँगे, और वह टकराव जानकारी है, ग़लती नहीं। Search Console हर इंप्रेशन को तारीख़ की अवधि और सभी डिवाइसों पर औसत करता है। एक SERP फ़ेच एक क्षण का एक परिणाम पृष्ठ है। दोनों की सीधी तुलना करेंगे तो भूतिया गिरावटों के पीछे भागेंगे — पाँचवाँ चरण इसीलिए तुलना नियम तय करता है।
कोड लिखने से पहले जानने लायक तीन आँकड़े। Search Console API प्रति रिक्वेस्ट 1 से 25,000 पंक्तियों की सीमा लेता है और डिफ़ॉल्ट 1,000 है, यानी मँझोले आकार की साइट एक ही कॉल में तीन महीने का क्वेरी-और-डिवाइस डेटा खींच सकती है। यह प्रति साइट और प्रति उपयोगकर्ता प्रति मिनट 1,200 क्वेरी की अनुमति देता है। और यह दस मिनट के खंडों में नापी जाने वाली लोड कोटा लगाता है, जहाँ लंबी तारीख़ अवधि छोटी से महँगी पड़ती है — Google के अपने दिशानिर्देश इसीलिए वही डेटा दोबारा क्वेरी करने से बचने को कहते हैं।
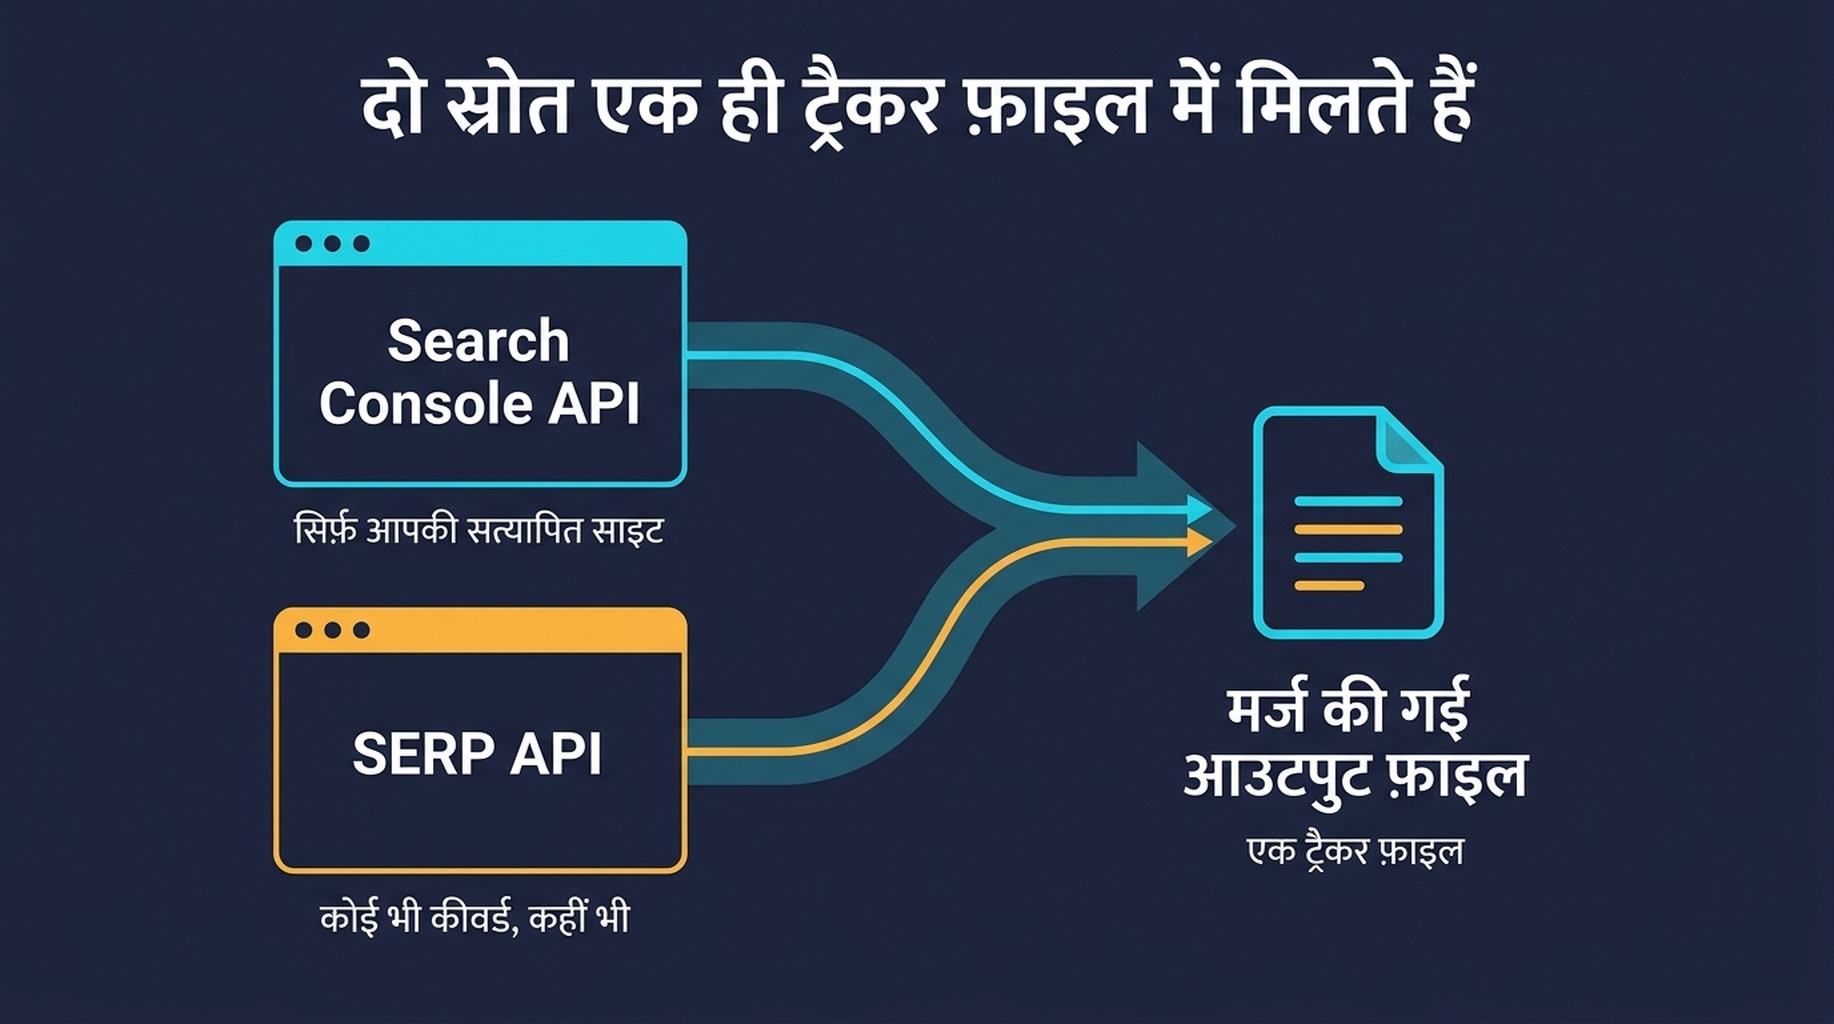
दो स्रोत, एक आउटपुट। Search Console बताता है "मैं कहाँ दिख रहा हूँ", SERP API बताता है "पृष्ठ कैसा दिख रहा है"।
चरण 1: कोड लिखने से पहले कीवर्ड सेट जमा दें
हर रन पर अलग कीवर्ड सूची खींचने वाला ट्रैकर यह जवाब नहीं दे सकता कि कुछ बदला या नहीं। पहले सूची चुनें और एक तिमाही तक उसे बनाए रखें।
तीन समूह हैं, और वे अलग-अलग जगहों से आते हैं।
- Search Console से: पिछले 90 दिनों में कम से कम 20 इंप्रेशन वाली हर क्वेरी। इन्हें आप नहीं चुनते; आपके इंप्रेशन चुनते हैं। यही वह समूह है जहाँ हलचल का मतलब होता है, क्योंकि इसके पीछे माँग पहले से है।
- बिज़नेस से: दस से बीस ऐसी क्वेरी जो आमदनी से जुड़ी हैं, चाहे आप उन पर रैंक करें या न करें।
- प्रतिस्पर्धियों से: ऐसी क्वेरी जिन पर कोई प्रतिस्पर्धी रैंक करता है और आप नहीं। इनके लिए SERP API चाहिए, क्योंकि Search Console इन्हें कभी नहीं दिखाएगा।
सूची को फ़ाइल में लिखें, उसका वर्शन रखें, और जोड़ों को बहाव नहीं बल्कि सोची-समझी तब्दीली मानें।
चरण 2: अपनी रैंकिंग मुफ़्त में खींचें
यह आधा हिस्सा आधिकारिक है, मुफ़्त है, और डिवाइस विभाजन तथा क्लिक डेटा देता है जो किसी SERP API के पास नहीं है।
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
इस रिक्वेस्ट की दो बारीकियाँ लगभग सारा काम कर देती हैं।
dataState: "final" उस ताज़ा डेटा को बाहर रखता है जिसे Google अब भी बदल सकता है। इसके बिना आख़िरी दो-तीन दिन रनों के बीच हिलते रहते हैं और आपका diff ऐसी हलचल दिखाता है जो कभी हुई ही नहीं।
dimensions: ["query", "device"] वह चीज़ है जो आउटपुट को बाद में काम का बनाती है। डिवाइस अब जोड़ने पर कुछ भी ख़र्च नहीं होता। तीन महीने का इतिहास बाद में दोबारा खींचने पर पूरा एक रन लगता है और जो दिन आप पहले ही छोड़ चुके हैं उनके लिए कुछ नहीं मिलता।
अपेक्षित आउटपुट: प्रति क्वेरी और डिवाइस एक पंक्ति, क्लिक, इंप्रेशन, CTR और औसत स्थान के साथ।
गुणवत्ता जाँच: पंक्तियों की संख्या 25,000 से कम होनी चाहिए। ठीक 25,000 आए तो आप काटे गए हैं और startRow: 25000 के साथ दूसरी कॉल चाहिए।
अगर न चले: 403 का मतलब आम तौर पर यह है कि service account का ईमेल प्रॉपर्टी पर उपयोगकर्ता के रूप में कभी जोड़ा ही नहीं गया। उसे Search Console में जोड़ें, कुछ मिनट रुकें, फिर कोशिश करें।
चरण 3: वे SERP खींचें जो आपके डेटा में नहीं दिखते
दूसरा आधा हिस्सा वह सब कवर करता है जो Search Console ढाँचे से नहीं कर सकता। यह सबसे छोटी चलने वाली कॉल है।
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
`depth` 200 नहीं, 100 रखें। हमने सितंबर 2026 में छह क्वेरी के लिए 200 नतीजे माँगकर यह जाँचा। Google 83 से 128 ऑर्गैनिक नतीजे लौटाकर रुक गया, और पूरे परीक्षण में सबसे गहरी रैंकिंग 142 थी। पूरा परीक्षण यहाँ। 200 माँगने से 200 नतीजे नहीं मिलते, और विक्रेता के हिसाब से माँगी गई गहराई का बिल फिर भी लग सकता है। 100 माँगें — जो मौजूद है वह लगभग हमेशा मिल जाएगा।
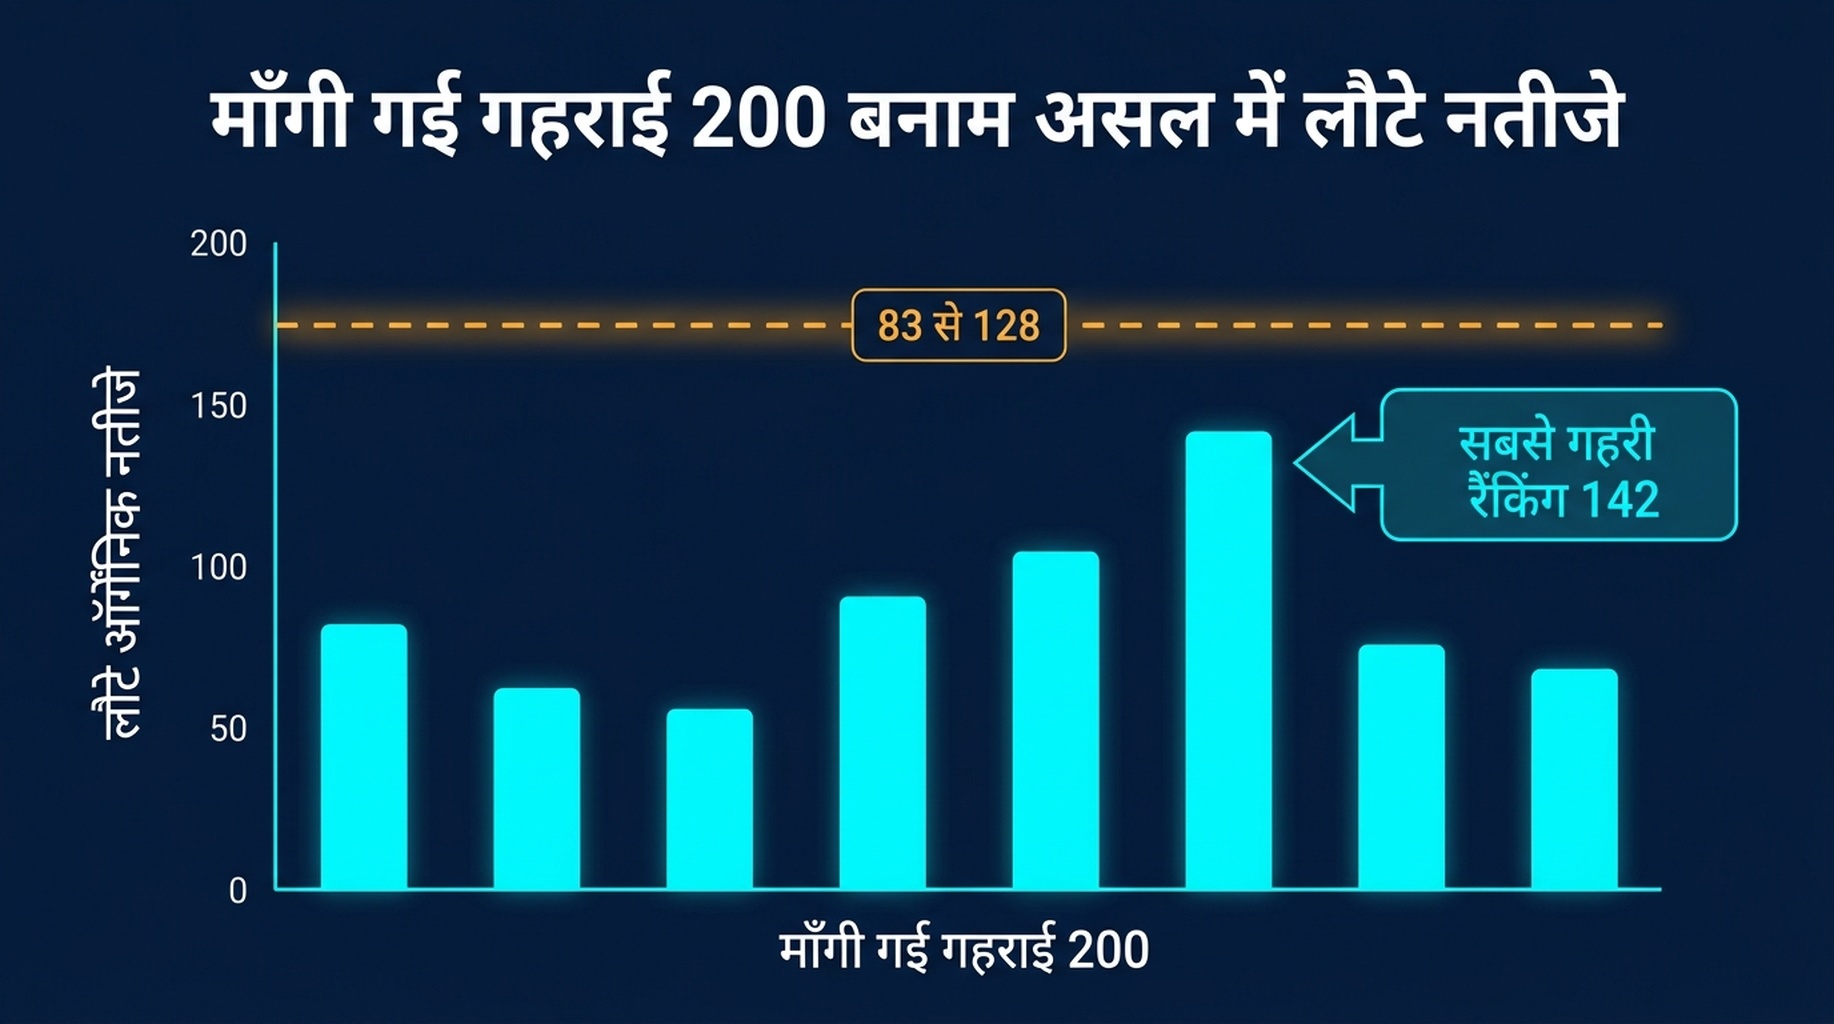
200 नतीजे माँगना और 83 से 128 पाना। लगभग 140 से ज़्यादा गहराई ज़्यादातर कमर्शियल क्वेरी पर कुछ नहीं ख़रीदती।
अपेक्षित आउटपुट: ऑर्गैनिक आइटम वाला JSON पेलोड, जिनमें स्थान, URL, शीर्षक और डोमेन हों।
गुणवत्ता जाँच: पुष्टि करें कि पेलोड में मौजूद होने पर ai_overview आइटम प्रकार शामिल है। सिर्फ़ organic आइटम निकालेंगे तो आप यह कारण चूक जाएँगे कि कोई पृष्ठ रैंकिंग बनाए रखते हुए क्लिक क्यों खो रहा है।
अगर न चले: 401 base64 या क्रेडेंशियल की ग़लती है। 40200 जैसा कोड बताता है कि खाते का बैलेंस ख़ाली है, और यह पहले महीने की सबसे आम नाकामी है।
चरण 4: सारांश नहीं, कच्चा पेलोड सहेजें
यही वह फ़ैसला है जिसे छोड़ने का लोगों को बाद में अफ़सोस होता है।
रैंकिंग की टेबल सहेजना तब तक काम करता है जब तक आपको कोई ऐसा सवाल न पूछना पड़े जिसका अनुमान आपने न लगाया हो: क्या परिणाम लंबे हो गए, क्या वीडियो ने सब ले लिया, कोई प्रतिस्पर्धी घुसा या नहीं, fold के ऊपर AI Overview आया या नहीं। सारांश इनका जवाब नहीं दे सकता। कच्चा पेलोड दे सकता है, बिना किसी अतिरिक्त लागत के।
व्यावहारिक रूप यह है: हर रन के लिए तारीख़ और समय से नामित एक फ़ाइल लिखें जिसमें मर्ज किया गया आउटपुट हो। आख़िरी 90 दिन रखें। यह रेपो में रहने लायक छोटा है और पुराने सवालों का दोबारा जवाब देने लायक पूरा।
चरण 5: कुछ भी शेड्यूल करने से पहले तुलना नियम लिखें
पिछले रन की तुलना मौजूदा से करने वाला ट्रैकर ज़्यादातर दिनों में झूठा अलार्म बजाता है। हमारे अपने आँकड़े कारण बताते हैं: कम से कम 30 इंप्रेशन वाली 124 क्वेरी पर औसत क्वेरी दिन-ब-दिन 4.57 स्थान खिसकी। चार स्थान की गिरावट एक मंगलवार है।
यानी नियम को एक दहलीज़ और एक दिशा चाहिए।
किसी क्वेरी की सूचना दें केवल जब:
  - पिछले रन के मुक़ाबले पूर्ण स्थान परिवर्तन 5 या अधिक हो, और
  - तुलना अवधि में क्वेरी के कम से कम 20 इंप्रेशन हों, और
  - बदलाव की वजह डिवाइस मिश्रण का खिसकना न हो

आउटपुट को क्वेरी वर्ग के हिसाब से समूहित करें: money, comparison, brand, informational.
सुधार सुझाएँ नहीं।
डिवाइस वाली शर्त सजावट नहीं है। वही क्वेरी मोबाइल और डेस्कटॉप पर 11 स्थान अलग खड़ी हो सकती है, और रनों के बीच डिवाइस मिश्रण खिसके तो मिला-जुला आँकड़ा भी खिसकेगा। हमने इसे अलग से नापा और यह एक ट्रेंड गढ़ने के लिए काफ़ी बड़ा है।
इसका ख़र्च क्या है
विक्रेताओं की क़ीमतें बदलती रहती हैं, इसलिए किसी कोटेशन के पीछे भागने के बजाय मॉडल बनाएँ।
- एक कीवर्ड, 30 दिन तक रोज़ एक बार जाँचा गया, महीने के 30 रिक्वेस्ट हैं।
- 200 कीवर्ड का सेट रोज़ जाँचा गया तो महीने के 6,000 रिक्वेस्ट।
- वही सेट हफ़्ते में एक बार जाँचा गया तो महीने के क़रीब 860 रिक्वेस्ट।
- Search Console वाला आधा मुफ़्त है और उसमें कितने भी कीवर्ड हों, हर व्यू के लिए एक रिक्वेस्ट है।
पूरा फ़ैसला यही गुणा है। "क्या कोई टूल ख़रीदूँ" का सवाल लगभग हमेशा इसी पर उतरता है: महीने के रिक्वेस्ट गिनें, अपनी प्रति-रिक्वेस्ट क़ीमत से गुणा करें, और सीट लाइसेंस से तुलना करें। बड़े कीवर्ड सेट की रोज़ाना ट्रैकिंग आम तौर पर सब्सक्रिप्शन में सस्ती पड़ती है। छोटे सेट की हफ़्तेवार ट्रैकिंग आम तौर पर API से सस्ती पड़ती है। जमी हुई सूची ट्रैक करें, API वाला हिस्सा छोटा रहेगा।
कब बनाने के बजाय ख़रीदें
अगर आपको अपने ही पाइपलाइन में रैंकिंग चाहिए, अगर आपके पास SERP API क्रेडेंशियल पहले से है, या अगर कच्चा परिणाम पृष्ठ आपको रैंकिंग के अलावा दूसरी वजहों से चाहिए — तो बनाएँ।
इसके बजाय ख़रीदें अगर आज से पहले का ऐतिहासिक रैंकिंग डेटा चाहिए, अगर उन्हीं कीवर्ड के लिए दस स्थान और पाँच डिवाइस चाहिए, या अगर टीम में कोई cron को नहीं निभाएगा। विक्रेताओं की सूचियाँ इसीलिए पढ़ने लायक हैं, और ऐसी अधोसंरचना रखने की असली क़ीमत है जो उसके लेखक के टीम बदलते ही रुक जाती है।
अगर आपको असल में JSON फ़ाइल नहीं बल्कि लिखित साप्ताहिक रिपोर्ट चाहिए, तो Codex में रिपोर्टिंग वर्कफ़्लो उन्हीं दो स्रोतों से शुरू होकर एक दस्तावेज़ पर ख़त्म होता है। फ़ाइल के ऊपर अलर्ट लगाने के लिए मॉनिटरिंग डिज़ाइन गाइड दहलीज़ों पर चलता है।
Auspia का नज़रिया: रैंक ट्रैकिंग API का सवाल असल में डेटा के स्वामित्व का सवाल है। Search Console आपकी प्रॉपर्टी का आधिकारिक डेटा मुफ़्त देता है और हमेशा देता रहेगा। बाक़ी सब एक ऐसा स्नैपशॉट है जिसके पैसे आप देते हैं। पहले मुफ़्त वाला आधा बनाएँ, और पैसे वाला आधा सिर्फ़ वहीं जोड़ें जहाँ वह उस सवाल का जवाब दे जो सचमुच आपके पास है।
अक्सर पूछे जाने वाले सवाल
क्या Google कोई रैंक ट्रैकिंग API देता है? सार्वजनिक नहीं। Search Console API उन क्वेरी के लिए आपका औसत स्थान लौटाता है जिन पर आप पहले से दिखते हैं; यह क़रीब है पर वही चीज़ नहीं। यह उस कीवर्ड को नहीं जाँच सकता जिस पर आप रैंक नहीं करते, और प्रतिस्पर्धी को नहीं जाँच सकता।
SERP API कितनी गहराई तक जा सकता है? विक्रेता 200 से बहुत ऊपर की गहराई स्वीकार कर लेंगे, पर ज़्यादातर कमर्शियल क्वेरी पर Google 100 से 140 के बीच कहीं नतीजे देना बंद कर देता है। ज़्यादा माँगने से ज़्यादा नतीजे नहीं मिलते।
रोज़ जाँचें या हफ़्ते में? सामान्य कीवर्ड सेट के लिए हफ़्ते में। रोज़ सिर्फ़ पैसे वाली क्वेरी की छोटी सूची के लिए। बड़े सेट की रोज़ाना जाँच ख़र्च सात गुना कर देती है और ज़्यादातर शोर नापती है, क्योंकि हमारे डेटा में औसत रोज़ाना खिसकाव 4.57 स्थान था।
मेरा API वाला आँकड़ा मेरे रैंक ट्रैकर से अलग क्यों है? अलग डिवाइस, अलग स्थान, अलग क्षण, और अक्सर अलग डेटा स्रोत। आँकड़ा एक नमूना है। यह तय करने से पहले कि कुछ बदला है, रिक्वेस्ट में स्थान और डिवाइस तय करें और दोबारा खींचें।
क्या कोई एजेंट यह मेरे लिए चला सकता है? हाँ, और यह अच्छी तरह बैठता है, क्योंकि हर रन में काम का आकार एक ही रहता है। रैंकिंग के काम में एजेंट क्या-क्या ले सकता है, इसकी बड़ी तस्वीर SEO एजेंट की प्रैक्टिकल गाइड में है। तुलना नियम एक लिखित निर्देश फ़ाइल में रखें और diff एजेंट से बनवाएँ; बनाना है या ख़रीदना है, यह फ़ैसला इंसान के पास रखें।
लेखक: Rowan Blake, Auspia में कंटेंट ऑटोमेशन विश्लेषक, 100 से अधिक पब्लिशिंग पाइपलाइन देखते हैं। स्वचालित डेटा पाइपलाइन, तय समय पर रिपोर्टिंग, और आपके बिना चलने वाले सिस्टमों की रखरखाव लागत पर लिखते हैं।