גשש נראות ב-AI נשמע פשוט. שואלים עוזר את שאלות הקטגוריה שלכם, רושמים אם המותג מופיע, ומתווים את זה על ציר זמן.
הבעיה נמצאת במעלה הזרם מהרישום. הדבר שאתם מודדים לא מחזיק מעמד במקום. שלחו את אותה שאילתה לאותו מודל פעמיים ותקבלו שתי תשובות שחופפות חלקית, לא במלואן. רשמו אחת מהן ורשמתם דגימה אחת מתוך התפלגות, ואז הצגתם אותה כעובדה.
רצינו לדעת כמה גדול הפיזור באמת, אז הרצנו את הניסוי במקום להניח אותו. הגרסה הקצרה: שש בקשות זהות הניבו שמונה עשר מקורות מצוטטים, ואף מקור לא צוטט בכל השש.
המאמר הזה עוסק במה שהרצנו, במה שחזר, ובארבעה שדות שגשש נראות ב-AI חייב לאחסן כדי שהמספר יהיה שווה מבט גם בחודש הבא.
מה הרצנו
שני ניסויים, שניהם על שאילתות שצוות SaaS באמת ישתמש בהן למחקר קטגוריה.
ניסוי 1: שאילתה אחת, מודל אחד, שש הרצות. המודל gpt-4o, חיפוש ווב מופעל, ארצות הברית, אנגלית. השאילתה: "מהן כלי מעקב הדירוג הטובים ביותר לצוות SaaS קטן ב-2026? תן רשימה קצרה עם מקורות." שש קריאות חיות נפרדות, שהורצו ברצף באותו חלון הפעלה.
ניסוי 2: שני מודלים, אותה שאילתה, שלוש הרצות כל אחד. אותה שאילתה נשלחה ל-Claude Sonnet 5 ול-Gemini 3.8 Flash, שלוש פעמים כל אחד, בלי חיפוש ווב. בלי חיפוש אנחנו מודדים אילו מוצרים המודל נוקב משמו מידע עצמי, וזה אות נפרד מזה של אילו מקורות הוא מצטט.
שלחנו גם שאילתה שנייה במסלול חיפוש הווב ארבע פעמים, כדי לראות אם התנהגות הציטוט עקבית בין סוגי שאלות: "איך אני עוקב אחרי AI Overviews לאתר שלי? תן שיטות קונקרטיות עם מקורות."
שש הרצות זה לא מדגם גדול, ואנחנו מתייחסים לזה ככזה. זה מספיק כדי להראות את הכיוון ואת הסדר גודל הגס של השונות, וזו הנקודה.
תוצאה 1: שמונה עשר מקורות, ואפס משותפים לכל שש ההרצות
שש הרצות חיפוש הווב ציטטו יחד 18 כתובות URL נפרדות. הנה באיזו תדירות הופיע כל דומיין.
מספר ציטוטים (מתוך 6 הרצות) | דומיינים |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
אף דומיין לא צוטט בכל שש ההרצות. אף כתובת URL לא צוטטה בכל שש ההרצות.
המספר שחשוב כאן הוא החפיפה בין הרצות. בהשוואת כל זוג הרצות, חפיפת Jaccard הממוצעת על כתובות URL מצוטטות הייתה 0.167. בשניים מחמישה עשר הזוגות החפיפה הייתה אפס בדיוק, כלומר שתי התשובות האלה לא חלקו אף מקור.
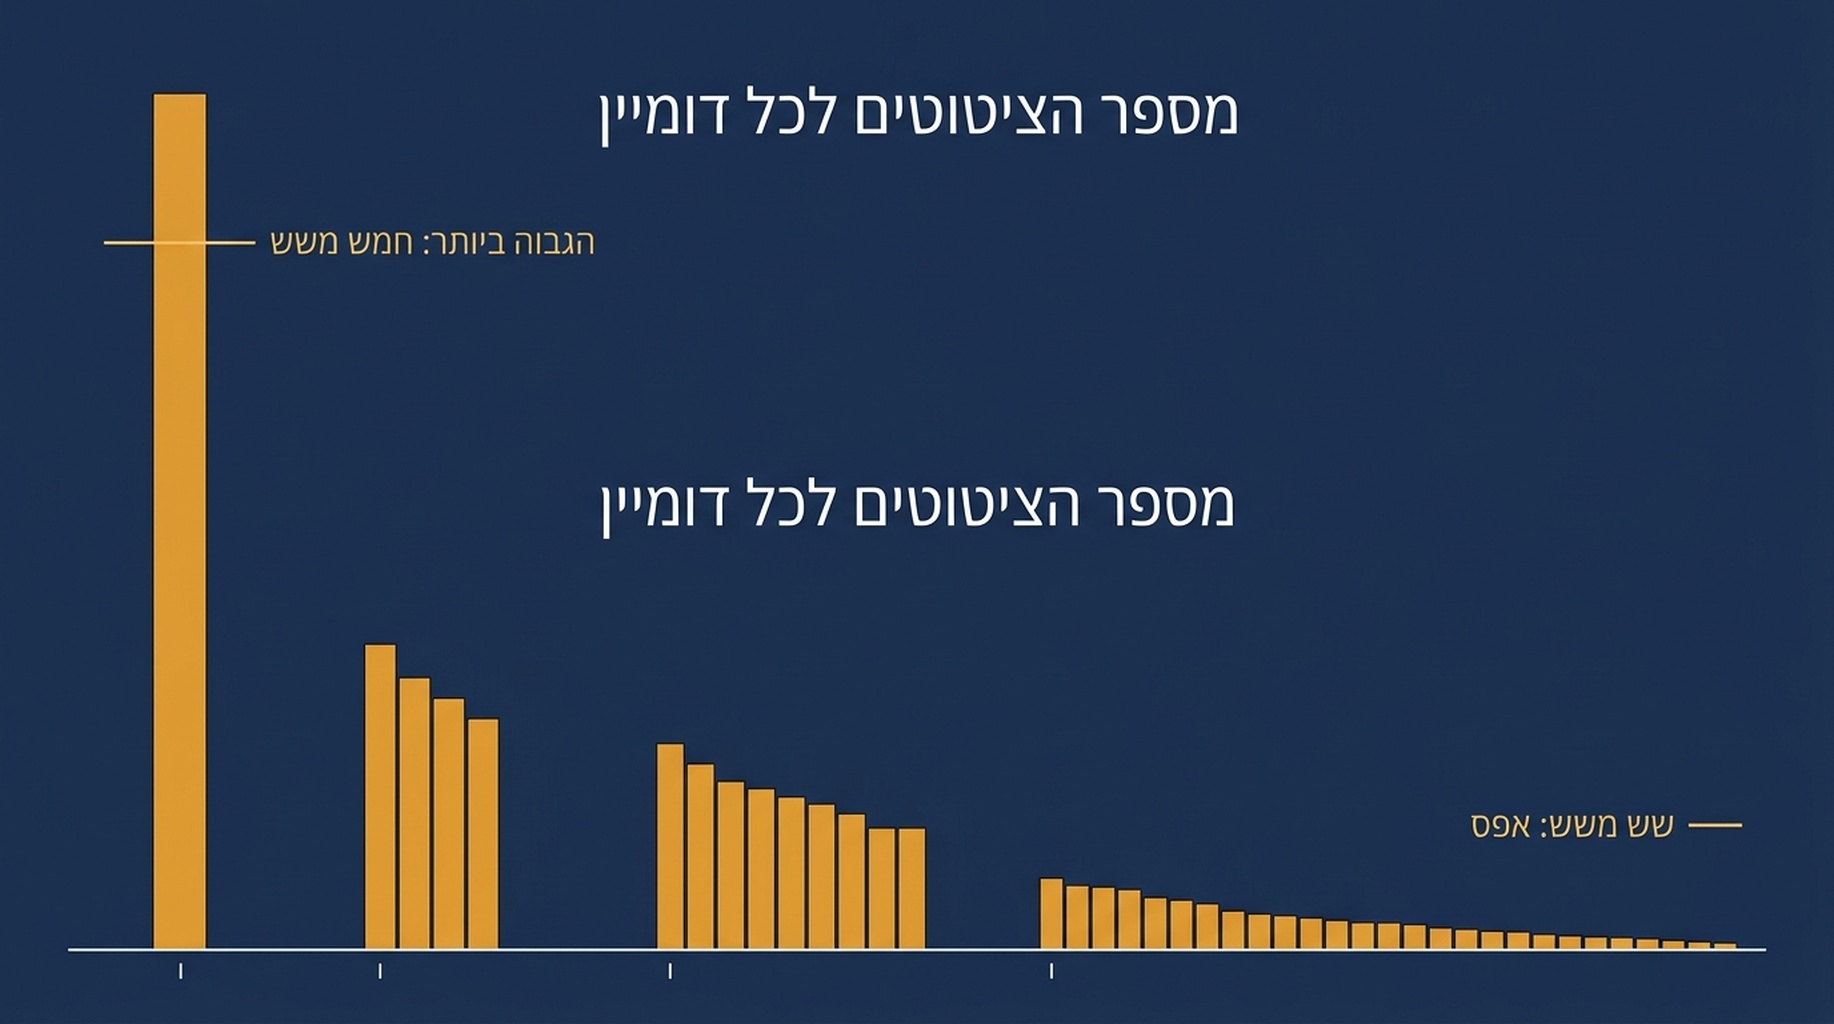
מקור שצוטט בחמש משש הרצות הוא התקרה שראינו. שום דבר לא צוטט בכל פעם.
בטבלה ההיא קבורה ממצא שני. הדומיינים שהמודל הושיט אליהם יד הם ברובם לא אתרי ההשוואה המוכרים בקטגוריה. תשעה משמונה עשר הדומיינים הופיעו בדיוק פעם אחת, וכמה מהם אתרים קטנים שתוכנם נקרא כמו משהו שהורכב עבור השאילתה ולא כמו משהו שדווח. עבור מותג זה חרב פיפיות. זה אומר שתא הציטוט קל יותר לזכייה מדירוג "הכלים הטובים ביותר" המסורתי. זה גם אומר שהתא מתמלא על ידי מי שהפיק דף שהתאים לצורת השאילתה באותה הרצה, והוא יתמלא מחדש בהרצה הבאה.
תוצאה 2: התשובה עצמה משנה גודל
הציטוטים זזו, וגם אורך התשובה זז.
הרצה | טוקנים בפלט | אורך התשובה | עלות ההרצה |
|---|---|---|---|
1 | 505 | 2,153 תווים | $0.0735 |
2 | 860 | 3,728 תווים | $0.0770 |
3 | 1,108 | 4,746 תווים | $0.0797 |
4 | 832 | 3,555 תווים | $0.0765 |
5 | 870 | 3,547 תווים | $0.0772 |
6 | 813 | 3,544 תווים | $0.0768 |
אורך הפלט נע בין 505 ל-1,108 טוקנים, פיזור של 603 טוקנים, כ-73 אחוז מהממוצע. התשובה הארוכה הייתה יותר מכפולה מהקצרה. חמש משש ההרצות נפלו ברצועה צרה למדי בין 813 ל-1,108 טוקנים; הרצה אחת נעצרה מוקדם ב-505 וציטטה חמישה מקורות במקום תשעה עד ארבעה עשר.
למדידה זה חשוב באופן ספציפי. אם הגשש שלכם לוכד "האם המותג מופיע בתשובה, ובאיזה מיקום", להרצה קצרה יש פחות תאים להופיע בהם. צוות שדוגם פעם בשבוע ובמקרה שלף הרצה קצרה ירשום תוצאה גרועה מזו של צוות ששלף הרצה ארוכה, בלי שום שינוי באתר.
תוצאה 3: יש שאילתות שלא מקבלות ציטוטים בכלל
השאילתה השנייה, על מעקב אחרי AI Overviews, עברה באותו מסלול חיפוש ווב ארבע פעמים והחזירה אפס ציטוטים בכל הרצה.
הרצה | טוקנים בפלט | אורך התשובה | ציטוטים |
|---|---|---|---|
1 | 479 | 2,135 תווים | 0 |
2 | 522 | 2,240 תווים | 0 |
3 | 534 | 2,312 תווים | 0 |
4 | 497 | 2,228 תווים | 0 |
התשובות היו יציבות באורך, והשתנו ב-8 אחוז בלבד לאורך ארבע הרצות. אבל המודל השיב מידע עצמי ולא נקב בשם אף מקור, כך שלא היה מה לרשום בעמודת הציטוטים.
מכאן נוצרת קריאה ספציפית ומטעה של הגשש. לוח מחוונים של שיעור ציטוטים יציג אפס לשאלה הזו, וזה נראה כמו כשל נראות. זה לא. זו צורת שאלה שלא מפעילה חיפוש מקורות. הקריאה הנכונה היא "ציטוט לא רלוונטי", וגשש שלא מסוגל להבחין בכך מ"נבדק ציטוט והייתה היעדרות" ישלח אתכם לרדוף אחרי בעיה שלא קיימת.
תוצאה 4: החלפת מודל היא מדידה אחרת, לא חזרה
בלי חיפוש ווב מדדנו אילו מוצרים כל מודל נוקב. זה מבודד את מערך ההמלצות של המודל עצמו מכל מה שמדד החיפוש החזיר באותה דקה.
Claude Sonnet 5 נקב בארבעה עד חמישה מוצרים בכל הרצה. לאורך שלוש הרצות הוא נקב בשישה מוצרים נפרדים: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat ו-SerpWatcher. שלושה מהם הופיעו בכל שלוש ההרצות: AccuRanker, Ahrefs ו-SEMrush. חפיפה זוגית ממוצעת 0.587.
Gemini 3.8 Flash נקב בשניים עד חמישה מוצרים בכל הרצה. לאורך שלוש הרצות הוא נקב בשבעה מוצרים נפרדים: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush ו-Wincher. אחד מהם, SE Ranking, הופיע בכל שלוש ההרצות. חפיפה זוגית ממוצעת 0.306.
בין שני המודלים, ארבעה מוצרים נקבו על ידי שניהם וחמישה נקבו על ידי אחד בלבד.
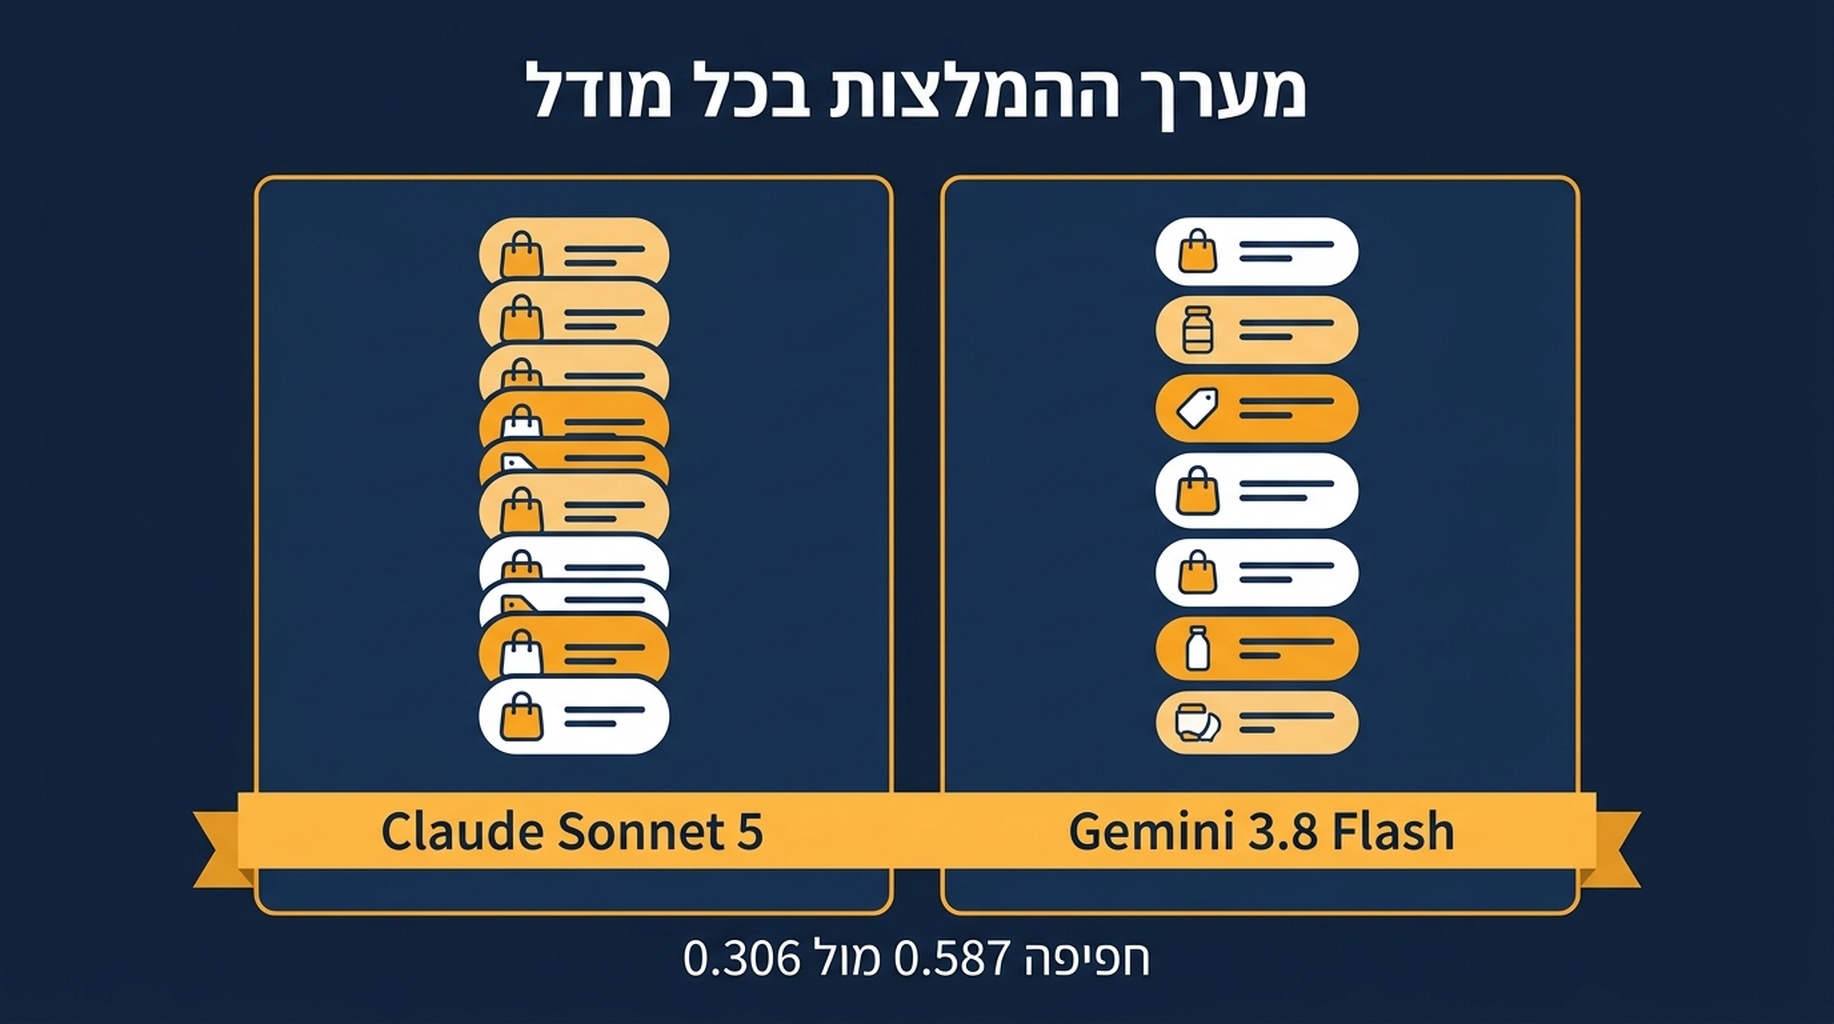
אותה שאלה מייצרת מערך המלצות שונה בחלקו בכל מודל ובכל הרצה.
המסקנה המעשית: אם אתם עוקבים אחרי "נראות ב-AI" כמספר אחד, אתם ממצעים על פני לפחות שני מקורות שונות בלתי תלויים, ההרצה והמודל. מותג שמופיע בעקביות בעוזר אחד ולא באחר הוא ממצא אמיתי ובר-פעולה. מותג שמדידת דגימה בודדת שלו זזה בשני מקומות הוא רעש.
מה גשש נראות ב-AI צריך לרשום
ארבעה שדות הופכים צילום מסך למדידה.
מספר ההרצות, לא תוצאת ההרצה. אחסנו כל הרצה ודווחו על הטווח. "צוטט ב-4 מתוך 6 הרצות" הוא עובדה. "צוטט, מיקום 3" הוא מקריות. שש הרצות הוא רצפה סבירה לתוכנית קטנה; שתים עשרה טובה יותר אם השאילתה חשובה מסחרית.
שדה הציטוט בנפרד משדה האזכור. "המודל המליץ עלינו" ו"המודל קישר אלינו" הן תוצאות שונות עם תיקונים שונים. שש ההרצות שלנו הניבו 18 ציטוטים מ-18 כתובות URL נפרדות; גשש שרושם רק אזכורי מותג לא היה לוכד דבר מהתחלופה הזו.
מצב ערוץ התשובה. רשמו אם ההרצה השתמשה בכלל בחיפוש ווב, ורשמו את אורך התשובה. הרצה עם אפס ציטוטים והרצה עם אפס אזכורים נראות זהות בלוח מחוונים ומשמעותן הפוכה.
נוסח השאילתה, מילה במילה, עם גרסה. הניסוח של השאילתה קובע אילו מקורות נמשכים. אם השאילתה משתנה בין חודשים, קו המגמה נשבר. נסחו גרסאות לשאילתה כמו שאתם מנסחים גרסאות לסקריפט מעקב.
בניית לולאת ההרצה
בדיקה ידנית לא שורדת מפגש עם יומן. הלולאה היא סקריפט שמריץ שאילתה N פעמים, מאחסן כל תשובה גולמית עם הציטוטים שלה, ומשווה את החלון הנוכחי לקודם.
זה מתאים היטב לסוכן כי העבודה חזרתית, כפופה לכללים, וזקוקה לתיעוד כתוב. ב-Claude Code או Codex, ההוראה המועילה היא להשאיר את ההרצות הגולמיות על הדיסק ולעולם לא לדרוס אותן, ואז לדווח טבלת סיכום ולא נתון בודד. אם אתם כבר מושכים נתוני Search Console ו-Bing דרך שרתי MCP, אותו מפגש יכול להחזיק את יומן הציטוטים לצד נתוני החשיפות, ושם שני המספרים מתחילים להיות מועילים יחד. ההערות שלנו על מה שהשרתים האלה חושפים נמצאות במה ארבעה שרתי SEO MCP באמת עושים, וצד הנוכחות של אותה בעיה נמצא בתצלום AI Overview שלנו לארבעים שאילתות.
כלל עיצוב אחד חשוב מהשאר: הפלט של הגשש צריך להיות התפלגות. דווחו "צוטט ב-4 מתוך 6", לא "צוטט". דווחו את רשימת המקורות, לא את המקור המוביל. כל לוח מחוונים שדוחס שש הרצות למספר אחד זרק את המידע היחיד שההרצות הנוספות קנו.
אם המטרה היא השוואת מתחרים ולא ניטור, לולאת מעקב דירוג לאורך זמן היא הכלי המתאים יותר, והפשרות בין מקורות הנתונים נמצאות בבניית גשש דירוג משני מקורות.
גבולות של מדגם שש הרצות
שלוש הסתייגויות כנות.
המדגם קטן. שש הרצות תוחמות את הפיזור באופן רופף. הן מבססות שהחפיפה בין הרצות חלקית ושזוגות עם אפס חפיפה מתרחשים; הן לא נותנות רווח סמך לקטגוריה שלכם.
התוצאות תלויות בזמן. ההרצות האלה בוצעו ב-12 בספטמבר 2026 מול מודלים חיים. גם המודלים וגם תוצאות החיפוש שמתחתם משתנים.
הדומיינים המצוטטים הם מדגם של שאילתה מסחרית אחת. צורת שאלה שונה, כמו שאלת השוואה או שאלת איך, תפיק דפוס ציטוט שונה. המהלך המועיל הוא להריץ את אותו עיצוב על עשר השאילתות החשובות לכם ביותר מסחרית ולרשום מה הקטגוריה שלכם עושה.
שאלות נפוצות
כמה הרצות אני צריך לפני שמספר נראות ב-AI הופך למשמעותי? שש היא הרצפה המעשית לשאילתה בודדת, והמספר צריך להיות מדווח כספירה מתוך הרצות ולא כמיקום. אם שאילתה מניעה החלטות הכנסה, שתים עשרה הרצות נותנות קריאה הדוקה יותר תמורת כמה דולרים.
האם זה אומר שמעקב נראות ב-AI לא שווה עשייה? זה אומר שמעקב מדגם בודד לא שווה. השונות היא הממצא. גשש שמדווח "צוטט ב-4 מתוך 6 הרצות, המקורות השתנו ב-12 דומיינים מאז החודש שעבר" מתאר מערכת אמיתית שמתחרה בה מתחרה.
למה שאילתה אחת החזירה אפס ציטוטים? המודל השיב מידע עצמי במקום לבצע חיפוש מקורות. זו תכונה של השאלה, לא כשל של האתר שלכם. עקבו אחריה כלא רלוונטי ולא כאפס.
האם לעקוב אחרי ChatGPT, Claude ו-Gemini בנפרד? כן. בהשוואה שלנו על שלוש הרצות, שני המודלים חפפו בארבעה בלבד מתוך תשעה מוצרים שנקבו. ממוצע ביניהם מסתיר החלטה ברמת התוכנית לגבי איזה עוזר שווה אופטימיזציה קודם.
אפשר להפחית את השונות על ידי הורדת הטמפרטורה של המודל? חלקית, וכדאי לבדוק על השאילתות שלכם. אבל מערך הציטוטים מונע גם על ידי מדד החיפוש, שאותו אתם לא שולטים בו. מספר ההרצות הוא המנוף האמין יותר.
עמדת Auspia: אם אתם בונים מעקב נראות ב-AI ברבעון הזה, בנו את יומן ההרצות לפני לוח המחוונים. לוח המחוונים הוא בחירת תצוגה. יומן ההרצות הוא המדידה. התחילו עם עשר שאילתות, שש הרצות כל אחת, מאוחסנות מילה במילה, ותלמדו בשבוע אחד יותר ממה ששנה שלמה של בדיקת מדגם בודד תספר לכם.
מחבר/ת: Ethan Marlowe, הובלת מדידת GEO על פני יותר מ-500 שאילתות ב-Auspia. כותב על מעקב שאילתות, דוחות ציטוטים, ולוחות מחוונים של נראות ששורדים מפגש עם מחזור מדידה אמיתי.