Google Search Console के MCP सर्वर वह तरीका हैं जिससे कोई एजेंट आपका सर्च डेटा CSV निर्यात किए बिना पढ़ सकता है। यह आसान हिस्सा है। मुश्किल हिस्सा सर्वरों को एक-दूसरे से अलग पहचानना है, क्योंकि वे सब अपना परिचय एक ही तरह देते हैं, और फ़र्क़ तभी दिखता है जब आप पूछें कि वे असल में क्या कर सकते हैं।
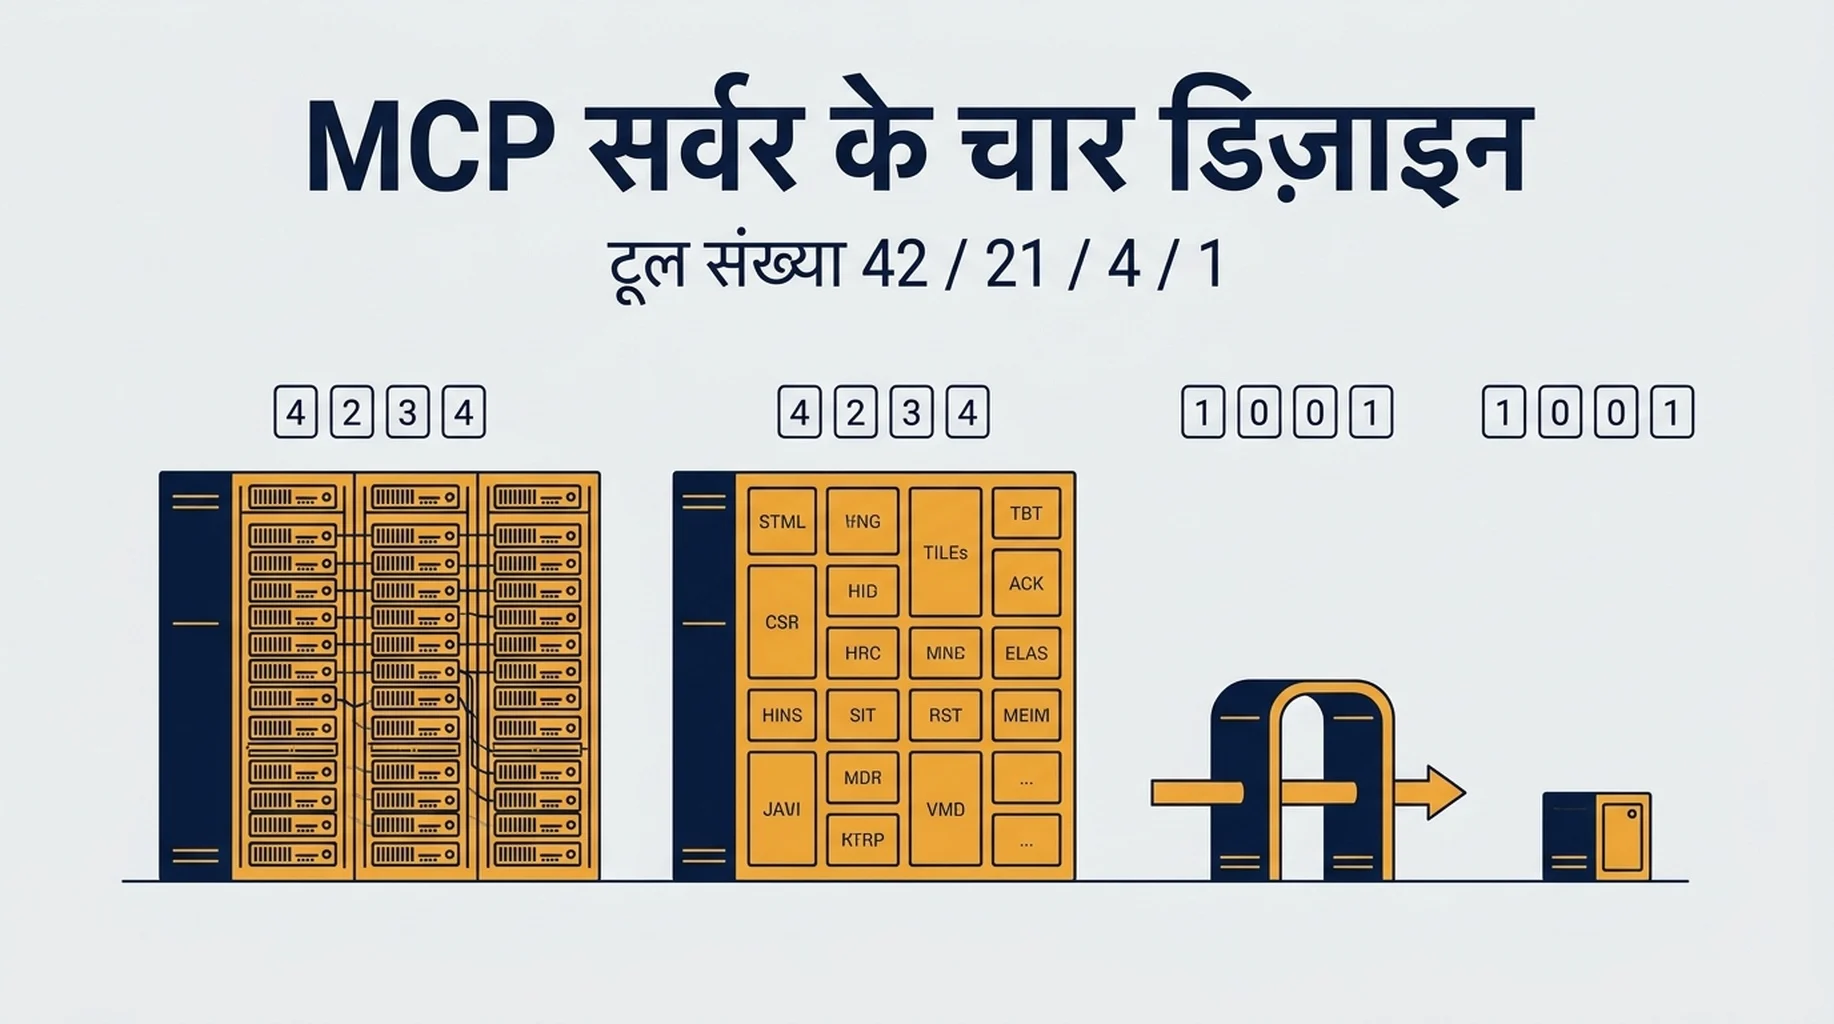
तो हमने पूछा। 12 सितंबर 2026 को हमने चार प्रकाशित SEO MCP सर्वर जोड़े, हर एक को tools/list अनुरोध भेजा, और जो लौटा उसे गिना। संख्याएँ थीं 42, 21, 4 और 1।
यह फ़ासला गुणवत्ता की रैंकिंग नहीं है। यह एक डिज़ाइन निर्णय है, और यह बदल देता है कि एजेंट क्या कर सकता है, आपके कॉन्टेक्स्ट पर उसकी क्या कीमत पड़ती है, और आपका कितना डेटा आपकी सीमा से बाहर जाता है।
हमने क्या जाँचा, और कैसे
तरीक़ा: हर सर्वर ठीक वैसे ही चलाया गया जैसा उसका अपना दस्तावेज़ कहता है — मानक इनपुट-आउटपुट से, या HTTP से जब दस्तावेज़ ने वह मोड बताया। हमने MCP का initialize हैंडशेक भेजा, फिर tools/list, और टूल की संख्या तथा नाम दर्ज किए। API कुंजियाँ हमने कहीं इस्तेमाल नहीं कीं, सिवाय उन जगहों के जहाँ सर्वर बिना कुंजी शुरू होने से मना कर रहा था।
सर्वर | संस्करण | लौटाए गए टूल | टूल सूची के लिए प्रमाणीकरण चाहिए? |
|---|---|---|---|
Ahrefs MCP | 0.0.11 | 42 | नहीं |
mcp-gsc | 0.3.2 | 21 | नहीं |
DataForSEO MCP | 3.1.1 | 4 | हाँ, HTTP से |
seo-mcp-server | 3.0.5 | 1 | नहीं |
एक सर्वर, किसी तीसरे पक्ष का Search Console पैकेज, हमारी 50 सेकंड की खिड़की में हैंडशेक पूरा नहीं कर सका, इसलिए उसे अंक देने के बजाय बाहर रखा गया। टूल सूचियाँ हर रिलीज़ में बदलती हैं, तो इन संख्याओं को किसी एक सुबह की तस्वीर मानिए, किसी विक्रेता का स्थायी गुण नहीं।
चार डिज़ाइन, और हर एक किस काम का
रैपर (21 टूल)। mcp-gsc Search Console API लेता है और हर रिपोर्ट को एक नामित टूल में लपेटता है। उसकी सूची किसी सर्च विश्लेषक के कार्य विवरण की तरह पढ़ी जाती है: search_analytics, inspect_url, top_movers, quick_wins, cannibalization, content_decay, device_country_breakdown, ctr_anomalies, weekly_seo_report, indexing_coverage. फ़ायदा यह है कि मॉडल को कभी क्वेरी बनानी ही नहीं पड़ती। क़ीमत यह है कि किसी रिपोर्ट में क्या होना चाहिए, इस पर आप किसी और की राय विरासत में ले लेते हैं, और सूची से बाहर कुछ माँगा नहीं जा सकता।
पूरे प्लेटफ़ॉर्म का दर्पण (42 टूल)। Ahrefs का सर्वर उस विक्रेता की उत्पाद सतह को एंडपॉइंट दर एंडपॉइंट खोल देता है: rank-tracker-overview, rank-tracker-competitors-overview, keywords-explorer-matching-terms, keywords-explorer-volume-history, batch-analysis. यह हमारी मापी गई सबसे समृद्ध सूची है और कॉन्टेक्स्ट के लिहाज़ से सबसे महँगी भी, क्योंकि हर टूल परिभाषा लोड होती है, चाहे वह काम से जुड़ी हो या नहीं। यही सौदा सबसे साफ़ भी दिखाती है: क्षमता की चौड़ाई के बदले हर प्रॉम्प्ट पर स्थायी कर।
गेटवे (4 टूल)। DataForSEO का v3 सर्वर उलटी दिशा में गया। वह docs_index, docs_list_sections, docs_search, और एक सामान्य टूल api_request खोलता है। हर एंडपॉइंट को नाम देने के बजाय वह मॉडल को सिखाता है कि दस्तावेज़ ढूँढो और फिर प्रमाणित कॉल करो। चार टूल सौ से ज़्यादा एंडपॉइंट वाली API को ढक लेते हैं, और मॉडल विशिष्टता की क़ीमत कॉल के समय चुकाता है, लोड के समय नहीं। हमारी जाँच में HTTP एंडपॉइंट ने बिना क्रेडेंशियल invalid auth लौटाया और क्रेडेंशियल के साथ ठीक जवाब दिया। यही मनचाहा व्यवहार है।
एक-टूल सर्वर (1 टूल)। seo-mcp-server ठीक एक टूल लौटाता है, ai_content_detect. छोटे सर्वर में कोई बुराई नहीं, पर उसे अपने बारे में ईमानदार होना चाहिए: यह एक डेमो या एक अकेली जाँच है, SEO का कार्यक्षेत्र नहीं। अगर आप इसे साप्ताहिक रिपोर्ट की उम्मीद में इंस्टॉल करेंगे, तो निराशा ऐसी होगी जिसका ज़िक्र इंस्टॉल निर्देशों में कहीं नहीं था।
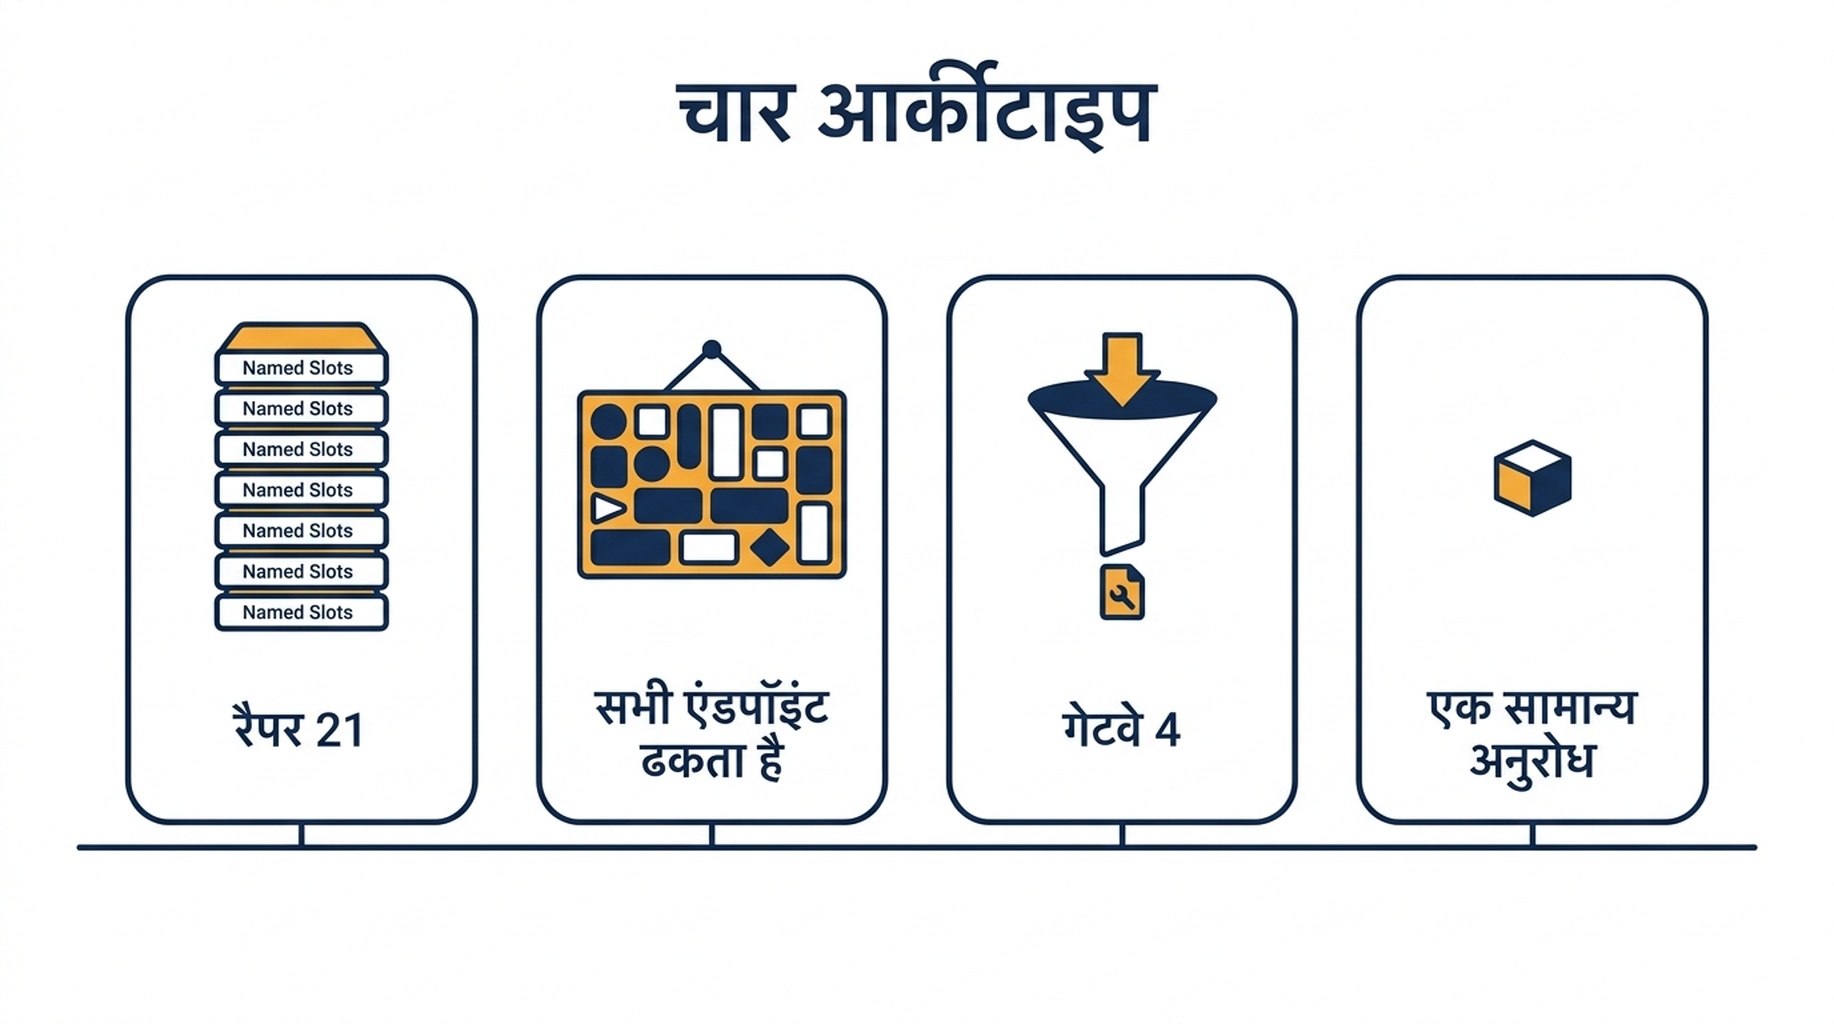
चार आर्कीटाइप। इनमें से दो असली रिपोर्टिंग काम तक बढ़ते हैं, और हर एक अलग दिशा में बढ़ता है।
टूल की संख्या गलत शीर्षक क्यों है
एक ही संख्या वाले दो सर्वर बिल्कुल अलग बर्ताव कर सकते हैं, क्योंकि मायने सीमा का आकार रखता है, अंक नहीं।
रैपर आपके सवाल पहले ही तय कर देता है। यह तब सचमुच काम का है जब नीचे की API पेचीदा हो और रैपर असली विशेषज्ञता दर्ज करता हो, और mcp-gsc की सूची ठीक यही करती है। यह उस पहले पल में बंधन बन जाता है जब आपका सवाल सूची में न हो, और इसे घुमाने का कोई रास्ता नहीं।
गेटवे लगभग कुछ तय नहीं करता और काम मॉडल पर डाल देता है। यह ज़्यादा लचीला और ज़्यादा नाज़ुक है। मॉडल कहीं भी पहुँच सकता है, यानी वह गलत एंडपॉइंट पर पहुँच सकता है, जवाब का आकार गलत पढ़ सकता है, और यह पता लगाने में तीन टूल कॉल खर्च कर सकता है कि जो फ़ील्ड वह चाहता था उसका नाम कुछ और है। आसान सवालों पर रैपर तेज़ है। नए सवालों पर जवाब सिर्फ़ गेटवे देता है।
व्यावहारिक परीक्षा "कितने टूल हैं" नहीं, बल्कि "क्या सर्वर वह चीज़ खोलता है जो मैं हर हफ़्ते पूछता हूँ" है। रैंक ट्रैकिंग के काम में वह आम तौर पर तारीख़ और डिवाइस विभाजन वाली सर्च एनालिटिक्स, साथ में URL निरीक्षण होता है। रैपर और गेटवे दोनों इसे ढकते हैं। 42 टूल वाला सर्वर इसे ढकता है, और साथ में वे चालीस और चीज़ें ढकता है जो आप आज इस्तेमाल नहीं करेंगे।
वे जाँचें जो कुछ भी इंस्टॉल करने से पहले सचमुच मायने रखती हैं
अनुमति का दायरा पढ़िए, सुविधा सूची नहीं। Search Console सर्वर वह विरासत में लेते हैं जो आपकी OAuth अनुमति देती है। केवल-पढ़ने की अनुमति, जो प्रॉपर्टी सूचीबद्ध कर सके और सर्च एनालिटिक्स खींच सके, रिपोर्टिंग और निगरानी के लिए काफ़ी है। जो भी सेटिंग बदलने, साइटमैप भेजने या इंडेक्सिंग माँगने का प्रस्ताव करता है वह आपकी प्रॉपर्टी में लिख रहा है, और वह "इस रेपो पर स्टार हैं" से कहीं ऊँची कसौटी का हक़दार है।
जाँचिए कि आपकी मशीन से क्या निकलता है। API क्रेडेंशियल किसी विक्रेता तक पहुँचाने वाला गेटवे उस स्थानीय रैपर से अलग जोखिम प्रोफ़ाइल रखता है जो आपके अपने टोकन से सीधे Google API से बात करता है। दोनों ठीक हो सकते हैं। पर सिर्फ़ एक का मतलब है कि कोई तीसरा पक्ष आपका खींचा हर कीवर्ड देख रहा है।
खाली जवाब की जाँच चलाइए। सर्वर से ऐसी तारीख़ों की रेंज माँगिए जिसमें डेटा न हो, जैसे कोई ऐसी प्रॉपर्टी जिसे आपने अभी लॉन्च नहीं किया। अच्छी तरह बना सर्वर खाली परिणाम लौटाता है। खराब बना सर्वर त्रुटि लौटाता है, और त्रुटि पाने वाला एजेंट अक्सर गुम डेटा के लिए कोई विश्वसनीय-सा स्पष्टीकरण गढ़ लेता है। यह एक जाँच किसी भी कोड समीक्षा से ज़्यादा समस्याएँ पकड़ती है।
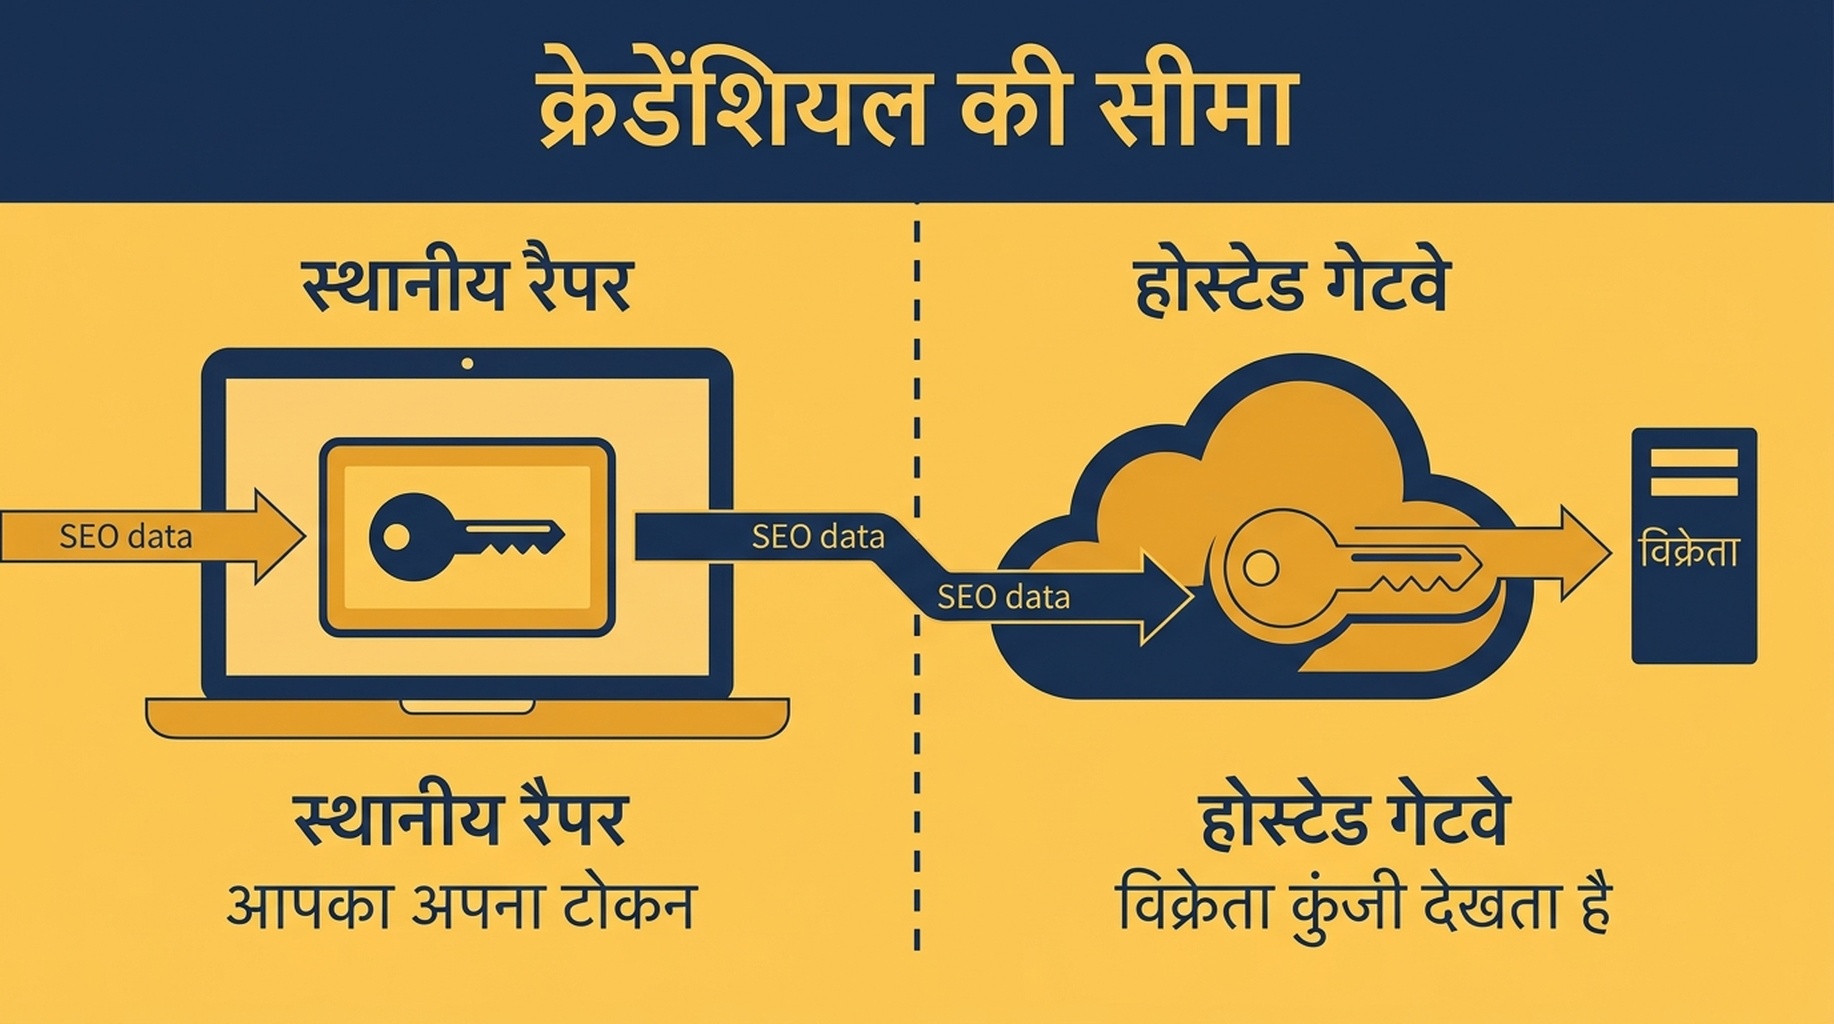
दो सर्वर ठीक एक ही रिपोर्ट खोल सकते हैं और इस बात में बिल्कुल अलग हो सकते हैं कि आपके क्रेडेंशियल कौन देखता है।
देखिए कि टूल के फ़ेल होने पर क्या होता है। दर सीमाएँ असली हैं: Search Console हर प्रॉपर्टी के लिए प्रति मिनट 1,200 क्वेरी की अनुमति देता है, और एजेंट के दोबारा प्रयासों की एक लहर अकेले उसे ख़त्म कर देती है। जो सर्वर सीमा दिखाता है वह काम का है। जो चुपचाप कुछ नहीं लौटाता वह आपके एजेंट को सिखा देता है कि आपके इंप्रेशन शून्य हैं, और वह त्रुटि से भी बुरा है। यही सीमा किसी भी ख़ुद बनाए रैंक ट्रैकर का आकार तय करती है, इसलिए अनुरोध बजट कॉन्फ़िग फ़ाइल में एक पंक्ति का हक़दार है।
इसे किसी एजेंट से जोड़ना
कॉन्फ़िगरेशन छोटा हिस्सा है। मूल्य मिलेगा या नहीं, यह जगह तय करती है।
{
  "mcpServers": {
    "gsc": {
      "command": "npx",
      "args": ["-y", "mcp-gsc"],
      "env": { "GSC_CREDENTIALS": "/path/to/service-account.json" }
    },
    "dataforseo": {
      "url": "http://localhost:3000/mcp",
      "headers": { "Authorization": "Basic <base64 login:password>" }
    }
  }
}
हमारे तीन नियम, उस दर्द के हिसाब से क्रम में जो वे बचाते हैं।
हर डेटा स्रोत के लिए एक सर्वर। दो सर्वर जो दोनों दावा करें कि रैंक के सवालों का जवाब देते हैं, दो जवाब बनाएँगे, और एजेंट सही नहीं बल्कि ज़्यादा विश्वसनीय सुनाई देने वाला चुनेगा। Search Console रैपर को दीजिए, तीसरे पक्ष का SERP डेटा गेटवे को, और लिखिए कि कौन-सा फ़ील्ड किसके लिए प्रामाणिक है।
रिपोर्टिंग की परिभाषा सर्वर के बाहर रखिए। टूल एजेंट को डेटा तक पहुँच देते हैं। वे उसे आपकी परिभाषाएँ नहीं देते: कौन-सी प्रॉपर्टी गिनी जाती हैं, कौन-सी क्वेरी राजस्व चलाती है, और रैंक अवधि का औसत है या दैनिक तस्वीर। वे उस निर्देश फ़ाइल में जाती हैं जिसे एजेंट कुछ भी कॉल करने से पहले पढ़ता है, और वहीं काम का सारांश और आत्मविश्वासी ग़लती का फ़र्क़ है। साप्ताहिक रिपोर्ट का वर्कफ़्लो उन परिभाषाओं का जीवित उदाहरण है जो टूल के बाहर रहती हैं।
पहला रन हाथ से जाँचिए। सर्वर से एक हफ़्ते की सर्च एनालिटिक्स खींचिए और Search Console के इंटरफ़ेस में उसी हफ़्ते से मिलाइए। संख्याएँ मेल न खाएँ तो आपके पास तारीख़ सीमा या एट्रिब्यूशन की समस्या है, और उसके बाद की हर स्वचालित रिपोर्ट उसे विरासत में लेगी।
Auspia का नज़रिया: MCP का सवाल यह नहीं कि कौन-सा सर्वर सबसे अच्छा है। यह है कि आप अपने एजेंट और अपने डेटा के बीच कैसी सीमा खींचना चाहते हैं। रैपर वह अनुबंध है जो आप पहले से स्वीकार करते हैं। गेटवे वह ज़िम्मेदारी है जो आप हर बार स्वीकार करते हैं। इनमें से कौन व्यापक रैंक वर्कफ़्लो में बैठता है, यह एजेंट क्षमता गाइड काम के हिसाब से क्रमबद्ध करती है। दोनों जायज़ हैं, और जलता वह दल है जिसने बिना यह समझे चुन लिया कि वह चुन रहा है।
अक्सर पूछे जाने वाले सवाल
क्या Google Search Console के लिए कोई आधिकारिक MCP सर्वर प्रकाशित करता है? 12 सितंबर 2026 तक हमें पैकेज रजिस्ट्रियों में कोई नहीं मिला। हमने जो Search Console सर्वर जाँचे वे आधिकारिक API के ऊपर बैठे समुदाय या विक्रेता के प्रोजेक्ट हैं। आधिकारिक API की परत है, जो अपने आप में कोई दोष नहीं, पर इसका मतलब है कि वह सर्वर एक रखरखाव निर्भरता है जिसे आप चुनते हैं।
एक एजेंट सत्र के लिए कितने MCP टूल बहुत ज़्यादा हैं? कोई तय संख्या नहीं। व्यावहारिक सीमा यह है कि टूल सूची आपके निर्देशों को कॉन्टेक्स्ट विंडो से बाहर धकेल रही है या नहीं। जिस काम को दो टूल चाहिए उसके लिए 42 टूल वाला सर्वर लोड करने का मतलब है कि हर कॉल पर आप चालीस परिभाषाओं की क़ीमत चुका रहे हैं। नियमित काम के लिए संकरे सर्वर लोड कीजिए और खोजबीन के लिए चौड़े।
क्या एजेंट बिना सेवा खाते के Search Console के साथ MCP इस्तेमाल कर सकता है? कर सकता है, बशर्ते सर्वर ने OAuth प्रवाह लागू किया हो और आपने उसे एक बार स्थानीय तौर पर पूरा किया हो। सेवा खाते का रास्ता स्वचालित करना आसान और किसी व्यक्ति को सौंपना मुश्किल है, इसलिए दल आम तौर पर दोनों चलाते हैं: निर्धारित रन के लिए सेवा खाता और बीच-बीच के काम के लिए OAuth।
आपने कौन-सा सर्वर रखा? रैपर, साप्ताहिक रिपोर्ट के लिए, क्योंकि सवाल ज्ञात हैं। गेटवे उन सब कामों के लिए इंस्टॉल रहता है जिन्हें ऐसा डेटा स्रोत चाहिए जो रैपर नहीं ढकता, और वह दिलचस्प काम का ज़्यादातर हिस्सा है और नियमित काम का कोई नहीं।
लेखक: Julian Mercer, Auspia में MCP एकीकरण शोधकर्ता, 40 से ज़्यादा एजेंट टूलचेन पर काम। वे एजेंट प्रोटोकॉल, टूल की सीमाओं, और भाषा मॉडलों को जीवित डेटा से जोड़ने की परिचालन लागत पर लिखते हैं।