מה יהיה לכם בסוף התהליך
בסיומו של התהליך הזה יהיה לאזור ה-Cloudflare שלכם מדיניות מפורשת ומכוונת לשלוש קטגוריות נפרדות של תעבורת בוטים של בינה מלאכותית — חיפוש (Search), סוכן (Agent) ואימון (Training) — במקום ברירת המחדל שנחתה על הדומיין שלכם. תדעו בדיוק אילו סורקים מותרים ואילו חסומים, ובאילו עמודים, ויהיו לכם קובץ robots.txt וכלל אכיפה בקצה שמתאימים זה לזה בפועל.
למי זה מיועד: לכל מי שמפעיל אתר שעובר דרך Cloudflare — מוציאים לאור, אתרי שיווק של SaaS, חנויות איקומרס, בלוגים — ורוצה להחליט בעצמו אם מערכות בינה מלאכותית יכולות להתאמן על התוכן שלו, לסכם אותו או לגלוש בו באמצעות סוכן, במקום לרשת ברירת מחדל של הפלטפורמה.
דרישות מוקדמות:
- דומיין שעובר דרך Cloudflare (כל מסלול, כולל החינמי; חלק מהשלבים למטה זמינים רק במסלולים בתשלום ומסומנים בהתאם)
- גישה ללוח הבקרה עם הרשאת עריכת הגדרות אבטחה ברמת הדומיין לכל הפחות
- 20 עד 30 דקות לשלבי הביקורת וההגדרה; ואחר כך כמה דקות ביום או בשבוע לניטור
הגדרת סיום: הגדרות האבטחה באזור שלכם מציגות בחירה מכוונת (ולא ברירת מחדל) עבור חיפוש, סוכן ואימון; קובץ ה-/robots.txt החי משקף את הבחירה הזו; ואימתתם ב-AI Crawl Control שהבוטים שהתכוונתם לחסום אכן חסומים.
למה זה פתאום חשוב: מה השתנה ב-15 בספטמבר
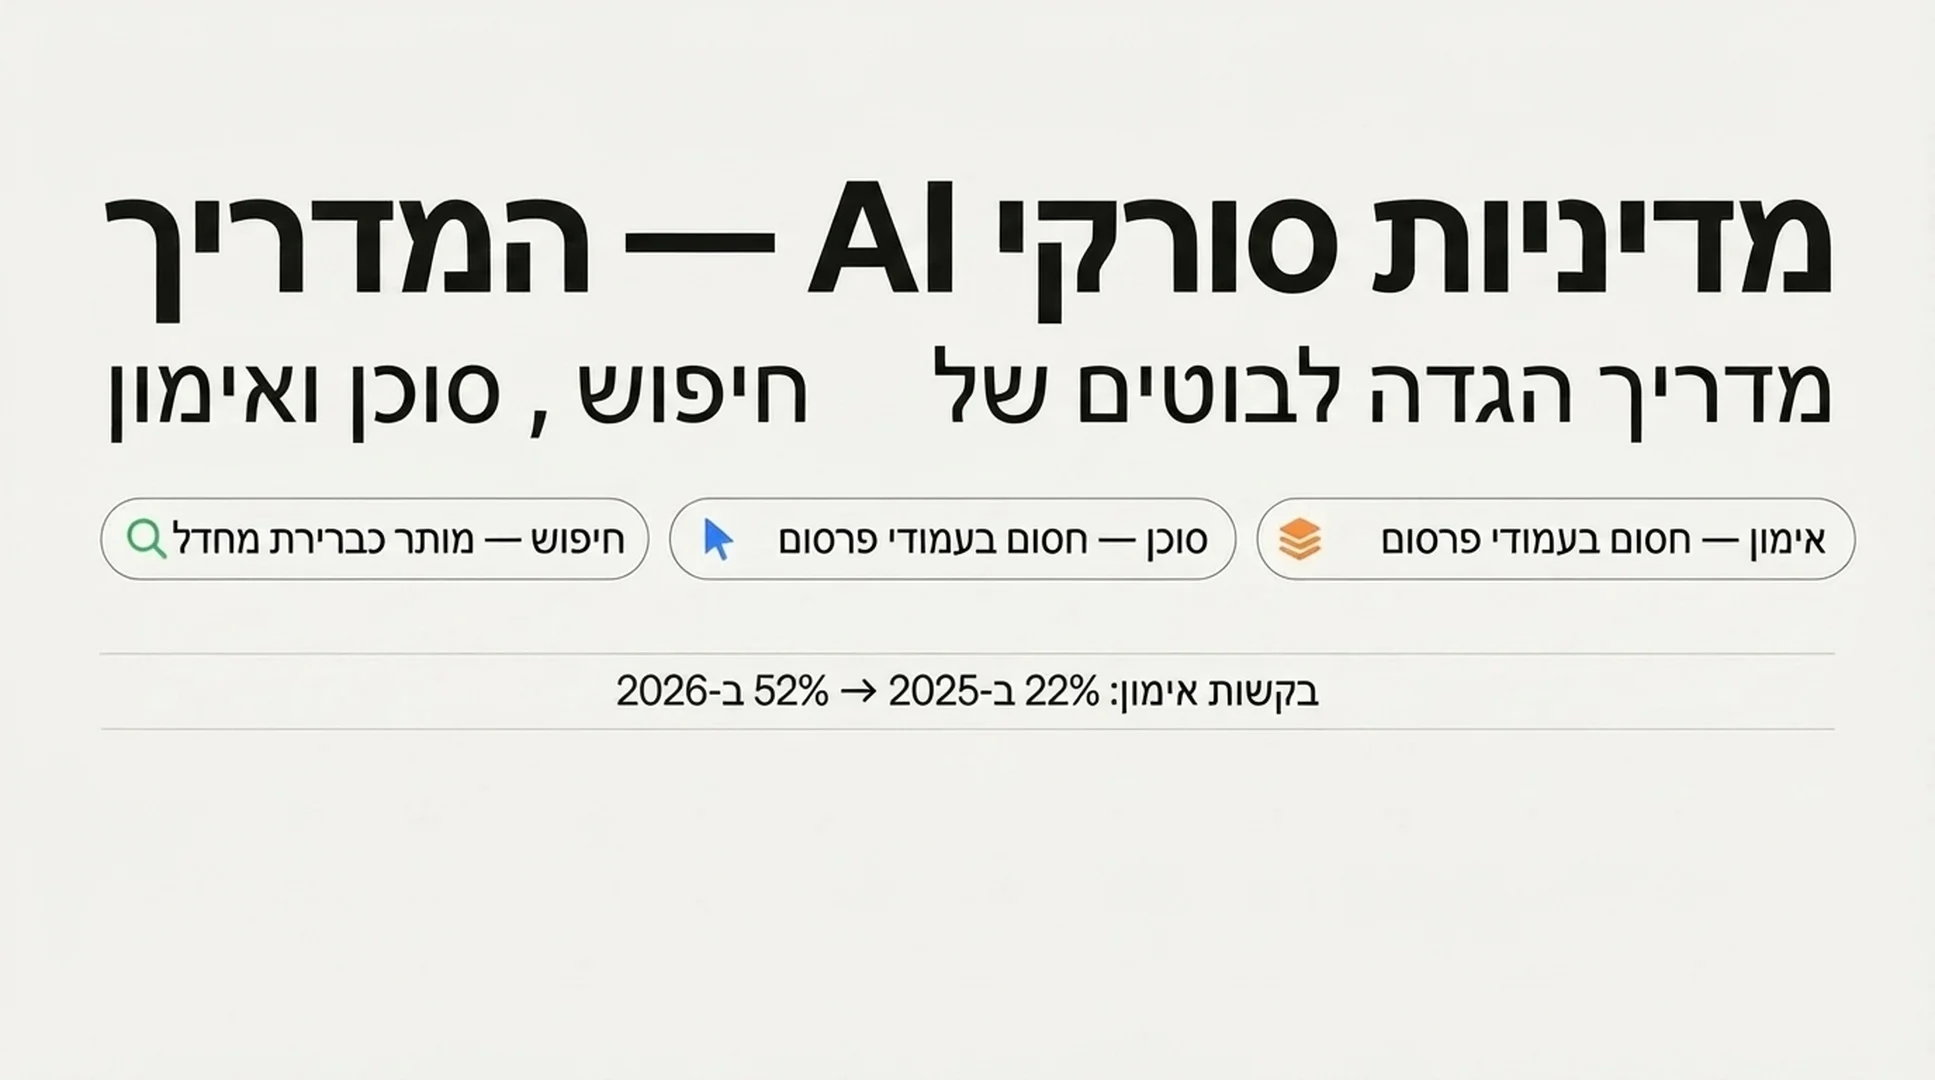
Cloudflare בנתה את בקרות תעבורת הבינה המלאכותית בשלבים, החל מתוספת Content Signals Policy לקובץ robots.txt בספטמבר 2025, וכלה בהשקת "Content Independence Day" ב-1 ביולי 2026, שהפרידה לראשונה בין התנהגות בוטים לשלוש קטגוריות בעלות שם, במקום מתג גס אחד של "בינה מלאכותית או לא":
- חיפוש (Search) — סריקה שבונה אינדקס חיפוש ומחזירה בהמשך קישורים או קטעים קצרים. כך Cloudflare מנסחת זאת: זו התעבורה שאמורה להביא לכם הפניות.
- סוכן (Agent) — פעילות אוטומטית בזמן אמת שפועלת בשם אדם ממש עכשיו, למשל עוזר צ'אט שמושך עמוד, או סוכן דפדפן שמשלים משימה.
- אימון (Training) — סריקה לצורך אימון או כיוונון עדין של מודל, שבה התוכן שלכם נספג באופן קבוע במשקולות המודל, במקום לחזור אליכם כקישור.
ב-15 בספטמבר 2026 שינתה Cloudflare את מה שקורה אוטומטית. עבור כל דומיין שמצטרף ל-Cloudflare בתאריך הזה או אחריו, אם האתר מסומן ככזה שמפיק הכנסות מפרסום, הגדרות ברירת המחדל הופכות להיות:
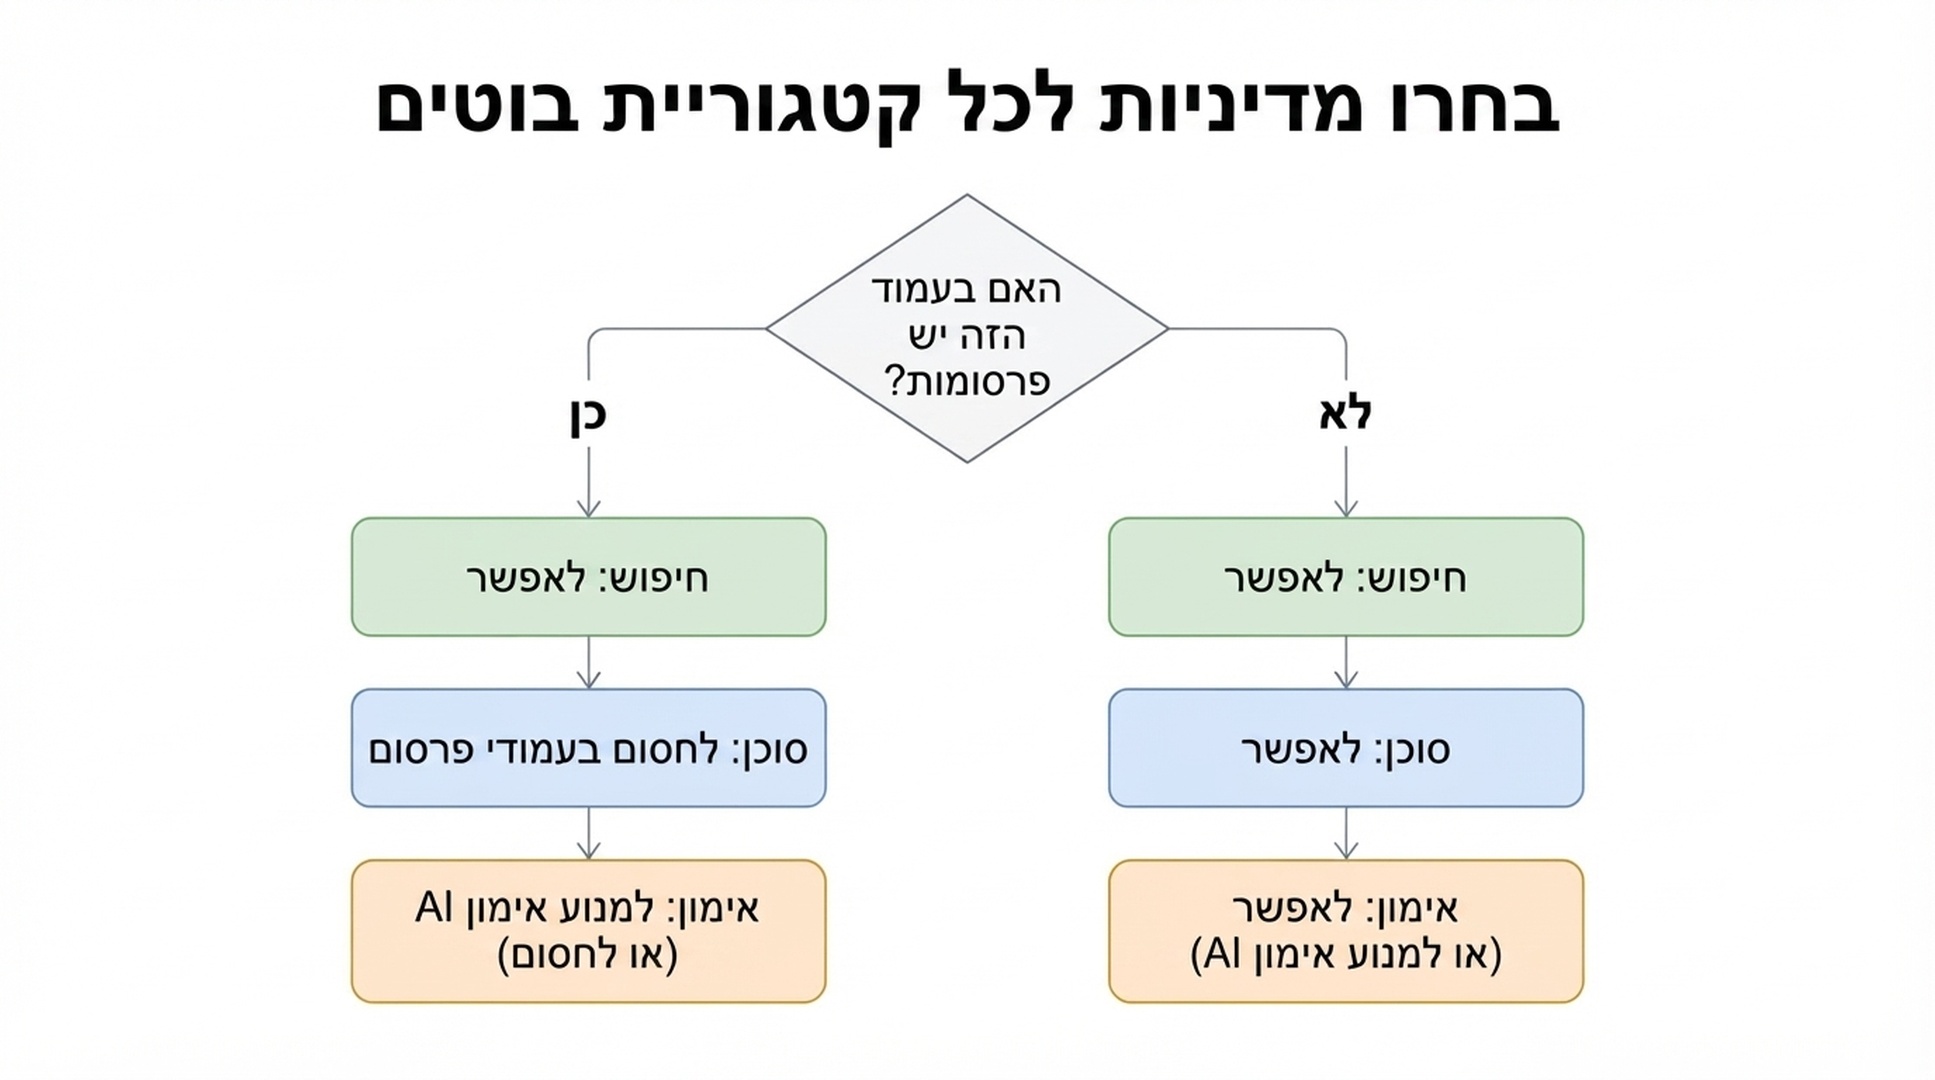
קטגוריה | ברירת מחדל בעמודים עם פרסום |
|---|---|
חיפוש (Search) | לאפשר |
סוכן (Agent) | לחסום בעמודים עם פרסומות |
אימון (Training) | למנוע אימון AI (Disallow AI Training) |
דומיינים חדשים בלי הכנסות מפרסום מקבלים ברירת מחדל של "לאפשר" בכל שלוש הקטגוריות. לקוחות קיימים לא הועברו בשקט — Cloudflare נתנה חלון זמן לפני ה-15 כדי לבטל את ההצטרפות דרך לוח הבקרה, וכללי ההעברה בפועל לכל דומיין היו מפורטים יותר מברירת מחדל חדשה אחת (מכוסה בהמשך).
הסיבה לכך שעמודים שמגישים פרסומות מקבלים את ברירת המחדל המחמירה היא שפרסומת בעמוד היא סימן לכך שציפו שבן אדם יראה אותו. לפי המספרים של Cloudflare עצמה, ביוני 2026 סורקים רב-שימושיים — אלה שמערבבים אינדוקס חיפוש, משיכת סוכן ואימון תחת סוכן משתמש אחד — היוו יותר מ-36% מתעבורת הסורקים המאומתת, הקטגוריה הגדולה ביותר. וחלקו של אימון הבינה המלאכותית מכלל בקשות הסריקה ברשת של Cloudflare עלה מכ-22% בערך באביב 2025 ל-52% ביוני 2026. זו התעבורה שהשינוי הזה מכוון אליה.
לפני שמתחילים: שלושה דברים שצריך להבין על הקטגוריות
1. חלק מהסורקים הם "רב-שימושיים" ומתנהגים אחרת תחת חסימה לעומת מניעת אימון. Googlebot, Bingbot ו-Applebot ממלאים כל אחד שני תפקידים — הם סורקים גם עבור חיפוש וגם עבור אימון תחת סוכן משתמש אחד. Cloudflare מכנה את Apple, Google ו-Microsoft מפעילות "Accountable" (בנות-דין) מפני שהן עומדות בארבעה תנאים: הן מכבדות העדפת robots.txt של אי-אימון, מציעות דרך ביטול לסיכומי בינה מלאכותית, מספקות שקיפות ברמת הכתובת לגבי מה שימש לאימון, ומסוגלות להראות שביטול ההצטרפות לאימון לא פוגע בנוכחותכם בחיפוש.
2. "מנוע אימון AI" ו"חסימה" הם לא אותה הגדרה, וההבדל ביניהם הוא כל העניין. מניעת אימון AI מפרסמת העדפת Disallow בקובץ robots.txt שמופנית לסוכני משתמש ייעודיים לאימון (כמו Google-Extended ו-Applebot-Extended). סורקים רב-שימושיים בנים-דין קוראים את ההעדפה הזו וממשיכים מרצונם לסרוק למען החיפוש תוך דילוג על האימון — כך הנוכחות שלכם בחיפוש נשמרת. כל סורק אימון אחר שאינו בן-דין נחסם לחלוטין בקצה, וזה לא נוגע בחיפוש מפני שאותן מפעילות מריצות בוטים נפרדים ומיוחדים לאימון. לעומת זאת, חסימה רגילה חוסמת כעת גם את Googlebot, Bingbot ו-Applebot עצמם — כלומר התוכן שלכם נעלם גם מתוצאות החיפוש שלהן. אם אתם רוצים שהאימון ייעלם אבל החיפוש יישאר, ההגדרה הרצויה היא מניעת אימון AI ולא חסימה.
3. Bing עדיין לא מכבדת את העדפת האימון ב-robots.txt. Applebot ו-Googlebot מכבדים היום הנחיית Disallow ייעודית לאימון. Microsoft מסרה שהיא בונה מקבילה עבור Bingbot, ביעד של תחילת 2027. עד אז, בחירה במניעת אימון AI תבקש את ההעדפה בקובץ ה-robots.txt שלכם, אבל התנהגות הסריקה של Bing לצורכי אימון לא תשתנה רק מהאות הזה — תג המטא NOARCHIVE של Bing או כלי ה-Content Removal שלו הם המנופים הזמניים אם החשיפה לאימון דרך Bing מטרידה אתכם במיוחד.
שלב 1: גלו היכן האתר שלכם באמת נחת
אל תניחו שאתם יודעים מהי ההגדרה הנוכחית שלכם — ודאו אותה.
פעולה: בלוח הבקרה של Cloudflare פתחו את הדומיין, עברו אל Security → Settings וחפשו את בקרות מדיניות בוטי הבינה המלאכותית (ממשק שלוש הקטגוריות החדש החליף את המתג היחיד הישן "Block AI Bots", אך בחשבונות שטרם הועברו ייתכן שעדיין יוצג המתג הישן). בנפרד, משכו את קובץ ה-robots.txt החי בדפדפן או עם curl https://yourdomain.com/robots.txt וחפשו בלוק שמתחיל בסמן הערה בניהול Cloudflare; אפשר גם להצליב עם בודק סורקי ה-AI ב-robots.txt של Auspia כדי לראות איך הכללים הנוכחיים נקראים בעיני סורקי בינה מלאכותית.
פלט צפוי: שלוש הגדרות, אחת לכל אחד מחיפוש, סוכן ואימון, כשכל אחת מהן על אחד מהערכים: לאפשר / לחסום בעמודים עם פרסומות / לחסום (ומניעת אימון AI היא אפשרות רביעית שזמינה רק לאימון). קובץ ה-robots.txt החי צריך להציג מקטע בניהול Cloudflare שמפרט סוכני משתמש מסוימים ושורות Disallow / Content-Signal, אם Bot Preference Sync או robots.txt מנוהל מופעלים.
בדיקת איכות: ודאו ששלוש ההגדרות תואמות את מה שהתכוונתם אליו באמת, ולא את מה שההעברה הניחה עבורכם. היגיון ההעברה המוצהר של Cloudflare עבור לקוחות קיימים: אם הפעלתם בעבר את המתג הישן "Block AI", הועברתם לאימון = מנוע אימון AI, חיפוש נשאר על לאפשר, וסוכן הוגדר ללחסום בעמודים עם פרסומות. אם הגדרתם בעבר את האימון עצמו ללחסום או ללחסום בעמודים עם פרסומות, הועברתם למנוע אימון AI. שתי דרכי ההעברה מניחות שרציתם לשמר את החיפוש — אם למעשה רציתם שהסורקים הרב-שימושיים ייעלמו לגמרי (כולל מהחיפוש), זה לא מה שיש לכם כעת, ואתם צריכים לבחור במפורש בחסימה.
מסלול התאוששות: אם הגדרות האבטחה מציגות רק מתג ישן יחיד "Block AI Bots" בלי פירוט לשלוש קטגוריות, החשבון שלכם טרם הועבר לבקרות החדשות. חפשו את "Configure AI bot policies" כמשטח הגדרות נפרד וחדש יותר; שם יושבות הבקרות המפורטות מעתה ואילך, לצד המתג הישן בתקופת המעבר.
שלב 2: החליטו על מדיניות לכל קטגוריה בנפרד, לא תשובה גורפת אחת
זהו שלב ההחלטה האמיתי. עברו על כל קטגוריה בנפרד.
חיפוש. כמעט אף אחד לא חוסם את זה — Cloudflare מדווחת שפחות מ-1% מהאתרים בוחרים לחסום בוטי חיפוש — מפני שאובדן נראות בחיפוש כמעט ולא משתלם. ברירת המחדל צריכה להיות לאפשר, אלא אם יש לכם סיבה מפורשת (למשל סביבת בדיקות, ארכיון מאחורי חומת תשלום) להשאיר אותו מחוץ לאינדקס החיפוש.
סוכן. אלה בוטים שפועלים בזמן אמת בשם אדם שמנסה לעשות משהו באתר שלכם ממש עכשיו — לבדוק מחיר, להשלים הזמנה, לשלוף עובדה לתוך תשובת צ'אט. חסימת תעבורת סוכנים בעמודים הממונטים שלכם היא הנימוק של ברירת המחדל החדשה: ביקור של סוכן לא מייצר את החשיפה הפרסומית שביקור של אדם היה מייצר. אם מודל העסקים שלכם תלוי בתשומת הלב האנושית הזו (מדיה, אתרי תוכן עם פרסום תצוגה), לחסום בעמודים עם פרסומות הוא עמדה הגיונית. אם אתם מעדיפים שסוכנים יוכלו להשלים משימות באתר שלכם גם בעמודי פרסומות — למשל אם תעבורה שמונעת על ידי סוכנים עדיין ממירה אצלכם — בחרו בלאפשר.
אימון. כאן נמצאת ההחלטה האמיתית, וכאן הטרמינולוגיה מבלבלת אנשים:
- בחרו במנוע אימון AI אם אתם רוצים לעצור את השימוש בתוכן שלכם לאימון מודלים תוך שמירה על הנוכחות שלכם במוצרי החיפוש של Google, Bing ו-Apple (ובהינתן הפיגור הנוכחי של Bing, הבינו זאת כ"שמור היום אצל Google ו-Apple, ממתין אצל Bing"). זהו המסלול האמצעי המומלץ של Cloudflare, וזה שנבנה במיוחד עבור הפשרה בין חיפוש לאימון.
- בחרו בלחסום רק אם אתם מוכנים לאבד לחלוטין את סריקת החיפוש של Googlebot, Bingbot ו-Applebot, כמחיר של חסימת התנהגות מצב האימון שלהן גם כן. זו האפשרות המחמירה כעת — נכון ל-15 בספטמבר, חסימה חלה גם על סורקים רב-שימושיים, וזה לא היה המצב קודם.
- בחרו בלאפשר רק אם אתם מקבלים ביודעין שהתוכן שלכם ישמש לאימון מודלים של בינה מלאכותית, למשל מפני שאתם רוצים חשיפה מקסימלית לציטוט בתשובות בינה מלאכותית ורואים בחשיפה לאימון פשרה מקובלת לשם כך.
פעולה: ב-Security → Settings → Configure AI bot policies הגדירו כל אחד משלושת התפריטים הנפתחים לפי החלטתכם.
פלט צפוי: לוח הבקרה אמור לשקף את הבחירה המפורשת שלכם בכל קטגוריה, ואם Bot Preference Sync מופעל — להתחיל לפרסם אוטומטית בלוק robots.txt תואם, בלי צורך בעריכה ידנית של הקובץ.
בדיקת איכות: קראו שוב את הבחירה שלכם באימון לנוכח המשפט האחד הזה: "האם אני רוצה לשמר נראות בחיפוש, או שלא אכפת לי?" אם לשמר — זו מניעת אימון AI, לא חסימה, ולא משנה כמה מפתה נשמעת המילה "לחסום" כשמדובר בעצירת אימון בינה מלאכותית.
מסלול התאוששות: אם בחרתם הגדרה ותעבורת החיפוש שלכם ירדה אחר כך, בדקו אם בחרתם בטעות בחסימה במקום במניעת אימון AI — זו הטעות העצמית הנפוצה ביותר בהגדרה הזו, כי השם גורם ל"לחסום" להישמע כמו האפשרות ש"עושה יותר", אבל באימון במיוחד היא עושה משהו שאולי לא רציתם (מאבדים גם את החיפוש).
שלב 3: הפעילו Bot Preference Sync כדי ש-robots.txt יתאים למה שהגדרתם
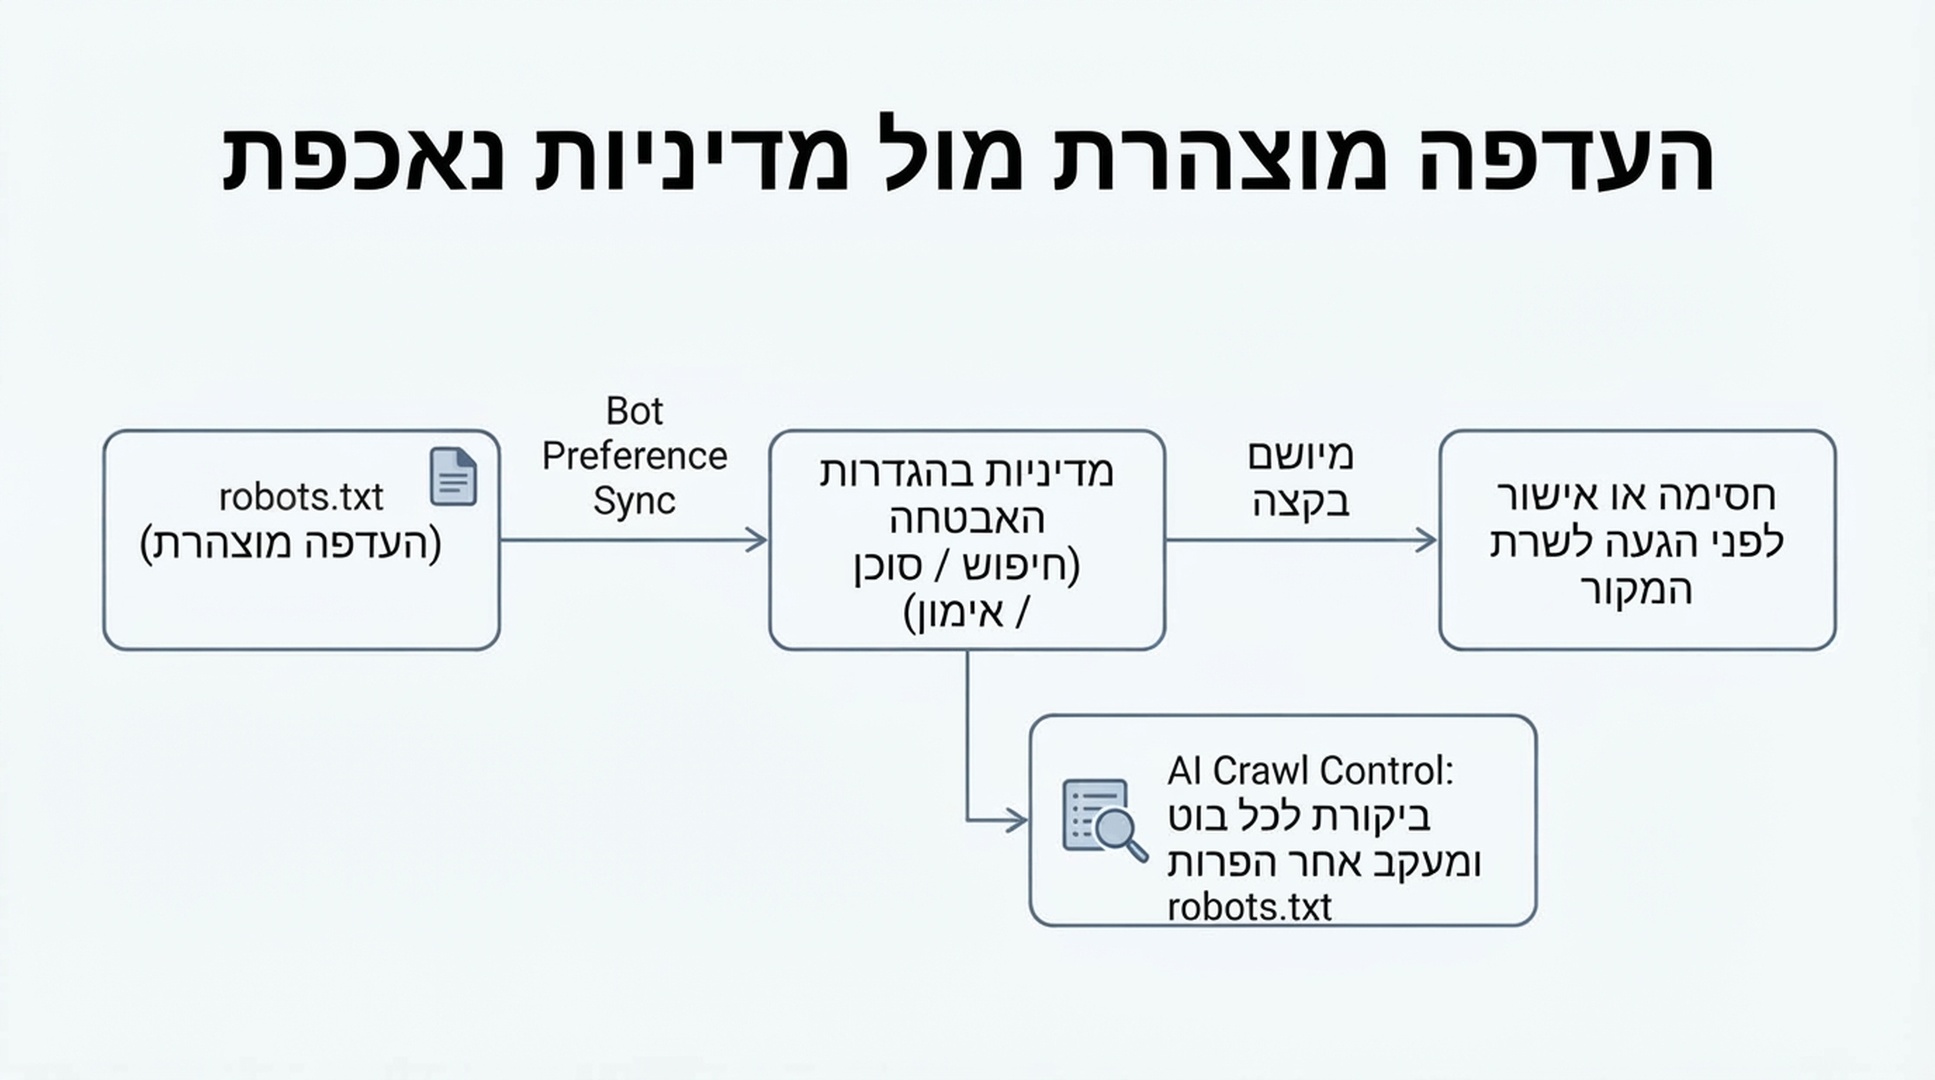
הגדרה בלוח הבקרה וקובץ robots.txt הם שתי מערכות שונות, וכאשר הן חולקות, חלק מהסורקים משתמשים באי-ההתאמה כתירוץ להתעלם מההעדפה שלכם. Bot Preference Sync של Cloudflare סוגר את הפער הזה בכך שהוא מייצר את קובץ ה-robots.txt ישירות מהבחירות שלכם בהגדרות האבטחה.
פעולה: באותו אזור של הגדרות מדיניות בוטי הבינה המלאכותית, הפעילו את Bot Preference Sync (הוא מופעל כברירת מחדל אצל לקוחות חדשים; לקוחות קיימים שמשתמשים בתכונת ה-robots.txt המנוהל הישנה יותר יתבקשו לסקור ולאשר במהלך ההעברה).
פלט צפוי: Cloudflare מוסיפה בלוק מנוהל בתחילת קובץ ה-robots.txt, עטוף בהערות # BEGIN Cloudflare Bot Preference Sync ו-# END, שמפרט את סוכני המשתמש המושפעים ואת כללי ה-Disallow שלהם — בלי למחוק כללים מותאמים אישית שכבר היו לכם בקובץ, שנשארים במקומם מתחת לבלוק המנוהל.
בדיקת איכות: משכו שוב את /robots.txt אחרי ההפעלה וודאו שהבלוק המנוהל מופיע ושהבחירות שלכם משלב 2 משתקפות בו — למשל, אם הגדרתם את האימון למנוע אימון AI, אמורים להופיע סוכני משתמש ייעודיים לאימון (כמו Google-Extended ו-Applebot-Extended) עם כללי Disallow, בעוד שסוכני המשתמש הכלליים Googlebot / Applebot / Bingbot נשארים לא חסומים לצורכי חיפוש.
מסלול התאוששות: אם יש לכם הסדר חד-פעמי מיוחד עם מפעיל סורק מסוים שהמדיניות הרוחבית של הקטגוריה תשבור (נניח הסכם רישוי תוכן בתשלום), כבו את Bot Preference Sync וערכו ידנית את קובץ ה-robots.txt שלכם במקום זאת — מתגי הקטגוריות נבנו למדיניות ברמת האזור כולו, לא לחריגים של מפעיל בודד.
שלב 4: ודאו שהמדיניות שלכם נאכפת בפועל, ולא רק מתבקשת
robots.txt הוא בקשה. הוא לא עוצר סורק שמחליט להתעלם ממנו ברמה הטכנית. זה השלב שאנשים מדלגים עליו, והוא זה שאומר לכם אם ההחלטה שלכם משלב 2 אמיתית או תיאורטית.
פעולה: פתחו את AI Crawl Control עבור האזור שלכם (זמין בכל המסלולים, כולל החינמי — איכות הזיהוי חזקה יותר במסלולים עם Bot Management, אבל תכונות הנראות עובדות בכל מקום). בדקו את לשונית Crawlers, שמפרטת כל בוט שהגיע לאתר שלכם יחד עם עמודת Robots.txt violations.
פלט צפוי: טבלה של בוטים עם מספרי בקשות ומונה הפרות לכל בוט. מונה הפרות שאינו אפס אצל בוט שהגדרתם למנוע או לחסום אומר שהבוט הזה מתעלם כעת מקובץ ה-robots.txt שלכם.
בדיקת איכות: עבור כל בוט שמציג הפרות, הסתכלו על מה הוא ניגש אליו בפועל תחת "Most popular paths" — מסונן לנתיבים שמסומנים — כדי לראות אם הוא נוגע בתוכן שבאמת חשוב לכם להגן עליו.
מסלול התאוששות: אם בוט מתעלם מההעדפה המוצהרת שלכם, robots.txt לבדו לא יעצור אותו. השתמשו בפעולה "Enforce robots.txt rules" ב-AI Crawl Control (שלעיתים מכונה בשם הפנימי שלה, Robotcop) כדי להמיר את הכללים המוצהרים שלכם לכלל WAF ממשי, שחוסם את הבוט שאינו מציית בקצה של Cloudflare לפני שהוא מגיע לשרת המקור שלכם — כך אתם עוברים מבקשת ציות לאכיפת ציות. שלב זה משתמש ב-WAF, ולכן הזמינות שלו תלויה בגישת ה-WAF של המסלול שלכם.
שלב 5: החליטו אם להפיק הכנסה במקום רק לחסום
אם ההחלטה שלכם לגבי אימון הייתה "בלי גישה לאימון", יש לכם אפשרות שנייה מעבר לחסימה גורפת: לגבות על זה כסף.
פעולה: אם זה מעניין אתכם, הירשמו לבטא הפרטית Pay Per Crawl של Cloudflare (דרך עמוד ההרשמה של Cloudflare, או דרך מנהל החשבון שלכם אם אתם לקוחות Enterprise). לאחר הפעלה ברמת החשבון (Manage Account → Settings → Pay Per Crawl → הגדירו את ה-Visibility של הדומיין ל-Visible), תוכלו לקבוע מחיר קבוע אחד לבקשה עבור האזור כולו, ולבחור לכל סורק אחד מהבאים: לאפשר (חינם), לחייב (חיוב לפי המחיר שלכם), או לחסום.
פלט צפוי: כאשר סורק שמזוהה דרך Web Bot Auth (בקשה חתומה ב-Ed25519 שמזהה את הסורק) מבקש עמוד שהגדרתם לחייב, הוא מקבל תגובת HTTP 402 Payment Required שנושאת כותרת crawler-price; אם הוא מנסה שוב בהסכמה לשלם, או שצירף מראש כותרת crawler-max-price שמכסה את המחיר שלכם, הוא מקבל את התוכן עם כותרת crawler-charged שמאשרת את הסכום שחויב. Cloudflare פועלת כסוחר רשום ומטפלת בסליקה.
בדיקת איכות: זה עובד רק מול סורקים שרשמו פרטי תשלום ב-Cloudflare ותומכים בזרימת ה-402 — זה לא מתג אוניברסלי מול כל בוט. כלפי כל השאר, הגדרת החיוב שלכם מתנהגת למעשה כמו חסימה, ו-Cloudflare מציינת שהיא עדיין יכולה לשמש כאות לכך שתהיו פתוחים למערכת יחסים בתשלום בעתיד.
מסלול התאוששות: התכונה הזו נמצאת בבטא פרטית; אם לא התקבלתם או שלא בא לכם לחכות, מניעת אימון AI או חסימה נשארות האפשרויות הזמינות היום עבור אותם סורקים.
טיפול בחריג: מה אם מפעיל בינה מלאכותית מסוים מבקש גישה?
ייתכן שתקבלו פנייה יזומה — שותפות, הסדר ציטוט, שיחה על רישוי — מחברת בינה מלאכותית שרוצה גישה מפורשת למרות המדיניות הרוחבית של האזור שלכם.
יש שתי דרכים להעניק חריג צר בלי לפתוח מחדש את כל הקטגוריה:
- עקיפה לפי סורק ב-Manage AI crawlers: החליפו את השורה של הבוט הספציפי הזה מחסום/חיוב ללאפשר, באופן בלתי תלוי בהגדרת האימון או הסוכן הרוחבית של הקטגוריה.
- עריכה ידנית של robots.txt: אם כיביתם את Bot Preference Sync (או שאתם ממקמים את החריג מחוץ לבלוק המנוהל), אתם יכולים להוסיף Allow ממוקד עבור סוכן המשתמש האחד הזה מתחת למקטע המנוהל על ידי Cloudflare.
בכל אחת מהדרכים, השאירו את מדיניות הקטגוריות הרוחבית כברירת מחדל והתייחסו לחריגים בשם מפורש כהחלטות מכוונות ומתועדות — ולא להפך.
אימות התוצאה המוגמרת
עברו על רשימת הבדיקה הזו לאחר שההגדרה שלכם פעילה:
- [ ] הגדרות האבטחה מציגות ערך מפורש ומכוון עבור חיפוש, סוכן ואימון — ולא ברירת מחדל שלא נסקרה
- [ ] ה-
/robots.txtבדומיין החי שלכם מציג בלוק מנוהל של Cloudflare שתואם את ההגדרות האלה - [ ] לשונית Crawlers ב-AI Crawl Control מציגה את הבוטים שאתם מצפים להם, עם הפרות באפס או קרוב לאפס עבור כל מה שהגדרתם לחסום או למנוע
- [ ] אם בחרתם במנוע אימון AI, אימתתם (דרך Search Console / Bing Webmaster Tools, או פשוט בהתבוננות בתעבורה האורגנית) שסריקת החיפוש מ-Googlebot / Applebot ממשיכה כרגיל
- [ ] אם הפעלתם אכיפת robots.txt (Robotcop), כלל ה-WAF שנוצר פרוס ופעיל, ולא רק נוצר והושאר כטיוטה
- [ ] תיעדתם איזו הגדרה בחרתם ולמה, כך שסקירה עתידית לא תתחיל מאפס
שמרו על התוצאה
זו אינה הגדרה של "כוונן ושכח". חזרו אליה בקצב קל:
- חודשי: בדקו את לשונית Metrics ב-AI Crawl Control לאיתור בוטים חדשים שלא קבעתם להם מדיניות, ובדקו שוב את מונה ההפרות.
- כאשר Bing תשיק תמיכה בהעדפת אימון עבור Bingbot (ביעד תחילת 2027 לפי Microsoft), העריכו מחדש אם ההגדרה הנוכחית שלכם עדיין מניבה את התוצאה שרציתם — חיפוש נשמר ואימון חסום — מפני שזו הנקודה שבה Bing משיגה את ההתנהגות הנוכחית של Google ו-Apple.
- בכל פעם שסטטוס ההכנסות מפרסום שלכם משתנה — הוספה או הסרה של פרסום תצוגה משנה את מסלול ברירת המחדל שעמודיכם נופלים תחתיו, וכדאי לוודא שוב שההגדרות המפורשות שלכם עדיין הגיוניות לנוכח זה.
שאלות נפוצות
האם חסימת סורקי אימון פוגעת בדירוג ה-SEO שלי? לא, אם תשתמשו במנוע אימון AI ולא בחסימה. מניעת אימון AI נבנתה במיוחד כדי שסורקים רב-שימושיים בנים-דין (Google, Apple ובהמשך Bing) ימשיכו לסרוק למען החיפוש תוך דילוג על האימון. לעומת זאת, חסימה רגילה חוסמת כעת גם את התנהגות החיפוש של אותם סורקים, וזה יפגע בנראות שלכם במוצרי החיפוש שלהם.
כבר היה לי "Block AI Bots" מופעל לפני 15 בספטמבר. מה קרה להגדרה שלי? Cloudflare העבירה אותה אוטומטית: Block AI Bots הישן הפך לאימון = מנוע אימון AI, חיפוש = לאפשר, סוכן = לחסום בעמודים עם פרסומות. ודאו שזה אכן נחת כמצופה באמצעות שלב 1 שלמעלה, במקום להניח שההעברה התאימה לכוונה שלכם.
האם משהו מזה זמין במסלול החינמי? כן. AI Crawl Control, הגדרות הקטגוריות חיפוש/סוכן/אימון ו-Bot Preference Sync זמינים כולם בכל המסלולים, כולל החינמי. חלק מפרטי האכיפה שונים בין מסלולים — למשל, אכיפת robots.txt עוברת דרך WAF, וזיהוי בוטים במסלול החינמי נשען על מחרוזות סוכן משתמש ולא על מזהה הזיהוי המתקדם יותר של Bot Management.
מה ההבדל בין AI Crawl Control לבין הגדרות האבטחה של בוטי בינה מלאכותית? הגדרות האבטחה הן המקום שבו אתם קובעים את המדיניות (לאפשר / לחסום בעמודי פרסומות / לחסום / מנוע אימון AI לפי קטגוריה). AI Crawl Control הוא המקום שבו אתם מבקרים מה קורה בפועל — מספרי בקשות לפי בוט, הפרות robots.txt, פירוט ברמת הנתיב — וגם המקום שבו תוכלו להמיר מדיניות robots.txt מוצהרת לכלל WAF נאכף.
האם אני צריך לערוך ידנית את robots.txt אחרי הגדרת ההגדרות האלה? לא, אם Bot Preference Sync מופעל — הוא כותב ומתחזק עבורכם את בלוק ה-robots.txt המתאים על בסיס הגדרות לוח הבקרה. עריכה ידנית נדרשת רק לחריגים מותאמים של מפעיל בודד מחוץ לקטגוריות המנוהלות.
מחבר: Julian Mercer, מומחה SEO טכני בן 14 שנות ניסיון ב-Auspia. כותב על יכולת סריקה, סכמות, רינדור ותשתיות טכניות לתוכן קריא לבינה מלאכותית.