La regla que Google acaba de escribir
El 26 de octubre de 2026, Google añadió una sección de dos párrafos a su guía sobre cómo evitar el spam generado por usuarios. Es la parte más corta de la página y probablemente la que más hojas de ruta de producto va a cambiar, porque plantea una pregunta que la mayoría de los equipos nunca puso en una diapositiva: ¿esta URL debería estar en el índice de Google?
La sección se titula "Only index content meant for Search" (indexa solo el contenido destinado a la Búsqueda). Traducida, dice lo siguiente:
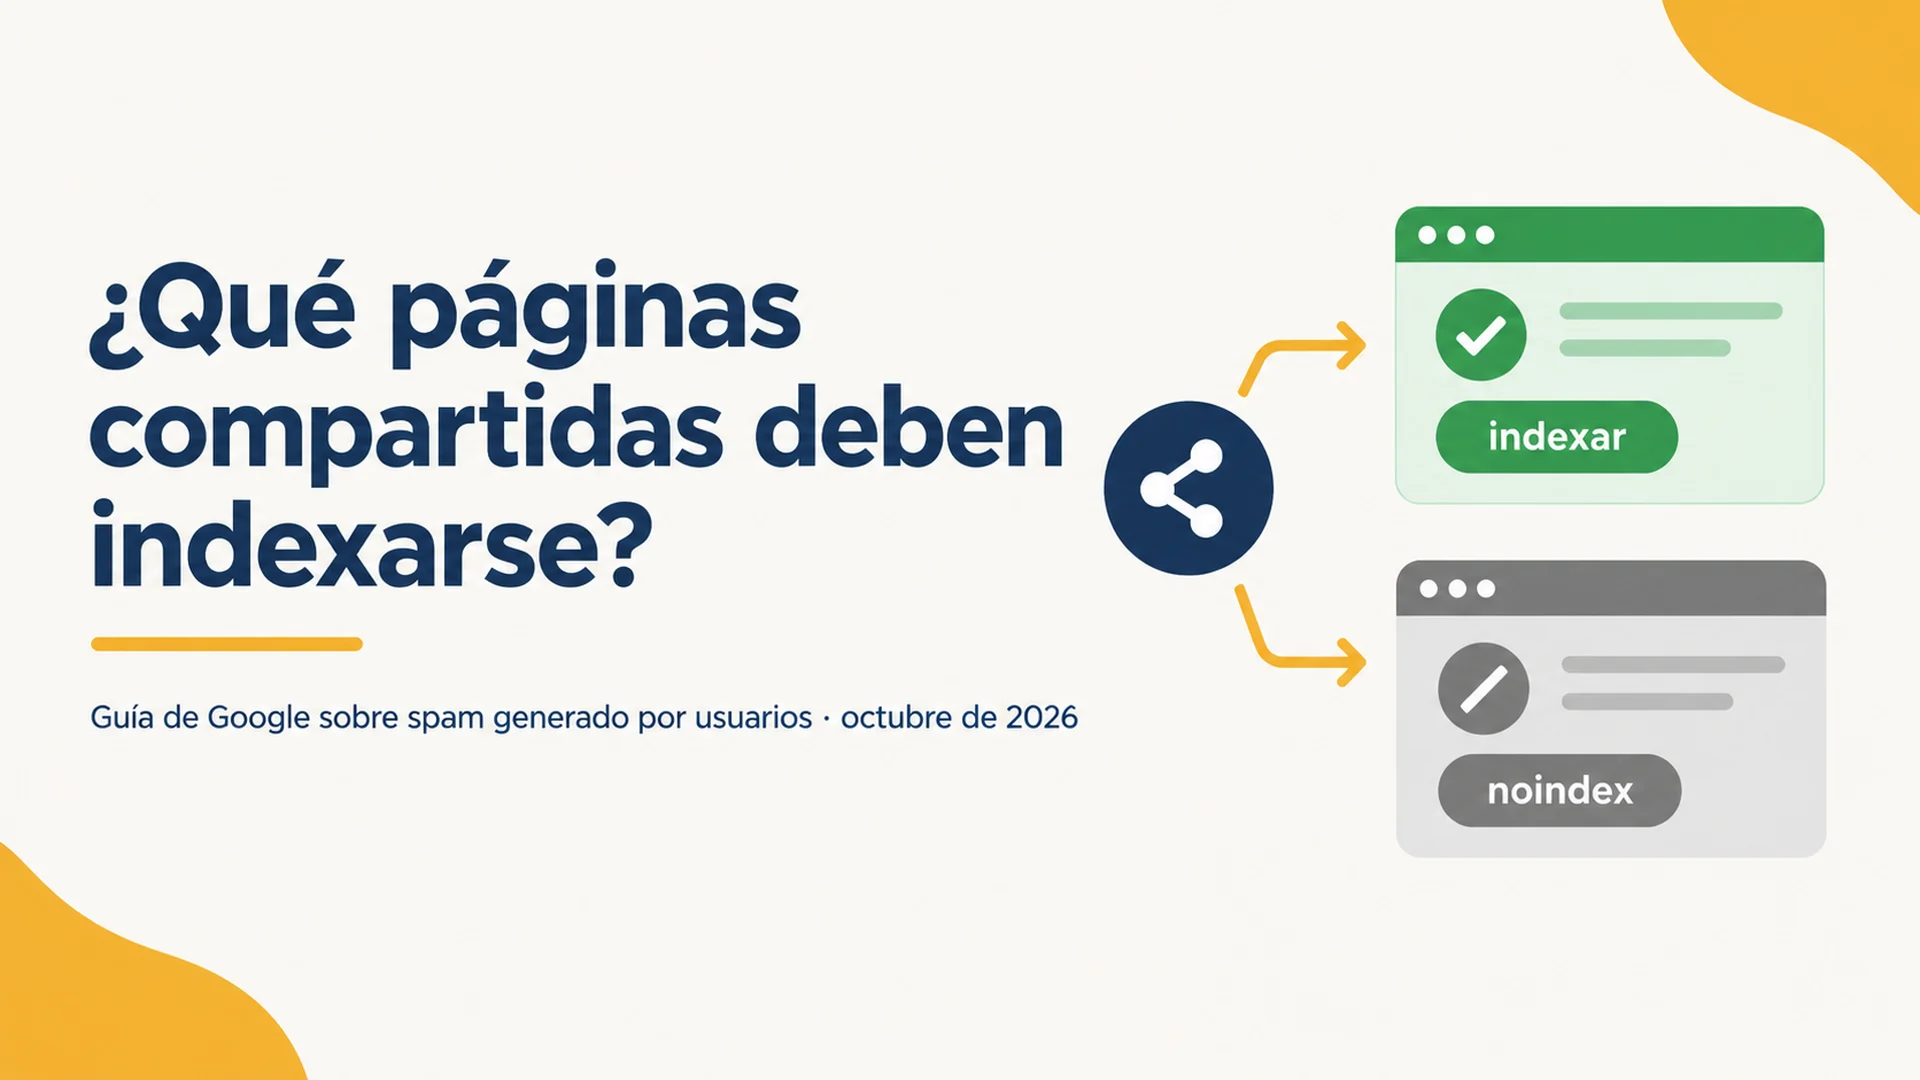
Si tu servicio permite a los usuarios crear páginas compartibles, resultados generados o herramientas interactivas, plantéate si ese contenido está pensado para que lo encuentren los motores de búsqueda o solo para que lo abra directamente quien tiene el enlace.
Cuando las páginas se crean para compartir de forma directa, para colaborar o para ser útiles, y no para que se descubran en una búsqueda pública, aplica la regla noindex (con una metaetiqueta robots o la cabecera HTTP X-Robots-Tag) o bloquea el rastreo en robots.txt de forma predeterminada.
El registro de cambios de Google del mismo día es más explícito sobre la intención: la guía se actualizó con "orientación sobre cómo bloquear la indexación de contenido compartido por enlace y cómo monitorizar abusos en Search Console", para que las plataformas puedan "mantener fuera del índice las páginas creadas por usuarios que no están destinadas a la Búsqueda y detectar spam antes".
Eso es todo. No hay acción manual nueva, ni anuncio de un sistema de posicionamiento, ni lista de penalizaciones. Lo que hay es una recomendación de valor predeterminado, y de los valores predeterminados salen casi todos los accidentes de indexación.
Para quién es esto. Equipos que publican cualquier URL que un usuario pueda generar: enlaces para compartir, chats guardados, paneles públicos, vistas previas de modelos, compilaciones de apps, informes generados, hilos de foro, páginas de perfil, páginas de reseñas, páginas de anuncios.
Con qué terminas. Un veredicto por ruta para cada tipo de URL generada, el control que de verdad saca la página del índice y una regla de monitorización que detecta el patrón de abuso que describe Google.
Tiempo. Entre 45 y 90 minutos para una primera pasada en un producto. Un día si tienes varios generadores de URL y ningún inventario de rutas.
Cómo se ve terminado. Cada ruta generada marcada como index, noindex o privada. Las rutas noindex devuelven la directiva desde el servidor, no después de que se ejecute JavaScript. Search Console muestra esas URL como excluidas por noindex, no como "Indexada, aunque bloqueada por robots.txt".
Qué cambió y qué solo lo parece
Hay cuatro cambios que importan. El resto de la página no se movió, incluida la orientación de diciembre de 2025, que sigue vigente.
Qué cambió Google | El texto real | Por qué te importa |
|---|---|---|
Alcance de la guía | Ahora nombra plataformas de alojamiento "y herramientas que permiten a los usuarios publicar páginas compartidas, contenido generado o aplicaciones web" | Al pie de la letra, esto cubre exportaciones de chat de IA, páginas de artefactos, constructores de apps y herramientas no-code, no solo foros y comentarios |
Unidad del abuso | Los spammers pueden crear "una gran cantidad de páginas o sitios" | Google habla de volumen, no de astucia. Una cuenta abusiva puede acuñar miles de URL |
Sección nueva | "Only index content meant for Search" | Es la declaración más clara hasta la fecha de que noindex es un valor predeterminado razonable para contenido accesible solo por enlace |
Monitorización | Verificar el sitio o subdominio en Search Console, vigilar picos en Indexación de páginas y en Rendimiento de búsqueda, alertar cuando "pocos usuarios" producen "una gran parte de las URL indexables" | La hinchazón del índice tiene ahora un método de detección con nombre, y normalmente eso es lo que precede a una forma de revisión |
Lo que no cambió: noindex en publicaciones de usuarios nuevos hasta que se ganen reputación, y nofollow o ugc en enlaces dentro de contenido poco fiable. Si ya haces las dos cosas, vas por delante de esta actualización.
Conviene decirlo con claridad, porque la reacción en X se adelantó al documento: esto es orientación para plataformas sobre su propio inventario de URL. No crea una violación nueva para un sitio de marketing corriente y no cambia el posicionamiento de ninguna página. Cambia qué debería existir en el índice.
Otro dato de contexto explica el momento. A finales de julio de 2026, los enlaces para compartir y las páginas de artefactos de Claude aparecieron en el índice de Google, y las crónicas de entonces describieron historiales médicos, claves de API y otro material privado expuesto antes de que Anthropic cerrara el agujero en pocos días. La misma cobertura señaló URL públicas de apps en constructores como Replit y Lovable. Google rara vez escribe una sección nueva para una hipótesis. Esta ya había ocurrido.
La pregunta que decide cada URL generada
La prueba de Google cabe en una frase y se puede aplicar sin adivinar intenciones: ¿este contenido está pensado para que lo encuentren los motores de búsqueda, o solo para que lo abra quien tiene el enlace?
En la práctica, cuatro señales responden. Evalúa la ruta, no la página individual.
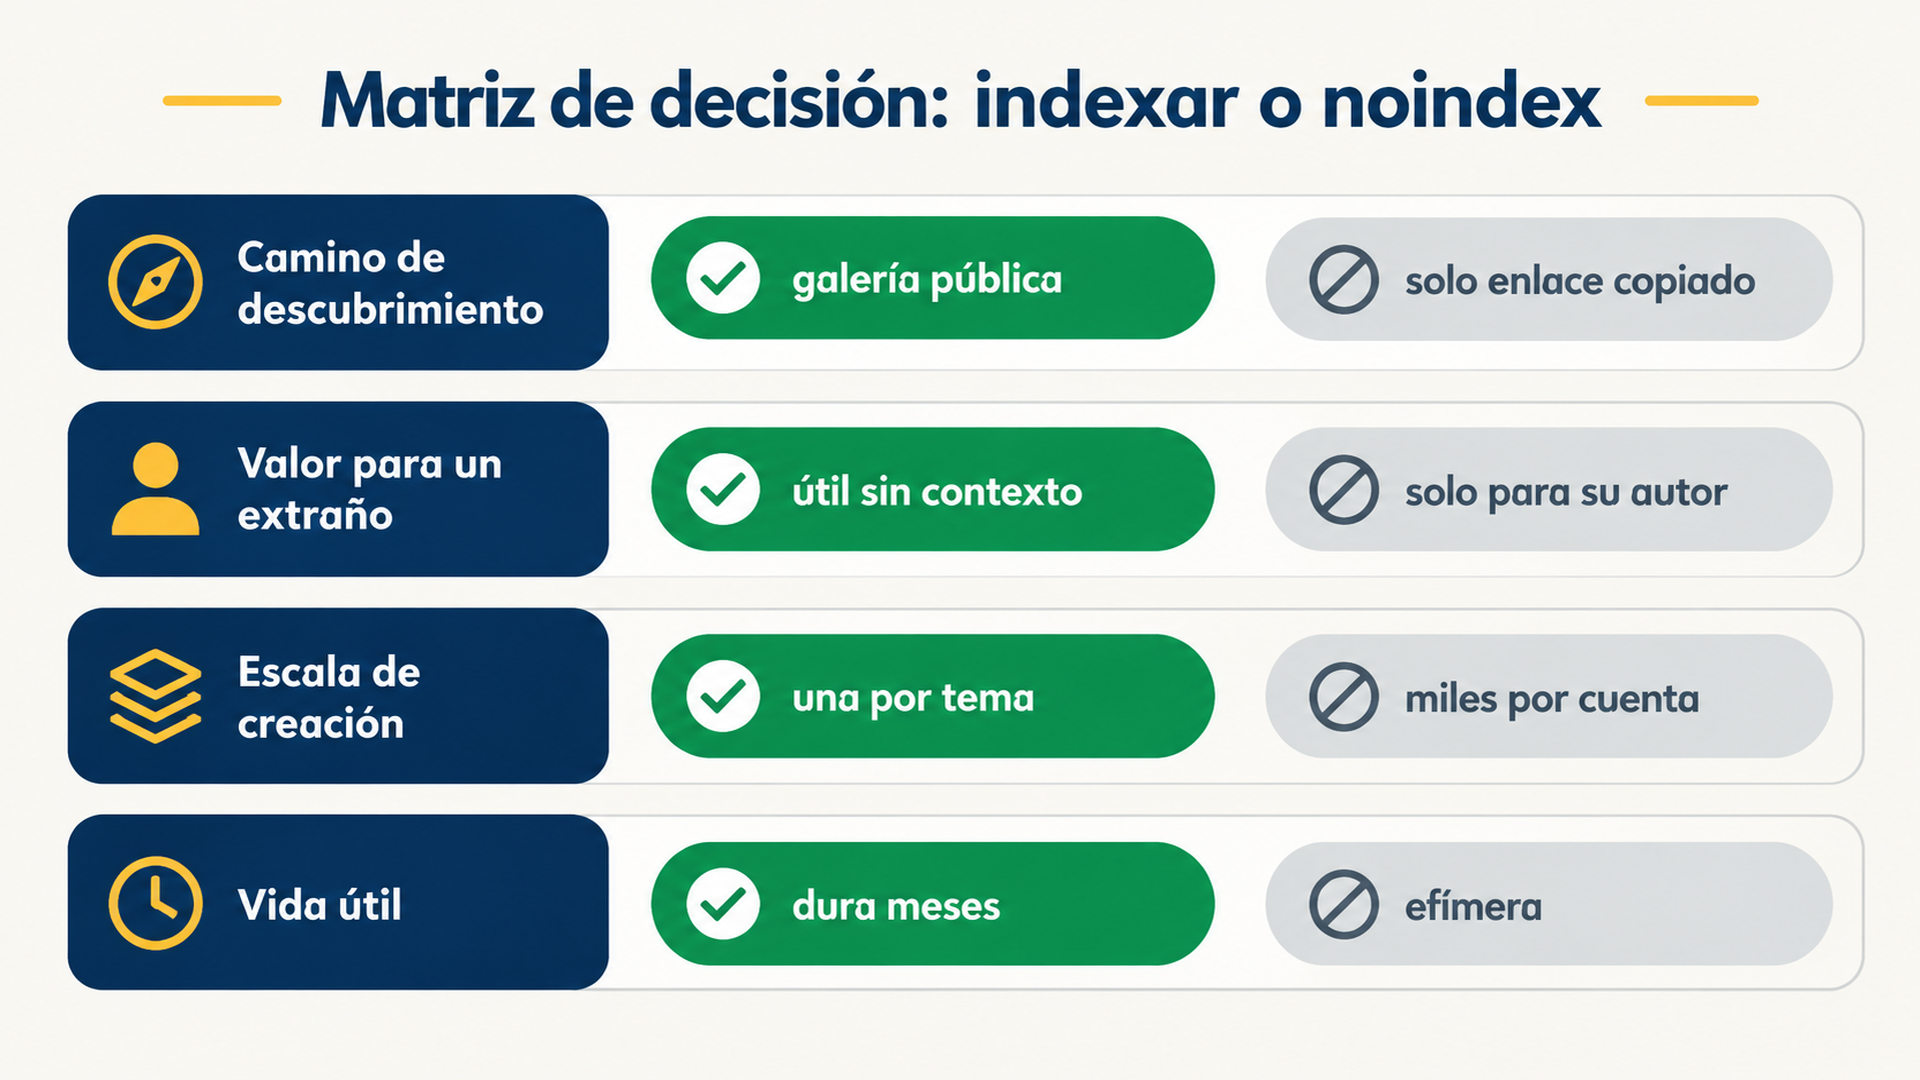
Señal | Apunta a indexar | Apunta a noindex |
|---|---|---|
Camino de descubrimiento | Enlazada desde una galería pública, un sitemap, una página de categoría o un perfil | Solo alcanzable con un enlace copiado o un botón de compartir |
Valor para un extraño | Útil sin conocer a quien la creó | Solo tiene sentido para el creador, su equipo o el destinatario |
Escala de creación | Una página por tema, o un conjunto curado | Miles de URL de una cuenta, casi todas casi duplicadas |
Vida útil | Sigue siendo exacta durante meses | Efímera: un chat, una compilación, un borrador, una exportación temporal |
Tres de cuatro apuntando a noindex es un veredicto claro. Un resultado mixto normalmente significa que la ruta hay que partirla: una galería pública indexable y, por debajo, los resultados individuales, que no lo son. Esa división es la respuesta correcta más frecuente y también la que más se salta, porque exige dos plantillas en lugar de una bandera.
Una prueba de rechazo útil: si un extraño viera esta URL en un resultado de búsqueda sin contexto, ¿tendrían sentido el título y el fragmento? "Conversación con Sam, 24 oct" no lo tiene. "Plantilla de factura para diseñadores autónomos" sí. El rechazo no va de calidad. Va de si la página se hizo para que la encontraran o se hizo para enviarla.
Elige un control que realmente saque la URL
Aquí es donde se puede seguir la nueva orientación al pie de la letra y aun así fallar. Google ofrece dos opciones en la misma frase y no son equivalentes.
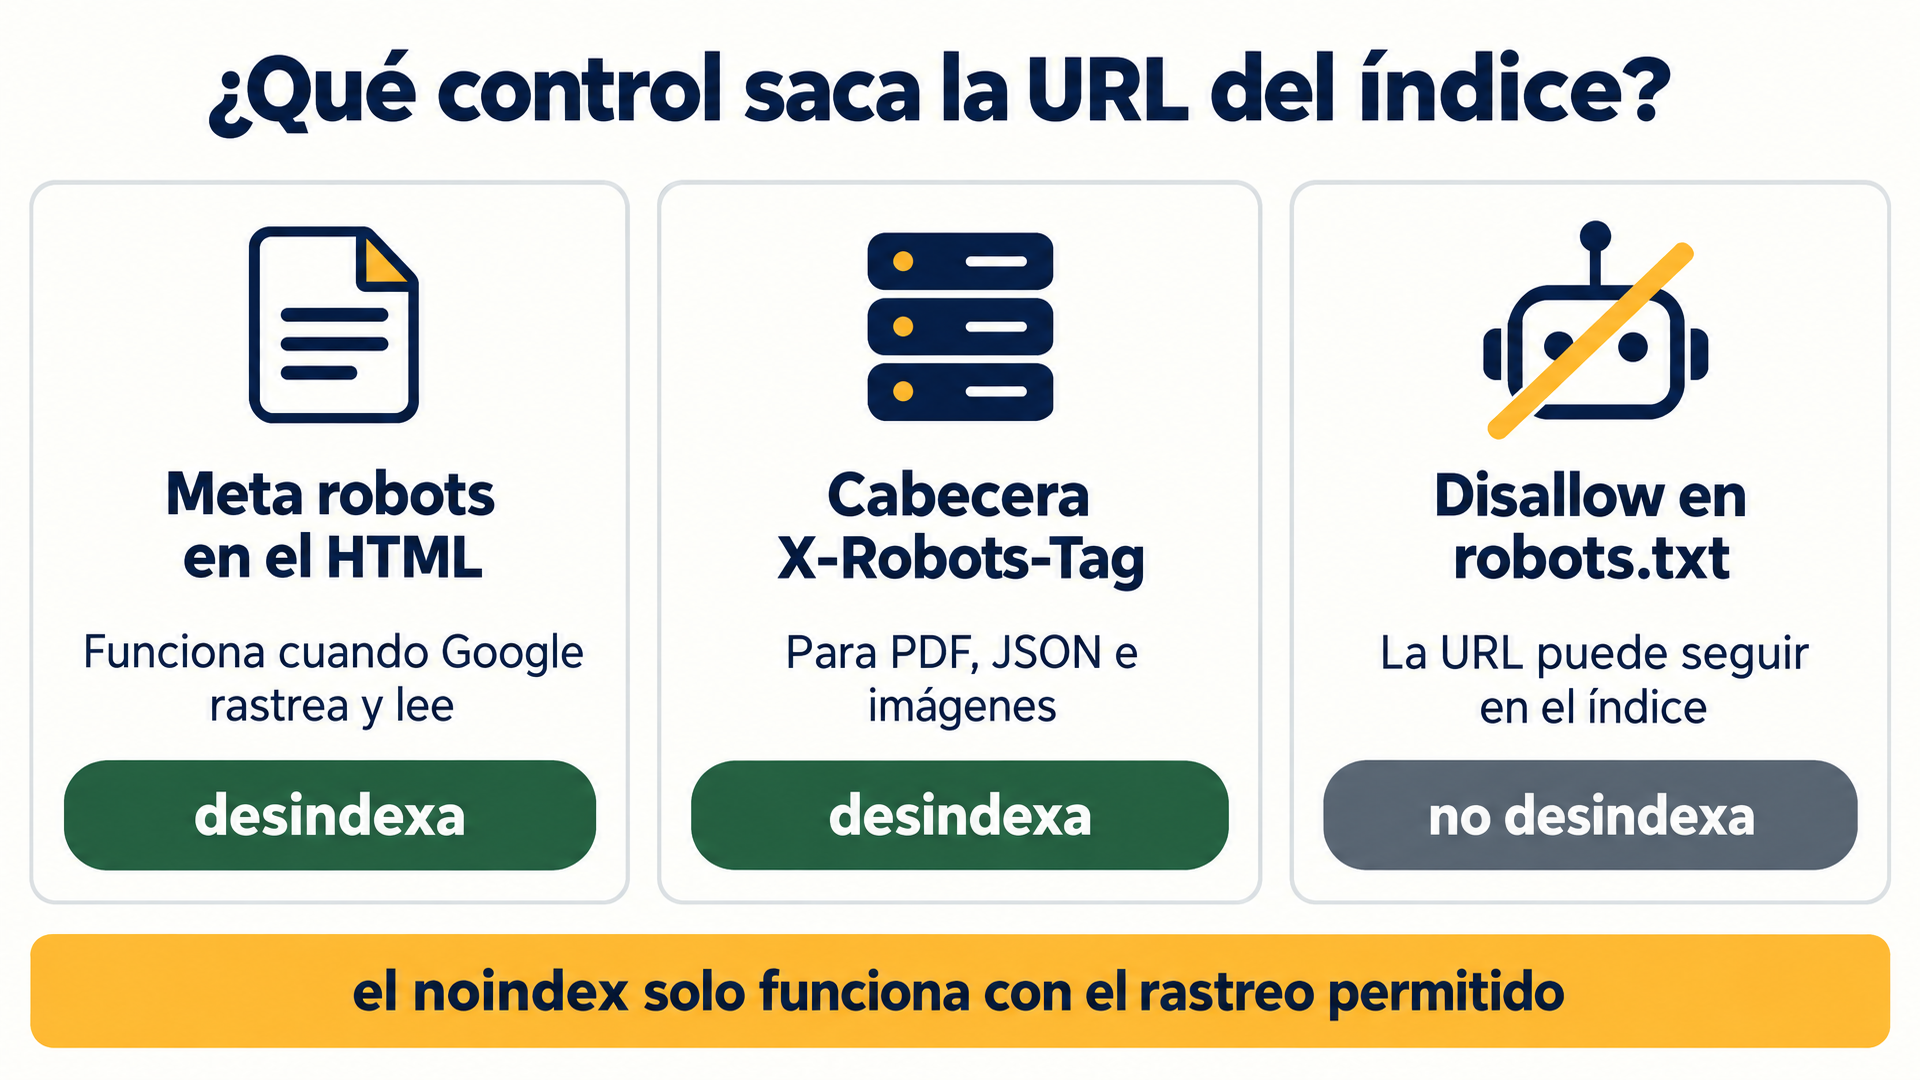
El robots.txt controla el rastreo. No elimina una URL del índice, y el propio Google lo dice en la introducción de robots.txt: una página bloqueada ahí "puede seguir indexada si hay enlaces de otros sitios que apunten a ella" y, en ese caso, la URL y posiblemente el texto del ancla pueden aparecer en los resultados sin descripción.
El noindex controla la indexación, pero solo si Google puede rastrear la página y leer la directiva. La documentación de noindex de Google es explícita: para que la regla funcione, la página no puede estar bloqueada por robots.txt, porque entonces "el rastreador nunca verá la regla noindex".
Junta los dos hechos y el orden pasa a importar.
Control | Saca la URL del índice | Dónde falla | Úsalo para |
|---|---|---|---|
Cabecera de respuesta | Sí, una vez que Google rastrea y lee | Cualquier cosa bloqueada por robots.txt o detrás de un inicio de sesión | Respuestas que no son HTML (PDF, JSON, imágenes) y reglas de edge o CDN para muchas rutas |
| Sí, una vez que Google rastrea y lee | Etiquetas inyectadas por JavaScript después de la carga; páginas bloqueadas por robots.txt | Páginas HTML para compartir renderizadas en el servidor |
Disallow en | No | Una URL enlazada puede seguir indexada sin fragmento | Reducir carga de rastreo, no privacidad |
Inicio de sesión o URL firmada | Sí, al impedir el acceso | Exige que la página sea de verdad privada | Todo lo que contenga datos de otras personas |
410 tras la caducidad | Sí, con el tiempo | Más lento que el 404; no hace nada mientras la URL siga resolviendo | Compartidos y compilaciones efímeras |
Un atajo que hay que evitar: X-Robots-Tag: none no es un valor neutro. Google lo trata como noindex más nofollow. A veces es lo que quieres, pero los equipos lo copian de una configuración de proxy sin saberlo.
Segundo atajo a evitar: las etiquetas canonical. El canonical es una pista. Si la página no debería estar en el índice, escribe noindex.
Paso 1: haz inventario de las rutas que crean URL
No se puede clasificar lo que no está en una lista, y la mayoría de los equipos subestima el recuento porque piensa en funcionalidades en vez de en patrones de ruta.
Abre el router, o el mapa de URL, y enumera cada segmento dinámico. Los sospechosos de siempre tienen esta pinta:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Después contrástalo con lo que Google ya sabe, porque el código y el índice van a discrepar.
Desde el sitemap. Descárgalo y cuenta:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
El segundo comando da un histograma aproximado por prefijo de ruta. Si una ruta generada aparece en tu sitemap, eso ya es un error: el sitemap es una lista de páginas que le estás pidiendo a Google que indexe.
Desde Search Console. Abre el informe de Indexación de páginas, filtra por prefijo de URL para cada ruta candidata y anota los números. Es la única fuente que dice qué hizo Google de verdad con esas URL.
Desde los registros del servidor. Agrupa las peticiones de Googlebot por prefijo:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Resultado esperado. Una lista de patrones de ruta con un recuento de URL al lado de cada uno, sacada de al menos dos fuentes.
Control de calidad. Toda ruta que pueda devolver un 200 a un visitante que no sea del equipo tiene que estar en la lista. Si el recuento del sitemap y el de Search Console difieren en más de unos pocos puntos porcentuales en el mismo prefijo, averigua por qué antes de cambiar nada.
Si no encuentras nada. Probablemente tienes un router del lado del cliente. Busca las definiciones de ruta en el frontend en vez del backend y mira la pestaña de red en un enlace para compartir real.
Paso 2: clasifica cada ruta en una tabla, no en una reunión
Escribe el veredicto donde alguien pueda revisarlo. Basta con una fila por patrón de ruta.
Ruta | La crea | Camino de descubrimiento | Valor para un extraño | Veredicto | Control | Responsable |
|---|---|---|---|---|---|---|
| Cualquier usuario | Solo enlace | Ninguno | noindex | Cabecera | Plataforma |
| Curaduría | Enlaces internos, sitemap | Alto | index | Ninguno | Contenido |
| Cualquier usuario | Enlaces de perfil | Bajo hasta estar activo | noindex hasta tener reputación | Meta | Confianza y seguridad |
| Cualquier usuario | Solo enlace | Ninguno | noindex | Cabecera | Plataforma |
| Editores | Sitemap | Alto | index | Ninguno | Contenido |
La tabla solo funciona si tres cosas son ciertas.
Una persona responsable por fila. Un dueño ambiguo es la razón por la que las rutas generadas siguen siendo indexables durante años.
Escribe el control al lado del veredicto, no después. "Noindex" no es una decisión hasta que alguien sabe si eso significa una cabecera, un cambio de plantilla o una regla de CDN.
Anota la excepción. Si una ruta es noindex pero un subconjunto pequeño debería ser público, escribe la condición de ese subconjunto ahora. Hacer el recorte seis meses después es como una regla de noindex termina quitándose entera, en silencio.
Paso 3: aplica el control a nivel de plantilla
Los arreglos página a página no sobreviven al siguiente despliegue. Aplica el control donde se renderiza la ruta.
Para páginas HTML, pon la etiqueta en el head renderizado en el servidor. En el App Router de Next.js eso es la metadata; en Astro, el head del layout; en Rails o Django, la plantilla de layout. La sintaxis exacta importa menos que el lugar: tiene que estar en el HTML que recibe Google, no añadida por un efecto en el cliente.
<meta name="robots" content="noindex">Para todo lo que no es HTML, no existe metaetiqueta, así que usa la cabecera:
X-Robots-Tag: noindexEsto cubre exportaciones en PDF, respuestas JSON, imágenes generadas y descargas CSV. Si esos archivos se sirven desde una CDN, define la cabecera en el borde para que las rutas nuevas hereden la regla.
Para una familia entera de rutas, una regla de middleware suele ser más limpia que tocar cada plantilla:
// Ejemplo en Express: noindex en todos los URL de compartir generados
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Resultado esperado. Un despliegue en el que toda ruta marcada como noindex devuelve la directiva en el primer byte, para peticiones anónimas.
Control de calidad. Ejecuta curl -sI sobre la URL publicada. Deberías ver x-robots-tag: noindex en las cabeceras de respuesta, y curl -s debería mostrar la metaetiqueta en el código fuente, antes de que se ejecute ningún script.
Camino de recuperación. Si la etiqueta solo aparece después de que se ejecute el JavaScript, muévela a renderizado en el servidor. Si el framework no renderiza etiquetas de head por ruta, usa la cabecera. No publiques un noindex inyectado por JS dando por hecho que funciona: Google describe el comportamiento del noindex renderizado como poco definido.
Hay dos cosas más que pertenecen al mismo pull request. Quita las rutas noindex del sitemap, porque enviar una URL que no quieres indexar es una contradicción que Google resuelve a su favor. Y añade una regla de caducidad: cuando muere un enlace para compartir, devuelve 410 en vez de mantener una página 200 con el estado vacío.
Paso 4: verifica que Googlebot puede ver la directiva
Todo lo anterior no está verificado hasta que lo compruebas como lo comprueba Google.
Mira primero las cabeceras de respuesta:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagLuego mira el HTML inicial, antes de que ningún script tenga la oportunidad de ejecutarse:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Por último, confirma que el robots.txt no bloquea la ruta. Si la bloquea, Google nunca rastrea la página y nunca lee la directiva:
curl -s https://example.com/robots.txtSearch Console es la comprobación final. Pide la inspección de la URL en Inspección de URL y lee el veredicto.
El resultado correcto es "Página no indexada: excluida por la etiqueta 'noindex'". El resultado que indica que has caído en la trampa es "Indexada, aunque bloqueada por robots.txt": Google tiene la URL, no puede leer la directiva y puede seguir mostrándola. Si aparece eso, quita la regla de robots.txt y deja que el noindex haga su trabajo.
También puedes buscar la página tal como la ve Googlebot con un simulador de rastreador, que es más rápido que esperar un nuevo rastreo cuando estás comprobando veinte rutas: Googlebot Spider Simulator.
Resultado esperado. Que toda ruta noindex muestre el estado de exclusión por noindex en unos días tras el siguiente rastreo. Las rutas creadas después del cambio no deberían aparecer en el índice en absoluto.
Camino de recuperación. Si una URL sigue indexada después de dos semanas, comprueba que Google pueda rastrearla, que la página devuelva 200 a Googlebot y que ninguna etiqueta canonical o hreflang esté apuntando a los motores de búsqueda a otro sitio. Usa la herramienta de Eliminaciones solo como bloqueo temporal mientras arreglas la causa; no sustituye a la directiva.
Cuando la página compartida es el canal de crecimiento
Algunas páginas generadas sí deben indexarse, y poner noindex a todo sería un tiro en el pie. Estas son las que merece la pena proteger:
Patrón | Por qué merece el índice | Barandilla |
|---|---|---|
Galerías públicas de plantillas | Los usuarios publican un diseño y otros lo reutilizan; el resultado es único y duradero | Moderar los envíos nuevos |
Constructores con páginas públicas de escaparate | Un resultado real con crédito "built with" es un canal de distribución | Mantener la plantilla del escaparate separada de la página de marketing |
Documentación que crece a partir de hilos de usuarios | Una pregunta recurrente merece una respuesta permanente y editada | Indexar la respuesta curada, no la conversación en bruto |
Si estás en una de estas categorías, la orientación más antigua de Google sigue vigente y es la mejor palanca: noindex en contenido de usuarios sin reputación y, después, abrir cuando la cuenta tenga historial. Eso da resistencia al spam sin abandonar el ciclo de adquisición, y es el patrón que la guía recomendaba antes de esta actualización.
La prueba para las tres es la misma. Si la página gana impresiones en Rendimiento de búsqueda para consultas que un extraño escribiría, pertenece al índice. Si solo gana impresiones por su propia cadena de URL y nada más, no pertenece.
Hay un efecto de segundo orden que conviene nombrar. Las URL públicas para compartir fueron durante años una superficie barata de enlaces: crear una página en una plataforma con dominio fuerte, apuntar un enlace al sitio propio, repetir en veinte propiedades. Patrick Stox contó más de 20 enlaces de plataformas distintas en el mismo hilo. Si las plataformas siguen la orientación, esa superficie se encoge. Si no la siguen, Google ya tiene un documento que citar la próxima vez que decida que esas páginas son spam.
Paso 5: instrumenta el patrón que describió Google
La sección de monitorización es la parte de la actualización que la mayoría de los equipos va a saltarse, y es justo la que pilla un incidente real antes de que se convierta en una acción manual.
Cuatro comprobaciones, cada una con un sitio donde mirar.
Propiedad en Search Console. Verifica el sitio o el subdominio para que los avisos de acción manual y de seguridad lleguen por correo. Si operas una plataforma con subdominios por inquilino, verifica el padre y al menos una muestra de los hijos; un aviso que no llega a ningún sitio no es monitorización.
Tendencia de indexación de páginas. Establece hoy la línea base de URL indexadas por ruta generada y vigila los cambios en escalón, no el ruido. Duplicar el número de URL indexadas en una semana en una ruta que debería ser estática es la señal.
Anomalías en Rendimiento de búsqueda. Filtra por consultas sin relación con el producto. Las páginas de spam atraen consultas de spam mucho antes de que alguien se queje.
Relación entre creación e indexación. Esta es la métrica que Google nombra y que casi nadie mide: cuántas URL indexables puede producir una sola cuenta al día, y qué parte de las nuevas URL indexables viene del 1% de cuentas que más genera. Una alerta inicial a 3 veces la mediana de los últimos siete días para una cuenta es arbitraria, pero funciona; ajústala con tu tráfico.
La misma relación sirve como barandilla de producto. Si una funcionalidad permite que un usuario genere mil URL indexables al día, es una funcionalidad de hinchazón de índice, aunque todavía nadie abuse de ella.
Qué está diciendo realmente la actualización
Quita la redacción y Google está discutiendo sobre la oferta.
Durante veinte años, la política de spam describió páginas: superficiales, raspadas, encubiertas, apiladas de palabras clave. Esas categorías dan por hecho que un humano o un script decide producir una página y Google decide si merece posicionar. Los resultados generados rompen ese modelo. Una decisión de producto puede crear un millón de URL, todas técnicamente únicas, todas técnicamente 200, la mayoría sin valor para quien no las creó. Google no puede evaluarlas una a una y ha dejado de fingir que puede.
La reacción se partió en dos campos. El primero lo leyó como un disparo de aviso: Marie Haynes preguntó si llegarían acciones manuales nuevas para herramientas de IA y constructores de apps, y Lily Ray trató la sección como una señal de lo que Google ya combate a escala, citando artefactos de Claude, páginas para compartir de ChatGPT y publicaciones en redes sociales. El segundo se encogió de hombros. Los equipos cuidadosos llevan años poniendo informes generados por usuarios en noindex, argumentaron varias respuestas, y las propias páginas generadas de Google son el problema mayor. Las dos lecturas pueden ser ciertas. Lo que hace relevante la orientación no es que el consejo sea nuevo, sino que ahora está escrito en un sitio al que se puede apuntar cuando se aplica la política.
Así que la orientación mueve la decisión hacia arriba en la cadena. De las plataformas se espera que decidan, a nivel de plantilla, si una clase de URL pertenece al índice. Es una cuestión de gobernanza, no de SEO, y por eso el consejo está en la guía de spam y no en la documentación de indexación.
Para la búsqueda con IA la misma lógica funciona en las dos direcciones. Las funciones de IA de Google extraen del índice de Google, así que una directiva noindex saca la página tanto del fondo como de los enlaces azules. Si una página generada había estado ganando citas en AI Overviews, espera que paren. Normalmente eso es lo correcto para un enlace para compartir y lo incorrecto para una página de plantilla. Otros rastreadores de IA siguen sus propias reglas, así que decide por separado cuáles quieres que puedan rastrear esas páginas.
El aprendizaje práctico es una frase que se puede llevar a una revisión de diseño: toda URL que un usuario puede crear es una superficie de producto o un pasivo de índice, y la plantilla decide cuál.
Preguntas frecuentes
¿Esto aplica a un sitio de marketing corriente?
No, salvo que tu sitio genere URL a partir de entrada del usuario. Un sitio de marketing publica un conjunto de páginas que una persona decidió que debían existir, lo contrario del problema que describe la guía. La línea de alcance nombra plataformas de alojamiento y herramientas que permiten a los usuarios publicar páginas compartidas, contenido generado o aplicaciones web. Si tienes comentarios, foro o perfiles de miembros, aplica la orientación antigua: nofollow o ugc en enlaces de cuentas poco fiables y noindex para usuarios nuevos hasta que construyan reputación.
¿Debo usar robots.txt o una etiqueta noindex?
Noindex, y solo uno de los dos en cada ruta. La frase de Google lista las dos opciones, pero hacen cosas distintas. Un Disallow en robots.txt bloquea el rastreo, y una URL bloqueada pero enlazada desde otro sitio puede seguir apareciendo en los resultados sin fragmento. El noindex solo funciona cuando Google puede rastrear la página y leerla. En la práctica eso significa una metaetiqueta o una cabecera de respuesta, y nunca una regla de robots.txt en el mismo camino.
¿Poner páginas compartidas en noindex me va a costar tráfico?
Comprueba la ruta antes de decidir, no después. Si una página gana impresiones solo por su propia cadena de URL, no está aportando tráfico orgánico y quitarla no cuesta nada. El patrón que pierde tráfico es tumbar una galería pública junto con los resultados que hay dentro. Mantén la galería indexable, pon noindex en lo que está detrás de ella y sigue el rendimiento de búsqueda de las consultas de la galería antes y después.
¿Los motores de búsqueda con IA respetan noindex?
Las funciones de IA de Google sí, porque AI Overviews y AI Mode extraen del mismo índice, así que la directiva saca la página tanto de los enlaces azules como de las respuestas de IA. Otros rastreadores de IA son una decisión aparte. El comportamiento de los proveedores varía y cambia sin registro de cambios, así que lee la documentación de cada rastreador y busca la página con su user agent en vez de suponer que una directiva los cubre todos.
Autor: Grace Miller, analista de riesgo de AI Search en Auspia. Sigue más de 200 cambios de política. Escribe sobre reglas de plataforma, riesgo de contenido y optimización con conciencia de política.