完成這份流程後你會得到什麼
走完這套流程後,你的 Cloudflare 網域會有明確且有意識的三類 AI 機器人流量政策——搜尋(Search)、代理(Agent)、訓練(Training)——而不是被網域預設值牽著走。你會確切知道哪些爬蟲被允許、哪些被封鎖、以及套用在哪些頁面上,而且你的 robots.txt 與邊緣強制執行規則會真正彼此一致。
這份指南適合誰: 任何透過 Cloudflare 代理網站的人——媒體出版方、SaaS 行銷網站、電商商店、部落格——想自己決定 AI 系統能不能訓練、摘要或代理瀏覽你的內容,而不是繼承平台預設值。
前置條件:
- 一個透過 Cloudflare 代理的網域(任何方案皆可,包含 Free;以下部分步驟為付費方案專屬,會另行標註)
- 至少具備網域層級安全性設定權限的儀表板存取權
- 稽核與設定約需 20 至 30 分鐘;之後每天或每週花幾分鐘監控
完成定義: 你的網域安全性設定中,搜尋、代理、訓練三類都顯示出刻意做出的選擇(而非預設值);線上 /robots.txt 反映該選擇;而且你已在 AI Crawl Control 中確認,原本打算封鎖的機器人確實被封鎖。
為什麼這件事突然變得重要:9 月 15 日改了什麼
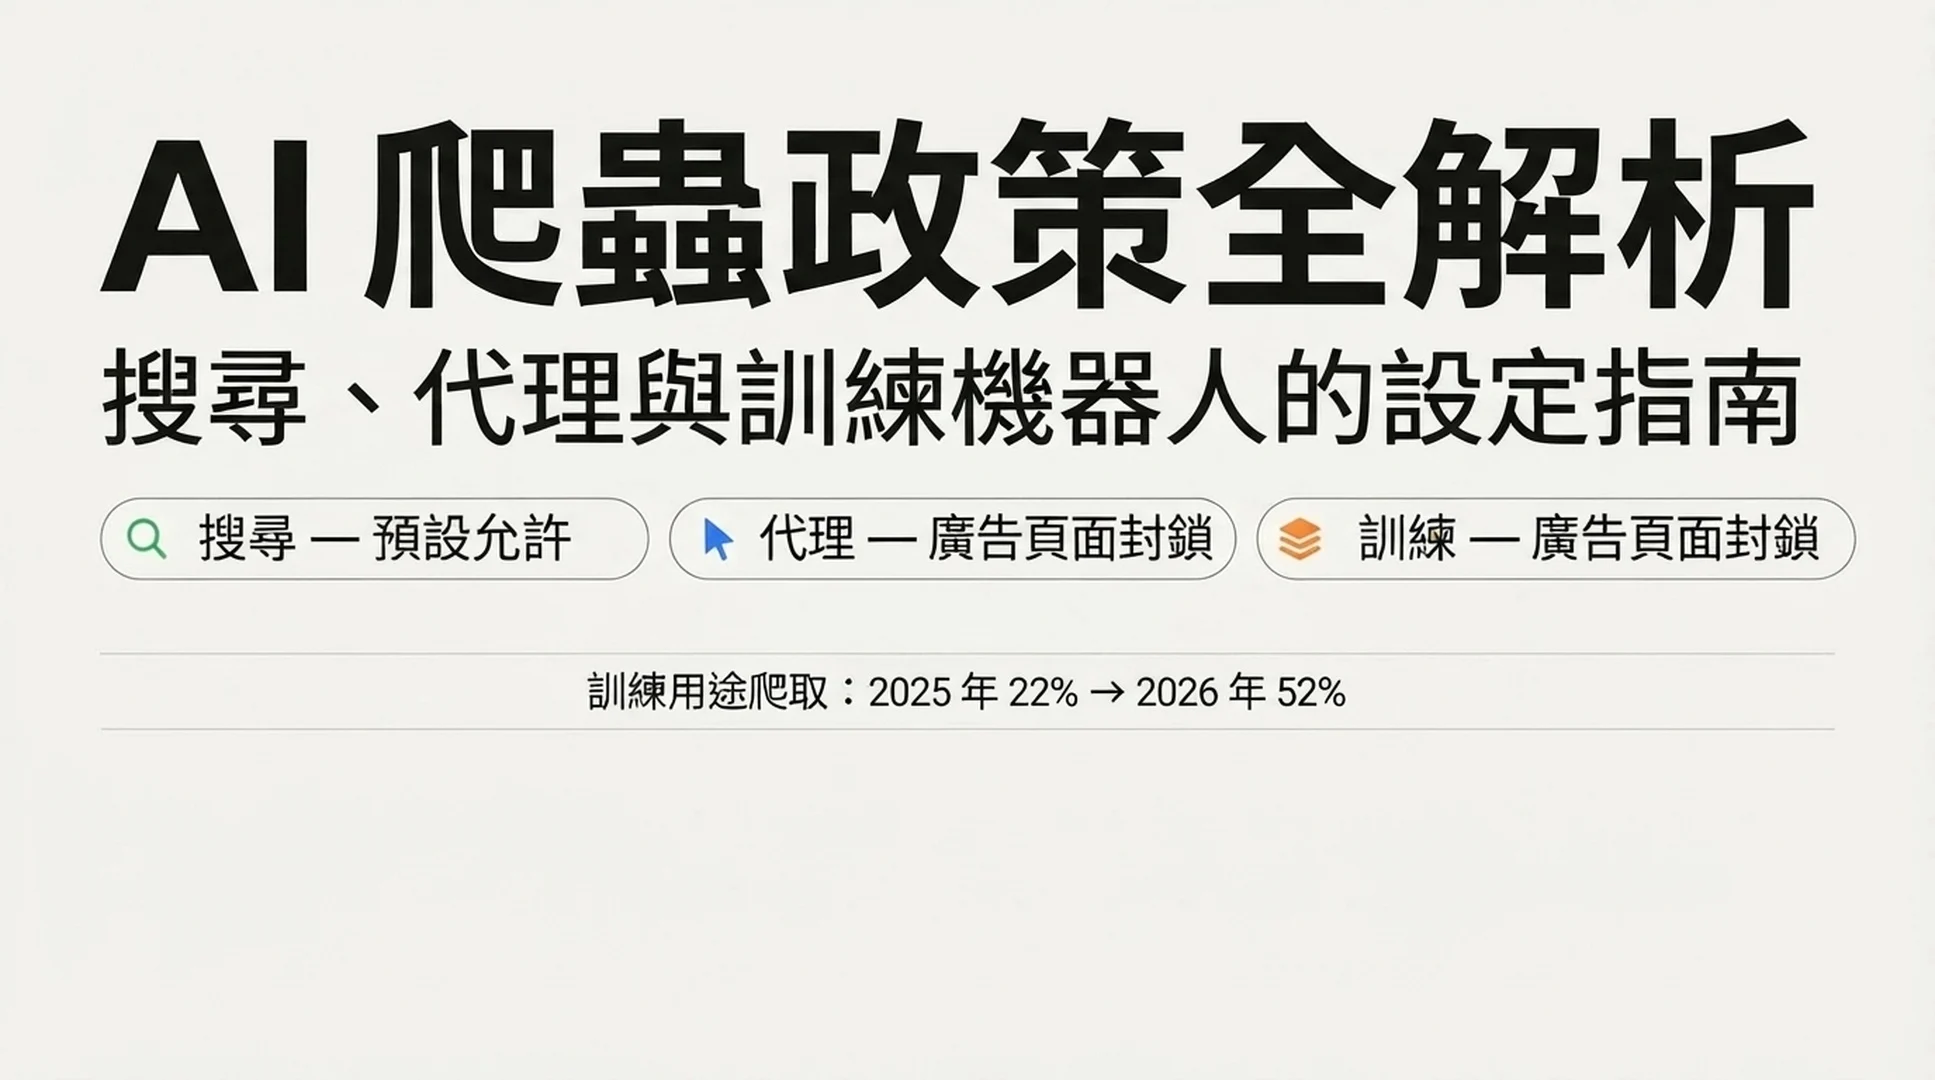
Cloudflare 從 2025 年 9 月在 robots.txt 加入 Content Signals Policy,以及 2026 年 7 月 1 日「Content Independence Day」上線開始,分階段建立 AI 流量控制機制。後者首次把原本粗糙的「是 AI/不是 AI」單一開關,拆成三個有名字的類別:
- 搜尋(Search)——建立搜尋索引,之後回傳連結或簡短摘要的爬取。Cloudflare 的說法是:這類流量應該為你帶來推薦流量。
- 代理(Agent)——正在代替某個人即時行動的自動化活動,例如聊天助理抓取頁面,或瀏覽器代理完成一項任務。
- 訓練(Training)——為了訓練或微調模型而爬取,你的內容會被永久吸收進模型權重,而不是以連結回饋給你。
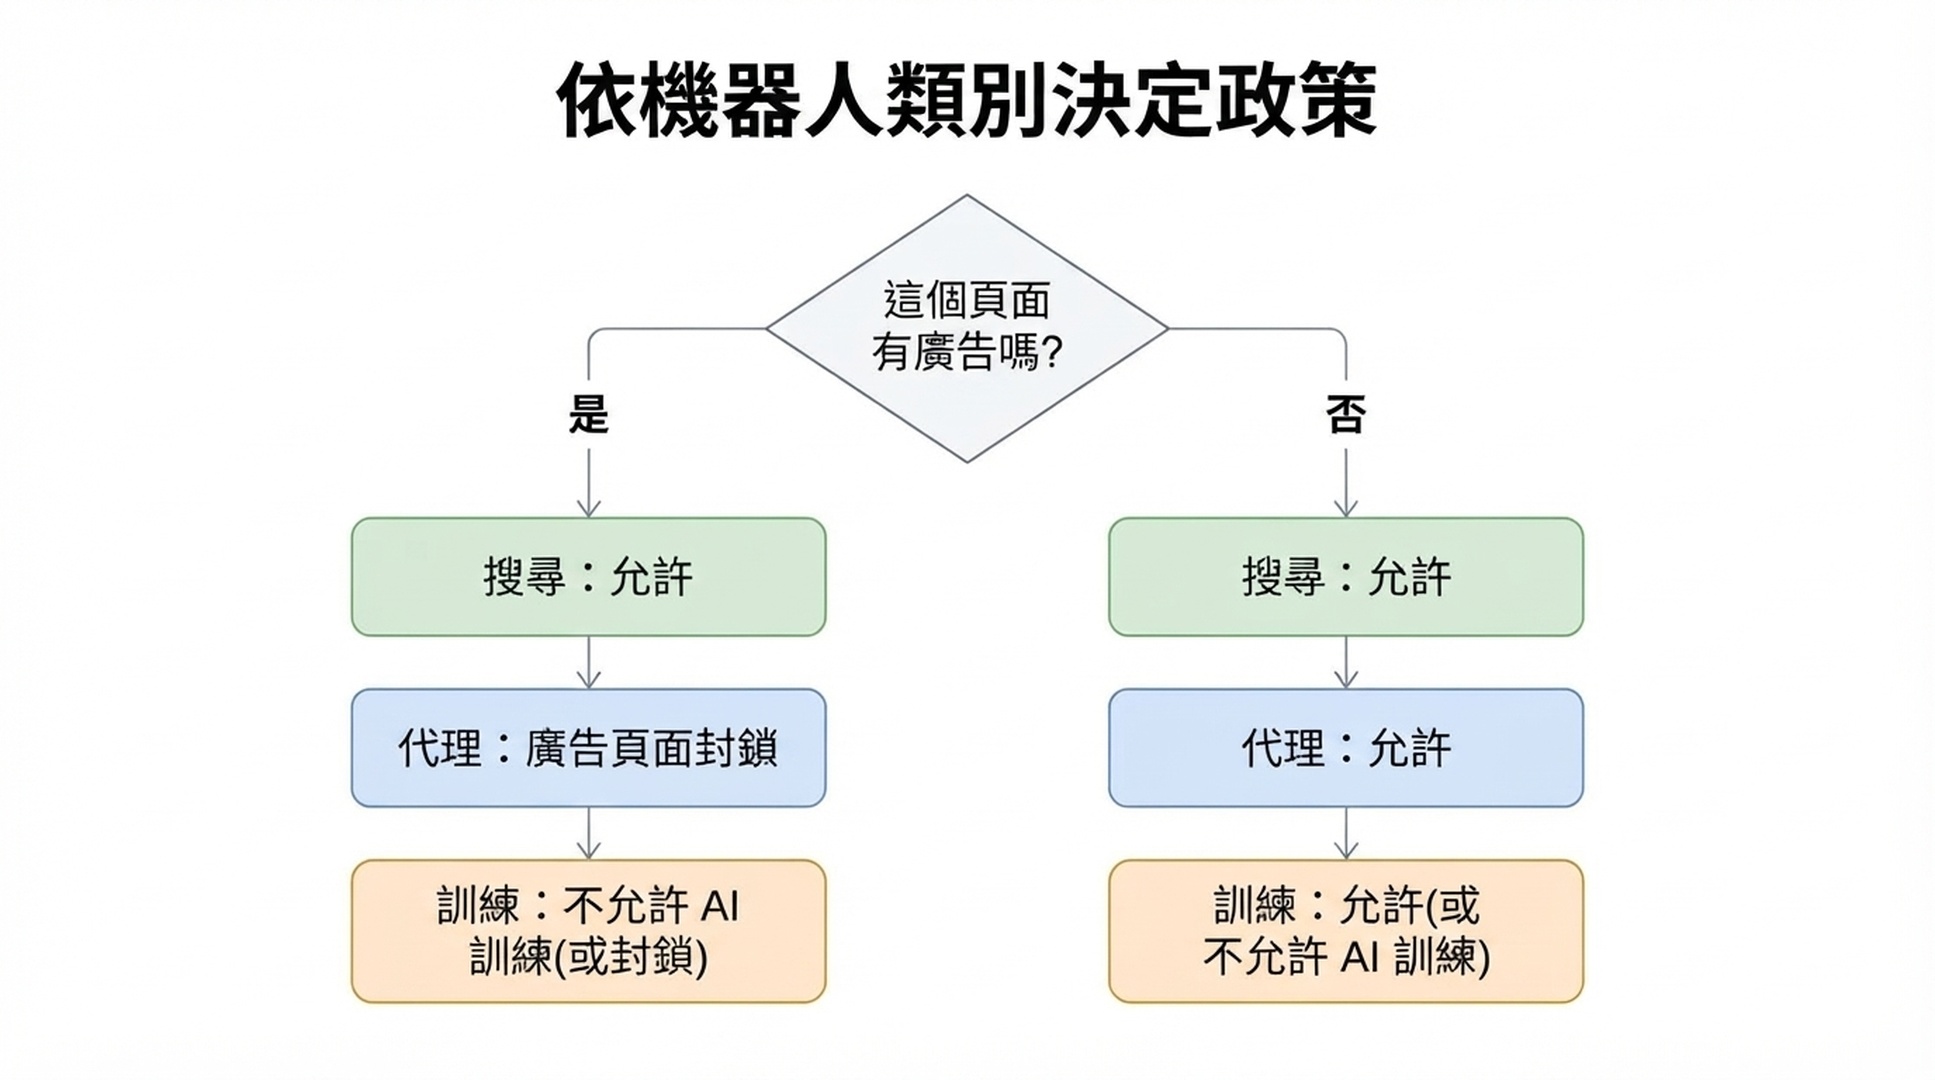
2026 年 9 月 15 日,Cloudflare 改變了自動套用的內容。對於在該日之後新加入 Cloudflare 的網域,若網站被標記為廣告變現,預設設定變成:
類別 | 廣告變現頁面上的預設值 |
|---|---|
搜尋(Search) | 允許 |
代理(Agent) | 在含廣告的頁面上封鎖 |
訓練(Training) | 不允許 AI 訓練(Disallow AI Training) |
未以廣告變現的新網域,三類預設都是允許。既有客戶並未被悄悄切換——Cloudflare 在 15 日之前提供了一段可透過儀表板退出的視窗期,而且實際的逐網域移轉規則比單一新預設值更細緻(下文會說明)。
廣告頁面會套用較嚴格預設值的原因在於:頁面上的廣告代表「本來預期會有人看到這一頁」。根據 Cloudflare 自家數字,2026 年 6 月時,把搜尋索引、代理抓取與訓練混在同一個使用者代理後面的「混合用途爬蟲」,佔了已驗證爬蟲流量的 超過 36%,是最大的單一類別。而在 Cloudflare 網路上,AI 訓練佔全部爬蟲請求的比例,從 2025 年春季的約 22% 成長到 2026 年 6 月的 52%。這次變更鎖定的就是這類流量。
開始之前:關於類別必須理解的三件事
1. 有些爬蟲是「混合用途」,在封鎖與不允許 AI 訓練之下的行為並不相同。 Googlebot、Bingbot 與 Applebot 各自身兼兩職——用同一個使用者代理同時為搜尋與訓練爬取。Cloudflare 把 Apple、Google、Microsoft 稱為「Accountable(可問責)」營運方,因為它們符合四項條件:尊重 robots.txt 中關於訓練的偏好設定、提供退出 AI 摘要的機制、能提供 URL 層級的可見性說明哪些內容被用於訓練,以及能證明退出訓練不會損害你的搜尋曝光。
2.「不允許 AI 訓練」與「封鎖」不是同一個設定,而這個差別正是重點。 不允許 AI 訓練會在 robots.txt 中發布針對訓練專用使用者代理(例如 Google-Extended、Applebot-Extended)的 Disallow 偏好。可問責的混合用途爬蟲會讀取該偏好,自願跳過訓練、繼續為搜尋而爬取——因此你的搜尋曝光得以保留。其他不屬於可問責營運方的訓練爬蟲,會在邊緣被直接封鎖,而這不影響搜尋,因為那些營運方另外運行獨立的訓練專用機器人。相對地,單純的封鎖在 9 月 15 日之後也會直接封鎖 Googlebot、Bingbot 與 Applebot,意味著你的內容同樣會從它們的搜尋結果中消失。如果你想要訓練消失但搜尋留存,該選的是「不允許 AI 訓練」,不是封鎖。
3. Bing 目前還不遵守 robots.txt 的訓練偏好。 Applebot 與 Googlebot 今日都會遵循訓練專用的 Disallow 指令。Microsoft 表示正在為 Bingbot 建立對應機制,目標是 2027 年初。在那之前,選擇「不允許 AI 訓練」會把你的偏好寫進 robots.txt,但 Bing 為了訓練而爬取的行為不會只因這個訊號而改變——若你特別在意透過 Bing 的訓練曝光,Bing 自家的 NOARCHIVE meta 標籤或 Content Removal 工具是過渡期的槓桿。
步驟 1:查出你的網站實際上落在哪裡
不要以為你知道目前的設定——去驗證它。
動作: 在 Cloudflare 儀表板中開啟你的網域,前往 Security → Settings,找到 AI 機器人政策控制項(較新的三類別介面已取代舊的單一「Block AI Bots」開關,但尚未移轉的帳號仍可能顯示舊開關)。另外,用瀏覽器或 curl https://yourdomain.com/robots.txt 取得線上 robots.txt,尋找以 Cloudflare 管理的註解標記開頭的區塊;你也可以用 Auspia 的 Robots.txt AI 爬蟲檢查工具 交叉比對,看看目前的規則對 AI 爬蟲讀起來是什麼樣子。
預期輸出: 三個設定,分別對應搜尋、代理、訓練,各自為「允許/在含廣告的頁面上封鎖/封鎖」其中之一(「不允許 AI 訓練」是訓練專屬的第四個選項)。若 Bot Preference Sync 或託管 robots.txt 已啟用,你的線上 robots.txt 應該會出現一段 Cloudflare 管理的區塊,列出特定機器人使用者代理與 Disallow/Content-Signal 行。
品質檢查: 確認這三個設定符合你真正的意圖,而不是移轉機制替你假設的結果。Cloudflare 說明的既有客戶移轉邏輯是:如果你先前開啟了舊版的「Block AI」開關,你會被移到訓練=不允許 AI 訓練、搜尋維持允許、代理=在含廣告的頁面上封鎖。如果你先前把訓練本身設為封鎖或在含廣告的頁面上封鎖,你會被移到不允許 AI 訓練。這兩條移轉路徑都假設你想保留搜尋——如果你其實想讓混合用途爬蟲完全消失(連搜尋也算在內),那並不是你現在的狀態,你必須明確選擇封鎖。
復原路徑: 若安全性設定只顯示單一舊版「Block AI Bots」開關、沒有三類別細分,代表你的帳號還沒移轉到新控制項。請尋找「Configure AI bot policies」這個獨立且較新的設定介面;過渡期間,細緻的控制項與舊開關並存,而未來就在那裡。
步驟 2:針對每個類別分別決定政策,不要一個籠統答案
這才是真正的決策步驟。請逐一處理每個類別。
搜尋。 幾乎沒人封鎖這一項——Cloudflare 指出不到 1% 的網站選擇封鎖搜尋機器人——因為失去搜尋曝光很少值得。除非你有特定理由(例如測試環境、付費牆後的封存內容)要把它排除在搜尋索引之外,否則預設選允許。
代理。 這些是當下正在替某個人即時行動的機器人——查價格、完成預訂、把一項事實拉進聊天回答。在變現或廣告頁面上封鎖代理流量之所以成為新的預設邏輯,是因為代理造訪不會產生人類造訪那樣的廣告曝光。如果你的商業模式依賴那份人類注意力(媒體、有展示型廣告的內容網站),在含廣告的頁面上封鎖是站得住腳的。如果你反而希望代理即使是在廣告頁面也能完成任務——例如代理帶來的流量在你這裡仍會轉換——請選允許。
訓練。 真正的決定在這裡,也是術語最容易讓人混淆的地方:
- 如果你想阻止內容被用於訓練模型,同時維持在 Google、Bing、Apple 搜尋產品中的曝光,請選不允許 AI 訓練(考量 Bing 目前的落後,請理解為「今日對 Google 與 Apple 有效,對 Bing 待補」)。這是 Cloudflare 建議的中間路線,也是專為搜尋與訓練之間的取捨而設計的設定。
- 只有在你願意以失去 Googlebot、Bingbot、Applebot 的搜尋爬取為代價,來同時封鎖它們的訓練模式行為時,才選封鎖。這現在是嚴格選項——自 9 月 15 日起,封鎖也適用於混合用途爬蟲,這是以往沒有的。
- 只有在你刻意接受內容被用來訓練 AI 模型時才選允許,例如你想把 AI 回答中的引用曝光最大化,並把被用於訓練當成可接受的代價。
動作: 在 Security → Settings → Configure AI bot policies 中,把三個下拉選單各自設為你的決定。
預期輸出: 儀表板應反映你對每個類別的明確選擇,並且(若 Bot Preference Sync 已開啟)開始自動發布相符的 robots.txt 區塊——不需要手動編輯檔案。
品質檢查: 用這句話重新檢視你對訓練的選擇:「我要不要保留搜尋曝光?」若要保留,那就是不允許 AI 訓練,不是封鎖,無論「封鎖」這個詞在阻止 AI 訓練上聽起來多麼誘人。
復原路徑: 如果你選了某個設定之後搜尋流量下滑,請檢查是不是誤選了封鎖而不是不允許 AI 訓練——這是這個設定中最常見的自傷錯誤,因為命名會讓「封鎖」聽起來像「做得更多」的選項,但對訓練而言,它實際上做了你可能不想要的事(連搜尋也一起失去)。
步驟 3:開啟 Bot Preference Sync,讓 robots.txt 與你的設定一致
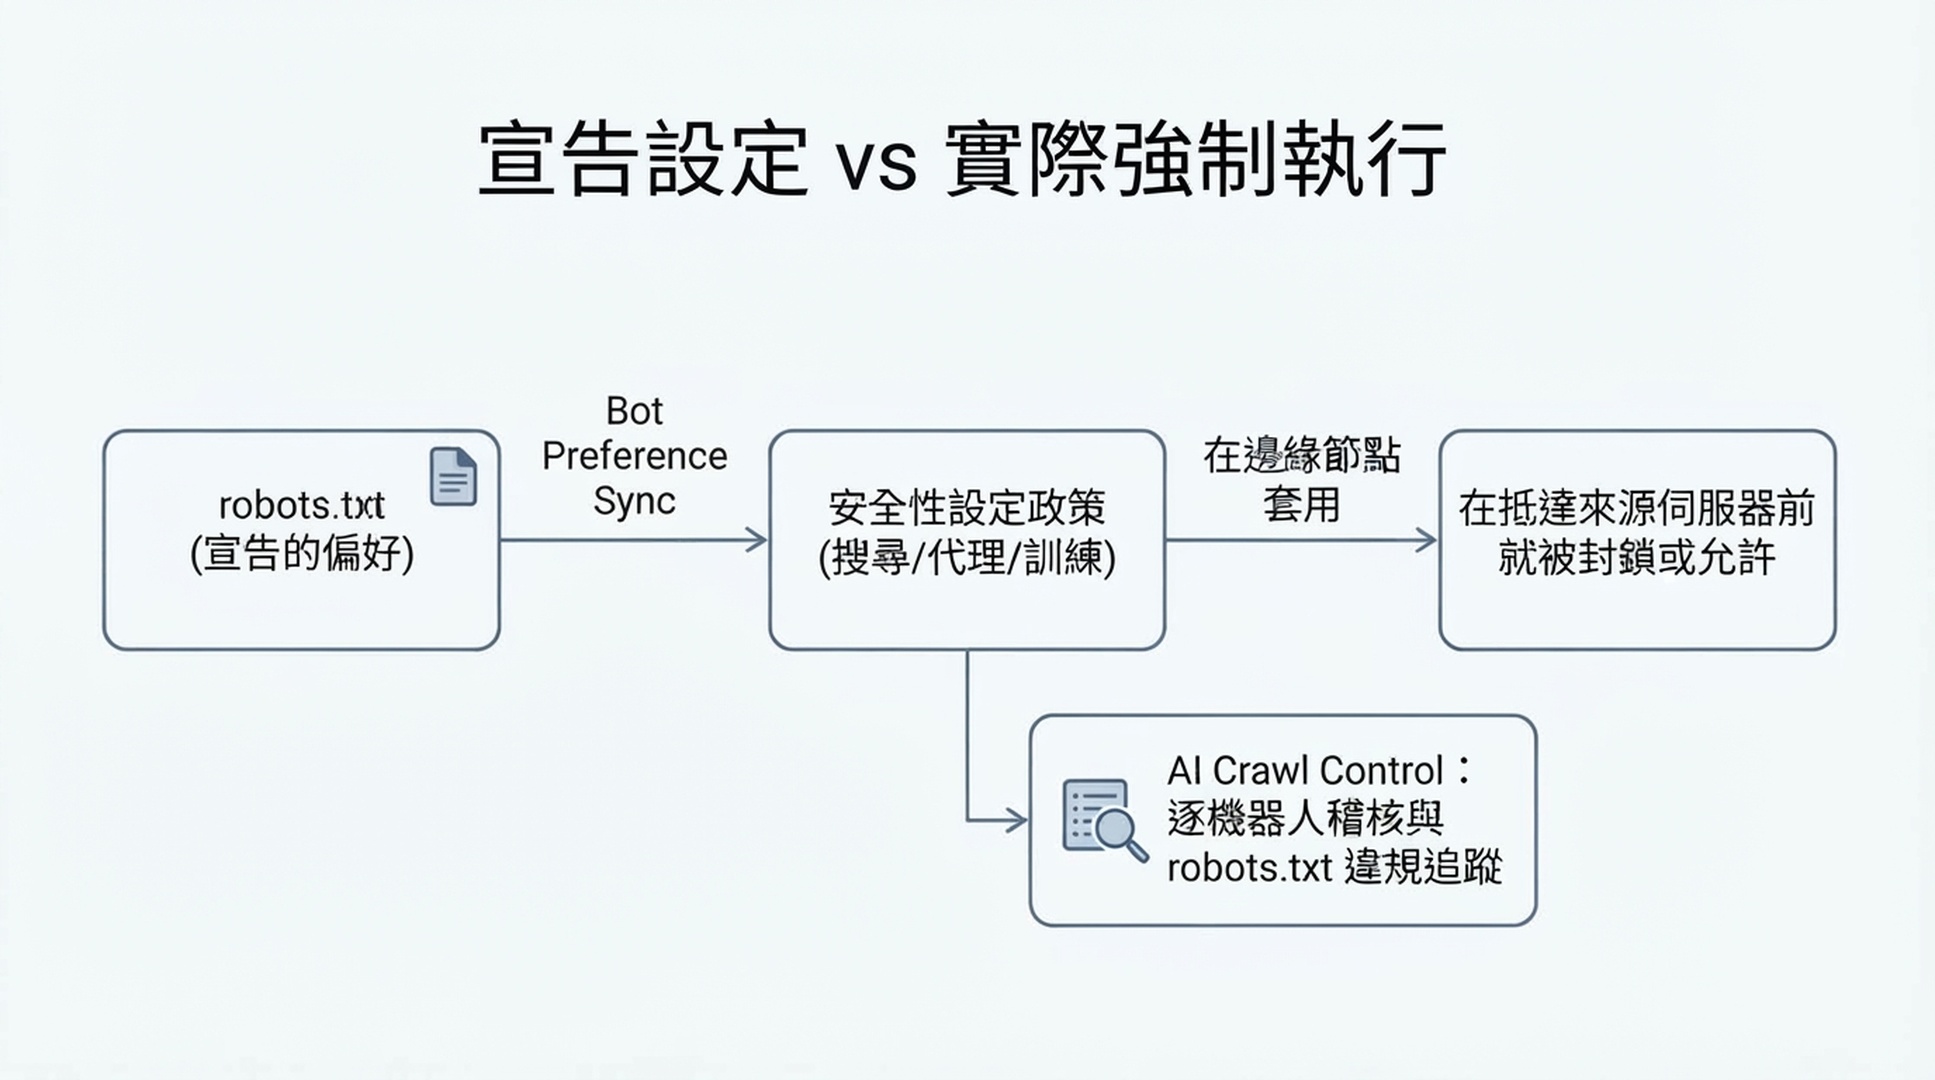
儀表板設定與 robots.txt 檔案是兩套不同的系統,當兩者不一致時,某些爬蟲會拿這個落差當藉口無視你的偏好。Cloudflare 的 Bot Preference Sync 直接從你的安全性設定產生 robots.txt,補上這個缺口。
動作: 在同一個 AI 機器人政策設定區塊中啟用 Bot Preference Sync(對新客戶預設為開啟;使用較舊託管 robots.txt 功能的既有客戶,會在移轉期間被提示檢視並確認)。
預期輸出: Cloudflare 會在你的 robots.txt 開頭加上一段託管區塊,以 # BEGIN Cloudflare Bot Preference Sync / # END 註解包住,列出受影響的特定使用者代理與其 Disallow 規則——而且不會刪除你原本 robots.txt 中已有的自訂規則,它們會保留在託管區塊下方。
品質檢查: 啟用後再次取得 /robots.txt,確認託管區塊出現且與步驟 2 的選擇相符——例如你若把訓練設為不允許 AI 訓練,應該會看到訓練專用的使用者代理(如 Google-Extended、Applebot-Extended)帶有 Disallow 規則,而通用型的 Googlebot/Applebot/Bingbot 使用者代理為了搜尋仍未被封鎖。
復原路徑: 如果你與某個特定爬蟲營運方有一次性特殊安排,而類別層級的政策會破壞它(例如付費內容授權合約),請關閉 Bot Preference Sync,改為手動編輯你自己的 robots.txt——類別開關是為整個網域的政策設計的,不是為個別營運方的例外設計的。
步驟 4:確認政策是真的被強制執行,而不只是被請求
robots.txt 是一個請求,它在技術層面擋不住無視它的爬蟲。這是大家最常跳過的一步,也是能告訴你步驟 2 的決定是真實還是理論的一步。
動作: 開啟你網域的 AI Crawl Control(所有方案皆可使用,包含 Free——在含 Bot Management 的方案上偵測品質更好,但可視性功能到處都能用)。查看 Crawlers 分頁,其中列出所有造訪過你網站的機器人,以及一欄 Robots.txt violations。
預期輸出: 一張列出各機器人請求數與違規數的表。你設為不允許或封鎖的機器人若違規數不為零,代表它目前正在無視你的 robots.txt。
品質檢查: 對任何顯示違規的機器人,查看「Most popular paths」(篩選到被標記的路徑),看它實際存取的內容是否真的是你在意、想保護的內容。
復原路徑: 如果某個機器人無視你宣告的偏好,單靠 robots.txt 擋不住它。使用 AI Crawl Control 中的「Enforce robots.txt rules」動作(有時以內部名稱 Robotcop 稱之),把你宣告的規則轉換成實際的 WAF 規則,讓不服從的機器人在抵達你的來源伺服器之前,就先在 Cloudflare 邊緣被封鎖——把你從「請求對方配合」推進到「強制對方配合」。這個步驟使用 WAF,因此可用性取決於你方案中的 WAF 存取權。
步驟 5:決定要單純封鎖,還是收費變現
如果你對訓練的決定是「不給訓練存取」,除了一律封鎖,你還有第二個選項:收費。
動作: 如果你有興趣,申請 Cloudflare 的 Pay Per Crawl 私人測試(透過 Cloudflare 的申請頁面,或 Enterprise 客戶可透過客戶經理)。在帳號層級啟用後(Manage Account → Settings → Pay Per Crawl → 把網域的 Visibility 設為 Visible),你可以為整個網域設定單一固定的一次請求價格,並針對每個爬蟲選擇允許(免費)、收費(依你的價格計費)或封鎖。
預期輸出: 當一個透過 Web Bot Auth(帶有 Ed25519 簽章、用以識別爬蟲的請求)認證的爬蟲要求你設為收費的頁面時,會收到附帶 crawler-price 標頭的 HTTP 402 Payment Required;若它同意付費後重試,或事先附上足以涵蓋你價格的 crawler-max-price 標頭,就會取得內容,並附上確認計費金額的 crawler-charged 標頭。Cloudflare 作為 merchant of record 處理結算。
品質檢查: 這只對已向 Cloudflare 註冊付款資訊並支援 402 流程的爬蟲有效,不是對所有機器人都通用的開關。對其他對象而言,你的收費設定實質上等同封鎖——Cloudflare 指出,這仍可作為你未來願意建立付費關係的訊號。
復原路徑: 這項功能仍在私人測試階段;若你未獲錄取或不想等待,對同樣這些爬蟲,目前可用的選項仍是不允許 AI 訓練或封鎖。
處理例外:如果有特定 AI 營運方要求存取
你可能會收到主動聯繫——合作提案、引用協議、授權洽談——來自想在整個網域政策之外取得明確存取的 AI 公司。
有兩種方式可以在不重新打開整個類別的前提下給予狹窄的例外:
- 在 Manage AI crawlers 中逐爬蟲覆寫: 把該特定機器人的列從封鎖/收費改為允許,獨立於你類別層級的訓練或代理設定。
- 直接手動編輯 robots.txt: 如果你已關閉 Bot Preference Sync(或把例外放在託管區塊之外),可以在 Cloudflare 管理區段下方,為那一個使用者代理加上針對性的 Allow。
無論採哪一種,請把網域層級的類別政策維持為預設,並把指名例外當成刻意、有紀錄的決定——而不是反過來。
驗證完成的結果
設定上線後,跑一遍這份檢查清單:
- [ ] 安全性設定對搜尋、代理、訓練都顯示明確、刻意的值——不是未經檢視的預設值
- [ ] 線上網域的
/robots.txt顯示與這些設定相符的 Cloudflare 託管區塊 - [ ] AI Crawl Control 的 Crawlers 分頁顯示你預期的機器人,且你設為封鎖/不允許的項目違規數為零或接近零
- [ ] 若你選擇不允許 AI 訓練,你已確認(透過 Search Console/Bing Webmaster Tools,或單純觀察自然流量)Googlebot/Applebot 的搜尋爬取仍正常進行
- [ ] 若你啟用了 robots.txt 強制執行(Robotcop),產生的 WAF 規則已部署並生效,而不只是產生後留在草稿
- [ ] 你已記錄選擇了哪個設定與原因,讓未來的檢視不必從零開始
維持成果
這不是設定完就能忘的設定。請用輕量的節奏重新檢視:
- 每月: 查看 AI Crawl Control 的 Metrics 分頁,找出你還沒決定政策的新機器人,並重新檢查違規數。
- 當 Bing 為 Bingbot 推出訓練偏好支援時(依 Microsoft 說法目標為 2027 年初):重新評估你目前的設定是否仍能達到你想要的「保留搜尋、封鎖訓練」結果,因為那正是 Bing 追上 Google 與 Apple 現行行為的時間點。
- 每當你的廣告變現狀態改變時:新增或移除展示型廣告會改變你的頁面落在哪一條預設軌道上,值得重新確認你的明確設定在該情況下仍合理。
常見問題
封鎖訓練爬蟲會傷害我的 SEO 排名嗎?如果你用的是不允許 AI 訓練而不是封鎖,就不會。不允許 AI 訓練是專為讓可問責的混合用途爬蟲(Google、Apple,以及將來的 Bing)在跳過訓練的同時繼續為搜尋爬取而設計的。相對地,單純的封鎖現在也會封鎖這些爬蟲的搜尋行為,這會損害你在它們搜尋產品中的曝光。
我在 9 月 15 日之前就已經開啟「Block AI Bots」,我的設定後來怎麼了? Cloudflare 自動移轉了它:舊版 Block AI Bots 變成訓練=不允許 AI 訓練、搜尋=允許、代理=在含廣告的頁面上封鎖。請用上面的步驟 1 驗證實際結果是否符合預期,而不是假設移轉符合你的意圖。
這些功能在 Free 方案上可用嗎?可以。AI Crawl Control、搜尋/代理/訓練的類別設定,以及 Bot Preference Sync 都可在所有方案使用,包括 Free。部分強制執行細節因方案而異——例如 robots.txt 強制執行透過 WAF 運作,而 Free 方案的機器人偵測依賴使用者代理字串,而非更進階的 Bot Management 偵測 ID。
AI Crawl Control 與 AI 機器人安全性設定有什麼不同?安全性設定是你決定政策的地方(每個類別的允許/廣告頁面封鎖/封鎖/不允許 AI 訓練)。AI Crawl Control 是你稽核實際狀況的地方——各機器人的請求數、robots.txt 違規、路徑層級細節——也是你可以把已宣告的 robots.txt 政策轉換成強制執行的 WAF 規則的地方。
設定這些之後,我需要手動編輯 robots.txt 嗎?若 Bot Preference Sync 已啟用就不需要——它會依你的儀表板設定寫入並維護適當的 robots.txt 區塊。只有在託管類別之外需要自訂的個別營運方例外時,才需要手動編輯。
作者:Julian Mercer,Auspia 的 14 年資歷技術 SEO 實務工作者。他撰寫關於可爬取性、結構化資料、渲染,以及讓內容可被 AI 讀取的技術基礎。