Apa yang anda peroleh selepas menamatkan panduan ini
Selepas menamatkan panduan ini, domain Cloudflare anda akan mempunyai dasar yang jelas dan sengaja ditetapkan bagi tiga kategori trafik bot AI yang berasingan — Search (carian), Agent (ejen) dan Training (latihan) — dan bukan tetapan lalai yang diwarisi oleh domain itu. Anda akan tahu dengan tepat bot mana yang dibenarkan, mana yang disekat dan pada halaman mana, serta robots.txt anda dan peraturan penguatkuasaan di tepi akan benar-benar selaras.
Untuk siapa: sesiapa yang mengendalikan laman web di belakang Cloudflare — penerbit, laman pemasaran SaaS, kedai e-dagang, blog — dan mahu memutuskan sendiri sama ada sistem AI boleh melatih model atas kandungan anda, meringkaskannya, atau membacanya melalui ejen, bukannya mewarisi pilihan yang dibuat oleh sesebuah platform.
Apa yang anda perlukan:
- Domain yang diproksi melalui Cloudflare (apa-apa pelan, termasuk pelan percuma; beberapa langkah di bawah terhad kepada pelan berbayar dan telah ditandakan)
- Akses papan pemuka dengan kebenaran sekurang-kurangnya untuk menukar tetapan keselamatan peringkat zon
- 20 hingga 30 minit untuk audit dan konfigurasi; selepas itu beberapa minit sehari atau seminggu untuk pemantauan
Takrif selesai: tetapan keselamatan zon anda menunjukkan pilihan yang sengaja dibuat (bukan tetapan lalai yang tidak pernah disemak) bagi carian, ejen dan latihan; /robots.txt produksi mencerminkan pilihan itu; dan anda telah mengesahkan dalam AI Crawl Control bahawa bot yang sepatutnya disekat benar-benar disekat.
Mengapa ia tiba-tiba penting: apa yang berubah pada 15 September
Cloudflare membina kawalan trafik AI secara berperingkat: daripada menambah Content Signals Policy pada robots.txt pada September 2025, sehingga "Content Independence Day" pada 1 Julai 2026 yang buat pertama kalinya memecahkan tingkah laku bot AI kepada tiga kategori bernama, bukan satu suis kasar "AI atau bukan AI":
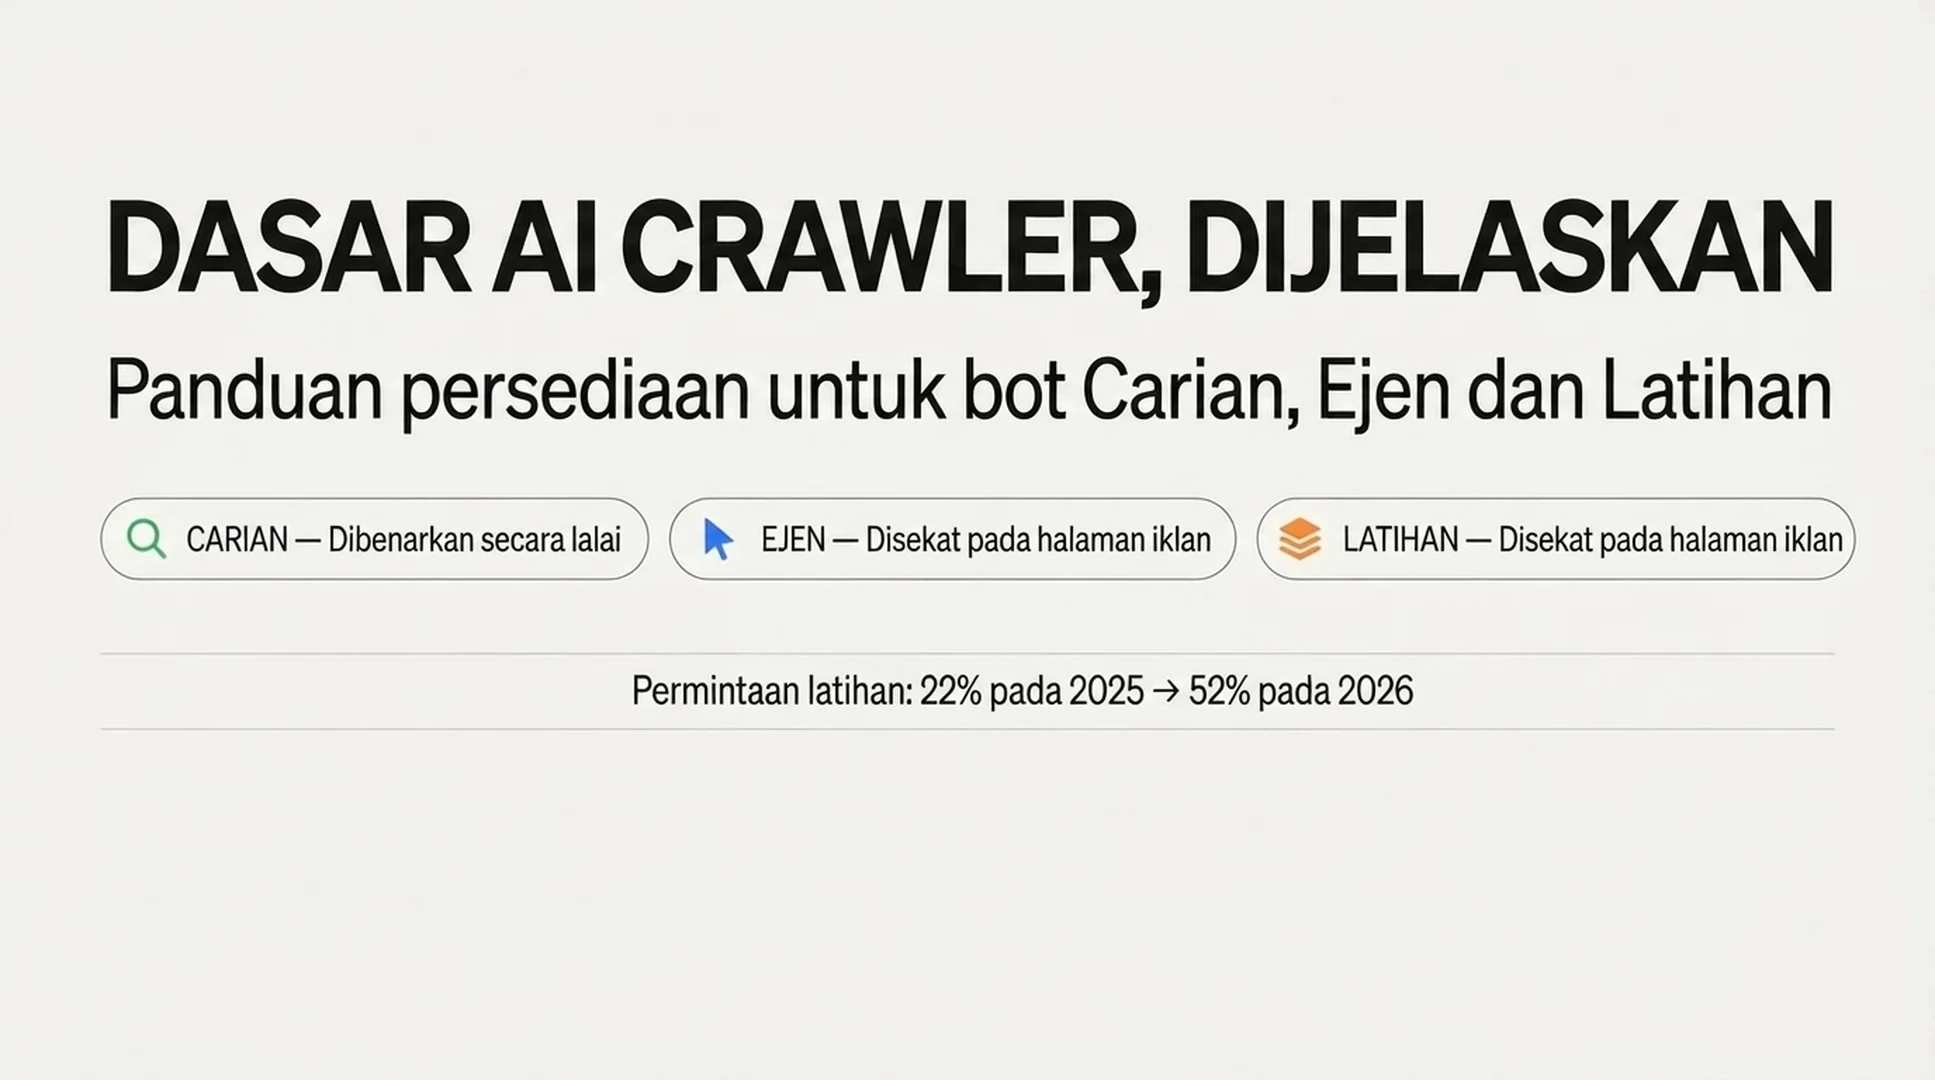
- Search (carian) — perayapan yang membina indeks carian, kemudian memulangkan pautan atau petikan pendek. Dalam kata-kata Cloudflare sendiri, inilah trafik yang sepatutnya membawa rujukan kepada anda.
- Agent (ejen) — aktiviti automatik yang bertindak bagi pihak seseorang dalam masa nyata, contohnya pembantu sembang yang mengambil halaman, atau ejen pelayar yang menyelesaikan tugasan.
- Training (latihan) — perayapan untuk melatih atau menala model, di mana kandungan anda diserap secara kekal ke dalam pemberat model dan bukan dipulangkan kepada anda sebagai pautan.
Pada 15 September 2026, Cloudflare mengubah apa yang berlaku secara automatik. Bagi setiap domain yang menyertai Cloudflare pada atau selepas tarikh itu, jika laman ditandakan sebagai dimonetisasi iklan, tetapan lalai menjadi:
Kategori | Lalai pada halaman beriklan |
|---|---|
Search (carian) | Benarkan |
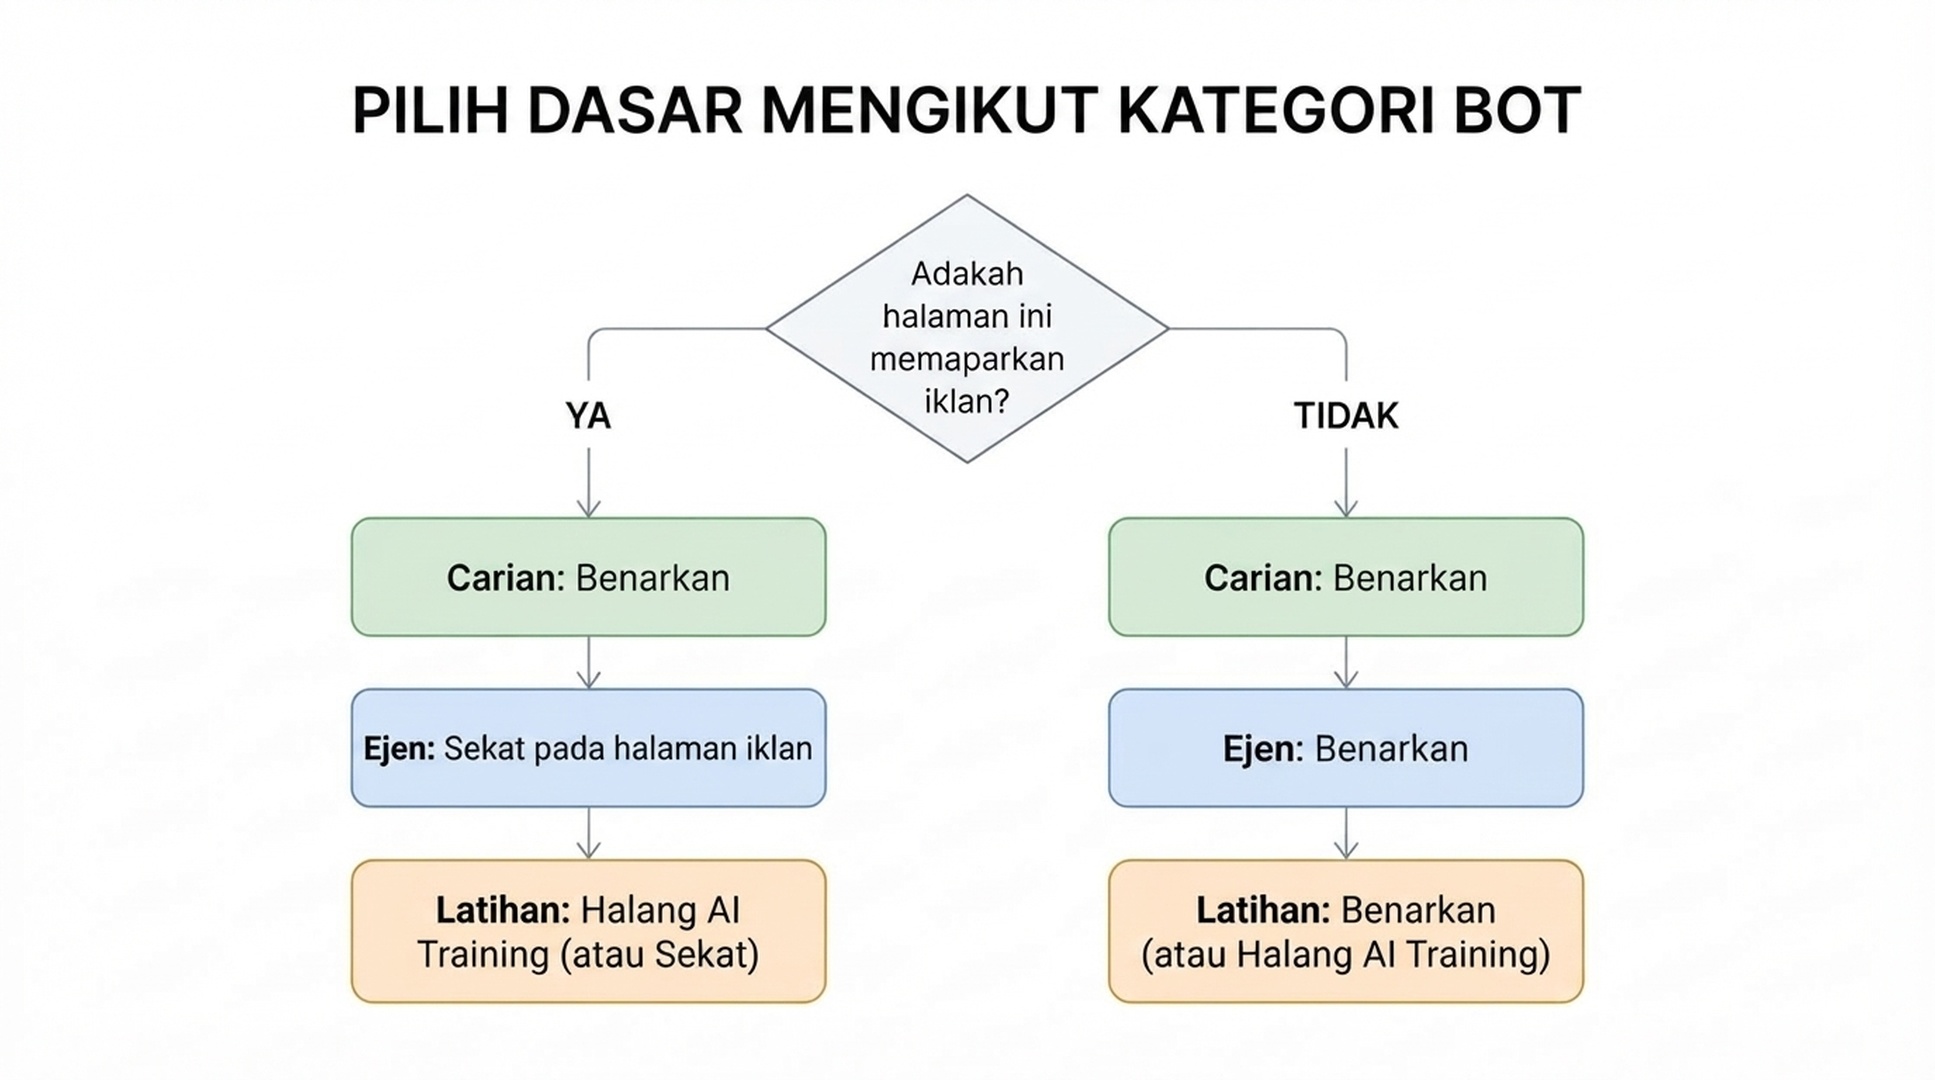
Agent (ejen) | Sekat pada halaman iklan |
Training (latihan) | Jangan benarkan Latihan AI |
Domain baharu tanpa monetisasi iklan mendapat "Benarkan" secara lalai dalam ketiga-tiga kategori. Pelanggan sedia ada tidak ditukar secara senyap — Cloudflare memberi tempoh untuk menarik diri melalui papan pemuka sebelum 15 haribulan, dan peraturan migrasi sebenar bagi setiap domain ternyata lebih terperinci daripada satu tetapan lalai baharu (dijelaskan di bawah).
Sebab halaman beriklan mendapat tetapan lalai yang lebih ketat ialah kehadiran iklan menandakan bahawa halaman itu memang dimaksudkan untuk dilihat manusia. Menurut data Cloudflare sendiri, pada Jun 2026 perayap penggunaan bercampur — yang menggabungkan pengindeksan carian, permintaan ejen dan latihan di bawah satu user agent — merangkumi lebih 36% trafik perayap yang disahkan, kategori tunggal terbesar. Dan bahagian latihan AI daripada jumlah permintaan bot dalam rangkaian Cloudflare meningkat daripada sekitar 22% pada musim bunga 2025 kepada 52% pada Jun 2026. Perubahan ini menyasarkan tepat trafik itu.
Sebelum bermula: tiga perkara yang perlu difahami tentang kategori
1. Sesetengah perayap menggunakan mod bercampur dan bertindak berbeza antara disekat dengan dilarang melatih. Googlebot, Bingbot dan Applebot melakukan dua kerja sekali gus — mereka mengindeks untuk carian dan untuk latihan di bawah user agent yang sama. Cloudflare memanggil Apple, Google dan Microsoft sebagai pengendali "Accountable" (bertanggungjawab) kerana mereka memenuhi empat syarat: menghormati keutamaan menolak latihan dalam robots.txt, menyediakan cara untuk menarik diri daripada ringkasan janaan AI, menunjukkan ketelusan peringkat URL tentang apa yang digunakan untuk latihan, dan boleh membuktikan bahawa penarikan diri daripada latihan tidak menjejaskan kehadiran carian anda.
2. "Jangan benarkan Latihan AI" dan "Sekat" bukan tetapan yang sama, dan perbezaan inilah inti pati keseluruhan isu. Jangan benarkan Latihan AI menerbitkan keutamaan Disallow dalam robots.txt yang disasarkan kepada user agent khusus latihan (seperti Google-Extended dan Applebot-Extended). Bot bercampur yang bertanggungjawab membaca keutamaan itu dan secara sukarela meneruskan pengindeksan untuk carian sambil melangkau latihan — dengan itu kehadiran carian anda terpelihara. Perayap latihan lain yang tidak bertanggungjawab disekat serta-merta di tepi, dan ini tidak menjejaskan carian kerana pengendali tersebut menjalankan bot latihan yang berasingan. Sebaliknya, Sekat semata-mata kini turut menyekat Googlebot, Bingbot dan Applebot sendiri, bermakna kandungan anda turut hilang daripada hasil carian mereka. Jika anda mahu membuang latihan tetapi mengekalkan carian, tetapan yang betul ialah "Jangan benarkan Latihan AI", bukan "Sekat".
3. Bing masih belum menghormati keutamaan latihan dalam robots.txt. Hari ini kedua-dua Applebot dan Googlebot mematuhi arahan Disallow khusus latihan. Microsoft menyatakan mereka sedang membina padanannya untuk Bingbot, dengan sasaran awal 2027. Sehingga itu, pilihan "Jangan benarkan Latihan AI" akan merekodkan keutamaan anda dalam robots.txt, tetapi tingkah laku perayapan latihan Bing tidak akan berubah semata-mata kerana isyarat itu — tag meta NOARCHIVE Bing sendiri atau alat Content Removal mereka kekal sebagai tuas sementara jika anda khususnya bimbang tentang latihan oleh Bing.
Langkah 1: Tentukan di mana laman anda sebenarnya berada
Jangan andaikan anda tahu tetapan semasa — pergilah semak.
Tindakan: dalam papan pemuka Cloudflare, buka domain anda, pergi ke Security → Settings dan cari kawalan dasar bot AI (antara muka baharu dengan tiga kategori menggantikan suis tunggal "Block AI Bots" yang lama, tetapi akaun yang belum dimigrasikan mungkin masih memaparkan suis lama). Secara berasingan, ambil robots.txt produksi dalam pelayar atau melalui curl https://yourdomain.com/robots.txt dan cari blok yang bermula dengan penanda komen yang diurus Cloudflare; atau bandingkan dengan pemeriksa perayap AI robots.txt daripada Auspia untuk melihat bagaimana peraturan semasa anda dibaca oleh bot AI.
Hasil yang dijangkakan: tiga tetapan — satu untuk carian, satu untuk ejen dan satu untuk latihan — masing-masing dengan nilai Benarkan / Sekat pada halaman iklan / Sekat (dengan "Jangan benarkan Latihan AI" sebagai pilihan keempat yang hanya tersedia untuk latihan). robots.txt produksi sepatutnya menunjukkan bahagian yang diurus Cloudflare yang menyenaraikan user agent tertentu bersama baris Disallow / Content-Signal jika Bot Preference Sync atau robots.txt terurus dihidupkan.
Semakan kualiti: pastikan ketiga-tiga tetapan mencerminkan apa yang anda benar-benar maksudkan, bukan apa yang migration andaikan untuk anda. Logik migrasi yang didokumenkan Cloudflare untuk pelanggan sedia ada ialah: jika anda sebelum ini menghidupkan suis "Block AI" yang lama, anda dipindahkan ke latihan = Jangan benarkan Latihan AI, carian kekal Benarkan, dan ejen ditetapkan kepada Sekat pada halaman iklan. Jika anda sebelum ini menetapkan latihan kepada Sekat atau Sekat pada halaman iklan sendiri, anda dipindahkan ke Jangan benarkan Latihan AI. Kedua-dua laluan migrasi menganggap anda mahu mengekalkan carian. Jika sebenarnya anda mahu bot bercampur hilang sepenuhnya, termasuk carian, itu bukan keadaan semasa anda dan anda perlu memilih Sekat secara eksplisit.
Laluan pemulihan: jika tetapan keselamatan hanya menunjukkan suis "Block AI Bots" lama tanpa pecahan tiga kategori, akaun anda belum dimigrasikan kepada kawalan baharu. Cari "Configure AI bot policies" — skrin tetapan yang berasingan dan lebih baharu; semasa tempoh peralihan, kawalan terperinci wujud bersama suis lama dan masa depan menuju ke arah itu.
Langkah 2: Tetapkan dasar bagi setiap kategori secara berasingan, bukan satu jawapan menyeluruh
Inilah langkah keputusan sebenar. Lalui setiap kategori satu demi satu.
Carian. Hampir tiada siapa menyekatnya — Cloudflare menyatakan kurang daripada 1% laman memilih menyekat bot carian — kerana kehilangan keterlihatan carian hampir tidak pernah berbaloi. Tetapkan Benarkan secara lalai, kecuali anda ada sebab khusus (persekitaran pentas, arkib di belakang tembok bayaran) untuk mengekalkan laman di luar indeks enjin carian.
Ejen. Ini bot yang bertindak dalam masa nyata bagi pihak seseorang yang sedang cuba melakukan sesuatu di laman anda sekarang: menyemak harga, menamatkan tempahan, mengeluarkan fakta untuk jawapan sembang. Menyekat trafik ejen pada halaman beriklan atau bermonetisasi ialah justifikasi bagi tetapan lalai baharu, kerana lawatan ejen tidak menghasilkan pendedahan iklan yang akan dihasilkan oleh lawatan manusia. Jika model perniagaan anda bergantung pada perhatian manusia itu (media, laman kandungan dengan iklan paparan), Sekat pada halaman iklan ialah pendirian bertahan. Jika anda mahu ejen dapat menyelesaikan tugasan di laman anda walaupun pada halaman beriklan — contohnya kerana trafik ejen sebenarnya menukar untuk anda — pilih Benarkan.
Latihan. Di sinilah keputusan sebenar terletak, dan di sinilah istilah mengelirukan:
- Pilih Jangan benarkan Latihan AI jika anda mahu menghalang kandungan digunakan untuk melatih model sambil kekal hadir dalam produk carian Google, Bing dan Apple (dengan kelewatan Bing sekarang, fahamkannya sebagai "berkuat kuasa untuk Google dan Apple hari ini, sementara menunggu Bing"). Ini jalan tengah yang disyorkan Cloudflare, dibina tepat untuk mengimbangi carian dengan latihan.
- Pilih Sekat hanya jika anda sanggup kehilangan sepenuhnya pengindeksan carian oleh Googlebot, Bingbot dan Applebot sebagai harga untuk menyekat tingkah laku latihan mereka. Ini kini pilihan yang keras: sejak 15 September, sekatan itu turut terpakai kepada perayap bercampur, sesuatu yang tidak berlaku sebelum ini.
- Pilih Benarkan hanya jika anda secara sedar menerima bahawa kandungan anda akan melatih model AI — contohnya kerana anda mahu keterlihatan maksimum dalam jawapan AI dan menganggap latihan sebagai harga yang boleh diterima.
Tindakan: dalam Security → Settings → Configure AI bot policies, tetapkan ketiga-tiga senarai mengikut keputusan anda.
Hasil yang dijangkakan: papan pemuka sepatutnya mencerminkan pilihan eksplisit anda pada setiap kategori dan (jika Bot Preference Sync dihidupkan) mula menerbitkan secara automatik blok robots.txt yang sepadan — tanpa penyuntingan fail secara manual.
Semakan kualiti: baca semula keputusan latihan anda dan ujinya dengan satu soalan: "Adakah saya mahu mengekalkan keterlihatan carian?" Jika ya, jawapannya ialah Jangan benarkan Latihan AI, bukan Sekat — walaupun perkataan "Sekat" kedengaran seperti cara yang lebih tegas untuk menghentikan latihan AI.
Laluan pemulihan: jika trafik carian menjunam selepas memilih tetapan, semak sama ada anda tersilap memilih Sekat dan bukan Jangan benarkan Latihan AI. Inilah kesilapan mencederakan diri yang paling biasa di sini: namanya membuatkan "Sekat" kelihatan seperti pilihan yang "buat lebih banyak", tetapi bagi latihan ia melakukan perkara yang mungkin anda tidak mahu — ia turut mengambil carian.
Langkah 3: Hidupkan Bot Preference Sync supaya robots.txt mengikut tetapan anda
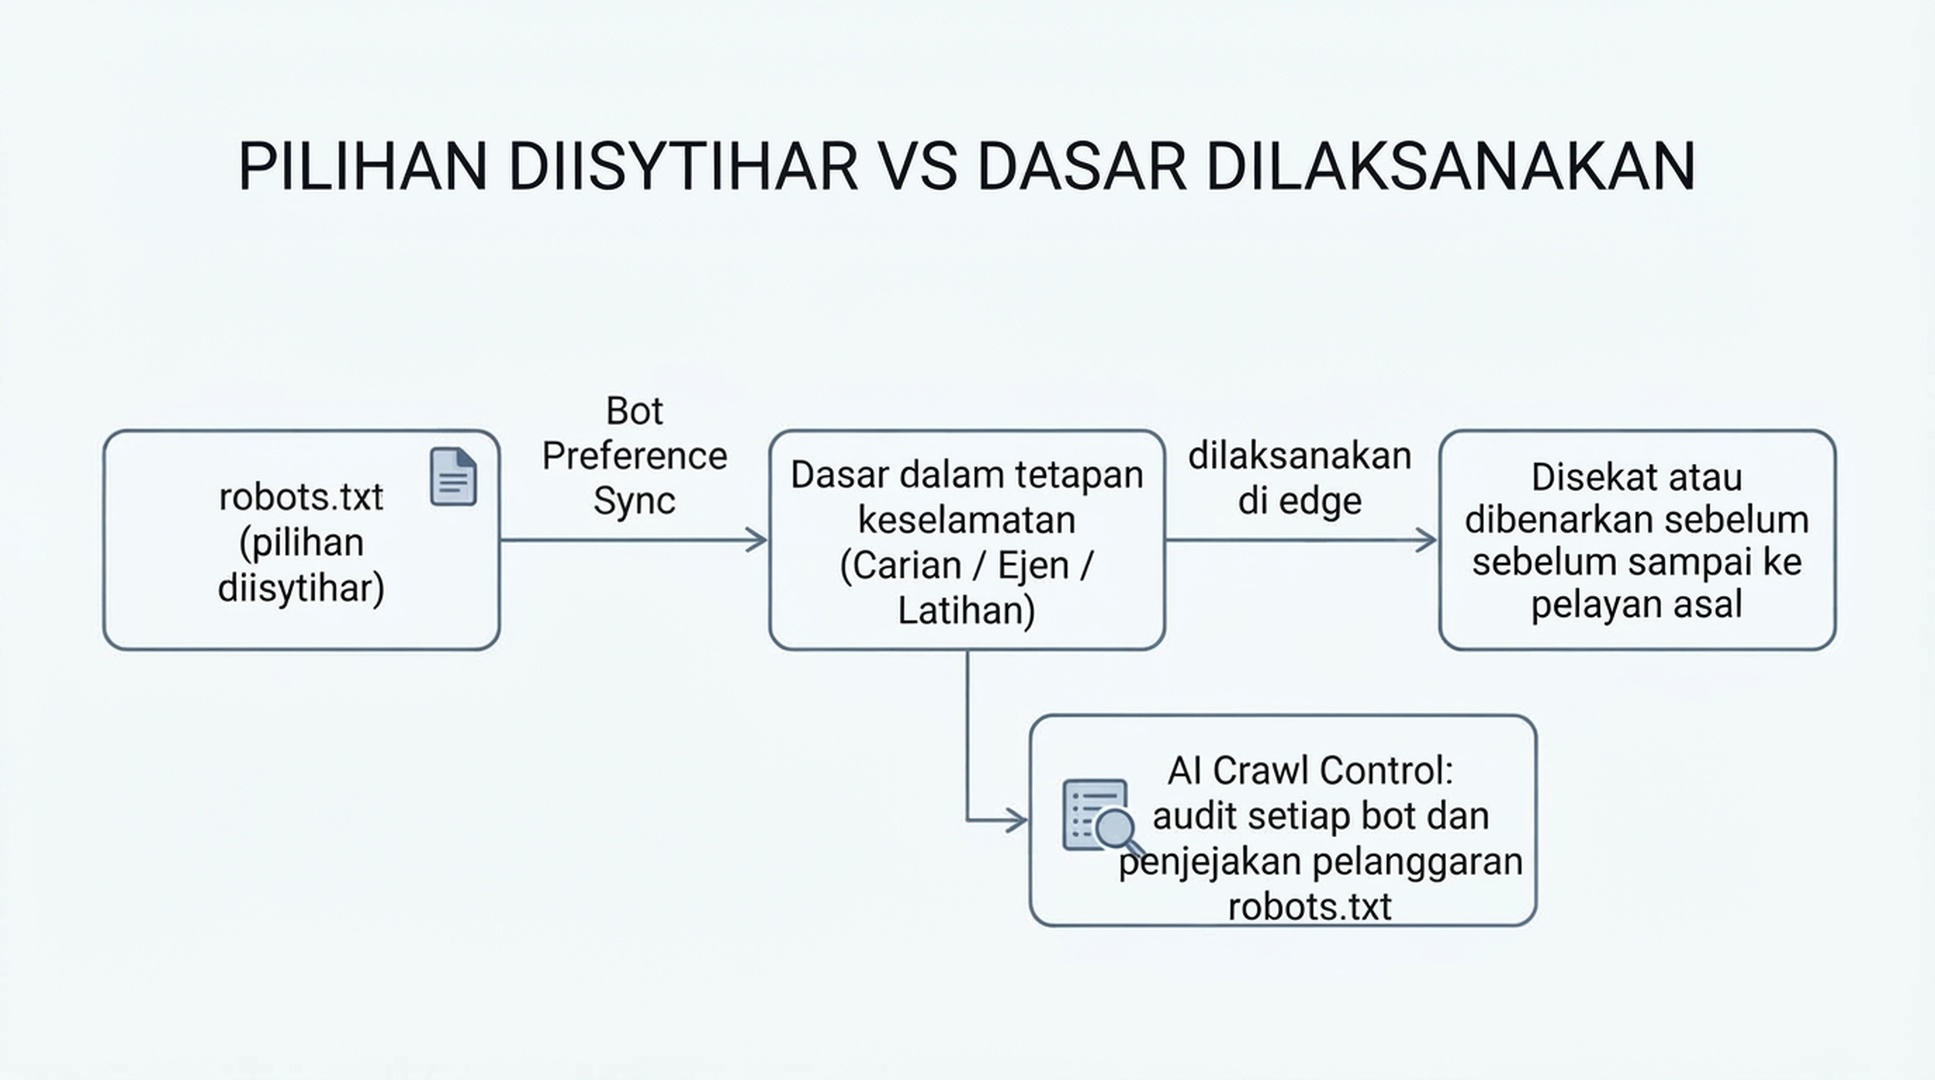
Tetapan papan pemuka dan fail robots.txt ialah dua sistem berlainan, dan apabila kedua-duanya tidak selaras, sesetengah bot mengambil percanggahan itu sebagai alasan untuk mengabaikan keutamaan anda. Bot Preference Sync daripada Cloudflare menutup jurang ini dengan menjana robots.txt anda terus daripada kawalan keselamatan yang anda pilih.
Tindakan: dalam kawasan dasar bot AI yang sama, hidupkan Bot Preference Sync (ia dihidupkan secara lalai untuk pelanggan baharu; pelanggan sedia ada yang menggunakan ciri robots.txt terurus versi lama akan diminta menyemak dan mengesahkannya semasa migrasi).
Hasil yang dijangkakan: Cloudflare menambah satu blok terurus di bahagian atas robots.txt anda, dibalut dengan komen # BEGIN Cloudflare Bot Preference Sync / # END, menyenaraikan user agent yang dilindungi dan peraturan Disallow mereka — dan ia tidak membuang mana-mana peraturan yang anda sendiri sudah tulis dalam robots.txt; peraturan itu kekal di bawah blok terurus.
Semakan kualiti: muat turun /robots.txt semula selepas dihidupkan dan pastikan blok terurus telah muncul dan sepadan dengan pilihan Langkah 2. Contohnya, jika anda menetapkan latihan kepada Jangan benarkan Latihan AI, anda sepatutnya melihat user agent khusus latihan (Google-Extended, Applebot-Extended) dengan peraturan Disallow, sementara Googlebot / Applebot / Bingbot umum kekal tidak disekat untuk carian.
Laluan pemulihan: jika anda mempunyai perjanjian khas sekali sahaja dengan pengendali bot tertentu yang akan dilanggar oleh dasar peringkat kategori (contohnya kontrak pelesenan kandungan berbayar), matikan Bot Preference Sync dan sunting robots.txt anda secara manual: suis kategori direka untuk dasar seluruh zon, bukan untuk pengecualian pengendali tunggal.
Langkah 4: Sahkan dasar itu benar-benar dikuatkuasakan, bukan sekadar dipohon
robots.txt secara teknikalnya ialah satu permohonan: ia tidak akan menghentikan bot yang mengabaikannya. Inilah langkah yang orang langkau, dan inilah yang menunjukkan sama ada keputusan Langkah 2 anda benar-benar wujud atau hanya di atas kertas.
Tindakan: buka AI Crawl Control untuk zon anda (tersedia pada semua pelan, termasuk pelan percuma — kualiti pengesanan lebih baik pada pelan dengan Bot Management, tetapi ciri keterlihatan berfungsi di mana-mana). Lihat tab Crawlers, yang menyenaraikan semua bot yang telah sampai ke laman anda, bersama lajur Robots.txt violations.
Hasil yang dijangkakan: jadual dengan bilangan permintaan dan bilangan pelanggaran bagi setiap bot. Bot yang anda tetapkan kepada jangan benarkan atau sekat tetapi menunjukkan pelanggaran lebih daripada sifar bermakna bot itu sedang mengabaikan robots.txt anda.
Semakan kualiti: bagi setiap bot yang mempunyai pelanggaran, lihat "Most popular paths" (ditapis kepada laluan yang ditandakan) untuk melihat apa sebenarnya yang diminta, dan nilai sama ada ia sampai kepada kandungan yang anda benar-benar mahu lindungi.
Laluan pemulihan: jika sesuatu bot mengabaikan keutamaan yang anda isytiharkan, robots.txt sahaja tidak akan menghentikannya. Gunakan tindakan "Enforce robots.txt rules" dalam AI Crawl Control (kadangkala dipanggil Robotcop secara dalaman) untuk menukar peraturan yang diisytiharkan menjadi peraturan WAF sebenar yang menyekat bot derhaka di tepi Cloudflare sebelum ia menyentuh pelayan asal anda — anda beralih daripada "memohon pematuhan" kepada "menguatkuasakan pematuhan". Langkah ini menggunakan WAF, jadi ketersediaannya bergantung pada sama ada pelan anda mempunyai akses WAF.
Langkah 5: Putuskan sama ada mahu menyekat terus atau mengenakan bayaran untuk akses
Jika keputusan latihan anda ialah "tiada akses untuk latihan", anda mempunyai pilihan kedua selain menyekat sepenuhnya: mengenakan bayaran.
Tindakan: jika anda berminat, mohon penyertaan beta tertutup Pay Per Crawl Cloudflare (melalui halaman pendaftaran Cloudflare, atau melalui pengurus akaun anda jika anda pelanggan Enterprise). Selepas dihidupkan pada peringkat akaun (Manage Account → Settings → Pay Per Crawl → tetapkan Visibility domain anda kepada Visible), anda boleh menetapkan satu harga tetap bagi setiap permintaan untuk seluruh zon dan memilih bagi setiap bot: benarkan (percuma), caj bayaran (pada kadar anda), atau sekat.
Hasil yang dijangkakan: apabila bot yang disahkan melalui Web Bot Auth (permintaan bertandatangan Ed25519 yang mengenal pasti bot itu) meminta halaman yang anda tandakan sebagai berbayar, ia menerima HTTP 402 Payment Required bersama pengepala crawler-price; jika ia mencuba semula dan bersetuju membayar, atau terus menghantar pengepala crawler-max-price yang menampung kadar anda, ia menerima kandungan itu bersama pengepala crawler-charged yang mengesahkan jumlah yang dicaj. Cloudflare bertindak sebagai merchant of record dan mengendalikan penyelesaian pembayaran.
Semakan kualiti: ini hanya berfungsi untuk bot yang telah mendaftarkan butiran pembayaran dengan Cloudflare dan mengendalikan aliran 402; ia bukan suis sejagat untuk semua bot. Bagi semua yang lain, tetapan caj anda berkelakuan seperti sekatan dalam praktik — Cloudflare sendiri menyatakan ia tetap berfungsi sebagai isyarat bahawa anda terbuka kepada hubungan berbayar pada masa hadapan.
Laluan pemulihan: ciri ini dalam beta tertutup; jika anda tidak diterima atau tidak mahu menunggu, Jangan benarkan Latihan AI atau Sekat kekal tersedia untuk bot yang sama hari ini.
Mengendalikan pengecualian: apabila pengendali AI tertentu meminta akses
Sesebuah syarikat AI mungkin menghubungi anda — cadangan perkongsian, perjanjian petikan, rundingan pelesenan — dan mahukan akses eksplisit di luar dasar seluruh zon.
Ada dua cara memberi pengecualian sempit tanpa membuka semula keseluruhan kategori:
- Ganti per bot dalam Manage AI crawlers: tukar baris bot itu daripada sekat/caj kepada benarkan, tanpa mengira tetapan latihan atau ejen pada peringkat kategori.
- Suntingan manual robots.txt: jika anda telah mematikan Bot Preference Sync (atau sedang meletakkan pengecualian di luar blok terurus), anda boleh menambah Allow bersasar untuk satu user agent itu di bawah bahagian yang diurus Cloudflare.
Dalam kedua-dua kes, kekalkan dasar kategori seluruh zon sebagai lalai dan anggap pengecualian yang dinamakan sebagai keputusan yang sengaja dibuat dan didokumenkan — bukan sebaliknya.
Sahkan hasilnya
Lalui senarai ini apabila konfigurasi telah berkuat kuasa:
- [ ] Tetapan keselamatan menunjukkan nilai yang eksplisit dan sengaja dipilih bagi carian, ejen dan latihan — bukan tetapan lalai yang tidak pernah disemak
- [ ]
/robots.txtproduksi menunjukkan blok terurus Cloudflare yang sepadan dengan tetapan tersebut - [ ] Tab Crawlers dalam AI Crawl Control menunjukkan bot yang dijangkakan, dengan pelanggaran sifar atau hampir sifar bagi semua yang anda tetapkan kepada sekat/jangan benarkan
- [ ] Jika anda memilih Jangan benarkan Latihan AI, anda telah mengesahkan (melalui Search Console / Bing Webmaster Tools, atau sekadar memerhati trafik organik) bahawa pengindeksan carian oleh Googlebot / Applebot berjalan seperti biasa
- [ ] Jika anda menghidupkan penguatkuasaan robots.txt (Robotcop), peraturan WAF yang terhasil telah digunakan dan aktif, bukan hanya dicipta lalu ditinggalkan sebagai draf
- [ ] Anda telah mendokumentasikan tetapan mana yang anda pilih dan mengapa, supaya semakan pada masa hadapan tidak bermula dari kosong
Kekalkan hasilnya
Ini bukan konfigurasi "set dan lupakan". Kembalilah kepadanya mengikut rentak yang ringan:
- Setiap bulan: semak tab Metrics dalam AI Crawl Control untuk bot baharu yang belum anda tetapkan dasar, dan sahkan semula angka pelanggaran.
- Apabila Bing mengeluarkan sokongan keutamaan latihan untuk Bingbot (Microsoft menyasarkan awal 2027): nilai semula sama ada konfigurasi semasa anda masih menghasilkan hasil yang dimaksudkan — carian terpelihara, latihan disekat — kerana itulah titik Bing menyusul tingkah laku semasa Google dan Apple.
- Setiap kali status monetisasi iklan anda berubah: menambah atau membuang iklan paparan mengubah laluan lalai yang dimasuki halaman anda, dan adalah wajar untuk mengesahkan bahawa tetapan eksplisit anda masih masuk akal dalam keadaan tersebut.
Soalan lazim
Adakah menyekat bot latihan akan menjejaskan kedudukan SEO saya? Tidak, jika anda menggunakan Jangan benarkan Latihan AI dan bukan Sekat. Jangan benarkan Latihan AI dicipta tepat supaya bot bercampur yang bertanggungjawab (Google, Apple dan kemudiannya Bing) terus mengindeks untuk carian sambil melangkau latihan. Sebaliknya, Sekat semata-mata kini turut menyekat tingkah laku carian bot yang sama, yang akan menjejaskan keterlihatan anda dalam produk carian mereka.
Saya sudah menghidupkan "Block AI Bots" sebelum 15 September. Apa jadi kepada tetapan saya? Cloudflare memigrasikannya secara automatik: Block AI Bots yang lama menjadi latihan = Jangan benarkan Latihan AI, carian = Benarkan, dan ejen = Sekat pada halaman iklan. Lakukan Langkah 1 di atas untuk melihat sama ada hasil sebenarnya seperti yang dijangkakan, bukannya menganggap migrasi itu sepadan dengan niat anda.
Adakah mana-mana bahagian ini tersedia pada pelan percuma? Ya. AI Crawl Control, tetapan kategori carian/ejen/latihan dan Bot Preference Sync semuanya berfungsi pada semua pelan, termasuk pelan percuma. Sesetengah perincian penguatkuasaan bergantung pada pelan — contohnya penguatkuasaan robots.txt berjalan melalui WAF, dan pengenalan bot pada pelan percuma bergantung pada rentetan user agent dan bukan pengecam pengesanan Bot Management yang lebih maju.
Apa beza AI Crawl Control dengan tetapan keselamatan bot AI? Tetapan keselamatan ialah tempat anda menetapkan dasar (benarkan / sekat pada halaman iklan / sekat / jangan benarkan Latihan AI bagi setiap kategori). AI Crawl Control ialah tempat anda mengaudit apa yang sebenarnya berlaku — bilangan permintaan bagi setiap bot, pelanggaran robots.txt, perincian peringkat laluan — dan juga tempat anda boleh menukar dasar robots.txt yang diisytiharkan menjadi peraturan WAF yang dikuatkuasakan.
Selepas mengkonfigurasi semua ini, adakah saya perlu menyunting robots.txt secara manual? Tidak, jika Bot Preference Sync dihidupkan: ia menulis dan menyelenggara blok robots.txt yang sepadan dengan tetapan papan pemuka anda. Penyuntingan manual hanya diperlukan untuk pengecualian sekali sahaja bagi pengendali tertentu, di luar kategori terurus.
Penulis: Julian Mercer, pengamal technical SEO dengan 14 tahun pengalaman di Auspia. Beliau menulis tentang keboleharayapan, data berstruktur, pemaparan dan asas teknikal yang menjadikan kandungan mudah dibaca oleh AI.