Apa yang Anda dapatkan setelah menyelesaikan panduan ini
Setelah menyelesaikan panduan ini, domain Cloudflare Anda akan punya kebijakan yang eksplisit dan sengaja Anda tentukan untuk tiga kategori terpisah dari lalu lintas bot AI — pencarian (Search), agen (Agent), dan pelatihan (Training) — bukan setelan bawaan yang diwarisi domain Anda. Anda akan tahu persis bot mana yang diizinkan, mana yang diblokir, dan di halaman mana, dengan robots.txt serta aturan penegakan di edge yang benar-benar konsisten satu sama lain.
Untuk siapa ini: siapa pun yang mengelola situs di balik Cloudflare — penerbit, situs pemasaran SaaS, toko e-commerce, blog — dan ingin memutuskan sendiri apakah sistem AI boleh melatih, meringkas, atau menjelajahi konten Anda lewat agen, alih-alih mewarisi setelan yang dipilih platform.
Yang Anda butuhkan:
- Domain yang diproksikan melalui Cloudflare (paket apa pun termasuk Free; beberapa langkah di bawah khusus paket berbayar dan sudah ditandai)
- Akses dasbor dengan izin minimal untuk mengubah setelan keamanan tingkat domain
- Waktu 20 sampai 30 menit untuk mengaudit dan mengonfigurasi; setelah itu beberapa menit per hari atau per minggu untuk memantau
Definisi selesai: setelan keamanan zona Anda menampilkan pilihan yang sengaja Anda buat (bukan bawaan yang belum ditinjau) untuk pencarian, agen, dan pelatihan; /robots.txt yang aktif mencerminkan pilihan itu; dan Anda sudah memastikan di AI Crawl Control bahwa bot yang seharusnya diblokir memang benar-benar diblokir.
Mengapa ini mendadak penting: apa yang berubah pada 15 September
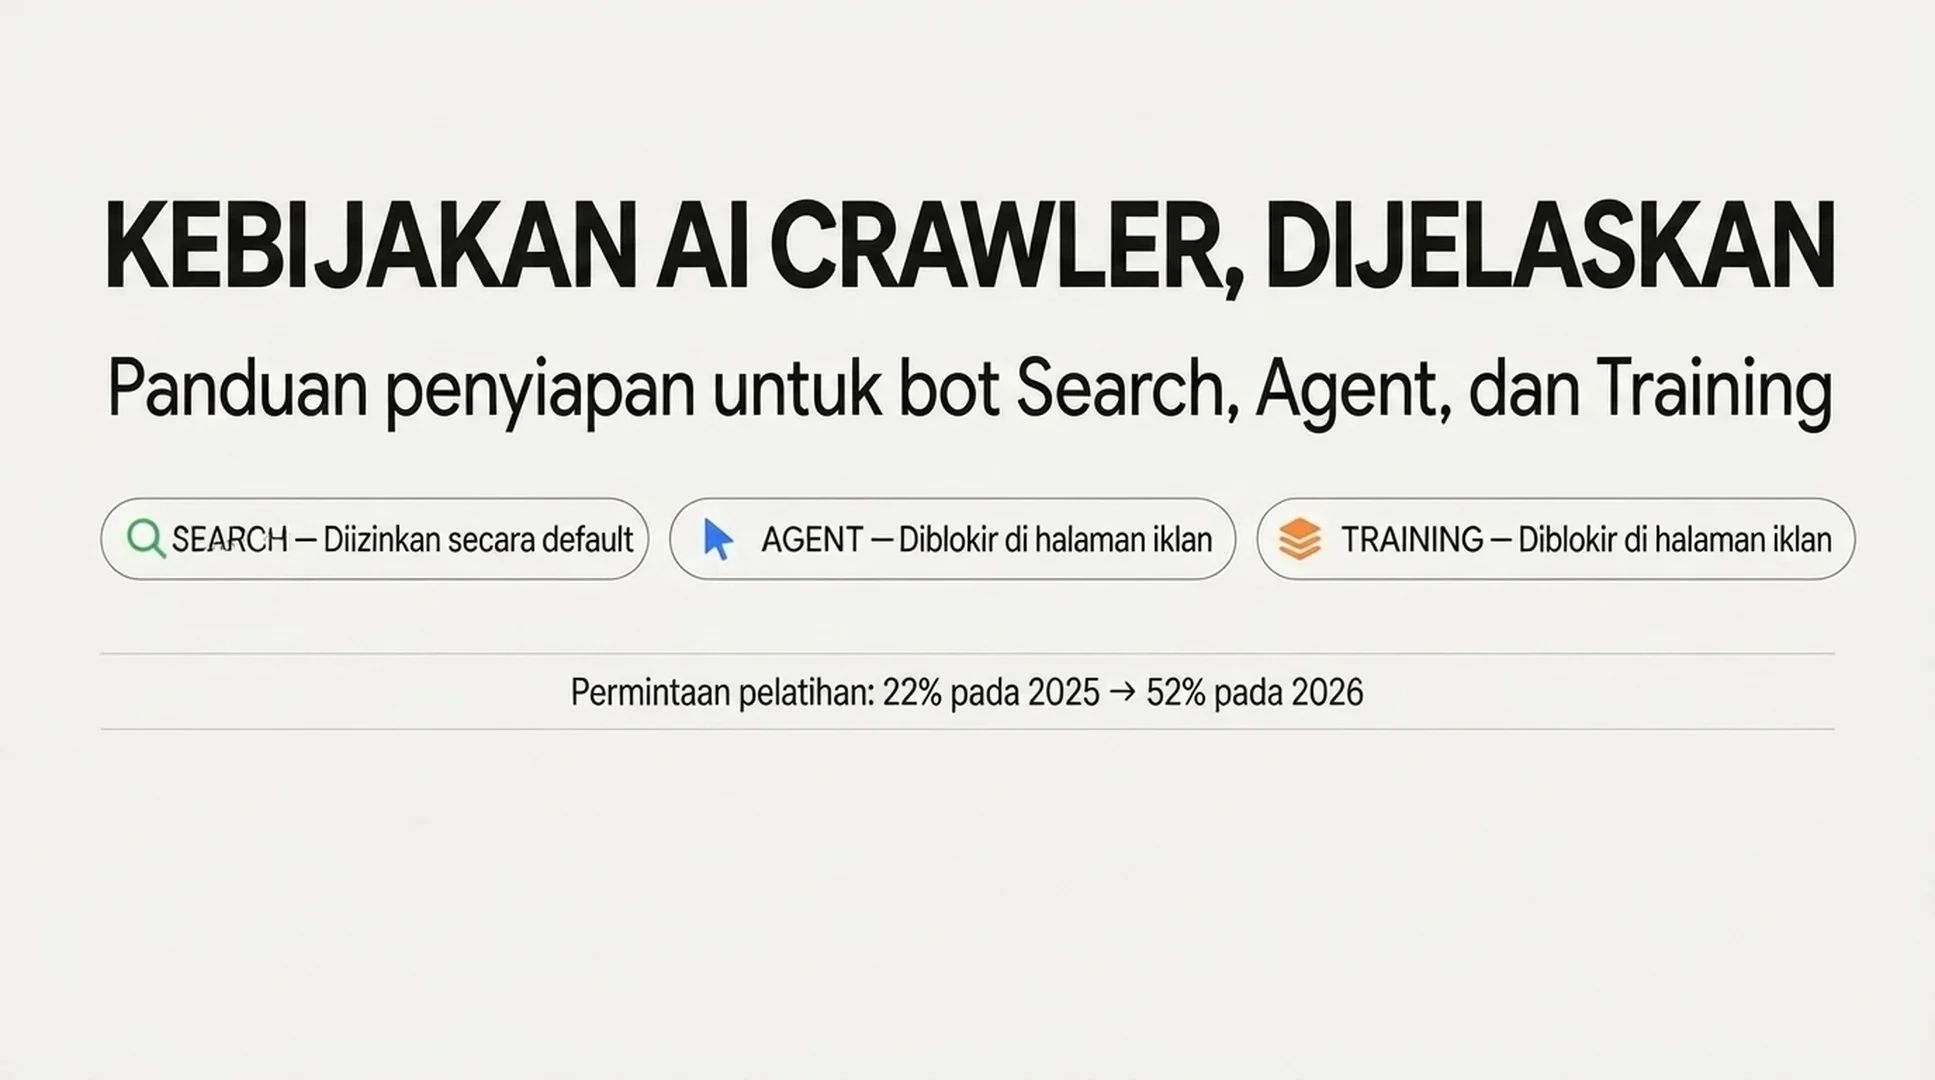
Cloudflare membangun kontrol lalu lintas AI secara bertahap, dimulai dengan penambahan Content Signals Policy ke robots.txt pada September 2025 dan berlanjut ke peluncuran "Content Independence Day" pada 1 Juli 2026, yang untuk pertama kalinya memisahkan perilaku bot AI menjadi tiga kategori bernama, bukan satu sakelar kasar "AI atau bukan AI":
- Pencarian (Search) — perayapan yang membangun indeks pencarian lalu mengembalikan tautan atau cuplikan singkat. Dalam kata-kata Cloudflare sendiri, inilah lalu lintas yang seharusnya mendatangkan rujukan bagi Anda.
- Agen (Agent) — aktivitas otomatis yang bertindak atas nama seseorang secara real time, misalnya asisten chat mengambil sebuah halaman atau agen peramban menyelesaikan tugas.
- Pelatihan (Training) — perayapan untuk melatih atau menyempurnakan model, di mana konten Anda diserap permanen ke dalam bobot model alih-alih kembali kepada Anda sebagai tautan.
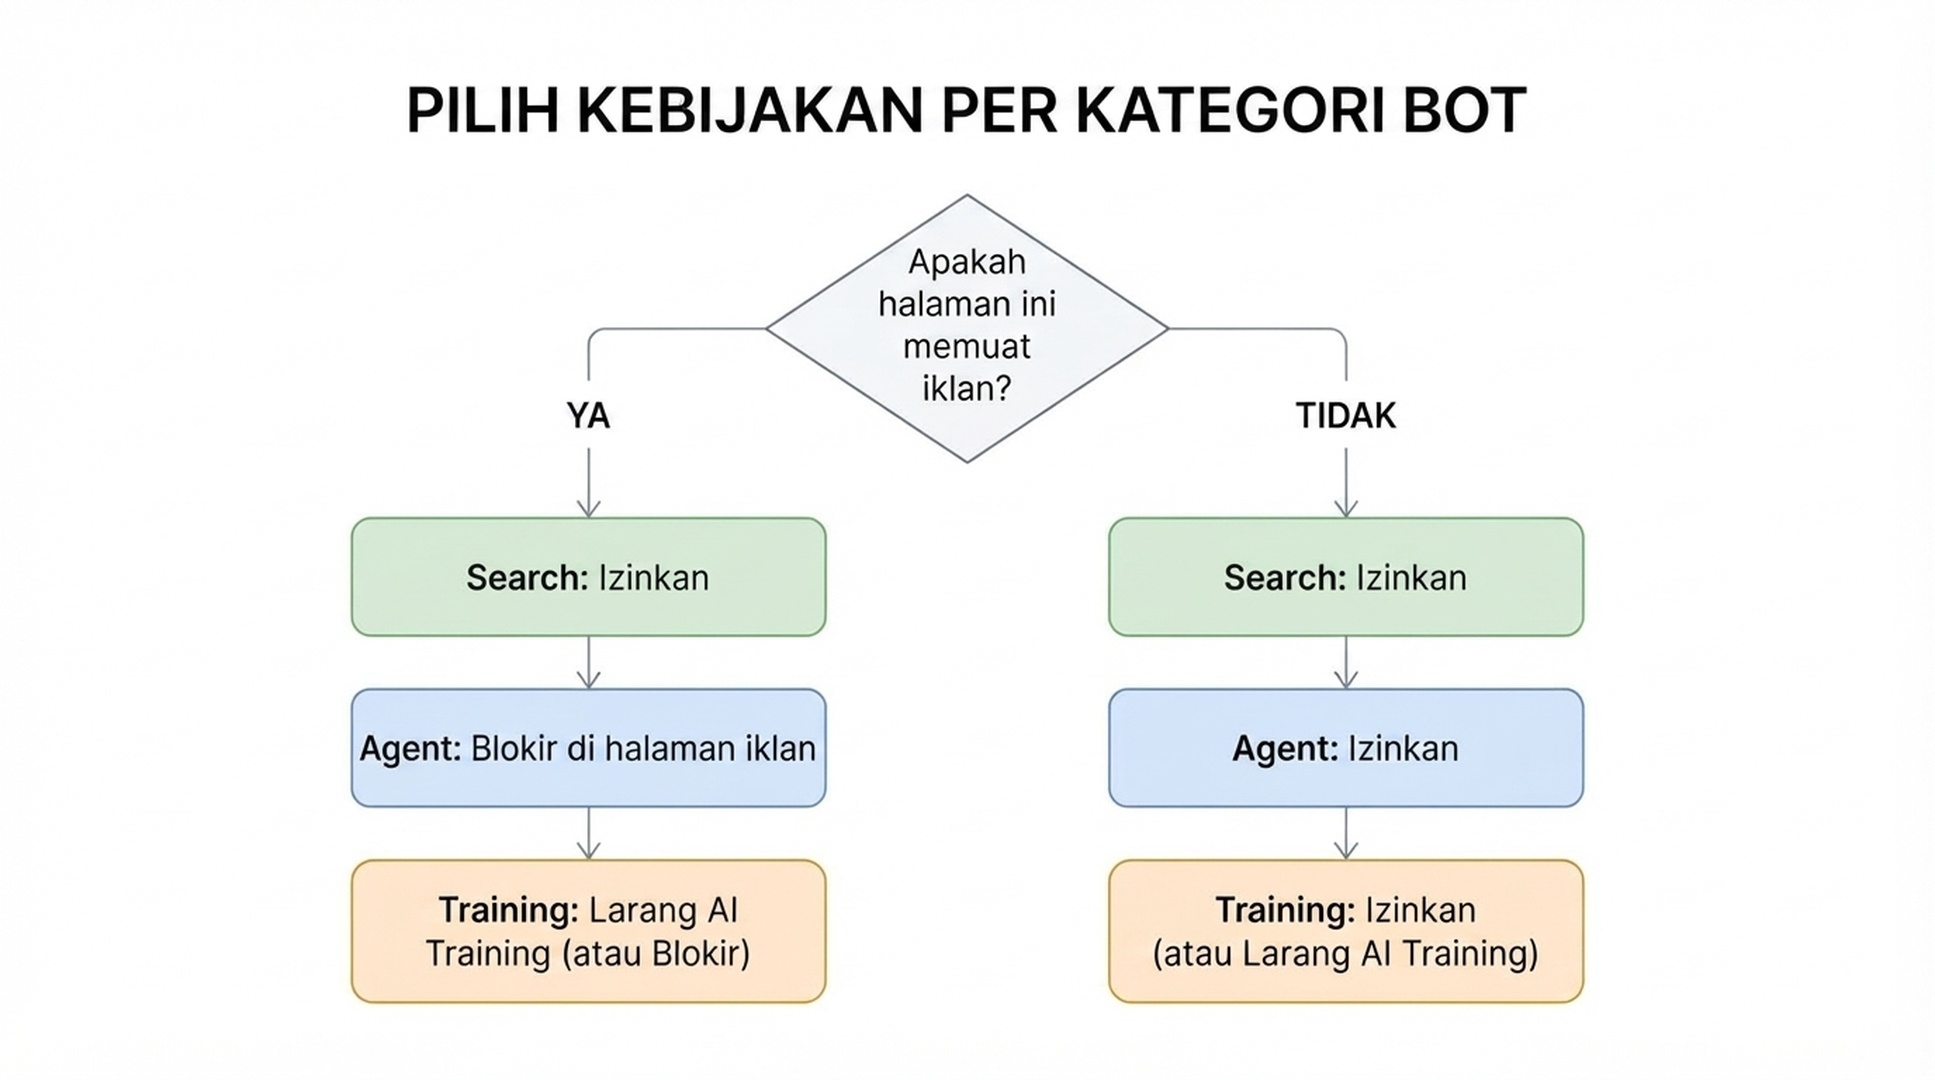
Pada 15 September 2026, Cloudflare mengubah apa yang terjadi secara otomatis. Untuk domain mana pun yang bergabung dengan Cloudflare pada tanggal itu atau setelahnya, jika situs ditandai termonetisasi iklan, bawaannya menjadi:
Kategori | Bawaan di halaman beriklan |
|---|---|
Pencarian (Search) | Izinkan |
Agen (Agent) | Blokir di halaman beriklan |
Pelatihan (Training) | Larang Pelatihan AI (Disallow AI Training) |
Domain baru tanpa monetisasi iklan mendapat Izinkan di ketiga kategori secara bawaan. Pelanggan lama tidak dialihkan secara diam-diam — Cloudflare memberi jendela sebelum tanggal 15 untuk memilih keluar lewat dasbor, dan aturan migrasi nyata per domain ternyata lebih rinci daripada satu nilai bawaan baru (kami bahas di bawah).
Alasan halaman beriklan mendapat bawaan yang lebih ketat adalah keberadaan iklan di halaman menjadi sinyal bahwa halaman itu dimaksudkan untuk dilihat manusia. Menurut data Cloudflare sendiri, pada Juni 2026 perayap penggunaan campuran — yang menggabungkan pengindeksan pencarian, permintaan agen, dan pelatihan di bawah satu user agent — mencakup lebih dari 36% lalu lintas perayap terverifikasi, kategori tunggal terbesar. Dan porsi pelatihan AI dari total permintaan perayap di jaringan Cloudflare naik dari sekitar 22% pada musim semi 2025 menjadi 52% pada Juni 2026. Perubahan ini membidik lalu lintas tersebut.
Sebelum mulai: tiga hal yang perlu dipahami tentang kategorinya
1. Sebagian perayap bersifat penggunaan campuran dan berperilaku berbeda antara diblokir dan dilarang melatih. Googlebot, Bingbot, dan Applebot melakukan kerja ganda — merayap untuk pencarian sekaligus untuk pelatihan di bawah user agent yang sama. Cloudflare menyebut Apple, Google, dan Microsoft sebagai operator "Accountable" (bertanggung jawab) karena memenuhi empat syarat: menghormati preferensi tidak melatih di robots.txt, menyediakan cara menolak ringkasan buatan AI, memberi visibilitas tingkat URL atas apa yang dipakai untuk pelatihan, dan mampu membuktikan bahwa menolak pelatihan tidak merugikan kehadiran Anda di pencarian.
2. "Larang Pelatihan AI" dan "Blokir" bukan setelan yang sama, dan perbedaan itulah intinya. Larang Pelatihan AI menerbitkan preferensi Disallow di robots.txt yang ditujukan ke user agent khusus pelatihan (seperti Google-Extended dan Applebot-Extended). Perayap penggunaan campuran yang bertanggung jawab membaca preferensi itu dan dengan sukarela terus merayap untuk pencarian sambil melewati pelatihan — jadi kehadiran Anda di pencarian tetap terjaga. Perayap pelatihan lain yang bukan milik operator bertanggung jawab langsung diblokir di edge, dan itu tidak memengaruhi pencarian karena operator tersebut menjalankan bot khusus pelatihan secara terpisah. Sebaliknya, Blokir biasa kini juga memblokir Googlebot, Bingbot, dan Applebot itu sendiri, yang berarti konten Anda ikut hilang dari hasil pencarian mereka. Jika Anda ingin pelatihan hilang tetapi pencarian tetap ada, setelan yang benar adalah "Larang Pelatihan AI", bukan "Blokir".
3. Bing belum menghormati preferensi pelatihan di robots.txt. Hari ini Applebot dan Googlebot mematuhi direktif Disallow khusus pelatihan. Microsoft menyatakan sedang membangun mekanisme setara untuk Bingbot dengan target awal 2027. Sampai saat itu, memilih "Larang Pelatihan AI" akan menuliskan preferensi Anda ke robots.txt, tetapi perilaku perayapan Bing untuk pelatihan tidak berubah hanya karena sinyal itu — meta tag NOARCHIVE milik Bing sendiri atau alat Content Removal tetap menjadi tuas sementara jika yang Anda khawatirkan khususnya pelatihan lewat Bing.
Langkah 1: Cari tahu di mana situs Anda sebenarnya berada
Jangan mengira Anda tahu setelan saat ini — periksa.
Tindakan: di dasbor Cloudflare, buka domain Anda, masuk ke Security → Settings, dan temukan kontrol kebijakan bot AI (antarmuka tiga kategori yang lebih baru telah menggantikan sakelar tunggal "Block AI Bots" yang lama, tetapi akun yang belum bermigrasi masih dapat menampilkan sakelar lama). Secara terpisah, ambil robots.txt yang aktif di peramban atau dengan curl https://yourdomain.com/robots.txt dan cari blok yang diawali komentar penanda yang dikelola Cloudflare; Anda juga bisa membandingkannya dengan pemeriksa perayap AI di robots.txt dari Auspia untuk melihat bagaimana aturan Anda saat ini terbaca oleh perayap AI.
Keluaran yang diharapkan: tiga setelan, masing-masing untuk pencarian, agen, dan pelatihan, dengan nilai salah satu dari Izinkan / Blokir di halaman beriklan / Blokir (dengan "Larang Pelatihan AI" sebagai opsi keempat khusus pelatihan). robots.txt yang aktif semestinya menampilkan bagian yang dikelola Cloudflare berisi daftar user agent spesifik serta baris Disallow / Content-Signal, jika Bot Preference Sync atau robots.txt terkelola aktif.
Pemeriksaan mutu: pastikan ketiga setelan itu sesuai dengan yang benar-benar Anda maksud, bukan yang diasumsikan mekanisme migrasi untuk Anda. Logika migrasi pelanggan lama yang didokumentasikan Cloudflare adalah: jika Anda dulu menyalakan sakelar "Block AI", Anda dipindahkan ke pelatihan = Larang Pelatihan AI, pencarian tetap Izinkan, dan agen = Blokir di halaman beriklan. Jika Anda dulu menyetel pelatihannya sendiri ke Blokir atau Blokir di halaman beriklan, Anda dipindahkan ke Larang Pelatihan AI. Kedua jalur migrasi mengasumsikan Anda ingin mempertahankan pencarian. Jika sebenarnya Anda ingin perayap penggunaan campuran hilang sepenuhnya termasuk pencarian, itu bukan keadaan Anda sekarang, dan Anda perlu memilih Blokir secara eksplisit.
Jalur pemulihan: jika setelan keamanan hanya menampilkan sakelar lama "Block AI Bots" tanpa pembagian tiga kategori, akun Anda belum bermigrasi ke kontrol baru. Cari "Configure AI bot policies", permukaan setelan terpisah yang lebih baru; di sanalah kontrol rinci hidup berdampingan dengan sakelar lama selama masa transisi, dan ke sanalah arah masa depannya.
Langkah 2: Tentukan kebijakan per kategori, bukan satu jawaban umum
Inilah langkah keputusan yang sebenarnya. Telusuri tiap kategori satu per satu.
Pencarian. Hampir tidak ada yang memblokirnya — Cloudflare melaporkan kurang dari 1% situs memilih memblokir bot pencarian — karena kehilangan visibilitas di pencarian hampir tidak pernah sepadan. Setel Izinkan sebagai bawaan, kecuali Anda punya alasan spesifik (lingkungan uji, arsip di balik paywall) untuk menahan situs dari indeks pencarian.
Agen. Ini bot yang bertindak real time atas nama seseorang yang sedang mencoba melakukan sesuatu di situs Anda saat ini juga: mengecek harga, menyelesaikan pemesanan, menarik satu fakta untuk jawaban chat. Memblokir lalu lintas agen di halaman termonetisasi atau beriklan adalah alasan di balik bawaan baru, karena kunjungan agen tidak menghasilkan impresi iklan seperti yang dihasilkan kunjungan manusia. Jika model bisnis Anda bergantung pada perhatian manusia itu (media, situs konten dengan display ad), Blokir di halaman beriklan adalah posisi yang bisa dipertahankan. Jika Anda justru ingin agen bisa menyelesaikan tugas di situs Anda bahkan di halaman beriklan — misalnya karena lalu lintas agen tetap berkonversi bagi Anda — pilih Izinkan.
Pelatihan. Di sinilah keputusan sesungguhnya, dan di sinilah istilahnya membingungkan:
- Pilih Larang Pelatihan AI jika Anda ingin menghentikan konten dipakai melatih model sambil mempertahankan kehadiran di produk pencarian Google, Bing, dan Apple (mengingat ketertinggalan Bing saat ini, pahami sebagai "hari ini berlaku untuk Google dan Apple, tertunda untuk Bing"). Ini jalan tengah yang direkomendasikan Cloudflare, dibuat khusus untuk trade-off antara pencarian dan pelatihan.
- Pilih Blokir hanya jika Anda bersedia kehilangan sepenuhnya perayapan pencarian dari Googlebot, Bingbot, dan Applebot sebagai harga memblokir perilaku mode pelatihan mereka. Kini ini opsi yang ketat: sejak 15 September, pemblokiran juga berlaku untuk perayap penggunaan campuran, yang sebelumnya tidak terjadi.
- Pilih Izinkan hanya jika Anda dengan sadar menerima konten Anda melatih model AI, misalnya karena ingin memaksimalkan visibilitas di jawaban AI dan menganggap pelatihan sebagai harga yang wajar.
Tindakan: di Security → Settings → Configure AI bot policies, setel ketiga menu sesuai keputusan Anda.
Keluaran yang diharapkan: dasbor semestinya mencerminkan pilihan eksplisit Anda di tiap kategori dan (jika Bot Preference Sync menyala) mulai menerbitkan blok robots.txt yang sesuai secara otomatis — tanpa menyunting berkas secara manual.
Pemeriksaan mutu: tinjau ulang keputusan pelatihan Anda dengan satu pertanyaan: "Apakah saya ingin mempertahankan visibilitas di pencarian atau tidak?" Jika ya, itu berarti Larang Pelatihan AI, bukan Blokir, sesulit apa pun istilah "Blokir" terdengar menggoda untuk menghentikan pelatihan AI.
Jalur pemulihan: jika lalu lintas pencarian turun setelah Anda memilih setelan, periksa apakah Anda tidak sengaja memilih Blokir alih-alih Larang Pelatihan AI. Inilah kesalahan yang paling sering merugikan diri sendiri di sini: namanya membuat "Blokir" terdengar seperti opsi yang "melakukan lebih banyak", tetapi untuk pelatihan, ia melakukan hal yang mungkin tidak Anda inginkan, yaitu ikut menghilangkan pencarian.
Langkah 3: Nyalakan Bot Preference Sync agar robots.txt mengikuti setelan Anda
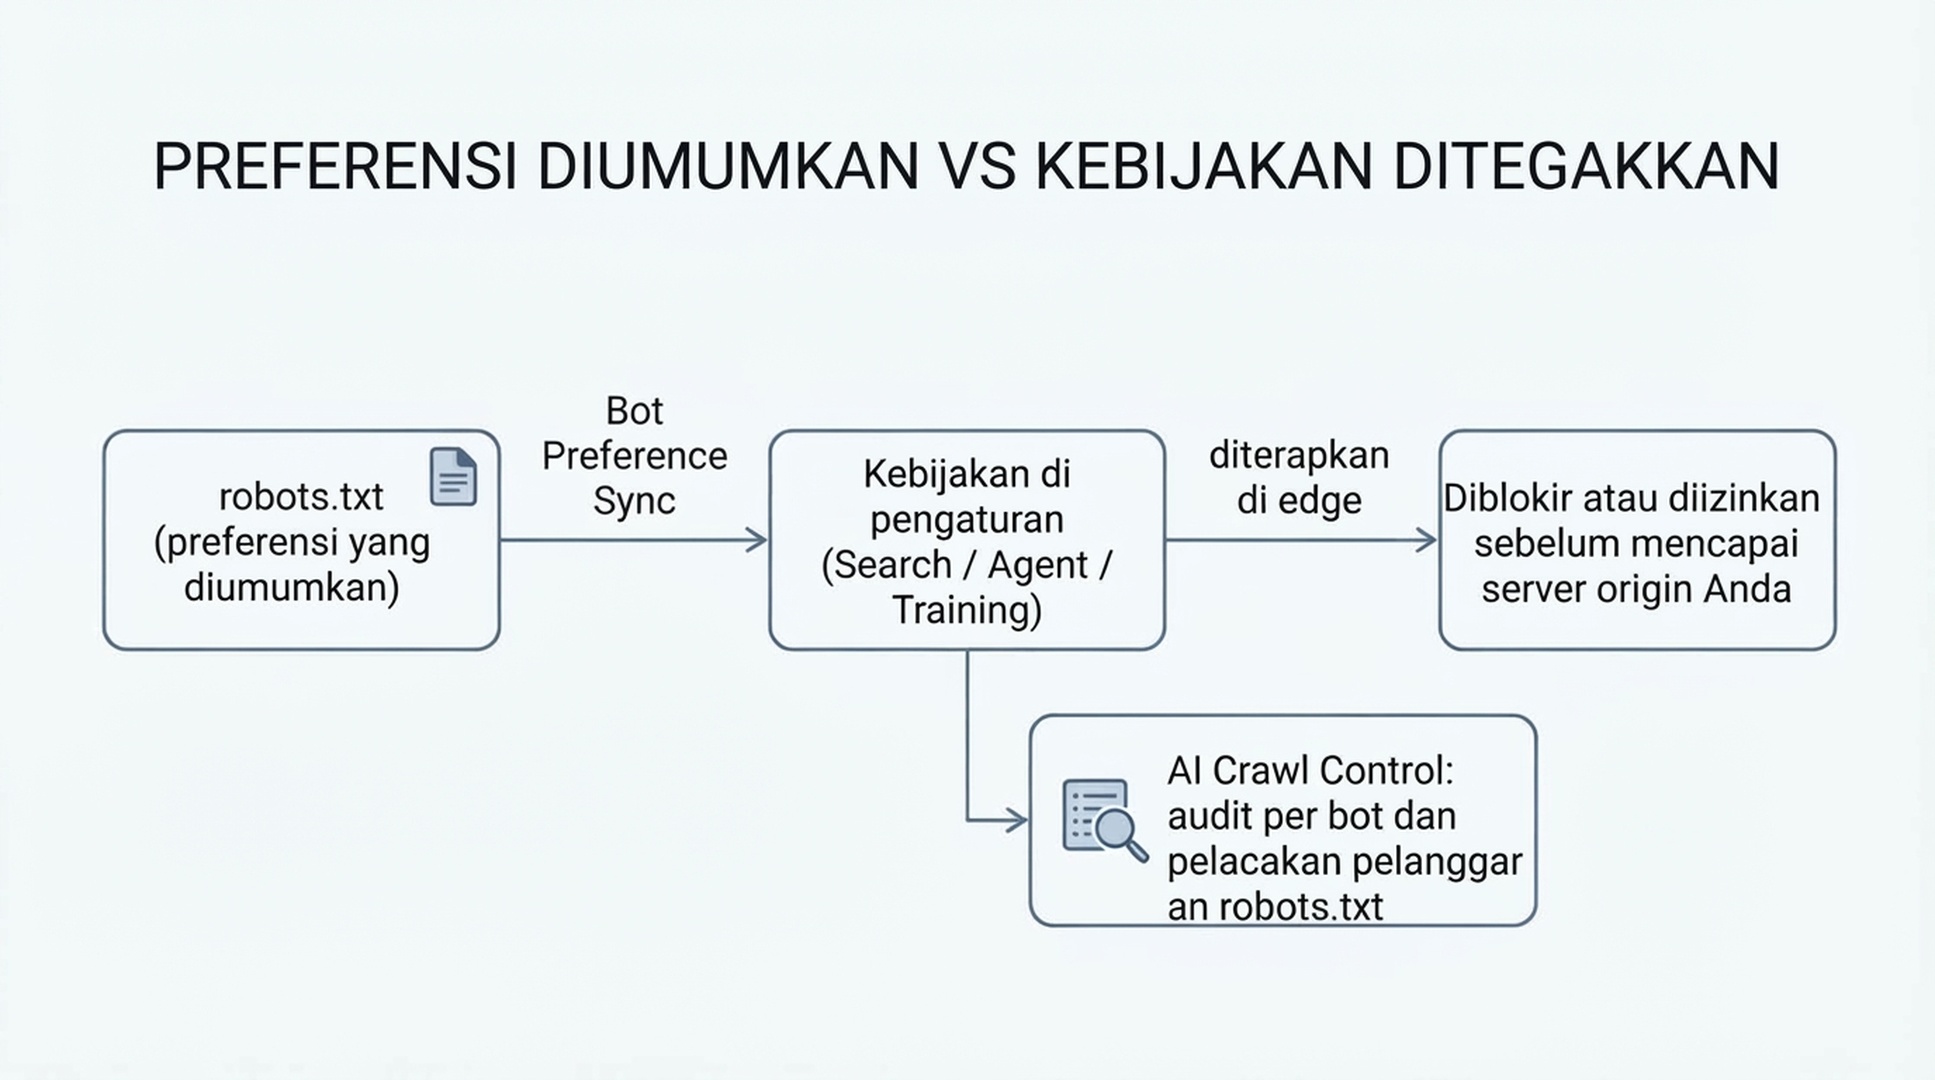
Setelan di dasbor dan berkas robots.txt adalah dua sistem berbeda, dan ketika keduanya berbeda, sebagian perayap memakai celah itu sebagai alasan mengabaikan preferensi Anda. Bot Preference Sync dari Cloudflare menutup celah ini dengan menghasilkan robots.txt Anda langsung dari setelan keamanan yang Anda pilih.
Tindakan: di area setelan kebijakan bot AI yang sama, nyalakan Bot Preference Sync (bawaannya menyala untuk pelanggan baru; pelanggan lama yang memakai fitur robots.txt terkelola versi lama akan diminta meninjau dan mengonfirmasi selama migrasi).
Keluaran yang diharapkan: Cloudflare menambahkan blok terkelola di bagian atas robots.txt Anda, dibungkus komentar # BEGIN Cloudflare Bot Preference Sync / # END, berisi daftar user agent yang terdampak dan aturan Disallow mereka — dan tidak menghapus aturan Anda sendiri yang sudah ada di robots.txt, yang tetap berada di bawah blok terkelola.
Pemeriksaan mutu: ambil /robots.txt lagi setelah diaktifkan dan pastikan blok terkelola muncul serta cocok dengan pilihan dari Langkah 2. Misalnya, jika Anda menyetel pelatihan ke Larang Pelatihan AI, Anda semestinya melihat user agent khusus pelatihan (Google-Extended, Applebot-Extended) dengan aturan Disallow, sementara user agent umum Googlebot / Applebot / Bingbot tetap tidak diblokir untuk pencarian.
Jalur pemulihan: jika Anda punya perjanjian khusus sekali waktu dengan operator perayap tertentu yang akan dirusak kebijakan tingkat kategori (misalnya kontrak lisensi konten berbayar), matikan Bot Preference Sync dan sunting robots.txt Anda sendiri secara manual: sakelar kategori dirancang untuk kebijakan seluruh zona, bukan pengecualian per operator.
Langkah 4: Pastikan kebijakan benar-benar ditegakkan, bukan sekadar diminta
robots.txt secara teknis adalah permintaan: ia tidak menghentikan perayap yang mengabaikannya. Inilah langkah yang orang lewatkan, dan justru langkah inilah yang menunjukkan apakah keputusan Langkah 2 Anda nyata atau hanya teori.
Tindakan: buka AI Crawl Control untuk zona Anda (tersedia di semua paket termasuk Free — kualitas deteksi lebih baik pada paket dengan Bot Management, tetapi fitur visibilitas bekerja di mana pun). Lihat tab Crawlers, yang mendaftar semua bot yang mencapai situs Anda, dengan kolom Robots.txt violations.
Keluaran yang diharapkan: tabel berisi jumlah permintaan dan jumlah pelanggaran per bot. Jumlah pelanggaran bukan nol pada bot yang Anda setel larang atau blokir berarti bot itu sedang mengabaikan robots.txt Anda.
Pemeriksaan mutu: untuk bot mana pun yang menunjukkan pelanggaran, lihat "Most popular paths" (dengan filter pada jalur yang ditandai) untuk melihat apa yang sebenarnya ia minta, lalu putuskan apakah ia menjangkau konten yang benar-benar ingin Anda lindungi.
Jalur pemulihan: jika sebuah bot mengabaikan preferensi yang Anda deklarasikan, robots.txt saja tidak akan menghentikannya. Gunakan tindakan "Enforce robots.txt rules" di AI Crawl Control (kadang disebut dengan nama internalnya, Robotcop) untuk mengubah aturan yang Anda deklarasikan menjadi aturan WAF nyata yang memblokir bot pembangkang di edge Cloudflare sebelum mencapai server asal Anda — Anda naik dari "meminta kepatuhan" menjadi "menegakkan kepatuhan". Langkah ini memakai WAF, jadi ketersediaannya bergantung pada akses WAF di paket Anda.
Langkah 5: Putuskan antara sekadar memblokir atau menagih akses
Jika keputusan pelatihan Anda adalah "tanpa akses untuk pelatihan", Anda punya opsi kedua selain memblokir habis: menagih.
Tindakan: jika tertarik, daftar ke beta tertutup Pay Per Crawl dari Cloudflare (lewat halaman pendaftaran Cloudflare atau account manager Anda jika Anda pelanggan Enterprise). Setelah diaktifkan di tingkat akun (Manage Account → Settings → Pay Per Crawl → setel Visibility domain Anda ke Visible), Anda dapat menetapkan harga tetap tunggal per permintaan untuk zona dan memilih per perayap antara izinkan (gratis), tagih (sesuai harga Anda), atau blokir.
Keluaran yang diharapkan: ketika perayap yang terautentikasi lewat Web Bot Auth (permintaan bertanda tangan Ed25519 yang mengidentifikasi perayap) meminta halaman yang Anda tandai berbayar, ia menerima HTTP 402 Payment Required dengan header crawler-price; jika ia mencoba lagi dengan menyetujui membayar, atau menyertakan header crawler-max-price yang menutupi harga Anda sejak awal, ia menerima konten dengan header crawler-charged yang mengonfirmasi jumlah yang ditagihkan. Cloudflare bertindak sebagai merchant of record dan menyelesaikan pembayarannya.
Pemeriksaan mutu: ini hanya bekerja terhadap perayap yang telah mendaftarkan data pembayaran ke Cloudflare dan mendukung alur 402; ini bukan sakelar universal untuk semua bot. Untuk yang lain, setelan penagihan Anda praktis berperilaku seperti pemblokiran — Cloudflare mencatat bahwa itu tetap berfungsi sebagai sinyal bahwa Anda terbuka pada hubungan berbayar di masa depan.
Jalur pemulihan: fitur ini masih beta tertutup; jika Anda tidak diterima atau tidak ingin menunggu, Larang Pelatihan AI atau Blokir tetap tersedia untuk perayap yang sama hari ini.
Menangani pengecualian: ketika operator AI tertentu meminta akses
Anda mungkin menerima pendekatan — kemitraan, perjanjian kutipan, pembicaraan lisensi — dari perusahaan AI yang menginginkan akses eksplisit di luar kebijakan seluruh zona.
Ada dua cara memberi pengecualian sempit tanpa membuka kembali seluruh kategori:
- Menimpa per perayap di Manage AI crawlers: ubah baris bot itu dari blokir/tagih menjadi izinkan, terlepas dari setelan pelatihan atau agen tingkat kategori Anda.
- Menyunting robots.txt secara manual: jika Anda mematikan Bot Preference Sync (atau menempatkan pengecualian di luar blok terkelola), Anda dapat menambahkan Allow yang ditargetkan untuk satu user agent itu di bawah bagian yang dikelola Cloudflare.
Apa pun caranya, pertahankan kebijakan kategori tingkat zona sebagai bawaan dan perlakukan pengecualian bernama sebagai keputusan yang sengaja dibuat dan terdokumentasi — bukan sebaliknya.
Verifikasi hasilnya
Telusuri daftar ini saat konfigurasi sudah berjalan:
- [ ] Setelan keamanan menampilkan nilai yang eksplisit dan sengaja dipilih untuk pencarian, agen, dan pelatihan — bukan bawaan yang belum ditinjau
- [ ]
/robots.txtdi domain aktif menampilkan blok terkelola Cloudflare yang cocok dengan setelan tersebut - [ ] Tab Crawlers di AI Crawl Control menampilkan bot yang Anda harapkan, dengan pelanggaran nol atau mendekati nol untuk semua yang Anda setel blokir/larang
- [ ] Jika Anda memilih Larang Pelatihan AI, Anda sudah memastikan (lewat Search Console / Bing Webmaster Tools, atau sekadar mengamati lalu lintas organik) bahwa perayapan pencarian Googlebot / Applebot tetap berjalan normal
- [ ] Jika Anda mengaktifkan penegakan robots.txt (Robotcop), aturan WAF yang dihasilkan sudah diterapkan dan aktif, bukan hanya dibuat lalu dibiarkan sebagai draf
- [ ] Anda sudah mencatat setelan mana yang dipilih dan alasannya, agar tinjauan di masa depan tidak mulai dari nol
Menjaga hasilnya tetap berjalan
Ini bukan konfigurasi sekali pasang lalu lupa. Kembalilah ke sana dengan irama ringan:
- Bulanan: periksa tab Metrics di AI Crawl Control untuk bot baru yang belum Anda tentukan kebijakannya, dan periksa ulang jumlah pelanggaran.
- Saat Bing merilis dukungan preferensi pelatihan untuk Bingbot (Microsoft menyebut target awal 2027): nilai ulang apakah konfigurasi Anda sekarang masih memberi hasil yang dimaksud — mempertahankan pencarian, memblokir pelatihan — karena di situlah Bing menyusul perilaku Google dan Apple saat ini.
- Setiap kali status monetisasi iklan Anda berubah: menambah atau menghapus display ad mengubah jalur bawaan mana yang ditempati halaman Anda, dan ada baiknya memastikan ulang bahwa setelan eksplisit Anda masih masuk akal dalam kondisi itu.
Pertanyaan yang sering diajukan
Apakah memblokir perayap pelatihan akan merugikan peringkat SEO saya? Tidak, jika Anda memakai Larang Pelatihan AI alih-alih Blokir. Larang Pelatihan AI memang dirancang agar perayap penggunaan campuran yang bertanggung jawab (Google, Apple, dan kelak Bing) terus merayap untuk pencarian sambil melewati pelatihan. Sebaliknya, Blokir biasa kini juga memblokir perilaku pencarian perayap tersebut, yang akan merugikan visibilitas Anda di produk pencarian mereka.
Saya sudah menyalakan "Block AI Bots" sebelum 15 September. Apa yang terjadi pada setelan saya? Cloudflare memigrasikannya otomatis: Block AI Bots lama menjadi pelatihan = Larang Pelatihan AI, pencarian = Izinkan, dan agen = Blokir di halaman beriklan. Verifikasi lewat Langkah 1 di atas bahwa hasil nyatanya sesuai harapan, alih-alih mengasumsikan migrasinya cocok dengan maksud Anda.
Apakah ada yang tersedia di paket Free? Ada. AI Crawl Control, setelan kategori pencarian/agen/pelatihan, dan Bot Preference Sync berfungsi di semua paket termasuk Free. Beberapa detail penegakan bergantung paket — misalnya penegakan robots.txt berjalan lewat WAF, dan deteksi bot di paket Free bersandar pada string user agent alih-alih ID deteksi Bot Management yang lebih canggih.
Apa bedanya AI Crawl Control dengan setelan keamanan bot AI? Setelan keamanan adalah tempat Anda menetapkan kebijakan (izinkan / blokir di halaman beriklan / blokir / larang pelatihan AI per kategori). AI Crawl Control adalah tempat Anda mengaudit apa yang sebenarnya terjadi — jumlah permintaan per bot, pelanggaran robots.txt, rincian tingkat jalur — dan tempat Anda dapat mengubah kebijakan robots.txt yang dideklarasikan menjadi aturan WAF yang ditegakkan.
Apakah saya perlu menyunting robots.txt secara manual setelah menyetel ini? Tidak, jika Bot Preference Sync aktif: ia menulis dan memelihara blok robots.txt yang sesuai dari setelan dasbor Anda. Penyuntingan manual hanya diperlukan untuk pengecualian satu kali bagi operator tertentu, di luar kategori yang dikelola.
Penulis: Julian Mercer, praktisi technical SEO dengan pengalaman 14 tahun di Auspia. Ia menulis tentang keterayapan, data terstruktur, rendering, dan fondasi teknis yang membuat konten terbaca oleh AI.