Що ви отримаєте після цього посібника
Після завершення цього посібника ваш домен на Cloudflare матиме явну й свідомо визначену політику для трьох окремих категорій трафіку ШІ-ботів — пошукових (Search), агентних (Agent) і навчальних (Training) — замість типового значення, яке дісталося вашому домену. Ви точно знатимете, які сканери дозволені, які заблоковані й на яких сторінках, а ваш robots.txt і правило примусового застосування на межі мережі справді узгоджуватимуться між собою.
Для кого це: для всіх, хто керує сайтом, проксійованим через Cloudflare — видавців, маркетингових сайтів SaaS, інтернет-магазинів, блогів — і хоче сам вирішувати, чи можуть ШІ-системи навчатися на його контенті, підсумовувати його чи переглядати через агентів, а не успадковувати налаштування платформи.
Що потрібно:
- Домен, проксійований через Cloudflare (будь-який тариф, зокрема безкоштовний; деякі кроки нижче доступні лише на платних тарифах, і це позначено)
- Доступ до панелі щонайменше з правом змінювати налаштування безпеки на рівні домену
- 20–30 хвилин на аудит і налаштування; далі кілька хвилин на день або тиждень на моніторинг
Визначення готовності: у налаштуваннях безпеки вашої зони видно свідомо зроблений вибір (а не неперевірене типове значення) для пошуку, агентів і навчання; робочий /robots.txt відображає цей вибір; і ви підтвердили в AI Crawl Control, що боти, які мали бути заблоковані, справді блокуються.
Чому це раптом стало важливим: що змінилося 15 вересня
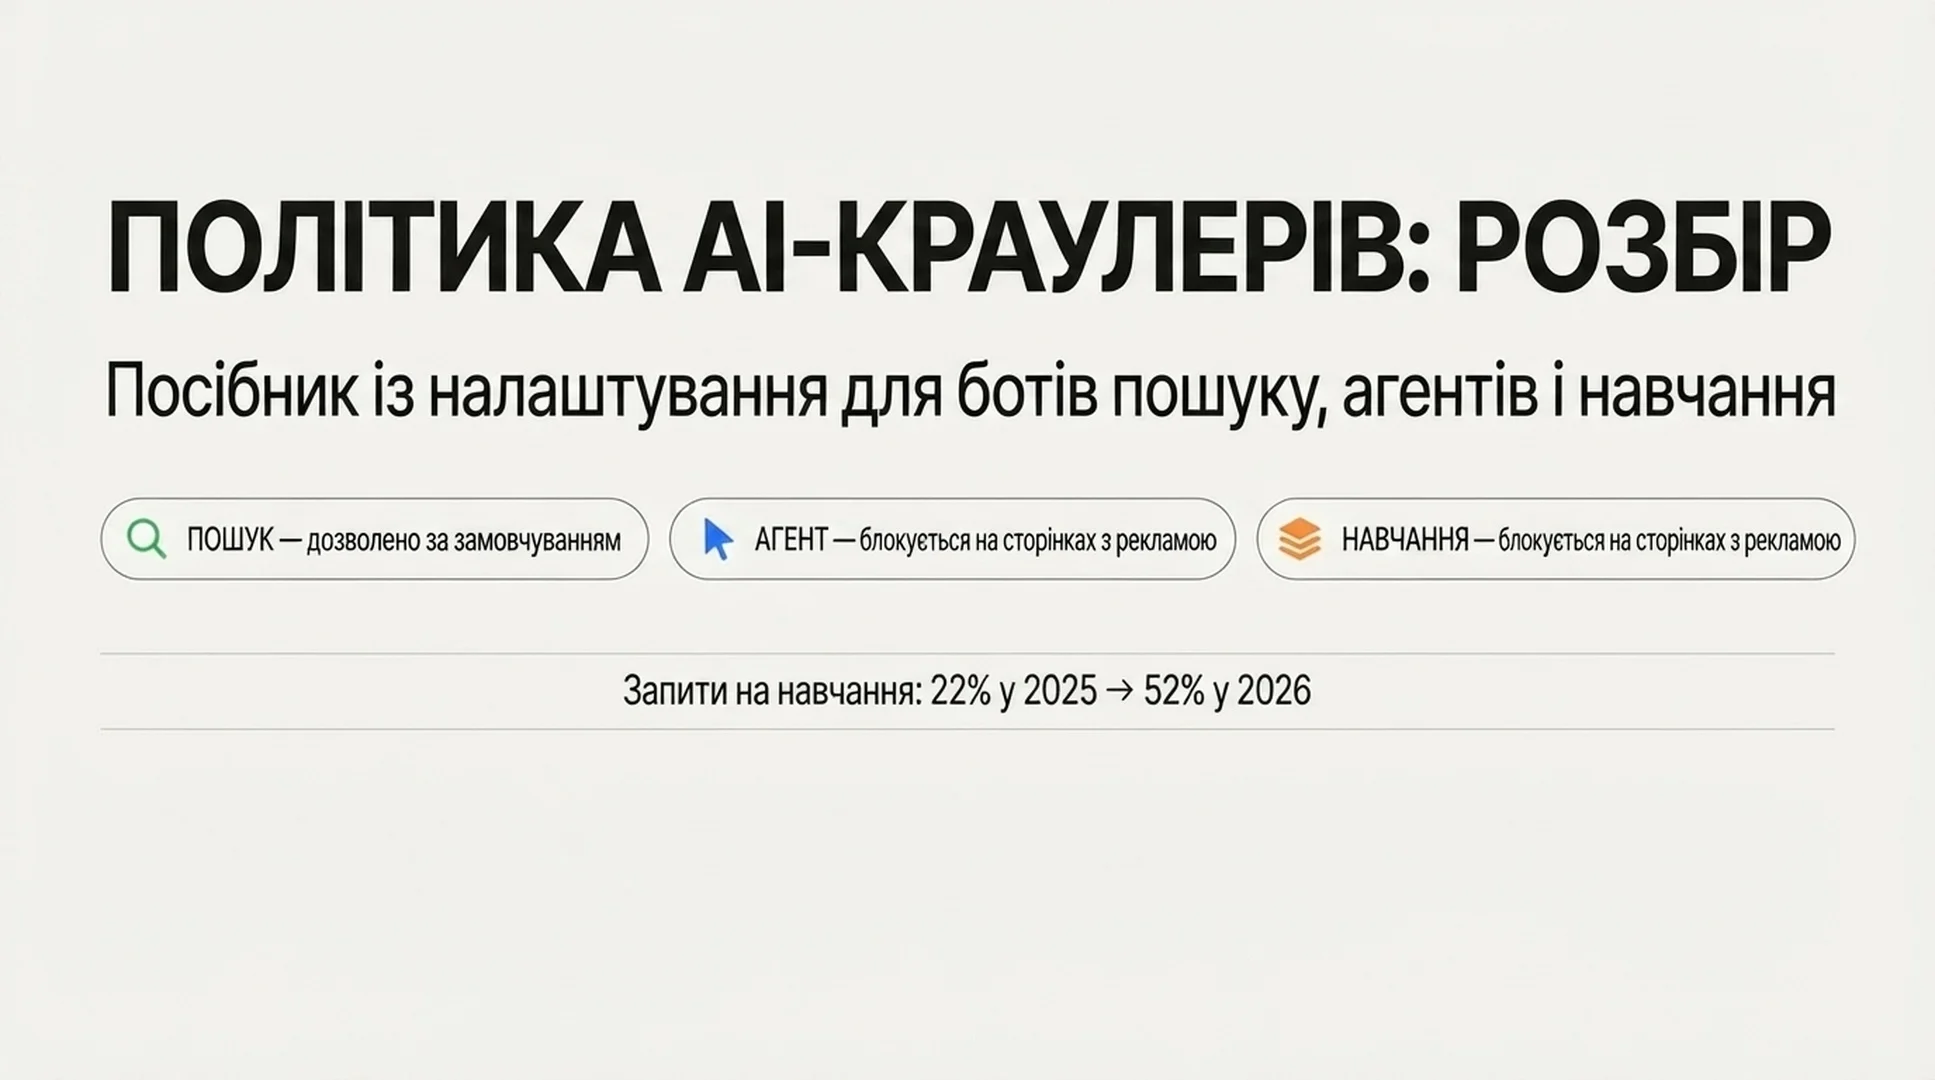
Cloudflare будувала засоби контролю ШІ-трафіку поетапно: від додавання Content Signals Policy до robots.txt у вересні 2025 року до запуску «Content Independence Day» 1 липня 2026 року, який уперше розділив поведінку ШІ-ботів на три іменовані категорії замість одного грубого перемикача «це ШІ чи ні»:
- Пошук (Search) — сканування, що будує пошуковий індекс і згодом повертає посилання або короткі уривки. За формулюванням самої Cloudflare, це трафік, який має приносити вам переходи.
- Агент (Agent) — автоматизована активність, що діє від імені людини в реальному часі, наприклад чат-асистент отримує сторінку або браузерний агент виконує завдання.
- Навчання (Training) — сканування для тренування чи донавчання моделі, коли ваш контент назавжди поглинається вагами моделі, а не повертається до вас посиланням.
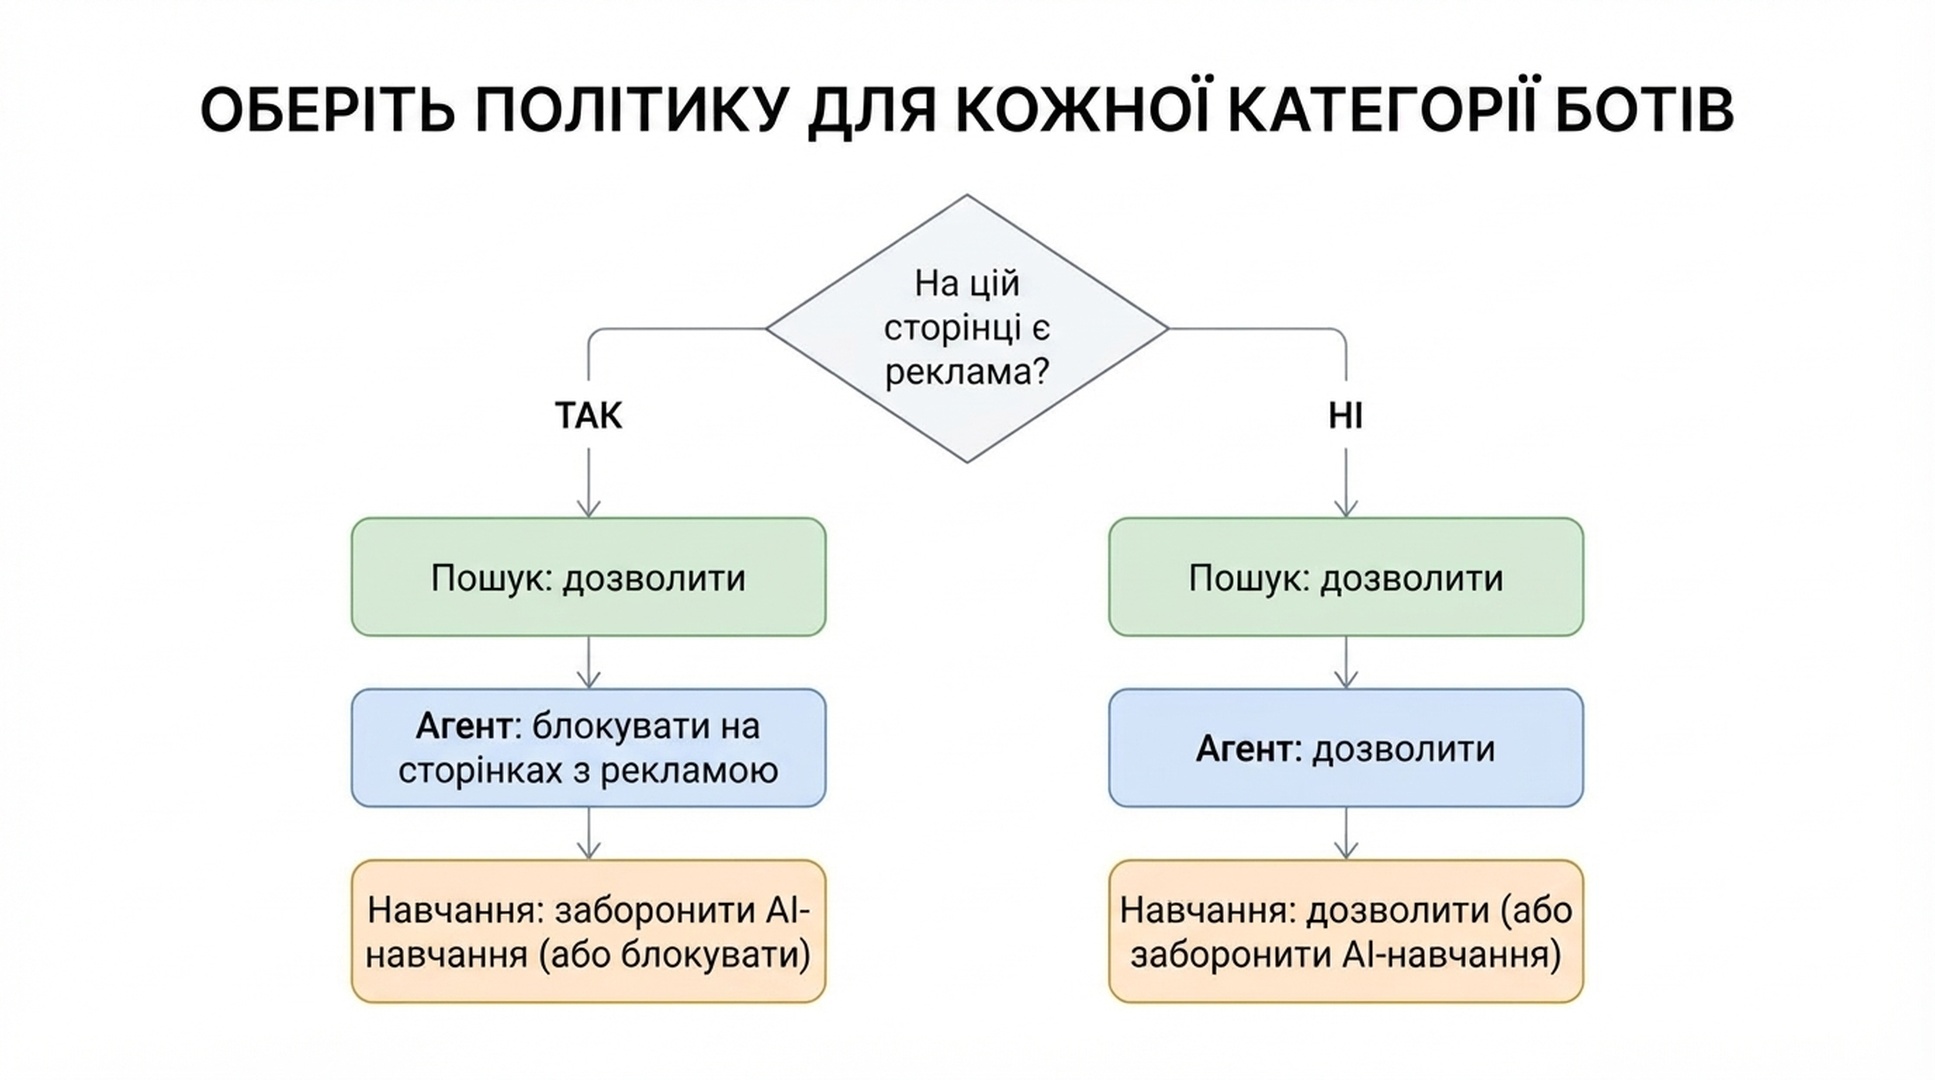
15 вересня 2026 року Cloudflare змінила те, що відбувається автоматично. Для будь-якого домену, який приєднується до Cloudflare цієї дати або пізніше, якщо сайт позначено як такий, що монетизується рекламою, типовим стає таке:
Категорія | Типове значення на сторінках із рекламою |
|---|---|
Пошук (Search) | Дозволити |
Агент (Agent) | Блокувати на сторінках із рекламою |
Навчання (Training) | Заборонити навчання ШІ (Disallow AI Training) |
Нові домени без рекламної монетизації типово отримують «Дозволити» в усіх трьох категоріях. Наявних клієнтів ніхто не перемикав мовчки — Cloudflare дала вікно до 15-го, щоб відмовитися через панель, а фактичні правила міграції для кожного домену виявилися детальнішими за одне нове типове значення (розбираємо нижче).
Причина, чому сторінки з рекламою отримують суворіше типове значення, полягає в тому, що реклама на сторінці — це сигнал, що її передбачалося показати людині. За власними даними Cloudflare, у червні 2026 року сканери змішаного призначення — ті, що поєднують пошукову індексацію, агентні запити й навчання під одним user agent, — становили понад 36% підтвердженого трафіку сканерів, найбільшу окрему категорію. А частка навчання ШІ в загальній кількості запитів сканерів у мережі Cloudflare зросла з приблизно 22% навесні 2025 року до 52% у червні 2026-го. Саме на цей трафік і спрямована зміна.
Перед початком: три речі, які треба зрозуміти про категорії
1. Частина сканерів має змішане призначення і поводиться по-різному при блокуванні та при забороні навчання. Googlebot, Bingbot і Applebot виконують подвійну роботу — сканують і для пошуку, і для навчання під одним user agent. Cloudflare називає Apple, Google і Microsoft «Accountable» (підзвітними) операторами, бо вони виконують чотири умови: поважають налаштування про відмову від навчання в robots.txt, дають спосіб відмовитися від ШІ-переказів, забезпечують прозорість на рівні URL щодо того, що використовувалося для навчання, і можуть довести, що відмова від навчання не шкодить вашій присутності в пошуку.
2. «Заборонити навчання ШІ» і «Блокувати» — це не одне й те саме налаштування, і саме в цій різниці вся суть. Заборона навчання ШІ публікує в robots.txt настанову Disallow, адресовану user agent, призначеним для навчання (як-от Google-Extended і Applebot-Extended). Підзвітні сканери змішаного призначення читають цю настанову й добровільно продовжують сканувати для пошуку, пропускаючи навчання, — тож ваша присутність у пошуку зберігається. Інші навчальні сканери, що не належать підзвітним операторам, блокуються на межі мережі одразу, і це не зачіпає пошук, бо такі оператори запускають окремих ботів для навчання. Натомість звичайне блокування тепер блокує й самих Googlebot, Bingbot і Applebot, а отже, ваш контент зникає і з їхніх результатів пошуку. Якщо ви хочете прибрати навчання, але зберегти пошук, потрібне налаштування — «Заборонити навчання ШІ», а не «Блокувати».
3. Bing поки не дотримується настанови щодо навчання в robots.txt. Сьогодні і Applebot, і Googlebot виконують директиву Disallow, призначену для навчання. Microsoft заявляє, що створює аналогічний механізм для Bingbot із ціллю на початок 2027 року. До того часу вибір «Заборонити навчання ШІ» пропише вашу настанову в robots.txt, але поведінка сканування Bing для навчання не зміниться лише від цього сигналу — метатег NOARCHIVE самого Bing або його інструмент Content Removal залишаються тимчасовими важелями, якщо вас турбує саме навчання через Bing.
Крок 1: З'ясуйте, де насправді опинився ваш сайт
Не припускайте, що знаєте поточне налаштування, — перевірте його.
Дія: у панелі Cloudflare відкрийте свій домен, перейдіть до Security → Settings і знайдіть елементи керування політикою ШІ-ботів (новіший інтерфейс із трьома категоріями замінив старий єдиний перемикач «Block AI Bots», але в облікових записах, які ще не мігрували, може відображатися старий перемикач). Окремо отримайте робочий robots.txt у браузері або командою curl https://yourdomain.com/robots.txt і пошукайте блок, що починається з керованого Cloudflare коментаря-маркера; можна також звірити з перевіркою ШІ-сканерів у robots.txt від Auspia, щоб побачити, як ваші поточні правила читаються ШІ-сканерами.
Очікуваний результат: три налаштування — по одному для пошуку, агентів і навчання, — кожне зі значенням «Дозволити / Блокувати на сторінках із рекламою / Блокувати» (четвертий варіант «Заборонити навчання ШІ» доступний лише для навчання). Робочий robots.txt має показувати керований Cloudflare розділ зі списком конкретних user agent і рядків Disallow / Content-Signal, якщо Bot Preference Sync або керований robots.txt увімкнені.
Перевірка якості: переконайтеся, що всі три налаштування відповідають тому, що ви справді маєте на увазі, а не тому, що за вас припустив механізм міграції. Задокументована Cloudflare логіка міграції для наявних клієнтів така: якщо ви раніше вмикали старий перемикач «Block AI», вас перевели в стан навчання = Заборонити навчання ШІ, пошук залишився на «Дозволити», а агент встановлено в «Блокувати на сторінках із рекламою». Якщо ви раніше ставили саме навчання в «Блокувати» або «Блокувати на сторінках із рекламою», вас перевели в «Заборонити навчання ШІ». Обидва шляхи міграції виходять із того, що ви хотіли зберегти пошук. Якщо ж ви хотіли прибрати сканери змішаного призначення повністю, включно з пошуком, то це не ваш поточний стан, і вам потрібно явно вибрати «Блокувати».
Шлях відновлення: якщо в налаштуваннях безпеки видно лише старий перемикач «Block AI Bots» без поділу на три категорії, ваш обліковий запис ще не мігрував на нові елементи керування. Шукайте «Configure AI bot policies» — окрему, новішу поверхню налаштувань; саме там детальні елементи керування живуть поряд зі старим перемикачем під час переходу, і саме туди прямує майбутнє.
Крок 2: Визначте політику для кожної категорії окремо, а не однією загальною відповіддю
Це і є власне крок ухвалення рішення. Пройдіться по кожній категорії окремо.
Пошук. Його майже ніхто не блокує — Cloudflare повідомляє, що менш ніж 1% сайтів обирають блокування пошукових ботів, — бо втрачати видимість у пошуку майже ніколи не варте того. Типово ставте Дозволити, якщо у вас немає конкретної причини (тестове середовище, архів за платною підпискою) тримати сайт поза пошуковими індексами.
Агенти. Це боти, що діють у реальному часі від імені людини, яка просто зараз намагається щось зробити на вашому сайті: перевірити ціну, завершити бронювання, витягти факт для відповіді в чаті. Блокування агентного трафіку на монетизованих сторінках чи сторінках із рекламою — це обґрунтування нового типового значення, бо візит агента не створює того показу реклами, який створив би візит людини. Якщо ваша бізнес-модель залежить від цієї людської уваги (медіа, контентні сайти з медійною рекламою), Блокувати на сторінках із рекламою — захищена позиція. Якщо ж ви волієте, щоб агенти могли виконувати завдання на вашому сайті навіть на сторінках із рекламою — наприклад, бо агентний трафік у вас усе одно конвертується, — виберіть Дозволити.
Навчання. Тут і є справжнє рішення, і саме тут термінологія плутає:
- Виберіть Заборонити навчання ШІ, якщо хочете зупинити використання вашого контенту для тренування моделей, зберігши присутність у пошукових продуктах Google, Bing і Apple (з огляду на поточне відставання Bing розумійте це як «сьогодні чинно для Google і Apple, відкладено для Bing»). Це рекомендований Cloudflare середній шлях, створений саме для компромісу між пошуком і навчанням.
- Вибирайте Блокувати лише якщо готові повністю втратити пошукове сканування від Googlebot, Bingbot і Applebot як плату за блокування їхньої поведінки в режимі навчання. Тепер це суворий варіант: від 15 вересня блокування застосовується й до сканерів змішаного призначення, чого раніше не було.
- Вибирайте Дозволити лише якщо свідомо погоджуєтеся, що ваш контент навчає ШІ-моделі, наприклад бо хочете максимальної помітності у ШІ-відповідях і вважаєте навчання прийнятною платою за це.
Дія: у Security → Settings → Configure AI bot policies виставте всі три списки відповідно до свого рішення.
Очікуваний результат: панель має відображати ваш явний вибір у кожній категорії та (якщо Bot Preference Sync увімкнено) почати автоматично публікувати відповідний блок robots.txt — без ручного редагування файлу.
Перевірка якості: перечитайте своє рішення щодо навчання, звіривши з одним запитанням: «Чи хочу я зберегти видимість у пошуку чи ні?» Якщо хочу — це «Заборонити навчання ШІ», а не «Блокувати», хоч би як привабливо звучало слово «Блокувати» для зупинки навчання ШІ.
Шлях відновлення: якщо пошуковий трафік упав після вибору налаштування, перевірте, чи не обрали ви випадково «Блокувати» замість «Заборонити навчання ШІ». Це найпоширеніша помилка, яка тут шкодить самому собі: через назву «Блокувати» звучить як варіант, що «робить більше», але для навчання він робить те, чого ви, можливо, не хочете, — забирає й пошук.
Крок 3: Увімкніть Bot Preference Sync, щоб robots.txt відповідав вашим налаштуванням
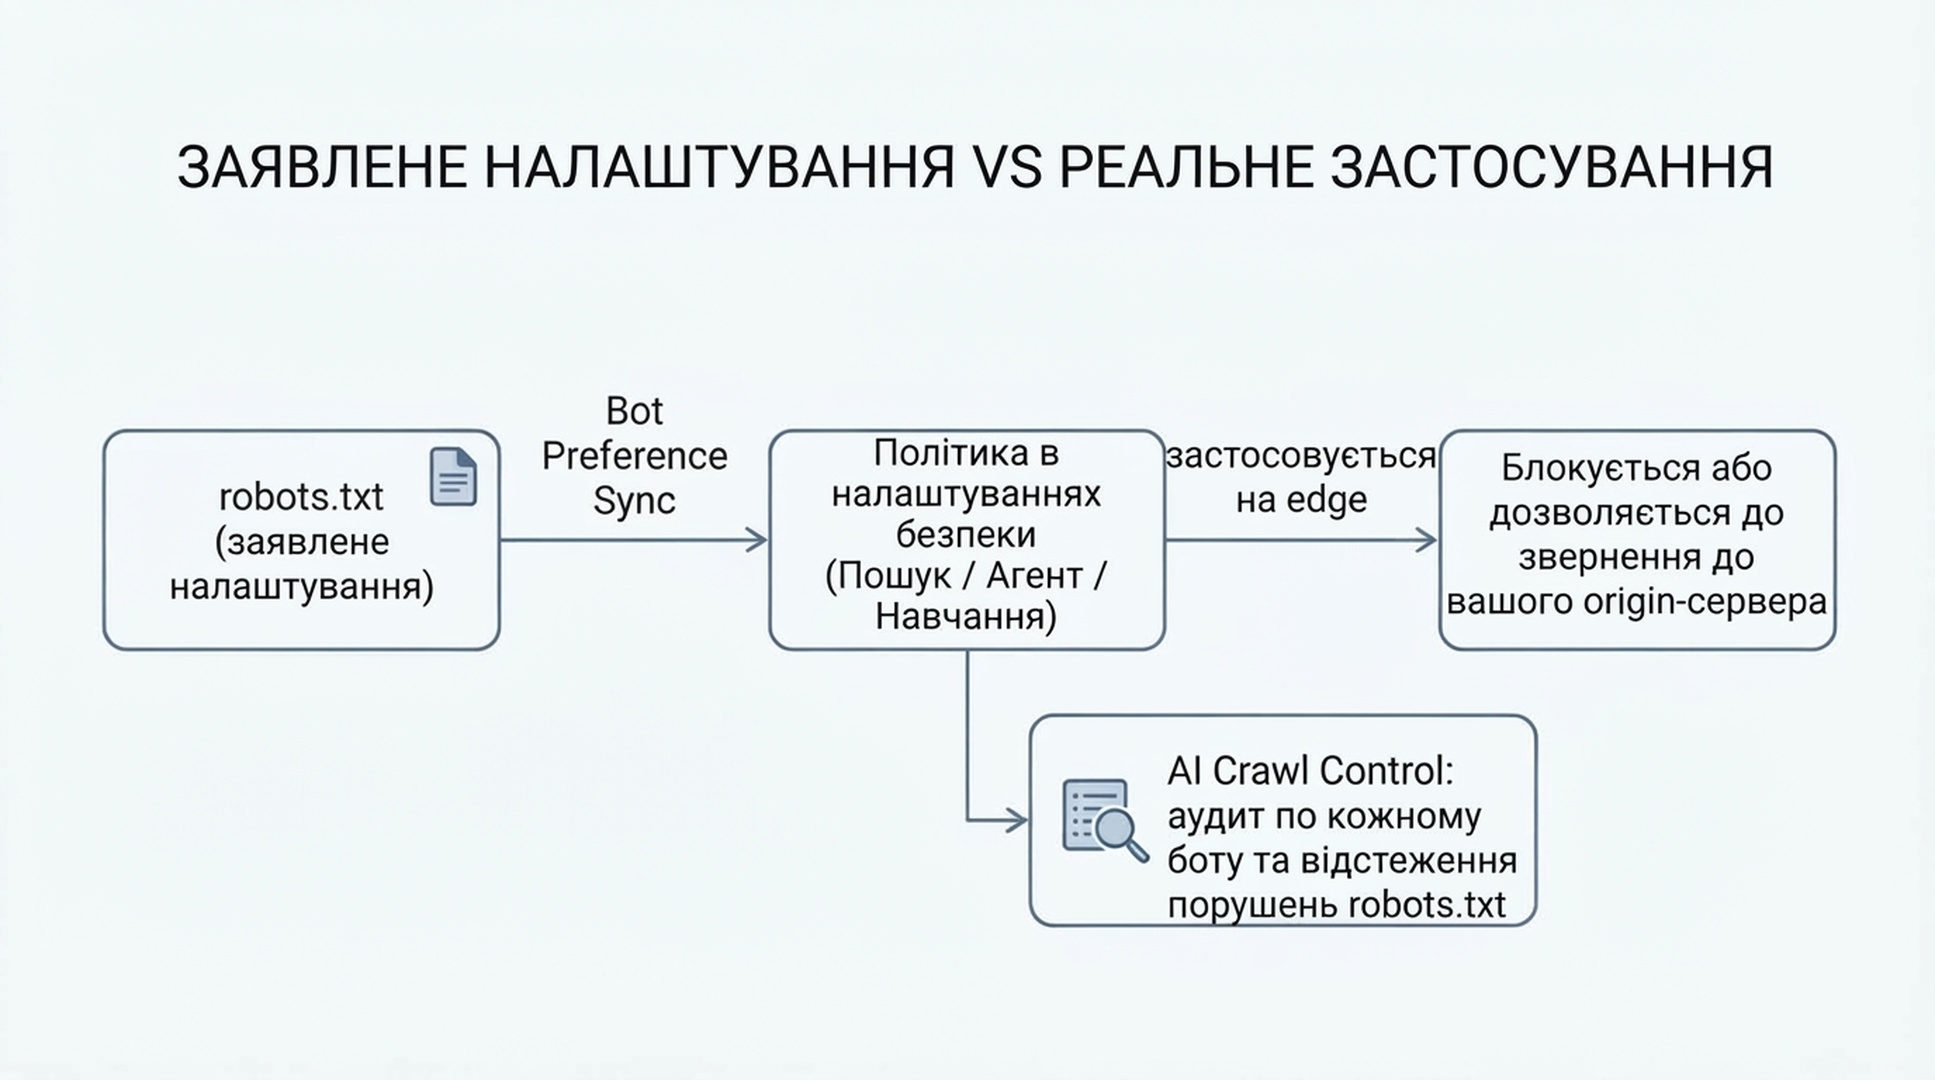
Налаштування в панелі та файл robots.txt — це дві різні системи, і коли вони розходяться, деякі сканери використовують цю розбіжність як привід ігнорувати вашу настанову. Bot Preference Sync від Cloudflare закриває цю прогалину, формуючи ваш robots.txt безпосередньо з обраних налаштувань безпеки.
Дія: у тій самій області налаштувань політики ШІ-ботів увімкніть Bot Preference Sync (для нових клієнтів він увімкнений типово; наявним клієнтам, які користуються старішою функцією керованого robots.txt, під час міграції запропонують переглянути й підтвердити).
Очікуваний результат: Cloudflare додає керований блок на початок вашого robots.txt, обгорнутий коментарями # BEGIN Cloudflare Bot Preference Sync / # END, зі списком уражених user agent і їхніх правил Disallow — і не видаляє жодного вашого власного правила, яке вже було в robots.txt; вони залишаються нижче керованого блоку.
Перевірка якості: отримайте /robots.txt ще раз після ввімкнення та переконайтеся, що керований блок з'явився й збігається з вибором із кроку 2. Наприклад, якщо ви поставили навчанню «Заборонити навчання ШІ», ви маєте побачити призначені для навчання user agent (Google-Extended, Applebot-Extended) із правилами Disallow, тоді як загальні Googlebot / Applebot / Bingbot залишаться незаблокованими для пошуку.
Шлях відновлення: якщо у вас є разова особлива домовленість із конкретним оператором сканера, яку зламає політика рівня категорії (скажімо, платна ліцензійна угода на контент), вимкніть Bot Preference Sync і редагуйте свій robots.txt вручну: перемикачі категорій створені для політики всієї зони, а не для винятків для окремих операторів.
Крок 4: Переконайтеся, що політика справді застосовується, а не лише запитується
robots.txt — це прохання з технічного погляду: він не зупиняє сканер, який його ігнорує. Це крок, який люди пропускають, і саме він показує, чи ваше рішення з кроку 2 реальне, чи тільки теоретичне.
Дія: відкрийте AI Crawl Control для своєї зони (доступний на всіх тарифах, зокрема безкоштовному — якість виявлення краща на тарифах із Bot Management, але функції видимості працюють усюди). Подивіться вкладку Crawlers, де перелічено всіх ботів, що дійшли до вашого сайту, зі стовпцем Robots.txt violations.
Очікуваний результат: таблиця з кількістю запитів і кількістю порушень для кожного бота. Ненульова кількість порушень у бота, якому ви поставили «заборонити» або «блокувати», означає, що цей бот зараз ігнорує ваш robots.txt.
Перевірка якості: для будь-якого бота з порушеннями подивіться «Most popular paths» (з фільтром на позначені шляхи) — що саме він запитує, — і вирішіть, чи зачіпає він контент, який вам справді важливо захищати.
Шлях відновлення: якщо бот ігнорує заявлену настанову, самий лише robots.txt його не зупинить. Скористайтеся дією «Enforce robots.txt rules» в AI Crawl Control (іноді її називають внутрішнім іменем Robotcop), щоб перетворити заявлені правила на справжнє правило WAF, яке блокує неслухняного бота на межі Cloudflare до того, як він дійде до вашого початкового сервера — ви переходите від «просити дотримання» до «вимагати дотримання». Цей крок використовує WAF, тож доступність залежить від наявності WAF на вашому тарифі.
Крок 5: Вирішіть, чи просто блокувати, чи брати плату за доступ
Якщо ваше рішення щодо навчання було «без доступу для навчання», у вас є другий варіант, окрім суцільного блокування: брати за це плату.
Дія: якщо цікаво, подайте заявку на закриту бету Pay Per Crawl від Cloudflare (через сторінку реєстрації Cloudflare або вашого менеджера, якщо ви клієнт Enterprise). Після ввімкнення на рівні облікового запису (Manage Account → Settings → Pay Per Crawl → установіть для свого домену Visibility у значення Visible) ви можете задати єдину фіксовану ціну за запит для всієї зони й для кожного сканера вибрати: дозволити (безкоштовно), стягувати плату (за вашою ціною) або блокувати.
Очікуваний результат: коли сканер, автентифікований через Web Bot Auth (запит із підписом Ed25519, що ідентифікує сканера), запитує сторінку, яку ви позначили як платну, він отримує HTTP 402 Payment Required із заголовком crawler-price; якщо він повторить запит, погодившись платити, або заздалегідь додасть заголовок crawler-max-price, що покриває вашу ціну, він отримає контент із заголовком crawler-charged, який підтверджує стягнуту суму. Cloudflare виступає як merchant of record і проводить розрахунки.
Перевірка якості: це працює лише проти сканерів, які зареєстрували платіжні дані в Cloudflare і підтримують сценарій із 402; це не універсальний перемикач проти всіх ботів. Для всіх інших ваше налаштування «стягувати плату» практично поводиться як блокування — Cloudflare зазначає, що воно все одно може слугувати сигналом про вашу готовність до платних відносин у майбутньому.
Шлях відновлення: функція в закритій беті; якщо вас не прийняли або ви не хочете чекати, «Заборонити навчання ШІ» або «Блокувати» залишаються доступними для тих самих сканерів сьогодні.
Робота з винятком: коли конкретний ШІ-оператор просить доступ
До вас може надійти звернення — партнерство, угода про цитування, розмова про ліцензування — від ШІ-компанії, яка хоче явного доступу всупереч політиці всієї зони.
Є два способи дати вузький виняток, не відкриваючи заново всю категорію:
- Перевизначення для конкретного сканера в Manage AI crawlers: переведіть рядок цього бота з «блокувати/стягувати плату» в «дозволити», незалежно від вашого налаштування навчання чи агентів на рівні категорії.
- Ручне редагування robots.txt: якщо ви вимкнули Bot Preference Sync (або розміщуєте виняток поза керованим блоком), можна додати точковий Allow для цього єдиного user agent нижче керованого Cloudflare розділу.
У будь-якому разі залишайте політику категорій для всієї зони типовою, а іменовані винятки вважайте свідомими задокументованими рішеннями — а не навпаки.
Перевірте результат
Пройдіться цим списком, коли конфігурація набуде чинності:
- [ ] У налаштуваннях безпеки для пошуку, агентів і навчання виставлено явні, свідомі значення, а не неперевірені типові
- [ ] У робочому
/robots.txtвидно керований Cloudflare блок, що відповідає цим налаштуванням - [ ] На вкладці Crawlers в AI Crawl Control видно очікуваних ботів, а порушення в усього, що ви поставили на «блокувати/заборонити», дорівнюють нулю або близькі до нього
- [ ] Якщо ви вибрали «Заборонити навчання ШІ», ви переконалися (через Search Console / Bing Webmaster Tools або просто спостерігаючи за органічним трафіком), що пошукове сканування від Googlebot / Applebot триває як звичайно
- [ ] Якщо ви ввімкнули примусове застосування robots.txt (Robotcop), отримане правило WAF розгорнуто й активне, а не просто створене й залишене чернеткою
- [ ] Ви задокументували, яке налаштування вибрали й чому, щоб майбутній перегляд не починався з нуля
Підтримуйте результат
Це не конфігурація «налаштував і забув». Повертайтеся до неї в легкому режимі:
- Щомісяця: перевіряйте вкладку Metrics в AI Crawl Control на наявність нових ботів, для яких ви ще не визначили політику, і переглядайте кількість порушень.
- Коли Bing випустить підтримку настанови щодо навчання для Bingbot (Microsoft заявляє ціль на початок 2027 року): переоцініть, чи ваша поточна конфігурація все ще дає задуманий результат — пошук збережено, навчання заблоковано, — бо саме тоді Bing наздожене поточну поведінку Google і Apple.
- Щоразу, коли змінюється ваш статус рекламної монетизації: додавання або вилучення медійної реклами змінює те, під яке типове значення потрапляють ваші сторінки, і варто заново переконатися, що ваші явні налаштування все ще мають сенс у цих умовах.
Часті запитання
Чи зашкодить блокування навчальних сканерів моїм позиціям у SEO? Ні, якщо ви використовуєте «Заборонити навчання ШІ», а не «Блокувати». Заборона навчання ШІ створена саме для того, щоб підзвітні сканери змішаного призначення (Google, Apple, а згодом і Bing) продовжували сканувати для пошуку, пропускаючи навчання. Натомість звичайне блокування тепер блокує й пошукову поведінку цих самих сканерів, що зашкодить вашій видимості в їхніх пошукових продуктах.
Я вже мав увімкнений «Block AI Bots» до 15 вересня. Що сталося з моїм налаштуванням? Cloudflare перенесла його автоматично: старий Block AI Bots став навчанням = Заборонити навчання ШІ, пошук = Дозволити, а агент = Блокувати на сторінках із рекламою. Перевірте за кроком 1 вище, чи фактичний результат вийшов таким, як очікувалося, замість припускати, що міграція збіглася з вашим наміром.
Чи щось із цього доступне на безкоштовному тарифі? Так. AI Crawl Control, налаштування категорій «пошук/агенти/навчання» та Bot Preference Sync працюють на всіх тарифах, зокрема безкоштовному. Деякі деталі застосування залежать від тарифу — наприклад, примусове застосування robots.txt працює через WAF, а виявлення ботів на безкоштовному тарифі спирається на рядки user agent, а не на досконаліший ідентифікатор виявлення Bot Management.
Чим AI Crawl Control відрізняється від налаштувань безпеки ШІ-ботів? Налаштування безпеки — це місце, де ви визначаєте політику (дозволити / блокувати на сторінках із рекламою / блокувати / заборонити навчання ШІ для кожної категорії). AI Crawl Control — це місце, де ви перевіряєте, що відбувається насправді: кількість запитів для кожного бота, порушення robots.txt, деталізація на рівні шляхів — і де можна перетворити заявлену політику robots.txt на застосовуване правило WAF.
Чи потрібно мені вручну редагувати robots.txt після налаштування всього цього? Ні, якщо Bot Preference Sync увімкнено: він сам записує й підтримує потрібний блок robots.txt на основі ваших налаштувань у панелі. Ручне редагування потрібне лише для разових винятків для окремого оператора поза керованими категоріями.
Автор: Julian Mercer, практик технічного SEO з 14-річним досвідом в Auspia. Пише про сканованість, структуровані дані, рендеринг і технічні основи, що роблять контент читабельним для ШІ.