Was Sie am Ende dieses Leitfadens haben
Wenn Sie diesen Leitfaden durchgearbeitet haben, hat Ihre Cloudflare-Zone eine ausdrückliche, bewusst gesetzte Richtlinie für die drei getrennten Kategorien des KI-Bot-Traffics — Suche (Search), Agenten (Agent) und Training (Training) — statt der Standardeinstellung, die Ihre Domain geerbt hat. Sie wissen genau, welche Crawler zugelassen, welche blockiert sind und auf welchen Seiten, und Ihr robots.txt sowie die Durchsetzungsregel am Edge passen tatsächlich zueinander.
Für wen das gedacht ist: alle, die eine über Cloudflare laufende Website betreiben — Publisher, SaaS-Marketingseiten, Onlineshops, Blogs — und selbst entscheiden wollen, ob KI-Systeme auf ihren Inhalten trainieren, sie zusammenfassen oder per Agent darauf zugreifen dürfen, statt die Einstellung der Plattform zu übernehmen.
Was Sie brauchen:
- Eine über Cloudflare proxied Domain (jeder Tarif, auch Free; einige Schritte unten sind kostenpflichtigen Tarifen vorbehalten, was jeweils gekennzeichnet ist)
- Dashboard-Zugang mit mindestens der Berechtigung, Sicherheitseinstellungen auf Domain-Ebene zu ändern
- 20 bis 30 Minuten für Prüfung und Einrichtung; danach einige Minuten pro Tag oder Woche für die Überwachung
Definition von „fertig": Ihre Zonen-Sicherheitseinstellungen zeigen für Suche, Agenten und Training eine bewusste Entscheidung (keine ungeprüfte Standardeinstellung); das ausgelieferte /robots.txt spiegelt diese Entscheidung wider; und Sie haben im AI Crawl Control bestätigt, dass Bots, die blockiert sein sollten, tatsächlich blockiert werden.
Warum das plötzlich wichtig wurde: Was sich am 15. September geändert hat
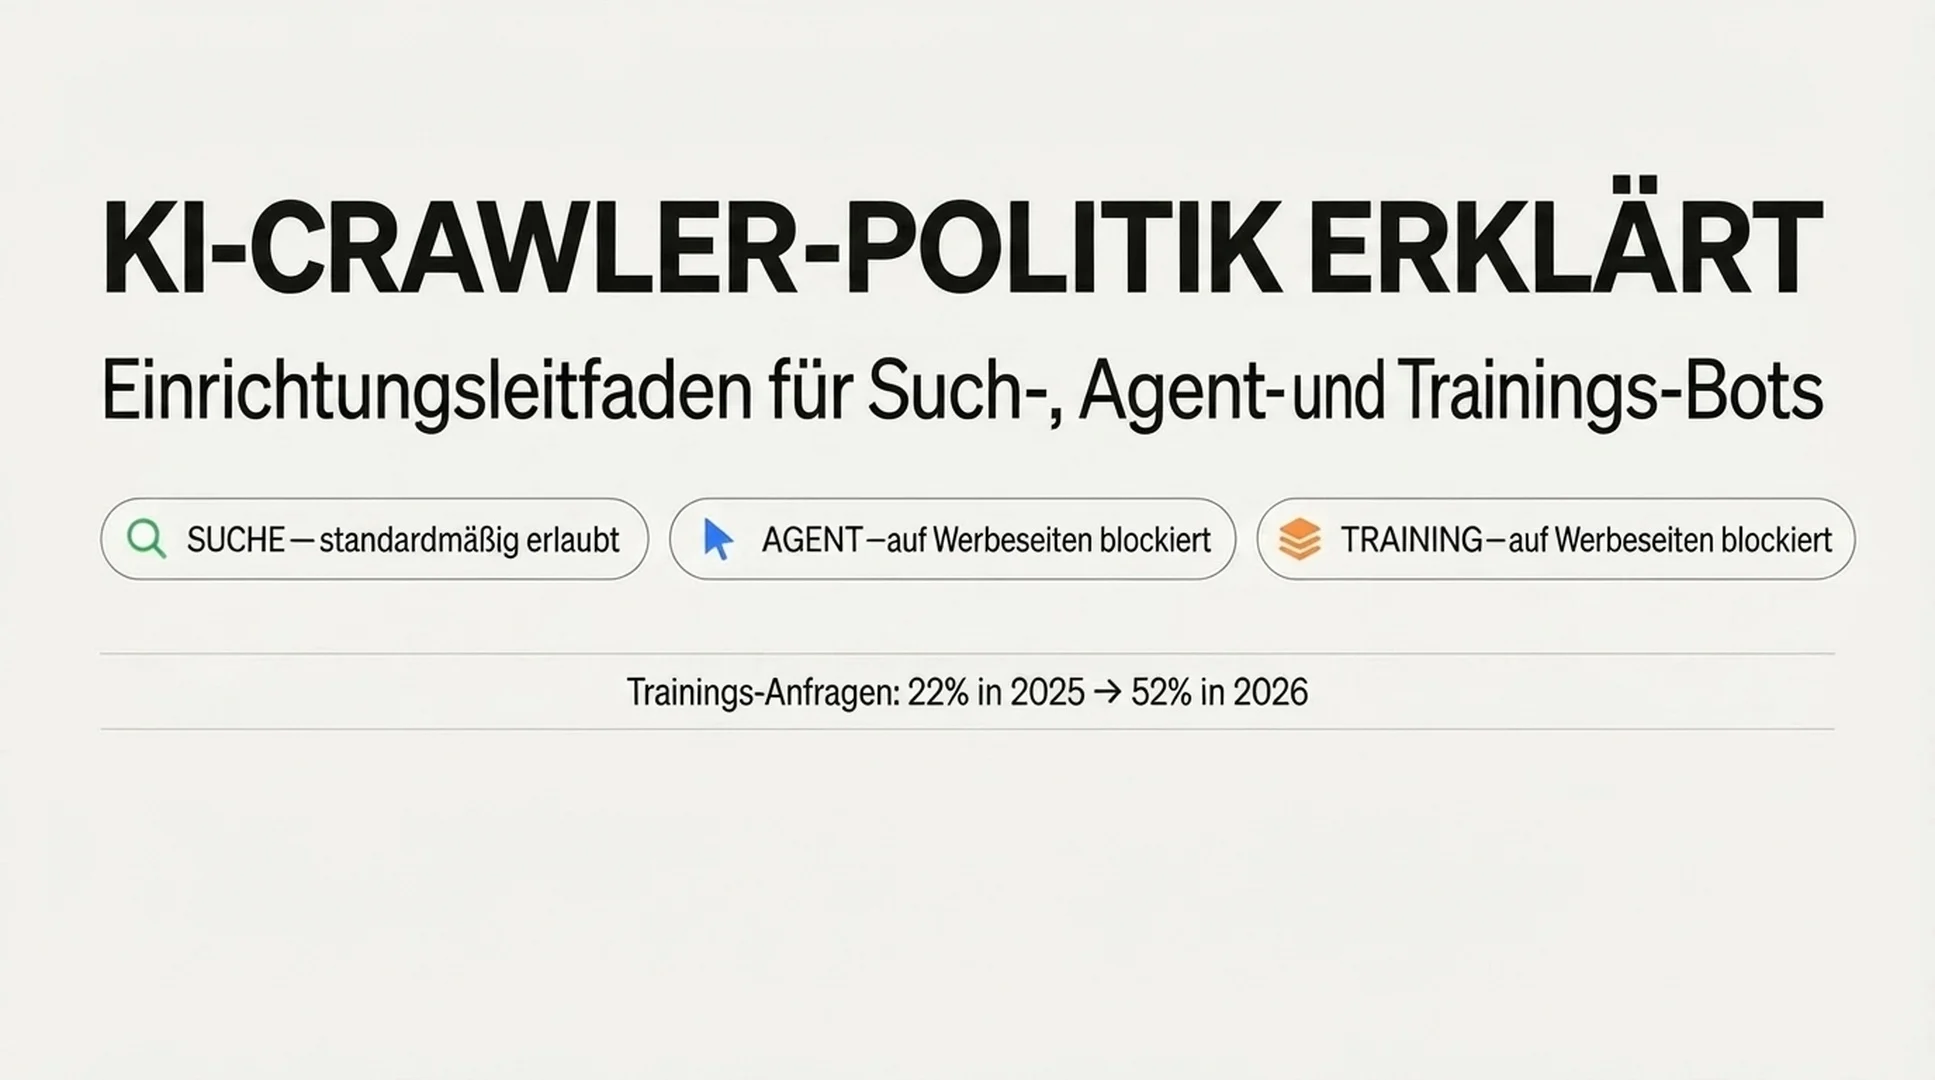
Cloudflare hat seine KI-Traffic-Kontrollen in Etappen aufgebaut: beginnend mit der Content Signals Policy im robots.txt im September 2025 bis hin zum Start des „Content Independence Day" am 1. Juli 2026, der das Verhalten von KI-Bots erstmals in drei benannte Kategorien aufteilte, statt in einen groben Schalter „KI oder nicht KI":
- Suche (Search) — Crawling, das einen Suchindex aufbaut und später Links oder kurze Auszüge zurückliefert. In Cloudflares eigenen Worten: der Traffic, der Ihnen Empfehlungen bringen sollte.
- Agent (Agent) — automatisierte Aktivität, die in Echtzeit im Namen einer Person handelt, etwa ein Chat-Assistent, der eine Seite abruft, oder ein Browser-Agent, der eine Aufgabe erledigt.
- Training (Training) — Crawling zum Trainieren oder Feinabstimmen eines Modells, bei dem Ihr Inhalt dauerhaft in den Modellgewichten verschwindet, statt als Link zu Ihnen zurückzukommen.
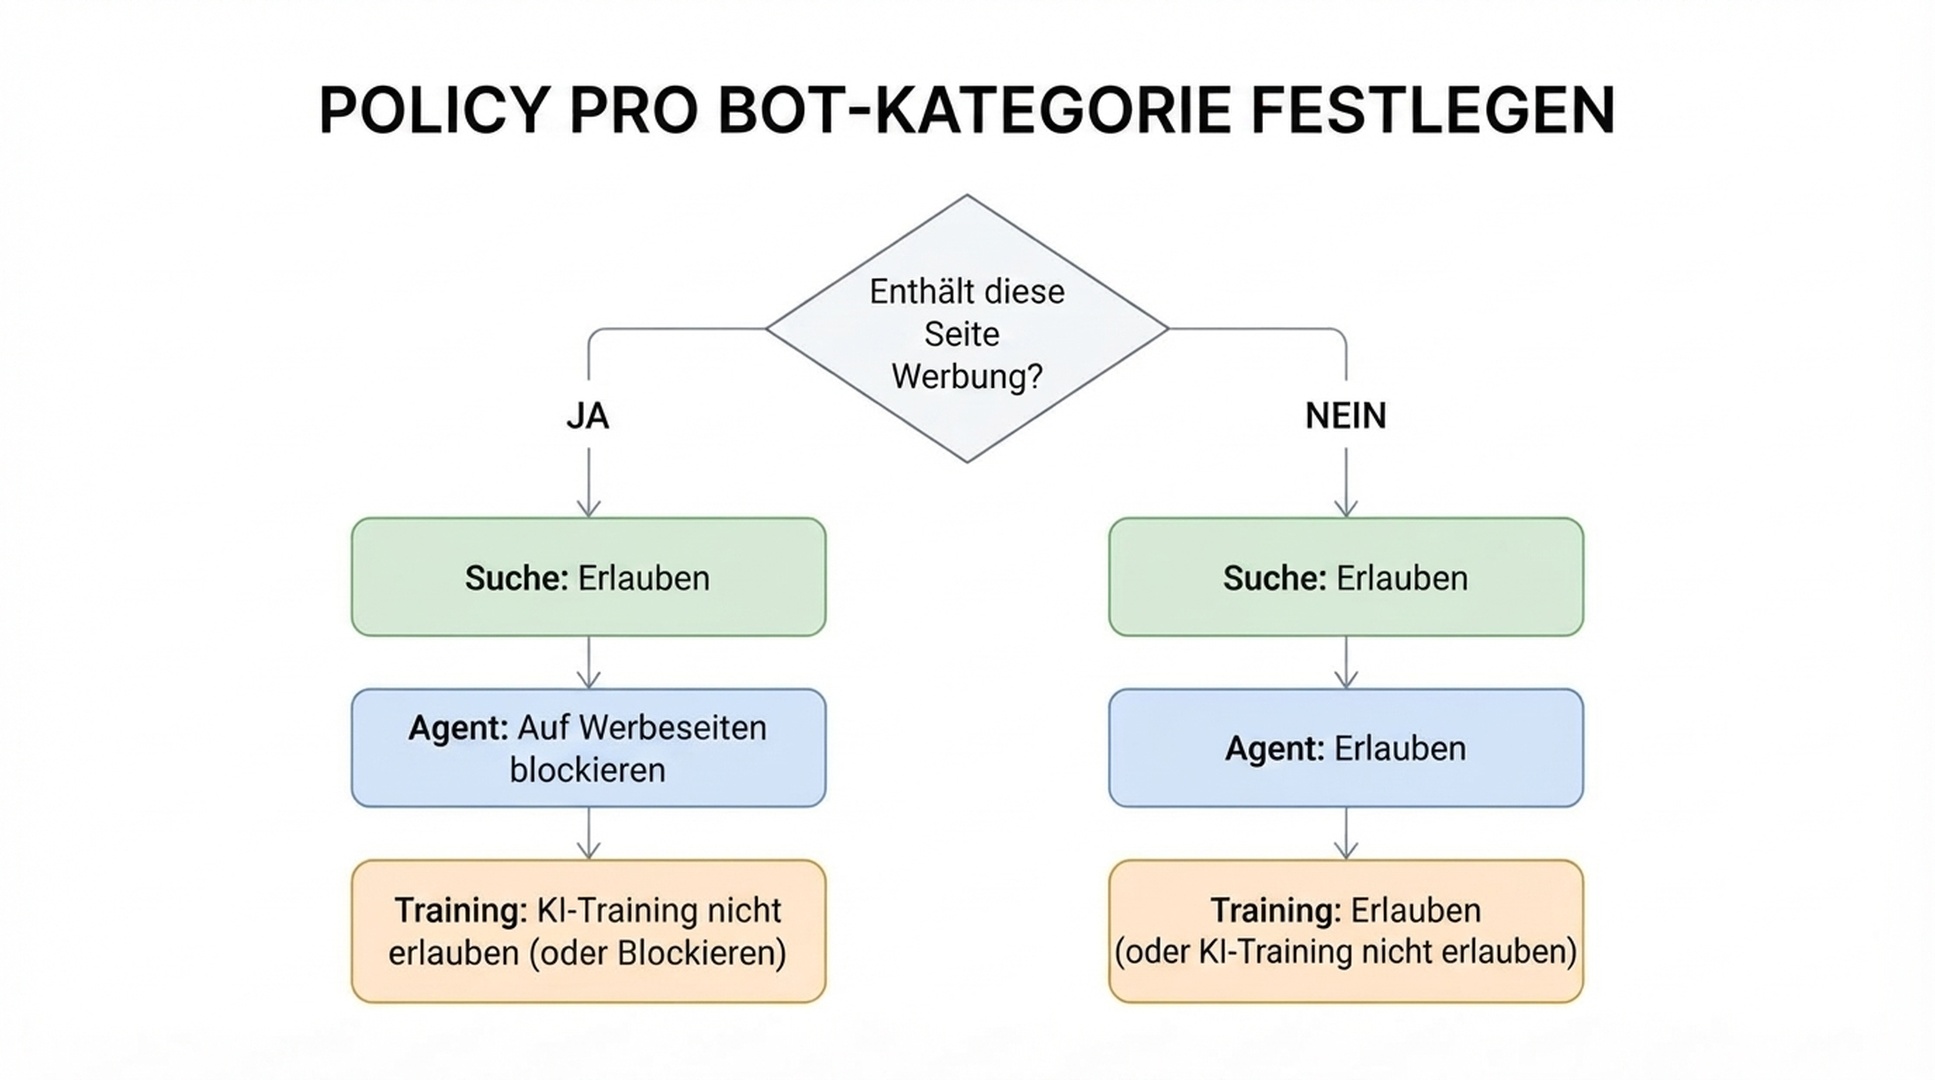
Am 15. September 2026 hat Cloudflare geändert, was automatisch passiert. Für jede Domain, die an diesem Tag oder später zu Cloudflare kommt, gilt, wenn die Website als werbefinanziert markiert ist, folgende Standardeinstellung:
Kategorie | Standard auf Seiten mit Werbung |
|---|---|
Suche (Search) | Erlauben |
Agent (Agent) | Auf Seiten mit Werbung blockieren |
Training (Training) | KI-Training nicht erlauben (Disallow AI Training) |
Neue Domains ohne Werbefinanzierung erhalten in allen drei Kategorien standardmäßig „Erlauben". Bestandskunden wurden nicht stillschweigend umgestellt — Cloudflare bot vor dem 15. ein Fenster, um über das Dashboard zu widersprechen, und die tatsächlichen Migrationsregeln pro Domain fielen differenzierter aus als ein einziger neuer Standardwert (dazu unten mehr).
Der Grund, warum Seiten mit Werbung strengere Standards erhalten, ist, dass Werbung auf der Seite ein Signal dafür ist, dass sie für die Betrachtung durch Menschen gedacht war. Nach Cloudflares eigenen Zahlen machten Crawler mit gemischter Nutzung — solche, die Suchindexierung, Agenten-Anfragen und Training unter einem einzigen User Agent kombinieren — im Juni 2026 über 36% des verifizierten Crawler-Traffics aus, die größte Einzelkategorie. Und der Anteil von KI-Training an allen Crawler-Anfragen im Cloudflare-Netz stieg von etwa 22% im Frühjahr 2025 auf 52% im Juni 2026. Genau auf diesen Traffic zielt die Änderung.
Bevor Sie beginnen: drei Dinge, die Sie zu den Kategorien verstehen müssen
1. Manche Crawler haben gemischte Nutzung und verhalten sich bei Blockierung anders als beim Trainingsverbot. Googlebot, Bingbot und Applebot leisten Doppelarbeit — sie crawlen unter demselben User Agent sowohl für die Suche als auch für das Training. Cloudflare bezeichnet Apple, Google und Microsoft als „Accountable"-Betreiber (rechenschaftspflichtig), weil sie vier Bedingungen erfüllen: Sie respektieren die Trainings-Ablehnung im robots.txt, bieten einen Weg, KI-Zusammenfassungen abzulehnen, geben Transparenz auf URL-Ebene darüber, was fürs Training verwendet wurde, und können belegen, dass eine Trainings-Ablehnung Ihrer Suchpräsenz nicht schadet.
2. „KI-Training nicht erlauben" und „Blockieren" sind nicht dieselbe Einstellung, und genau dieser Unterschied ist der Kern. „KI-Training nicht erlauben" veröffentlicht im robots.txt eine Disallow-Präferenz, die sich an trainingsspezifische User Agents richtet (etwa Google-Extended und Applebot-Extended). Rechenschaftspflichtige Crawler mit gemischter Nutzung lesen diese Präferenz und crawlen freiwillig weiter für die Suche, während sie das Training überspringen — Ihre Suchpräsenz bleibt also erhalten. Andere Trainings-Crawler, die nicht von rechenschaftspflichtigen Betreibern stammen, werden sofort am Edge blockiert, was die Suche nicht betrifft, weil diese Betreiber separate Trainings-Bots laufen lassen. Ein einfaches Blockieren dagegen blockiert jetzt auch Googlebot, Bingbot und Applebot selbst, was bedeutet, dass Ihr Inhalt auch aus deren Suchergebnissen verschwindet. Wenn Sie das Training loswerden und die Suche behalten wollen, ist die richtige Einstellung „KI-Training nicht erlauben" und nicht „Blockieren".
3. Bing respektiert die Trainingspräferenz im robots.txt noch nicht. Heute befolgen sowohl Applebot als auch Googlebot die trainingsspezifische Disallow-Direktive. Microsoft gibt an, einen entsprechenden Mechanismus für Bingbot zu bauen, mit Ziel Anfang 2027. Bis dahin schreibt die Wahl „KI-Training nicht erlauben" Ihre Präferenz ins robots.txt, aber das Crawling-Verhalten von Bing zu Trainingszwecken ändert sich durch dieses Signal allein nicht — Bings eigene NOARCHIVE-Meta-Auszeichnung oder das Content-Removal-Tool bleiben die vorläufigen Hebel, wenn Ihr Anliegen speziell das Training über Bing ist.
Schritt 1: Finden Sie heraus, wo Ihre Website tatsächlich gelandet ist
Nehmen Sie nicht an, dass Sie die aktuelle Einstellung kennen — prüfen Sie sie.
Aktion: Öffnen Sie im Cloudflare-Dashboard Ihre Domain, gehen Sie zu Security → Settings und suchen Sie die Richtlinien-Steuerelemente für KI-Bots (die neuere Oberfläche mit drei Kategorien hat den alten Einzelschalter „Block AI Bots" ersetzt, doch Konten, die noch nicht migriert wurden, können den alten Schalter weiterhin anzeigen). Rufen Sie separat das ausgelieferte robots.txt im Browser oder per curl https://yourdomain.com/robots.txt ab und suchen Sie einen Block, der mit einem von Cloudflare verwalteten Marker-Kommentar beginnt; Sie können die Regeln auch mit dem Robots.txt-KI-Crawler-Checker von Auspia abgleichen, um zu sehen, wie KI-Crawler Ihre aktuellen Regeln lesen.
Erwartetes Ergebnis: drei Einstellungen, je eine für Suche, Agenten und Training, jede in einem von: Erlauben / Auf Seiten mit Werbung blockieren / Blockieren (mit „KI-Training nicht erlauben" als vierter, nur für Training verfügbarer Option). Das ausgelieferte robots.txt sollte einen von Cloudflare verwalteten Abschnitt zeigen, der konkrete User Agents und Disallow- bzw. Content-Signal-Zeilen auflistet, sofern Bot Preference Sync oder das verwaltete robots.txt aktiv sind.
Qualitätsprüfung: Vergewissern Sie sich, dass die drei Einstellungen dem entsprechen, was Sie wirklich wollen, und nicht dem, was die Migration für Sie angenommen hat. Die von Cloudflare dokumentierte Migrationslogik für Bestandskunden lautet: Wenn Sie den alten Schalter „Block AI" aktiviert hatten, wurden Sie auf Training = KI-Training nicht erlauben, Suche weiterhin Erlauben und Agent = Auf Seiten mit Werbung blockieren gesetzt. Wenn Sie das Training selbst auf Blockieren oder Auf Seiten mit Werbung blockieren gestellt hatten, wurden Sie auf KI-Training nicht erlauben gesetzt. Beide Migrationspfade gehen davon aus, dass Sie die Suche behalten wollten. Wenn Sie eigentlich wollten, dass Crawler mit gemischter Nutzung vollständig verschwinden, einschließlich Suche, dann ist das nicht Ihr aktueller Zustand, und Sie müssen ausdrücklich Blockieren wählen.
Wiederherstellungspfad: Wenn die Sicherheitseinstellungen nur den alten Schalter „Block AI Bots" ohne Aufteilung in drei Kategorien zeigen, ist Ihr Konto noch nicht auf die neuen Steuerelemente migriert. Suchen Sie nach „Configure AI bot policies", einer separaten, neueren Einstellungsoberfläche; dort leben die detaillierten Steuerelemente während der Übergangszeit neben dem alten Schalter, und dorthin zeigt die Zukunft.
Schritt 2: Entscheiden Sie die Richtlinie je Kategorie, nicht mit einer pauschalen Antwort
Das ist der eigentliche Entscheidungsschritt. Gehen Sie jede Kategorie einzeln durch.
Suche. Kaum jemand blockiert sie — Cloudflare berichtet, dass weniger als 1% der Websites Such-Bots blockieren — weil der Verlust von Suchsichtbarkeit fast nie die Kosten wert ist. Setzen Sie standardmäßig Erlauben, es sei denn, Sie haben einen konkreten Grund (eine Testumgebung, ein Archiv hinter einer Bezahlschranke), die Website aus Suchindizes herauszuhalten.
Agenten. Das sind Bots, die in Echtzeit für jemanden handeln, der gerade jetzt etwas auf Ihrer Website tun will: einen Preis prüfen, eine Buchung abschließen, eine Information für eine Chat-Antwort herausziehen. Agenten-Traffic auf monetarisierten oder Werbeseiten zu blockieren, ist der Grund hinter dem neuen Standardwert, denn ein Agentenbesuch erzeugt nicht die Werbeimpression, die ein menschlicher Besuch erzeugen würde. Wenn Ihr Geschäftsmodell von dieser menschlichen Aufmerksamkeit abhängt (Medien, Content-Websites mit Display-Werbung), ist Auf Seiten mit Werbung blockieren eine vertretbare Haltung. Wenn Sie es vorziehen, dass Agenten Aufgaben auf Ihrer Website auch auf Werbeseiten abschließen können — etwa weil Agenten-Traffic bei Ihnen trotzdem konvertiert —, wählen Sie Erlauben.
Training. Hier liegt die eigentliche Entscheidung, und hier stiftet die Terminologie Verwirrung:
- Wählen Sie KI-Training nicht erlauben, wenn Sie verhindern wollen, dass Ihr Inhalt zum Trainieren von Modellen verwendet wird, und gleichzeitig in den Suchprodukten von Google, Bing und Apple präsent bleiben wollen (angesichts des aktuellen Rückstands von Bing verstehen Sie das als „gilt heute für Google und Apple, steht für Bing noch aus"). Das ist der von Cloudflare empfohlene Mittelweg, der genau für die Abwägung zwischen Suche und Training geschaffen wurde.
- Wählen Sie Blockieren nur, wenn Sie bereit sind, das Such-Crawling von Googlebot, Bingbot und Applebot vollständig zu verlieren, als Preis dafür, deren Trainingsverhalten zu blockieren. Das ist jetzt die strenge Option: Seit dem 15. September gilt die Blockierung auch für Crawler mit gemischter Nutzung, was vorher nicht der Fall war.
- Wählen Sie Erlauben nur, wenn Sie bewusst akzeptieren, dass Ihr Inhalt KI-Modelle trainiert, etwa weil Sie die Sichtbarkeit in KI-Antworten maximieren wollen und das Training als akzeptablen Preis dafür betrachten.
Aktion: Stellen Sie in Security → Settings → Configure AI bot policies die drei Auswahlfelder entsprechend Ihrer Entscheidung ein.
Erwartetes Ergebnis: Das Dashboard sollte Ihre ausdrückliche Wahl in jeder Kategorie widerspiegeln und (bei aktivem Bot Preference Sync) beginnen, den passenden robots.txt-Block automatisch zu veröffentlichen — ohne manuelle Dateibearbeitung.
Qualitätsprüfung: Prüfen Sie Ihre Trainings-Entscheidung mit einer einzigen Frage nach: „Will ich meine Suchsichtbarkeit behalten oder nicht?" Wenn ja, dann ist das KI-Training nicht erlauben und nicht Blockieren, so verlockend der Begriff „Blockieren" auch klingt, um KI-Training zu stoppen.
Wiederherstellungspfad: Wenn der Suchtraffic gesunken ist, nachdem Sie eine Einstellung gewählt haben, prüfen Sie, ob Sie versehentlich Blockieren statt KI-Training nicht erlauben gewählt haben. Das ist der häufigste selbstschädigende Fehler hier: Der Name lässt „Blockieren" wie die Option klingen, die „mehr macht", aber beim Training bewirkt sie, was Sie vielleicht nicht wollen — sie nimmt die Suche mit.
Schritt 3: Aktivieren Sie Bot Preference Sync, damit das robots.txt zu Ihren Einstellungen passt
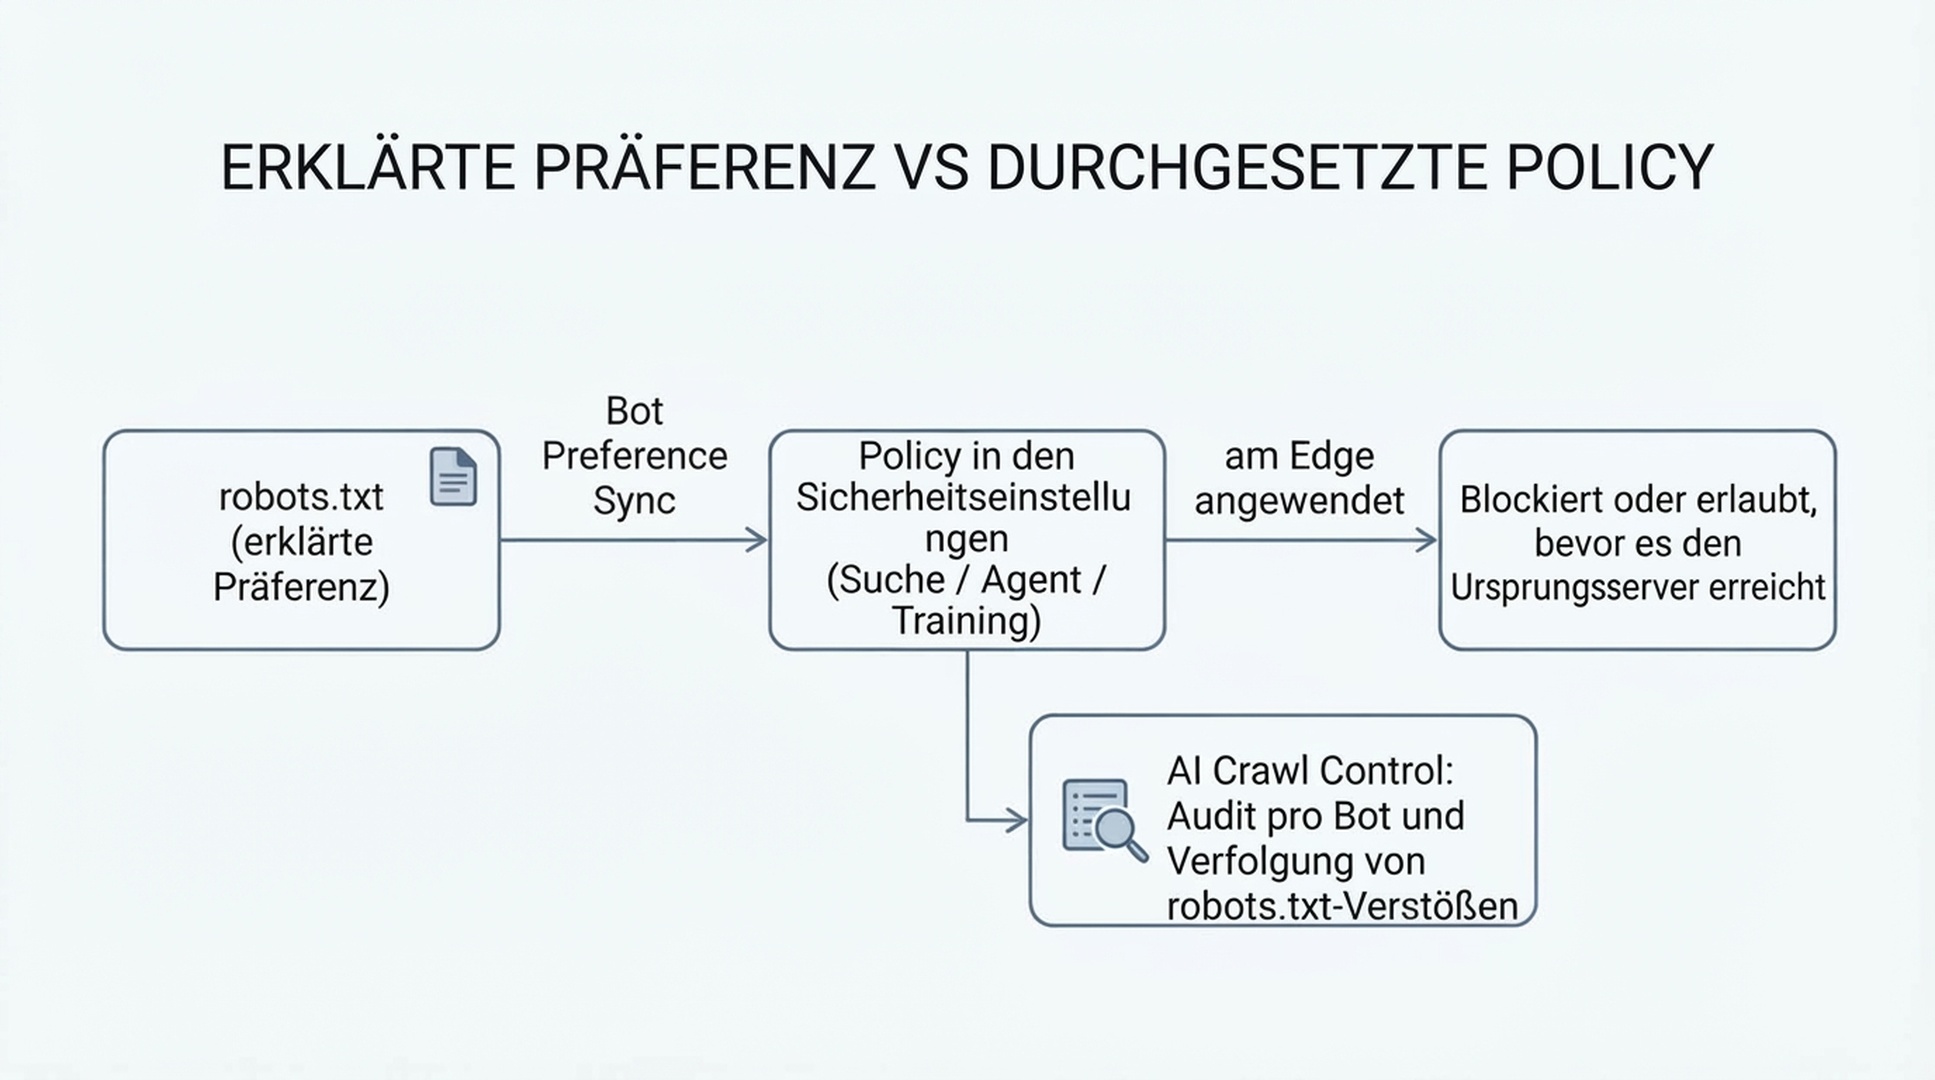
Die Dashboard-Einstellung und die robots.txt-Datei sind zwei verschiedene Systeme, und wenn sie auseinanderlaufen, nutzen manche Crawler diese Lücke als Vorwand, Ihre Präferenz zu ignorieren. Cloudflares Bot Preference Sync schließt diese Lücke, indem er Ihr robots.txt direkt aus den gewählten Sicherheitseinstellungen erzeugt.
Aktion: Aktivieren Sie im selben Bereich für die KI-Bot-Richtlinie den Bot Preference Sync (bei neuen Kunden standardmäßig an; Bestandskunden mit der älteren Funktion für verwaltetes robots.txt werden bei der Migration gebeten, dies zu prüfen und zu bestätigen).
Erwartetes Ergebnis: Cloudflare fügt oben in Ihrem robots.txt einen verwalteten Block ein, umschlossen von den Kommentaren # BEGIN Cloudflare Bot Preference Sync / # END, der die betroffenen User Agents und ihre Disallow-Regeln auflistet — und entfernt keine eigenen Regeln, die Sie bereits im robots.txt hatten; diese bleiben unterhalb des verwalteten Blocks erhalten.
Qualitätsprüfung: Rufen Sie /robots.txt nach der Aktivierung erneut ab und vergewissern Sie sich, dass der verwaltete Block erscheint und zu den Entscheidungen aus Schritt 2 passt. Wenn Sie das Training etwa auf KI-Training nicht erlauben gesetzt haben, sollten Sie die trainingsspezifischen User Agents (Google-Extended, Applebot-Extended) mit Disallow-Regeln sehen, während die allgemeinen User Agents Googlebot / Applebot / Bingbot für die Suche weiterhin nicht blockiert sind.
Wiederherstellungspfad: Wenn Sie eine einmalige Sondervereinbarung mit einem bestimmten Crawler-Betreiber haben, die eine Richtlinie auf Kategorieebene brechen würde (etwa ein bezahlter Content-Lizenzvertrag), deaktivieren Sie Bot Preference Sync und bearbeiten Sie Ihr robots.txt manuell: Die Kategorieschalter sind für Zonen-weite Richtlinien gedacht, nicht für Ausnahmen einzelner Betreiber.
Schritt 4: Bestätigen Sie, dass die Richtlinie tatsächlich durchgesetzt wird und nicht nur erbeten
Das robots.txt ist technisch gesehen eine Bitte: Es hält einen Crawler, der sie ignoriert, nicht auf. Diesen Schritt lassen die Leute aus, und genau er zeigt, ob Ihre Entscheidung aus Schritt 2 real oder nur Theorie ist.
Aktion: Öffnen Sie das AI Crawl Control Ihrer Zone (in allen Tarifen verfügbar, auch Free — die Erkennungsqualität ist in Tarifen mit Bot Management besser, aber die Sichtbarkeitsfunktionen arbeiten überall). Sehen Sie sich den Tab Crawlers an, der alle Bots auflistet, die Ihre Website erreicht haben, mit einer Spalte Robots.txt violations.
Erwartetes Ergebnis: eine Tabelle mit Anfrage- und Verstoßzahlen je Bot. Eine Verstoßzahl ungleich null bei einem Bot, den Sie auf nicht erlaubt oder blockiert gesetzt haben, bedeutet, dass dieser Bot Ihr robots.txt gerade ignoriert.
Qualitätsprüfung: Sehen Sie bei jedem Bot mit Verstößen unter „Most popular paths" (gefiltert auf die markierten Pfade) nach, was er tatsächlich anfragt, um zu entscheiden, ob er Inhalte erreicht, die Sie wirklich schützen wollen.
Wiederherstellungspfad: Wenn ein Bot Ihre erklärte Präferenz ignoriert, hält das robots.txt allein ihn nicht auf. Nutzen Sie die Aktion „Enforce robots.txt rules" im AI Crawl Control (manchmal unter dem internen Namen Robotcop geführt), um Ihre erklärten Regeln in eine echte WAF-Regel umzuwandeln, die den uneinsichtigen Bot am Cloudflare-Edge blockiert, bevor er Ihren Ursprungsserver erreicht — Sie gehen von „Um Einhaltung bitten" zu „Einhaltung erzwingen" über. Dieser Schritt nutzt die WAF, die Verfügbarkeit hängt also davon ab, ob Ihr Tarif WAF-Zugang hat.
Schritt 5: Entscheiden Sie zwischen reinem Blockieren und Bezahlung für den Zugriff
Wenn Ihre Trainings-Entscheidung „kein Zugriff fürs Training" lautete, haben Sie neben dem reinen Blockieren eine zweite Option: Geld verlangen.
Aktion: Wenn das interessant ist, bewerben Sie sich für Cloudflares geschlossene Pay-Per-Crawl-Beta (über die Anmeldeseite von Cloudflare oder über Ihren Account-Manager, wenn Sie Enterprise-Kunde sind). Nach der Aktivierung auf Kontoebene (Manage Account → Settings → Pay Per Crawl → setzen Sie das Visibility Ihrer Domain auf Visible) können Sie einen einheitlichen Festpreis pro Anfrage für die Zone festlegen und je Crawler wählen zwischen erlauben (kostenlos), berechnen (zu Ihrem Preis) oder blockieren.
Erwartetes Ergebnis: Wenn ein über Web Bot Auth authentifizierter Crawler (eine Anfrage mit Ed25519-Signatur, die den Crawler identifiziert) eine Seite anfragt, die Sie als kostenpflichtig markiert haben, erhält er ein HTTP 402 Payment Required mit dem Header crawler-price; versucht er es erneut mit Zahlungszusage, oder sendet er vorab einen crawler-max-price-Header, der Ihren Preis abdeckt, bekommt er den Inhalt mit dem Header crawler-charged, der den berechneten Betrag bestätigt. Cloudflare tritt als Merchant of Record auf und wickelt die Abrechnung ab.
Qualitätsprüfung: Das funktioniert nur gegen Crawler, die Zahlungsdaten bei Cloudflare hinterlegt haben und den 402-Ablauf unterstützen; es ist kein Universalschalter gegen alle Bots. Für alles andere wirkt Ihre Einstellung „berechnen" praktisch wie eine Blockierung — Cloudflare merkt an, dass sie dennoch als Signal dient, dass Sie künftig für eine bezahlte Beziehung offen sind.
Wiederherstellungspfad: Die Funktion ist in einer geschlossenen Beta; wenn Sie nicht angenommen werden oder nicht warten wollen, bleiben KI-Training nicht erlauben oder Blockieren für dieselben Crawler heute verfügbar.
Umgang mit der Ausnahme: Wenn ein bestimmter KI-Betreiber um Zugang bittet
Es kann eine Anfrage bei Ihnen eingehen — eine Partnerschaft, eine Zitiervereinbarung, ein Lizenzgespräch — von einem KI-Unternehmen, das ausdrücklich Zugang außerhalb der Zonen-weiten Richtlinie möchte.
Es gibt zwei Wege, eine eng gefasste Ausnahme zu gewähren, ohne die ganze Kategorie wieder zu öffnen:
- Überschreiben je Crawler in Manage AI crawlers: Ändern Sie die Zeile dieses Bots von blockieren/berechnen auf erlauben, unabhängig von Ihrer Trainings- oder Agenten-Einstellung auf Kategorieebene.
- robots.txt direkt bearbeiten: Wenn Sie Bot Preference Sync deaktiviert haben (oder die Ausnahme außerhalb des verwalteten Blocks platzieren), können Sie unterhalb des von Cloudflare verwalteten Abschnitts ein gezieltes Allow für genau diesen User Agent hinzufügen.
Halten Sie in beiden Fällen die Kategorierichtlinie der Zone als Standard aufrecht und behandeln Sie namentliche Ausnahmen als bewusste, dokumentierte Entscheidungen — nicht umgekehrt.
Prüfen Sie das Ergebnis
Gehen Sie diese Checkliste durch, wenn die Konfiguration live ist:
- [ ] Die Sicherheitseinstellungen zeigen ausdrückliche, bewusste Werte für Suche, Agenten und Training — keine ungeprüften Standardwerte
- [ ] Das ausgelieferte
/robots.txtzeigt einen von Cloudflare verwalteten Block, der zu diesen Einstellungen passt - [ ] Der Tab Crawlers im AI Crawl Control zeigt die erwarteten Bots, mit null oder nahezu null Verstößen für alles, was Sie auf blockiert/nicht erlaubt gesetzt haben
- [ ] Wenn Sie KI-Training nicht erlauben gewählt haben, haben Sie bestätigt (über Search Console / Bing Webmaster Tools oder einfach durch Beobachtung des organischen Traffics), dass das Such-Crawling von Googlebot / Applebot normal weiterläuft
- [ ] Wenn Sie die robots.txt-Durchsetzung (Robotcop) aktiviert haben, ist die resultierende WAF-Regel ausgerollt und aktiv und nicht nur erstellt und als Entwurf liegen gelassen
- [ ] Sie haben dokumentiert, welche Einstellung Sie gewählt haben und warum, damit eine künftige Überprüfung nicht bei null beginnt
Halten Sie das Ergebnis am Laufen
Das ist keine Konfiguration zum Einrichten und Vergessen. Kommen Sie in leichtem Rhythmus darauf zurück:
- Monatlich: Prüfen Sie den Tab Metrics im AI Crawl Control auf neue Bots, für die Sie noch keine Richtlinie festgelegt haben, und kontrollieren Sie die Verstoßzahlen erneut.
- Wenn Bing die Trainingspräferenz für Bingbot ausrollt (Microsoft nennt als Ziel Anfang 2027): Bewerten Sie neu, ob Ihre aktuelle Konfiguration noch das beabsichtigte Ergebnis liefert — Suche behalten, Training blockieren —, denn dann zieht Bing mit dem heutigen Verhalten von Google und Apple gleich.
- Immer wenn sich Ihr Werbe-Monetarisierungsstatus ändert: Display-Werbung hinzuzufügen oder zu entfernen ändert, in welchen Standardbereich Ihre Seiten fallen, und es lohnt sich, erneut zu prüfen, ob Ihre ausdrücklichen Einstellungen in diesem Szenario noch sinnvoll sind.
Häufige Fragen
Schadet das Blockieren von Trainings-Crawlern meinem SEO-Ranking? Nein, wenn Sie KI-Training nicht erlauben statt Blockieren verwenden. KI-Training nicht erlauben wurde genau dafür geschaffen, dass rechenschaftspflichtige Crawler mit gemischter Nutzung (Google, Apple und künftig Bing) weiter für die Suche crawlen, während sie das Training überspringen. Ein einfaches Blockieren dagegen blockiert jetzt auch das Suchverhalten genau dieser Crawler, was Ihre Sichtbarkeit in deren Suchprodukten schädigt.
Ich hatte vor dem 15. September bereits „Block AI Bots" aktiviert. Was ist aus meiner Einstellung geworden? Cloudflare hat sie automatisch migriert: Das alte Block AI Bots wurde zu Training = KI-Training nicht erlauben, Suche = Erlauben und Agent = Auf Seiten mit Werbung blockieren. Prüfen Sie mit Schritt 1 oben, ob das tatsächliche Ergebnis wie erwartet ausgefallen ist, statt anzunehmen, dass die Migration Ihrer Absicht entsprach.
Ist davon etwas im Free-Tarif verfügbar? Ja. AI Crawl Control, die Kategorieeinstellungen für Suche/Agenten/Training und Bot Preference Sync funktionieren in allen Tarifen, auch Free. Einige Durchsetzungsdetails hängen vom Tarif ab — die robots.txt-Durchsetzung läuft etwa über die WAF, und die Bot-Erkennung im Free-Tarif stützt sich auf User-Agent-Zeichenketten statt auf die fortgeschrittenere Erkennungs-ID von Bot Management.
Worin unterscheidet sich AI Crawl Control von den KI-Bot-Sicherheitseinstellungen? Die Sicherheitseinstellungen sind der Ort, an dem Sie die Richtlinie festlegen (erlauben / auf Seiten mit Werbung blockieren / blockieren / KI-Training nicht erlauben je Kategorie). AI Crawl Control ist der Ort, an dem Sie prüfen, was tatsächlich passiert — Anfragezahlen je Bot, robots.txt-Verstöße, Details auf Pfadebene — und an dem Sie die erklärte robots.txt-Richtlinie in eine durchgesetzte WAF-Regel umwandeln können.
Muss ich das robots.txt nach dem Einrichten manuell bearbeiten? Nein, wenn Bot Preference Sync aktiv ist: Er schreibt und pflegt den passenden robots.txt-Block aus Ihren Dashboard-Einstellungen. Eine manuelle Bearbeitung ist nur für punktuelle Ausnahmen einzelner Betreiber außerhalb der verwalteten Kategorien nötig.
Autor: Julian Mercer, Technical-SEO-Praktiker mit 14 Jahren Erfahrung bei Auspia. Er schreibt über Crawlbarkeit, strukturierte Daten, Rendering und die technischen Grundlagen, die Inhalte für KI lesbar machen.