Ce que vous obtiendrez à la fin de ce guide
À la fin de ce guide, votre domaine sur Cloudflare disposera d'une politique explicite et délibérée pour les trois catégories distinctes de trafic des robots d'IA — recherche (Search), agents (Agent) et entraînement (Training) — au lieu du réglage par défaut que votre domaine a hérité. Vous saurez exactement quels robots sont autorisés, lesquels sont bloqués et sur quelles pages, avec un robots.txt et une règle d'application en périphérie réellement cohérents entre eux.
À qui cela s'adresse : toute personne qui gère un site derrière Cloudflare — éditeurs, sites marketing de SaaS, boutiques en ligne, blogs — et qui veut décider elle-même si des systèmes d'IA peuvent s'entraîner sur ses contenus, les résumer ou y accéder par des agents, plutôt que d'hériter du réglage choisi par la plateforme.
Ce qu'il vous faut :
- Un domaine proxyfié via Cloudflare (tous les forfaits, y compris le gratuit ; certaines étapes ci-dessous sont réservées aux forfaits payants, ce qui est signalé)
- Un accès au tableau de bord avec au minimum le droit de modifier les réglages de sécurité au niveau du domaine
- 20 à 30 minutes pour auditer et configurer ; ensuite quelques minutes par jour ou par semaine pour surveiller
Définition de « terminé » : vos réglages de sécurité de zone affichent un choix délibéré (et non une valeur par défaut non vérifiée) pour la recherche, les agents et l'entraînement ; le /robots.txt en production reflète ce choix ; et vous avez confirmé dans AI Crawl Control que les robots censés être bloqués le sont réellement.
Pourquoi c'est devenu important d'un coup : ce qui a changé le 15 septembre
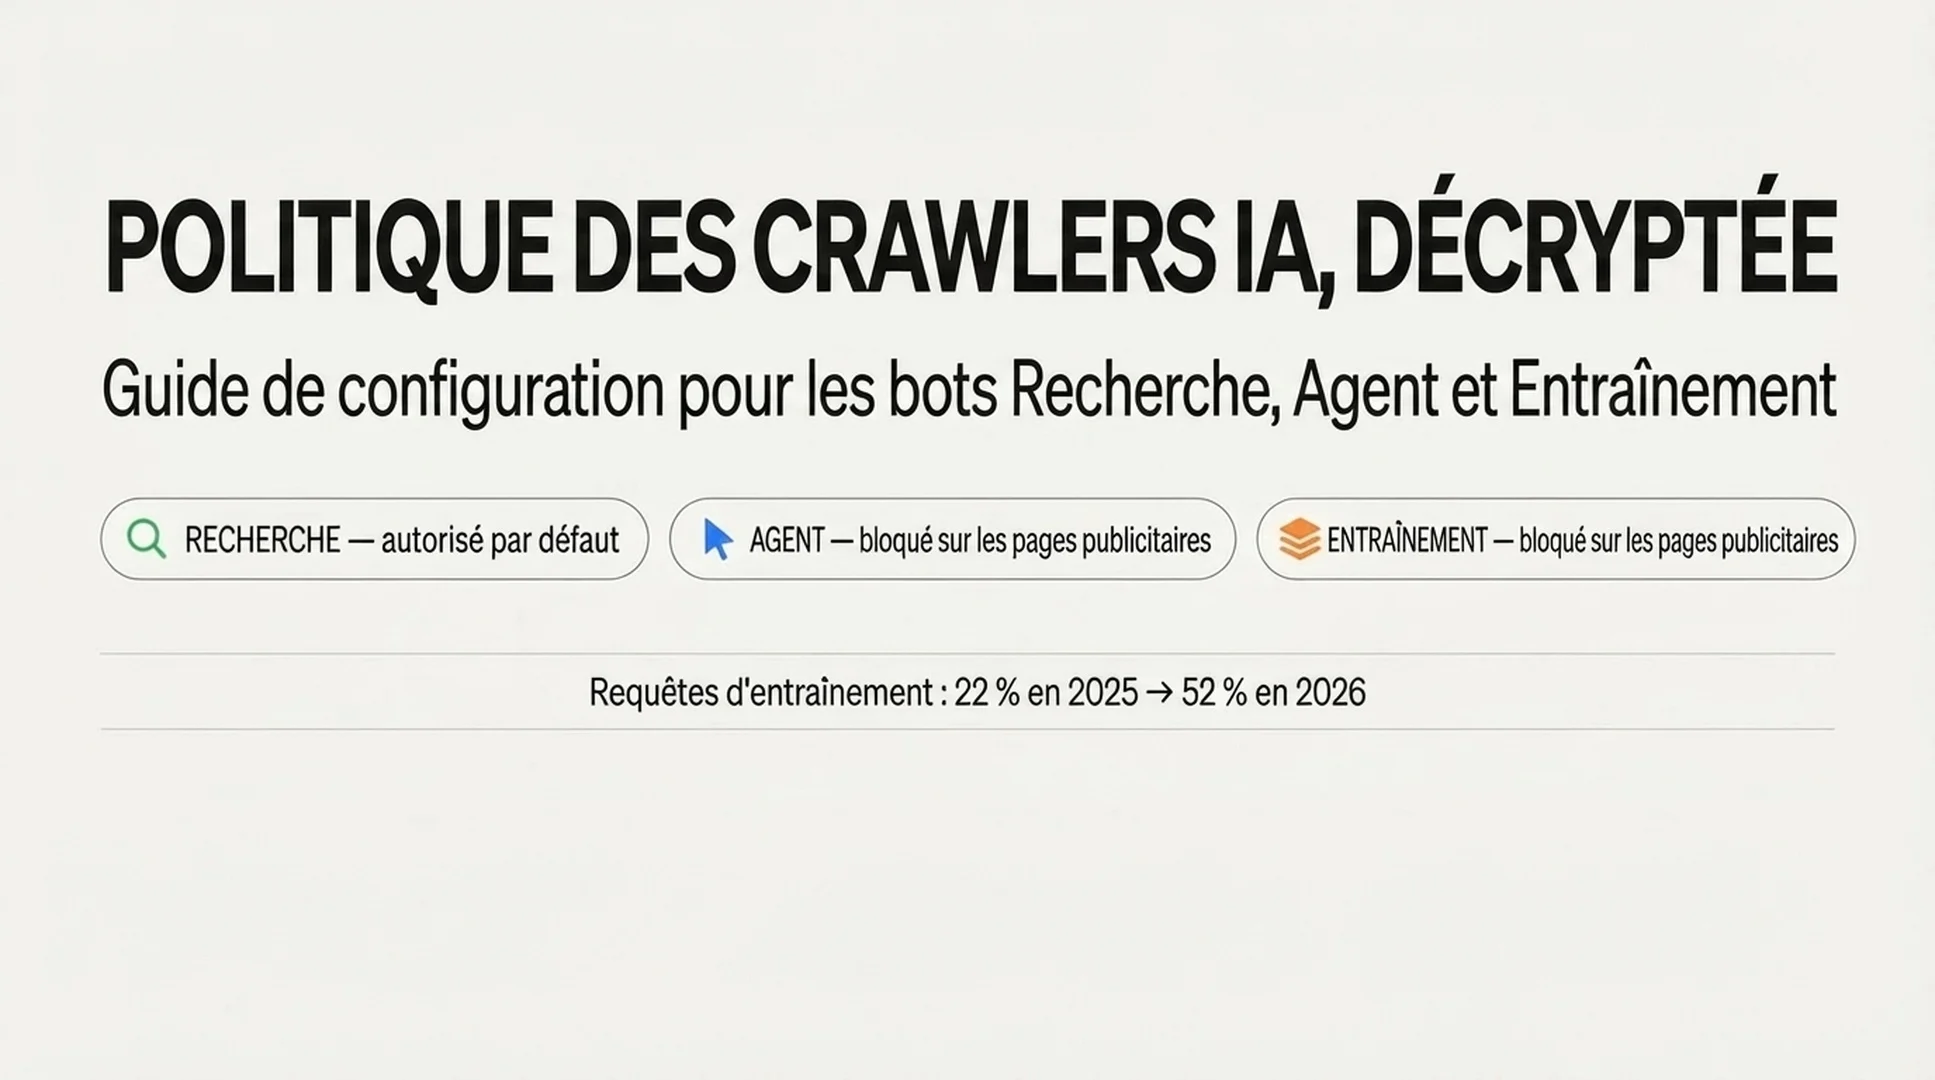
Cloudflare a construit ses contrôles du trafic d'IA par étapes, en commençant par l'ajout de la Content Signals Policy dans le robots.txt en septembre 2025, jusqu'au lancement du « Content Independence Day » le 1er juillet 2026, qui a séparé pour la première fois le comportement des robots d'IA en trois catégories nommées, au lieu d'un unique interrupteur grossier « IA ou pas IA » :
- Recherche (Search) — exploration qui construit un index de recherche, puis renvoie des liens ou de courts extraits. Selon les mots de Cloudflare, c'est le trafic censé vous apporter des références.
- Agent (Agent) — activité automatisée agissant au nom d'une personne en temps réel, comme un assistant de chat qui récupère une page ou un agent navigateur qui accomplit une tâche.
- Entraînement (Training) — exploration pour entraîner ou affiner un modèle, où votre contenu est absorbé définitivement dans les poids du modèle au lieu de vous revenir sous forme de lien.
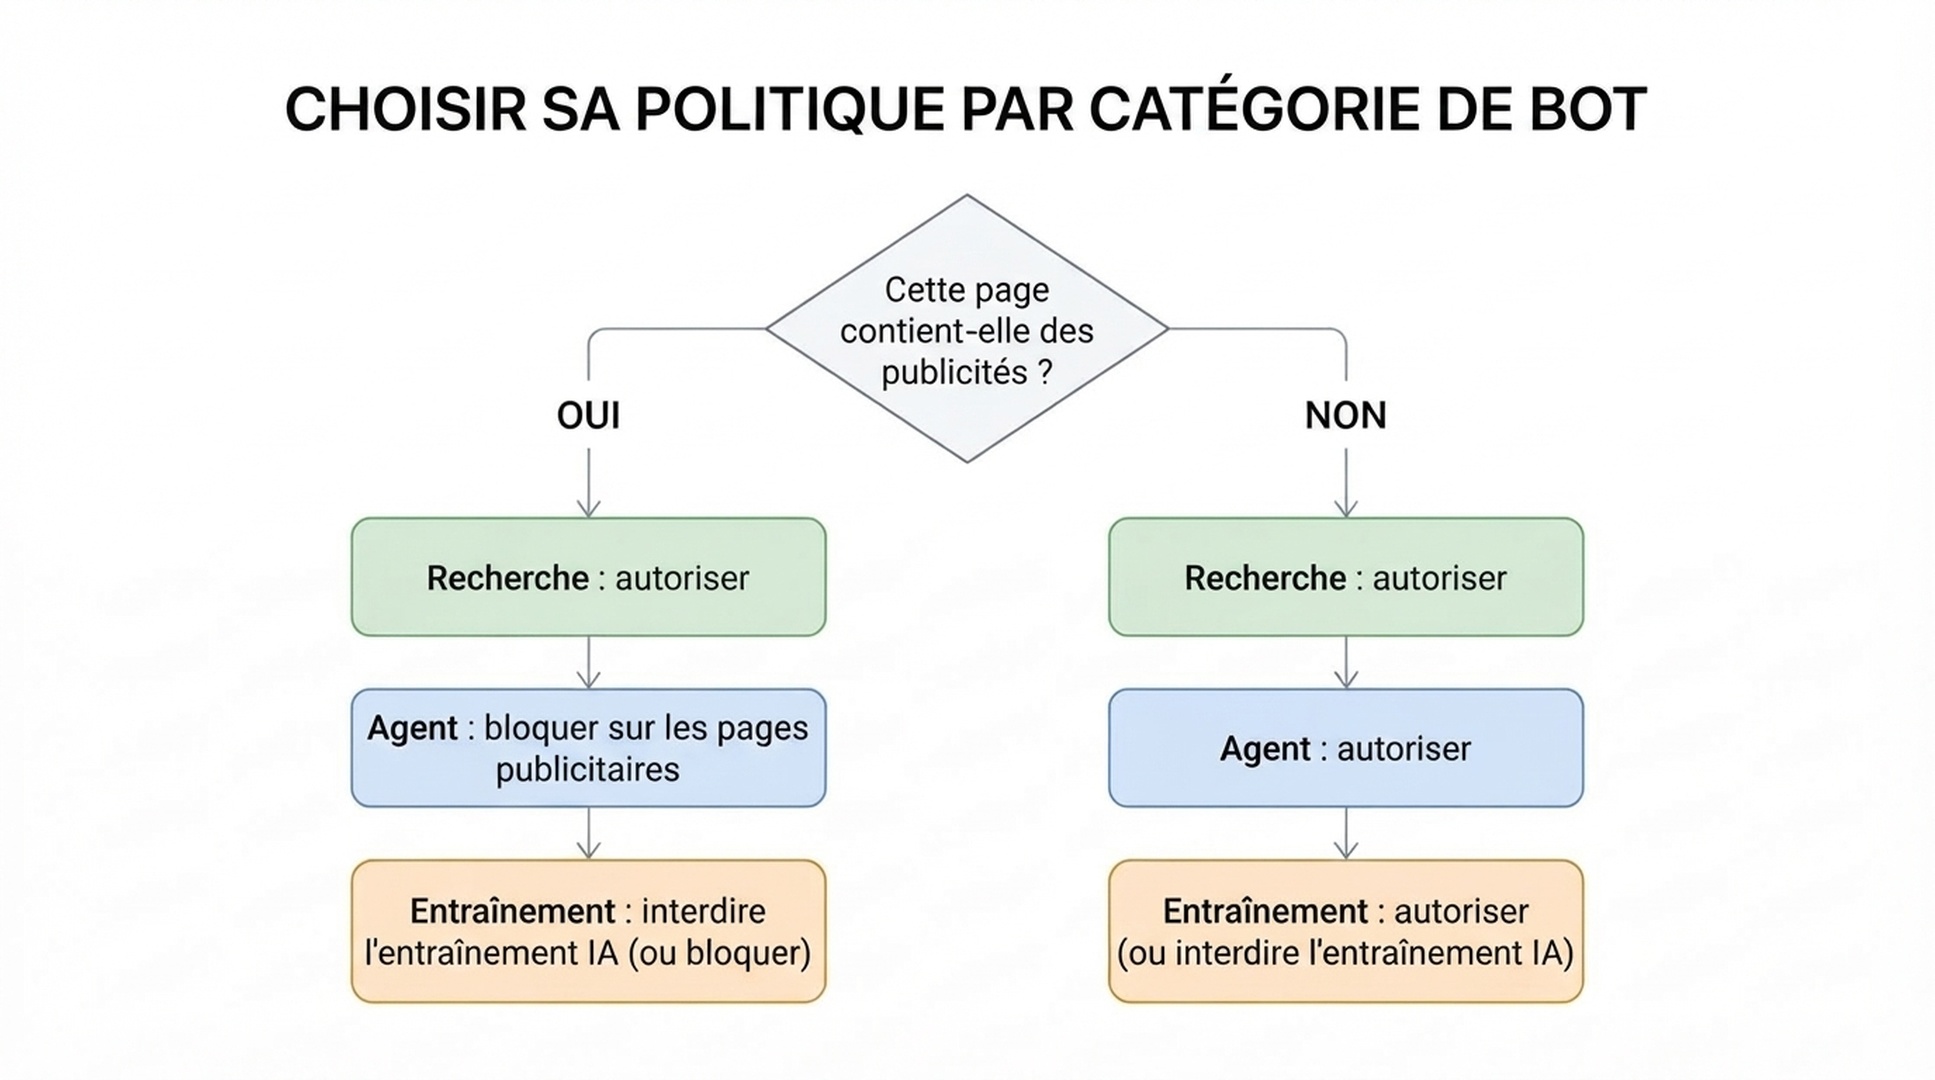
Le 15 septembre 2026, Cloudflare a modifié ce qui se produit automatiquement. Pour tout domaine qui rejoint Cloudflare à cette date ou après, si le site est marqué comme monétisé par la publicité, le réglage par défaut devient :
Catégorie | Défaut sur les pages publicitaires |
|---|---|
Recherche (Search) | Autoriser |
Agent (Agent) | Bloquer sur les pages publicitaires |
Entraînement (Training) | Interdire l'entraînement IA (Disallow AI Training) |
Les nouveaux domaines sans monétisation publicitaire obtiennent « Autoriser » par défaut dans les trois catégories. Les clients existants n'ont pas été basculés en silence — Cloudflare a laissé une fenêtre avant le 15 pour se retirer via le tableau de bord, et les règles de migration réelles par domaine se sont révélées plus nuancées qu'une seule nouvelle valeur par défaut (nous détaillons cela plus bas).
La raison pour laquelle les pages publicitaires reçoivent un défaut plus strict est que la présence de publicité sur la page signale qu'elle était destinée à être vue par un humain. Selon les propres données de Cloudflare, en juin 2026, les robots à usage mixte — ceux qui combinent indexation de recherche, requêtes d'agents et entraînement sous un même user agent — représentaient plus de 36 % du trafic vérifié de robots, la plus grande catégorie isolée. Et la part de l'entraînement IA dans l'ensemble des requêtes de robots sur le réseau Cloudflare est passée d'environ 22 % au printemps 2025 à 52 % en juin 2026. C'est précisément ce trafic que vise ce changement.
Avant de commencer : trois choses à comprendre sur les catégories
1. Certains robots ont un usage mixte et se comportent différemment selon qu'on bloque ou qu'on interdit l'entraînement. Googlebot, Bingbot et Applebot font double emploi — ils explorent à la fois pour la recherche et pour l'entraînement sous le même user agent. Cloudflare qualifie Apple, Google et Microsoft d'opérateurs « Accountable » (responsables) parce qu'ils remplissent quatre conditions : ils respectent la préférence de non-entraînement dans le robots.txt, offrent un moyen de refuser les résumés produits par IA, donnent une visibilité au niveau des URL sur ce qui a servi à l'entraînement, et peuvent démontrer que refuser l'entraînement ne nuit pas à votre présence dans la recherche.
2. « Interdire l'entraînement IA » et « Bloquer » ne sont pas le même réglage, et cette différence est tout l'enjeu. Interdire l'entraînement IA publie dans le robots.txt une préférence Disallow adressée aux user agents propres à l'entraînement (comme Google-Extended et Applebot-Extended). Les robots à usage mixte qui sont responsables lisent cette préférence et continuent volontairement d'explorer pour la recherche en sautant l'entraînement — votre présence dans la recherche est donc préservée. Les autres robots d'entraînement qui n'appartiennent pas à des opérateurs responsables sont bloqués immédiatement en périphérie, et cela n'affecte pas la recherche, car ces opérateurs font tourner des robots d'entraînement distincts. En revanche, le simple Bloquer bloque désormais Googlebot, Bingbot et Applebot eux-mêmes, ce qui signifie que votre contenu disparaît aussi de leurs résultats de recherche. Si vous voulez faire disparaître l'entraînement tout en gardant la recherche, le bon réglage est « Interdire l'entraînement IA », pas « Bloquer ».
3. Bing ne respecte pas encore la préférence d'entraînement du robots.txt. Aujourd'hui, Applebot et Googlebot honorent la directive Disallow propre à l'entraînement. Microsoft indique construire un mécanisme équivalent pour Bingbot, avec un objectif au début de 2027. D'ici là, choisir « Interdire l'entraînement IA » inscrira votre préférence dans le robots.txt, mais le comportement d'exploration de Bing à des fins d'entraînement ne changera pas du seul fait de ce signal — la balise meta NOARCHIVE de Bing ou son outil Content Removal restent les leviers temporaires si votre préoccupation porte précisément sur l'entraînement via Bing.
Étape 1 : Déterminez où votre site a réellement atterri
Ne partez pas du principe que vous connaissez le réglage actuel — vérifiez-le.
Action : dans le tableau de bord Cloudflare, ouvrez votre domaine, allez dans Security → Settings et trouvez les contrôles de politique pour les robots d'IA (l'interface plus récente à trois catégories a remplacé l'ancien interrupteur unique « Block AI Bots », mais les comptes non encore migrés peuvent toujours afficher l'ancien interrupteur). Séparément, récupérez le robots.txt en production dans le navigateur ou avec curl https://yourdomain.com/robots.txt et cherchez un bloc commençant par un commentaire marqueur géré par Cloudflare ; vous pouvez aussi le comparer avec le vérificateur de robots d'IA dans le robots.txt d'Auspia pour voir comment vos règles actuelles sont lues par les robots d'IA.
Résultat attendu : trois réglages, un pour la recherche, un pour les agents et un pour l'entraînement, chacun en Autoriser / Bloquer sur les pages publicitaires / Bloquer (avec « Interdire l'entraînement IA » comme quatrième option, réservée à l'entraînement). Le robots.txt en production devrait montrer une section gérée par Cloudflare listant des user agents précis et des lignes Disallow / Content-Signal, si Bot Preference Sync ou le robots.txt géré sont actifs.
Contrôle qualité : vérifiez que les trois réglages correspondent bien à ce que vous voulez réellement, et non à ce que la migration a supposé pour vous. La logique de migration pour les clients existants documentée par Cloudflare est la suivante : si vous aviez l'ancien interrupteur « Block AI » activé, vous avez été basculé vers entraînement = Interdire l'entraînement IA, recherche maintenue en Autoriser et agent réglé sur Bloquer sur les pages publicitaires. Si vous aviez réglé l'entraînement lui-même sur Bloquer ou Bloquer sur les pages publicitaires, vous avez été basculé vers Interdire l'entraînement IA. Ces deux chemins de migration supposent que vous vouliez conserver la recherche. Si en réalité vous vouliez que les robots à usage mixte disparaissent complètement, recherche incluse, ce n'est pas votre état actuel, et vous devez choisir explicitement Bloquer.
Voie de rétablissement : si les réglages de sécurité n'affichent que l'ancien interrupteur « Block AI Bots » sans la division en trois catégories, votre compte n'a pas encore migré vers les nouveaux contrôles. Cherchez « Configure AI bot policies », une surface de réglages distincte et plus récente ; c'est là que vivent les contrôles détaillés aux côtés de l'ancien interrupteur pendant la transition, et c'est là que se situe l'avenir.
Étape 2 : Décidez la politique catégorie par catégorie, pas par une réponse globale unique
C'est l'étape de décision proprement dite. Parcourez chaque catégorie séparément.
Recherche. Presque personne ne la bloque — Cloudflare indique que moins de 1 % des sites choisissent de bloquer les robots de recherche — car perdre sa visibilité dans la recherche n'en vaut presque jamais le prix. Réglez Autoriser par défaut, sauf si vous avez une raison précise (un environnement de test, une archive derrière un paywall) de tenir le site hors des index de recherche.
Agents. Ce sont des robots qui agissent en temps réel pour quelqu'un qui essaie de faire quelque chose sur votre site à l'instant même : vérifier un prix, finaliser une réservation, extraire un fait pour une réponse de chat. Bloquer le trafic d'agents sur les pages monétisées ou publicitaires est la raison derrière le nouveau défaut, car une visite d'agent ne génère pas l'impression publicitaire qu'une visite humaine générerait. Si votre modèle économique dépend de cette attention humaine (médias, sites de contenu avec display ads), Bloquer sur les pages publicitaires est une position défendable. Si vous préférez que les agents puissent accomplir des tâches sur votre site même sur les pages publicitaires — par exemple parce que le trafic d'agents vous convertit quand même — choisissez Autoriser.
Entraînement. C'est ici que se joue la vraie décision, et c'est là que la terminologie prête à confusion :
- Choisissez Interdire l'entraînement IA si vous voulez empêcher que votre contenu serve à entraîner des modèles tout en conservant votre présence dans les produits de recherche de Google, Bing et Apple (compte tenu du retard actuel de Bing, comprenez « vaut aujourd'hui pour Google et Apple, en attente pour Bing »). C'est le juste milieu recommandé par Cloudflare, conçu précisément pour l'arbitrage entre recherche et entraînement.
- Choisissez Bloquer uniquement si vous acceptez de perdre entièrement l'exploration pour la recherche de Googlebot, Bingbot et Applebot, en échange du blocage de leur comportement en mode entraînement. C'est désormais l'option stricte : depuis le 15 septembre, le blocage s'applique aussi aux robots à usage mixte, ce qui n'était pas le cas auparavant.
- Choisissez Autoriser uniquement si vous acceptez délibérément que votre contenu entraîne des modèles d'IA, par exemple parce que vous voulez maximiser la visibilité dans les réponses d'IA et considérez l'entraînement comme un prix acceptable.
Action : dans Security → Settings → Configure AI bot policies, réglez les trois menus selon votre décision.
Résultat attendu : le tableau de bord devrait refléter votre choix explicite dans chaque catégorie et (si Bot Preference Sync est activé) commencer à publier automatiquement le bloc robots.txt correspondant — sans édition manuelle de fichier.
Contrôle qualité : relisez votre décision sur l'entraînement avec une seule question : « Est-ce que je veux conserver ma visibilité dans la recherche, oui ou non ? » Si oui, c'est Interdire l'entraînement IA, et non Bloquer, aussi tentant que le terme « Bloquer » paraisse pour arrêter l'entraînement IA.
Voie de rétablissement : si le trafic de recherche a chuté après avoir choisi un réglage, vérifiez si vous avez sélectionné Bloquer au lieu d'Interdire l'entraînement IA. C'est l'erreur autodestructrice la plus courante ici : le nom fait paraître « Bloquer » comme l'option qui « en fait plus », mais pour l'entraînement, elle fait ce que vous ne voulez peut-être pas — elle emporte la recherche avec elle.
Étape 3 : Activez Bot Preference Sync pour que le robots.txt suive vos réglages
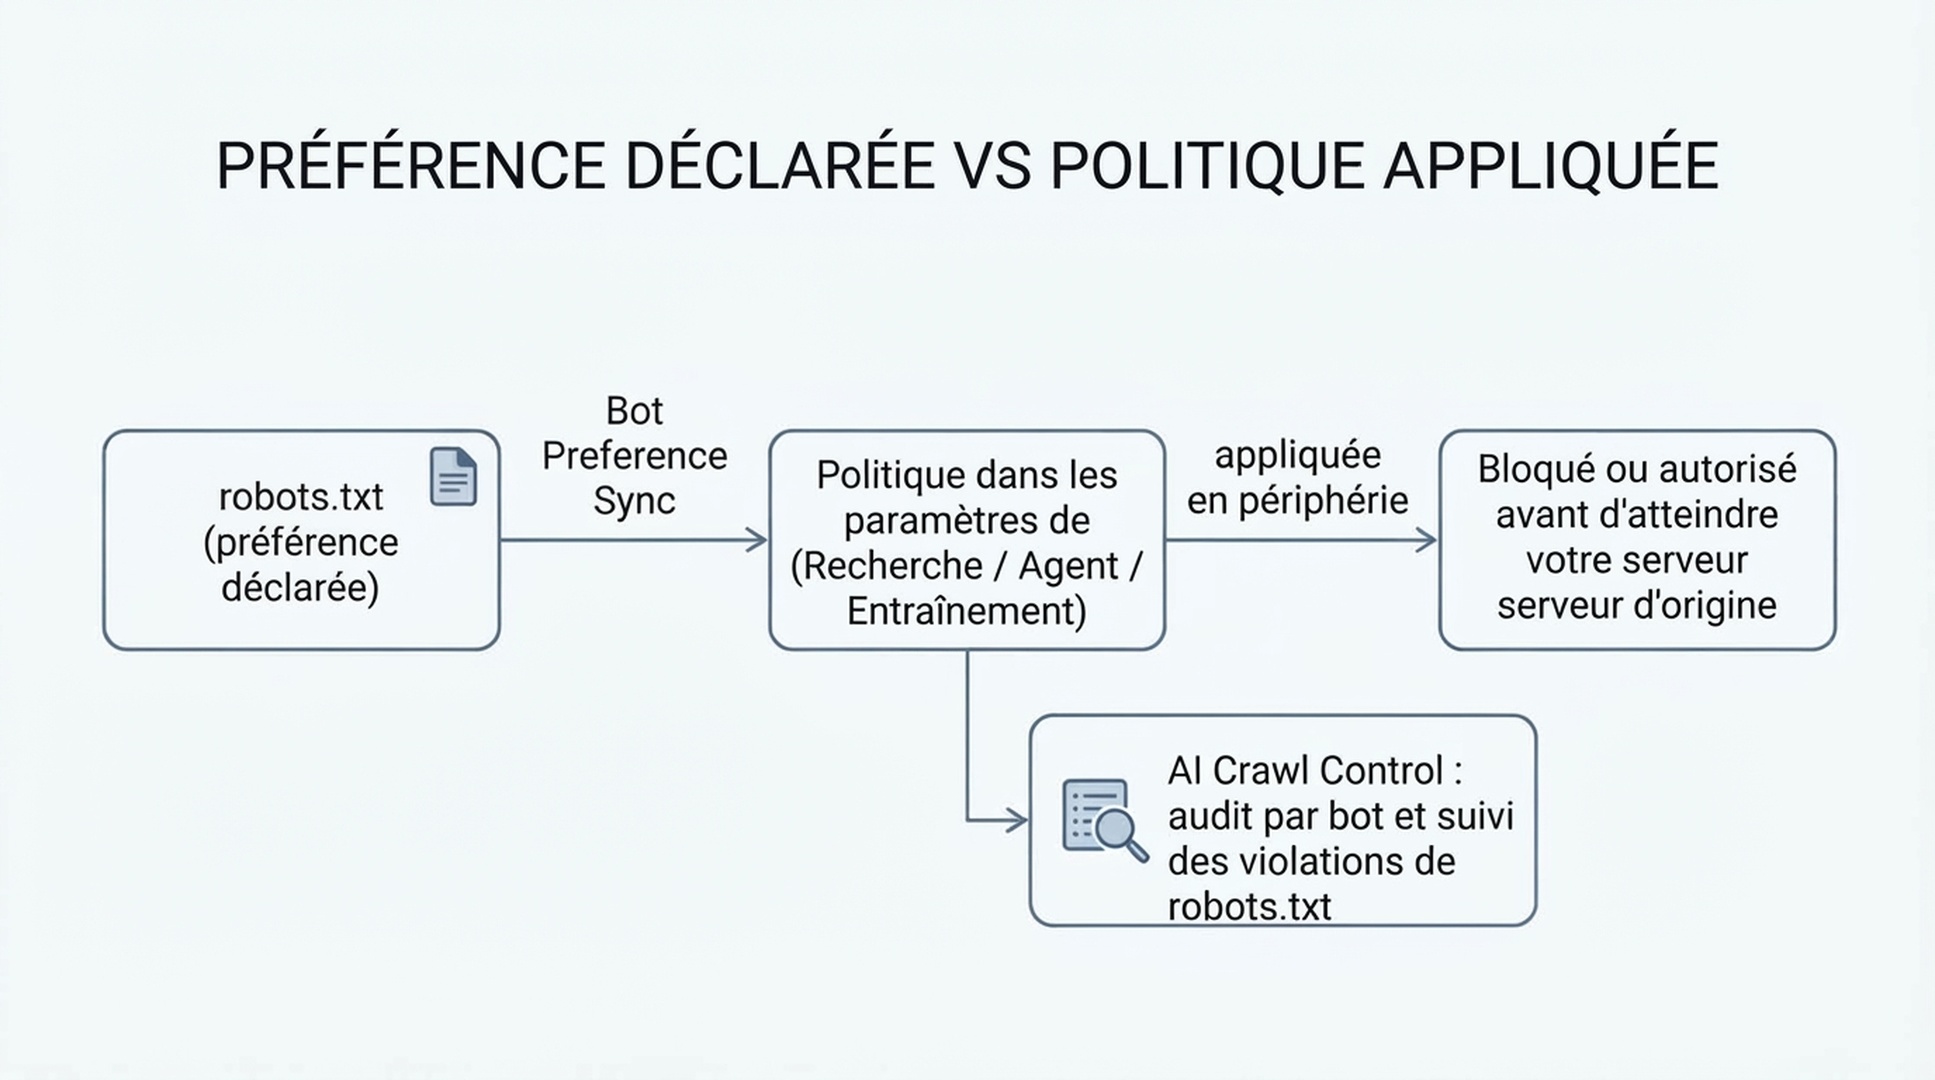
Le réglage dans le tableau de bord et le fichier robots.txt sont deux systèmes distincts, et lorsqu'ils divergent, certains robots utilisent cet écart comme prétexte pour ignorer votre préférence. Bot Preference Sync de Cloudflare comble cet écart en générant votre robots.txt directement à partir des réglages de sécurité choisis.
Action : dans la même zone de réglages de politique pour les robots d'IA, activez Bot Preference Sync (activé par défaut pour les nouveaux clients ; les clients existants qui utilisent l'ancienne fonctionnalité de robots.txt géré seront invités à le vérifier et à le confirmer lors de la migration).
Résultat attendu : Cloudflare ajoute en tête de votre robots.txt un bloc géré, encadré par les commentaires # BEGIN Cloudflare Bot Preference Sync / # END, listant les user agents concernés et leurs règles Disallow — et ne supprime aucune de vos propres règles déjà présentes dans le robots.txt, qui restent sous le bloc géré.
Contrôle qualité : récupérez /robots.txt à nouveau après l'activation et vérifiez que le bloc géré apparaît et correspond aux choix de l'étape 2. Par exemple, si vous avez réglé l'entraînement sur Interdire l'entraînement IA, vous devriez voir les user agents propres à l'entraînement (Google-Extended, Applebot-Extended) avec des règles Disallow, tandis que les user agents génériques Googlebot / Applebot / Bingbot restent non bloqués pour la recherche.
Voie de rétablissement : si vous avez un accord ponctuel avec un opérateur de robots précis qu'une politique au niveau de la catégorie casserait (par exemple un contrat de licence de contenu payant), désactivez Bot Preference Sync et modifiez votre propre robots.txt à la main : les interrupteurs de catégorie sont faits pour une politique à l'échelle de la zone, pas pour des exceptions par opérateur.
Étape 4 : Confirmez que la politique est réellement appliquée, et pas seulement demandée
Le robots.txt est une demande sur le plan technique : il n'arrête pas un robot qui l'ignore. C'est l'étape que les gens sautent, et c'est celle qui montre si votre décision de l'étape 2 est réelle ou seulement théorique.
Action : ouvrez AI Crawl Control pour votre zone (disponible sur tous les forfaits, y compris le gratuit — la qualité de détection est meilleure sur les forfaits avec Bot Management, mais les fonctions de visibilité marchent partout). Regardez l'onglet Crawlers, qui liste tous les robots ayant atteint votre site, avec une colonne Robots.txt violations.
Résultat attendu : un tableau avec le nombre de requêtes et le nombre de violations par robot. Un nombre de violations non nul pour un robot que vous avez réglé sur non autorisé ou bloqué signifie que ce robot ignore votre robots.txt en ce moment.
Contrôle qualité : pour tout robot présentant des violations, regardez « Most popular paths » (en filtrant sur les chemins signalés) pour voir ce qu'il demande réellement, afin de décider s'il atteint du contenu que vous tenez vraiment à protéger.
Voie de rétablissement : si un robot ignore votre préférence déclarée, le robots.txt seul ne l'arrêtera pas. Utilisez l'action « Enforce robots.txt rules » dans AI Crawl Control (parfois appelée par son nom interne Robotcop) pour transformer vos règles déclarées en une véritable règle WAF qui bloque le robot récalcitrant en périphérie de Cloudflare avant qu'il n'atteigne votre serveur d'origine — vous passez de « demander la conformité » à « l'imposer ». Cette étape utilise le WAF, sa disponibilité dépend donc de l'accès WAF de votre forfait.
Étape 5 : Décidez entre bloquer simplement ou facturer l'accès
Si votre décision sur l'entraînement était « pas d'accès pour l'entraînement », vous avez une seconde option en plus du blocage pur : facturer.
Action : si cela vous intéresse, candidatez à la bêta fermée Pay Per Crawl de Cloudflare (via la page d'inscription Cloudflare ou votre chargé de compte si vous êtes client Enterprise). Une fois activé au niveau du compte (Manage Account → Settings → Pay Per Crawl → réglez le Visibility de votre domaine sur Visible), vous pouvez fixer un prix fixe unique par requête pour la zone et choisir, robot par robot, entre autoriser (gratuit), facturer (à votre prix) ou bloquer.
Résultat attendu : lorsqu'un robot authentifié via Web Bot Auth (une requête signée Ed25519 identifiant le robot) demande une page que vous avez marquée comme payante, il reçoit un HTTP 402 Payment Required avec l'en-tête crawler-price ; s'il réessaie en acceptant de payer, ou s'il inclut d'emblée un en-tête crawler-max-price couvrant votre prix, il reçoit le contenu avec l'en-tête crawler-charged confirmant le montant facturé. Cloudflare agit comme merchant of record et assure le règlement.
Contrôle qualité : cela ne fonctionne que face aux robots ayant enregistré des informations de paiement auprès de Cloudflare et prenant en charge le flux 402 ; ce n'est pas un interrupteur universel contre tous les robots. Pour tout le reste, votre réglage de facturation agit en pratique comme un blocage — Cloudflare note qu'il sert malgré tout de signal indiquant que vous êtes ouvert à une relation payante à l'avenir.
Voie de rétablissement : la fonctionnalité est en bêta fermée ; si vous n'êtes pas accepté ou ne voulez pas attendre, Interdire l'entraînement IA ou Bloquer restent disponibles aujourd'hui pour ces mêmes robots.
Gérer l'exception : quand un opérateur d'IA précis demande l'accès
Vous pouvez recevoir une sollicitation — un partenariat, un accord de citation, une discussion de licence — de la part d'une entreprise d'IA souhaitant un accès explicite en dehors de la politique de toute la zone.
Il existe deux façons d'accorder une exception étroite sans rouvrir toute la catégorie :
- Remplacer robot par robot dans Manage AI crawlers : faites passer la ligne de ce robot de bloquer/facturer à autoriser, indépendamment de votre réglage d'entraînement ou d'agents au niveau de la catégorie.
- Modifier le robots.txt à la main : si vous avez désactivé Bot Preference Sync (ou placez l'exception hors du bloc géré), vous pouvez ajouter un Allow ciblé pour ce seul user agent sous la section gérée par Cloudflare.
Dans les deux cas, gardez la politique de catégorie de la zone comme valeur par défaut et traitez les exceptions nommées comme des décisions délibérées et documentées — et non l'inverse.
Vérifiez le résultat
Parcourez cette liste une fois la configuration en place :
- [ ] Les réglages de sécurité affichent des valeurs explicites et délibérées pour la recherche, les agents et l'entraînement — pas des valeurs par défaut non vérifiées
- [ ] Le
/robots.txten production montre un bloc géré par Cloudflare correspondant à ces réglages - [ ] L'onglet Crawlers d'AI Crawl Control montre les robots attendus, avec zéro ou presque zéro violation pour tout ce que vous avez réglé sur bloqué/non autorisé
- [ ] Si vous avez choisi Interdire l'entraînement IA, vous avez confirmé (via Search Console / Bing Webmaster Tools, ou simplement en observant le trafic organique) que l'exploration pour la recherche de Googlebot / Applebot se poursuit normalement
- [ ] Si vous avez activé l'application du robots.txt (Robotcop), la règle WAF résultante est déployée et active, et pas seulement créée puis laissée en brouillon
- [ ] Vous avez documenté quel réglage vous avez choisi et pourquoi, afin qu'une revue future ne reparte pas de zéro
Maintenez le résultat dans le temps
Ce n'est pas une configuration à régler et oublier. Revenez-y à un rythme léger :
- Chaque mois : consultez l'onglet Metrics d'AI Crawl Control pour repérer les nouveaux robots pour lesquels vous n'avez pas encore défini de politique, et revérifiez les compteurs de violations.
- Quand Bing déploiera la prise en charge de la préférence d'entraînement pour Bingbot (Microsoft vise le début de 2027) : réévaluez si votre configuration actuelle produit toujours le résultat voulu — conserver la recherche et bloquer l'entraînement — car c'est le moment où Bing rattrape le comportement actuel de Google et Apple.
- Chaque fois que votre statut de monétisation publicitaire change : ajouter ou retirer des display ads change la voie par défaut dans laquelle tombent vos pages, et il vaut la peine de revérifier que vos réglages explicites restent pertinents dans ce contexte.
Questions fréquentes
Bloquer les robots d'entraînement nuira-t-il à mon référencement SEO ? Non, si vous utilisez Interdire l'entraînement IA plutôt que Bloquer. Interdire l'entraînement IA a été conçu précisément pour que les robots à usage mixte responsables (Google, Apple et, à terme, Bing) continuent d'explorer pour la recherche tout en sautant l'entraînement. En revanche, le simple Bloquer bloque désormais aussi le comportement de recherche de ces mêmes robots, ce qui nuira à votre visibilité dans leurs produits de recherche.
J'avais déjà « Block AI Bots » activé avant le 15 septembre. Qu'est-il arrivé à mon réglage ? Cloudflare l'a migré automatiquement : l'ancien Block AI Bots est devenu entraînement = Interdire l'entraînement IA, recherche = Autoriser et agent = Bloquer sur les pages publicitaires. Vérifiez avec l'étape 1 ci-dessus que le résultat réel correspond bien à vos attentes, plutôt que de supposer que la migration a coïncidé avec votre intention.
Certaines de ces fonctions sont-elles disponibles sur le forfait gratuit ? Oui. AI Crawl Control, les réglages de catégorie recherche/agents/entraînement et Bot Preference Sync fonctionnent sur tous les forfaits, y compris le gratuit. Certains détails d'application varient selon le forfait — par exemple, l'application du robots.txt passe par le WAF, et la détection des robots sur le forfait gratuit s'appuie sur les chaînes de user agent plutôt que sur l'identifiant de détection plus avancé de Bot Management.
Quelle est la différence entre AI Crawl Control et les réglages de sécurité des robots d'IA ? Les réglages de sécurité sont l'endroit où vous définissez la politique (autoriser / bloquer sur les pages publicitaires / bloquer / interdire l'entraînement IA par catégorie). AI Crawl Control est l'endroit où vous auditez ce qui se passe réellement — nombre de requêtes par robot, violations de robots.txt, détail par chemin — et où vous pouvez convertir la politique déclarée dans le robots.txt en règle WAF appliquée.
Dois-je modifier le robots.txt à la main après avoir réglé tout cela ? Non, si Bot Preference Sync est actif : il écrit et maintient le bloc robots.txt approprié à partir de vos réglages dans le tableau de bord. Une modification manuelle n'est nécessaire que pour des exceptions ponctuelles concernant un opérateur précis, en dehors des catégories gérées.
Auteur : Julian Mercer, praticien du SEO technique avec 14 ans d'expérience chez Auspia. Il écrit sur l'explorabilité, les données structurées, le rendu et les fondations techniques qui rendent un contenu lisible par l'IA.