Bu rehberi bitirdiğinizde elinizde ne olacak
Bu rehberi tamamladığınızda Cloudflare bölgeniz, alan adınızın devraldığı varsayılan ayar yerine, yapay zekâ bot trafiğinin üç ayrı kategorisi — arama (Search), ajan (Agent) ve eğitim (Training) — için açık ve bilinçli olarak belirlenmiş bir politikaya sahip olacak. Hangi tarayıcıların izinli, hangilerinin engelli olduğunu ve bunun hangi sayfalarda geçerli olduğunu tam olarak bileceksiniz; robots.txt dosyanız ile edge üzerindeki uygulama kuralı da gerçekten birbiriyle tutarlı olacak.
Kimler için: Cloudflare arkasında site işleten herkes — yayıncılar, SaaS pazarlama siteleri, e-ticaret mağazaları, bloglar — yapay zekâ sistemlerinin içeriğiniz üzerinde eğitilip eğitilemeyeceğine, onu özetleyip özetleyemeyeceğine veya ajanlar aracılığıyla erişip erişemeyeceğine platformun seçtiği ayarı devralmak yerine kendisi karar vermek isteyenler.
İhtiyacınız olanlar:
- Cloudflare üzerinden proxy'lenen bir alan adı (ücretsiz dahil her plan; aşağıdaki bazı adımlar yalnızca ücretli planlarda geçerlidir ve bu belirtilmiştir)
- Panele en az alan adı düzeyinde güvenlik ayarlarını değiştirme izniyle erişim
- Denetleme ve yapılandırma için 20-30 dakika; sonrasında izleme için günde veya haftada birkaç dakika
Tamamlanma tanımı: bölgenizin güvenlik ayarları arama, ajanlar ve eğitim için bilinçli olarak yapılmış bir seçimi (gözden geçirilmemiş bir varsayılanı değil) gösteriyor; canlı /robots.txt bu seçimi yansıtıyor; ve AI Crawl Control'de engellenmesi gereken botların gerçekten engellendiğini doğruladınız.
Bu neden birden önemli hâle geldi: 15 Eylül'de ne değişti
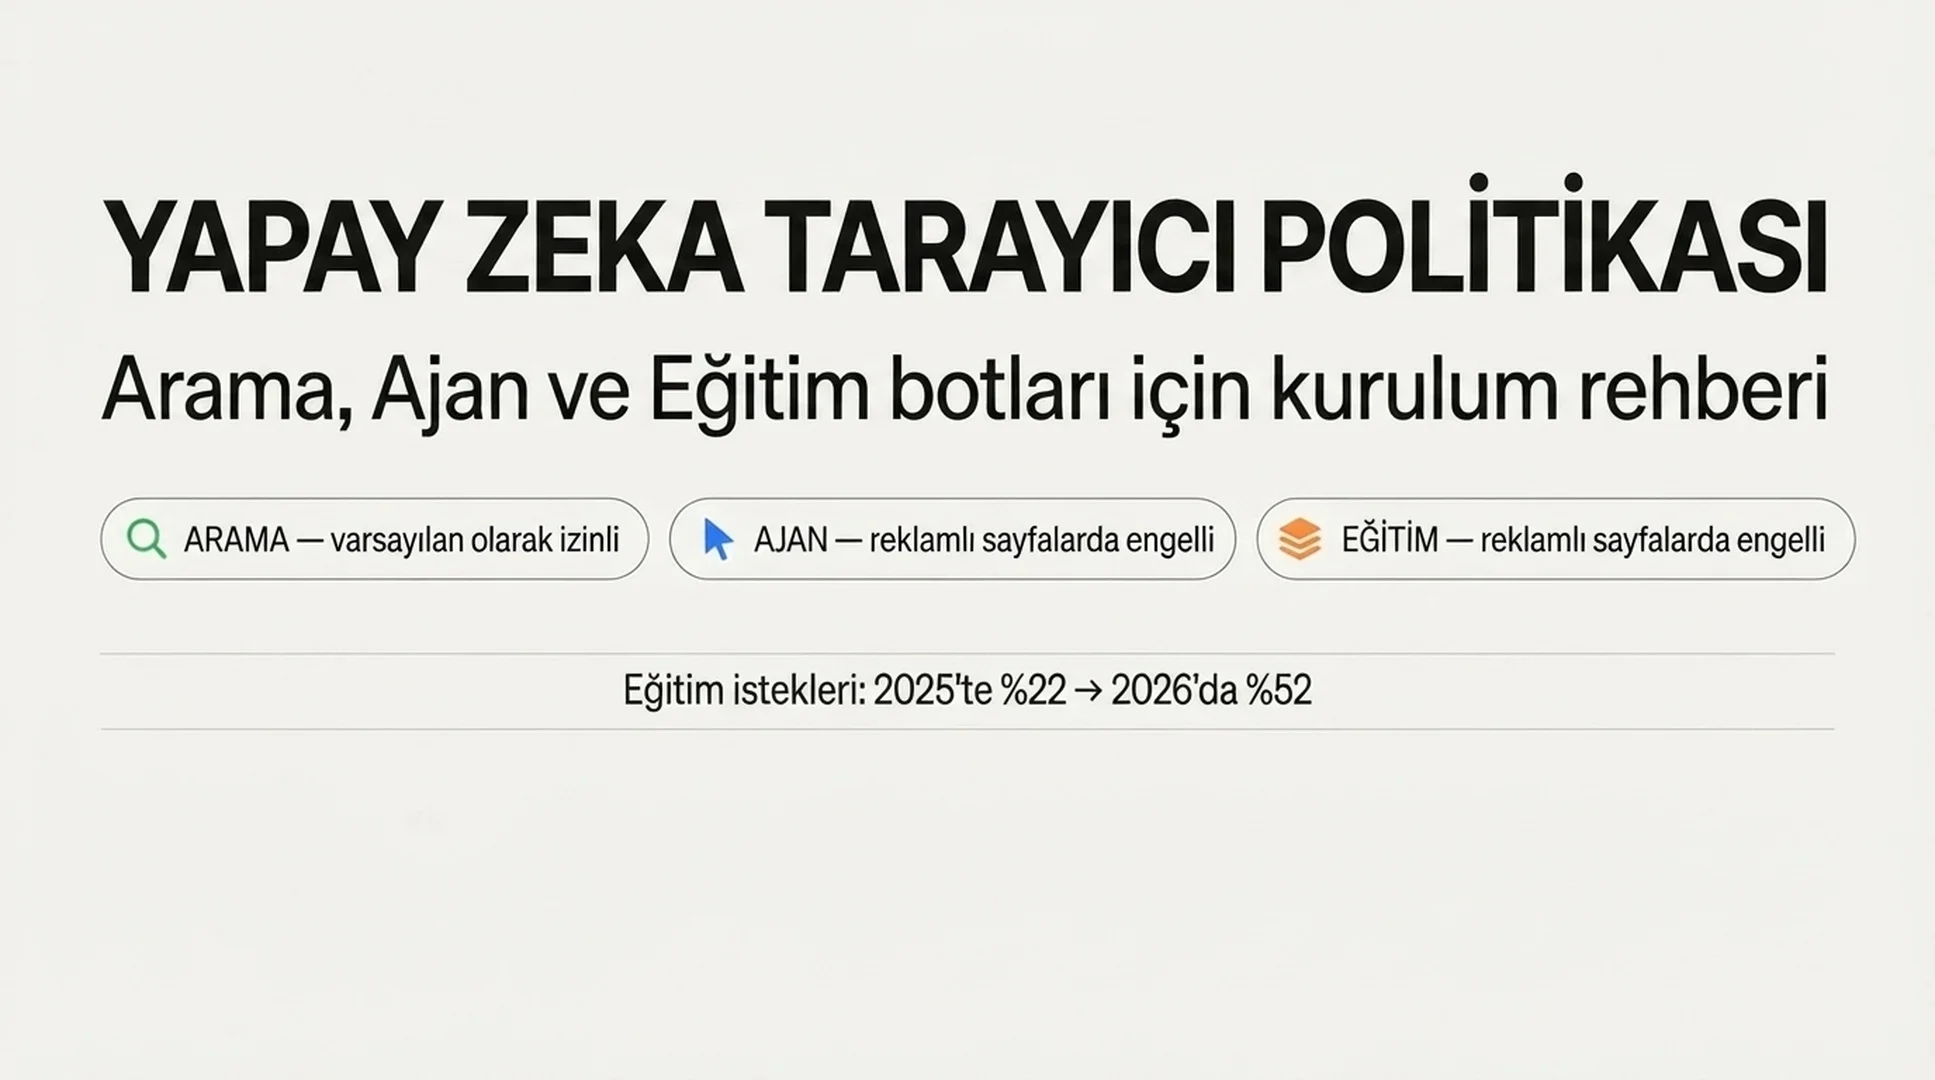
Cloudflare yapay zekâ trafiği kontrollerini aşamalı olarak kurdu: Eylül 2025'te robots.txt dosyasına Content Signals Policy eklenmesiyle başladı ve 1 Temmuz 2026'da "Content Independence Day" lansmanına ulaştı. O lansman, yapay zekâ bot davranışını ilk kez kaba bir "yapay zekâ mı, değil mi" anahtarı yerine üç adlandırılmış kategoriye ayırdı:
- Arama (Search) — bir arama dizini oluşturan ve sonrasında bağlantı ya da kısa alıntı döndüren tarama. Cloudflare'in kendi ifadesiyle, size yönlendirme getirmesi beklenen trafik budur.
- Ajan (Agent) — bir kişi adına gerçek zamanlı hareket eden otomatik etkinlik; örneğin bir sohbet asistanının sayfayı çekmesi ya da bir tarayıcı ajanının görevi tamamlaması.
- Eğitim (Training) — bir modeli eğitmek veya ince ayar yapmak için tarama; içeriğiniz size bağlantı olarak geri dönmek yerine kalıcı olarak model ağırlıklarına emilir.
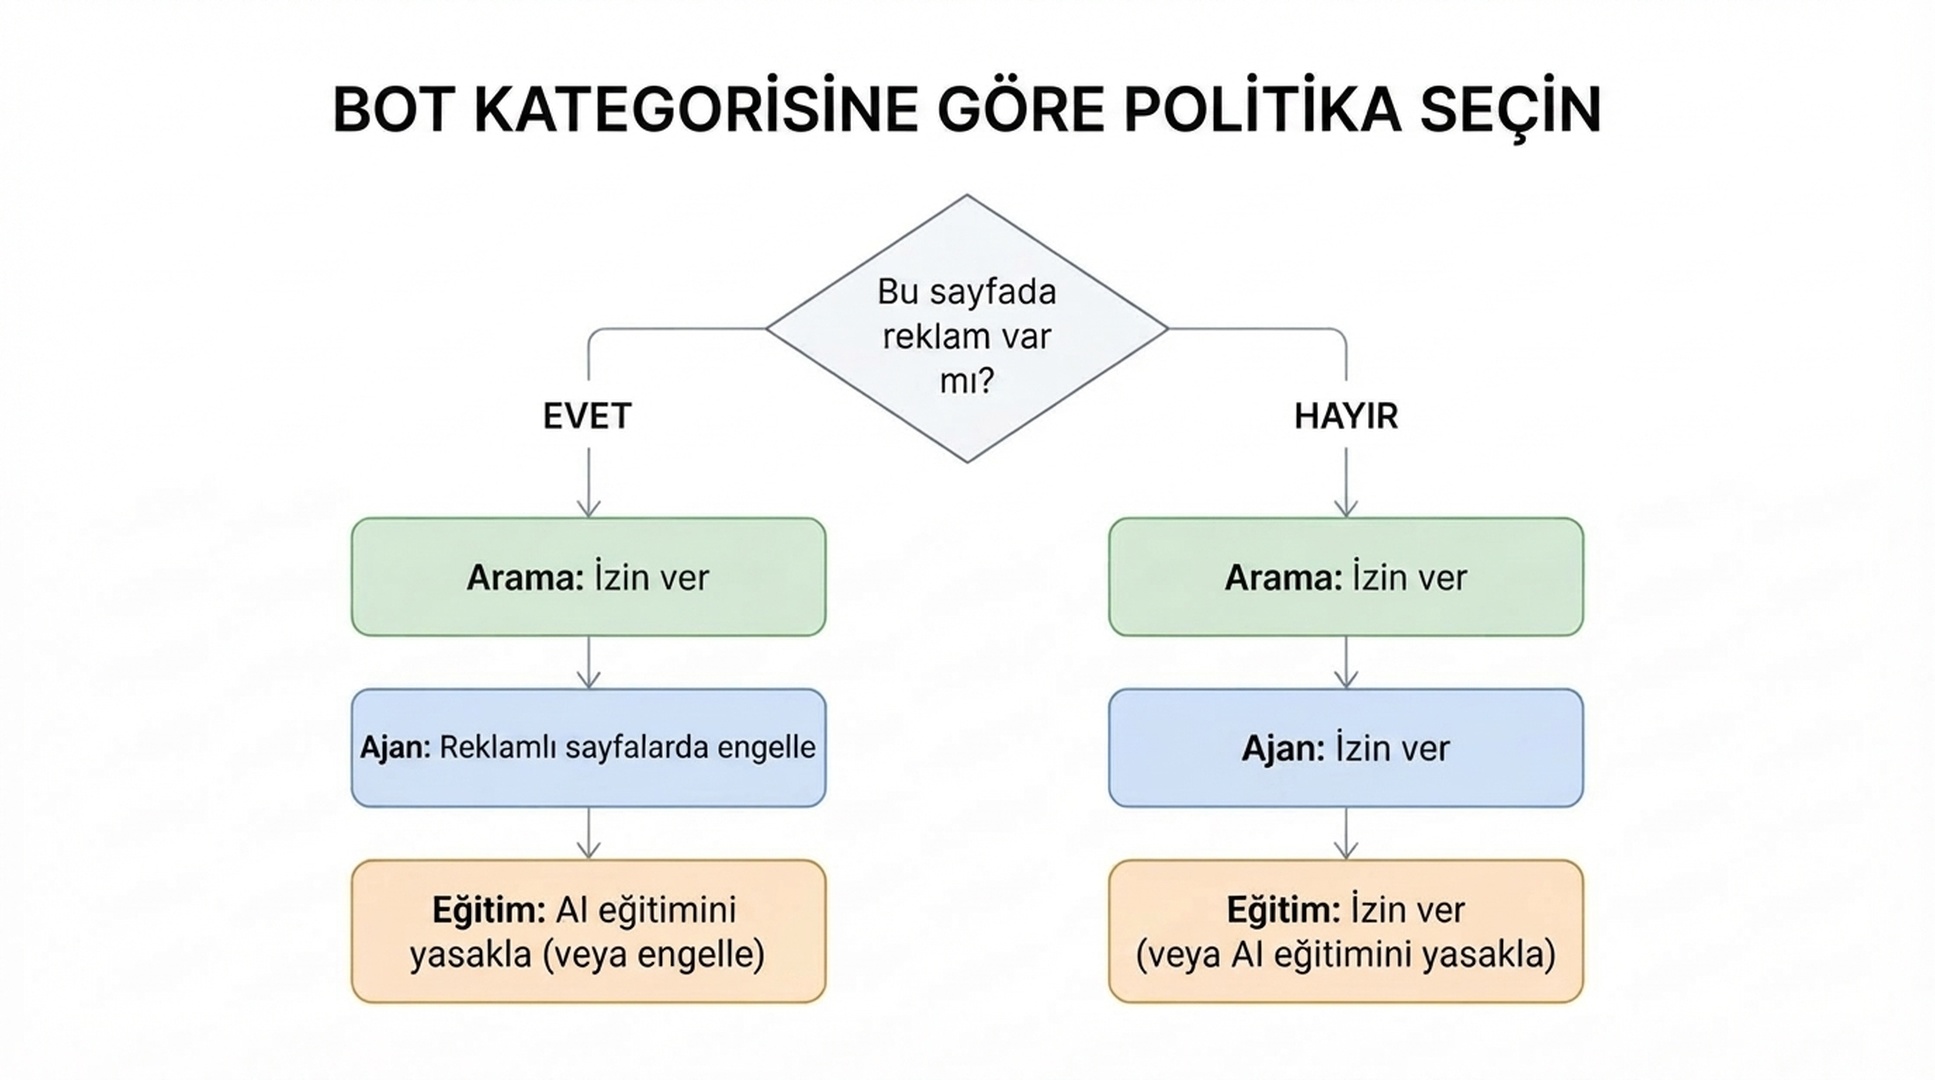
15 Eylül 2026'da Cloudflare otomatik olarak ne olduğunu değiştirdi. O tarihte veya sonrasında Cloudflare'e katılan her alan adı için, site reklamla para kazanıyor olarak işaretlenmişse varsayılan şu hâle gelir:
Kategori | Reklamlı sayfalardaki varsayılan |
|---|---|
Arama (Search) | İzin ver |
Ajan (Agent) | Reklamlı sayfalarda engelle |
Eğitim (Training) | Yapay zekâ eğitimine izin verme (Disallow AI Training) |
Reklamla para kazanmayan yeni alan adları üç kategoride de varsayılan olarak İzin ver alır. Mevcut müşteriler sessizce geçirilmedi — Cloudflare 15'inden önce panelden vazgeçmek için bir pencere tanıdı ve alan adı bazında gerçek geçiş kuralları tek bir yeni varsayılandan daha ayrıntılı çıktı (aşağıda açıklıyoruz).
Reklamlı sayfaların daha katı bir varsayılan almasının nedeni, sayfada reklam bulunmasının o sayfanın bir insan tarafından görülmek üzere tasarlandığının işareti olmasıdır. Cloudflare'in kendi verilerine göre Haziran 2026'da, arama dizinlemeyi, ajan isteklerini ve eğitimi tek bir user agent altında birleştiren karma kullanımlı tarayıcılar, doğrulanmış tarayıcı trafiğinin %36'sından fazlasını oluşturuyordu; en büyük tek kategori. Cloudflare ağındaki tüm tarayıcı istekleri içinde yapay zekâ eğitiminin payı da 2025 baharındaki yaklaşık %22'den Haziran 2026'da %52'ye çıktı. Bu değişiklik tam olarak bu trafiği hedefliyor.
Başlamadan önce: kategorilerle ilgili anlaşılması gereken üç şey
1. Bazı tarayıcılar karma kullanımlıdır ve engellenme ile eğitim yasağı altında farklı davranır. Googlebot, Bingbot ve Applebot çift iş yapar — aynı user agent altında hem arama hem eğitim için tararlar. Cloudflare, Apple, Google ve Microsoft'u "Accountable" (hesap verebilir) operatörler olarak adlandırır çünkü dört koşulu karşılarlar: robots.txt'teki eğitmeme tercihine saygı gösterirler, yapay zekâ özetlerini reddetme yolu sunarlar, eğitim için neyin kullanıldığına dair URL düzeyinde görünürlük sağlarlar ve eğitimi reddetmenin arama görünürlüğünüze zarar vermediğini kanıtlayabilirler.
2. "Yapay zekâ eğitimine izin verme" ile "Engelle" aynı ayar değildir ve bütün mesele bu farktır. Yapay zekâ eğitimine izin verme, robots.txt'te eğitime özel user agent'lara (örneğin Google-Extended ve Applebot-Extended) yönelik bir Disallow tercihi yayımlar. Hesap verebilir karma kullanımlı tarayıcılar bu tercihi okur ve eğitimi atlayarak arama için taramaya gönüllü olarak devam eder — böylece arama görünürlüğünüz korunur. Hesap verebilir operatörlere ait olmayan diğer eğitim tarayıcıları edge'de anında engellenir ve bu aramayı etkilemez, çünkü o operatörler ayrı eğitim botları çalıştırır. Buna karşılık düz Engelle artık Googlebot, Bingbot ve Applebot'u da engeller; yani içeriğiniz onların arama sonuçlarından da kaybolur. Eğitim ortadan kalksın ama arama kalsın istiyorsanız doğru ayar "Yapay zekâ eğitimine izin verme"dir, "Engelle" değil.
3. Bing, robots.txt'teki eğitim tercihine henüz uymuyor. Bugün hem Applebot hem de Googlebot eğitime özel Disallow direktifine uyuyor. Microsoft, Bingbot için eşdeğer bir mekanizma kurduğunu ve 2027 başını hedeflediğini belirtiyor. O zamana kadar "Yapay zekâ eğitimine izin verme" seçimi tercihinizi robots.txt'e yazar, ancak Bing'in eğitim amacıyla tarama davranışı yalnızca bu sinyal yüzünden değişmez — kaygınız özellikle Bing üzerinden eğitimse, Bing'in kendi NOARCHIVE meta etiketi veya Content Removal aracı geçici kaldıraçlar olarak kalır.
Adım 1: Sitenizin gerçekte nereye düştüğünü öğrenin
Mevcut ayarı bildiğinizi varsaymayın — doğrulayın.
Eylem: Cloudflare panelinde alan adınızı açın, Security → Settings bölümüne gidin ve yapay zekâ bot politikası kontrollerini bulun (daha yeni üç kategorili arayüz, eski tek "Block AI Bots" anahtarının yerini aldı, ancak henüz geçiş yapmamış hesaplarda eski anahtar hâlâ görünebilir). Ayrıca canlı robots.txt dosyasını tarayıcıdan veya curl https://yourdomain.com/robots.txt ile çekin ve Cloudflare'in yönettiği bir işaret yorumuyla başlayan bloğu arayın; mevcut kurallarınızın yapay zekâ tarayıcıları tarafından nasıl okunduğunu görmek için Auspia'nın robots.txt yapay zekâ tarayıcı denetleyicisi ile de karşılaştırabilirsiniz.
Beklenen çıktı: arama, ajanlar ve eğitim için birer tane olmak üzere üç ayar; her biri İzin ver / Reklamlı sayfalarda engelle / Engelle değerlerinden birinde (eğitime özel dördüncü seçenek olarak "Yapay zekâ eğitimine izin verme" ile birlikte). Bot Preference Sync veya yönetilen robots.txt etkinse, canlı robots.txt Cloudflare tarafından yönetilen ve belirli user agent'ları ve Disallow / Content-Signal satırlarını listeleyen bir bölüm göstermelidir.
Kalite kontrolü: üç ayarın, geçiş mekanizmasının sizin adınıza varsaydığı şeyi değil, gerçekten istediğiniz şeyi karşıladığını doğrulayın. Cloudflare'in belgelediği mevcut müşteri geçiş mantığı şöyledir: eski "Block AI" anahtarını açmışsanız eğitim = Yapay zekâ eğitimine izin verme, arama İzin ver olarak korunmuş ve ajan = Reklamlı sayfalarda engelle konumuna geçirilmişsinizdir. Eğitimin kendisini Engelle veya Reklamlı sayfalarda engelle yapmışsanız Yapay zekâ eğitimine izin verme konumuna geçirilmişsinizdir. Her iki geçiş yolu da aramayı korumak istediğinizi varsayar. Gerçekte karma kullanımlı tarayıcıların arama dahil tamamen kaybolmasını istiyorsanız, mevcut durumunuz bu değildir ve açıkça Engelle seçmeniz gerekir.
Kurtarma yolu: güvenlik ayarları üç kategoriye bölünmeden yalnızca eski "Block AI Bots" anahtarını gösteriyorsa hesabınız henüz yeni kontrollere geçmemiştir. Ayrı ve daha yeni bir ayar yüzeyi olan "Configure AI bot policies"i arayın; geçiş döneminde ayrıntılı kontroller eski anahtarın yanında orada yaşar ve gelecek oraya bakar.
Adım 2: Politikayı tek bir genel cevapla değil, kategori kategori belirleyin
Asıl karar adımı budur. Her kategoriyi ayrı ayrı ele alın.
Arama. Neredeyse kimse engellemiyor — Cloudflare sitelerin %1'inden azının arama botlarını engellemeyi seçtiğini bildiriyor — çünkü arama görünürlüğünü kaybetmek neredeyse hiçbir zaman bedeline değmez. Sitenizi arama dizinlerinin dışında tutmak için özel bir gerekçeniz (bir test ortamı, ödeme duvarı arkasındaki bir arşiv) yoksa varsayılan olarak İzin ver seçin.
Ajanlar. Bunlar, şu anda sitenizde bir şey yapmaya çalışan bir kişi adına gerçek zamanlı hareket eden botlardır: fiyat kontrol etmek, rezervasyonu tamamlamak, bir sohbet cevabı için bir bilgiyi çekmek. Ajan trafiğini para kazandıran veya reklamlı sayfalarda engellemek yeni varsayılanın arkasındaki gerekçedir, çünkü bir ajan ziyareti insan ziyaretinin yaratacağı reklam gösterimini yaratmaz. İş modeliniz o insan dikkatine bağlıysa (medya, görüntülü reklam içeren içerik siteleri), Reklamlı sayfalarda engelle savunulabilir bir pozisyondur. Ajanların reklamlı sayfalarda bile sitenizde görev tamamlayabilmesini tercih ediyorsanız — örneğin ajan trafiği sizde yine dönüşüyorsa — İzin ver seçin.
Eğitim. Asıl karar burada ve terminoloji tam da burada kafa karıştırıyor:
- İçeriğinizin model eğitmek için kullanılmasını durdururken Google, Bing ve Apple arama ürünlerindeki varlığınızı korumak istiyorsanız Yapay zekâ eğitimine izin verme seçin (Bing'in mevcut geriliği düşünüldüğünde bunu "bugün Google ve Apple için geçerli, Bing için beklemede" olarak anlayın). Bu, Cloudflare'in önerdiği orta yoldur ve tam olarak arama ile eğitim arasındaki denge için tasarlanmıştır.
- Engelle seçeneğini yalnızca Googlebot, Bingbot ve Applebot'un arama taramasını tamamen kaybetmeyi, onların eğitim modundaki davranışını engellemenin bedeli olarak kabul ediyorsanız seçin. Artık bu katı seçenektir: 15 Eylül'den itibaren engelleme karma kullanımlı tarayıcılar için de geçerli, ki daha önce böyle değildi.
- İzin ver seçeneğini yalnızca içeriğinizin yapay zekâ modellerini eğitmesini bilinçli olarak kabul ediyorsanız seçin; örneğin yapay zekâ cevaplarındaki görünürlüğü en üst düzeye çıkarmak istiyor ve eğitimi kabul edilebilir bir bedel olarak görüyorsanız.
Eylem: Security → Settings → Configure AI bot policies bölümünde üç menüyü kararınıza göre ayarlayın.
Beklenen çıktı: panel her kategoride açık seçiminizi yansıtmalı ve (Bot Preference Sync açıksa) uygun robots.txt bloğunu otomatik olarak yayımlamaya başlamalıdır — dosyayı elle düzenlemeye gerek kalmadan.
Kalite kontrolü: eğitim kararınızı tek bir soruyla gözden geçirin: "Arama görünürlüğümü korumak istiyor muyum, istemiyor muyum?" Cevap evetse bu, yapay zekâ eğitimine izin vermedir; Engelle değil — "Engelle" kelimesi yapay zekâ eğitimini durdurmak için ne kadar çekici görünse de.
Kurtarma yolu: bir ayarı seçtikten sonra arama trafiği düştüyse, yanlışlıkla Yapay zekâ eğitimine izin verme yerine Engelle'yi seçip seçmediğinizi kontrol edin. Buradaki en yaygın kendine zarar verme hatası budur: adı, "Engelle"yi "daha fazlasını yapan" seçenek gibi gösterir, ama eğitim söz konusu olduğunda istemediğiniz şeyi yapar ve aramayı da beraberinde götürür.
Adım 3: robots.txt ayarlarınızı izlesin diye Bot Preference Sync'i açın
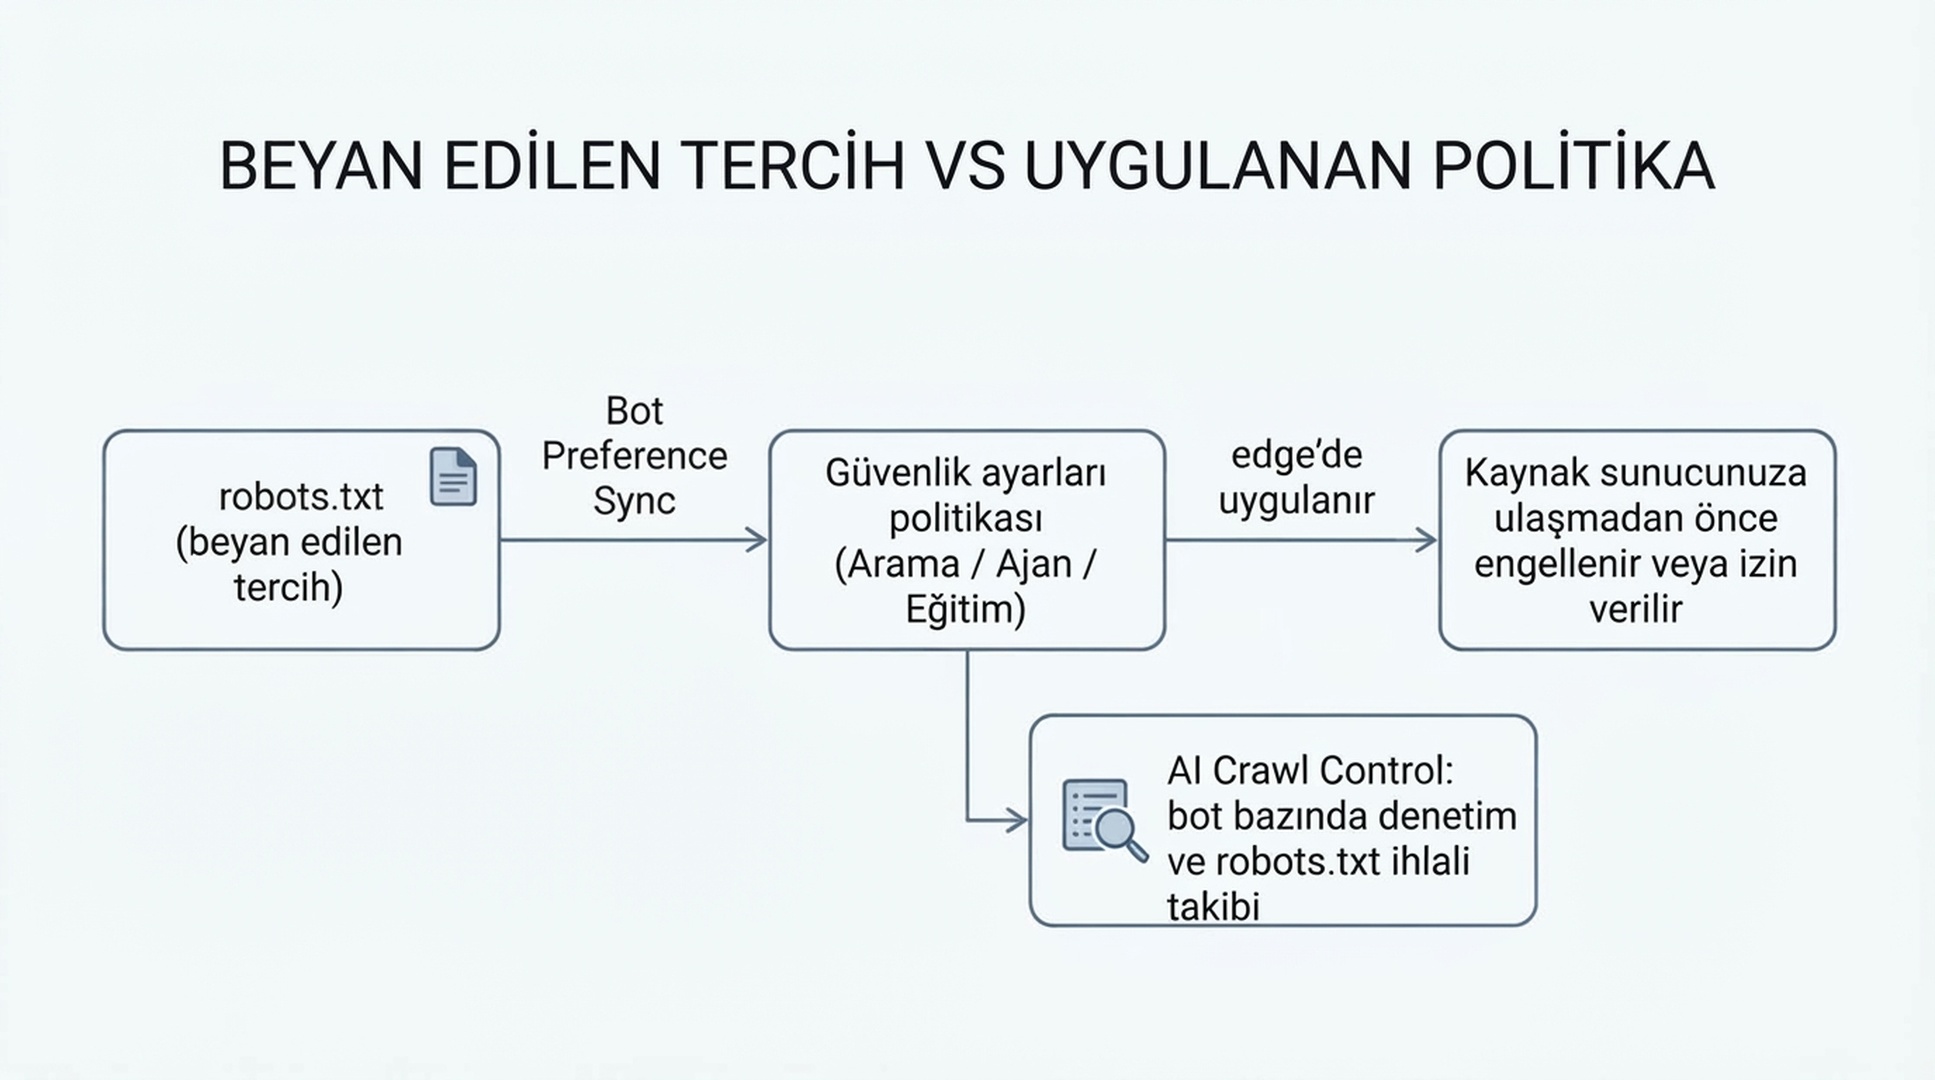
Panel ayarı ile robots.txt dosyası iki ayrı sistemdir ve ikisi ayrıştığında bazı tarayıcılar bu boşluğu tercihinizi yok saymak için bahane olarak kullanır. Cloudflare'in Bot Preference Sync'i bu boşluğu, robots.txt dosyanızı doğrudan seçtiğiniz güvenlik ayarlarından üreterek kapatır.
Eylem: aynı yapay zekâ bot politikası ayar alanında Bot Preference Sync'i açın (yeni müşterilerde varsayılan olarak açıktır; daha eski yönetilen robots.txt özelliğini kullanan mevcut müşterilerden geçiş sırasında gözden geçirip onaylamaları istenir).
Beklenen çıktı: Cloudflare robots.txt dosyanızın en başına # BEGIN Cloudflare Bot Preference Sync / # END yorumlarıyla sarılı, etkilenen belirli user agent'ları ve Disallow kurallarını listeleyen yönetilen bir blok ekler — ve robots.txt'te zaten var olan kendi kurallarınızın hiçbirini silmez; onlar yönetilen bloğun altında kalır.
Kalite kontrolü: etkinleştirdikten sonra /robots.txt dosyasını yeniden çekin ve yönetilen bloğun göründüğünü ve Adım 2'deki seçimlerle örtüştüğünü doğrulayın. Örneğin eğitimi Yapay zekâ eğitimine izin verme yaptıysanız, eğitime özel user agent'ları (Google-Extended, Applebot-Extended) Disallow kurallarıyla görmelisiniz; genel Googlebot / Applebot / Bingbot user agent'ları ise arama için engelsiz kalır.
Kurtarma yolu: belirli bir tarayıcı operatörüyle, kategori düzeyindeki bir politikanın bozacağı tek seferlik özel bir anlaşmanız varsa (örneğin ücretli içerik lisans sözleşmesi), Bot Preference Sync'i kapatın ve kendi robots.txt dosyanızı elle düzenleyin: kategori anahtarları bölge geneli politika için tasarlanmıştır, tek tek operatör istisnaları için değil.
Adım 4: Politikanın yalnızca rica edilmediğini, gerçekten uygulandığını doğrulayın
robots.txt teknik olarak bir ricadır: onu yok sayan bir tarayıcıyı durdurmaz. İnsanların atladığı adım budur ve Adım 2'deki kararınızın gerçek mi yoksa yalnızca teori mi olduğunu gösteren de bu adımdır.
Eylem: bölgeniz için AI Crawl Control'ü açın (ücretsiz dahil tüm planlarda kullanılabilir — algılama kalitesi Bot Management içeren planlarda daha iyidir, ancak görünürlük özellikleri her yerde çalışır). Sitenize ulaşan tüm botları Robots.txt violations sütunuyla listeleyen Crawlers sekmesine bakın.
Beklenen çıktı: bot başına istek ve ihlal sayısını gösteren bir tablo. İzin verilmeyen veya engellenen olarak ayarladığınız bir botta sıfırdan farklı ihlal sayısı, o botun şu anda robots.txt dosyanızı yok saydığı anlamına gelir.
Kalite kontrolü: ihlal gösteren herhangi bir bot için "Most popular paths" bölümüne bakın (işaretlenen yollara filtreleyerek) ve gerçekte neyi istediğini görün; korumak istediğiniz içeriğe ulaşıp ulaşmadığına karar verin.
Kurtarma yolu: bir bot bildirdiğiniz tercihi yok sayıyorsa, robots.txt tek başına onu durdurmaz. AI Crawl Control'deki "Enforce robots.txt rules" eylemini kullanın (bazen iç adı olan Robotcop ile anılır) ve bildirdiğiniz kuralları, itaatsiz botu kaynak sunucunuza ulaşmadan önce Cloudflare edge'inde engelleyen gerçek bir WAF kuralına dönüştürün — "uyum rica etmek"ten "uyumu zorunlu kılmak"a geçersiniz. Bu adım WAF kullanır, dolayısıyla kullanılabilirliği planınızın WAF erişimine bağlıdır.
Adım 5: Sadece engellemek mi, yoksa erişimi ücretlendirmek mi
Eğitim kararınız "eğitim için erişim yok" ise, toptan engellemenin yanında ikinci bir seçeneğiniz var: ücret almak.
Eylem: ilginizi çekiyorsa Cloudflare'in kapalı beta Pay Per Crawl programına başvurun (Cloudflare'in kayıt sayfasından veya Enterprise müşterisiyseniz hesap yöneticiniz aracılığıyla). Hesap düzeyinde etkinleştirildikten sonra (Manage Account → Settings → Pay Per Crawl → alan adınızın Visibility değerini Visible yapın), bölge için tek bir sabit istek başına fiyat belirleyebilir ve her tarayıcı için izin ver (ücretsiz), ücretlendir (sizin fiyatınızdan) veya engelle arasından seçim yapabilirsiniz.
Beklenen çıktı: Web Bot Auth ile kimlik doğrulayan bir tarayıcı (tarayıcıyı tanımlayan Ed25519 imzalı istek), ücretli olarak işaretlediğiniz bir sayfayı istediğinde crawler-price başlığıyla birlikte HTTP 402 Payment Required alır; ödemeyi kabul ederek yeniden denerse ya da baştan fiyatınızı karşılayan bir crawler-max-price başlığı eklerse, içeriği ücretlendirilen tutarı doğrulayan crawler-charged başlığıyla alır. Cloudflare merchant of record olarak hareket eder ve ödemeyi gerçekleştirir.
Kalite kontrolü: bu yalnızca Cloudflare'e ödeme bilgisi kaydetmiş ve 402 akışını destekleyen tarayıcılara karşı çalışır; tüm botlara karşı evrensel bir anahtar değildir. Diğer herkes için ücretlendirme ayarınız pratikte engelleme gibi davranır — Cloudflare bunun yine de gelecekte ücretli bir ilişkiye açık olduğunuzun sinyali olarak işlev gördüğünü belirtiyor.
Kurtarma yolu: özellik kapalı betada; kabul edilmediyseniz veya beklemek istemiyorsanız, aynı tarayıcılar için Yapay zekâ eğitimine izin verme ya da Engelle bugün hâlâ kullanılabilir.
İstisnayı yönetmek: belirli bir yapay zekâ operatörü erişim istediğinde
Bölge geneli politikanın dışında açık erişim isteyen bir yapay zekâ şirketinden size bir talep gelebilir — bir ortaklık, bir alıntılama anlaşması, bir lisans görüşmesi.
Tüm kategoriyi yeniden açmadan dar bir istisna vermenin iki yolu vardır:
- Manage AI crawlers'da tarayıcı bazında geçersiz kılma: o botun satırını, kategori düzeyindeki eğitim veya ajan ayarınızdan bağımsız olarak engelle/ücretlendir'den izin ver'e çevirin.
- robots.txt'i doğrudan elle düzenleme: Bot Preference Sync'i kapattıysanız (veya istisnayı yönetilen bloğun dışına koyuyorsanız), Cloudflare'in yönettiği bölümün altına yalnızca o user agent için hedefli bir Allow ekleyebilirsiniz.
Her iki durumda da bölge düzeyindeki kategori politikasını varsayılan olarak koruyun ve adlandırılmış istisnaları bilinçli, belgelenmiş kararlar olarak ele alın — tersi değil.
Sonucu doğrulayın
Yapılandırma yayına girdiğinde bu listeyi gözden geçirin:
- [ ] Güvenlik ayarları arama, ajanlar ve eğitim için açık ve bilinçli değerler gösteriyor — gözden geçirilmemiş varsayılanlar değil
- [ ] Canlı
/robots.txtbu ayarlarla örtüşen Cloudflare yönetimli bir blok gösteriyor - [ ] AI Crawl Control'ün Crawlers sekmesi beklediğiniz botları gösteriyor ve engelli/izin verilmeyen olarak ayarladığınız her şey için ihlal sayısı sıfır ya da sıfıra yakın
- [ ] Yapay zekâ eğitimine izin verme seçtiyseniz, Googlebot / Applebot arama taramasının normal seyrettiğini doğruladınız (Search Console / Bing Webmaster Tools üzerinden ya da yalnızca organik trafiği izleyerek)
- [ ] robots.txt uygulamasını (Robotcop) açtıysanız, ortaya çıkan WAF kuralı yalnızca oluşturulup taslak bırakılmamış, dağıtılmış ve etkin
- [ ] Hangi ayarı neden seçtiğinizi belgelediniz, böylece gelecekteki bir gözden geçirme sıfırdan başlamaz
Sonucu ayakta tutun
Bu, bir kez ayarlanıp unutulacak bir yapılandırma değildir. Hafif bir tempoyla geri dönün:
- Aylık: AI Crawl Control'ün Metrics sekmesini, henüz politika belirlemediğiniz yeni botlar için kontrol edin ve ihlal sayılarını yeniden gözden geçirin.
- Bing, Bingbot için eğitim tercihi desteğini yayımladığında (Microsoft 2027 başını hedef olarak belirtiyor): mevcut yapılandırmanızın hâlâ amaçlanan sonucu verip vermediğini yeniden değerlendirin — aramayı korumak, eğitimi engellemek — çünkü Bing'in Google ve Apple'ın bugünkü davranışını yakaladığı an orasıdır.
- Reklamla para kazanma durumunuz her değiştiğinde: görüntülü reklam eklemek veya kaldırmak sayfalarınızın hangi varsayılan şeride düştüğünü değiştirir ve açık ayarlarınızın o senaryoda hâlâ anlamlı olduğunu yeniden doğrulamaya değer.
Sık sorulan sorular
Eğitim tarayıcılarını engellemek SEO sıralamamı bozar mı? Hayır, Engelle yerine Yapay zekâ eğitimine izin verme kullanırsanız bozmaz. Yapay zekâ eğitimine izin verme, hesap verebilir karma kullanımlı tarayıcıların (Google, Apple ve ileride Bing) eğitimi atlayarak arama için taramaya devam etmesi için tasarlandı. Buna karşılık düz Engelle artık bu tarayıcıların arama davranışını da engelliyor, bu da onların arama ürünlerindeki görünürlüğünüze zarar verir.
15 Eylül'den önce "Block AI Bots" zaten açıktı. Ayarıma ne oldu? Cloudflare bunu otomatik olarak taşıdı: eski Block AI Bots, eğitim = Yapay zekâ eğitimine izin verme, arama = İzin ver ve ajan = Reklamlı sayfalarda engelle hâline geldi. Gerçek sonucun beklendiği gibi çıkıp çıkmadığını yukarıdaki Adım 1 ile doğrulayın; geçişin amacınızla örtüştüğünü varsaymayın.
Bunlardan herhangi biri ücretsiz planda var mı? Var. AI Crawl Control, arama/ajanlar/eğitim kategori ayarları ve Bot Preference Sync ücretsiz dahil tüm planlarda çalışır. Bazı uygulama ayrıntıları plana göre değişir — örneğin robots.txt uygulaması WAF üzerinden çalışır ve ücretsiz planda bot algılama, daha gelişmiş Bot Management algılama kimliği yerine user agent dizelerine dayanır.
AI Crawl Control ile yapay zekâ bot güvenlik ayarları arasındaki fark nedir? Güvenlik ayarları politikayı belirlediğiniz yerdir (kategori başına izin ver / reklamlı sayfalarda engelle / engelle / yapay zekâ eğitimine izin verme). AI Crawl Control ise gerçekte ne olduğunu denetlediğiniz yerdir — bot başına istek sayıları, robots.txt ihlalleri, yol düzeyinde ayrıntı — ve bildirilen robots.txt politikasını uygulanan bir WAF kuralına dönüştürebileceğiniz yerdir.
Bunları ayarladıktan sonra robots.txt'i elle düzenlemem gerekiyor mu? Bot Preference Sync açıksa gerekmez: panel ayarlarınızdan uygun robots.txt bloğunu yazar ve korur. Elle düzenleme yalnızca yönetilen kategorilerin dışında, belirli bir operatör için tek seferlik istisnalar gerektiğinde gerekir.
Yazar: Julian Mercer, Auspia'da 14 yıllık deneyime sahip teknik SEO uygulayıcısı. Taranabilirlik, yapılandırılmış veri, render ve içeriği yapay zekâ tarafından okunabilir kılan teknik temeller üzerine yazıyor.