Bạn nhận được gì sau khi hoàn thành hướng dẫn này
Khi hoàn thành hướng dẫn này, tên miền Cloudflare của bạn sẽ có một chính sách rõ ràng, được chủ động lựa chọn cho ba nhóm lưu lượng bot AI riêng biệt — Search (tìm kiếm), Agent (tác nhân) và Training (huấn luyện) — thay vì mặc định mà tên miền thừa hưởng. Bạn sẽ biết chính xác bot nào được phép, bot nào bị chặn và trên những trang nào, đồng thời robots.txt của bạn và quy tắc thực thi ở biên sẽ thực sự khớp với nhau.
Dành cho ai: bất kỳ ai vận hành một website phía sau Cloudflare — nhà xuất bản, site marketing của SaaS, cửa hàng thương mại điện tử, blog — và muốn tự quyết định liệu các hệ thống AI có được huấn luyện trên nội dung của mình, tóm tắt nó, hay đọc nó qua các tác nhân hay không, thay vì thừa hưởng lựa chọn do một nền tảng đặt sẵn.
Bạn cần gì:
- Một tên miền đang được Cloudflare proxy (bất kỳ gói nào, kể cả gói miễn phí; một số bước dưới đây chỉ có ở gói trả phí và đã được ghi rõ)
- Quyền truy cập bảng điều khiển có khả năng thay đổi cài đặt bảo mật ở cấp zone
- 20 đến 30 phút để rà soát và cấu hình; sau đó vài phút mỗi ngày hoặc mỗi tuần để theo dõi
Định nghĩa hoàn thành: cài đặt bảo mật của zone hiển thị lựa chọn chủ động (chứ không phải mặc định chưa từng xem lại) cho tìm kiếm, tác nhân và huấn luyện; /robots.txt trên production phản ánh lựa chọn đó; và bạn đã xác nhận trong AI Crawl Control rằng những bot lẽ ra phải bị chặn đang thực sự bị chặn.
Vì sao chuyện này bỗng trở nên quan trọng: điều gì đã thay đổi vào ngày 15 tháng 9
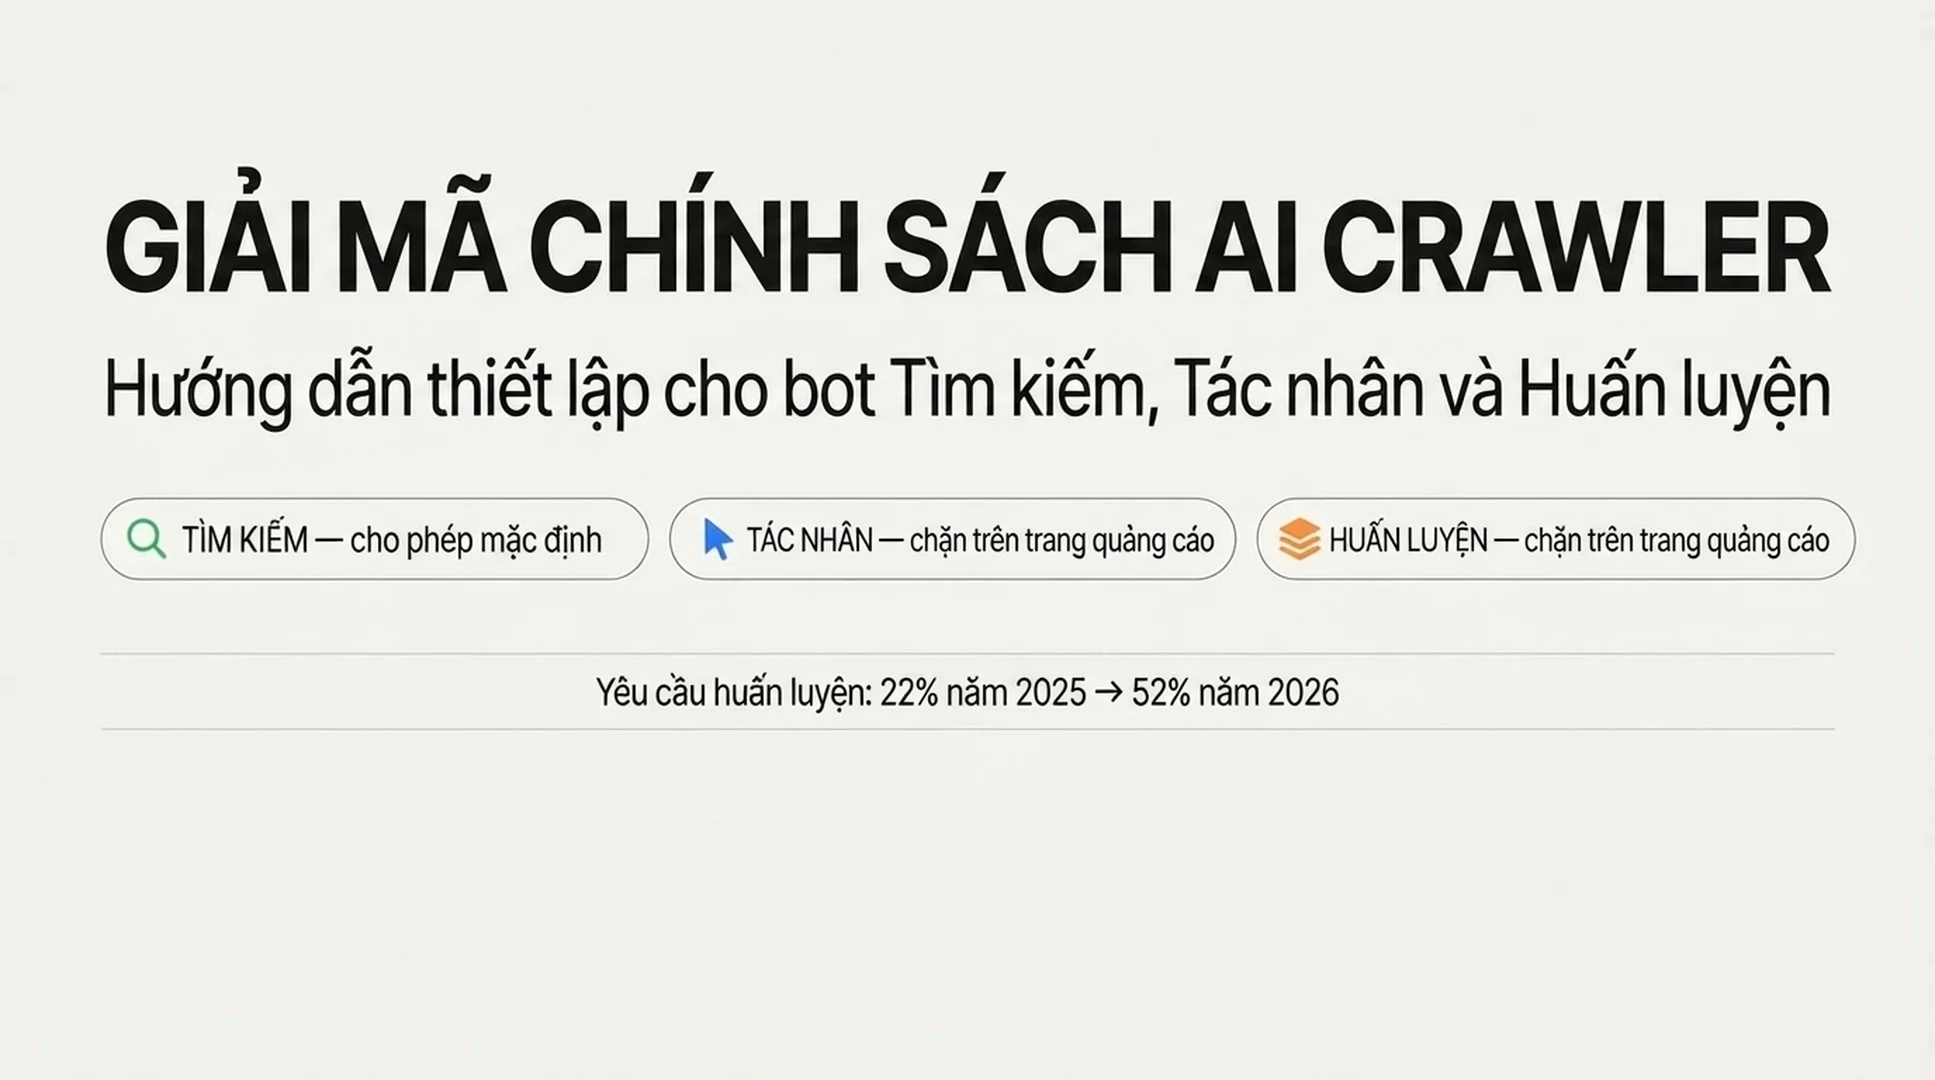
Cloudflare xây dựng các cơ chế kiểm soát lưu lượng AI theo từng bước: từ việc thêm Content Signals Policy vào robots.txt hồi tháng 9 năm 2025, cho tới "Content Independence Day" ngày 1 tháng 7 năm 2026 — sự kiện lần đầu chia hành vi bot AI thành ba nhóm có tên gọi thay vì một công tắc thô "là AI hay không phải AI":
- Search (tìm kiếm) — hoạt động thu thập dữ liệu để xây dựng chỉ mục tìm kiếm, rồi trả về liên kết hoặc đoạn trích ngắn. Theo cách diễn đạt của chính Cloudflare, đây là lưu lượng được kỳ vọng sẽ mang lại lượt giới thiệu cho bạn.
- Agent (tác nhân) — hoạt động tự động hành xử thay ai đó trong thời gian thực, ví dụ một trợ lý chat đang tải một trang, hoặc một tác nhân trình duyệt đang hoàn tất một tác vụ.
- Training (huấn luyện) — thu thập dữ liệu nhằm huấn luyện hoặc tinh chỉnh mô hình, trong đó nội dung của bạn bị hấp thụ vĩnh viễn vào trọng số của mô hình thay vì quay về với bạn dưới dạng liên kết.
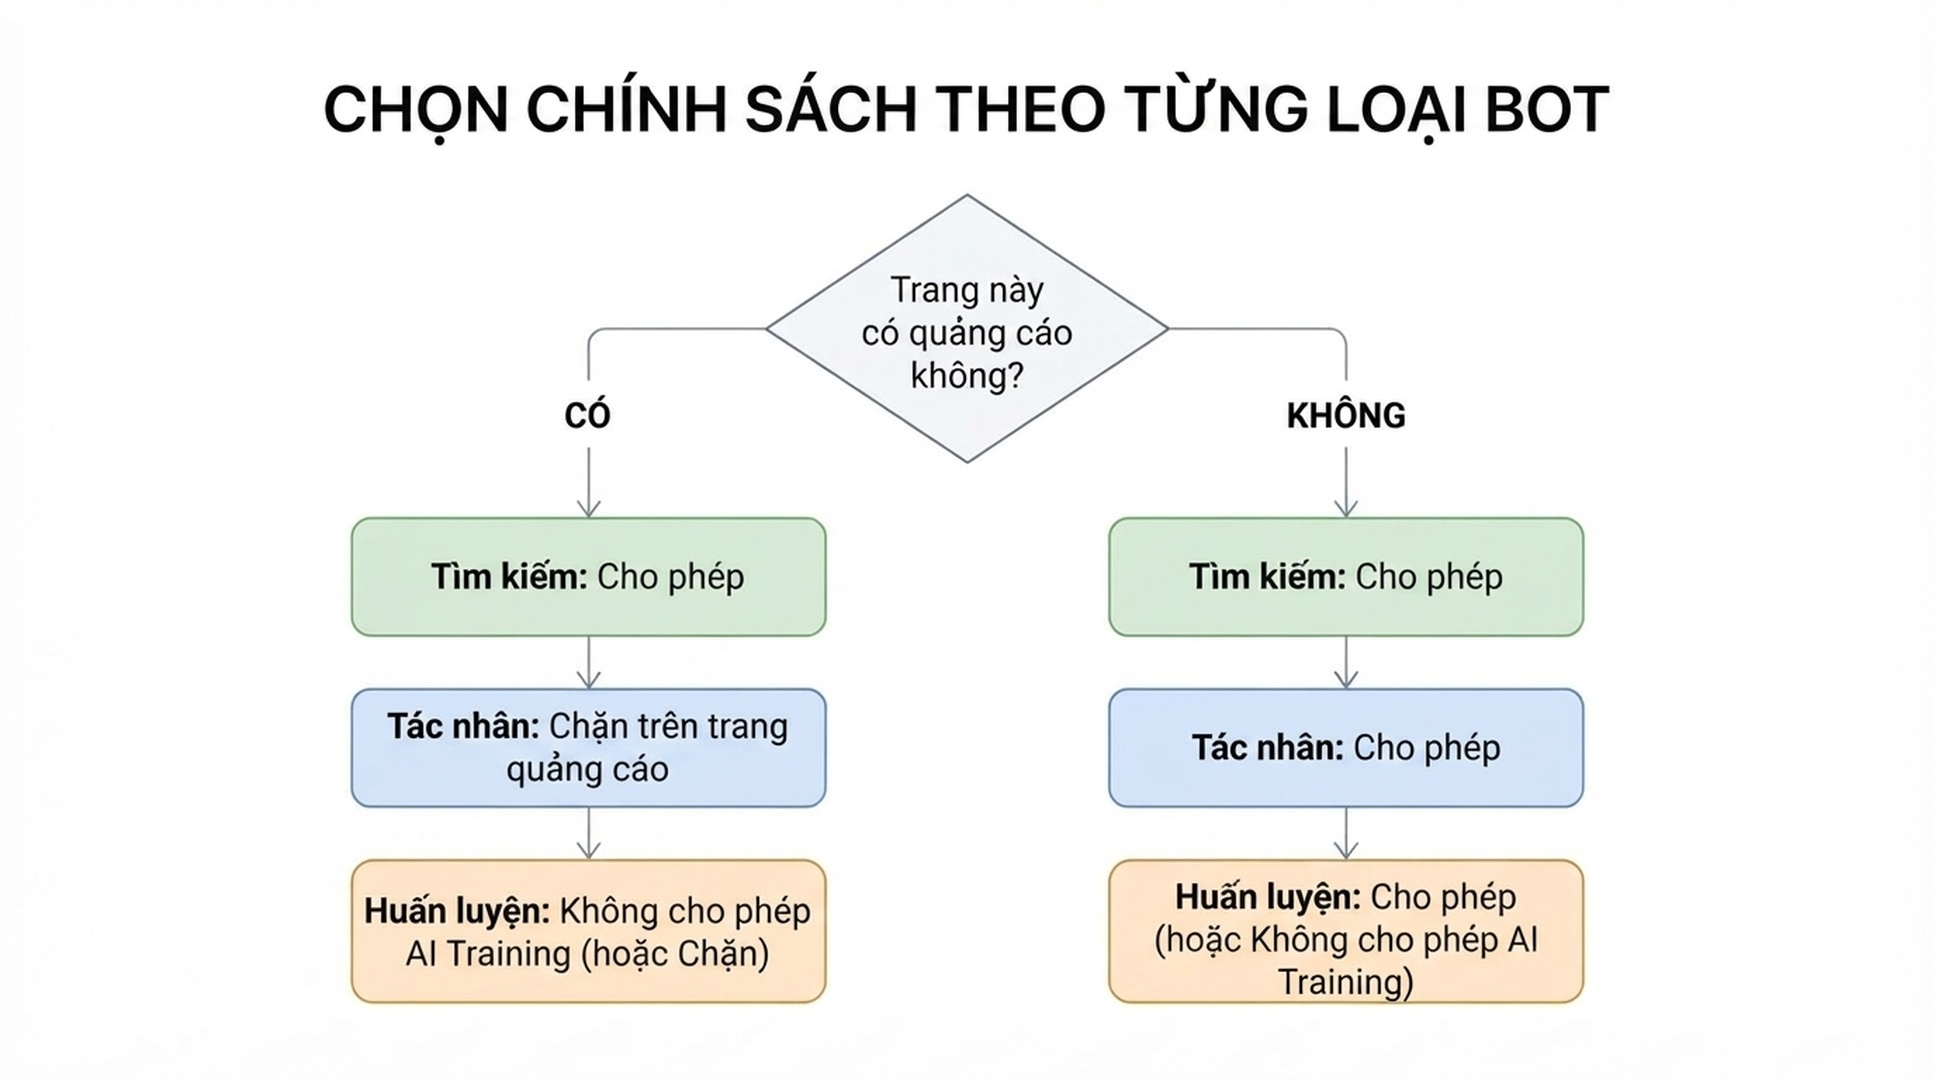
Ngày 15 tháng 9 năm 2026, Cloudflare thay đổi những gì diễn ra tự động. Với mọi tên miền tham gia Cloudflare từ ngày đó trở đi, nếu site được đánh dấu là có kiếm tiền từ quảng cáo, mặc định trở thành:
Nhóm | Mặc định trên các trang có quảng cáo |
|---|---|
Search (tìm kiếm) | Cho phép |
Agent (tác nhân) | Chặn trên các trang quảng cáo |
Training (huấn luyện) | Không cho phép huấn luyện AI |
Tên miền mới không kiếm tiền từ quảng cáo mặc định được "Cho phép" ở cả ba nhóm. Khách hàng hiện hữu không bị âm thầm chuyển đổi — Cloudflare mở một khoảng thời gian để chọn không tham gia qua bảng điều khiển trước ngày 15, và các quy tắc di trú thực tế theo từng tên miền hóa ra chi tiết hơn nhiều so với một mặc định mới duy nhất (giải thích ở dưới).
Lý do các trang có quảng cáo nhận mặc định nghiêm ngặt hơn là vì sự hiện diện của quảng cáo báo hiệu rằng trang đó được thiết kế để con người xem. Theo số liệu của chính Cloudflare, vào tháng 6 năm 2026, các trình thu thập dữ liệu dùng hỗn hợp — những con kết hợp lập chỉ mục tìm kiếm, yêu cầu của tác nhân và huấn luyện dưới cùng một user agent — chiếm hơn 36% lưu lượng trình thu thập đã xác minh, là nhóm đơn lẻ lớn nhất. Và tỷ trọng huấn luyện AI trong tổng số yêu cầu bot trên mạng lưới Cloudflare đã tăng từ khoảng 22% vào mùa xuân năm 2025 lên 52% vào tháng 6 năm 2026. Thay đổi này nhắm thẳng vào dòng lưu lượng đó.
Trước khi bắt đầu: ba điều cần hiểu về các nhóm
1. Một số trình thu thập dùng hỗn hợp và hành xử khác nhau giữa việc bị chặn và việc bị từ chối huấn luyện. Googlebot, Bingbot và Applebot làm hai việc cùng lúc — chúng lập chỉ mục cho cả tìm kiếm lẫn huấn luyện dưới cùng một user agent. Cloudflare gọi Apple, Google và Microsoft là những nhà vận hành "Accountable" (có trách nhiệm giải trình) vì họ đáp ứng bốn điều kiện: tôn trọng tùy chọn từ chối huấn luyện trong robots.txt, cung cấp cách để không tham gia các bản tóm tắt do AI tạo, cho thấy minh bạch ở cấp URL về những gì đã được dùng để huấn luyện, và chứng minh được rằng việc rút khỏi huấn luyện không gây hại cho sự hiện diện tìm kiếm của bạn.
2. "Không cho phép huấn luyện AI" và "Chặn" không phải cùng một cài đặt, và chính khác biệt này là điểm mấu chốt. Không cho phép huấn luyện AI công bố một tùy chọn Disallow trong robots.txt hướng tới các user agent chỉ dùng cho huấn luyện (như Google-Extended và Applebot-Extended). Những bot hỗn hợp có trách nhiệm giải trình đọc tùy chọn đó và tự nguyện tiếp tục lập chỉ mục cho tìm kiếm trong khi bỏ qua huấn luyện — nhờ vậy sự hiện diện tìm kiếm của bạn được giữ nguyên. Các trình thu thập huấn luyện khác không thuộc nhóm có trách nhiệm giải trình bị chặn ngay ở biên, và điều này không ảnh hưởng tới tìm kiếm vì những nhà vận hành đó chạy bot huấn luyện riêng. Ngược lại, Chặn đơn thuần giờ đây cũng chặn chính Googlebot, Bingbot và Applebot, nghĩa là nội dung của bạn biến mất khỏi kết quả tìm kiếm của họ nữa. Nếu bạn muốn gỡ bỏ huấn luyện nhưng giữ lại tìm kiếm, cài đặt đúng là "Không cho phép huấn luyện AI", không phải "Chặn".
3. Bing hiện vẫn chưa tôn trọng tùy chọn huấn luyện trong robots.txt. Hôm nay cả Applebot và Googlebot đều tuân theo chỉ thị Disallow dành cho huấn luyện. Microsoft nói họ đang xây dựng cơ chế tương đương cho Bingbot, nhắm tới đầu năm 2027. Cho tới lúc đó, lựa chọn "Không cho phép huấn luyện AI" sẽ ghi tùy chọn của bạn vào robots.txt, nhưng hành vi thu thập để huấn luyện của Bing sẽ không thay đổi chỉ vì tín hiệu đó — thẻ meta NOARCHIVE của chính Bing hoặc công cụ Content Removal của họ vẫn là những đòn bẩy tạm thời nếu bạn đặc biệt lo ngại về việc Bing huấn luyện.
Bước 1: Xác định xem site của bạn thực sự đang ở đâu
Đừng đoán cài đặt hiện tại — hãy đi kiểm tra.
Việc cần làm: trong bảng điều khiển Cloudflare, mở tên miền của bạn, vào Security → Settings và tìm các nút điều khiển chính sách bot AI (giao diện mới với ba nhóm đã thay thế công tắc "Block AI Bots" đơn lẻ trước đây, nhưng những tài khoản chưa được di trú vẫn có thể hiển thị công tắc cũ). Riêng phần robots.txt, hãy tải tệp trên production bằng trình duyệt hoặc bằng curl https://yourdomain.com/robots.txt và tìm khối bắt đầu bằng dấu chú thích do Cloudflare quản lý; hoặc đối chiếu với công cụ kiểm tra trình thu thập AI trong robots.txt của Auspia để xem các quy tắc hiện tại của bạn được bot AI đọc như thế nào.
Kết quả mong đợi: ba cài đặt — một cho tìm kiếm, một cho tác nhân, một cho huấn luyện — mỗi cài đặt nhận một giá trị trong số Cho phép / Chặn trên các trang quảng cáo / Chặn (với "Không cho phép huấn luyện AI" là lựa chọn thứ tư chỉ có ở phần huấn luyện). robots.txt trên production phải hiển thị phần do Cloudflare quản lý, liệt kê các user agent cụ thể cùng các dòng Disallow / Content-Signal nếu Bot Preference Sync hoặc robots.txt được quản lý đang bật.
Kiểm tra chất lượng: hãy chắc chắn cả ba cài đặt phản ánh điều bạn thực sự muốn, chứ không phải điều mà cơ chế di trú mặc định cho bạn. Logic di trú mà Cloudflare công bố cho khách hàng hiện hữu là: nếu trước đây bạn đã bật công tắc "Block AI" cũ, bạn được đưa sang huấn luyện = Không cho phép huấn luyện AI, tìm kiếm giữ nguyên ở Cho phép, và tác nhân được đặt thành Chặn trên các trang quảng cáo. Nếu trước đây bạn tự đặt huấn luyện thành Chặn hoặc Chặn trên các trang quảng cáo, bạn được đưa sang Không cho phép huấn luyện AI. Cả hai đường di trú đều giả định rằng bạn muốn giữ tìm kiếm. Nếu thực ra bạn muốn các bot hỗn hợp biến mất hoàn toàn, kể cả tìm kiếm, thì đó không phải trạng thái hiện tại của bạn và bạn cần chủ động chọn Chặn.
Đường khôi phục: nếu cài đặt bảo mật chỉ hiển thị công tắc "Block AI Bots" cũ mà không có phân tách ba nhóm, tài khoản của bạn chưa được di trú sang các nút điều khiển mới. Hãy tìm "Configure AI bot policies" — một màn hình cài đặt riêng và mới hơn; trong giai đoạn chuyển tiếp, các nút điều khiển chi tiết cùng tồn tại với công tắc cũ và tương lai nằm ở hướng đó.
Bước 2: Đặt chính sách cho từng nhóm riêng biệt, không dùng một câu trả lời chung
Đây là bước quyết định thực sự. Hãy đi qua từng nhóm một.
Tìm kiếm. Gần như không ai chặn nhóm này — Cloudflare cho biết chưa tới 1% website chọn chặn bot tìm kiếm — vì mất khả năng hiển thị trong tìm kiếm hầu như không bao giờ đáng. Hãy đặt mặc định là Cho phép, trừ khi bạn có lý do cụ thể (môi trường staging, kho lưu trữ sau tường phí) để giữ site ngoài các chỉ mục tìm kiếm.
Tác nhân. Đây là những bot hành động trong thời gian thực thay cho người đang cố làm điều gì đó trên site của bạn ngay lúc này: kiểm tra giá, hoàn tất đặt chỗ, rút ra một dữ kiện để trả lời trong chat. Chặn lưu lượng tác nhân trên các trang có quảng cáo hoặc có kiếm tiền là lý do biện minh cho mặc định mới, bởi một lượt truy cập của tác nhân không tạo ra lượt hiển thị quảng cáo mà một lượt truy cập của con người sẽ tạo ra. Nếu mô hình kinh doanh của bạn dựa vào sự chú ý của con người đó (báo chí, các site nội dung có quảng cáo hiển thị), Chặn trên các trang quảng cáo là thế phòng thủ. Nếu bạn muốn tác nhân hoàn tất công việc trên site mình kể cả ở các trang có quảng cáo — chẳng hạn vì lưu lượng tác nhân thực sự chuyển đổi cho bạn — hãy chọn Cho phép.
Huấn luyện. Đây là quyết định thực sự, và cũng là chỗ thuật ngữ gây nhầm lẫn:
- Chọn Không cho phép huấn luyện AI nếu bạn muốn ngăn nội dung được dùng để huấn luyện mô hình trong khi vẫn hiện diện trong các sản phẩm tìm kiếm của Google, Bing và Apple (với độ trễ hiện tại của Bing, hãy hiểu là "hôm nay đã hiệu lực với Google và Apple, còn Bing thì đang chờ"). Đây là con đường trung dung mà Cloudflare khuyến nghị, được tạo ra đúng để cân bằng giữa tìm kiếm và huấn luyện.
- Chỉ chọn Chặn nếu bạn chấp nhận mất hoàn toàn khả năng được Googlebot, Bingbot và Applebot lập chỉ mục cho tìm kiếm như cái giá để ngăn hành vi huấn luyện của chúng. Đây giờ là lựa chọn gay gắt: từ ngày 15 tháng 9, việc chặn áp dụng cả cho các bot hỗn hợp, điều trước đây không xảy ra.
- Chỉ chọn Cho phép nếu bạn chủ động chấp nhận rằng nội dung của mình sẽ huấn luyện các mô hình AI — chẳng hạn vì bạn muốn khả năng hiển thị tối đa trong các câu trả lời AI và coi huấn luyện là cái giá chấp nhận được.
Việc cần làm: trong Security → Settings → Configure AI bot policies, đặt cả ba danh sách theo quyết định của bạn.
Kết quả mong đợi: bảng điều khiển phải phản ánh lựa chọn rõ ràng của bạn ở từng nhóm và (nếu Bot Preference Sync đang bật) bắt đầu tự động công bố khối robots.txt tương ứng — không cần chỉnh sửa tệp bằng tay.
Kiểm tra chất lượng: hãy đọc lại quyết định về huấn luyện và tự kiểm tra bằng một câu hỏi: "Tôi có muốn giữ khả năng hiển thị trong tìm kiếm không?" Nếu có, câu trả lời là Không cho phép huấn luyện AI, không phải Chặn — dù từ "Chặn" nghe có vẻ là cách dứt khoát hơn để ngăn AI huấn luyện.
Đường khôi phục: nếu lưu lượng tìm kiếm giảm sau khi chọn cài đặt, hãy kiểm tra xem bạn có vô tình chọn Chặn thay vì Không cho phép huấn luyện AI hay không. Đây là lỗi tự hại phổ biến nhất ở bước này: cái tên khiến "Chặn" trông như lựa chọn "làm được nhiều hơn", nhưng với huấn luyện thì nó làm điều bạn có thể không muốn — lấy luôn cả tìm kiếm.
Bước 3: Bật Bot Preference Sync để robots.txt bám theo cài đặt của bạn
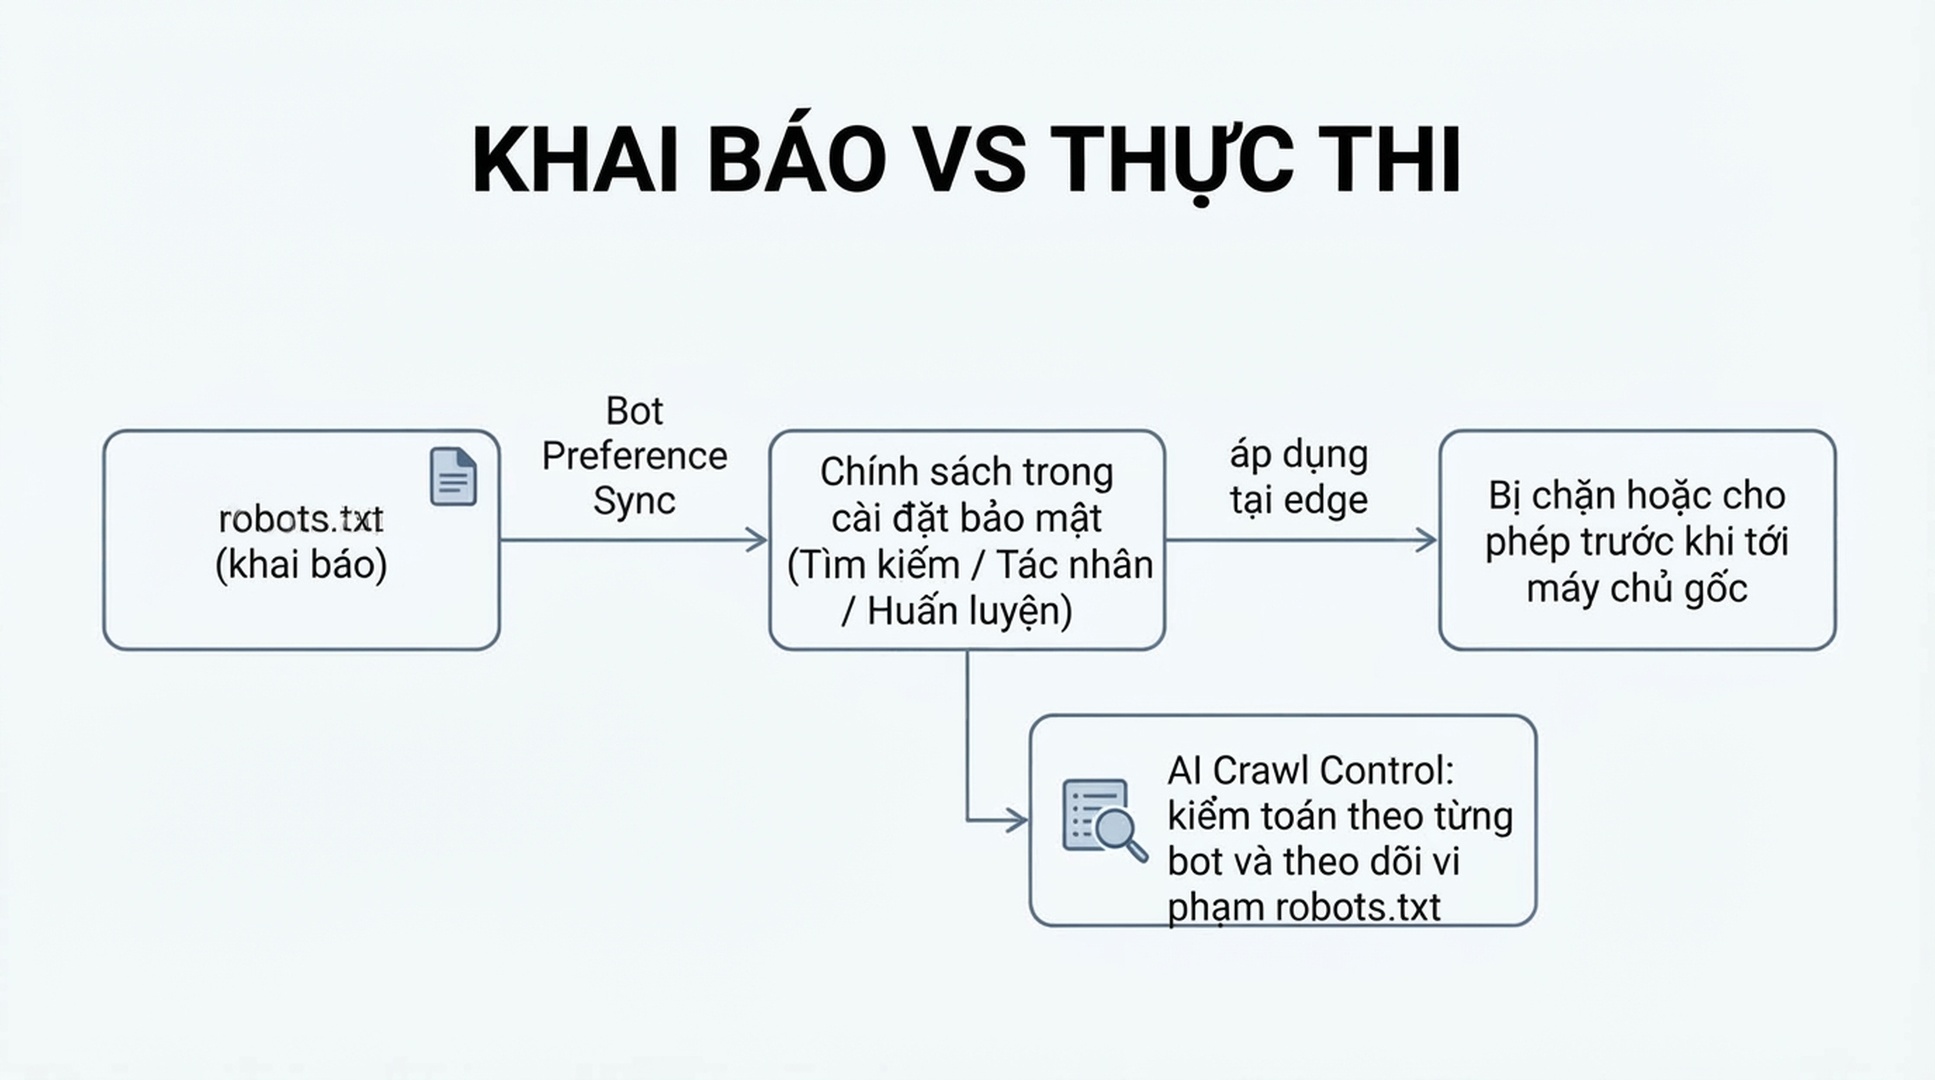
Cài đặt trong bảng điều khiển và tệp robots.txt là hai hệ thống khác nhau, và khi chúng lệch nhau, một số bot lấy chính sự lệch đó làm cớ để phớt lờ tùy chọn của bạn. Bot Preference Sync của Cloudflare bịt khoảng trống này bằng cách sinh robots.txt trực tiếp từ các nút điều khiển bảo mật bạn đã chọn.
Việc cần làm: trong cùng khu vực chính sách bot AI, bật Bot Preference Sync (nó mặc định bật cho khách hàng mới; khách hàng hiện hữu đang dùng tính năng robots.txt được quản lý phiên bản cũ sẽ được nhắc xem lại và xác nhận trong quá trình di trú).
Kết quả mong đợi: Cloudflare thêm một khối được quản lý ở đầu robots.txt, bọc trong chú thích # BEGIN Cloudflare Bot Preference Sync / # END, liệt kê các user agent được bao gồm và các quy tắc Disallow của chúng — và không xóa bất kỳ quy tắc nào bạn tự viết đã có trong robots.txt; chúng nằm bên dưới khối được quản lý.
Kiểm tra chất lượng: tải lại /robots.txt sau khi bật và xác nhận khối được quản lý đã xuất hiện và khớp với các lựa chọn ở Bước 2. Ví dụ, nếu bạn đặt huấn luyện thành Không cho phép huấn luyện AI, bạn sẽ thấy các user agent chỉ dùng cho huấn luyện (Google-Extended, Applebot-Extended) với quy tắc Disallow, trong khi Googlebot / Applebot / Bingbot nói chung vẫn không bị chặn cho mục đích tìm kiếm.
Đường khôi phục: nếu bạn có một thỏa thuận đặc biệt riêng lẻ với một nhà vận hành bot cụ thể mà chính sách cấp nhóm sẽ phá vỡ (ví dụ một hợp đồng cấp phép nội dung có trả tiền), hãy tắt Bot Preference Sync và tự chỉnh sửa robots.txt: các công tắc theo nhóm được thiết kế cho chính sách toàn zone, không phải cho ngoại lệ với từng nhà vận hành.
Bước 4: Xác nhận chính sách thực sự được thực thi, không chỉ được đề nghị
robots.txt về mặt kỹ thuật là một lời đề nghị: nó sẽ không dừng một bot phớt lờ nó. Đây là bước người ta hay bỏ qua, và cũng là bước cho thấy quyết định ở Bước 2 của bạn là thật hay chỉ trên giấy.
Việc cần làm: mở AI Crawl Control cho zone của bạn (có ở mọi gói, kể cả gói miễn phí — chất lượng phát hiện tốt hơn ở các gói có Bot Management, nhưng các tính năng hiển thị hoạt động ở mọi nơi). Xem tab Crawlers, nơi liệt kê mọi bot đã tiếp cận site của bạn, kèm cột Robots.txt violations.
Kết quả mong đợi: một bảng với số yêu cầu và số vi phạm cho từng bot. Một bot bạn đã đặt ở mức không cho phép hoặc chặn mà có số vi phạm lớn hơn 0 nghĩa là bot đó đang phớt lờ robots.txt của bạn.
Kiểm tra chất lượng: với mỗi bot có vi phạm, hãy xem "Most popular paths" (lọc theo các đường dẫn bị gắn cờ) để biết nó thực sự đang yêu cầu gì, và đánh giá xem nó có đang với tới nội dung mà bạn thực sự muốn bảo vệ hay không.
Đường khôi phục: nếu một bot phớt lờ tùy chọn đã công bố của bạn, chỉ riêng robots.txt sẽ không dừng được nó. Hãy dùng hành động "Enforce robots.txt rules" trong AI Crawl Control (đôi khi được gọi nội bộ là Robotcop) để biến quy tắc đã công bố thành một quy tắc WAF thực sự chặn bot không tuân thủ ngay ở biên Cloudflare trước khi nó chạm tới máy chủ gốc của bạn — bạn chuyển từ "đề nghị tuân thủ" sang "cưỡng chế tuân thủ". Bước này dùng WAF, nên tính khả dụng phụ thuộc vào việc gói của bạn có quyền truy cập WAF hay không.
Bước 5: Quyết định chặn thẳng hay thu phí truy cập
Nếu quyết định về huấn luyện của bạn là "không cho truy cập để huấn luyện", bạn có một lựa chọn thứ hai ngoài việc chặn hoàn toàn: thu phí.
Việc cần làm: nếu quan tâm, hãy đăng ký bản beta kín Pay Per Crawl của Cloudflare (qua trang đăng ký của Cloudflare, hoặc qua quản lý tài khoản nếu bạn là khách hàng Enterprise). Sau khi bật ở cấp tài khoản (Manage Account → Settings → Pay Per Crawl → đặt Visibility của tên miền thành Visible), bạn có thể đặt một mức giá cố định cho mỗi yêu cầu trên toàn zone và chọn cho từng bot: cho phép (miễn phí), thu phí (theo mức giá của bạn), hoặc chặn.
Kết quả mong đợi: khi một bot đã xác thực qua Web Bot Auth (yêu cầu có chữ ký Ed25519 định danh bot) yêu cầu một trang bạn đã đánh dấu là phải trả tiền, nó nhận HTTP 402 Payment Required kèm header crawler-price; nếu nó thử lại và đồng ý trả, hoặc gửi luôn header crawler-max-price bao được mức giá của bạn, nó nhận nội dung kèm header crawler-charged xác nhận khoản đã tính. Cloudflare đóng vai trò merchant of record và thực hiện việc thanh toán.
Kiểm tra chất lượng: cơ chế này chỉ hoạt động với những bot đã đăng ký thông tin thanh toán với Cloudflare và xử lý được luồng 402; nó không phải công tắc vạn năng áp cho mọi bot. Với tất cả phần còn lại, cài đặt thu phí của bạn hành xử giống như chặn trên thực tế — Cloudflare lưu ý rằng dù sao nó cũng là tín hiệu cho thấy bạn sẵn sàng cho một quan hệ có trả tiền trong tương lai.
Đường khôi phục: tính năng này đang trong beta kín; nếu bạn không được nhận hoặc không muốn chờ, Không cho phép huấn luyện AI hoặc Chặn vẫn là lựa chọn hiện có cho chính những bot đó.
Xử lý ngoại lệ: khi một nhà vận hành AI cụ thể xin quyền truy cập
Một công ty AI có thể liên hệ với bạn — đề nghị hợp tác, thỏa thuận trích dẫn, đàm phán cấp phép — và muốn quyền truy cập rõ ràng nằm ngoài chính sách toàn zone.
Có hai cách cấp một ngoại lệ hẹp mà không phải mở lại cả nhóm:
- Ghi đè theo từng bot trong Manage AI crawlers: đổi dòng của bot đó từ chặn/thu phí sang cho phép, bất kể cài đặt huấn luyện hay tác nhân ở cấp nhóm.
- Chỉnh sửa robots.txt bằng tay: nếu bạn đã tắt Bot Preference Sync (hoặc đang đặt ngoại lệ bên ngoài khối được quản lý), bạn có thể thêm một dòng Allow có mục tiêu cho đúng user agent đó, nằm dưới phần do Cloudflare quản lý.
Trong cả hai trường hợp, hãy giữ chính sách nhóm toàn zone làm mặc định và coi các ngoại lệ được nêu tên như những quyết định có chủ đích, đã được ghi lại — chứ không phải ngược lại.
Xác minh kết quả
Hãy đi qua danh sách này khi cấu hình đã có hiệu lực:
- [ ] Cài đặt bảo mật hiển thị giá trị rõ ràng, có chủ đích cho tìm kiếm, tác nhân và huấn luyện — không phải mặc định chưa từng xem lại
- [ ]
/robots.txttrên production hiển thị khối do Cloudflare quản lý khớp với những cài đặt đó - [ ] Tab Crawlers trong AI Crawl Control hiển thị các bot mong đợi, với số vi phạm bằng 0 hoặc gần 0 cho mọi thứ bạn đặt ở mức chặn/không cho phép
- [ ] Nếu bạn chọn Không cho phép huấn luyện AI, bạn đã xác nhận (qua Search Console / Bing Webmaster Tools, hoặc chỉ bằng cách theo dõi lưu lượng organic) rằng việc lập chỉ mục tìm kiếm của Googlebot / Applebot vẫn diễn ra bình thường
- [ ] Nếu bạn bật thực thi robots.txt (Robotcop), quy tắc WAF tạo ra đã được triển khai và đang hoạt động, chứ không chỉ được tạo rồi bỏ ở dạng nháp
- [ ] Bạn đã ghi lại mình chọn cài đặt nào và vì sao, để lần rà soát sau không phải bắt đầu lại từ con số không
Duy trì kết quả
Đây không phải cấu hình "đặt rồi quên". Hãy quay lại với nó theo nhịp nhẹ nhàng:
- Hàng tháng: xem tab Metrics trong AI Crawl Control để phát hiện bot mới chưa có chính sách, và kiểm tra lại các con số vi phạm.
- Khi Bing phát hành hỗ trợ tùy chọn huấn luyện cho Bingbot (Microsoft nhắm tới đầu năm 2027): đánh giá lại xem cấu hình hiện tại của bạn có còn tạo ra kết quả mong muốn — giữ tìm kiếm, chặn huấn luyện — hay không, vì đó là thời điểm Bing bắt kịp hành vi hiện tại của Google và Apple.
- Mỗi khi trạng thái kiếm tiền từ quảng cáo của bạn thay đổi: thêm hoặc bỏ quảng cáo hiển thị sẽ làm thay đổi việc các trang của bạn rơi vào đường mặc định nào, và việc xác nhận rằng các cài đặt rõ ràng của bạn vẫn hợp lý trong điều kiện đó là điều nên làm.
Câu hỏi thường gặp
Chặn bot huấn luyện có làm hại thứ hạng SEO của tôi không? Không, nếu bạn dùng Không cho phép huấn luyện AI thay vì Chặn. Không cho phép huấn luyện AI được tạo ra chính để các bot hỗn hợp có trách nhiệm giải trình (Google, Apple và sau này là Bing) vẫn lập chỉ mục cho tìm kiếm trong khi bỏ qua huấn luyện. Còn Chặn đơn thuần giờ cũng chặn hành vi tìm kiếm của chính những bot đó, gây hại cho khả năng hiển thị của bạn trong các sản phẩm tìm kiếm của họ.
Tôi đã bật "Block AI Bots" từ trước ngày 15 tháng 9. Cài đặt của tôi bị làm sao? Cloudflare đã tự động di trú nó: Block AI Bots cũ trở thành huấn luyện = Không cho phép huấn luyện AI, tìm kiếm = Cho phép, và tác nhân = Chặn trên các trang quảng cáo. Hãy làm Bước 1 ở trên để xem kết quả thực tế có đúng như mong đợi hay không, thay vì giả định rằng việc di trú khớp với ý định của bạn.
Có phần nào trong số này dùng được ở gói miễn phí không? Có. AI Crawl Control, cài đặt nhóm tìm kiếm/tác nhân/huấn luyện và Bot Preference Sync đều hoạt động ở mọi gói, kể cả gói miễn phí. Một số chi tiết thực thi phụ thuộc vào gói — ví dụ việc thực thi robots.txt chạy qua WAF, và khả năng nhận diện bot ở gói miễn phí dựa trên chuỗi user agent thay vì định danh phát hiện tiên tiến hơn của Bot Management.
AI Crawl Control khác gì với cài đặt bảo mật bot AI? Cài đặt bảo mật là nơi bạn đặt chính sách (cho phép / chặn trên các trang quảng cáo / chặn / không cho phép huấn luyện AI cho từng nhóm). AI Crawl Control là nơi bạn kiểm tra điều thực sự đang diễn ra — số yêu cầu theo từng bot, vi phạm robots.txt, chi tiết ở cấp đường dẫn — và cũng là nơi bạn có thể biến chính sách robots.txt đã công bố thành quy tắc WAF được thực thi.
Sau khi cấu hình xong, tôi có phải tự chỉnh sửa robots.txt không? Không, nếu Bot Preference Sync đang bật: nó ghi và duy trì khối robots.txt khớp với cài đặt trên bảng điều khiển của bạn. Bạn chỉ cần chỉnh sửa bằng tay cho những ngoại lệ riêng lẻ với một nhà vận hành cụ thể, nằm ngoài các nhóm được quản lý.
Tác giả: Julian Mercer, chuyên gia technical SEO với 14 năm kinh nghiệm tại Auspia. Anh viết về khả năng thu thập dữ liệu, dữ liệu có cấu trúc, khả năng render và những nền tảng kỹ thuật giúp nội dung dễ đọc với AI.