Cosa avrai al termine di questa guida
Alla fine di questa guida il tuo dominio su Cloudflare avrà una policy esplicita e deliberata per le tre categorie separate di traffico dei bot AI — ricerca (Search), agenti (Agent) e addestramento (Training) — invece dell'impostazione predefinita che il tuo dominio si è ritrovato. Saprai esattamente quali crawler sono ammessi, quali bloccati e su quali pagine, con robots.txt e regola di applicazione all'edge realmente coerenti tra loro.
A chi è rivolta: a chiunque gestisca un sito dietro Cloudflare — editori, siti marketing di SaaS, negozi e-commerce, blog — e voglia decidere in autonomia se i sistemi di AI possono addestrarsi sui suoi contenuti, riassumerli o accedervi tramite agenti, invece di ereditare l'impostazione scelta dalla piattaforma.
Cosa ti serve:
- Un dominio proxato tramite Cloudflare (qualsiasi piano, incluso quello gratuito; alcuni passaggi qui sotto sono esclusivi dei piani a pagamento e sono segnalati)
- Accesso alla dashboard con permesso almeno di modificare le impostazioni di sicurezza a livello di dominio
- Da 20 a 30 minuti per verificare e configurare; poi qualche minuto al giorno o alla settimana per il monitoraggio
Definizione di completato: le impostazioni di sicurezza della tua zona mostrano una scelta deliberata (non un valore predefinito non verificato) per ricerca, agenti e addestramento; il /robots.txt in produzione riflette quella scelta; e hai confermato in AI Crawl Control che i bot che dovevano essere bloccati lo sono davvero.
Perché è diventato importante all'improvviso: cosa è cambiato il 15 settembre
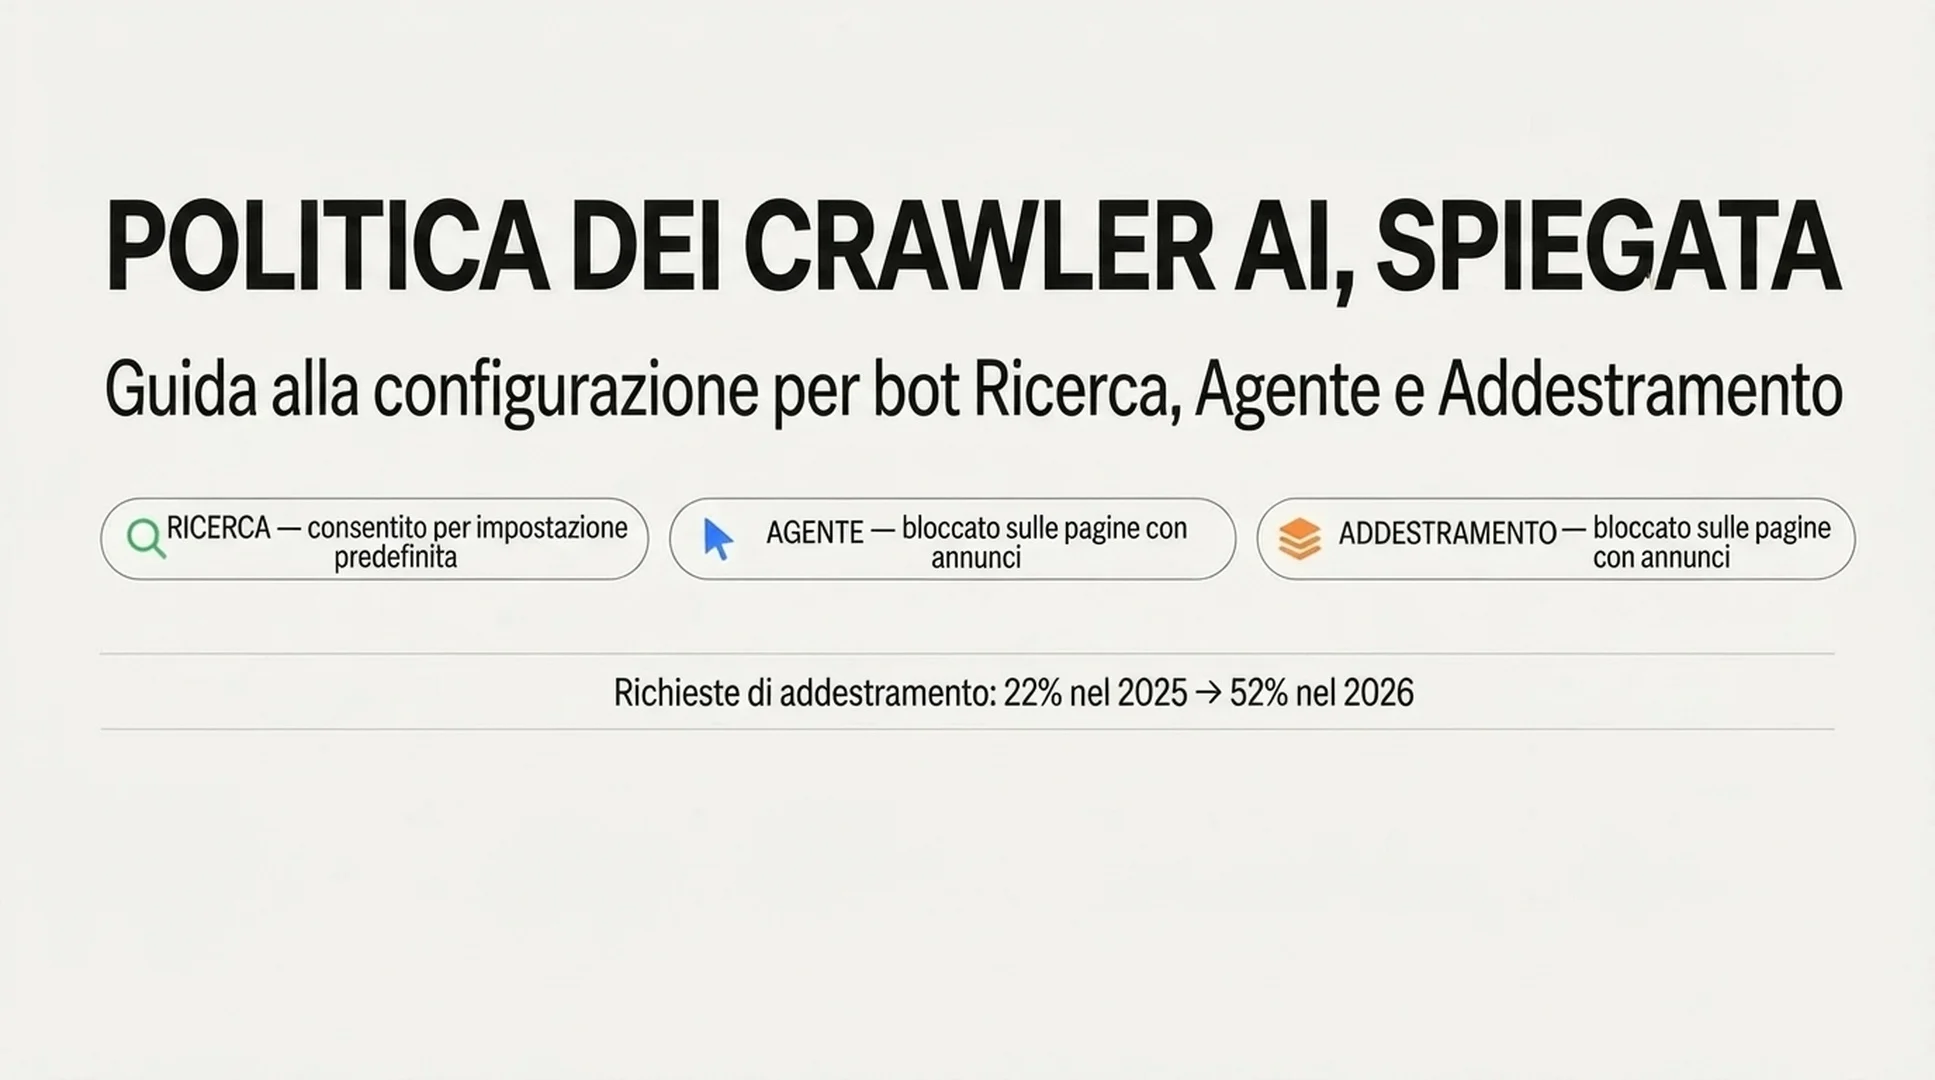
Cloudflare ha costruito i suoi controlli sul traffico AI per tappe, iniziando dall'aggiunta della Content Signals Policy al robots.txt a settembre 2025 e arrivando al lancio del «Content Independence Day» il 1° luglio 2026, che per la prima volta ha separato il comportamento dei bot AI in tre categorie con un nome, invece di un unico grossolano interruttore «è AI o non è AI»:
- Ricerca (Search) — scansione che costruisce un indice di ricerca e poi restituisce link o brevi estratti. Nelle parole di Cloudflare stessa, è il traffico che dovrebbe portarti citazioni.
- Agente (Agent) — attività automatizzata che agisce per conto di una persona in tempo reale, come un assistente di chat che recupera una pagina o un agente browser che completa un'attività.
- Addestramento (Training) — scansione per addestrare o mettere a punto un modello, in cui il tuo contenuto viene assorbito in modo permanente nei pesi del modello invece di tornare da te come link.
Il 15 settembre 2026 Cloudflare ha cambiato ciò che accade automaticamente. Per qualsiasi dominio che entra in Cloudflare in quella data o dopo, se il sito è contrassegnato come monetizzato con pubblicità, il valore predefinito diventa:
Categoria | Predefinito sulle pagine con pubblicità |
|---|---|
Ricerca (Search) | Consenti |
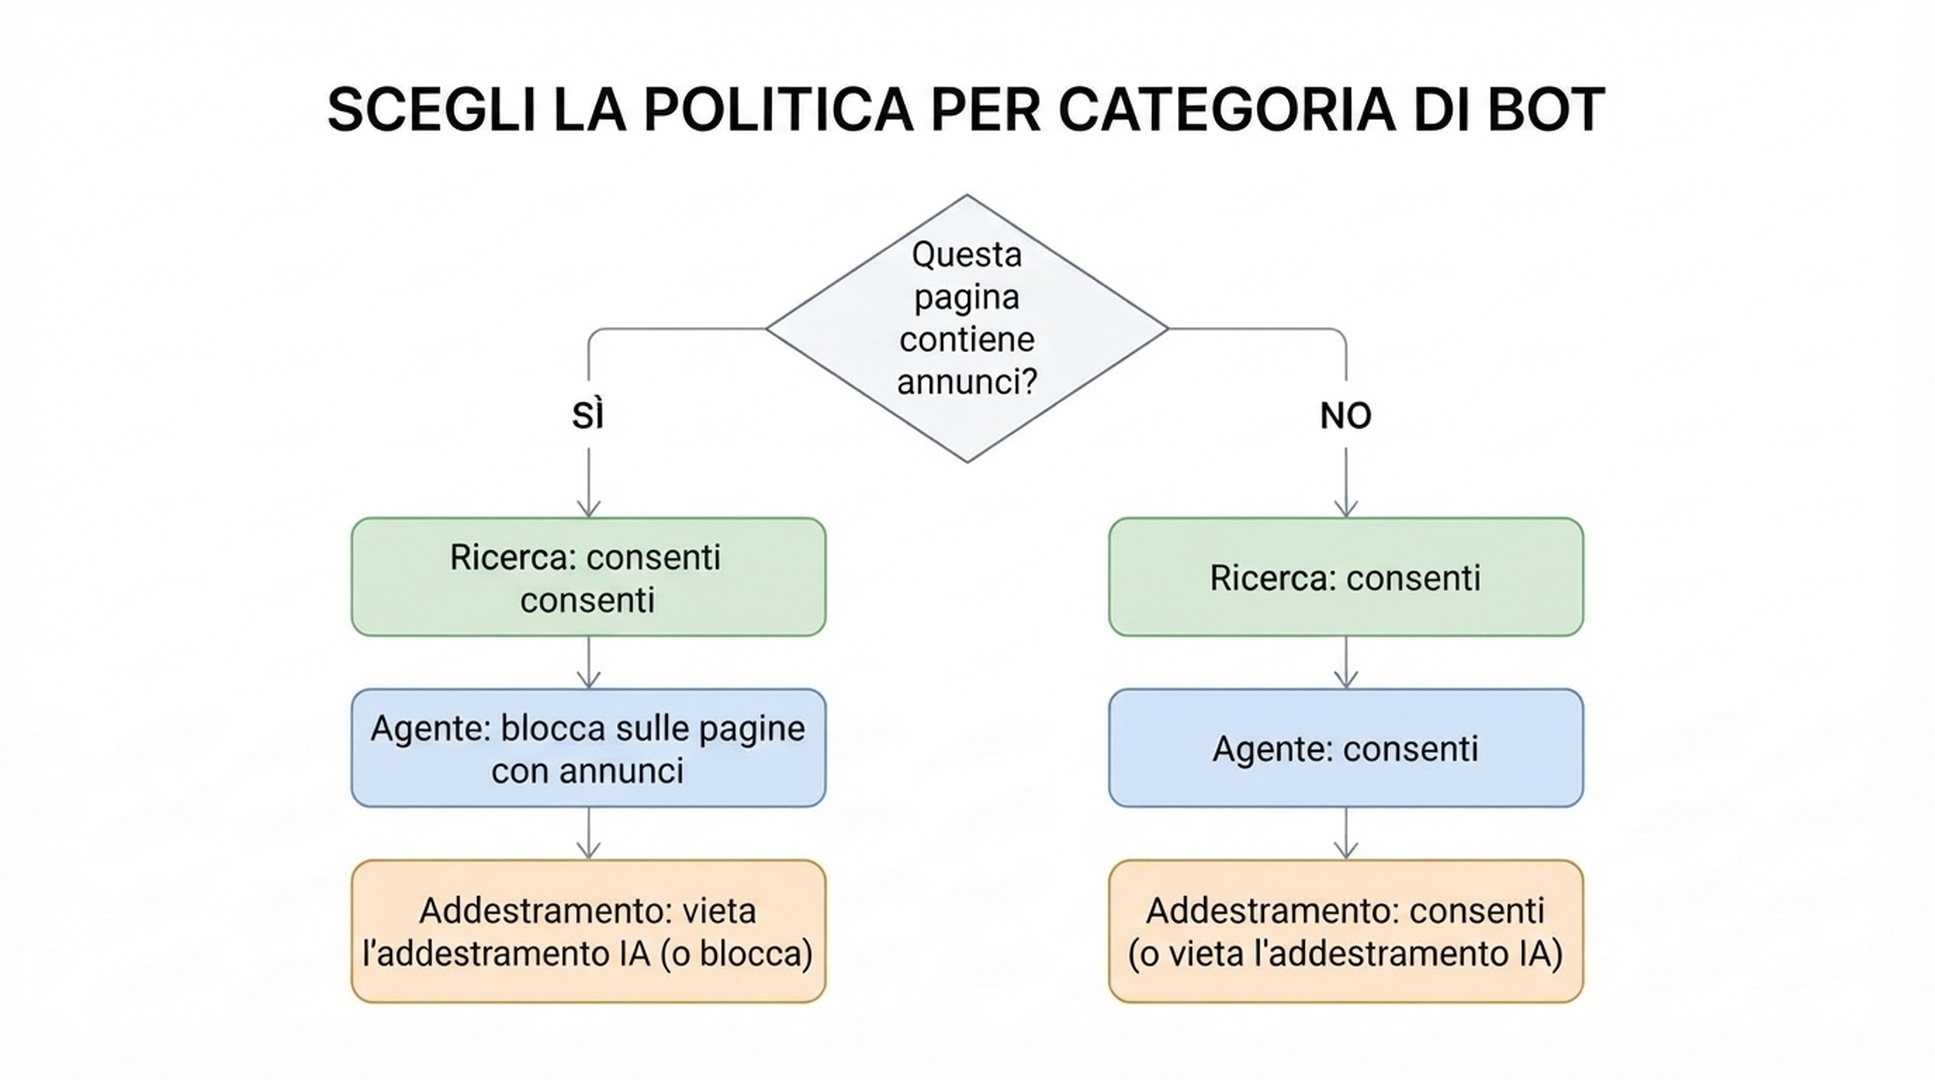
Agente (Agent) | Blocca sulle pagine con pubblicità |
Addestramento (Training) | Non consentire l'addestramento AI (Disallow AI Training) |
I nuovi domini senza monetizzazione pubblicitaria ricevono Consenti su tutte e tre le categorie per impostazione predefinita. I clienti esistenti non sono stati commutati in silenzio — Cloudflare ha concesso una finestra prima del 15 per rinunciare tramite dashboard, e le regole di migrazione reali per dominio si sono rivelate più sfumate di un unico nuovo valore predefinito (le dettagliamo sotto).
Il motivo per cui le pagine con pubblicità ricevono un predefinito più severo è che la presenza di annunci sulla pagina è un segnale che quella pagina era pensata per essere vista da una persona. Secondo i dati della stessa Cloudflare, a giugno 2026 i crawler a uso misto — quelli che combinano indicizzazione di ricerca, richieste di agenti e addestramento sotto un unico user agent — rappresentavano oltre il 36% del traffico verificato dei crawler, la categoria singola più ampia. E la quota di addestramento AI sul totale delle richieste dei crawler nella rete Cloudflare è salita da circa il 22% nella primavera 2025 al 52% a giugno 2026. È contro questo traffico che punta il cambiamento.
Prima di iniziare: tre cose da capire sulle categorie
1. Alcuni crawler sono a uso misto e si comportano diversamente sotto blocco e sotto divieto di addestramento. Googlebot, Bingbot e Applebot fanno doppio lavoro — scansionano sia per la ricerca sia per l'addestramento sotto lo stesso user agent. Cloudflare definisce Apple, Google e Microsoft operatori «Accountable» (responsabili) perché soddisfano quattro condizioni: rispettano la preferenza di non addestrare nel robots.txt, offrono un modo per rifiutare i riassunti fatti dall'AI, danno visibilità a livello di URL su cosa è stato usato per l'addestramento e sanno dimostrare che rifiutare l'addestramento non danneggia la tua presenza nella ricerca.
2. «Non consentire l'addestramento AI» e «Blocca» non sono la stessa impostazione, e la differenza è proprio il punto. Non consentire l'addestramento AI pubblica nel robots.txt una preferenza Disallow rivolta a user agent specifici per l'addestramento (come Google-Extended e Applebot-Extended). I crawler a uso misto che sono responsabili leggono quella preferenza e continuano volontariamente a scansionare per la ricerca, saltando l'addestramento — così la tua presenza nella ricerca resta intatta. Gli altri crawler di addestramento che non appartengono a operatori responsabili vengono bloccati subito all'edge, e questo non tocca la ricerca, perché quegli operatori gestiscono bot di addestramento separati. Il semplice Blocca, invece, ora blocca gli stessi Googlebot, Bingbot e Applebot, il che significa che i tuoi contenuti spariscono anche dai loro risultati di ricerca. Se vuoi far sparire l'addestramento e tenerti la ricerca, l'impostazione giusta è «Non consentire l'addestramento AI», non «Blocca».
3. Bing non rispetta ancora la preferenza di addestramento nel robots.txt. Oggi sia Applebot sia Googlebot ottemperano alla direttiva Disallow specifica per l'addestramento. Microsoft dichiara di stare costruendo un meccanismo equivalente per Bingbot, con obiettivo ai primi del 2027. Fino ad allora, scegliere «Non consentire l'addestramento AI» scriverà la tua preferenza nel robots.txt, ma il comportamento di scansione di Bing a fini di addestramento non cambierà solo per quel segnale — il meta tag NOARCHIVE di Bing o il suo strumento Content Removal restano le leve temporanee se la tua preoccupazione riguarda nello specifico l'addestramento via Bing.
Passo 1: Scopri dove è finito davvero il tuo sito
Non dare per scontato di conoscere l'impostazione attuale — verificala.
Azione: nella dashboard Cloudflare apri il tuo dominio, vai su Security → Settings e trova i controlli della policy per i bot AI (l'interfaccia più recente a tre categorie ha sostituito il vecchio interruttore unico «Block AI Bots», ma gli account non ancora migrati possono ancora mostrare l'interruttore vecchio). A parte, recupera il robots.txt in produzione dal browser o con curl https://yourdomain.com/robots.txt e cerca un blocco che inizi con un commento marcatore gestito da Cloudflare; puoi anche confrontarlo con il verificatore di crawler AI nel robots.txt di Auspia per vedere come le tue regole attuali vengono lette dai crawler AI.
Risultato atteso: tre impostazioni, una per ricerca, una per agenti e una per addestramento, ciascuna in Consenti / Blocca sulle pagine con pubblicità / Blocca (con «Non consentire l'addestramento AI» come quarta opzione, esclusiva dell'addestramento). Il robots.txt in produzione dovrebbe mostrare una sezione gestita da Cloudflare con l'elenco degli user agent specifici e le righe Disallow / Content-Signal, se Bot Preference Sync o il robots.txt gestito sono attivi.
Controllo di qualità: verifica che le tre impostazioni corrispondano a ciò che vuoi davvero, e non a ciò che la migrazione ha dato per scontato al posto tuo. La logica di migrazione per i clienti esistenti documentata da Cloudflare è questa: se avevi attivato il vecchio interruttore «Block AI», sei stato spostato su addestramento = Non consentire l'addestramento AI, ricerca mantenuta su Consenti e agente impostato su Blocca sulle pagine con pubblicità. Se avevi impostato l'addestramento stesso su Blocca o Blocca sulle pagine con pubblicità, sei stato spostato su Non consentire l'addestramento AI. Entrambi i percorsi di migrazione presuppongono che tu volessi conservare la ricerca. Se in realtà volevi che i crawler a uso misto sparissero del tutto, ricerca compresa, non è il tuo stato attuale, e devi scegliere Blocca esplicitamente.
Percorso di recupero: se le impostazioni di sicurezza mostrano solo il vecchio interruttore «Block AI Bots» senza la divisione in tre categorie, il tuo account non è ancora migrato ai nuovi controlli. Cerca «Configure AI bot policies», una superficie di impostazioni separata e più recente: è lì che i controlli dettagliati convivono con l'interruttore vecchio durante la transizione, ed è lì che punta il futuro.
Passo 2: Decidi la policy categoria per categoria, non con un'unica risposta generica
Questo è il vero passaggio decisionale. Percorri ogni categoria separatamente.
Ricerca. Quasi nessuno la blocca — Cloudflare riporta che meno dell'1% dei siti sceglie di bloccare i bot di ricerca — perché perdere visibilità nella ricerca non vale quasi mai il prezzo. Imposta Consenti come predefinito, a meno che tu non abbia un motivo specifico (un ambiente di test, un archivio dietro un paywall) per tenere il sito fuori dagli indici di ricerca.
Agenti. Sono bot che agiscono in tempo reale per conto di qualcuno che sta cercando di fare qualcosa sul tuo sito proprio adesso: controllare un prezzo, completare una prenotazione, estrarre un dato per una risposta in chat. Bloccare il traffico degli agenti sulle pagine monetizzate o con pubblicità è la ragione dietro il nuovo predefinito, perché una visita di un agente non genera l'impression pubblicitaria che genererebbe una visita umana. Se il tuo modello di business dipende da quell'attenzione umana (media, siti di contenuti con display ad), Blocca sulle pagine con pubblicità è una posizione difendibile. Se invece preferisci che gli agenti possano completare attività sul tuo sito anche sulle pagine con pubblicità — per esempio perché il traffico degli agenti ti converte comunque — scegli Consenti.
Addestramento. Qui sta la decisione vera, ed è qui che la terminologia confonde:
- Scegli Non consentire l'addestramento AI se vuoi impedire che i contenuti vengano usati per addestrare modelli mantenendo la presenza nei prodotti di ricerca di Google, Bing e Apple (visto l'attuale ritardo di Bing, intendilo come «oggi vale per Google e Apple, in sospeso per Bing»). È la via di mezzo raccomandata da Cloudflare, creata apposta per il compromesso tra ricerca e addestramento.
- Scegli Blocca solo se sei disposto a perdere del tutto la scansione di ricerca di Googlebot, Bingbot e Applebot come prezzo per bloccare il loro comportamento in modalità addestramento. Ora è l'opzione severa: dal 15 settembre il blocco si applica anche ai crawler a uso misto, cosa che prima non accadeva.
- Scegli Consenti solo se accetti deliberatamente che i tuoi contenuti addestrino modelli di AI, per esempio perché vuoi massimizzare la visibilità nelle risposte AI e consideri l'addestramento un prezzo accettabile.
Azione: in Security → Settings → Configure AI bot policies imposta i tre menu secondo la tua decisione.
Risultato atteso: la dashboard dovrebbe riflettere la tua scelta esplicita in ogni categoria e (se Bot Preference Sync è attivo) iniziare a pubblicare automaticamente il blocco robots.txt corrispondente — senza modifiche manuali ai file.
Controllo di qualità: rileggi la tua decisione sull'addestramento con una sola domanda: «Voglio conservare la mia visibilità nella ricerca o no?» Se sì, allora è Non consentire l'addestramento AI, non Blocca, per quanto il termine «Blocca» suoni allettante per fermare l'addestramento AI.
Percorso di recupero: se il traffico di ricerca è calato dopo che hai scelto un'impostazione, controlla se hai selezionato Blocca invece di Non consentire l'addestramento AI. È l'errore autolesionistico più comune qui: il nome fa sembrare «Blocca» l'opzione che «fa di più», ma per l'addestramento fa ciò che potresti non volere, cioè portarsi via anche la ricerca.
Passo 3: Attiva Bot Preference Sync perché il robots.txt segua le tue impostazioni
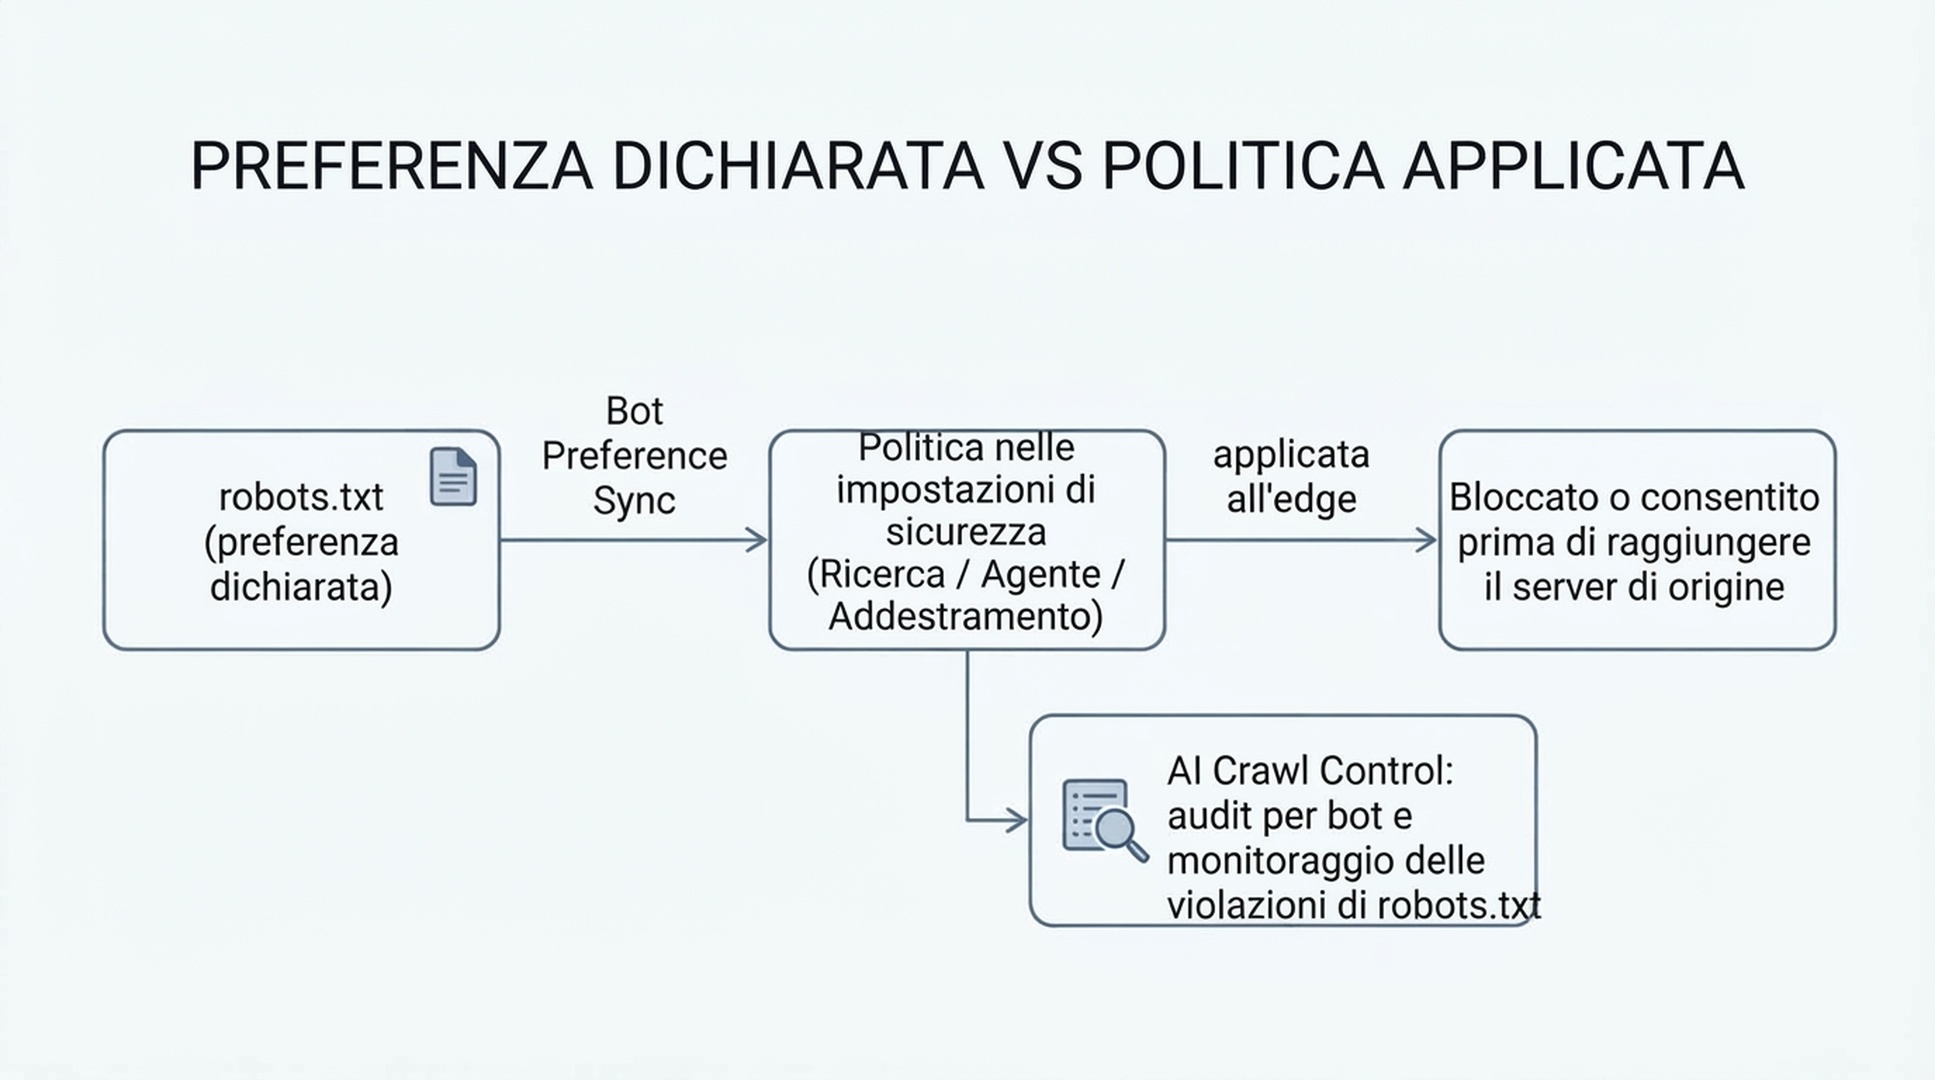
L'impostazione nella dashboard e il file robots.txt sono due sistemi distinti, e quando divergono alcuni crawler usano quello scarto come scusa per ignorare la tua preferenza. Bot Preference Sync di Cloudflare colma questa lacuna generando il tuo robots.txt direttamente dalle impostazioni di sicurezza che hai scelto.
Azione: nella stessa area di impostazioni della policy per i bot AI, attiva Bot Preference Sync (è attivo per impostazione predefinita sui nuovi clienti; i clienti esistenti che usano la funzione più vecchia di robots.txt gestito verranno invitati a rivederlo e confermarlo durante la migrazione).
Risultato atteso: Cloudflare aggiunge in cima al tuo robots.txt un blocco gestito, racchiuso dai commenti # BEGIN Cloudflare Bot Preference Sync / # END, con l'elenco degli user agent interessati e delle loro regole Disallow — e non rimuove nessuna regola tua già presente nel robots.txt, che resta sotto il blocco gestito.
Controllo di qualità: recupera di nuovo /robots.txt dopo l'attivazione e verifica che il blocco gestito compaia e corrisponda alle scelte del Passo 2. Per esempio, se hai impostato l'addestramento su Non consentire l'addestramento AI, dovresti vedere gli user agent specifici per l'addestramento (Google-Extended, Applebot-Extended) con regole Disallow, mentre gli user agent generici Googlebot / Applebot / Bingbot restano non bloccati per la ricerca.
Percorso di recupero: se hai un accordo una tantum con un operatore di crawler specifico che una policy a livello di categoria romperebbe (per esempio un contratto di licenza di contenuti a pagamento), disattiva Bot Preference Sync e modifica a mano il tuo robots.txt: gli interruttori di categoria esistono per la policy dell'intera zona, non per eccezioni per singolo operatore.
Passo 4: Conferma che la policy venga davvero applicata, non solo richiesta
Il robots.txt, tecnicamente, è una richiesta: non ferma un crawler che lo ignora. Questo è il passaggio che le persone saltano, ed è quello che mostra se la tua decisione del Passo 2 è reale o solo teoria.
Azione: apri AI Crawl Control della tua zona (disponibile su tutti i piani, incluso quello gratuito — la qualità di rilevamento è migliore sui piani con Bot Management, ma le funzioni di visibilità funzionano ovunque). Guarda la scheda Crawlers, che elenca tutti i bot arrivati al tuo sito, con una colonna Robots.txt violations.
Risultato atteso: una tabella con il numero di richieste e il numero di violazioni per bot. Un numero di violazioni diverso da zero per un bot che hai impostato su non consentito o bloccato significa che quel bot sta ignorando il tuo robots.txt in questo momento.
Controllo di qualità: per ogni bot con violazioni, guarda «Most popular paths» (filtrando sui percorsi segnalati) per vedere cosa sta effettivamente richiedendo, e decidi se sta raggiungendo contenuti che tieni davvero a proteggere.
Percorso di recupero: se un bot ignora la preferenza che hai dichiarato, il solo robots.txt non lo fermerà. Usa l'azione «Enforce robots.txt rules» in AI Crawl Control (a volte chiamata con il nome interno Robotcop) per trasformare le regole dichiarate in una vera regola WAF che blocca il bot indisciplinato all'edge di Cloudflare prima che raggiunga il tuo server di origine — passi da «chiedere conformità» a «pretendere conformità». Questo passaggio usa il WAF, quindi la disponibilità dipende dall'accesso al WAF del tuo piano.
Passo 5: Decidi se limitarti a bloccare o farti pagare per l'accesso
Se la tua decisione sull'addestramento è stata «nessun accesso per l'addestramento», hai una seconda opzione oltre al blocco netto: farsi pagare.
Azione: se ti interessa, candidati alla beta chiusa di Pay Per Crawl di Cloudflare (tramite la pagina di iscrizione di Cloudflare o il tuo account manager se sei cliente Enterprise). Una volta abilitato a livello di account (Manage Account → Settings → Pay Per Crawl → imposta il Visibility del tuo dominio su Visible), puoi definire un prezzo fisso unico per richiesta per la zona e scegliere, per ogni crawler, tra consenti (gratis), addebita (al tuo prezzo) o blocca.
Risultato atteso: quando un crawler autenticato tramite Web Bot Auth (una richiesta con firma Ed25519 che identifica il crawler) chiede una pagina che hai contrassegnato come a pagamento, riceve un HTTP 402 Payment Required con l'header crawler-price; se riprova accettando di pagare, o include in anticipo un header crawler-max-price che copre il tuo prezzo, riceve il contenuto con l'header crawler-charged che conferma l'importo addebitato. Cloudflare agisce come merchant of record e gestisce la liquidazione.
Controllo di qualità: funziona solo contro crawler che hanno registrato dati di pagamento presso Cloudflare e supportano il flusso 402; non è un interruttore universale contro tutti i bot. Per tutto il resto, la tua impostazione di addebito si comporta in pratica come un blocco — Cloudflare osserva che serve comunque da segnale del fatto che sei aperto a un rapporto a pagamento in futuro.
Percorso di recupero: la funzione è in beta chiusa; se non vieni accettato o non vuoi aspettare, Non consentire l'addestramento AI o Blocca restano oggi disponibili per quegli stessi crawler.
Gestire l'eccezione: quando un operatore AI specifico chiede accesso
Potresti ricevere un approccio — una partnership, un accordo di citazione, una trattativa di licenza — da un'azienda di AI che vuole accesso esplicito al di fuori della policy dell'intera zona.
Ci sono due modi per concedere un'eccezione mirata senza riaprire l'intera categoria:
- Sovrascrivere per crawler in Manage AI crawlers: cambia la riga di quel bot da blocca/addebita a consenti, indipendentemente dalla tua impostazione di addestramento o agenti a livello di categoria.
- Modificare il robots.txt a mano: se hai disattivato Bot Preference Sync (o collochi l'eccezione fuori dal blocco gestito), puoi aggiungere un Allow mirato per quello specifico user agent sotto la sezione gestita da Cloudflare.
In entrambi i casi, mantieni la policy di categoria a livello di zona come predefinita e tratta le eccezioni con nome come decisioni deliberate e documentate — non il contrario.
Verifica il risultato
Percorri questa lista quando la configurazione è attiva:
- [ ] Le impostazioni di sicurezza mostrano valori espliciti e deliberati per ricerca, agenti e addestramento — non predefiniti non verificati
- [ ] Il
/robots.txtin produzione mostra un blocco gestito da Cloudflare che corrisponde a quelle impostazioni - [ ] La scheda Crawlers di AI Crawl Control mostra i bot che ti aspettavi, con violazioni pari a zero o quasi per tutto ciò che hai impostato su bloccato/non consentito
- [ ] Se hai scelto Non consentire l'addestramento AI, hai confermato (via Search Console / Bing Webmaster Tools, o semplicemente osservando il traffico organico) che la scansione di ricerca di Googlebot / Applebot prosegue normalmente
- [ ] Se hai attivato l'applicazione del robots.txt (Robotcop), la regola WAF risultante è distribuita e attiva, non solo creata e lasciata come bozza
- [ ] Hai documentato quale impostazione hai scelto e perché, così che una revisione futura non riparta da zero
Mantieni il risultato nel tempo
Non è una configurazione da impostare e dimenticare. Torna a rivederla con un ritmo leggero:
- Ogni mese: controlla la scheda Metrics di AI Crawl Control per individuare bot nuovi per cui non hai ancora definito una policy, e ricontrolla i conteggi delle violazioni.
- Quando Bing rilascerà il supporto alla preferenza di addestramento per Bingbot (Microsoft indica come obiettivo i primi del 2027): rivaluta se la tua configurazione attuale produce ancora il risultato voluto — conservare la ricerca e bloccare l'addestramento — perché è il momento in cui Bing raggiunge il comportamento attuale di Google e Apple.
- Ogni volta che cambia il tuo stato di monetizzazione pubblicitaria: aggiungere o togliere display ad cambia la corsia predefinita in cui cadono le tue pagine, e vale la pena riconfermare che le tue impostazioni esplicite restino sensate in quello scenario.
Domande frequenti
Bloccare i crawler di addestramento danneggerà il mio posizionamento SEO? No, se usi Non consentire l'addestramento AI invece di Blocca. Non consentire l'addestramento AI è stato creato apposta perché i crawler a uso misto responsabili (Google, Apple e in prospettiva Bing) continuino a scansionare per la ricerca saltando l'addestramento. Il semplice Blocca, invece, ora blocca anche il comportamento di ricerca di quegli stessi crawler, il che danneggerà la tua visibilità nei loro prodotti di ricerca.
Avevo già «Block AI Bots» attivo prima del 15 settembre. Che fine ha fatto la mia impostazione? Cloudflare l'ha migrata automaticamente: il vecchio Block AI Bots è diventato addestramento = Non consentire l'addestramento AI, ricerca = Consenti e agente = Blocca sulle pagine con pubblicità. Verifica con il Passo 1 qui sopra che il risultato reale sia come previsto, invece di dare per scontato che la migrazione abbia coinciso con la tua intenzione.
Qualcosa di tutto questo è disponibile sul piano gratuito? Sì. AI Crawl Control, le impostazioni di categoria ricerca/agenti/addestramento e Bot Preference Sync funzionano su tutti i piani, incluso quello gratuito. Alcuni dettagli di applicazione variano per piano — per esempio l'applicazione del robots.txt passa dal WAF, e il rilevamento dei bot sul piano gratuito si basa sulle stringhe di user agent invece che sull'identificatore di rilevamento più avanzato di Bot Management.
Qual è la differenza tra AI Crawl Control e le impostazioni di sicurezza per i bot AI? Le impostazioni di sicurezza sono il luogo in cui definisci la policy (consenti / blocca sulle pagine con pubblicità / blocca / non consentire l'addestramento AI per categoria). AI Crawl Control è il luogo in cui verifichi cosa accade davvero — numero di richieste per bot, violazioni del robots.txt, dettaglio per percorso — e dove puoi convertire la policy dichiarata nel robots.txt in una regola WAF applicata.
Devo modificare il robots.txt a mano dopo aver configurato tutto questo? No, se Bot Preference Sync è attivo: scrive e mantiene il blocco robots.txt appropriato partendo dalle tue impostazioni nella dashboard. La modifica manuale serve solo per eccezioni una tantum relative a un operatore specifico, al di fuori delle categorie gestite.
Autore: Julian Mercer, professionista di SEO tecnico con 14 anni di esperienza in Auspia. Scrive di scansionabilità, dati strutturati, rendering e delle basi tecniche che rendono i contenuti leggibili dall'AI.