इस गाइड को पूरा करने पर आपको क्या मिलेगा
इस गाइड को पूरा करने तक आपके Cloudflare डोमेन पर AI बॉट ट्रैफ़िक की तीन अलग श्रेणियों — Search (खोज), Agent (एजेंट) और Training (ट्रेनिंग) — के लिए एक स्पष्ट, जान-बूझकर चुनी गई नीति मौजूद होगी, उस डिफ़ॉल्ट के बजाय जो आपके डोमेन को विरासत में मिला था। आपको ठीक-ठीक पता होगा कि कौन-से बॉट अनुमत हैं, कौन-से अवरुद्ध हैं और किन पेजों पर, और आपकी robots.txt तथा एज पर लागू होने वाला नियम वास्तव में एक-दूसरे से मेल खाएँगे।
यह किसके लिए है: हर उस व्यक्ति के लिए जो Cloudflare के पीछे कोई वेबसाइट चलाता है — प्रकाशक, SaaS मार्केटिंग साइटें, ई-कॉमर्स स्टोर, ब्लॉग — और यह तय करना चाहता है कि AI सिस्टम उसकी सामग्री पर ट्रेनिंग कर सकते हैं, उसका सारांश बना सकते हैं, या एजेंटों के ज़रिए उसे पढ़ सकते हैं या नहीं, बजाय उस सेटिंग को विरासत में पाने के जो किसी प्लेटफ़ॉर्म ने चुनी हो।
आपको क्या चाहिए:
- Cloudflare के ज़रिए प्रॉक्सी किया गया एक डोमेन (कोई भी प्लान, फ़्री प्लान भी; नीचे कुछ चरण सशुल्क प्लान तक सीमित हैं और वहाँ यह स्पष्ट रूप से लिखा है)
- डैशबोर्ड तक ऐसी पहुँच जिसमें कम से कम ज़ोन-स्तर की सुरक्षा सेटिंग बदलने का अधिकार हो
- ऑडिट और कॉन्फ़िगरेशन के लिए 20 से 30 मिनट; उसके बाद निगरानी के लिए रोज़ या हर हफ़्ते कुछ मिनट
पूर्णता की परिभाषा: आपकी ज़ोन की सुरक्षा सेटिंग्स में खोज, एजेंट और ट्रेनिंग के लिए जान-बूझकर किया गया चुनाव दिखता हो (ना कि कोई अनदेखा किया गया डिफ़ॉल्ट); प्रोडक्शन /robots.txt उसी चुनाव को दर्शाता हो; और आपने AI Crawl Control में पुष्टि कर ली हो कि जिन बॉट्स को अवरुद्ध होना था, वे वास्तव में अवरुद्ध हो रहे हैं।
यह अचानक अहम क्यों हो गया: 15 सितंबर को क्या बदला
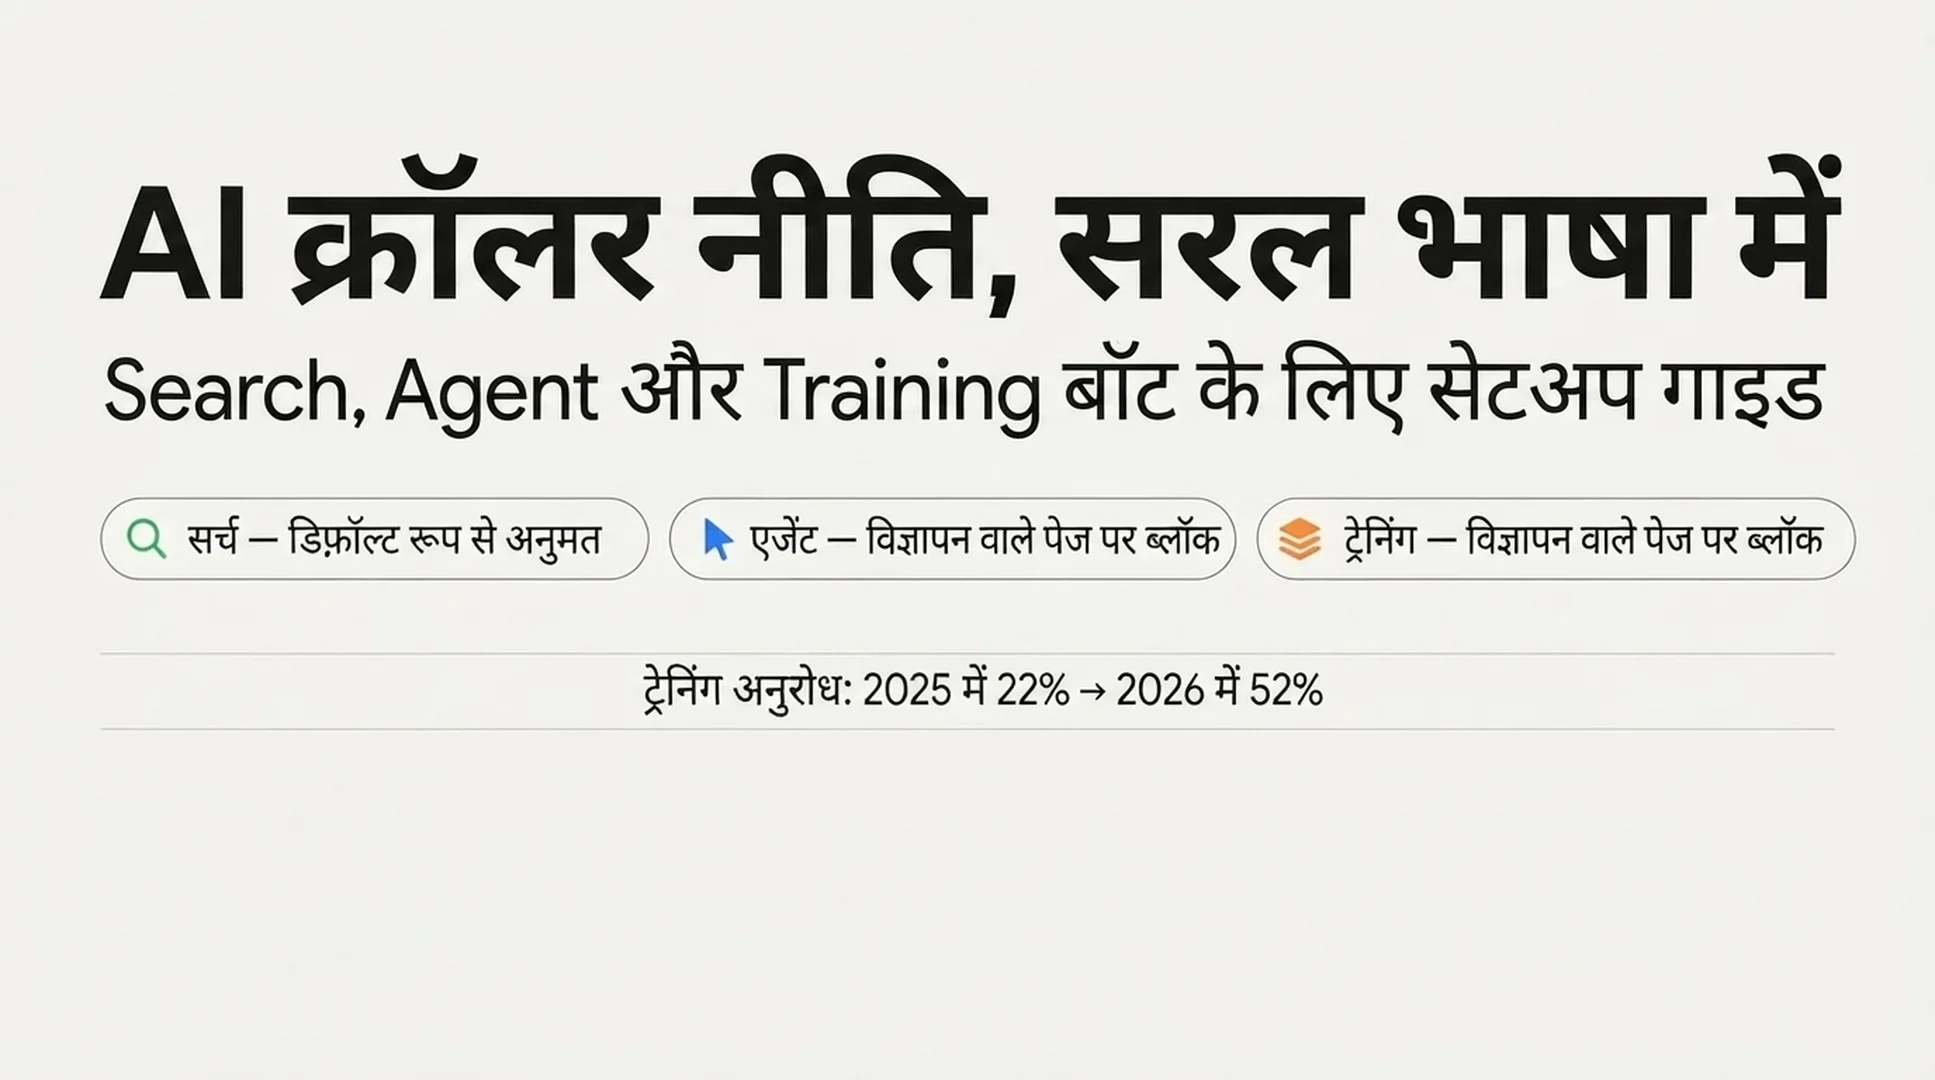
Cloudflare ने AI ट्रैफ़िक नियंत्रण को चरणों में बनाया: सितंबर 2025 में robots.txt में Content Signals Policy जोड़ने से लेकर 1 जुलाई 2026 के "Content Independence Day" तक, जिसने पहली बार AI बॉट व्यवहार को एक मोटे "AI है या नहीं" स्विच के बजाय तीन नामित श्रेणियों में बाँटा:
- Search (खोज) — वह क्रॉलिंग जो सर्च इंडेक्स बनाती है और फिर लिंक या छोटे स्निपेट लौटाती है। Cloudflare के अपने शब्दों में, यह वह ट्रैफ़िक है जो आपको रेफ़रल देने वाला है।
- Agent (एजेंट) — किसी के लिए रीयल-टाइम में काम करने वाली स्वचालित गतिविधि, जैसे कोई चैट असिस्टेंट पेज ला रहा हो या कोई ब्राउज़र एजेंट कोई काम पूरा कर रहा हो।
- Training (ट्रेनिंग) — मॉडल को प्रशिक्षित या फ़ाइन-ट्यून करने के लिए क्रॉलिंग, जिसमें आपकी सामग्री लिंक के रूप में लौटने के बजाय स्थायी रूप से मॉडल के वज़न में समा जाती है।
15 सितंबर 2026 को Cloudflare ने बदल दिया कि अपने-आप क्या होता है। उस दिन या उसके बाद Cloudflare से जुड़ने वाले हर डोमेन के लिए, अगर साइट को विज्ञापन-मुद्रीकृत के रूप में चिह्नित किया गया है, तो डिफ़ॉल्ट यह हो जाता है:
श्रेणी | विज्ञापन वाले पेजों पर डिफ़ॉल्ट |
|---|---|
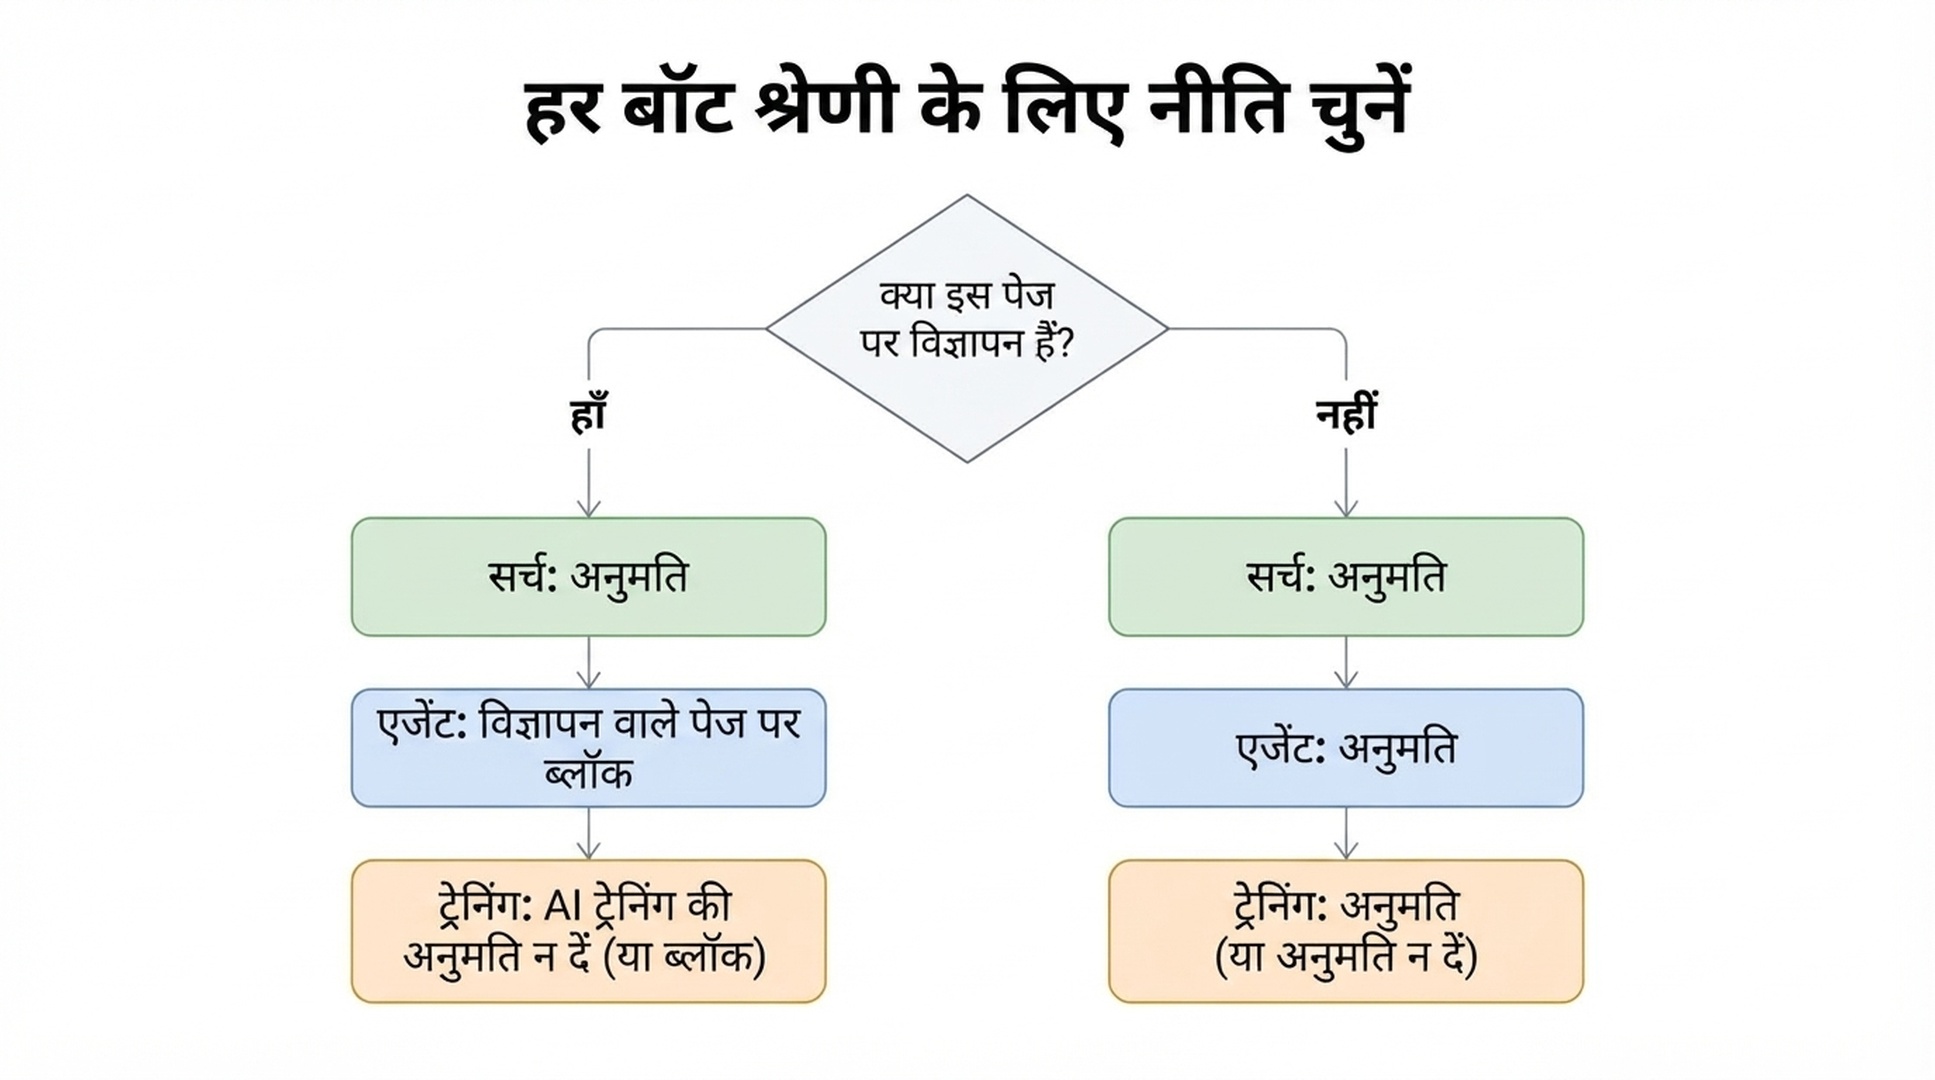
Search (खोज) | अनुमति दें |
Agent (एजेंट) | विज्ञापन वाले पेजों पर अवरुद्ध करें |
Training (ट्रेनिंग) | AI ट्रेनिंग की अनुमति न दें |
बिना विज्ञापन-मुद्रीकरण वाले नए डोमेन को तीनों श्रेणियों में डिफ़ॉल्ट रूप से "अनुमति दें" मिलता है। मौजूदा ग्राहकों को चुपचाप स्विच नहीं किया गया — Cloudflare ने 15 तारीख से पहले डैशबोर्ड के ज़रिए ऑप्ट-आउट की एक खिड़की दी, और प्रति-डोमेन माइग्रेशन नियम उस एक नई डिफ़ॉल्ट सेटिंग से कहीं ज़्यादा बारीक निकले (नीचे समझाया गया है)।
विज्ञापन वाले पेजों को सख़्त डिफ़ॉल्ट क्यों मिलता है, इसका कारण यह है कि पेज पर विज्ञापन होना इस बात का संकेत है कि उसे किसी इंसान ने देखा जाना था। Cloudflare के अपने आँकड़ों के मुताबिक जून 2026 में मिश्रित-उपयोग वाले क्रॉलर — वे जो एक ही user agent के तहत सर्च इंडेक्सिंग, एजेंट अनुरोध और ट्रेनिंग को जोड़ देते हैं — सत्यापित क्रॉलर ट्रैफ़िक का 36% से अधिक थे, यानी सबसे बड़ी एकल श्रेणी। और Cloudflare नेटवर्क पर कुल बॉट अनुरोधों में AI ट्रेनिंग का हिस्सा 2025 के वसंत के लगभग 22% से बढ़कर जून 2026 में 52% हो गया। यह बदलाव ठीक इसी ट्रैफ़िक को निशाना बनाता है।
शुरू करने से पहले: श्रेणियों के बारे में समझने योग्य तीन बातें
1. कुछ क्रॉलर मिश्रित-उपयोग वाले हैं और अवरोधन तथा ट्रेनिंग-निषेध पर अलग-अलग व्यवहार करते हैं। Googlebot, Bingbot और Applebot दोहरा काम करते हैं — वे एक ही user agent के तहत खोज और ट्रेनिंग, दोनों के लिए इंडेक्स करते हैं। Cloudflare Apple, Google और Microsoft को "Accountable" (जवाबदेह) ऑपरेटर कहता है, क्योंकि वे चार शर्तें पूरी करते हैं: वे robots.txt में ट्रेनिंग-निषेध वरीयता का पालन करते हैं, AI-जनित सारांशों से बाहर निकलने का रास्ता देते हैं, URL-स्तर पर दिखाते हैं कि ट्रेनिंग के लिए क्या इस्तेमाल हुआ, और यह प्रदर्शित कर सकते हैं कि ट्रेनिंग से हटने का आपकी खोज-उपस्थिति पर कोई असर नहीं पड़ता।
2. "AI ट्रेनिंग की अनुमति न दें" और "अवरुद्ध करें" एक ही सेटिंग नहीं हैं, और यही अंतर पूरे मामले की जड़ है। AI ट्रेनिंग की अनुमति न दें, robots.txt में केवल-ट्रेनिंग वाले user agents (जैसे Google-Extended और Applebot-Extended) को लक्षित करते हुए एक Disallow वरीयता प्रकाशित करता है। जवाबदेह मिश्रित-उपयोग वाले बॉट उस वरीयता को पढ़ते हैं और स्वेच्छा से ट्रेनिंग छोड़कर खोज के लिए इंडेक्सिंग जारी रखते हैं — इस तरह आपकी खोज-उपस्थिति बची रहती है। बाकी गैर-जवाबदेह ट्रेनिंग क्रॉलर को एज पर तुरंत अवरुद्ध कर दिया जाता है, जिससे खोज प्रभावित नहीं होती क्योंकि वे ऑपरेटर अलग ट्रेनिंग बॉट चलाते हैं। इसके उलट, सादा अवरुद्ध करें अब Googlebot, Bingbot और Applebot को भी अवरुद्ध करता है — यानी आपकी सामग्री उनके सर्च नतीजों से भी गायब हो जाती है। अगर आप ट्रेनिंग हटाना चाहते हैं पर खोज बनाए रखना चाहते हैं, तो सही सेटिंग "AI ट्रेनिंग की अनुमति न दें" है, "अवरुद्ध करें" नहीं।
3. Bing अभी भी robots.txt में ट्रेनिंग वरीयता का पालन नहीं करता। आज Applebot और Googlebot दोनों ट्रेनिंग-लक्षित Disallow निर्देश का पालन करते हैं। Microsoft कहती है कि वह Bingbot के लिए समान व्यवस्था बना रही है और उसका लक्ष्य 2027 की शुरुआत है। तब तक "AI ट्रेनिंग की अनुमति न दें" आपकी वरीयता robots.txt में दर्ज कर देगा, लेकिन Bing के ट्रेनिंग-क्रॉल व्यवहार में सिर्फ़ इस संकेत से बदलाव नहीं आएगा — अगर Bing की ट्रेनिंग आपको विशेष रूप से चिंतित करती है, तो Bing का खुद का NOARCHIVE मेटा टैग या उसका Content Removal टूल अभी अस्थायी साधन बने हुए हैं।
चरण 1: पता करें कि आपकी साइट वाकई कहाँ पहुँची है
यह मत मान लीजिए कि आपको मौजूदा सेटिंग पता है — उसे जाकर देखिए।
कार्रवाई: Cloudflare डैशबोर्ड में अपना डोमेन खोलिए, Security → Settings में जाइए और AI बॉट नीति के नियंत्रण खोजिए (तीन श्रेणियों वाला नया इंटरफ़ेस पुराने एकल "Block AI Bots" स्विच की जगह आया है, लेकिन जो खाते अब तक माइग्रेट नहीं हुए वे अब भी पुराना स्विच दिखा सकते हैं)। इससे अलग, प्रोडक्शन robots.txt ब्राउज़र में या curl https://yourdomain.com/robots.txt से लाइए और Cloudflare-प्रबंधित कमेंट मार्कर से शुरू होने वाले ब्लॉक को देखिए; या Auspia की robots.txt AI क्रॉलर चेकर से तुलना कीजिए ताकि दिखे कि आपके मौजूदा नियम AI क्रॉलरों की नज़र में कैसे पढ़े जाते हैं।
अपेक्षित नतीजा: तीन सेटिंग्स — खोज के लिए एक, एजेंट के लिए एक और ट्रेनिंग के लिए एक — हर एक पर अनुमति दें / विज्ञापन वाले पेजों पर अवरुद्ध करें / अवरुद्ध करें में से कोई मान (और चौथा विकल्प "AI ट्रेनिंग की अनुमति न दें", जो केवल ट्रेनिंग के लिए उपलब्ध है)। प्रोडक्शन robots.txt में Cloudflare-प्रबंधित हिस्सा दिखना चाहिए जिसमें अलग-अलग user agents और उनके Disallow / Content-Signal पंक्तियाँ हों, अगर Bot Preference Sync या प्रबंधित robots.txt चालू हैं।
गुणवत्ता जाँच: यह पक्का कीजिए कि तीनों सेटिंग्स वही कह रही हैं जो आप वास्तव में चाहते हैं, न कि वह जो माइग्रेशन ने आपके लिए मान लिया। मौजूदा ग्राहकों के लिए Cloudflare की प्रलेखित माइग्रेशन लॉजिक यह है: अगर आपने पहले पुराना "Block AI" स्विच चालू किया था, तो आप ट्रेनिंग = AI ट्रेनिंग की अनुमति न दें पर आ गए, खोज अनुमति दें पर ही रही, और एजेंट विज्ञापन वाले पेजों पर अवरुद्ध करें पर सेट हुआ। अगर आपने पहले खुद ट्रेनिंग को अवरुद्ध करें या विज्ञापन वाले पेजों पर अवरुद्ध करें पर सेट किया था, तो आप AI ट्रेनिंग की अनुमति न दें पर आ गए। दोनों माइग्रेशन रास्ते यह मानकर चलते हैं कि आप खोज बनाए रखना चाहते थे। अगर असल में आप चाहते थे कि मिश्रित-उपयोग वाले बॉट खोज समेत पूरी तरह गायब हो जाएँ, तो यह आपकी मौजूदा स्थिति नहीं है और आपको स्पष्ट रूप से अवरुद्ध करें चुनना होगा।
सुधार का रास्ता: अगर सुरक्षा सेटिंग्स में तीन श्रेणियों के विभाजन के बिना सिर्फ़ पुराना "Block AI Bots" स्विच दिखता है, तो आपका खाता अब तक नए नियंत्रणों पर माइग्रेट नहीं हुआ है। "Configure AI bot policies" खोजिए — यह एक अलग, नई सेटिंग स्क्रीन है; संक्रमण काल में बारीक नियंत्रण पुराने स्विच के साथ-साथ रहते हैं और भविष्य उसी तरफ़ जा रहा है।
चरण 2: हर श्रेणी के लिए अलग नीति तय करें, एक सामान्य जवाब नहीं
यह असली निर्णय-चरण है। हर श्रेणी को अलग-अलग लेकर चलिए।
खोज। इसे लगभग कोई अवरुद्ध नहीं करता — Cloudflare बताता है कि 1% से कम साइटें सर्च बॉट को अवरुद्ध करना चुनती हैं — क्योंकि खोज-दृश्यता खोने का नुक़सान लगभग कभी नहीं भरता। डिफ़ॉल्ट अनुमति दें रखिए, जब तक कोई ख़ास कारण न हो (स्टेजिंग वातावरण, पेवॉल के पीछे का संग्रह) कि साइट सर्च इंडेक्स से बाहर रहे।
एजेंट। ये वे बॉट हैं जो किसी के लिए उसी वक़्त कुछ कर रहे होते हैं जब वह आपकी साइट पर कुछ करने की कोशिश कर रहा है: कीमत देखना, कोई बुकिंग पूरी करना, चैट के जवाब के लिए कोई तथ्य निकालना। विज्ञापन वाले या मुद्रीकृत पेजों पर एजेंट ट्रैफ़िक अवरुद्ध करना नई डिफ़ॉल्ट सेटिंग का औचित्य है, क्योंकि एजेंट की विज़िट उस विज्ञापन इंप्रेशन को नहीं बनाती जो किसी इंसान की विज़िट बनाती। अगर आपका कारोबारी मॉडल उसी मानवीय ध्यान पर टिका है (मीडिया, डिस्प्ले विज्ञापन वाली सामग्री साइटें), तो विज्ञापन वाले पेजों पर अवरुद्ध करें रक्षात्मक रुख़ है। अगर आप चाहते हैं कि एजेंट विज्ञापन वाले पेजों पर भी आपकी साइट पर काम पूरे कर सकें — मसलन इसलिए कि एजेंट ट्रैफ़िक आपके लिए कन्वर्ट होता है — तो अनुमति दें चुनिए।
ट्रेनिंग। यहाँ असली फ़ैसला है और यहीं शब्दावली उलझन पैदा करती है:
- AI ट्रेनिंग की अनुमति न दें चुनिए अगर आप मॉडल ट्रेनिंग के लिए सामग्री के इस्तेमाल को रोकना चाहते हैं और साथ ही Google, Bing और Apple के सर्च उत्पादों में मौजूद रहना चाहते हैं (Bing की मौजूदा देरी को देखते हुए इसे ऐसे समझिए: "आज Google और Apple के लिए लागू, Bing के लिए लंबित")। यह Cloudflare का सुझाया मध्यमार्ग है, जो खोज और ट्रेनिंग के बीच संतुलन के लिए ही बनाया गया है।
- अवरुद्ध करें तभी चुनिए जब आप Googlebot, Bingbot और Applebot के ट्रेनिंग-व्यवहार को रोकने की कीमत के रूप में उनकी सर्च इंडेक्सिंग पूरी तरह खोने को तैयार हों। यह अब एक कठोर विकल्प है: 15 सितंबर से यह अवरोध मिश्रित-उपयोग वाले बॉट्स पर भी लागू होता है, जो पहले नहीं था।
- अनुमति दें तभी चुनिए जब आप जान-बूझकर यह स्वीकार कर रहे हों कि आपकी सामग्री AI मॉडलों को प्रशिक्षित करेगी — मसलन इसलिए कि आप AI जवाबों में अधिकतम दृश्यता चाहते हैं और ट्रेनिंग को इसकी स्वीकार्य कीमत मानते हैं।
कार्रवाई: Security → Settings → Configure AI bot policies में तीनों सूचियों को अपने फ़ैसले के मुताबिक सेट कीजिए।
अपेक्षित नतीजा: डैशबोर्ड में हर श्रेणी पर आपका स्पष्ट चुनाव दिखना चाहिए और (अगर Bot Preference Sync चालू है) उससे मेल खाता robots.txt ब्लॉक अपने-आप प्रकाशित होने लगना चाहिए — बिना फ़ाइल हाथ से संपादित किए।
गुणवत्ता जाँच: अपने ट्रेनिंग-फ़ैसले को एक सवाल से दोबारा जाँचिए: "क्या मुझे खोज में दिखना बनाए रखना है?" अगर हाँ, तो यह AI ट्रेनिंग की अनुमति न दें है, अवरुद्ध करें नहीं — भले ही "अवरुद्ध करें" शब्द AI ट्रेनिंग रोकने का ज़्यादा कारगर विकल्प लगे।
सुधार का रास्ता: अगर सेटिंग चुनने के बाद खोज ट्रैफ़िक गिर जाए, तो देखिए कि कहीं आपने AI ट्रेनिंग की अनुमति न दें के बजाय अवरुद्ध करें चुन लिया है या नहीं। यह यहाँ सबसे आम खुद को नुक़सान पहुँचाने वाली ग़लती है: नाम पढ़कर "अवरुद्ध करें" ज़्यादा काम करता हुआ लगता है, पर ट्रेनिंग के मामले में वह ऐसा करता है जो आप शायद नहीं चाहते — खोज भी छीन लेता है।
चरण 3: Bot Preference Sync चालू करें ताकि robots.txt आपकी सेटिंग्स के साथ चले
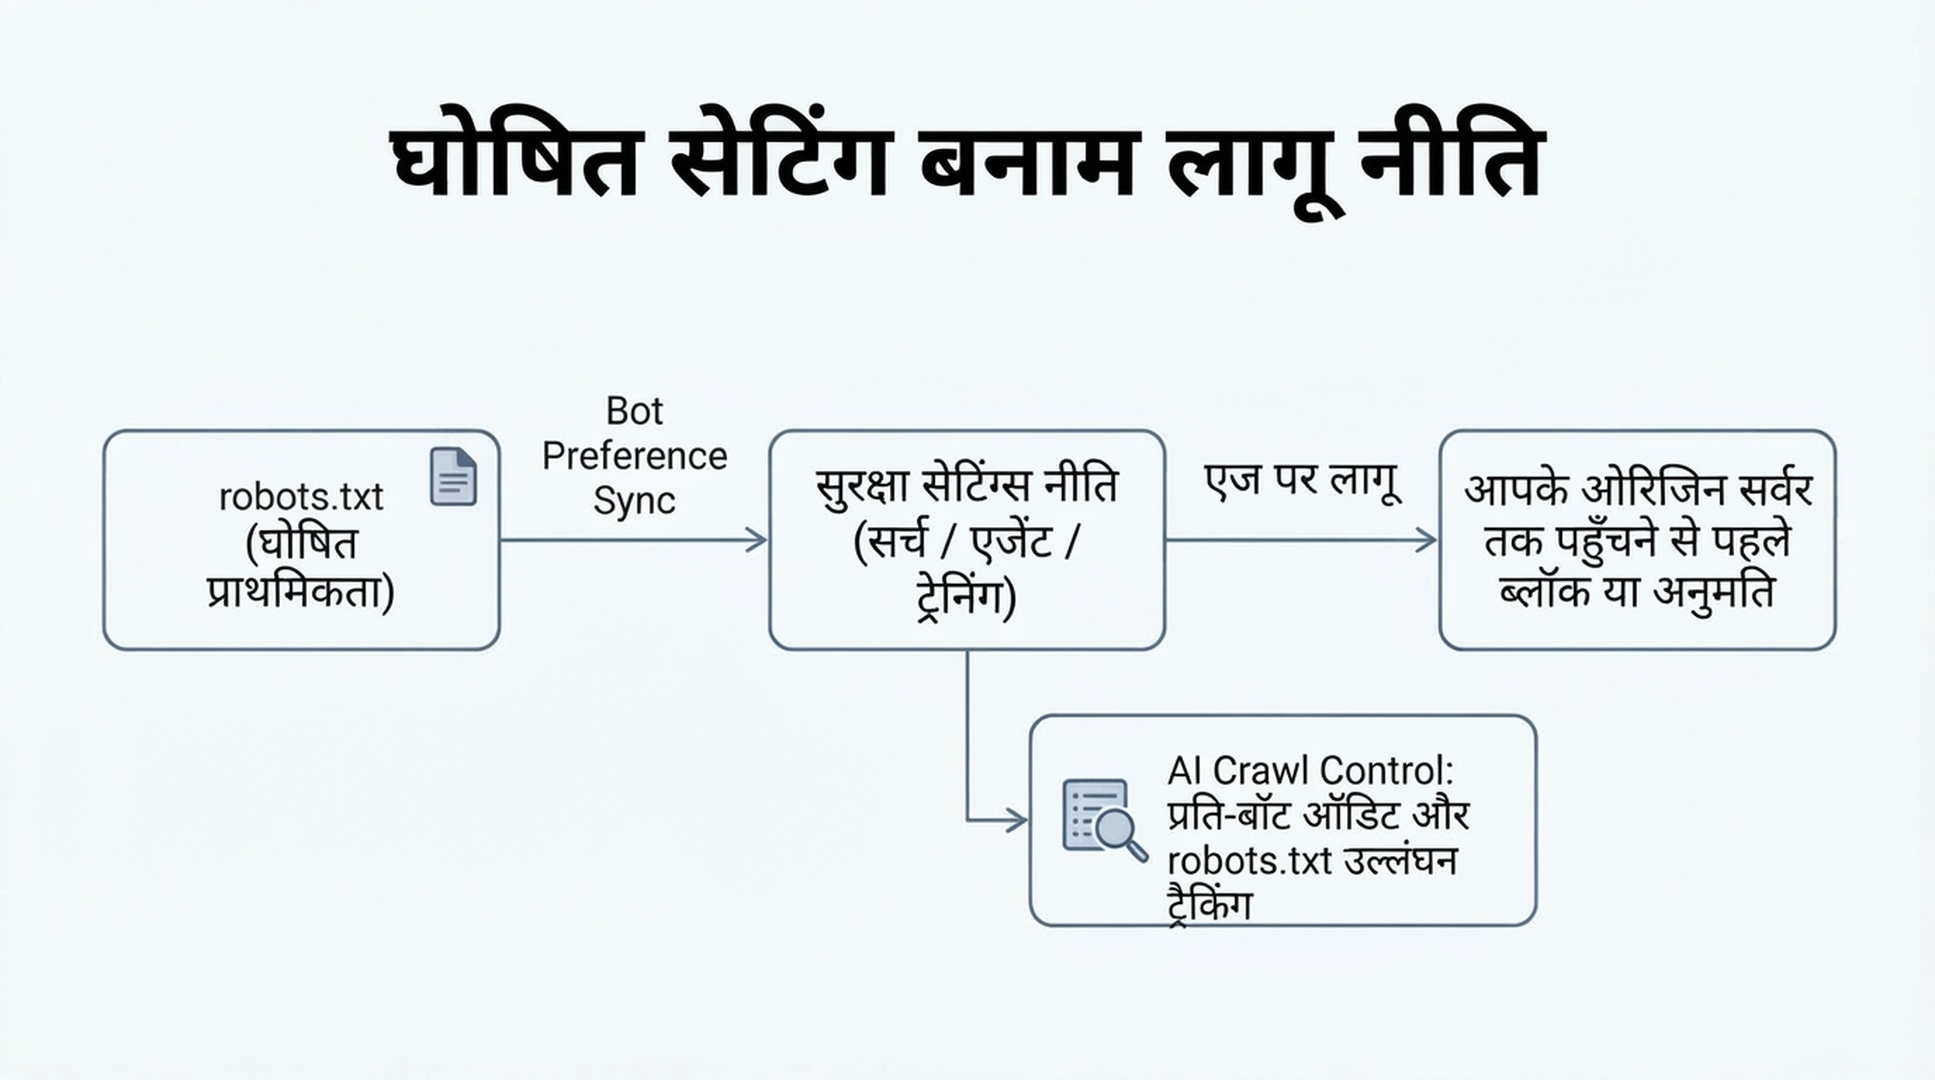
डैशबोर्ड सेटिंग और robots.txt फ़ाइल दो अलग सिस्टम हैं, और जब वे अलग-अलग हो जाते हैं, तो कुछ बॉट उसी अंतर को आपकी वरीयता न मानने का बहाना बना लेते हैं। Cloudflare का Bot Preference Sync यह अंतर भर देता है — वह आपके चुने हुए सुरक्षा नियंत्रणों से सीधे आपकी robots.txt जनरेट करता है।
कार्रवाई: उसी AI बॉट नीति क्षेत्र में Bot Preference Sync चालू कीजिए (नए ग्राहकों के लिए यह डिफ़ॉल्ट रूप से चालू है; पुरानी प्रबंधित robots.txt सुविधा इस्तेमाल करने वाले मौजूदा ग्राहकों से माइग्रेशन के दौरान इसे देखने और पुष्टि करने के लिए कहा जाएगा)।
अपेक्षित नतीजा: Cloudflare आपकी robots.txt के शीर्ष पर # BEGIN Cloudflare Bot Preference Sync / # END कमेंट्स में लिपटा एक प्रबंधित ब्लॉक जोड़ देता है, जिसमें शामिल user agents और उनके Disallow नियमों की सूची होती है — और आपकी खुद की लिखी कोई भी नियम हटाई नहीं जाती; वे प्रबंधित ब्लॉक के नीचे बनी रहती हैं।
गुणवत्ता जाँच: चालू करने के बाद /robots.txt दोबारा लाइए और देखिए कि प्रबंधित ब्लॉक आ गया है और चरण 2 के चुनावों से मेल खाता है। मसलन अगर आपने ट्रेनिंग को AI ट्रेनिंग की अनुमति न दें पर सेट किया है, तो आपको केवल-ट्रेनिंग वाले user agents (Google-Extended, Applebot-Extended) Disallow नियमों के साथ दिखने चाहिए, जबकि सामान्य Googlebot / Applebot / Bingbot खोज के लिए अनवरुद्ध रहने चाहिए।
सुधार का रास्ता: अगर किसी ख़ास बॉट ऑपरेटर के साथ आपका कोई एकबारगी विशेष करार है जिसे श्रेणी-स्तर की नीति तोड़ देगी (जैसे सामग्री लाइसेंसिंग का कोई सशुल्क सौदा), तो Bot Preference Sync बंद कीजिए और अपनी robots.txt हाथ से संपादित कीजिए: श्रेणी स्विच पूरे ज़ोन की नीति के लिए बने हैं, एकल ऑपरेटर के अपवादों के लिए नहीं।
चरण 4: पुष्टि करें कि नीति वाकई लागू हो रही है, सिर्फ़ कही नहीं जा रही
robots.txt तकनीकी रूप से एक विनती है: वह ऐसे बॉट को नहीं रोकेगी जो उसे अनदेखा कर दे। यही वह चरण है जो लोग छोड़ देते हैं, और यही दिखाता है कि चरण 2 का आपका फ़ैसला असली है या केवल काग़ज़ी।
कार्रवाई: अपने ज़ोन के लिए AI Crawl Control खोलिए (यह सभी प्लान में उपलब्ध है, फ़्री प्लान में भी — पहचान की गुणवत्ता Bot Management वाले प्लान में बेहतर होती है, पर दृश्यता सुविधाएँ हर जगह काम करती हैं)। Crawlers टैब देखिए, जिसमें वे सभी बॉट सूचीबद्ध हैं जो आपकी साइट तक पहुँचे, साथ में Robots.txt violations कॉलम भी।
अपेक्षित नतीजा: हर बॉट के लिए अनुरोध संख्या और उल्लंघन संख्या वाली एक तालिका। जिस बॉट को आपने अनुमति न दें या अवरुद्ध करें पर रखा है, उसके लिए शून्य से अधिक उल्लंघन का अर्थ है कि वह बॉट आपकी robots.txt को अनदेखा कर रहा है।
गुणवत्ता जाँच: जिन बॉट्स में उल्लंघन दिखें उनमें से हर एक के लिए "Most popular paths" देखिए (ध्वजांकित पथों पर फ़िल्टर लगाकर), ताकि पता चले कि वे असल में क्या माँग रहे हैं और क्या वे उन सामग्रियों तक पहुँच रहे हैं जिन्हें आप वाकई सुरक्षित रखना चाहते हैं।
सुधार का रास्ता: अगर कोई बॉट आपकी घोषित वरीयता अनदेखा करता है, तो अकेली robots.txt उसे नहीं रोकेगी। AI Crawl Control में "Enforce robots.txt rules" कार्रवाई इस्तेमाल कीजिए (जिसे आंतरिक रूप से कभी-कभी Robotcop कहा जाता है) ताकि घोषित नियम को एक असली WAF नियम में बदला जा सके जो न मानने वाले बॉट को आपके ओरिजिन सर्वर तक पहुँचने से पहले ही Cloudflare एज पर अवरुद्ध कर दे — यानी आप "अनुपालन की विनती" से "अनुपालन लागू करने" की ओर बढ़ते हैं। यह चरण WAF का उपयोग करता है, इसलिए उपलब्धता इस पर निर्भर है कि आपके प्लान में WAF की पहुँच है या नहीं।
चरण 5: तय करें कि सीधे अवरुद्ध करना है या पहुँच शुल्क लेना है
अगर आपका ट्रेनिंग फ़ैसला "ट्रेनिंग के लिए पहुँच नहीं" था, तो पूरी तरह अवरुद्ध करने के अलावा आपके पास दूसरा विकल्प भी है: शुल्क लेना।
कार्रवाई: अगर इसमें दिलचस्पी है तो Cloudflare के Pay Per Crawl बंद बीटा के लिए आवेदन कीजिए (Cloudflare के साइनअप पेज से, या अगर आप Enterprise ग्राहक हैं तो अपने अकाउंट प्रतिनिधि के ज़रिए)। अकाउंट स्तर पर चालू करने के बाद (Manage Account → Settings → Pay Per Crawl → अपने डोमेन की Visibility को Visible पर सेट कीजिए) आप पूरे ज़ोन के लिए प्रति अनुरोध एक सपाट कीमत तय कर सकते हैं और हर बॉट के लिए चुन सकते हैं: अनुमति दें (मुफ़्त), शुल्क लें (आपकी कीमत पर), या अवरुद्ध करें।
अपेक्षित नतीजा: जब Web Bot Auth से प्रमाणित कोई बॉट (एक Ed25519 हस्ताक्षरित अनुरोध जो बॉट की पहचान बताता है) ऐसे पेज की माँग करता है जिसे आपने भुगतान-योग्य चिह्नित किया है, तो उसे crawler-price हेडर के साथ HTTP 402 Payment Required मिलता है; अगर वह भुगतान पर सहमति देकर दोबारा कोशिश करता है, या सीधे आपकी कीमत कवर करने वाला crawler-max-price हेडर भेजता है, तो उसे सामग्री मिलती है और crawler-charged हेडर लगी रहती है जो लगाई गई राशि की पुष्टि करता है। Cloudflare merchant of record के रूप में काम करता है और भुगतान निपटान करता है।
गुणवत्ता जाँच: यह केवल उन्हीं बॉट्स पर काम करता है जिन्होंने Cloudflare के पास भुगतान विवरण पंजीकृत किया है और जो 402 प्रवाह संभालते हैं; यह हर बॉट पर लगने वाला सार्वभौमिक स्विच नहीं है। बाकी सब के लिए आपकी शुल्क-सेटिंग व्यवहार में अवरोधन जैसी ही काम करती है — Cloudflare स्वयं कहता है कि यह वैसे भी इस बात का संकेत देती है कि आप भविष्य में भुगतान वाले रिश्ते के लिए खुले हैं।
सुधार का रास्ता: यह सुविधा बंद बीटा में है; अगर आपको शामिल नहीं किया गया या आप इंतज़ार नहीं करना चाहते, तो इन्हीं बॉट्स के लिए AI ट्रेनिंग की अनुमति न दें या अवरुद्ध करें अब भी उपलब्ध विकल्प हैं।
अपवाद संभालना: जब कोई ख़ास AI ऑपरेटर पहुँच माँगे
कोई AI कंपनी आपके पास आ सकती है — साझेदारी के प्रस्ताव, उद्धरण समझौते, लाइसेंसिंग बातचीत — और पूरे ज़ोन की नीति से हटकर स्पष्ट पहुँच चाह सकती है।
पूरी श्रेणी दोबारा खोले बिना एक संकीर्ण अपवाद देने के दो तरीक़े हैं:
- Manage AI crawlers में प्रति-बॉट ओवरराइड: उस बॉट की पंक्ति को श्रेणी-स्तर की ट्रेनिंग या एजेंट सेटिंग की परवाह किए बिना अवरुद्ध/शुल्क से अनुमति पर बदल दीजिए।
- robots.txt में हाथ से संपादन: अगर आपने Bot Preference Sync बंद किया है (या अपवाद प्रबंधित ब्लॉक के बाहर रख रहे हैं), तो Cloudflare के प्रबंधित हिस्से के नीचे उस एक user agent के लिए लक्षित Allow जोड़ सकते हैं।
दोनों हालातों में, पूरे ज़ोन की श्रेणी नीति को डिफ़ॉल्ट बनाए रखिए और नामित अपवादों को जान-बूझकर लिए गए, दर्ज किए गए फ़ैसले मानिए — न कि उलटा।
नतीजा सत्यापित करें
कॉन्फ़िगरेशन लागू होने के बाद यह सूची देखिए:
- [ ] सुरक्षा सेटिंग्स में खोज, एजेंट और ट्रेनिंग के लिए स्पष्ट, जान-बूझकर चुने गए मान दिख रहे हैं — न कि अनदेखे किए गए डिफ़ॉल्ट
- [ ] प्रोडक्शन
/robots.txtमें उन सेटिंग्स से मेल खाता Cloudflare-प्रबंधित ब्लॉक दिख रहा है - [ ] AI Crawl Control का Crawlers टैब अपेक्षित बॉट दिखा रहा है, और जिन्हें अवरुद्ध/अनुमति न दें पर रखा था उनके लिए उल्लंघन शून्य या शून्य के आसपास है
- [ ] अगर आपने AI ट्रेनिंग की अनुमति न दें चुना है, तो आपने पुष्टि की है (Search Console / Bing Webmaster Tools से, या बस ऑर्गैनिक ट्रैफ़िक देखकर) कि Googlebot / Applebot की खोज-इंडेक्सिंग सामान्य चल रही है
- [ ] अगर robots.txt प्रवर्तन (Robotcop) चालू किया है, तो बना WAF नियम तैनात और सक्रिय है, केवल बनाकर ड्राफ़्ट में नहीं छोड़ा गया
- [ ] आपने दर्ज कर लिया है कि कौन-सी सेटिंग चुनी और क्यों, ताकि भविष्य की समीक्षा शून्य से शुरू न हो
नतीजा बनाए रखें
यह "सेट करके भूल जाइए" वाली कॉन्फ़िगरेशन नहीं है। हल्की लय में इस पर लौटते रहिए:
- हर महीने: AI Crawl Control के Metrics टैब में देखिए कि कोई नया बॉट आया है या नहीं जिसके लिए आपने अभी नीति तय नहीं की, और उल्लंघन संख्याएँ दोबारा जाँचिए।
- जब Bing Bingbot के लिए ट्रेनिंग वरीयता समर्थन जारी करे (Microsoft का लक्ष्य 2027 की शुरुआत है): दोबारा आँकिए कि आपकी मौजूदा कॉन्फ़िगरेशन अब भी वही नतीजा दे रही है या नहीं — खोज बची रहे, ट्रेनिंग अवरुद्ध रहे — क्योंकि उसी बिंदु पर Bing, Google और Apple के मौजूदा व्यवहार की बराबरी करेगा।
- जब भी आपकी विज्ञापन-मुद्रीकरण स्थिति बदले: डिस्प्ले विज्ञापन जोड़ने या हटाने से बदल जाता है कि आपके पेज किस डिफ़ॉल्ट रास्ते पर जाते हैं, और यह पुष्टि कर लेना अच्छा है कि आपकी स्पष्ट सेटिंग्स उन परिस्थितियों में भी मायने रखती हैं।
अक्सर पूछे जाने वाले सवाल
क्या ट्रेनिंग बॉट अवरुद्ध करने से मेरी SEO रैंकिंग पर असर पड़ेगा? नहीं, अगर आप अवरुद्ध करें के बजाय AI ट्रेनिंग की अनुमति न दें इस्तेमाल करते हैं। AI ट्रेनिंग की अनुमति न दें इसीलिए बनाया गया है कि जवाबदेह मिश्रित-उपयोग वाले बॉट (Google, Apple और आगे चलकर Bing) ट्रेनिंग छोड़कर खोज के लिए इंडेक्सिंग जारी रखें। वहीं सादा अवरुद्ध करें अब उन्हीं बॉट्स के खोज-व्यवहार को भी रोकता है, जिससे उनके सर्च उत्पादों में आपकी दृश्यता को नुक़सान होगा।
15 सितंबर से पहले मेरा "Block AI Bots" पहले से चालू था। मेरी सेटिंग का क्या हुआ? Cloudflare ने उसे अपने-आप माइग्रेट किया: पुराना Block AI Bots बन गया ट्रेनिंग = AI ट्रेनिंग की अनुमति न दें, खोज = अनुमति दें, और एजेंट = विज्ञापन वाले पेजों पर अवरुद्ध करें। ऊपर चरण 1 में जाकर देखिए कि वास्तविक नतीजा अपेक्षा के मुताबिक निकला या नहीं, बजाय यह मान लेने के कि माइग्रेशन आपके इरादे से मेल खा गया।
क्या इसमें से कुछ फ़्री प्लान में उपलब्ध है? हाँ। AI Crawl Control, खोज/एजेंट/ट्रेनिंग श्रेणी सेटिंग्स और Bot Preference Sync सभी प्लान में काम करते हैं, फ़्री प्लान में भी। प्रवर्तन के कुछ ब्यौरे प्लान पर निर्भर हैं — मसलन robots.txt प्रवर्तन WAF के ज़रिए चलता है, और फ़्री प्लान में बॉट पहचान अधिक उन्नत Bot Management पहचानकर्ता के बजाय user agent स्ट्रिंग्स पर आधारित होती है।
AI Crawl Control और AI बॉट सुरक्षा सेटिंग्स में क्या फ़र्क़ है? सुरक्षा सेटिंग्स वह जगह है जहाँ आप नीति तय करते हैं (हर श्रेणी के लिए अनुमति दें / विज्ञापन वाले पेजों पर अवरुद्ध करें / अवरुद्ध करें / AI ट्रेनिंग की अनुमति न दें)। AI Crawl Control वह जगह है जहाँ आप ऑडिट करते हैं कि वाकई क्या हो रहा है — प्रति-बॉट अनुरोध संख्याएँ, robots.txt उल्लंघन, पथ-स्तर का ब्यौरा — और जहाँ आप घोषित robots.txt नीति को लागू होने वाले WAF नियम में बदल सकते हैं।
क्या यह सेट करने के बाद मुझे robots.txt हाथ से संपादित करनी होगी? नहीं, अगर Bot Preference Sync चालू है: यह आपकी डैशबोर्ड सेटिंग्स से मेल खाता robots.txt ब्लॉक लिखता और बनाए रखता है। हाथ से संपादन की ज़रूरत केवल प्रबंधित श्रेणियों से बाहर, किसी एकल ऑपरेटर के लिए एकबारगी अपवाद बनाते समय पड़ती है।
लेखक: Julian Mercer, Auspia में 14 वर्षों के अनुभव वाले technical SEO प्रैक्टिशनर। वे crawlability, structured data, rendering और उन तकनीकी बुनियादों पर लिखते हैं जो सामग्री को AI के लिए पठनीय बनाती हैं।