Co otrzymasz po przejściu tego przewodnika
Po ukończeniu tego przewodnika Twoja domena w Cloudflare będzie miała jawną, świadomie ustaloną politykę dla trzech odrębnych kategorii ruchu botów AI — wyszukiwania (Search), agentów (Agent) i trenowania (Training) — zamiast ustawienia domyślnego, które domena odziedziczyła. Będziesz dokładnie wiedzieć, które roboty są dozwolone, które zablokowane i na których stronach, a Twój robots.txt oraz reguła egzekwowania na brzegu sieci będą rzeczywiście spójne.
Dla kogo to jest: dla każdego, kto prowadzi witrynę za Cloudflare — wydawców, stron marketingowych SaaS, sklepów e-commerce, blogów — i chce sam decydować, czy systemy AI mogą trenować na jego treściach, streszczać je lub przeglądać je przez agentów, zamiast dziedziczyć ustawienie wybrane przez platformę.
Czego potrzebujesz:
- Domena proxowana przez Cloudflare (dowolny plan, także darmowy; niektóre kroki poniżej są zarezerwowane dla planów płatnych i zostało to oznaczone)
- Dostęp do panelu z uprawnieniem co najmniej do zmiany ustawień bezpieczeństwa na poziomie domeny
- Od 20 do 30 minut na audyt i konfigurację; potem kilka minut dziennie lub tygodniowo na monitorowanie
Definicja ukończenia: ustawienia bezpieczeństwa Twojej strefy pokazują świadomy wybór (a nie niezweryfikowane ustawienie domyślne) dla wyszukiwania, agentów i trenowania; produkcyjny /robots.txt odzwierciedla ten wybór; a Ty potwierdziłeś w AI Crawl Control, że boty, które miały być zablokowane, faktycznie są blokowane.
Dlaczego nagle stało się to ważne: co zmieniło się 15 września
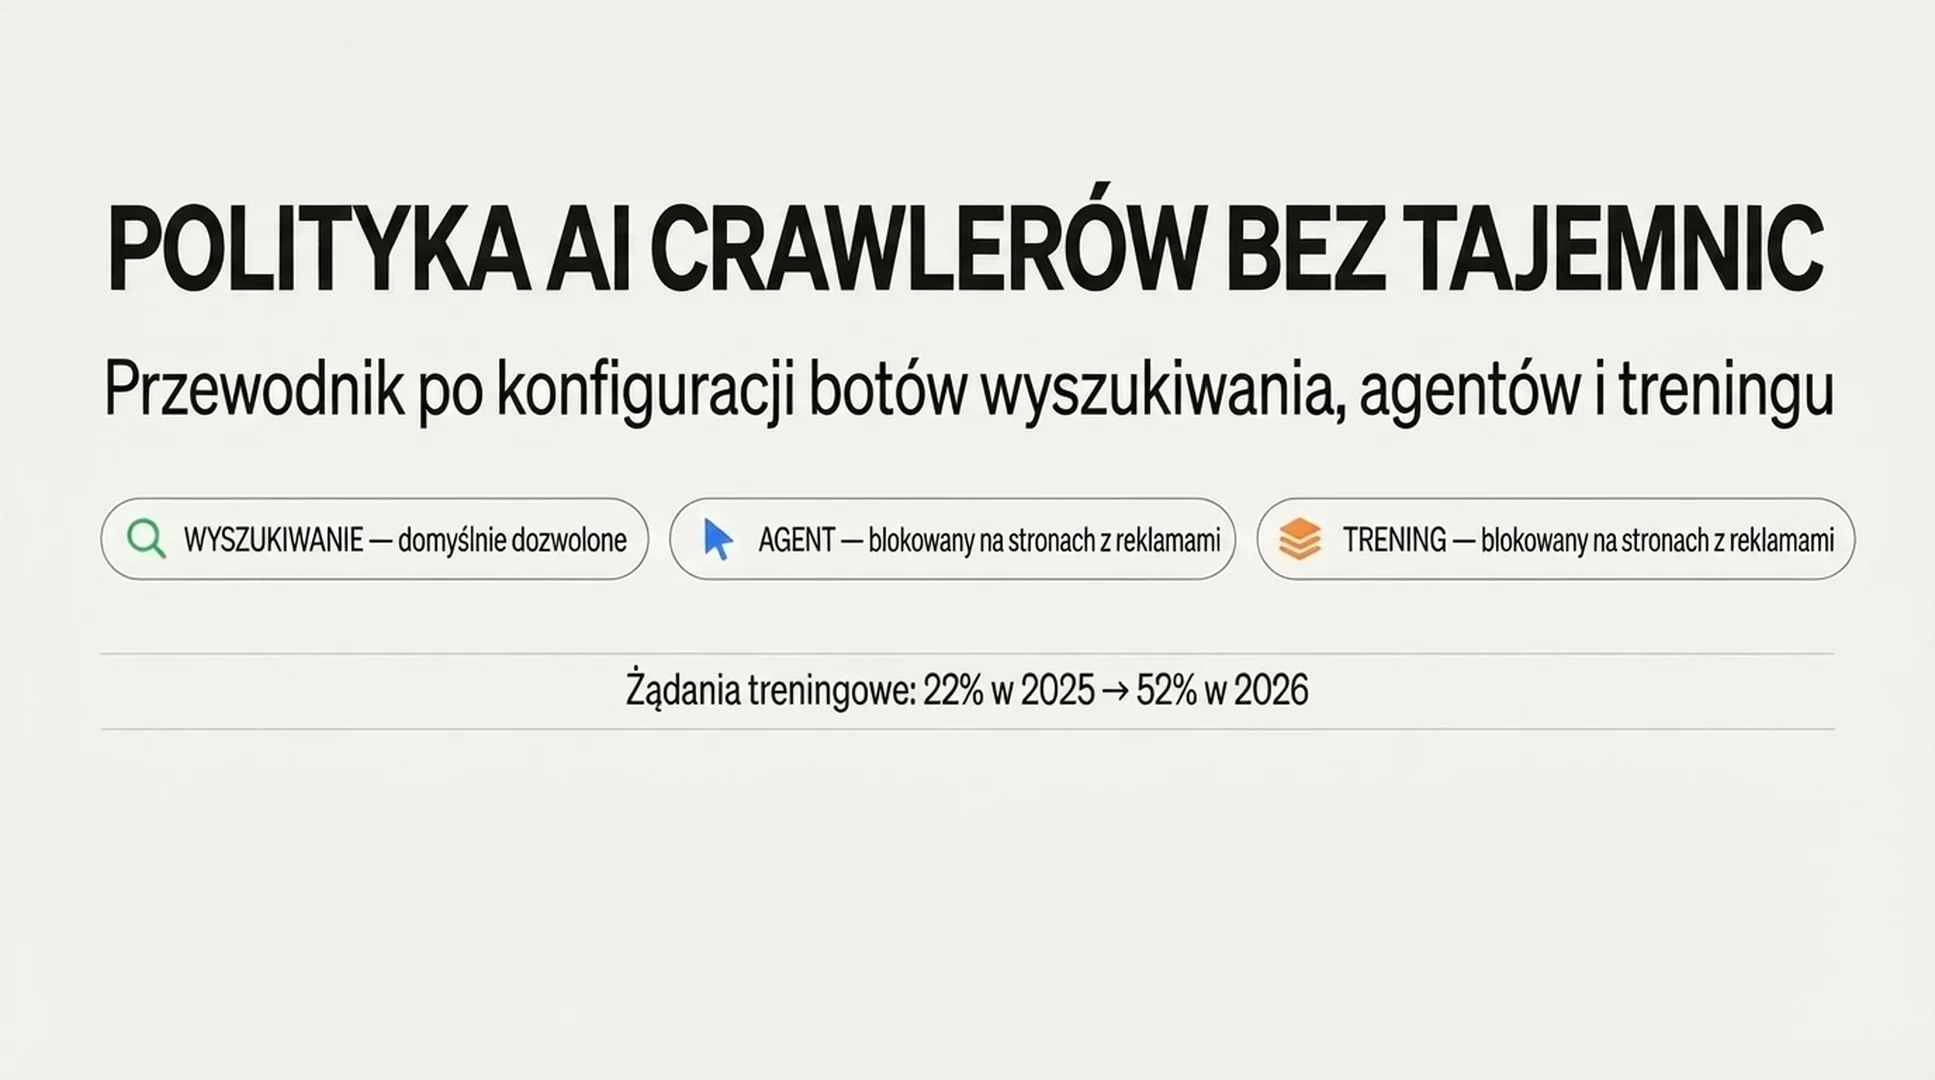
Cloudflare budowała mechanizmy kontroli ruchu AI etapami: od dodania Content Signals Policy do robots.txt we wrześniu 2025 roku, po uruchomienie „Content Independence Day" 1 lipca 2026 roku, które po raz pierwszy podzieliło zachowanie botów AI na trzy nazwane kategorie zamiast jednego zgrubnego przełącznika „to AI albo nie":
- Wyszukiwanie (Search) — indeksowanie, które buduje indeks wyszukiwania, a następnie zwraca linki lub krótkie fragmenty. Mówiąc słowami samego Cloudflare, to ruch, który powinien przynosić Ci odesłania.
- Agent (Agent) — zautomatyzowana aktywność działająca w czasie rzeczywistym w czyimś imieniu, na przykład asystent czatu pobierający stronę albo agent przeglądarkowy wykonujący zadanie.
- Trenowanie (Training) — indeksowanie w celu trenowania lub dostrajania modelu, w którym Twoja treść zostaje trwale wchłonięta w wagi modelu, zamiast wrócić do Ciebie jako link.
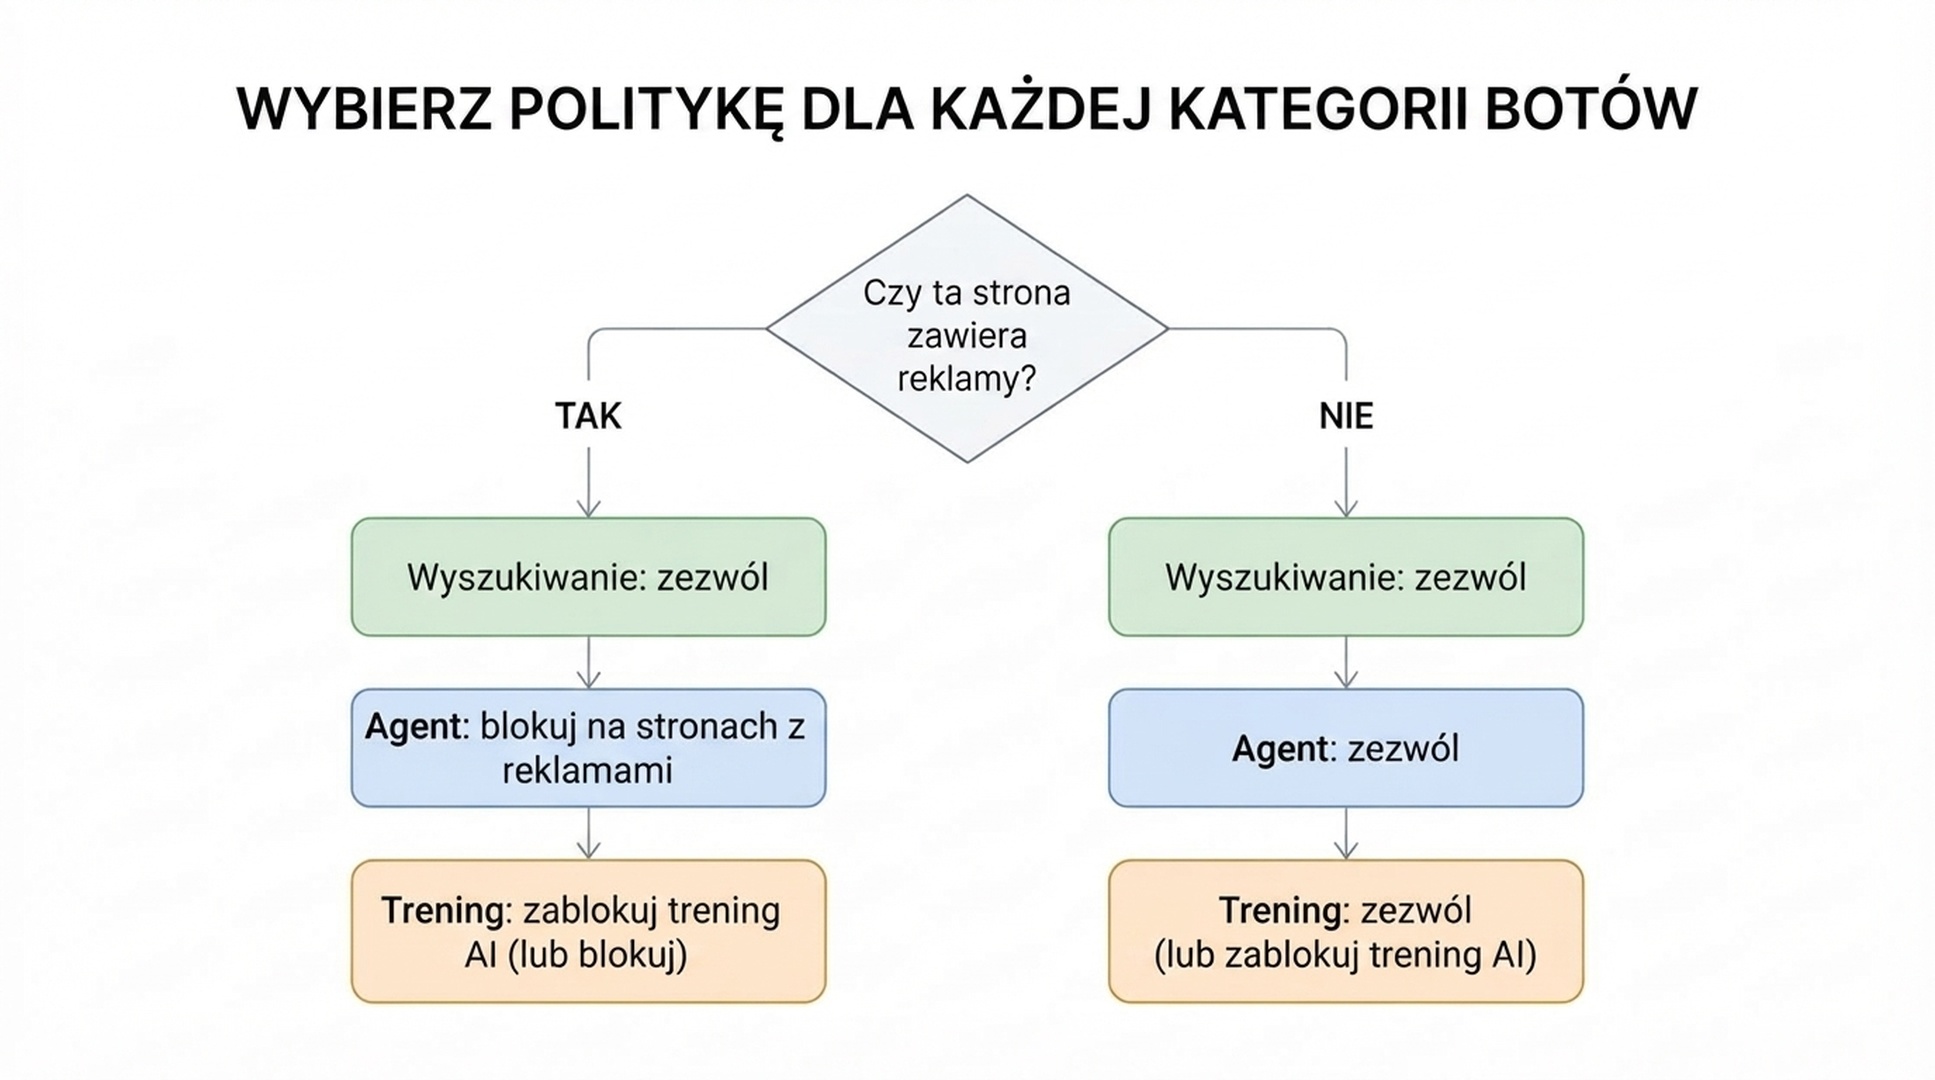
15 września 2026 roku Cloudflare zmieniła to, co dzieje się automatycznie. Dla każdej domeny dołączającej do Cloudflare w tym dniu lub później, jeśli witryna jest oznaczona jako monetyzowana reklamami, ustawienie domyślne staje się następujące:
Kategoria | Domyślnie na stronach z reklamami |
|---|---|
Wyszukiwanie (Search) | Zezwól |
Agent (Agent) | Blokuj na stronach z reklamami |
Trenowanie (Training) | Nie zezwalaj na trenowanie AI (Disallow AI Training) |
Nowe domeny bez monetyzacji reklamowej otrzymują domyślnie „Zezwól" we wszystkich trzech kategoriach. Istniejący klienci nie zostali przełączeni po cichu — Cloudflare dała okno przed 15. dniem na rezygnację przez panel, a rzeczywiste reguły migracji dla poszczególnych domen okazały się bardziej szczegółowe niż jedno nowe ustawienie domyślne (wyjaśniamy poniżej).
Powód, dla którego strony z reklamami dostają ostrzejsze ustawienie domyślne, jest taki, że obecność reklam na stronie jest sygnałem, że miała być oglądana przez człowieka. Według danych samego Cloudflare w czerwcu 2026 roku roboty o mieszanym zastosowaniu — te, które łączą indeksowanie wyszukiwania, żądania agentów i trenowanie pod jednym user agentem — stanowiły ponad 36% zweryfikowanego ruchu robotów, największą pojedynczą kategorię. A udział trenowania AI w łącznej liczbie żądań robotów w sieci Cloudflare wzrósł z około 22% wiosną 2025 roku do 52% w czerwcu 2026 roku. To właśnie w ten ruch celuje ta zmiana.
Zanim zaczniesz: trzy rzeczy, które trzeba zrozumieć o kategoriach
1. Część robotów ma mieszane zastosowanie i zachowuje się inaczej przy blokadzie niż przy zakazie trenowania. Googlebot, Bingbot i Applebot wykonują podwójną pracę — indeksują zarówno na potrzeby wyszukiwania, jak i trenowania pod tym samym user agentem. Cloudflare nazywa Apple, Google i Microsoft operatorami „Accountable" (odpowiedzialnymi), bo spełniają cztery warunki: respektują preferencję nietrenowania w robots.txt, oferują sposób na odrzucenie streszczeń tworzonych przez AI, dają widoczność na poziomie adresów URL co do tego, co wykorzystano do trenowania, i potrafią wykazać, że rezygnacja z trenowania nie szkodzi Twojej obecności w wyszukiwaniu.
2. „Nie zezwalaj na trenowanie AI" i „Blokuj" to nie to samo ustawienie i właśnie ta różnica jest sednem sprawy. Nie zezwalaj na trenowanie AI publikuje w robots.txt preferencję Disallow skierowaną do user agentów przeznaczonych wyłącznie do trenowania (takich jak Google-Extended i Applebot-Extended). Odpowiedzialne roboty o mieszanym zastosowaniu czytają tę preferencję i dobrowolnie kontynuują indeksowanie na potrzeby wyszukiwania, pomijając trenowanie — dzięki temu Twoja obecność w wyszukiwaniu zostaje zachowana. Pozostałe roboty treningowe nienależące do odpowiedzialnych operatorów są blokowane na brzegu sieci natychmiast, co nie dotyka wyszukiwania, bo ci operatorzy uruchamiają osobne boty treningowe. Natomiast zwykłe Blokuj blokuje teraz także samego Googlebota, Bingbota i Applebota, co oznacza, że Twoje treści znikają również z ich wyników wyszukiwania. Jeśli chcesz usunąć trenowanie, ale zachować wyszukiwanie, właściwym ustawieniem jest „Nie zezwalaj na trenowanie AI", a nie „Blokuj".
3. Bing wciąż nie respektuje preferencji trenowania w robots.txt. Dziś zarówno Applebot, jak i Googlebot stosują się do dyrektywy Disallow przeznaczonej dla trenowania. Microsoft podaje, że buduje odpowiednik dla Bingbota, celując w początek 2027 roku. Do tego czasu wybór „Nie zezwalaj na trenowanie AI" zapisze Twoją preferencję w robots.txt, ale zachowanie Binga przy indeksowaniu na potrzeby trenowania nie zmieni się tylko z powodu tego sygnału — meta tag NOARCHIVE samego Binga lub jego narzędzie Content Removal pozostają tymczasowymi dźwigniami, jeśli niepokoi Cię konkretnie trenowanie przez Bing.
Krok 1: Ustal, gdzie naprawdę wylądowała Twoja witryna
Nie zakładaj, że znasz obecne ustawienie — sprawdź je.
Działanie: w panelu Cloudflare otwórz swoją domenę, przejdź do Security → Settings i znajdź elementy sterujące polityką botów AI (nowszy interfejs z trzema kategoriami zastąpił stary pojedynczy przełącznik „Block AI Bots", ale konta, które jeszcze nie zostały zmigrowane, mogą nadal pokazywać stary przełącznik). Osobno pobierz produkcyjny robots.txt w przeglądarce lub poleceniem curl https://yourdomain.com/robots.txt i poszukaj bloku zaczynającego się od zarządzanego przez Cloudflare komentarza-znacznika; możesz też porównać go z sprawdzarką robotów AI w robots.txt od Auspii, aby zobaczyć, jak Twoje obecne reguły czytają roboty AI.
Oczekiwany wynik: trzy ustawienia — po jednym dla wyszukiwania, agentów i trenowania — każde z wartością Zezwól / Blokuj na stronach z reklamami / Blokuj (z „Nie zezwalaj na trenowanie AI" jako czwartą opcją, dostępną wyłącznie dla trenowania). Produkcyjny robots.txt powinien pokazywać sekcję zarządzaną przez Cloudflare z listą konkretnych user agentów oraz wierszy Disallow / Content-Signal, jeśli Bot Preference Sync lub zarządzany robots.txt są włączone.
Kontrola jakości: upewnij się, że wszystkie trzy ustawienia odpowiadają temu, co naprawdę masz na myśli, a nie temu, co założył za Ciebie mechanizm migracji. Udokumentowana przez Cloudflare logika migracji dla istniejących klientów jest następująca: jeśli wcześniej włączyłeś stary przełącznik „Block AI", zostałeś przeniesiony do stanu trenowanie = Nie zezwalaj na trenowanie AI, wyszukiwanie pozostało na Zezwól, a agent ustawiony został na Blokuj na stronach z reklamami. Jeśli wcześniej sam ustawiłeś trenowanie na Blokuj lub Blokuj na stronach z reklamami, zostałeś przeniesiony do Nie zezwalaj na trenowanie AI. Obie ścieżki migracji zakładają, że chciałeś zachować wyszukiwanie. Jeśli w rzeczywistości chciałeś, aby roboty o mieszanym zastosowaniu zniknęły całkowicie, wraz z wyszukiwaniem, to nie jest Twój obecny stan i musisz wyraźnie wybrać Blokuj.
Ścieżka odzyskania: jeśli ustawienia bezpieczeństwa pokazują wyłącznie stary przełącznik „Block AI Bots" bez podziału na trzy kategorie, Twoje konto nie zostało jeszcze zmigrowane do nowych mechanizmów. Poszukaj „Configure AI bot policies" — osobnego, nowszego ekranu ustawień; tam szczegółowe mechanizmy współistnieją ze starym przełącznikiem w okresie przejściowym i tam zmierza przyszłość.
Krok 2: Ustal politykę dla każdej kategorii osobno, a nie jedną ogólną odpowiedzią
To jest właściwy krok decyzyjny. Przejdź przez każdą kategorię oddzielnie.
Wyszukiwanie. Prawie nikt go nie blokuje — Cloudflare podaje, że mniej niż 1% witryn decyduje się blokować boty wyszukiwania — bo utrata widoczności w wyszukiwaniu prawie nigdy się nie opłaca. Ustaw domyślnie Zezwól, chyba że masz konkretny powód (środowisko testowe, archiwum za paywallem), by trzymać witrynę poza indeksami wyszukiwarek.
Agenci. To boty działające w czasie rzeczywistym w imieniu kogoś, kto właśnie teraz próbuje coś zrobić na Twojej stronie: sprawdzić cenę, dokończyć rezerwację, wyciągnąć fakt do odpowiedzi w czacie. Blokowanie ruchu agentów na stronach monetyzowanych lub z reklamami jest uzasadnieniem nowego ustawienia domyślnego, bo wizyta agenta nie generuje tej emisji reklamy, którą wygenerowałaby wizyta człowieka. Jeśli Twój model biznesowy opiera się na tej ludzkiej uwadze (media, witryny contentowe z reklamami displayowymi), Blokuj na stronach z reklamami to obronna pozycja. Jeśli wolisz, by agenci mogli realizować zadania na Twojej stronie nawet na stronach z reklamami — na przykład dlatego, że ruch agentów i tak Ci się konwertuje — wybierz Zezwól.
Trenowanie. Tu jest prawdziwa decyzja i tu terminologia wprowadza zamieszanie:
- Wybierz Nie zezwalaj na trenowanie AI, jeśli chcesz powstrzymać wykorzystywanie treści do trenowania modeli, zachowując obecność w produktach wyszukiwania Google, Bing i Apple (wobec obecnego opóźnienia Binga rozumiej to jako „dziś działa dla Google i Apple, dla Binga w zawieszeniu"). To zalecana przez Cloudflare droga środka, stworzona właśnie pod kompromis między wyszukiwaniem a trenowaniem.
- Wybierz Blokuj tylko wtedy, gdy godzisz się całkowicie stracić indeksowanie na potrzeby wyszukiwania przez Googlebota, Bingbota i Applebota jako cenę zablokowania ich zachowania w trybie trenowania. Teraz to opcja surowa: od 15 września blokada dotyczy także robotów o mieszanym zastosowaniu, co wcześniej nie miało miejsca.
- Wybierz Zezwól tylko wtedy, gdy świadomie akceptujesz, że Twoje treści trenują modele AI — na przykład dlatego, że chcesz maksymalnej widoczności w odpowiedziach AI i uznajesz trenowanie za akceptowalną cenę.
Działanie: w Security → Settings → Configure AI bot policies ustaw wszystkie trzy listy zgodnie ze swoją decyzją.
Oczekiwany wynik: panel powinien odzwierciedlać Twój jawny wybór w każdej kategorii i (jeśli Bot Preference Sync jest włączony) zacząć automatycznie publikować odpowiedni blok robots.txt — bez ręcznej edycji pliku.
Kontrola jakości: przeczytaj ponownie swoją decyzję o trenowaniu, weryfikując ją jednym pytaniem: „Czy chcę zachować widoczność w wyszukiwaniu, czy nie?" Jeśli tak, to Nie zezwalaj na trenowanie AI, a nie Blokuj — choćby słowo „Blokuj" brzmiało kusząco jako sposób na zatrzymanie trenowania AI.
Ścieżka odzyskania: jeśli ruch z wyszukiwania spadł po wybraniu ustawienia, sprawdź, czy przypadkiem nie wybrałeś Blokuj zamiast Nie zezwalaj na trenowanie AI. To najczęstszy tu błąd szkodzący samemu sobie: nazwa sprawia, że „Blokuj" wygląda na opcję, która „robi więcej", ale w przypadku trenowania robi to, czego możesz nie chcieć — zabiera też wyszukiwanie.
Krok 3: Włącz Bot Preference Sync, aby robots.txt nadążał za Twoimi ustawieniami
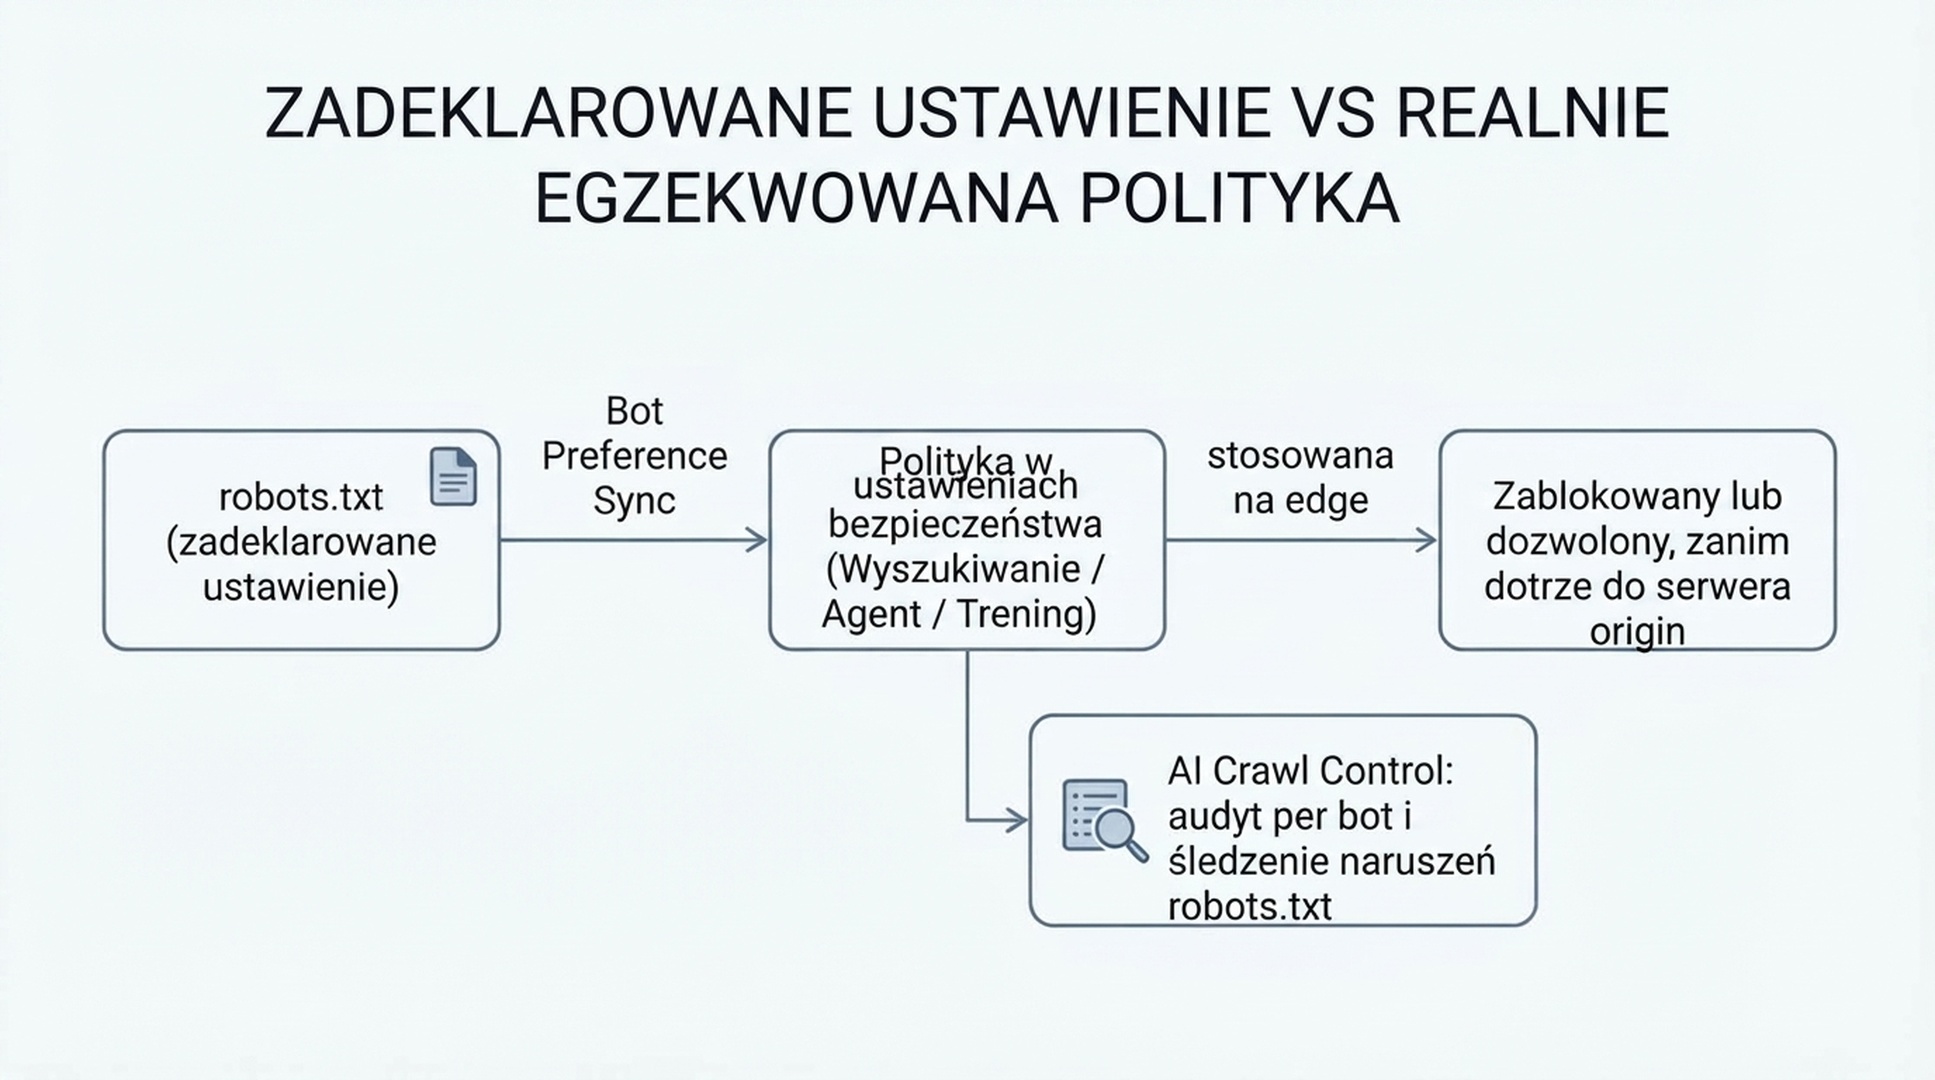
Ustawienie w panelu i plik robots.txt to dwa różne systemy, a gdy się rozchodzą, niektóre roboty wykorzystują tę rozbieżność jako pretekst do zignorowania Twojej preferencji. Bot Preference Sync od Cloudflare zamyka tę lukę, generując Twój robots.txt bezpośrednio z wybranych ustawień bezpieczeństwa.
Działanie: w tym samym obszarze ustawień polityki botów AI włącz Bot Preference Sync (domyślnie jest włączony dla nowych klientów; istniejący klienci korzystający ze starszej funkcji zarządzanego robots.txt zostaną poproszeni o przejrzenie i potwierdzenie w trakcie migracji).
Oczekiwany wynik: Cloudflare dodaje zarządzany blok na początku Twojego robots.txt, objęty komentarzami # BEGIN Cloudflare Bot Preference Sync / # END, z listą objętych user agentów i ich reguł Disallow — i nie usuwa żadnej Twojej własnej reguły już obecnej w robots.txt; pozostają one poniżej bloku zarządzanego.
Kontrola jakości: pobierz /robots.txt ponownie po włączeniu i upewnij się, że zarządzany blok się pojawił i zgadza się z wyborami z kroku 2. Na przykład jeśli ustawiłeś trenowanie na Nie zezwalaj na trenowanie AI, powinieneś zobaczyć user agentów przeznaczonych do trenowania (Google-Extended, Applebot-Extended) z regułami Disallow, podczas gdy ogólni Googlebot / Applebot / Bingbot pozostają niezablokowani na potrzeby wyszukiwania.
Ścieżka odzyskania: jeśli masz jednorazowe specjalne porozumienie z konkretnym operatorem robotów, które zepsułaby polityka na poziomie kategorii (na przykład płatna umowa licencyjna na treści), wyłącz Bot Preference Sync i edytuj swój robots.txt ręcznie: przełączniki kategorii są pomyślane dla polityki całej strefy, a nie dla wyjątków dla pojedynczych operatorów.
Krok 4: Potwierdź, że polityka jest rzeczywiście egzekwowana, a nie tylko proszona
robots.txt to technicznie prośba: nie zatrzyma robota, który ją zignoruje. To krok, który ludzie pomijają, i właśnie on pokazuje, czy Twoja decyzja z kroku 2 jest realna, czy tylko teoretyczna.
Działanie: otwórz AI Crawl Control dla swojej strefy (dostępny we wszystkich planach, także darmowym — jakość wykrywania jest lepsza w planach z Bot Management, ale funkcje widoczności działają wszędzie). Spójrz na zakładkę Crawlers, która wymienia wszystkie boty, jakie dotarły do Twojej witryny, wraz z kolumną Robots.txt violations.
Oczekiwany wynik: tabela z liczbą żądań i liczbą naruszeń dla każdego bota. Niezerowa liczba naruszeń u bota, którego ustawiłeś na nie zezwalaj lub blokuj, oznacza, że ten bot właśnie ignoruje Twój robots.txt.
Kontrola jakości: dla każdego bota z naruszeniami zajrzyj w „Most popular paths" (filtrując po oznaczonych ścieżkach), żeby zobaczyć, o co naprawdę prosi, i ocenić, czy sięga po treści, które naprawdę chcesz chronić.
Ścieżka odzyskania: jeśli bot ignoruje Twoją zadeklarowaną preferencję, sam robots.txt go nie zatrzyma. Użyj akcji „Enforce robots.txt rules" w AI Crawl Control (czasem nazywanej wewnętrznie Robotcop), aby zamienić zadeklarowane reguły w rzeczywistą regułę WAF, która blokuje nieposłusznego bota na brzegu Cloudflare, zanim dotrze on do Twojego serwera źródłowego — przechodzisz od „proszenia o zgodność" do „wymuszania zgodności". Ten krok korzysta z WAF, więc dostępność zależy od tego, czy Twój plan ma dostęp do WAF.
Krok 5: Zdecyduj, czy po prostu blokować, czy pobierać opłatę za dostęp
Jeśli Twoja decyzja o trenowaniu brzmiała „bez dostępu na potrzeby trenowania", masz drugą opcję poza całkowitą blokadą: pobieranie opłaty.
Działanie: jeśli Cię to interesuje, zgłoś się do zamkniętej bety Pay Per Crawl od Cloudflare (przez stronę zapisów Cloudflare lub przez swojego opiekuna konta, jeśli jesteś klientem Enterprise). Po włączeniu na poziomie konta (Manage Account → Settings → Pay Per Crawl → ustaw Visibility swojej domeny na Visible) możesz ustalić jedną stałą cenę za żądanie dla całej strefy i wybrać dla każdego robota: zezwól (bezpłatnie), nalicz opłatę (według Twojej ceny) albo blokuj.
Oczekiwany wynik: gdy robot uwierzytelniony przez Web Bot Auth (żądanie z podpisem Ed25519 identyfikującym robota) poprosi o stronę, którą oznaczyłeś jako płatną, otrzyma HTTP 402 Payment Required z nagłówkiem crawler-price; jeśli ponowi próbę, zgadzając się zapłacić, albo od razu dołączy nagłówek crawler-max-price pokrywający Twoją cenę, otrzyma treść z nagłówkiem crawler-charged potwierdzającym naliczoną kwotę. Cloudflare występuje jako merchant of record i przeprowadza rozliczenie.
Kontrola jakości: działa to wyłącznie wobec robotów, które zarejestrowały dane płatnicze w Cloudflare i obsługują przepływ 402; to nie jest uniwersalny przełącznik na wszystkie boty. Wobec całej reszty Twoje ustawienie naliczania opłaty zachowuje się w praktyce jak blokada — Cloudflare zauważa, że i tak służy ono jako sygnał, że jesteś otwarty na płatną relację w przyszłości.
Ścieżka odzyskania: funkcja jest w zamkniętej becie; jeśli nie zostałeś przyjęty albo nie chcesz czekać, Nie zezwalaj na trenowanie AI lub Blokuj pozostają dziś dostępne dla tych samych robotów.
Obsługa wyjątku: gdy konkretny operator AI prosi o dostęp
Może zgłosić się do Ciebie firma AI — z propozycją partnerstwa, umową o cytowanie, rozmową o licencji — chcąc jawnego dostępu poza polityką całej strefy.
Są dwa sposoby na przyznanie wąskiego wyjątku bez ponownego otwierania całej kategorii:
- Nadpisanie dla konkretnego robota w Manage AI crawlers: zmień wiersz tego bota z blokuj/nalicz na zezwól, niezależnie od ustawienia trenowania lub agentów na poziomie kategorii.
- Ręczna edycja robots.txt: jeśli wyłączyłeś Bot Preference Sync (albo umieszczasz wyjątek poza blokiem zarządzanym), możesz dodać punktowy Allow dla tego jednego user agenta poniżej sekcji zarządzanej przez Cloudflare.
W obu przypadkach utrzymuj politykę kategorii dla całej strefy jako domyślną, a nazwane wyjątki traktuj jako świadome, udokumentowane decyzje — a nie odwrotnie.
Zweryfikuj rezultat
Przejdź tę listę, gdy konfiguracja wejdzie w życie:
- [ ] Ustawienia bezpieczeństwa pokazują jawne, świadome wartości dla wyszukiwania, agentów i trenowania — nie niezweryfikowane ustawienia domyślne
- [ ] Produkcyjny
/robots.txtpokazuje zarządzany przez Cloudflare blok zgodny z tymi ustawieniami - [ ] Zakładka Crawlers w AI Crawl Control pokazuje oczekiwane boty, z zerem lub blisko zera naruszeń dla wszystkiego, co ustawiłeś na blokuj/nie zezwalaj
- [ ] Jeśli wybrałeś Nie zezwalaj na trenowanie AI, potwierdziłeś (przez Search Console / Bing Webmaster Tools albo po prostu obserwując ruch organiczny), że indeksowanie na potrzeby wyszukiwania przez Googlebota / Applebota przebiega normalnie
- [ ] Jeśli włączyłeś egzekwowanie robots.txt (Robotcop), wynikowa reguła WAF jest wdrożona i aktywna, a nie tylko utworzona i pozostawiona jako szkic
- [ ] Udokumentowałeś, które ustawienie wybrałeś i dlaczego, żeby przyszły przegląd nie zaczynał się od zera
Utrzymaj rezultat
To nie jest konfiguracja „ustaw i zapomnij". Wracaj do niej w lekkim rytmie:
- Co miesiąc: sprawdzaj zakładkę Metrics w AI Crawl Control pod kątem nowych botów, dla których nie ustaliłeś jeszcze polityki, i ponownie weryfikuj liczby naruszeń.
- Gdy Bing udostępni obsługę preferencji trenowania dla Bingbota (Microsoft podaje cel na początek 2027 roku): oceń ponownie, czy Twoja obecna konfiguracja wciąż daje zamierzony rezultat — zachowane wyszukiwanie, zablokowane trenowanie — bo właśnie wtedy Bing dogania obecne zachowanie Google i Apple.
- Za każdym razem, gdy zmieni się Twój status monetyzacji reklamowej: dodanie lub usunięcie reklam displayowych zmienia to, w którą domyślną ścieżkę trafiają Twoje strony, i warto potwierdzić, że Twoje jawne ustawienia wciąż mają sens w tych warunkach.
Najczęściej zadawane pytania
Czy blokowanie robotów treningowych zaszkodzi mojemu pozycjonowaniu SEO? Nie, jeśli używasz Nie zezwalaj na trenowanie AI zamiast Blokuj. Nie zezwalaj na trenowanie AI zostało stworzone właśnie po to, by odpowiedzialne roboty o mieszanym zastosowaniu (Google, Apple, a w przyszłości Bing) nadal indeksowały na potrzeby wyszukiwania, pomijając trenowanie. Natomiast zwykłe Blokuj blokuje teraz również zachowanie wyszukiwawcze tych samych robotów, co zaszkodzi Twojej widoczności w ich produktach wyszukiwania.
Miałem już włączone „Block AI Bots" przed 15 września. Co stało się z moim ustawieniem? Cloudflare zmigrowała je automatycznie: stary Block AI Bots stał się trenowaniem = Nie zezwalaj na trenowanie AI, wyszukiwanie = Zezwól, a agent = Blokuj na stronach z reklamami. Sprawdź w kroku 1 powyżej, czy rzeczywisty rezultat wyszedł zgodnie z oczekiwaniem, zamiast zakładać, że migracja pokryła się z Twoim zamiarem.
Czy cokolwiek z tego jest dostępne w planie darmowym? Tak. AI Crawl Control, ustawienia kategorii wyszukiwanie/agenci/trenowanie oraz Bot Preference Sync działają we wszystkich planach, także darmowym. Niektóre szczegóły egzekwowania zależą od planu — na przykład egzekwowanie robots.txt działa przez WAF, a wykrywanie botów w planie darmowym opiera się na ciągach user agent, a nie na bardziej zaawansowanym identyfikatorze wykrywania Bot Management.
Czym różni się AI Crawl Control od ustawień bezpieczeństwa botów AI? Ustawienia bezpieczeństwa to miejsce, w którym ustalasz politykę (zezwól / blokuj na stronach z reklamami / blokuj / nie zezwalaj na trenowanie AI dla każdej kategorii). AI Crawl Control to miejsce, w którym audytujesz, co dzieje się naprawdę — liczby żądań dla poszczególnych botów, naruszenia robots.txt, szczegóły na poziomie ścieżek — i gdzie możesz zamienić zadeklarowaną politykę robots.txt w egzekwowaną regułę WAF.
Czy po skonfigurowaniu tego muszę ręcznie edytować robots.txt? Nie, jeśli Bot Preference Sync jest włączony: zapisuje i utrzymuje odpowiedni blok robots.txt na podstawie Twoich ustawień w panelu. Ręczna edycja jest potrzebna tylko przy jednorazowych wyjątkach dla konkretnego operatora, poza zarządzanymi kategoriami.
Autor: Julian Mercer, praktyk technical SEO z 14-letnim doświadczeniem w Auspii. Pisze o skanowalności, danych strukturalnych, renderowaniu i technicznych podstawach, które czynią treści czytelnymi dla AI.