ما الذي ستحصل عليه في النهاية
بنهاية هذا الدليل، سيكون لديك في نطاق Cloudflare الخاص بك سياسة صريحة ومقصودة لثلاث فئات منفصلة من حركة مرور بوتات الذكاء الاصطناعي — البحث (Search) والوكيل (Agent) والتدريب (Training) — بدلًا من الإعداد الافتراضي الذي هبط على نطاقك. ستعرف بالتحديد أي زواحف مسموح لها وأيها محظور وعلى أي صفحات، وسيكون لديك ملف robots.txt وقاعدة فرض على الحافة متوافقين فعليًا مع بعضهما.
لمن هذا الدليل: كل من يدير موقعًا يمر عبر Cloudflare — الناشرون، ومواقع تسويق SaaS، ومتاجر التجارة الإلكترونية، والمدونات — ويريد أن يقرر بنفسه ما إذا كان يمكن لأنظمة الذكاء الاصطناعي التدريب على محتواه أو تلخيصه أو تصفحه بوكيل، بدلًا من أن يرث إعدادًا افتراضيًا من المنصة.
المتطلبات المسبقة:
- نطاق يمر عبر Cloudflare (أي خطة، بما في ذلك المجانية؛ بعض الخطوات أدناه مخصصة للخطط المدفوعة وسيُشار إلى ذلك)
- صلاحية وصول إلى لوحة التحكم تمكّنك على الأقل من تعديل إعدادات الأمان على مستوى النطاق
- من 20 إلى 30 دقيقة لخطوات التدقيق والإعداد؛ ثم بضع دقائق يوميًا أو أسبوعيًا للمراقبة
تعريف الإنجاز: تُظهر إعدادات الأمان في نطاقك اختيارًا مقصودًا (لا إعدادًا افتراضيًا) لكل من البحث والوكيل والتدريب؛ ويعكس ملف /robots.txt المباشر ذلك الاختيار؛ وقد تأكدت في AI Crawl Control من أن البوتات التي قصدت حظرها محظورة فعلًا.
لماذا صار هذا مهمًا فجأة: ما الذي تغيّر في 15 سبتمبر
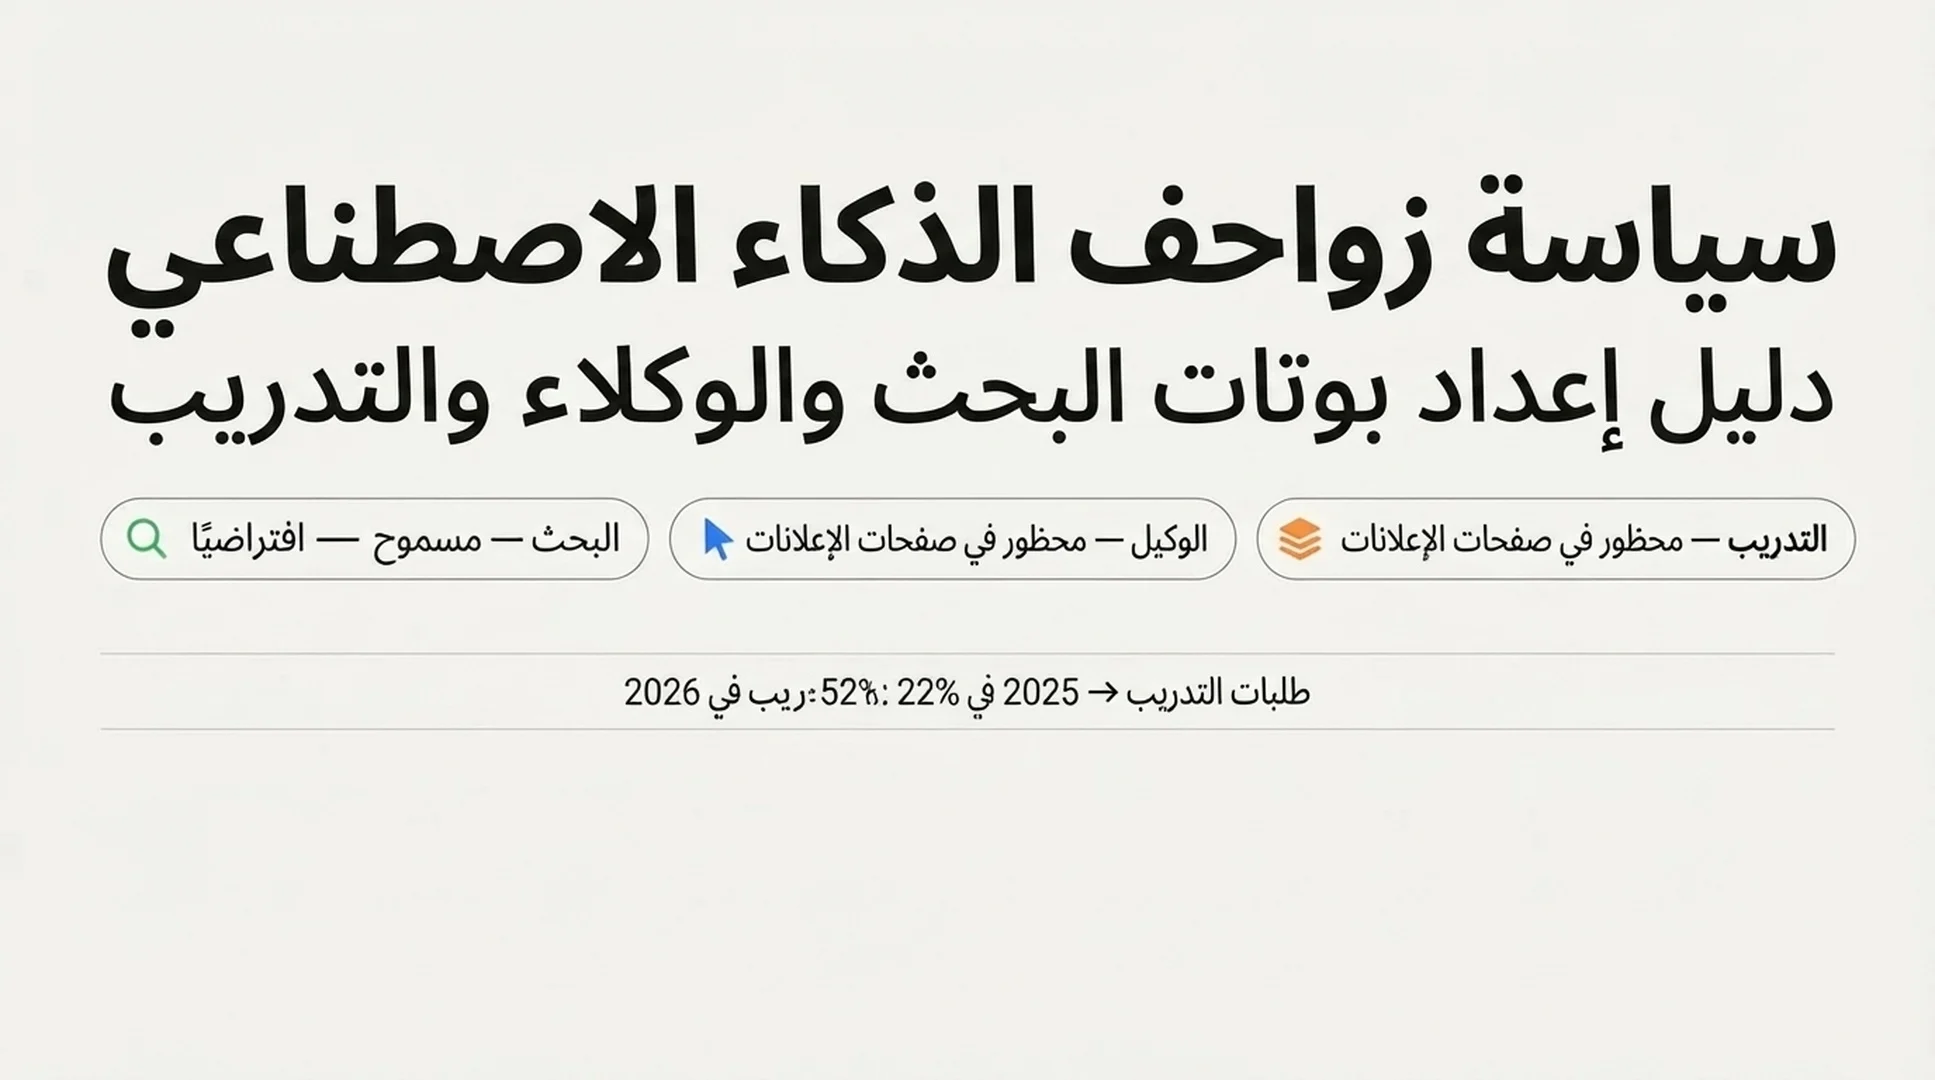
بنَت Cloudflare ضوابط حركة مرور الذكاء الاصطناعي على مراحل، بدءًا من إضافة Content Signals Policy إلى ملف robots.txt في سبتمبر 2025، ثم إطلاق «Content Independence Day» في 1 يوليو 2026، وهو ما قسّم سلوك بوتات الذكاء الاصطناعي لأول مرة إلى ثلاث فئات مسمّاة بدلًا من مفتاح واحد فظّ يسأل «ذكاء اصطناعي أو لا»:
- البحث (Search) — الزحف الذي يبني فهرس بحث ويعيد لاحقًا روابط أو مقتطفات قصيرة. وبحسب توصيف Cloudflare، هذه هي الحركة التي يُفترض أن تجلب لك زيارات مُحالة.
- الوكيل (Agent) — نشاط آلي لحظي يعمل نيابةً عن شخص الآن، مثل مساعد محادثة يجلب صفحة، أو وكيل يتصفح المتصفح لإتمام مهمة.
- التدريب (Training) — الزحف لتدريب نموذج أو ضبطه الدقيق، حيث يُدمج محتواك نهائيًا في أوزان النموذج بدلًا من أن يعود إليك كرابط.
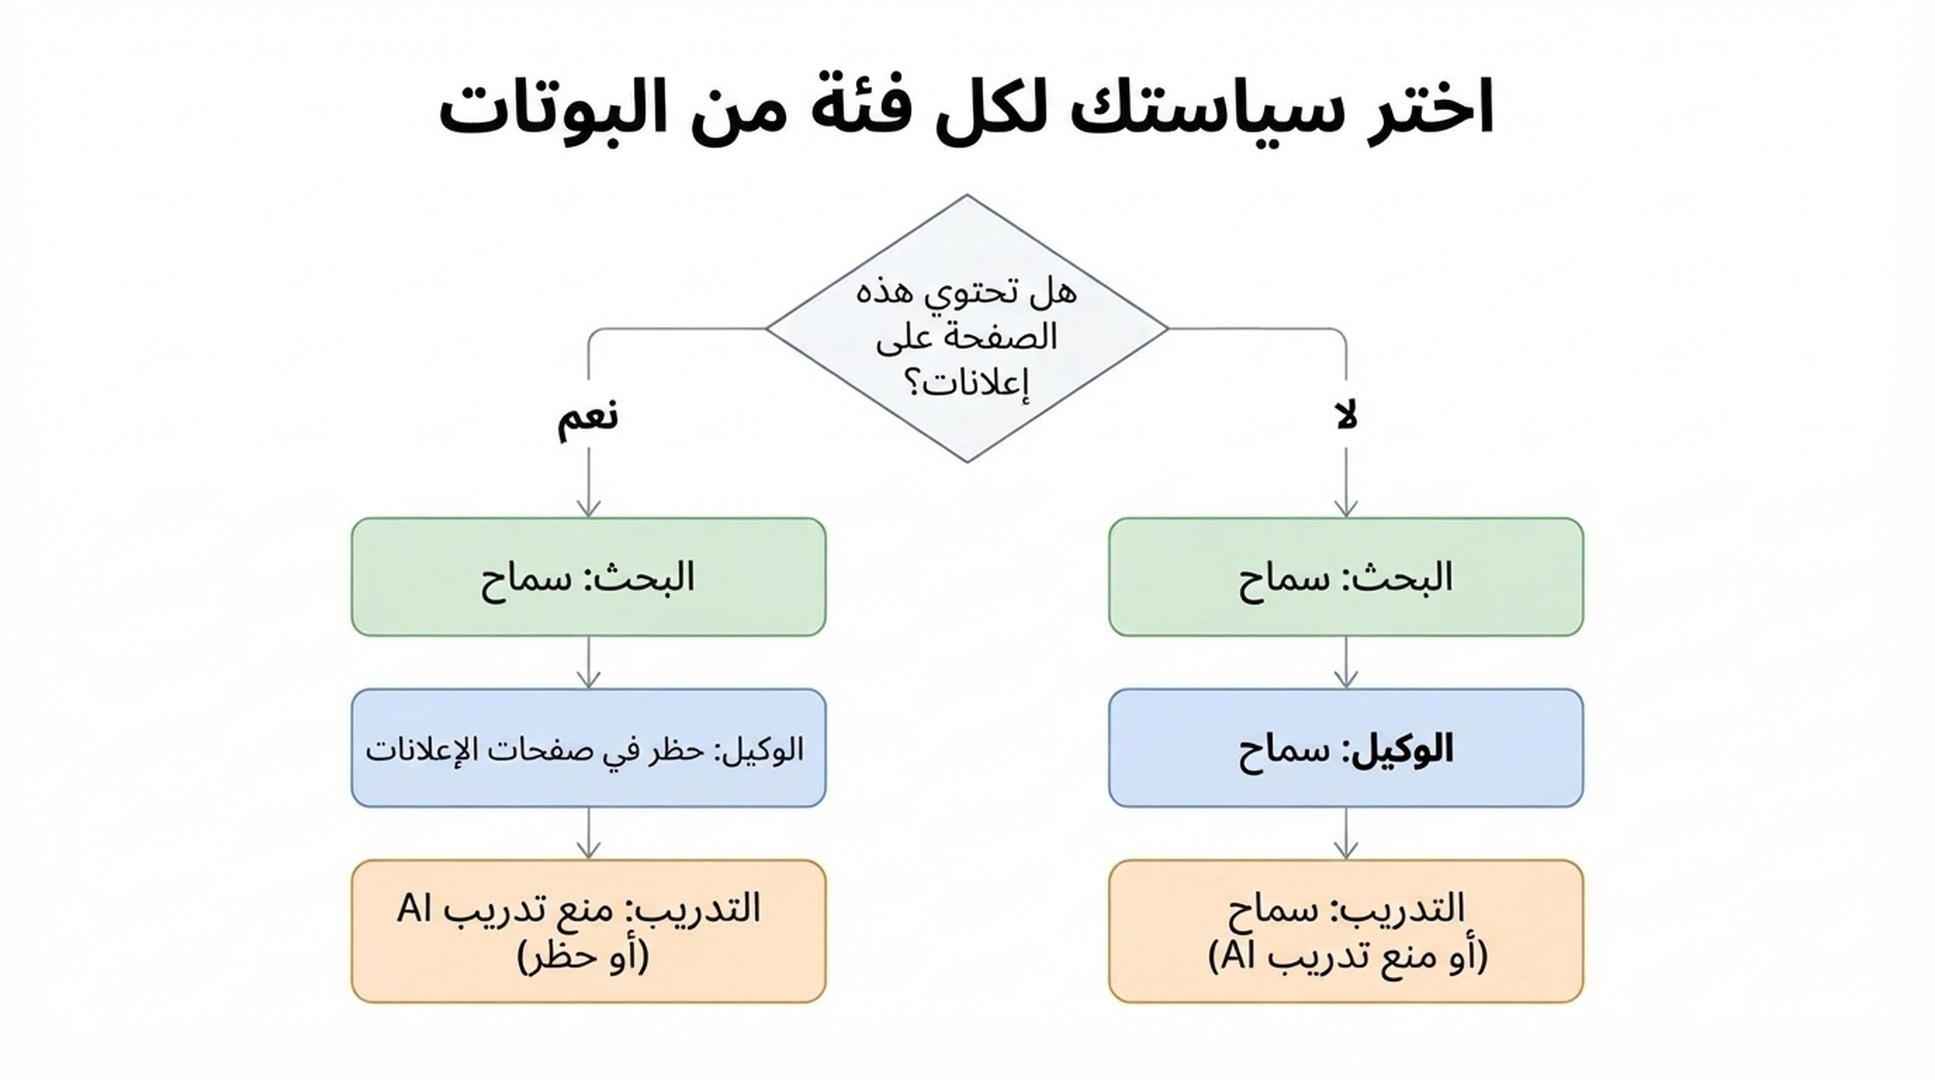
في 15 سبتمبر 2026، غيّرت Cloudflare ما يحدث تلقائيًا. لأي نطاق ينضم إلى Cloudflare في ذلك التاريخ أو بعده، إذا صُنّف الموقع بأنه يدرّ عائدات إعلانية، يصبح الإعداد الافتراضي كالتالي:
الفئة | الإعداد الافتراضي في الصفحات التي تحمل إعلانات |
|---|---|
البحث (Search) | سماح |
الوكيل (Agent) | حظر في الصفحات التي تحمل إعلانات |
التدريب (Training) | منع تدريب الذكاء الاصطناعي (Disallow AI Training) |
أما النطاقات الجديدة غير المُدرّة للإعلانات فيكون الافتراضي فيها «سماح» للفئات الثلاث. ولم يُحوَّل العملاء الحاليون بصمت — فقد منحت Cloudflare نافذة قبل يوم 15 للانسحاب عبر لوحة التحكم، وكانت قواعد الترحيل الفعلية لكل نطاق أكثر تحديدًا من إعداد افتراضي واحد جديد (نغطيها أدناه).
والسبب في أن الصفحات التي تعرض إعلانات تحصل على الافتراضي الأكثر صرامة هو أن وجود إعلان في صفحة يُعد إشارة إلى أن إنسانًا كان متوقعًا أن يراها. ووفقًا لأرقام Cloudflare نفسها، في يونيو 2026 شكّلت الزواحف مختلطة الاستخدام — تلك التي تخلط فهرسة البحث وجلب الوكيل والتدريب خلف وكيل مستخدم واحد — أكثر من 36% من حركة الزواحف الموثّقة، وهي أكبر شريحة منفردة. كما ارتفعت حصة تدريب الذكاء الاصطناعي من إجمالي طلبات الزحف على شبكة Cloudflare من نحو 22% في ربيع 2025 إلى 52% في يونيو 2026. هذه هي الحركة التي يستهدفها التغيير.
قبل أن تبدأ: ثلاثة أمور يجب فهمها عن الفئات
1. بعض الزواحف «مختلطة الاستخدام» وتتصرف بشكل مختلف بين الحظر ومنع التدريب. يؤدي Googlebot وBingbot وApplebot دورًا مزدوجًا — فهي تزحف للبحث وللتدريب معًا عبر وكيل مستخدم واحد. وتصف Cloudflare كلاً من Apple وGoogle وMicrosoft بأنها مشغّلات «Accountable» (تُساءل) لأنها تستوفي أربعة شروط: أن تحترم تفضيل robots.txt المتعلق بعدم التدريب، وأن توفر وسيلة انسحاب من الملخصات الذكية، وأن تقدم رؤية على مستوى الرابط لما استُخدم في التدريب، وأن تُثبت أن الانسحاب من التدريب لا يضر بحضورك في البحث.
2. «منع تدريب الذكاء الاصطناعي» و«الحظر» ليسا الإعداد نفسه، والفرق بينهما هو بيت القصيد. ينشر «منع تدريب الذكاء الاصطناعي» تفضيل Disallow في robots.txt موجّهًا إلى وكلاء المستخدم الخاصين بالتدريب (مثل Google-Extended وApplebot-Extended). تقرأ الزواحف المختلطة الخاضعة للمساءلة هذا التفضيل فتتخطى التدريب طوعًا وتواصل الزحف من أجل البحث — وبذلك يبقى حضورك في البحث سليمًا. أما كل زاحف تدريب آخر غير خاضع للمساءلة فيُحظر تمامًا عند الحافة، وهذا لا يمس البحث لأن هؤلاء المشغّلين يشغّلون بوتات تدريب منفصلة. في المقابل، الحظر المجرّد صار الآن يحظر Googlebot وBingbot وApplebot نفسها، أي أن محتواك يختفي أيضًا من نتائج بحثها. إذا أردت إزالة التدريب مع إبقاء البحث، فالإعداد الذي تريده هو «منع تدريب الذكاء الاصطناعي» وليس الحظر.
3. Bing لا تحترم بعد تفضيل التدريب في robots.txt. يحترم كل من Applebot وGooglebot اليوم توجيه Disallow الخاص بالتدريب. وقالت Microsoft إنها تبني ما يعادله لـ Bingbot، بهدف مبدئي في أوائل 2027. وحتى ذلك الحين، سيؤدي اختيار «منع تدريب الذكاء الاصطناعي» إلى تسجيل التفضيل في robots.txt، لكن سلوك زحف Bing بغرض التدريب لن يتغيّر من هذه الإشارة وحدها — وإذا كانت التعرّض للتدريب عبر Bing يقلقك تحديدًا، فإن وسم NOARCHIVE من Bing أو أداة Content Removal هما الرافعتان المؤقتتان.
الخطوة 1: اكتشف أين استقر موقعك فعليًا
لا تفترض أنك تعرف إعدادك الحالي — تحقّق منه.
الإجراء: في لوحة تحكم Cloudflare، افتح نطاقك وتوجّه إلى Security → Settings، وابحث عن ضوابط سياسة بوتات الذكاء الاصطناعي (واجهة الفئات الثلاث الأحدث حلّت محل مفتاح «Block AI Bots» القديم، لكن بعض الحسابات قد تُظهر المفتاح القديم إن لم تكن قد رُحّلت بعد). وبشكل منفصل، اجلب ملف robots.txt المباشر من المتصفح أو عبر curl https://yourdomain.com/robots.txt وابحث عن كتلة تبدأ بعلامة تعليق تديرها Cloudflare؛ ويمكنك أيضًا المقارنة باستخدام أداة فحص زواحف AI في Robots.txt من Auspia لترى كيف تُقرأ قواعدك الحالية من منظور زواحف الذكاء الاصطناعي.
الناتج المتوقع: ثلاثة إعدادات، واحد لكل من البحث والوكيل والتدريب، كل منها على أحد الخيارات: سماح / حظر في الصفحات التي تحمل إعلانات / حظر (و«منع تدريب الذكاء الاصطناعي» خيار رابع متاح للتدريب فقط). ويجب أن يُظهر ملف robots.txt المباشر قسمًا تديره Cloudflare يسرد وكلاء مستخدمين محددين وأسطر Disallow / Content-Signal، إن كان Bot Preference Sync أو robots.txt المُدار مُفعّلًا.
فحص الجودة: تأكد من أن الإعدادات الثلاثة تطابق ما تقصده فعلًا، لا ما افترضه الترحيل نيابةً عنك. منطق الترحيل المعلن من Cloudflare للعملاء الحاليين هو: إن كنت قد فعّلت مفتاح «Block AI» القديم، فقد نُقلت إلى التدريب = منع تدريب الذكاء الاصطناعي، والبحث بقي على سماح، والوكيل صار حظر في الصفحات التي تحمل إعلانات. وإن كنت قد ضبطت التدريب نفسه على حظر أو حظر في الصفحات التي تحمل إعلانات، فقد نُقلت إلى منع تدريب الذكاء الاصطناعي. وكل من مساري الترحيل يفترض أنك أردت الحفاظ على البحث — فإن كنت تريد فعلًا إزالة الزواحف مختلطة الاستخدام بالكامل (بما في ذلك من البحث)، فهذا ليس ما لديك الآن، وعليك اختيار الحظر صراحةً.
مسار الاستعادة: إن أظهرت إعدادات الأمان مفتاح «Block AI Bots» القديم وحده دون تقسيم للفئات الثلاث، فحسابك لم يُرحّل بعد إلى الضوابط الجديدة. ابحث عن «Configure AI bot policies» كواجهة إعدادات منفصلة وأحدث؛ فهناك تعيش الضوابط التفصيلية مستقبلًا، إلى جانب المفتاح القديم خلال فترة الانتقال.
الخطوة 2: قرّر سياستك لكل فئة، لا بجواب واحد شامل
هذه هي خطوة القرار الفعلية. ادرس كل فئة على حدة.
البحث. لا أحد تقريبًا يحظر هذه الفئة — إذ تفيد Cloudflare بأن أقل من 1% من المواقع تختار حظر بوتات البحث — لأن فقدان الظهور في البحث نادرًا ما يستحق. اجعل سماح هو الافتراضي، إلا إن كان لديك سبب محدد (بيئة اختبار، أرشيف خلف جدار دفع) لإبعاده عن فهارس البحث.
الوكيل. هذه بوتات تعمل لحظيًا نيابةً عن شخص يحاول فعل شيء على موقعك الآن — التحقق من سعر، أو إتمام حجز، أو جلب معلومة إلى إجابة محادثة. وحظر حركة الوكلاء في صفحاتك المُدرّة للإعلانات هو منطق الافتراضي الجديد، لأن زيارة الوكيل لا تولّد ظهورًا إعلانيًا كما تفعل زيارة الإنسان. وإذا كان نموذج أعمالك يعتمد على انتباه الإنسان هذا (الإعلام، مواقع المحتوى ذات الإعلانات العرضية)، فإن حظر في الصفحات التي تحمل إعلانات خيار يمكن الدفاع عنه. أما إن كنت تفضّل أن يتمكن الوكلاء من إتمام المهام على موقعك حتى في صفحات الإعلانات — مثلًا لأن حركة الوكلاء ما زالت تحقق تحويلات لديك — فاختر سماح.
التدريب. هنا يوجد القرار الحقيقي، وهنا أيضًا تُربك المصطلحات الناس:
- اختر منع تدريب الذكاء الاصطناعي إن أردت وقف استخدام محتواك في تدريب النماذج مع الحفاظ على حضورك في منتجات البحث لدى Google وBing وApple (وبالنظر إلى تأخر Bing الحالي، افهم ذلك على أنه «سليم لدى Google وApple اليوم، ومعلّق لدى Bing»). هذا هو المسار الوسطي الذي توصي به Cloudflare، والمصمم خصيصًا للمقايضة بين البحث والتدريب.
- اختر حظر فقط إن كنت مستعدًا لخسارة زحف Googlebot وBingbot وApplebot للبحث بالكامل، مقابل حظر سلوكها في وضع التدريب أيضًا. هذا هو الخيار الصارم الآن — فمنذ 15 سبتمبر، ينطبق الحظر على الزواحف مختلطة الاستخدام أيضًا، وهذا لم يكن الحال سابقًا.
- اختر سماح فقط إن كنت راضيًا عن استخدام محتواك في تدريب نماذج الذكاء الاصطناعي، مثلًا لأنك تريد أقصى تعرّض للاستشهاد في إجابات الذكاء الاصطناعي وتعتبر التعرّض للتدريب مقايضة مقبولة.
الإجراء: في Security → Settings → Configure AI bot policies، اضبط كل قائمة من القوائم الثلاث المنسدلة على قرارك.
الناتج المتوقع: يجب أن تعكس لوحة التحكم اختيارك الصريح لكل فئة، وأن تبدأ (إن كان Bot Preference Sync مفعّلًا) بنشر كتلة robots.txt مطابقة تلقائيًا — دون أي تحرير يدوي للملف.
فحص الجودة: أعد قراءة اختيارك للتدريب في ضوء هذه الجملة الواحدة: «هل أريد الحفاظ على الظهور في البحث أم لا يهمني؟» إن كان الجواب الحفاظ عليه، فهو منع تدريب الذكاء الاصطناعي وليس الحظر، مهما بدت كلمة «حظر» مغرية لإيقاف تدريب الذكاء الاصطناعي.
مسار الاستعادة: إن اخترت إعدادًا ثم انخفضت حركة البحث لديك لاحقًا، فتحقق مما إذا كنت قد اخترت الحظر بالخطأ بدل منع تدريب الذكاء الاصطناعي — فهذا هو الخطأ الأكثر شيوعًا الذي يرتكبه المرء ضد نفسه في هذا الإعداد، لأن التسمية تجعل «حظر» تبدو كأنها الخيار الذي «يفعل أكثر»، لكنها في حالة التدريب تحديدًا تفعل شيئًا قد لا تريده (تفقد البحث أيضًا).
الخطوة 3: فعّل Bot Preference Sync ليطابق robots.txt ما ضبطته
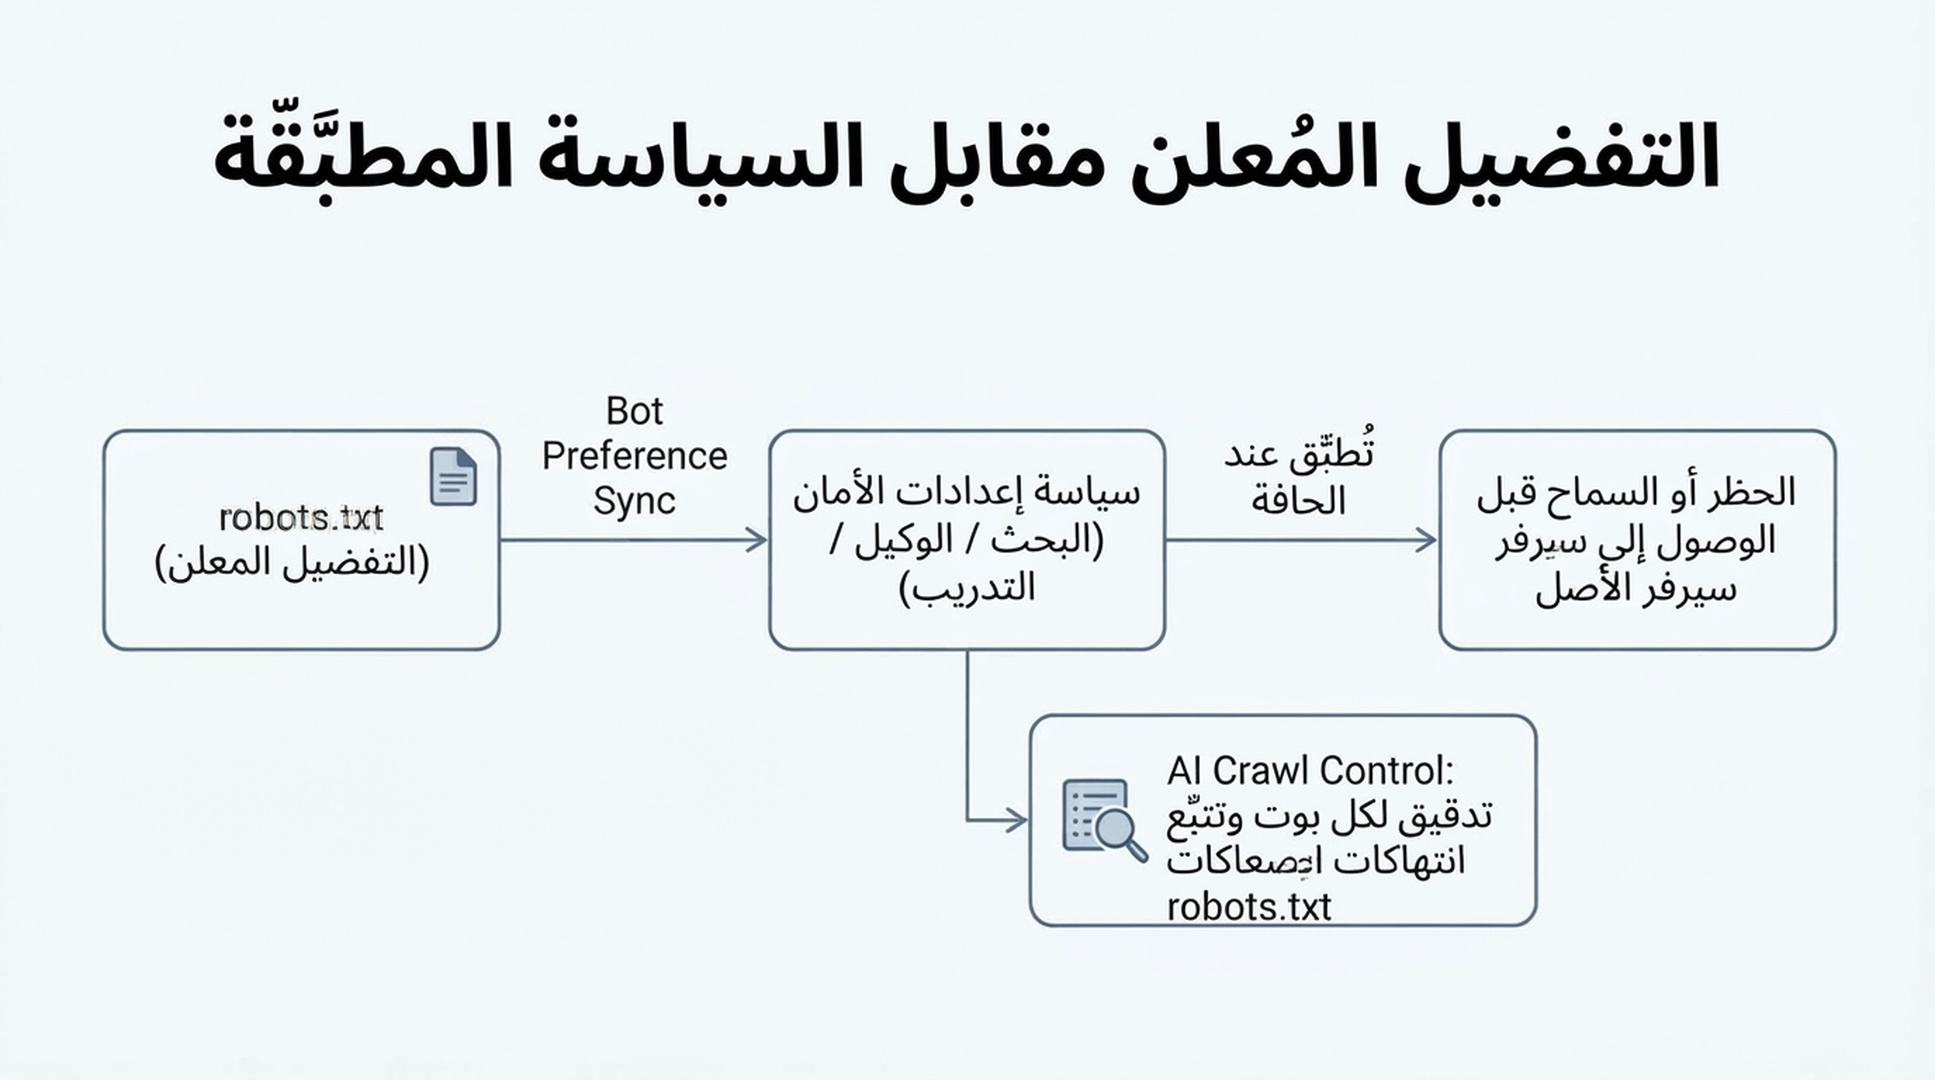
إعداد لوحة التحكم وملف robots.txt نظامان مختلفان، وعندما يتناقضان يتخذ بعض الزواحف من هذا التناقض عذرًا لتجاهل تفضيلك. تسدّ ميزة Bot Preference Sync من Cloudflare هذه الفجوة بأن تولّد ملف robots.txt مباشرة من اختياراتك في إعدادات الأمان.
الإجراء: في منطقة إعدادات سياسة البوتات نفسها، فعّل Bot Preference Sync (وهو مفعّل افتراضيًا للعملاء الجدد؛ أما العملاء الحاليون الذين يستخدمون ميزة robots.txt المُدار الأقدم فسيُطلب منهم المراجعة والتأكيد أثناء الترحيل).
الناتج المتوقع: تضيف Cloudflare كتلة مُدارة في مقدمة ملف robots.txt، محاطة بتعليقي # BEGIN Cloudflare Bot Preference Sync و# END، تسرد وكلاء المستخدم المتأثرين وقواعد Disallow الخاصة بهم — دون حذف أي قواعد مخصصة كانت لديك أصلًا في ملف robots.txt، إذ تبقى كما هي أسفل الكتلة المُدارة.
فحص الجودة: اجلب /robots.txt مرة أخرى بعد التفعيل وتأكد من ظهور الكتلة المُدارة ومن مطابقتها لاختيارات الخطوة 2 — فمثلًا إن ضبطت التدريب على منع تدريب الذكاء الاصطناعي، ينبغي أن ترى وكلاء المستخدم الخاصة بالتدريب (مثل Google-Extended وApplebot-Extended) وقد أُضيفت إليها قواعد Disallow، بينما تبقى وكلاء المستخدم العامة مثل Googlebot وApplebot وBingbot غير محظورة من أجل البحث.
مسار الاستعادة: إن كان لديك ترتيب خاص لمرة واحدة مع مشغّل زاحف معين وكانت السياسة على مستوى الفئة ستُفسده (مثل اتفاقية ترخيص محتوى مدفوعة)، فأوقف Bot Preference Sync وحرّر ملف robots.txt بنفسك بدلًا من ذلك — فمفاتيح الفئات مصممة لسياسة تشمل النطاق بأكمله، لا لاستثناءات فردية لمشغّل بعينه.
الخطوة 4: تأكد من أن سياستك مفروضة فعلًا لا مطلوبة فقط
ملف robots.txt مجرد طلب، وهو لا يوقف زاحفًا يقرر تجاهله على المستوى التقني. هذه هي الخطوة التي يتخطاها الناس، وهي الخطوة التي تخبرك ما إذا كان قرارك في الخطوة 2 حقيقيًا أم نظريًا.
الإجراء: افتح AI Crawl Control لنطاقك (متاح في جميع الخطط، بما فيها المجانية — جودة الكشف أقوى في الخطط التي تتضمن Bot Management، لكن ميزات الرؤية تعمل في كل مكان). افحص تبويب Crawlers الذي يسرد كل بوت وصل إلى موقعك مع عمود Robots.txt violations.
الناتج المتوقع: جدول بالبوتات مع عدد الطلبات وعدد الانتهاكات لكل بوت. ووجود عدد انتهاكات غير صفري لبوت ضبطته على منع أو حظر يعني أن هذا البوت يتجاهل ملف robots.txt الخاص بك حاليًا.
فحص الجودة: لأي بوت يُظهر انتهاكات، انظر في «Most popular paths» — مع التصفية على المسارات المُعلَّمة — لترى ما إذا كان يصل إلى محتوى تهتم فعلًا بحمايته.
مسار الاستعادة: إن كان بوت يتجاهل تفضيلك المُعلن، فلن يوقفه robots.txt وحده. استخدم إجراء «Enforce robots.txt rules» في AI Crawl Control (ويُشار إليه أحيانًا باسمه الداخلي Robotcop) لتحويل قواعدك المُعلنة إلى قاعدة WAF فعلية تحظر البوت غير الممتثل عند حافة Cloudflare قبل وصوله إلى خادمك الأصلي — فتنقل نفسك من طلب الامتثال إلى فرضه. تستخدم هذه الخطوة WAF، لذا يتبع توفرها مدى وصول خطتك إلى WAF.
الخطوة 5: قرّر ما إذا كنت ستُدرّ عائدًا بدل الاكتفاء بالحظر
إن كان قرارك بشأن التدريب هو «لا وصول للتدريب»، فلديك خيار ثانٍ غير الحظر المسطّح: أن تتقاضى مقابلًا.
الإجراء: إن كنت مهتمًا، سجّل في النسخة التجريبية الخاصة Pay Per Crawl من Cloudflare (عبر صفحة التسجيل لدى Cloudflare، أو عبر مدير حسابك إن كنت عميل Enterprise). وبعد تفعيلها على مستوى الحساب (Manage Account → Settings → Pay Per Crawl → اضبط Visibility لنطاقك على Visible)، يمكنك تحديد سعر ثابت واحد لكل طلب على مستوى نطاقك، واختيار أحد الخيارات لكل زاحف: سماح (مجانًا)، أو احتساب (بالفاتورة وفق سعرك)، أو حظر.
الناتج المتوقع: عندما يطلب زاحف يُوثّق نفسه عبر Web Bot Auth (طلب موقّع بـ Ed25519 يعرّف الزاحف) صفحة ضبطتها على «احتساب»، فإنه يتلقى استجابة HTTP 402 Payment Required تحمل ترويسة crawler-price؛ وإن أعاد المحاولة موافقًا على الدفع، أو أرفق مسبقًا ترويسة crawler-max-price تغطي سعرك، فإنه يحصل على المحتوى مع ترويسة crawler-charged تؤكد المبلغ المُحتسب. وتعمل Cloudflare كتاجر مسجّل وتتولى التسوية.
فحص الجودة: هذا لا يعمل إلا مع الزواحف التي سجّلت بيانات دفع لدى Cloudflare وتدعم مسار 402 — فهو ليس مفتاحًا شاملًا لكل بوت. ومع كل من سواهم، يتصرف إعداد «احتساب» عمليًا كالحظر، وتشير Cloudflare إلى أنه يظل مع ذلك مؤشرًا على انفتاحك على علاقة مدفوعة في المستقبل.
مسار الاستعادة: هذه الميزة في نسخة تجريبية خاصة؛ فإن لم تُقبل فيها أو لم ترد الانتظار، يبقى «منع تدريب الذكاء الاصطناعي» أو «حظر» هما الخيارين المتاحين اليوم لهؤلاء الزواحف نفسها.
التعامل مع الاستثناء: ماذا لو طلب مشغّل ذكاء اصطناعي معيّن الوصول؟
قد يصلك طلب وارد — شراكة، أو اتفاق استشهاد، أو محادثة ترخيص — من شركة ذكاء اصطناعي تريد وصولًا صريحًا على الرغم من سياستك الشاملة للنطاق.
وهناك طريقتان لمنح استثناء ضيق دون إعادة فتح الفئة بأكملها:
- تجاوز لكل زاحف في Manage AI crawlers: غيّر صف ذلك البوت تحديدًا من حظر/احتساب إلى سماح، بشكل مستقل عن إعدادك الشامل للتدريب أو الوكيل.
- تحرير robots.txt يدويًا: إن أوقفت Bot Preference Sync (أو جعلت الاستثناء خارج الكتلة المُدارة)، يمكنك إضافة سماح موجّه لذلك الوكيل الواحد أسفل القسم الذي تديره Cloudflare.
وفي كلتا الحالتين، أبقِ سياسة الفئات الشاملة للنطاق هي الافتراضية، وتعامل مع الاستثناءات المسماة كقرارات مقصودة وموثّقة — لا العكس.
تحقّق من النتيجة النهائية
نفّذ قائمة التحقق هذه بعد أن يصبح إعدادك فعّالًا:
- [ ] تُظهر إعدادات الأمان قيمة صريحة ومقصودة للبحث والوكيل والتدريب — وليس إعدادًا افتراضيًا لم تراجعه
- [ ] يُظهر
/robots.txtعلى نطاقك المباشر كتلة مُدارة من Cloudflare تطابق تلك الإعدادات - [ ] يعرض تبويب Crawlers في AI Crawl Control البوتات التي تتوقعها، مع انتهاكات عند الصفر أو قريبة منه لكل ما ضبطته على حظر/منع
- [ ] إن اخترت منع تدريب الذكاء الاصطناعي، فقد تأكدت (عبر Search Console / Bing Webmaster Tools، أو بمجرد مراقبة الحركة العضوية) من استمرار زحف Googlebot / Applebot للبحث بشكل طبيعي
- [ ] إن فعّلت فرض robots.txt (Robotcop)، فقاعدة WAF الناتجة منشورة وفعّالة، لا مجرد مُولَّدة ومتروكة كمسودة
- [ ] وثّقت أي إعداد اخترت ولماذا، حتى لا تبدأ أي مراجعة مستقبلية من الصفر
حافظ على النتيجة
هذا ليس إعدادًا يُضبط ثم يُنسى. أعد النظر فيه بإيقاع خفيف:
- شهريًا: افحص تبويب Metrics في AI Crawl Control بحثًا عن بوتات جديدة لم تحدد لها سياسة، وأعد التحقق من عدد الانتهاكات.
- عندما تُطلق Bing دعم تفضيل التدريب لـ Bingbot (بهدف مبدئي في أوائل 2027 وفق Microsoft)، أعد تقييم ما إذا كان إعدادك الحالي ما زال يحقق لك النتيجة المقصودة «بحث محفوظ وتدريب محظور»، لأن تلك هي النقطة التي تلحق فيها Bing بسلوك Google وApple الحالي.
- كلما تغيّرت حالة الإدرار الإعلاني لديك — فإضافة الإعلانات العرضية أو إزالتها يغيّر المسار الافتراضي الذي تقع فيه صفحاتك، ويستحق ذلك إعادة تأكيد أن إعداداتك الصريحة ما زالت منطقية في ضوئه.
الأسئلة الشائعة
هل يضر حظر زواحف التدريب بترتيبي في SEO؟ لا، إن استخدمت «منع تدريب الذكاء الاصطناعي» بدل «حظر». فمنع تدريب الذكاء الاصطناعي مصمم تحديدًا كي تواصل الزواحف المختلطة الخاضعة للمساءلة (Google وApple وBing لاحقًا) الزحف من أجل البحث مع تخطي التدريب. أما الحظر المجرّد فيحظر الآن أيضًا سلوك البحث لدى هذه الزواحف نفسها، وهذا سيضر بظهورك في منتجات بحثها.
كنت قد فعّلت «Block AI Bots» قبل 15 سبتمبر. ماذا حدث لإعدادي؟ رحّلته Cloudflare تلقائيًا: صار Block AI Bots القديم التدريب = منع تدريب الذكاء الاصطناعي، والبحث = سماح، والوكيل = حظر في الصفحات التي تحمل إعلانات. تحقق من أن هذا حدث فعلًا كما هو متوقع باستخدام الخطوة 1 أعلاه، بدلًا من افتراض أن الترحيل طابق نيتك.
هل شيء من هذا متاح في الخطة المجانية؟ نعم. AI Crawl Control وإعدادات فئات البحث/الوكيل/التدريب وBot Preference Sync كلها متاحة في جميع الخطط، بما فيها المجانية. وتختلف بعض تفاصيل الفرض بحسب الخطة — فمثلًا يجري فرض robots.txt عبر WAF، ويعتمد كشف البوتات في الخطة المجانية على سلاسل وكيل المستخدم بدلًا من معرّف الكشف الأكثر تقدمًا في Bot Management.
ما الفرق بين AI Crawl Control وإعدادات الأمان لبوتات الذكاء الاصطناعي؟ إعدادات الأمان هي حيث تحدد سياستك (سماح / حظر في صفحات الإعلانات / حظر / منع تدريب الذكاء الاصطناعي لكل فئة). أما AI Crawl Control فهي حيث تدقّق ما يحدث فعلًا — عدد الطلبات لكل بوت، وانتهاكات robots.txt، وتفاصيل على مستوى المسار — وحيث يمكنك تحويل سياسة robots.txt المُعلنة إلى قاعدة WAF مفروضة.
هل أحتاج إلى تحرير robots.txt يدويًا بعد ضبط هذه الإعدادات؟ لا، إن كان Bot Preference Sync مفعّلًا — فهو يكتب كتلة robots.txt المناسبة ويصونها لك بناءً على إعدادات لوحة التحكم. ولا يلزم التحرير اليدوي إلا للاستثناءات المخصصة لمشغّل بعينه خارج الفئات المُدارة.
المؤلف: Julian Mercer، ممارس تقني في SEO بخبرة 14 عامًا في Auspia. يكتب عن قابلية الزحف، والبنية المنظمة، والعرض، والأساسات التقنية للمحتوى القابل للقراءة من أنظمة الذكاء الاصطناعي.