Qué vas a tener al terminar esta guía
Al acabar esta guía, tu dominio de Cloudflare tendrá una política explícita y deliberada para las tres categorías separadas de tráfico de bots de IA —búsqueda (Search), agentes (Agent) y entrenamiento (Training)— en lugar de la configuración predeterminada que tu dominio acabó heredando. Sabrás exactamente qué rastreadores están permitidos, cuáles bloqueados y en qué páginas, con tu robots.txt y la regla de aplicación en el edge realmente coherentes entre sí.
Para quién es esto: cualquier persona que gestione un sitio detrás de Cloudflare —medios, webs de marketing de SaaS, tiendas de comercio electrónico, blogs— y quiera decidir por sí misma si los sistemas de IA pueden entrenar, resumir o navegar por su contenido mediante agentes, en vez de heredar el ajuste que eligió la plataforma.
Qué necesitas:
- Un dominio con proxy a través de Cloudflare (cualquier plan, incluido el gratuito; algunos pasos de abajo son exclusivos de planes de pago y así están señalados)
- Acceso al panel con permiso al menos para cambiar la configuración de seguridad a nivel de dominio
- Entre 20 y 30 minutos para auditar y configurar; después, unos minutos al día o a la semana de seguimiento
Definición de terminado: la configuración de seguridad de tu zona muestra una elección deliberada (no un valor predeterminado sin revisar) para búsqueda, agentes y entrenamiento; el /robots.txt en producción refleja esa elección; y has confirmado en AI Crawl Control que los bots que deberían estar bloqueados efectivamente lo están.
Por qué esto se volvió importante de golpe: qué cambió el 15 de septiembre
Cloudflare construyó sus controles de tráfico de IA por etapas, empezando por añadir la Content Signals Policy al robots.txt en septiembre de 2025 y llegando al lanzamiento del «Content Independence Day» el 1 de julio de 2026, que por primera vez separó el comportamiento de los bots de IA en tres categorías con nombre propio, en lugar de un único interruptor tosco de «es IA o no lo es»:
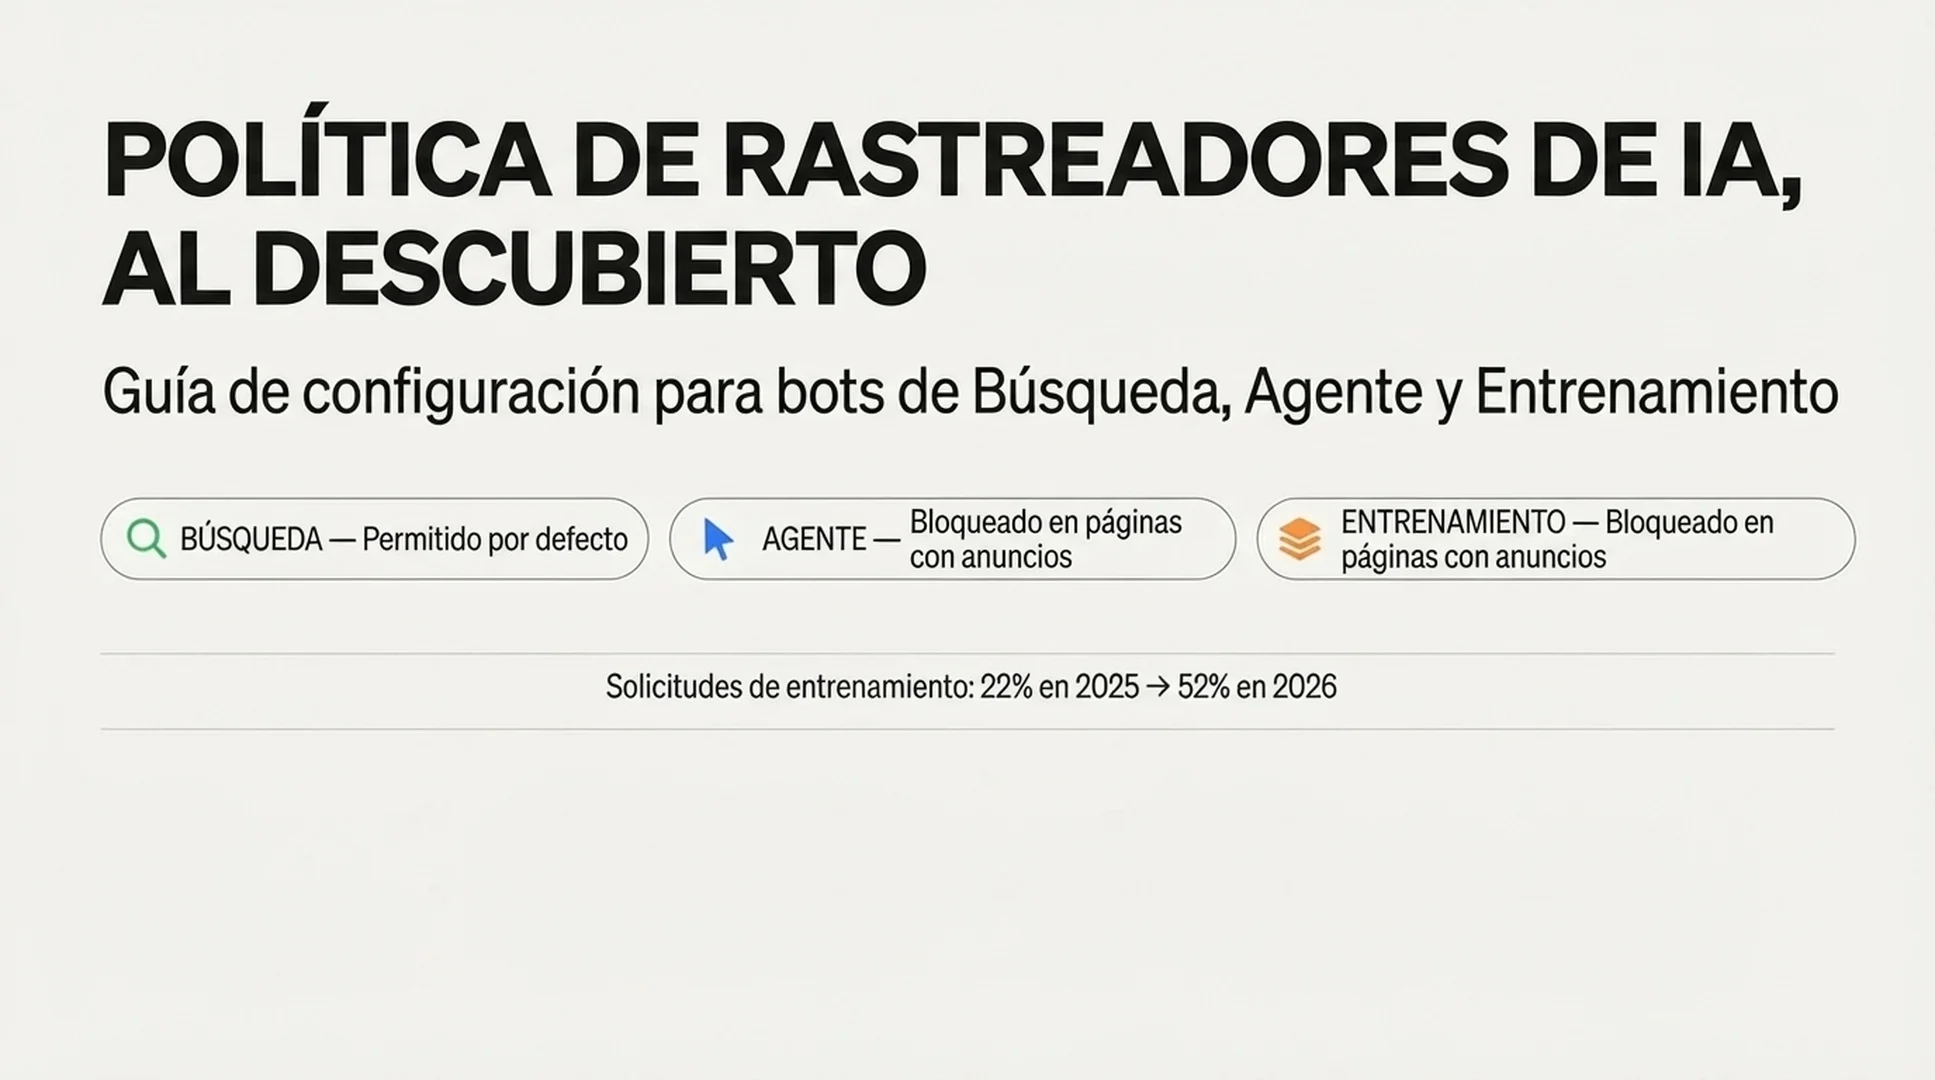
- Búsqueda (Search) — rastreo que construye un índice de búsqueda y luego devuelve enlaces o fragmentos breves. En palabras de la propia Cloudflare, es el tráfico que debería traerte referencias.
- Agente (Agent) — actividad automatizada que actúa en nombre de una persona en tiempo real, como un asistente de chat obteniendo una página o un agente de navegador completando una tarea.
- Entrenamiento (Training) — rastreo para entrenar o ajustar un modelo, en el que tu contenido se absorbe de forma permanente en los pesos del modelo en vez de volver a ti como un enlace.
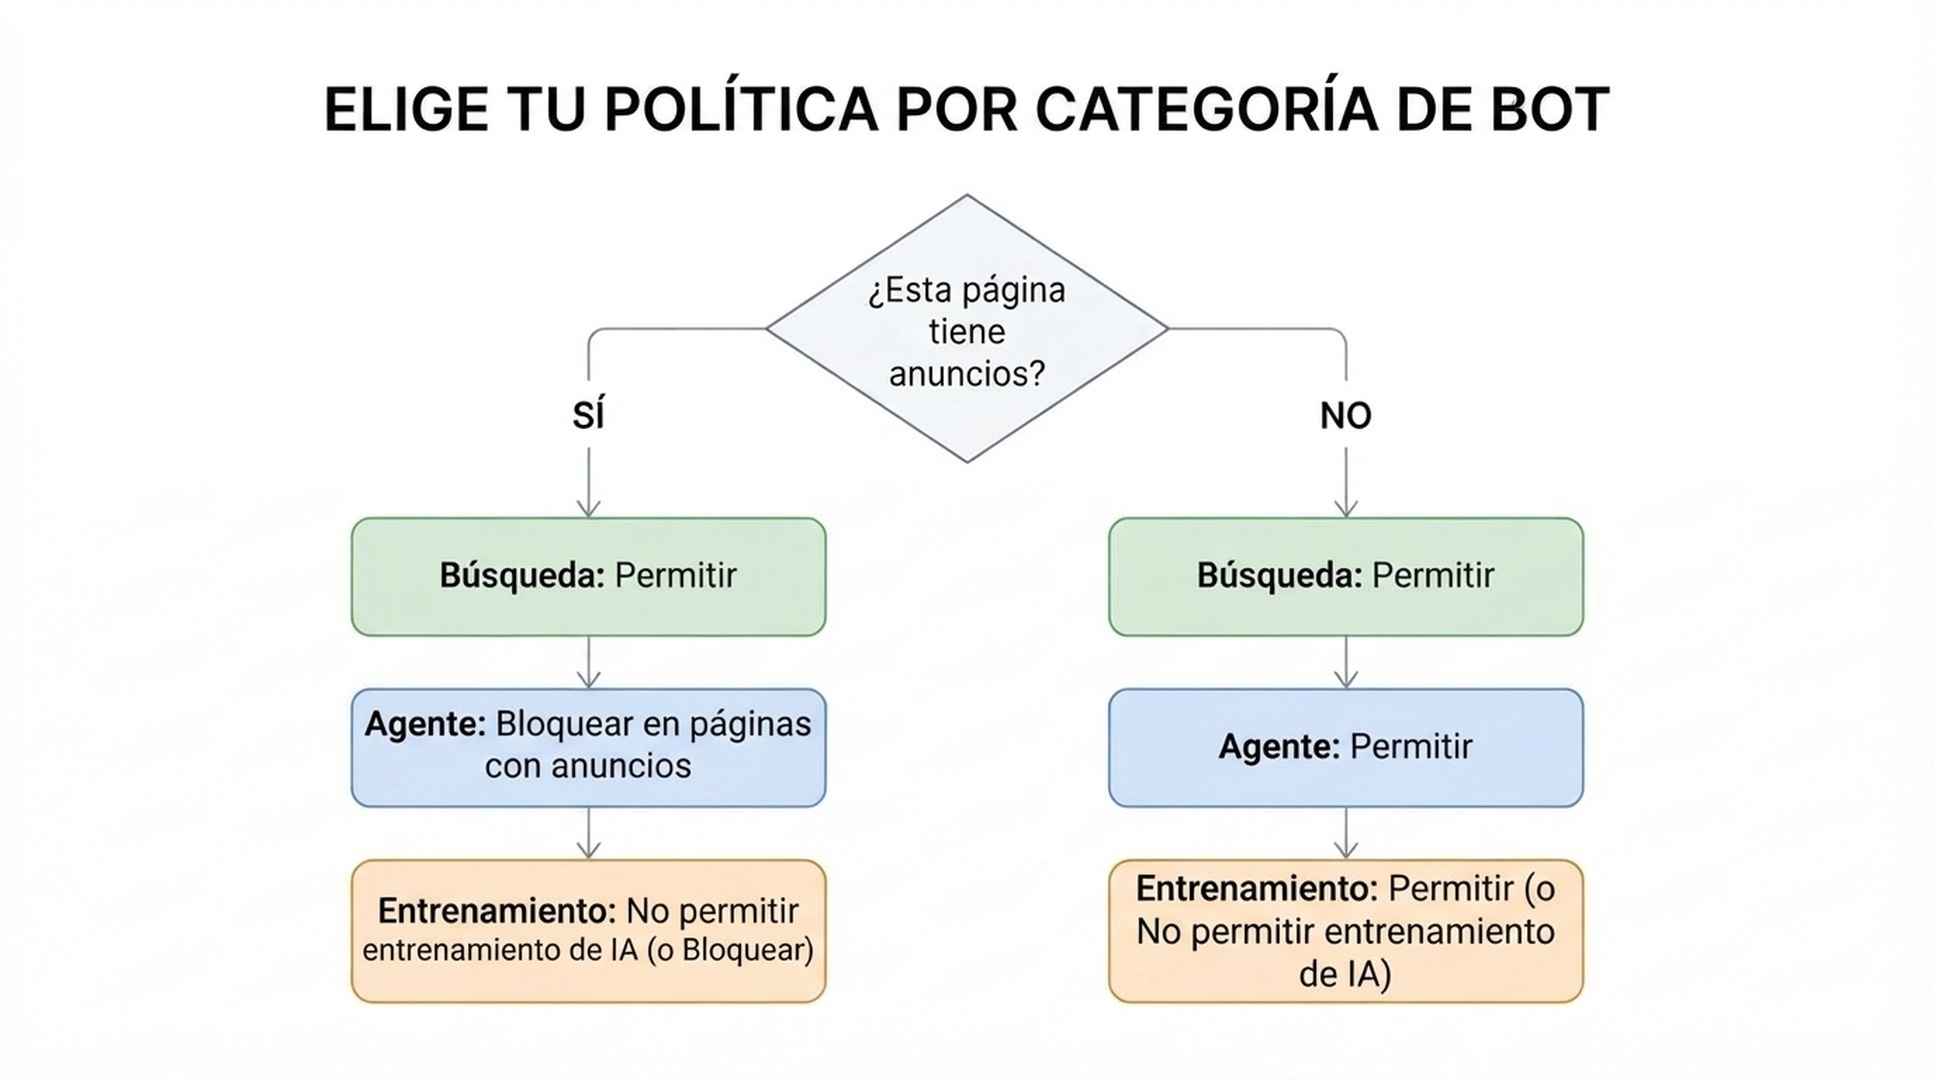
El 15 de septiembre de 2026, Cloudflare cambió lo que ocurre de forma automática. Para cualquier dominio que se incorpore a Cloudflare en esa fecha o después, si el sitio está marcado como monetizado con anuncios, la configuración predeterminada pasa a ser:
Categoría | Predeterminado en páginas con anuncios |
|---|---|
Búsqueda (Search) | Permitir |
Agente (Agent) | Bloquear en páginas con anuncios |
Entrenamiento (Training) | No permitir entrenamiento de IA (Disallow AI Training) |
Los dominios nuevos sin monetización con anuncios reciben Permitir en las tres categorías de forma predeterminada. A los clientes existentes no se les cambió en silencio: Cloudflare dio una ventana antes del día 15 para darse de baja desde el panel, y las reglas reales de migración por dominio acabaron siendo más matizadas que un único valor predeterminado nuevo (lo detallamos abajo).
La razón de que las páginas con anuncios reciban un valor predeterminado más estricto es que la presencia de anuncios en la página es una señal de que esa página estaba pensada para que la viera una persona. Según los propios datos de Cloudflare, en junio de 2026 los rastreadores de uso mixto —los que combinan indexación de búsqueda, solicitudes de agentes y entrenamiento bajo un mismo user agent— representaban más del 36% del tráfico verificado de rastreadores, la mayor categoría individual. Y la proporción de entrenamiento de IA sobre el total de solicitudes de rastreadores en la red de Cloudflare subió de alrededor del 22% en la primavera de 2025 al 52% en junio de 2026. El cambio apunta justo a ese tráfico.
Antes de empezar: tres cosas que hay que entender sobre las categorías
1. Algunos rastreadores son de uso mixto y se comportan distinto bajo bloqueo y bajo prohibición de entrenamiento. Googlebot, Bingbot y Applebot hacen doble trabajo: rastrean tanto para búsqueda como para entrenamiento bajo el mismo user agent. Cloudflare llama a Apple, Google y Microsoft operadores «Accountable» (responsables) porque cumplen cuatro condiciones: respetan la preferencia de no entrenar en el robots.txt, ofrecen una forma de rechazar los resúmenes hechos con IA, dan visibilidad a nivel de URL sobre qué se usó para entrenamiento y pueden demostrar que rechazar el entrenamiento no perjudica tu presencia en búsqueda.
2. «No permitir entrenamiento de IA» y «Bloquear» no son el mismo ajuste, y esa diferencia es justamente el punto. No permitir entrenamiento de IA publica una preferencia Disallow en el robots.txt dirigida a user agents específicos de entrenamiento (como Google-Extended y Applebot-Extended). Los rastreadores de uso mixto que son responsables leen esa preferencia y siguen rastreando voluntariamente para búsqueda, saltándose el entrenamiento, de modo que tu presencia en búsqueda se conserva. Otros rastreadores de entrenamiento que no pertenecen a operadores responsables se bloquean en el edge de inmediato, y eso no afecta a la búsqueda, porque esos operadores ejecutan bots de entrenamiento separados. En cambio, el Bloquear simple ahora bloquea a los propios Googlebot, Bingbot y Applebot, lo que significa que tu contenido desaparece también de sus resultados de búsqueda. Si quieres que el entrenamiento desaparezca y la búsqueda se quede, el ajuste correcto es «No permitir entrenamiento de IA», no «Bloquear».
3. Bing todavía no respeta la preferencia de entrenamiento en el robots.txt. Hoy, tanto Applebot como Googlebot cumplen la directiva Disallow específica de entrenamiento. Microsoft afirma estar construyendo un mecanismo equivalente para Bingbot, con objetivo para principios de 2027. Hasta entonces, elegir «No permitir entrenamiento de IA» pone tu preferencia en el robots.txt, pero el comportamiento de rastreo de Bing para entrenamiento no cambia solo por esa señal: la metaetiqueta NOARCHIVE del propio Bing o su herramienta Content Removal siguen siendo las palancas temporales si lo que te preocupa es concretamente el entrenamiento vía Bing.
Paso 1: Averigua dónde acabó realmente tu sitio
No des por hecho que conoces la configuración actual: compruébalo.
Acción: en el panel de Cloudflare, abre tu dominio, ve a Security → Settings y localiza los controles de política de bots de IA (la interfaz más reciente con tres categorías sustituyó al antiguo interruptor único «Block AI Bots», pero las cuentas que aún no han migrado pueden seguir mostrando el interruptor viejo). Aparte, solicita el robots.txt en producción en el navegador o con curl https://yourdomain.com/robots.txt y busca un bloque que empiece con un comentario marcador gestionado por Cloudflare; también puedes contrastarlo con el verificador de rastreadores de IA en robots.txt de Auspia para ver cómo leen los rastreadores de IA tus reglas actuales.
Resultado esperado: tres ajustes, uno para búsqueda, otro para agentes y otro para entrenamiento, cada uno en Permitir / Bloquear en páginas con anuncios / Bloquear (con «No permitir entrenamiento de IA» como cuarta opción, exclusiva de entrenamiento). El robots.txt en producción debería mostrar una sección gestionada por Cloudflare con la lista de user agents concretos y las líneas de Disallow / Content-Signal, si Bot Preference Sync o el robots.txt gestionado están activos.
Comprobación de calidad: confirma que los tres ajustes corresponden a lo que de verdad quieres, y no a lo que la migración dio por supuesto por ti. La lógica de migración para clientes existentes que documenta Cloudflare es: si tenías activado el antiguo interruptor «Block AI», te movieron a entrenamiento = No permitir entrenamiento de IA, búsqueda se mantuvo en Permitir y agente quedó en Bloquear en páginas con anuncios. Si tenías el propio entrenamiento en Bloquear o Bloquear en páginas con anuncios, te movieron a No permitir entrenamiento de IA. Ambas rutas de migración asumen que querías conservar la búsqueda. Si en realidad querías que los rastreadores de uso mixto desaparecieran por completo, incluida la búsqueda, ese no es tu estado actual, y tienes que elegir Bloquear de forma explícita.
Ruta de recuperación: si la configuración de seguridad muestra solo el antiguo interruptor «Block AI Bots» sin la división en tres categorías, tu cuenta aún no ha migrado a los controles nuevos. Busca «Configure AI bot policies», una pantalla de configuración aparte y más reciente; ahí es donde viven los controles detallados junto al interruptor antiguo durante la transición, y hacia ahí apunta el futuro.
Paso 2: Decide la política categoría por categoría, no con una respuesta genérica única
Este es el paso de decisión propiamente dicho. Recorre cada categoría por separado.
Búsqueda. Casi nadie la bloquea —Cloudflare informa de que menos del 1% de los sitios opta por bloquear bots de búsqueda— porque perder visibilidad en búsqueda casi nunca compensa. Pon Permitir por defecto, salvo que tengas un motivo concreto (un entorno de pruebas, un archivo tras un muro de pago) para mantener el sitio fuera de los índices de búsqueda.
Agentes. Son bots que actúan en tiempo real en nombre de alguien que intenta hacer algo en tu sitio ahora mismo: consultar un precio, completar una reserva, extraer un dato para una respuesta de chat. Bloquear tráfico de agentes en páginas monetizadas o con anuncios es la razón que hay detrás del nuevo valor predeterminado, porque una visita de agente no genera la impresión publicitaria que generaría una visita humana. Si tu modelo de negocio depende de esa atención humana (medios, sitios de contenido con display ads), Bloquear en páginas con anuncios es una postura defendible. Si prefieres que los agentes puedan completar tareas en tu sitio incluso en páginas con anuncios —por ejemplo, porque el tráfico de agentes aún te convierte—, elige Permitir.
Entrenamiento. Aquí está la decisión de verdad, y es donde la terminología confunde:
- Elige No permitir entrenamiento de IA si quieres impedir que tu contenido se use para entrenar modelos manteniendo la presencia en los productos de búsqueda de Google, Bing y Apple (dado el retraso actual de Bing, entiéndelo como «hoy vale para Google y Apple, y queda pendiente para Bing»). Es el punto medio recomendado por Cloudflare, creado a propósito para la disyuntiva entre búsqueda y entrenamiento.
- Elige Bloquear solo si estás dispuesto a perder por completo el rastreo de búsqueda de Googlebot, Bingbot y Applebot como precio de bloquear su comportamiento en modo entrenamiento. Ahora es la opción estricta: desde el 15 de septiembre, el bloqueo también se aplica a los rastreadores de uso mixto, algo que antes no ocurría.
- Elige Permitir solo si aceptas deliberadamente que tu contenido entrene modelos de IA, por ejemplo porque quieres maximizar la visibilidad en respuestas de IA y consideras el entrenamiento un precio asumible.
Acción: en Security → Settings → Configure AI bot policies, ajusta los tres menús según tu decisión.
Resultado esperado: el panel debería reflejar tu elección explícita en cada categoría y (si Bot Preference Sync está activado) empezar a publicar automáticamente el bloque correspondiente de robots.txt, sin edición manual de archivos.
Comprobación de calidad: relee tu decisión sobre entrenamiento con una sola pregunta: «¿Quiero conservar mi visibilidad en búsqueda o no?». Si la respuesta es sí, eso es No permitir entrenamiento de IA, no Bloquear, por muy tentador que suene el término «Bloquear» para detener el entrenamiento de IA.
Ruta de recuperación: si el tráfico de búsqueda cayó después de que eligieras un ajuste, comprueba si seleccionaste Bloquear en lugar de No permitir entrenamiento de IA. Es el error autodestructivo más común aquí: el nombre hace que «Bloquear» suene como la opción que «hace más», pero, para entrenamiento, hace lo que puede que no quieras, que es llevarse la búsqueda por delante.
Paso 3: Activa Bot Preference Sync para que el robots.txt acompañe tus ajustes
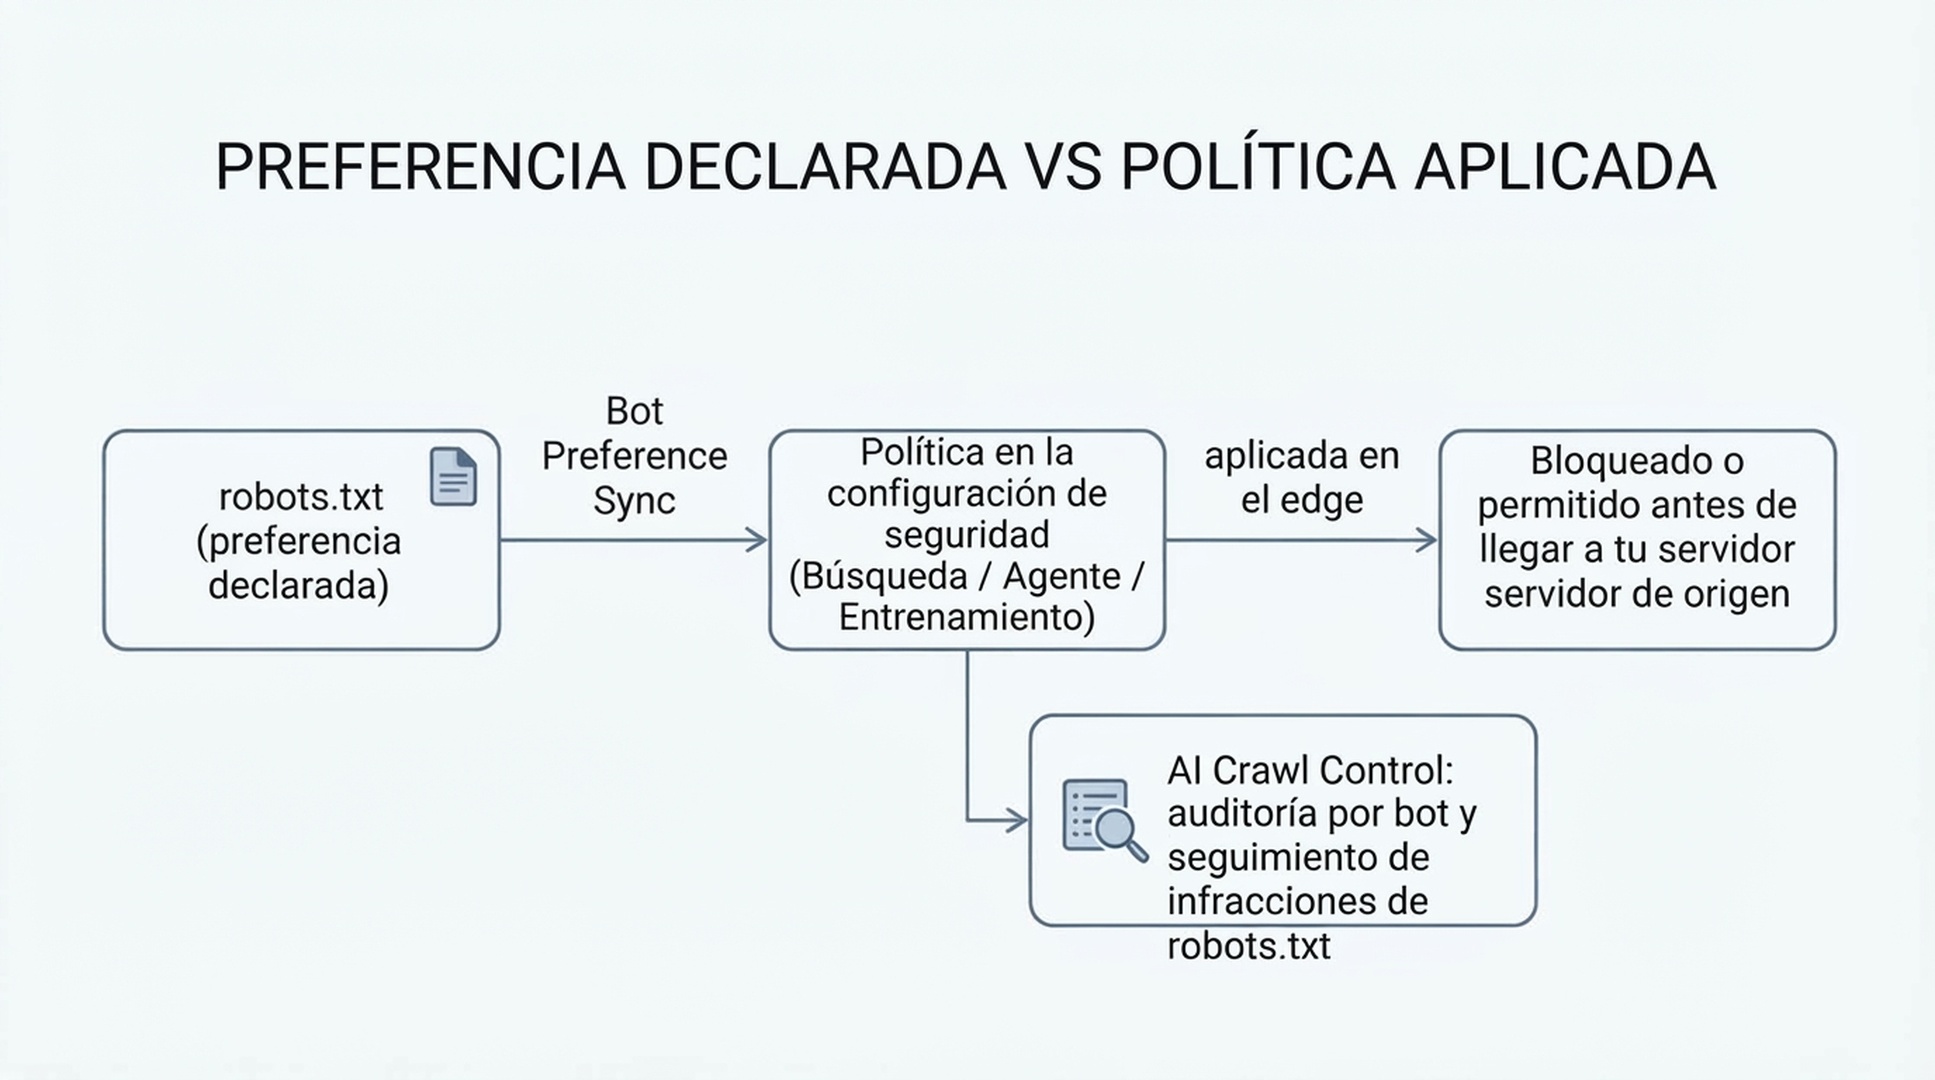
La configuración del panel y el archivo robots.txt son dos sistemas distintos, y cuando divergen algunos rastreadores usan esa brecha como excusa para ignorar tu preferencia. Bot Preference Sync de Cloudflare cierra esa brecha generando tu robots.txt directamente a partir de los ajustes de seguridad que elijas.
Acción: en la misma zona de configuración de política de bots de IA, activa Bot Preference Sync (viene activado por defecto para clientes nuevos; a los clientes existentes que usan la función más antigua de robots.txt gestionado se les pedirá revisar y confirmar durante la migración).
Resultado esperado: Cloudflare añade un bloque gestionado al principio de tu robots.txt, envuelto en los comentarios # BEGIN Cloudflare Bot Preference Sync / # END, con la lista de los user agents afectados y sus reglas de Disallow, y no elimina ninguna regla propia que ya tuvieras en el robots.txt: esas permanecen por debajo del bloque gestionado.
Comprobación de calidad: solicita /robots.txt otra vez tras activarlo y confirma que el bloque gestionado aparece y coincide con las elecciones del Paso 2. Por ejemplo, si pusiste entrenamiento en No permitir entrenamiento de IA, deberías ver los user agents específicos de entrenamiento (Google-Extended, Applebot-Extended) con reglas de Disallow, mientras que los user agents genéricos Googlebot / Applebot / Bingbot siguen sin bloquear para búsqueda.
Ruta de recuperación: si tienes un acuerdo puntual con un operador de rastreadores concreto que una política a nivel de categoría rompería (por ejemplo, un contrato de licencia de contenido de pago), desactiva Bot Preference Sync y edita tu propio robots.txt a mano: los interruptores de categoría existen para política de zona completa, no para excepciones por operador.
Paso 4: Confirma que la política se aplica de verdad y no solo se solicita
El robots.txt es una petición en términos técnicos: no detiene a un rastreador que lo ignore. Este es el paso que la gente se salta, y es el que muestra si tu decisión del Paso 2 es real o solo teoría.
Acción: abre AI Crawl Control de tu zona (disponible en todos los planes, incluido el gratuito; la calidad de detección es mejor en planes con Bot Management, pero las funciones de visibilidad funcionan en todos). Mira la pestaña Crawlers, que lista todos los bots que han llegado a tu sitio, con una columna de Robots.txt violations.
Resultado esperado: una tabla con el recuento de solicitudes y el de violaciones por bot. Un recuento de violaciones distinto de cero en un bot que pusiste como no permitido o bloqueado significa que ese bot está ignorando tu robots.txt ahora mismo.
Comprobación de calidad: para cualquier bot con violaciones, mira «Most popular paths» (filtrando por las rutas señaladas) y observa qué está solicitando en realidad, para decidir si está alcanzando contenido que de verdad te importa proteger.
Ruta de recuperación: si un bot ignora tu preferencia declarada, el robots.txt por sí solo no lo va a detener. Usa la acción «Enforce robots.txt rules» de AI Crawl Control (a veces llamada por su nombre interno Robotcop) para convertir tus reglas declaradas en una regla de WAF real que bloquee al bot desobediente en el edge de Cloudflare antes de que llegue a tu servidor de origen: pasas de «pedir cumplimiento» a «exigir cumplimiento». Este paso usa WAF, así que la disponibilidad depende de que tu plan tenga acceso a WAF.
Paso 5: Decide entre bloquear sin más o cobrar por el acceso
Si tu decisión sobre entrenamiento fue «sin acceso para entrenamiento», tienes una segunda opción además de bloquear sin más: cobrar.
Acción: si te interesa, solicita el beta cerrado de Pay Per Crawl de Cloudflare (a través de la página de inscripción de Cloudflare o de tu gestor de cuentas si eres cliente Enterprise). Una vez habilitado a nivel de cuenta (Manage Account → Settings → Pay Per Crawl → pon el Visibility de tu dominio en Visible), puedes fijar un precio fijo único por solicitud para la zona y elegir, por rastreador, entre permitir (gratis), cobrar (a tu precio) o bloquear.
Resultado esperado: cuando un rastreador autenticado vía Web Bot Auth (una solicitud con firma Ed25519 que identifica al rastreador) pide una página que marcaste como de pago, recibe un HTTP 402 Payment Required con la cabecera crawler-price; si lo reintenta aceptando pagar, o incluye de antemano una cabecera crawler-max-price que cubra tu precio, recibe el contenido con la cabecera crawler-charged confirmando el importe cobrado. Cloudflare actúa como merchant of record y liquida el pago.
Comprobación de calidad: esto solo funciona contra rastreadores que hayan registrado datos de pago en Cloudflare y soporten el flujo del 402; no es un interruptor universal contra todos los bots. Para todo lo demás, tu ajuste de cobro funciona en la práctica como un bloqueo, y Cloudflare señala que aun así sirve como señal de que estás abierto a una relación de pago en el futuro.
Ruta de recuperación: la función está en beta cerrada; si no te aceptan o no quieres esperar, No permitir entrenamiento de IA o Bloquear siguen disponibles hoy para esos mismos rastreadores.
Manejar la excepción: cuando un operador de IA concreto pide acceso
Puede llegarte un acercamiento —una alianza, un acuerdo de citación, una conversación de licencia— de una empresa de IA que quiere acceso explícito fuera de la política de toda la zona.
Hay dos formas de conceder una excepción estrecha sin reabrir la categoría entera:
- Anular por rastreador en Manage AI crawlers: cambia la fila de ese bot de bloquear/cobrar a permitir, con independencia de tu ajuste de entrenamiento o agentes a nivel de categoría.
- Editar el robots.txt a mano: si desactivaste Bot Preference Sync (o colocas la excepción fuera del bloque gestionado), puedes añadir un Allow dirigido a ese user agent concreto por debajo de la sección gestionada por Cloudflare.
En cualquiera de los dos casos, mantén la política de categoría de la zona como predeterminada y trata las excepciones con nombre como decisiones deliberadas y documentadas, no al contrario.
Verifica el resultado
Recorre esta lista cuando la configuración esté en marcha:
- [ ] La configuración de seguridad muestra valores explícitos y deliberados para búsqueda, agentes y entrenamiento, no predeterminados sin revisar
- [ ] El
/robots.txten producción muestra un bloque gestionado por Cloudflare que coincide con esos ajustes - [ ] La pestaña Crawlers de AI Crawl Control muestra los bots que esperabas, con cero o casi cero violaciones en todo lo que marcaste como bloqueado/no permitido
- [ ] Si elegiste No permitir entrenamiento de IA, has confirmado (vía Search Console / Bing Webmaster Tools, o simplemente observando el tráfico orgánico) que el rastreo de búsqueda de Googlebot / Applebot continúa con normalidad
- [ ] Si activaste la aplicación del robots.txt (Robotcop), la regla de WAF resultante está desplegada y activa, y no solo creada y dejada como borrador
- [ ] Has documentado qué ajuste elegiste y por qué, para que una revisión futura no empiece desde cero
Mantén el resultado en pie
Esto no es una configuración de definir y olvidar. Vuelve a ella con un ritmo ligero:
- Mensualmente: revisa la pestaña Metrics de AI Crawl Control en busca de bots nuevos para los que aún no hayas definido política, y vuelve a comprobar los recuentos de violaciones.
- Cuando Bing lance el soporte de la preferencia de entrenamiento para Bingbot (Microsoft apunta a principios de 2027): reevalúa si tu configuración actual sigue dando el resultado que buscabas —conservar la búsqueda y bloquear el entrenamiento—, porque es justo cuando Bing alcanza el comportamiento actual de Google y Apple.
- Cada vez que cambie tu situación de monetización con anuncios: añadir o quitar display ads cambia en qué franja predeterminada caen tus páginas, y conviene reconfirmar que tus ajustes explícitos siguen teniendo sentido en ese escenario.
Preguntas frecuentes
¿Bloquear rastreadores de entrenamiento perjudicará mi posicionamiento SEO? No, si usas No permitir entrenamiento de IA en lugar de Bloquear. No permitir entrenamiento de IA se creó precisamente para que los rastreadores de uso mixto que son responsables (Google, Apple y, en el futuro, Bing) sigan rastreando para búsqueda mientras se saltan el entrenamiento. En cambio, el Bloquear simple ahora bloquea también el comportamiento de búsqueda de esos mismos rastreadores, lo que perjudicará tu visibilidad en sus productos de búsqueda.
Ya tenía «Block AI Bots» activado antes del 15 de septiembre. ¿Qué pasó con mi ajuste? Cloudflare lo migró automáticamente: el antiguo Block AI Bots pasó a entrenamiento = No permitir entrenamiento de IA, búsqueda = Permitir y agente = Bloquear en páginas con anuncios. Verifica con el Paso 1 de arriba que el resultado real quedó como esperabas, en lugar de dar por hecho que la migración coincidió con tu intención.
¿Algo de esto está disponible en el plan gratuito? Sí. AI Crawl Control, los ajustes de categoría de búsqueda/agentes/entrenamiento y Bot Preference Sync funcionan en todos los planes, incluido el gratuito. Algunos detalles de aplicación varían según el plan: por ejemplo, la aplicación del robots.txt opera vía WAF, y la detección de bots en el plan gratuito se apoya en cadenas de user agent en lugar del identificador de detección más avanzado de Bot Management.
¿En qué se diferencia AI Crawl Control de los ajustes de seguridad de bots de IA? Los ajustes de seguridad son donde defines la política (permitir / bloquear en páginas con anuncios / bloquear / no permitir entrenamiento de IA por categoría). AI Crawl Control es donde auditás lo que ocurre de verdad —recuentos de solicitudes por bot, violaciones de robots.txt, detalle por ruta— y donde puedes convertir la política declarada en el robots.txt en una regla de WAF aplicada.
¿Tengo que editar el robots.txt a mano después de configurar esto? No, si Bot Preference Sync está activo: escribe y mantiene el bloque de robots.txt adecuado a partir de tus ajustes en el panel. La edición manual solo hace falta para excepciones puntuales de un operador concreto, fuera de las categorías gestionadas.
Autor: Julian Mercer, profesional de SEO técnico con 14 años de experiencia en Auspia. Escribe sobre rastreabilidad, datos estructurados, renderizado y los fundamentos técnicos que hacen que el contenido sea legible por la IA.