O que você terá ao final deste guia
Ao terminar este guia, seu domínio na Cloudflare terá uma política explícita e deliberada para as três categorias separadas de tráfego de bots de IA — busca (Search), agentes (Agent) e treinamento (Training) — em vez do padrão que o seu domínio acabou herdando. Você vai saber exatamente quais rastreadores estão liberados, quais estão bloqueados e em quais páginas, com o seu robots.txt e a regra de aplicação na borda realmente coerentes entre si.
Para quem é isto: qualquer pessoa que administre um site atrás da Cloudflare — veículos de imprensa, sites de marketing de SaaS, lojas de e-commerce, blogs — e queira decidir por conta própria se sistemas de IA podem treinar, resumir ou navegar pelo seu conteúdo por meio de agentes, em vez de herdar a configuração que a plataforma escolheu.
O que você precisa:
- Um domínio com proxy pela Cloudflare (qualquer plano, inclusive o Free; algumas etapas abaixo são exclusivas de planos pagos, e isso está sinalizado)
- Acesso ao painel com permissão pelo menos para alterar configurações de segurança no nível do domínio
- De 20 a 30 minutos para auditar e configurar; depois alguns minutos por dia ou por semana monitorando
Definição de pronto: as configurações de segurança da sua zona mostram uma escolha deliberada (e não um padrão não revisado) para busca, agentes e treinamento; o /robots.txt em produção reflete essa escolha; e você confirmou no AI Crawl Control que os bots que deveriam estar bloqueados estão de fato sendo bloqueados.
Por que isso virou assunto de repente: o que mudou em 15 de setembro
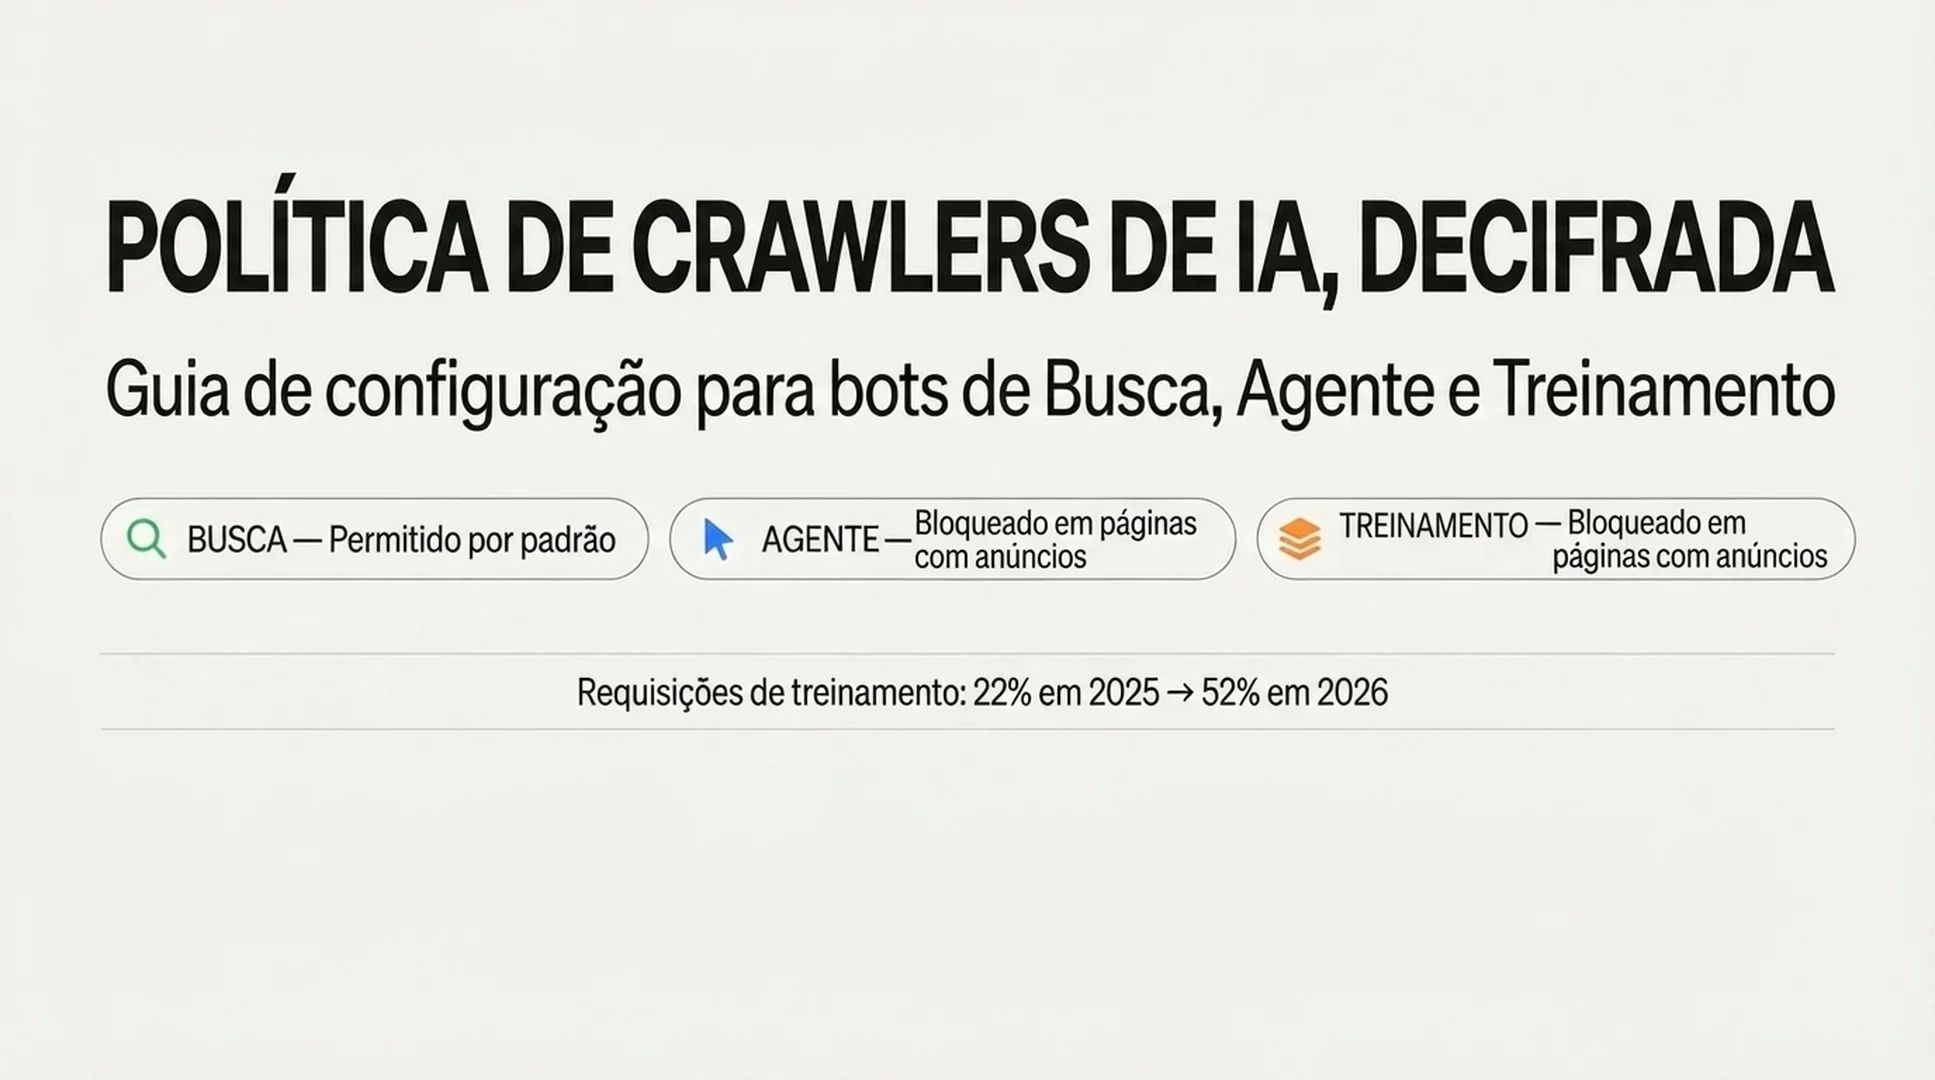
A Cloudflare construiu seus controles de tráfego de IA em etapas, começando com a adição da Content Signals Policy ao robots.txt em setembro de 2025 e chegando ao lançamento do "Content Independence Day" em 1º de julho de 2026, que pela primeira vez separou o comportamento dos bots de IA em três categorias nomeadas, em vez de um único interruptor grosseiro de "é IA ou não é IA":
- Busca (Search) — rastreamento que constrói um índice de busca e depois devolve links ou trechos curtos. Nas palavras da própria Cloudflare, é o tráfego que deveria trazer indicações para você.
- Agente (Agent) — atividade automatizada agindo em nome de uma pessoa em tempo real, como um assistente de chat buscando uma página ou um agente de navegador concluindo uma tarefa.
- Treinamento (Training) — rastreamento para treinar ou ajustar um modelo, em que seu conteúdo é absorvido permanentemente pelos pesos do modelo em vez de retornar até você como um link.
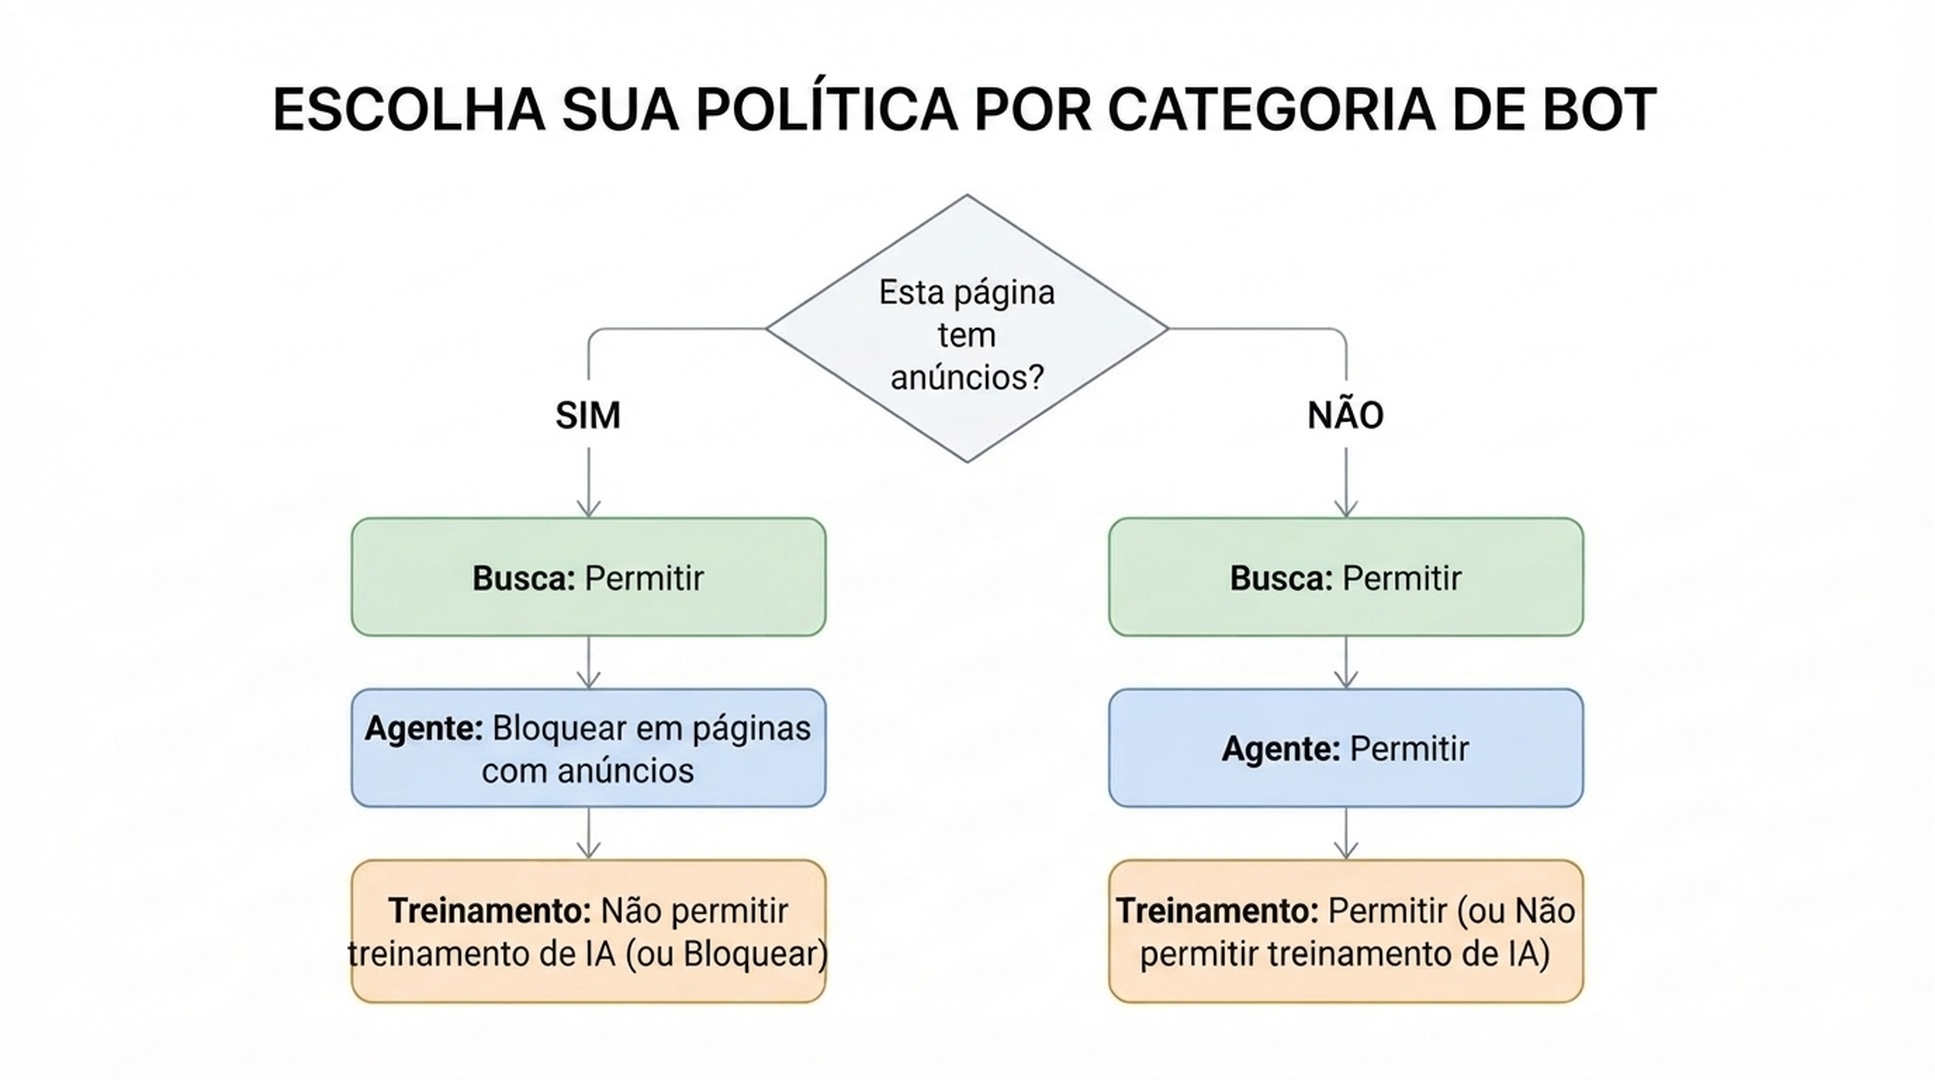
Em 15 de setembro de 2026, a Cloudflare mudou o que acontece automaticamente. Para qualquer domínio que entre na Cloudflare nessa data ou depois, se o site estiver marcado como monetizado por anúncios, o padrão passa a ser:
Categoria | Padrão em páginas com anúncios |
|---|---|
Busca (Search) | Permitir |
Agente (Agent) | Bloquear em páginas com anúncios |
Treinamento (Training) | Não permitir treinamento de IA (Disallow AI Training) |
Domínios novos sem monetização por anúncios recebem Permitir nas três categorias por padrão. Clientes existentes não foram trocados silenciosamente — a Cloudflare deu uma janela antes do dia 15 para sair via painel, e as regras reais de migração por domínio acabaram sendo mais detalhadas do que um único novo padrão (detalhamos abaixo).
A razão de páginas com anúncios receberem um padrão mais rígido é que a presença de anúncios na página é um sinal de que ela foi feita para ser vista por uma pessoa. Segundo os próprios dados da Cloudflare, em junho de 2026 os rastreadores de uso misto — aqueles que combinam indexação de busca, requisições de agentes e treinamento sob um mesmo user agent — representavam mais de 36% do tráfego verificado de rastreadores, a maior categoria isolada. E a fatia de treinamento de IA no total de requisições de rastreadores na rede da Cloudflare subiu de cerca de 22% na primavera de 2025 para 52% em junho de 2026. É contra esse tráfego que a mudança aponta.
Antes de começar: três coisas que você precisa entender sobre as categorias
1. Alguns rastreadores são de uso misto e se comportam de forma diferente sob bloqueio e sob proibição de treinamento. Googlebot, Bingbot e Applebot fazem trabalho duplo — rastreiam tanto para busca quanto para treinamento sob o mesmo user agent. A Cloudflare chama Apple, Google e Microsoft de operadores "Accountable" (responsáveis) porque atendem a quatro condições: respeitam a preferência de não treinar no robots.txt, oferecem uma forma de recusar resumos feitos por IA, dão visibilidade em nível de URL sobre o que foi usado para treinamento e conseguem demonstrar que recusar o treinamento não prejudica sua presença na busca.
2. "Não permitir treinamento de IA" e "Bloquear" não são a mesma configuração, e a diferença é justamente o ponto central. Não permitir treinamento de IA publica uma preferência Disallow no robots.txt voltada a user agents específicos de treinamento (como Google-Extended e Applebot-Extended). Rastreadores de uso misto que são responsáveis leem essa preferência e seguem rastreando voluntariamente para busca, pulando o treinamento — assim sua presença na busca é preservada. Outros rastreadores de treinamento que não são de operadores responsáveis são bloqueados na borda imediatamente, e isso não afeta a busca, porque esses operadores rodam bots de treinamento separados. Já o Bloquear simples agora bloqueia os próprios Googlebot, Bingbot e Applebot, o que significa que seu conteúdo desaparece dos resultados de busca deles também. Se você quer que o treinamento acabe e a busca continue, a configuração certa é "Não permitir treinamento de IA", não "Bloquear".
3. O Bing ainda não respeita a preferência de treinamento no robots.txt. Hoje, Applebot e Googlebot honram a diretiva Disallow específica de treinamento. A Microsoft afirma estar construindo um mecanismo equivalente para o Bingbot, com meta para o início de 2027. Até lá, escolher "Não permitir treinamento de IA" coloca sua preferência no robots.txt, mas o comportamento de rastreamento do Bing para treinamento não muda só por causa desse sinal — a meta tag NOARCHIVE do próprio Bing ou a ferramenta Content Removal continuam sendo as alavancas temporárias se a sua preocupação é especificamente o treinamento via Bing.
Passo 1: Descubra onde o seu site realmente ficou
Não presuma que você sabe a configuração atual — verifique.
Ação: no painel da Cloudflare, abra seu domínio, vá em Security → Settings e encontre os controles de política de bots de IA (a interface mais nova, com as três categorias, substituiu o antigo botão único "Block AI Bots", mas contas que ainda não migraram podem mostrar o botão antigo). À parte, busque o robots.txt em produção no navegador ou com curl https://yourdomain.com/robots.txt e procure um bloco que comece com um comentário marcador gerenciado pela Cloudflare; você também pode comparar com o verificador de rastreadores de IA no robots.txt da Auspia para ver como suas regras atuais são lidas por rastreadores de IA.
Saída esperada: três configurações, uma para busca, uma para agentes e uma para treinamento, cada uma em Permitir / Bloquear em páginas com anúncios / Bloquear (com "Não permitir treinamento de IA" como quarta opção, exclusiva de treinamento). O robots.txt em produção deve mostrar uma seção gerenciada pela Cloudflare listando user agents específicos e linhas de Disallow / Content-Signal, se o Bot Preference Sync ou o robots.txt gerenciado estiverem ativos.
Verificação de qualidade: confirme que as três configurações correspondem ao que você realmente quer, e não ao que a migração presumiu por você. A lógica de migração para clientes existentes documentada pela Cloudflare é: se você tinha o antigo botão "Block AI" ligado, você foi movido para treinamento = Não permitir treinamento de IA, busca mantida em Permitir e agente definido como Bloquear em páginas com anúncios. Se você tinha definido o próprio treinamento como Bloquear ou Bloquear em páginas com anúncios, você foi movido para Não permitir treinamento de IA. Os dois caminhos de migração presumem que você queria manter a busca. Se na verdade você queria que rastreadores de uso misto sumissem por completo, incluindo a busca, esse não é o seu estado atual, e você precisa escolher Bloquear explicitamente.
Caminho de recuperação: se as configurações de segurança mostrarem apenas o botão antigo "Block AI Bots" sem a divisão em três categorias, sua conta ainda não migrou para os novos controles. Procure por "Configure AI bot policies", uma tela de configuração separada e mais nova; é ali que os controles detalhados vivem ao lado do botão antigo durante a transição, e é para onde o futuro aponta.
Passo 2: Decida a política por categoria, não com uma resposta genérica única
Este é o passo de decisão propriamente dito. Percorra cada categoria separadamente.
Busca. Quase ninguém bloqueia — a Cloudflare relata que menos de 1% dos sites optam por bloquear bots de busca — porque perder visibilidade na busca quase nunca compensa. Defina Permitir como padrão, a menos que você tenha um motivo específico (um ambiente de teste, um arquivo atrás de paywall) para manter o site fora dos índices de busca.
Agentes. São bots agindo em tempo real em nome de alguém que está tentando fazer algo no seu site agora mesmo: conferir um preço, concluir uma reserva, extrair um fato para uma resposta de chat. Bloquear tráfego de agentes em páginas monetizadas ou com anúncios é a razão por trás do novo padrão, porque uma visita de agente não gera a impressão de anúncio que uma visita humana geraria. Se o seu modelo de negócio depende dessa atenção humana (mídia, sites de conteúdo com display ads), Bloquear em páginas com anúncios é uma posição defensável. Se você prefere que agentes consigam concluir tarefas no seu site mesmo em páginas com anúncios — por exemplo, porque o tráfego de agentes ainda converte para você — escolha Permitir.
Treinamento. Aqui está a decisão de verdade, e é onde a terminologia confunde:
- Escolha Não permitir treinamento de IA se quiser impedir que o conteúdo seja usado para treinar modelos, mantendo a presença nos produtos de busca do Google, do Bing e da Apple (dado o atraso atual do Bing, entenda como "hoje vale para Google e Apple, e fica pendente para o Bing"). Este é o meio-termo recomendado pela Cloudflare, criado sob medida para a troca entre busca e treinamento.
- Escolha Bloquear apenas se você aceitar perder completamente o rastreamento de busca do Googlebot, do Bingbot e do Applebot como preço de bloquear o comportamento deles em modo de treinamento. Agora é a opção estrita: desde 15 de setembro, o bloqueio também se aplica a rastreadores de uso misto, o que não era o caso antes.
- Escolha Permitir apenas se você aceitar deliberadamente que seu conteúdo treine modelos de IA, por exemplo porque quer maximizar a visibilidade em respostas de IA e considera o treinamento um preço aceitável.
Ação: em Security → Settings → Configure AI bot policies, defina os três menus conforme a sua decisão.
Saída esperada: o painel deve refletir a sua escolha explícita em cada categoria e (se o Bot Preference Sync estiver ligado) começar a publicar automaticamente o bloco de robots.txt correspondente — sem edição manual de arquivo.
Verificação de qualidade: releia sua decisão sobre treinamento com uma pergunta só: "Quero manter minha visibilidade na busca ou não?" Se quiser, isso é Não permitir treinamento de IA, não Bloquear, por mais tentador que o termo "Bloquear" pareça para interromper o treinamento de IA.
Caminho de recuperação: se o tráfego de busca caiu depois que você escolheu uma configuração, verifique se você selecionou Bloquear em vez de Não permitir treinamento de IA. Esse é o erro autossabotador mais comum aqui: o nome faz "Bloquear" soar como a opção que "faz mais", mas, para treinamento, ele faz o que você pode não querer, que é levar a busca junto.
Passo 3: Ative o Bot Preference Sync para o robots.txt acompanhar suas configurações
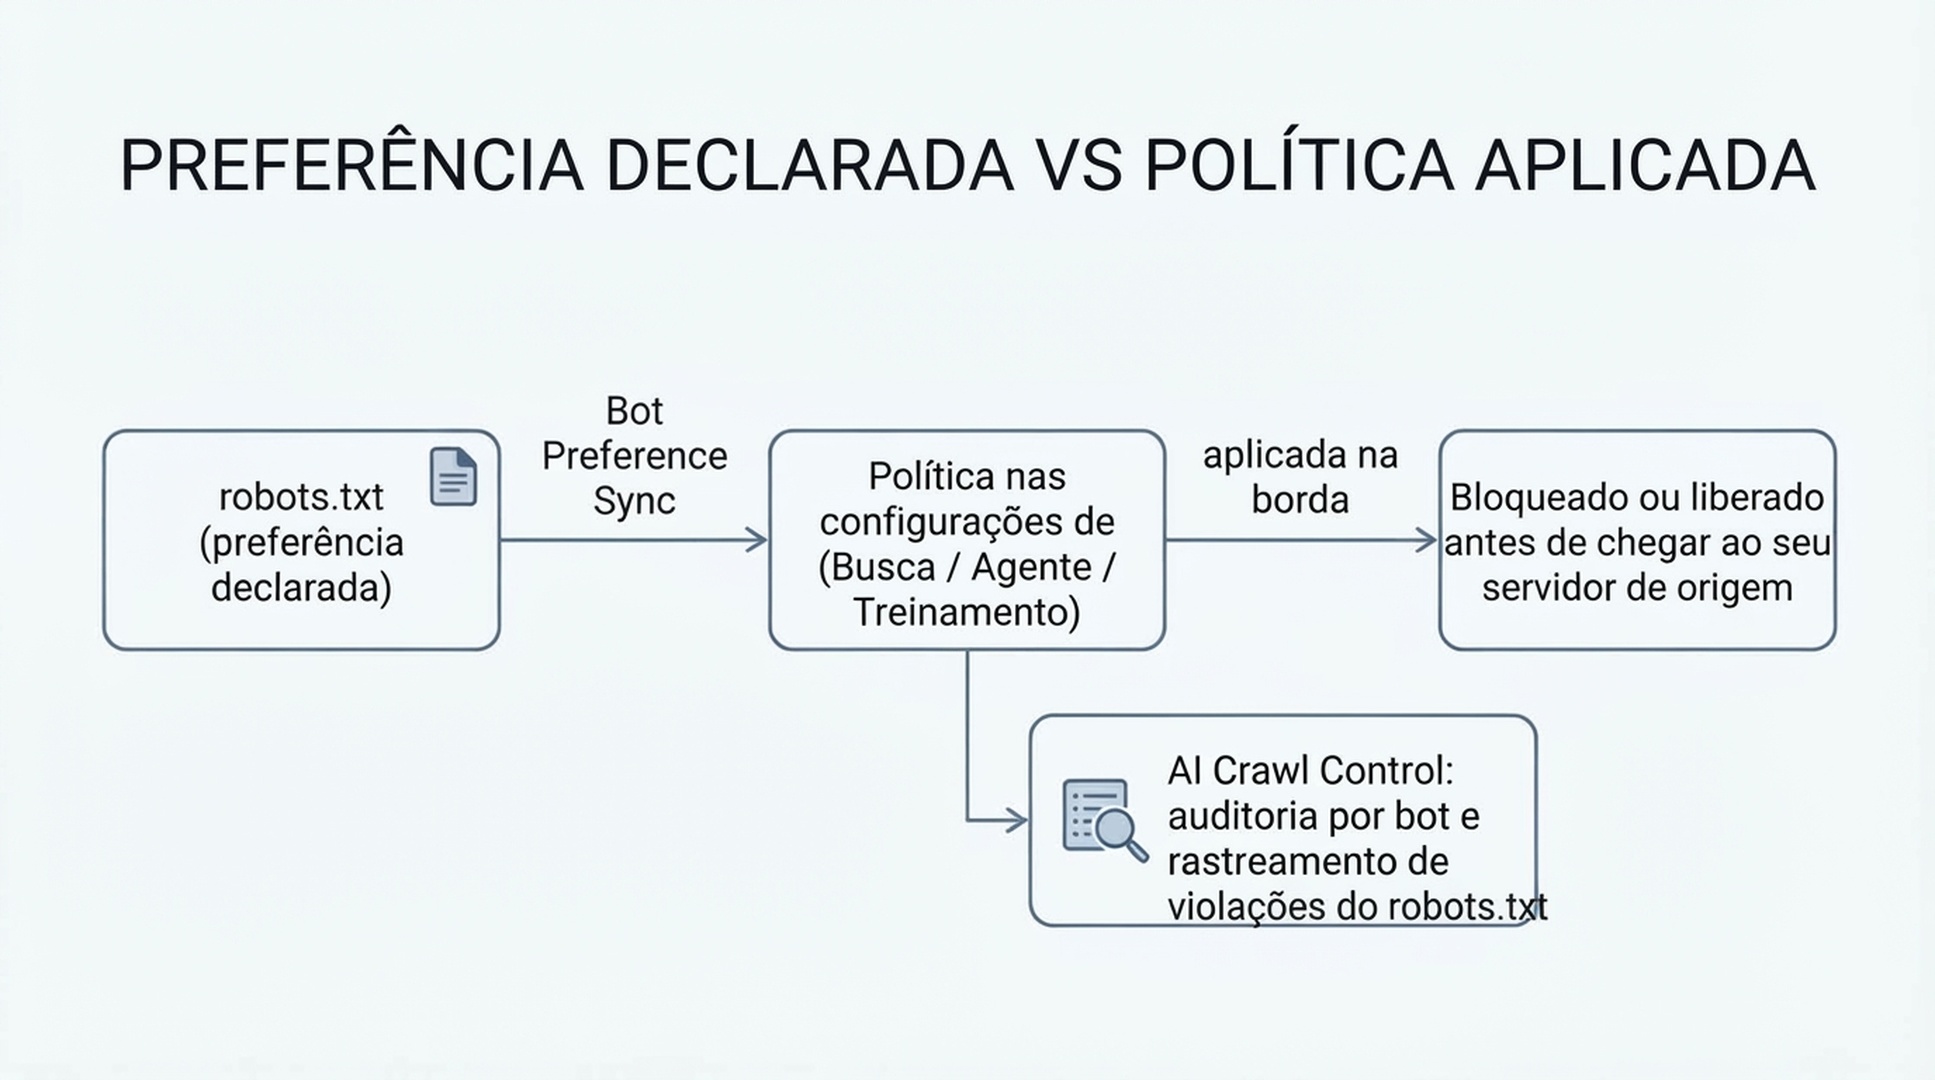
A configuração no painel e o arquivo robots.txt são dois sistemas diferentes, e, quando eles divergem, alguns rastreadores usam a brecha como desculpa para ignorar sua preferência. O Bot Preference Sync da Cloudflare fecha essa lacuna gerando o seu robots.txt diretamente a partir das configurações de segurança escolhidas.
Ação: na mesma área de configuração de política de bots de IA, ative o Bot Preference Sync (ele vem ligado por padrão para clientes novos; clientes existentes que usam o recurso mais antigo de robots.txt gerenciado serão convidados a revisar e confirmar durante a migração).
Saída esperada: a Cloudflare adiciona um bloco gerenciado no topo do seu robots.txt, envolto nos comentários # BEGIN Cloudflare Bot Preference Sync / # END, listando os user agents afetados e suas regras de Disallow — e não remove nenhuma regra própria que você já tinha no robots.txt, que permanece abaixo do bloco gerenciado.
Verificação de qualidade: busque /robots.txt novamente depois de ativar e confirme que o bloco gerenciado aparece e corresponde às escolhas do Passo 2. Por exemplo, se você definiu treinamento como Não permitir treinamento de IA, você deve ver os user agents específicos de treinamento (Google-Extended, Applebot-Extended) com regras de Disallow, enquanto os user agents genéricos Googlebot / Applebot / Bingbot seguem não bloqueados para busca.
Caminho de recuperação: se você tem um acordo pontual com um operador de rastreador específico que uma política em nível de categoria quebraria (por exemplo, um contrato de licenciamento pago de conteúdo), desligue o Bot Preference Sync e edite seu próprio robots.txt à mão: os botões de categoria existem para política de zona inteira, não para exceções por operador.
Passo 4: Confirme que a política é aplicada de fato, e não apenas solicitada
O robots.txt é um pedido em termos técnicos: ele não impede um rastreador que o ignore. Este é o passo que as pessoas pulam, e é o passo que mostra se a sua decisão do Passo 2 é real ou apenas teoria.
Ação: abra o AI Crawl Control da sua zona (disponível em todos os planos, inclusive o Free; a qualidade de detecção é melhor em planos com Bot Management, mas os recursos de visibilidade funcionam em qualquer um). Veja a aba Crawlers, que lista todos os bots que chegaram ao seu site, com uma coluna de Robots.txt violations.
Saída esperada: uma tabela com contagem de requisições e contagem de violações por bot. Uma contagem de violações diferente de zero para um bot que você definiu como não permitido ou bloqueado significa que ele está ignorando o seu robots.txt neste momento.
Verificação de qualidade: para qualquer bot com violações, abra "Most popular paths" (filtrando pelos caminhos sinalizados) e veja o que ele está de fato requisitando, para decidir se está alcançando conteúdo que você realmente quer proteger.
Caminho de recuperação: se um bot ignora a sua preferência declarada, o robots.txt sozinho não vai detê-lo. Use a ação "Enforce robots.txt rules" no AI Crawl Control (às vezes chamada pelo nome interno Robotcop) para transformar suas regras declaradas em uma regra de WAF real que bloqueia o bot desobediente na borda da Cloudflare antes que ele chegue ao seu servidor de origem — passando de "pedir conformidade" para "exigir conformidade". Esta etapa usa WAF, então a disponibilidade depende do seu plano ter acesso a WAF.
Passo 5: Decida entre apenas bloquear ou cobrar pelo acesso
Se a sua decisão sobre treinamento foi "sem acesso para treinamento", você tem uma segunda opção além de bloquear tudo: cobrar.
Ação: se isso interessar, candidate-se ao beta fechado do Pay Per Crawl da Cloudflare (pela página de inscrição da Cloudflare ou pelo seu gerente de conta, se você for cliente Enterprise). Uma vez habilitado no nível da conta (Manage Account → Settings → Pay Per Crawl → defina o Visibility do seu domínio como Visible), você pode definir um preço fixo único por requisição para a zona e escolher, por rastreador, entre permitir (gratuito), cobrar (pelo seu preço) ou bloquear.
Saída esperada: quando um rastreador autenticado via Web Bot Auth (uma requisição com assinatura Ed25519 que identifica o rastreador) pede uma página que você marcou como cobrada, ele recebe um HTTP 402 Payment Required com o cabeçalho crawler-price; se ele tentar de novo aceitando pagar, ou incluir de antemão um cabeçalho crawler-max-price que cubra o seu preço, ele recebe o conteúdo com o cabeçalho crawler-charged confirmando o valor cobrado. A Cloudflare atua como merchant of record e liquida o pagamento.
Verificação de qualidade: isso só funciona contra rastreadores que registraram dados de pagamento na Cloudflare e suportam o fluxo de 402; não é um interruptor universal contra todos os bots. Para todo o resto, sua configuração de cobrança funciona, na prática, como um bloqueio — e a Cloudflare observa que ela ainda assim serve como um sinal de que você está aberto a uma relação paga no futuro.
Caminho de recuperação: o recurso está em beta fechado; se você não for aceito ou não quiser esperar, Não permitir treinamento de IA ou Bloquear continuam disponíveis para esses mesmos rastreadores hoje.
Tratando a exceção: quando um operador de IA específico pede acesso
Pode chegar até você uma abordagem — uma parceria, um acordo de citação, uma conversa de licenciamento — de uma empresa de IA querendo acesso explícito fora da política da zona inteira.
Há duas formas de conceder uma exceção estreita sem reabrir a categoria toda:
- Sobrescrever por rastreador em Manage AI crawlers: mude a linha daquele bot de bloquear/cobrar para permitir, independentemente da sua configuração de treinamento ou de agentes em nível de categoria.
- Editar o robots.txt à mão: se você desligou o Bot Preference Sync (ou coloca a exceção fora do bloco gerenciado), você pode adicionar um Allow direcionado àquele user agent específico abaixo da seção gerenciada pela Cloudflare.
Em qualquer um dos casos, mantenha a política de categoria da zona como padrão e trate exceções nomeadas como decisões deliberadas e documentadas — não o contrário.
Verifique o resultado
Percorra esta lista quando a configuração estiver no ar:
- [ ] As configurações de segurança mostram valores explícitos e deliberados para busca, agentes e treinamento — não padrões não revisados
- [ ] O
/robots.txtem produção mostra um bloco gerenciado pela Cloudflare que corresponde a essas configurações - [ ] A aba Crawlers do AI Crawl Control mostra os bots que você esperava, com zero ou perto de zero violações para tudo que você marcou como bloqueado/não permitido
- [ ] Se você escolheu Não permitir treinamento de IA, você confirmou (via Search Console / Bing Webmaster Tools, ou apenas observando o tráfego orgânico) que o rastreamento de busca do Googlebot / Applebot continua normalmente
- [ ] Se você ativou a aplicação de robots.txt (Robotcop), a regra de WAF resultante está implantada e ativa, e não apenas criada e deixada como rascunho
- [ ] Você registrou qual configuração escolheu e por quê, para que uma revisão futura não comece do zero
Mantenha o resultado de pé
Isto não é uma configuração que se define e se esquece. Volte a ela em um ritmo leve:
- Mensalmente: confira a aba Metrics do AI Crawl Control em busca de bots novos para os quais você ainda não definiu política, e revise as contagens de violação.
- Quando o Bing lançar suporte à preferência de treinamento para o Bingbot (a Microsoft indica meta para o início de 2027): reavalie se a sua configuração atual ainda entrega o resultado pretendido de manter a busca e bloquear o treinamento, porque é aí que o Bing alcança o comportamento atual de Google e Apple.
- Sempre que o seu status de monetização por anúncios mudar: adicionar ou remover display ads muda em qual faixa de padrão suas páginas caem, e vale reconfirmar que as suas configurações explícitas ainda fazem sentido nesse cenário.
Perguntas frequentes
Bloquear rastreadores de treinamento vai prejudicar meu ranking de SEO? Não, se você usar Não permitir treinamento de IA em vez de Bloquear. Não permitir treinamento de IA foi criado justamente para que rastreadores de uso misto que são responsáveis (Google, Apple e, no futuro, Bing) continuem rastreando para busca enquanto pulam o treinamento. Já o Bloquear simples agora bloqueia também o comportamento de busca desses mesmos rastreadores, o que vai prejudicar sua visibilidade nos produtos de busca deles.
Eu já tinha o "Block AI Bots" ligado antes de 15 de setembro. O que aconteceu com a minha configuração? A Cloudflare a migrou automaticamente: o antigo Block AI Bots virou treinamento = Não permitir treinamento de IA, busca = Permitir e agente = Bloquear em páginas com anúncios. Verifique pelo Passo 1 acima se o resultado real ficou como o esperado, em vez de presumir que a migração correspondeu à sua intenção.
Algo disso está disponível no plano Free? Sim. O AI Crawl Control, as configurações de categoria de busca/agentes/treinamento e o Bot Preference Sync funcionam em todos os planos, inclusive o Free. Alguns detalhes de aplicação variam por plano — por exemplo, a aplicação do robots.txt opera via WAF, e a detecção de bots no plano Free depende de strings de user agent em vez do identificador de detecção mais avançado do Bot Management.
Qual é a diferença entre o AI Crawl Control e as configurações de segurança de bots de IA? As configurações de segurança são onde você define a política (permitir / bloquear em páginas com anúncios / bloquear / não permitir treinamento de IA por categoria). O AI Crawl Control é onde você audita o que está acontecendo de fato — contagens de requisições por bot, violações de robots.txt, detalhamento por caminho — e onde você pode converter a política declarada no robots.txt em uma regra de WAF aplicada.
Preciso editar o robots.txt à mão depois de configurar isso? Não, se o Bot Preference Sync estiver ativo: ele escreve e mantém o bloco de robots.txt adequado a partir das suas configurações no painel. A edição manual só é necessária para exceções pontuais de um operador específico, fora das categorias gerenciadas.
Autor: Julian Mercer, profissional de SEO técnico com 14 anos de experiência na Auspia. Ele escreve sobre rastreabilidade, dados estruturados, renderização e os fundamentos técnicos que tornam o conteúdo legível por IA.