이 작업을 마치면 얻게 되는 것
이 워크플로를 끝내면 Cloudflare 존에 AI 봇 트래픽의 세 가지 범주 — 검색(Search), 에이전트(Agent), 학습(Training) — 각각에 대한 명시적이고 의도적인 정책이 자리 잡게 됩니다. 도메인에 적용된 기본값을 그대로 물려받은 상태가 아닙니다. 어떤 크롤러가 허용되고 어떤 것이 차단되며, 그것이 어느 페이지에 적용되는지 정확히 알 수 있고, robots.txt와 엣지 적용 규칙이 실제로 서로 일치하는 상태가 됩니다.
대상 독자: Cloudflare를 통해 서비스하는 웹사이트 운영자 — 미디어, SaaS 마케팅 사이트, 이커머스 스토어, 블로그 — 로서 AI 시스템이 자기 콘텐츠를 학습하거나 요약하거나 에이전트 방식으로 열람하는 것을 플랫폼 기본값에 맡기지 않고 직접 결정하려는 분.
사전 준비:
- Cloudflare를 경유하는 도메인 (플랜 무관, Free 포함. 아래 일부 단계는 유료 플랜 전용이며 그렇게 표시했습니다)
- 최소한 도메인 수준 보안 설정 권한이 있는 대시보드 접근
- 감사와 설정에 20~30분, 이후 일간/주간 몇 분의 모니터링
완료 기준: 존의 보안 설정에 검색·에이전트·학습 각각에 대한 (기본값이 아닌) 의도된 선택이 들어 있고, 실제 운영 중인 /robots.txt가 그 선택을 반영하며, 차단하려던 봇이 실제로 차단되고 있음을 AI Crawl Control에서 확인한 상태.
왜 갑자기 중요해졌나: 9월 15일에 바뀐 것
Cloudflare는 2025년 9월 robots.txt에 Content Signals Policy를 추가하고, 2026년 7월 1일 "Content Independence Day"를 시작으로 AI 트래픽 제어를 단계적으로 구축해 왔습니다. 후자에서 뭉툭한 "AI냐 아니냐" 단일 토글이 처음으로 이름 붙은 세 범주로 나뉘었습니다.
- 검색(Search) — 검색 인덱스를 만들고 나중에 링크나 짧은 발췌를 돌려주기 위한 크롤링. Cloudflare의 설명으로는, 이것이 여러분에게 유입을 보내줘야 하는 트래픽입니다.
- 에이전트(Agent) — 지금 이 순간 사람을 대신해 움직이는 실시간 자동 활동. 채팅 어시스턴트가 페이지를 가져오거나, 브라우저 사용 에이전트가 작업을 끝내는 경우입니다.
- 학습(Training) — 모델 학습이나 파인튜닝을 위한 크롤링. 여러분의 콘텐츠는 링크로 돌아오는 대신 모델 가중치에 영구히 흡수됩니다.
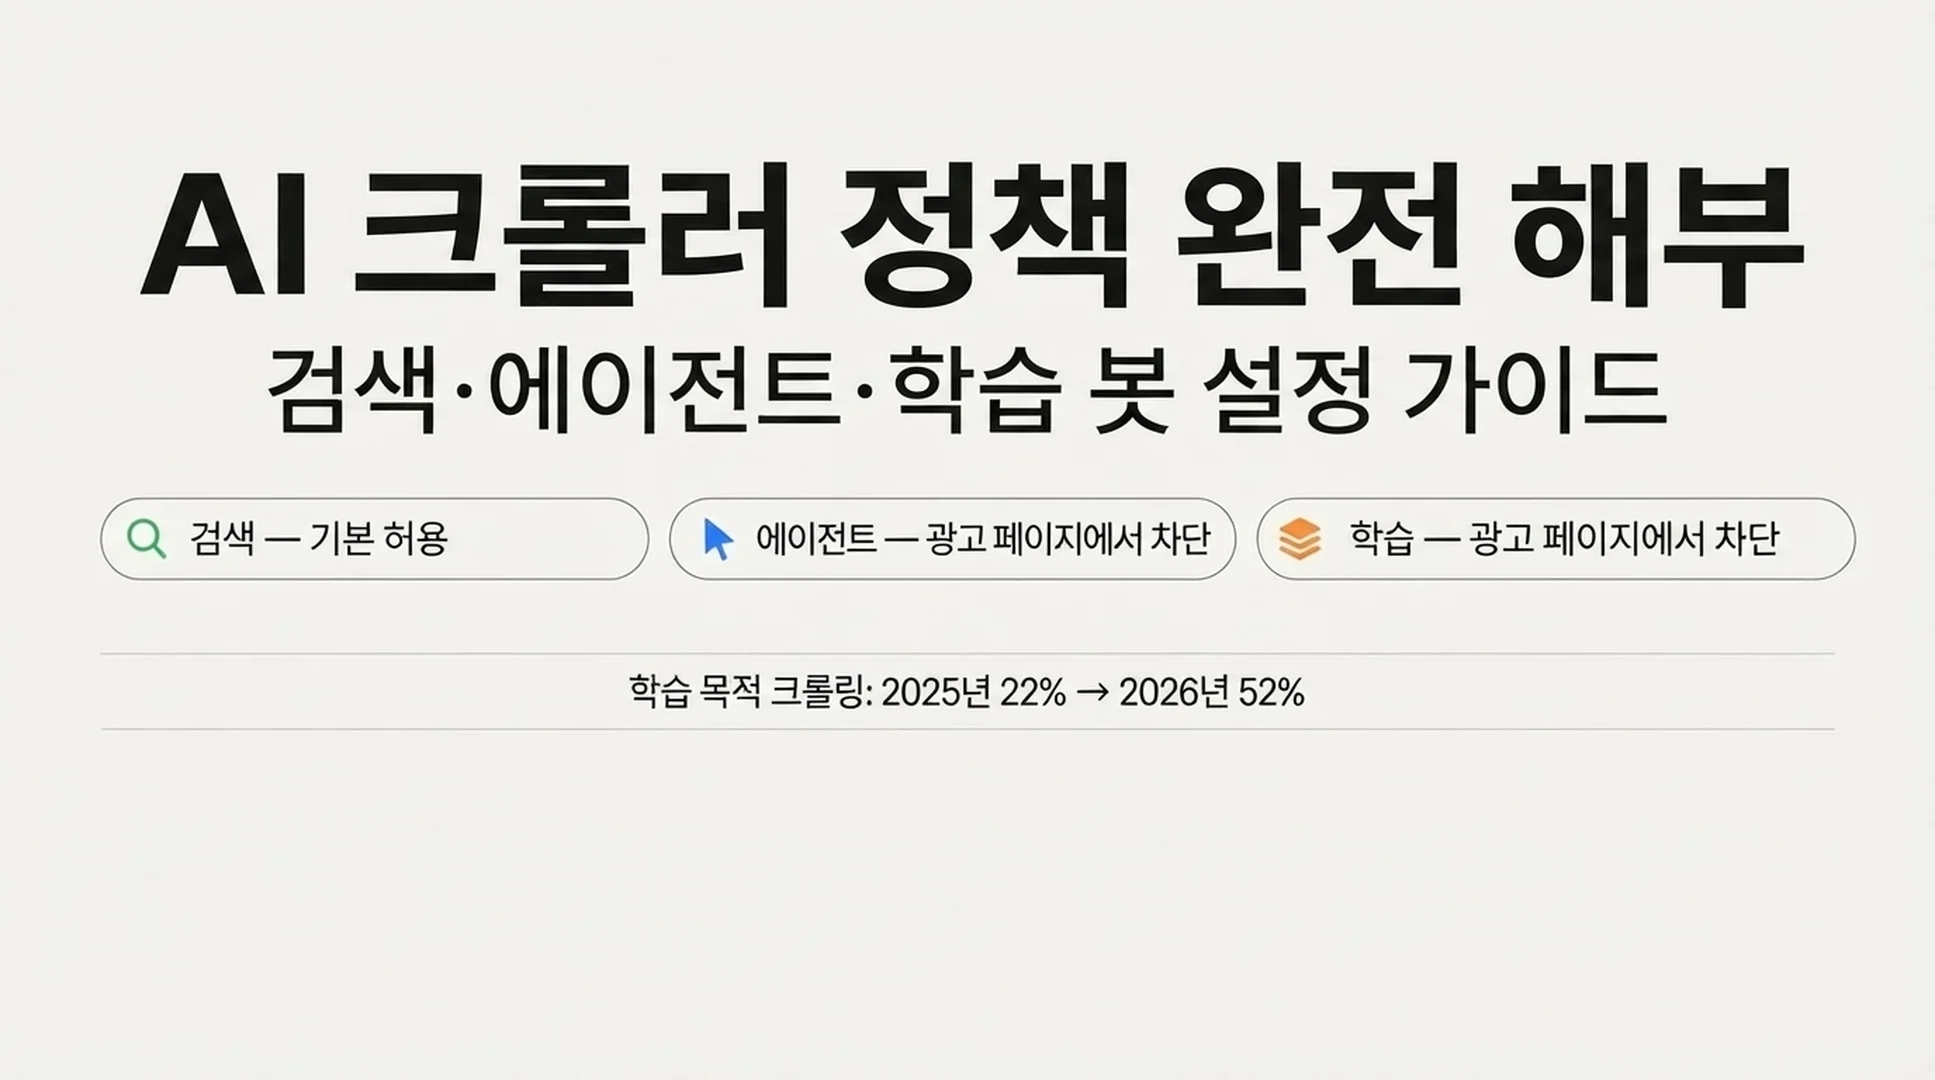
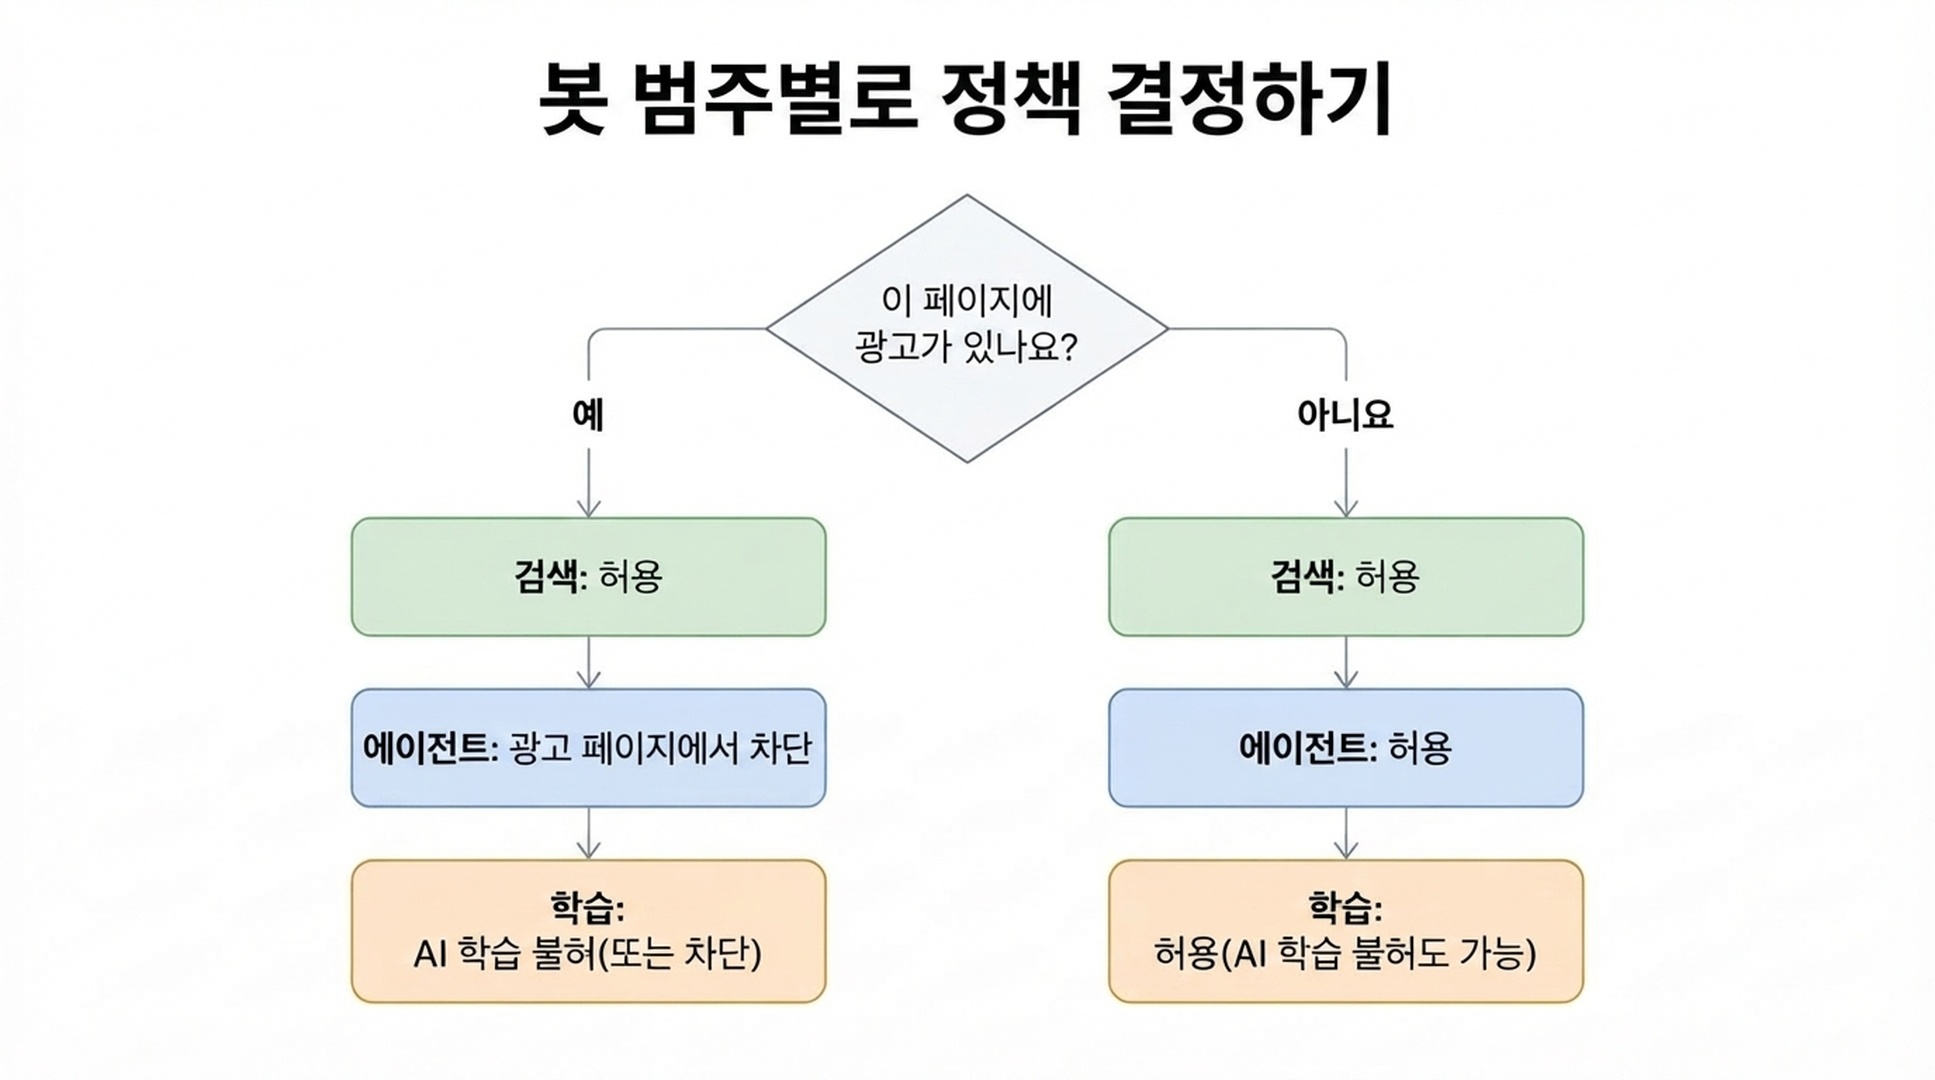
2026년 9월 15일, Cloudflare는 자동으로 적용되는 내용을 바꿨습니다. 이 날짜 이후 Cloudflare에 새로 온보딩하는 도메인이 광고 수익형으로 판별되면 기본 설정은 다음과 같습니다.
범주 | 광고 게재 페이지의 기본값 |
|---|---|
검색(Search) | 허용 |
에이전트(Agent) | 광고가 있는 페이지에서 차단 |
학습(Training) | AI 학습 불허 (Disallow AI Training) |
광고를 게재하지 않는 신규 도메인은 세 범주 모두 허용이 기본입니다. 기존 고객이 조용히 전환된 것은 아닙니다. Cloudflare는 15일 전까지 대시보드에서 옵트아웃할 수 있는 기간을 두었고, 실제 도메인별 마이그레이션 규칙은 단일한 새 기본값보다 더 세분화되어 있었습니다(아래에서 다룹니다).
광고가 실리는 페이지에 더 엄격한 기본값이 적용되는 이유는, 페이지 위의 광고가 곧 "거기에 사람이 볼 것으로 기대했다"는 신호이기 때문입니다. Cloudflare 자체 수치에 따르면 2026년 6월 기준으로 검색 인덱싱, 에이전트 조회, 학습을 단일 사용자 에이전트 뒤에 섞어 놓은 겸용 크롤러가 검증된 크롤러 트래픽의 36% 이상을 차지해 가장 큰 비중이었습니다. 또한 Cloudflare 네트워크의 전체 크롤러 요청에서 AI 학습이 차지하는 비율은 2025년 봄 약 22%에서 2026년 6월 52%로 늘었습니다. 이번 변경이 겨냥하는 트래픽이 바로 이것입니다.
시작하기 전에: 범주에 대해 알아야 할 세 가지
1. 일부 크롤러는 "겸용"이며, 차단과 AI 학습 불허에서 다르게 동작합니다. Googlebot, Bingbot, Applebot은 각각 두 역할을 겸합니다. 하나의 사용자 에이전트로 검색을 위해서도, 학습을 위해서도 크롤링합니다. Cloudflare는 Apple, Google, Microsoft를 "Accountable(책임 있는)" 운영자라고 부릅니다. 네 가지 조건을 충족하기 때문입니다. 학습 관련 robots.txt 설정을 존중하고, AI 요약에서 옵트아웃할 수단을 제공하며, 학습에 무엇이 쓰였는지 URL 단위로 보여주고, 학습을 옵트아웃해도 검색 노출이 나빠지지 않는다는 것을 입증할 수 있다는 점입니다.
2. "AI 학습 불허"와 "차단"은 같은 설정이 아니며, 그 차이가 핵심입니다. AI 학습 불허는 Google-Extended, Applebot-Extended 같은 학습 전용 사용자 에이전트를 겨냥한 Disallow 의사를 robots.txt에 게시합니다. Accountable 겸용 크롤러는 그 의사를 읽고 학습만 건너뛴 채 검색 크롤링을 자발적으로 계속합니다. 따라서 검색 노출은 살아남습니다. Accountable이 아닌 다른 학습 크롤러는 엣지에서 즉시 차단되는데, 그런 운영자들은 학습 전용 봇을 따로 돌리기 때문에 검색에는 영향이 없습니다. 반면 순수한 차단은 9월 15일 이후 Googlebot, Bingbot, Applebot 자체도 막습니다. 즉 그들의 검색 결과에서 여러분의 콘텐츠도 사라집니다. 학습은 없애되 검색은 유지하고 싶다면, 골라야 할 것은 차단이 아니라 AI 학습 불허입니다.
3. Bing은 아직 robots.txt의 학습 설정을 존중하지 않습니다. Applebot과 Googlebot은 현재 학습 전용 Disallow 지시를 따릅니다. Microsoft는 Bingbot용 동등한 장치를 만들고 있으며 2027년 초를 목표로 한다고 밝혔습니다. 그때까지 AI 학습 불허를 선택하면 robots.txt에 그 의사는 기록되지만, Bing의 학습 목적 크롤링 동작이 그 신호만으로 바뀌지는 않습니다. Bing을 통한 학습 노출이 특히 신경 쓰인다면, Bing 자체의 NOARCHIVE 메타 태그나 Content Removal 도구가 그 사이의 수단입니다.
1단계: 내 사이트가 실제로 어디에 놓였는지 확인하기
현재 설정을 안다고 가정하지 마십시오. 확인하십시오.
실행: Cloudflare 대시보드에서 도메인을 열고 Security → Settings로 이동해 AI 봇 정책 제어 항목을 찾습니다(새로운 3범주 UI가 예전의 단일 "Block AI Bots" 토글을 대체했지만, 마이그레이션이 끝나지 않은 계정은 아직 예전 토글이 보일 수 있습니다). 별도로 브라우저에서 또는 curl https://yourdomain.com/robots.txt로 운영 중인 robots.txt를 가져와, Cloudflare 관리 주석 표시로 시작하는 블록이 있는지 확인합니다. 현재 규칙이 AI 크롤러에게 어떻게 읽히는지는 Auspia의 Robots.txt AI 크롤러 검사기로 교차 확인할 수도 있습니다.
기대 결과: 검색·에이전트·학습에 각각 하나씩, 총 세 개의 설정이 있고 각각 허용 / 광고가 있는 페이지에서 차단 / 차단 중 하나로 되어 있습니다(AI 학습 불허는 학습에만 있는 네 번째 선택지입니다). Bot Preference Sync나 관리형 robots.txt가 켜져 있다면, 운영 중인 robots.txt에 Cloudflare 관리 섹션이 보이고 구체적인 봇 사용자 에이전트와 Disallow / Content-Signal 줄이 나열되어 있어야 합니다.
품질 점검: 세 설정이 마이그레이션이 임의로 정한 값이 아니라 실제로 의도한 값과 맞는지 확인합니다. 기존 고객에 대한 Cloudflare의 공표된 마이그레이션 로직은 이렇습니다. 이전에 예전 "Block AI" 토글을 켜 두었다면 학습 = AI 학습 불허, 검색 = 허용 유지, 에이전트 = 광고가 있는 페이지에서 차단으로 옮겨졌습니다. 이전에 학습 자체를 차단 또는 광고가 있는 페이지에서 차단으로 두었다면 역시 AI 학습 불허로 옮겨졌습니다. 두 경로 모두 검색은 유지하고 싶다는 전제를 깔고 있습니다. 겸용 크롤러를 검색에서까지 완전히 없애고 싶었다면, 지금 설정은 그렇게 되어 있지 않습니다. 명시적으로 차단을 선택해야 합니다.
복구 경로: 보안 설정에 3범주 구분 없이 예전 단일 "Block AI Bots" 토글만 보인다면, 그 계정은 아직 새 제어 항목으로 마이그레이션되지 않은 것입니다. 별도의 더 새로운 설정 화면인 "Configure AI bot policies"를 찾으십시오. 전환 기간 동안 예전 토글과 나란히, 앞으로 세밀한 제어가 사는 곳입니다.
2단계: 하나의 포괄적 답이 아니라 범주별로 정책 정하기
여기가 실제 결정 단계입니다. 범주별로 따로 검토합니다.
검색. 이걸 차단하는 사이트는 거의 없습니다. Cloudflare에 따르면 검색 봇 차단을 선택하는 사이트는 1% 미만입니다. 검색 가시성을 잃는 대가는 대개 그만한 값어치가 없기 때문입니다. 검색 인덱스에서 빼둘 특별한 이유(스테이징 환경, 유료 장벽 안의 아카이브 등)가 없다면 허용을 기본으로 하십시오.
에이전트. 이것들은 지금 이 순간 여러분 사이트에서 무언가를 하려는 사람을 위해 실시간으로 움직이는 봇입니다. 가격을 확인하거나, 예약을 완료하거나, 채팅 답변에 사실 하나를 끌어오는 일입니다. 수익화된 페이지나 광고 페이지에서 에이전트 트래픽을 차단하는 것이 새 기본값의 근거인 이유는, 에이전트 방문이 사람 방문이 만들어낼 광고 노출을 만들지 않기 때문입니다. 그 사람의 주의 자체가 비즈니스 모델이라면(미디어, 디스플레이 광고를 붙인 콘텐츠 사이트), 광고가 있는 페이지에서 차단이 방어 가능한 선택입니다. 반대로 광고 페이지에서도 에이전트가 작업을 끝내주길 바란다면 — 예컨대 에이전트 유입이 자기 쪽에서는 전환된다면 — 허용을 고릅니다.
학습. 진짜 결정은 여기에 있고, 용어가 사람을 헷갈리게 하는 지점도 여기입니다.
- 콘텐츠가 모델 학습에 쓰이는 것은 막되 Google, Bing, Apple 검색 제품에서의 노출은 유지하고 싶다면 AI 학습 불허를 고릅니다(Bing의 현재 지연을 감안하면 "오늘 기준 Google과 Apple은 유지, Bing은 보류"로 이해하십시오). 이것이 Cloudflare가 권하는 중간 경로이며, 검색과 학습의 트레이드오프를 위해 특별히 만들어진 설정입니다.
- Googlebot, Bingbot, Applebot의 검색 크롤링을 완전히 잃는 것을, 그들의 학습 모드 동작까지 막는 대가로 받아들일 수 있을 때만 차단을 고릅니다. 이것이 이제 엄격한 선택지입니다. 9월 15일부터 차단은 겸용 크롤러에도 적용되며, 이전에는 그렇지 않았습니다.
- 콘텐츠가 AI 모델 학습에 쓰여도 괜찮다면, 예컨대 AI 답변에서의 인용 노출을 최대화하고 싶고 학습되는 것을 그 대가로 받아들인다면 허용을 고릅니다.
실행: Security → Settings → Configure AI bot policies에서 세 드롭다운을 각각 결정한 값으로 설정합니다.
기대 결과: 대시보드가 범주별 명시적 선택을 반영하고, (Bot Preference Sync가 켜져 있다면) 그에 맞는 robots.txt 블록을 자동으로 게시하기 시작합니다. 수동 파일 편집은 필요 없습니다.
품질 점검: 학습 선택을 다음 한 문장에 비추어 다시 읽어 보십시오. "검색 가시성을 유지하고 싶은가, 아닌가." 유지하고 싶다면 그것은 차단이 아니라 AI 학습 불허입니다. "차단"이라는 단어가 AI 학습을 멈추는 데 아무리 매력적으로 들려도 그렇습니다.
복구 경로: 어떤 설정을 고른 뒤 검색 트래픽이 떨어졌다면, AI 학습 불허 대신 실수로 차단을 선택하지 않았는지 확인하십시오. 이 구성에서 가장 흔한 자초한 실수입니다. 이름 때문에 차단이 "더 많이 해주는" 선택지처럼 들리지만, 학습에 관해서는 원하지 않을 수 있는 일(검색도 잃는 것)을 실제로 합니다.
3단계: Bot Preference Sync를 켜서 robots.txt를 설정과 일치시키기
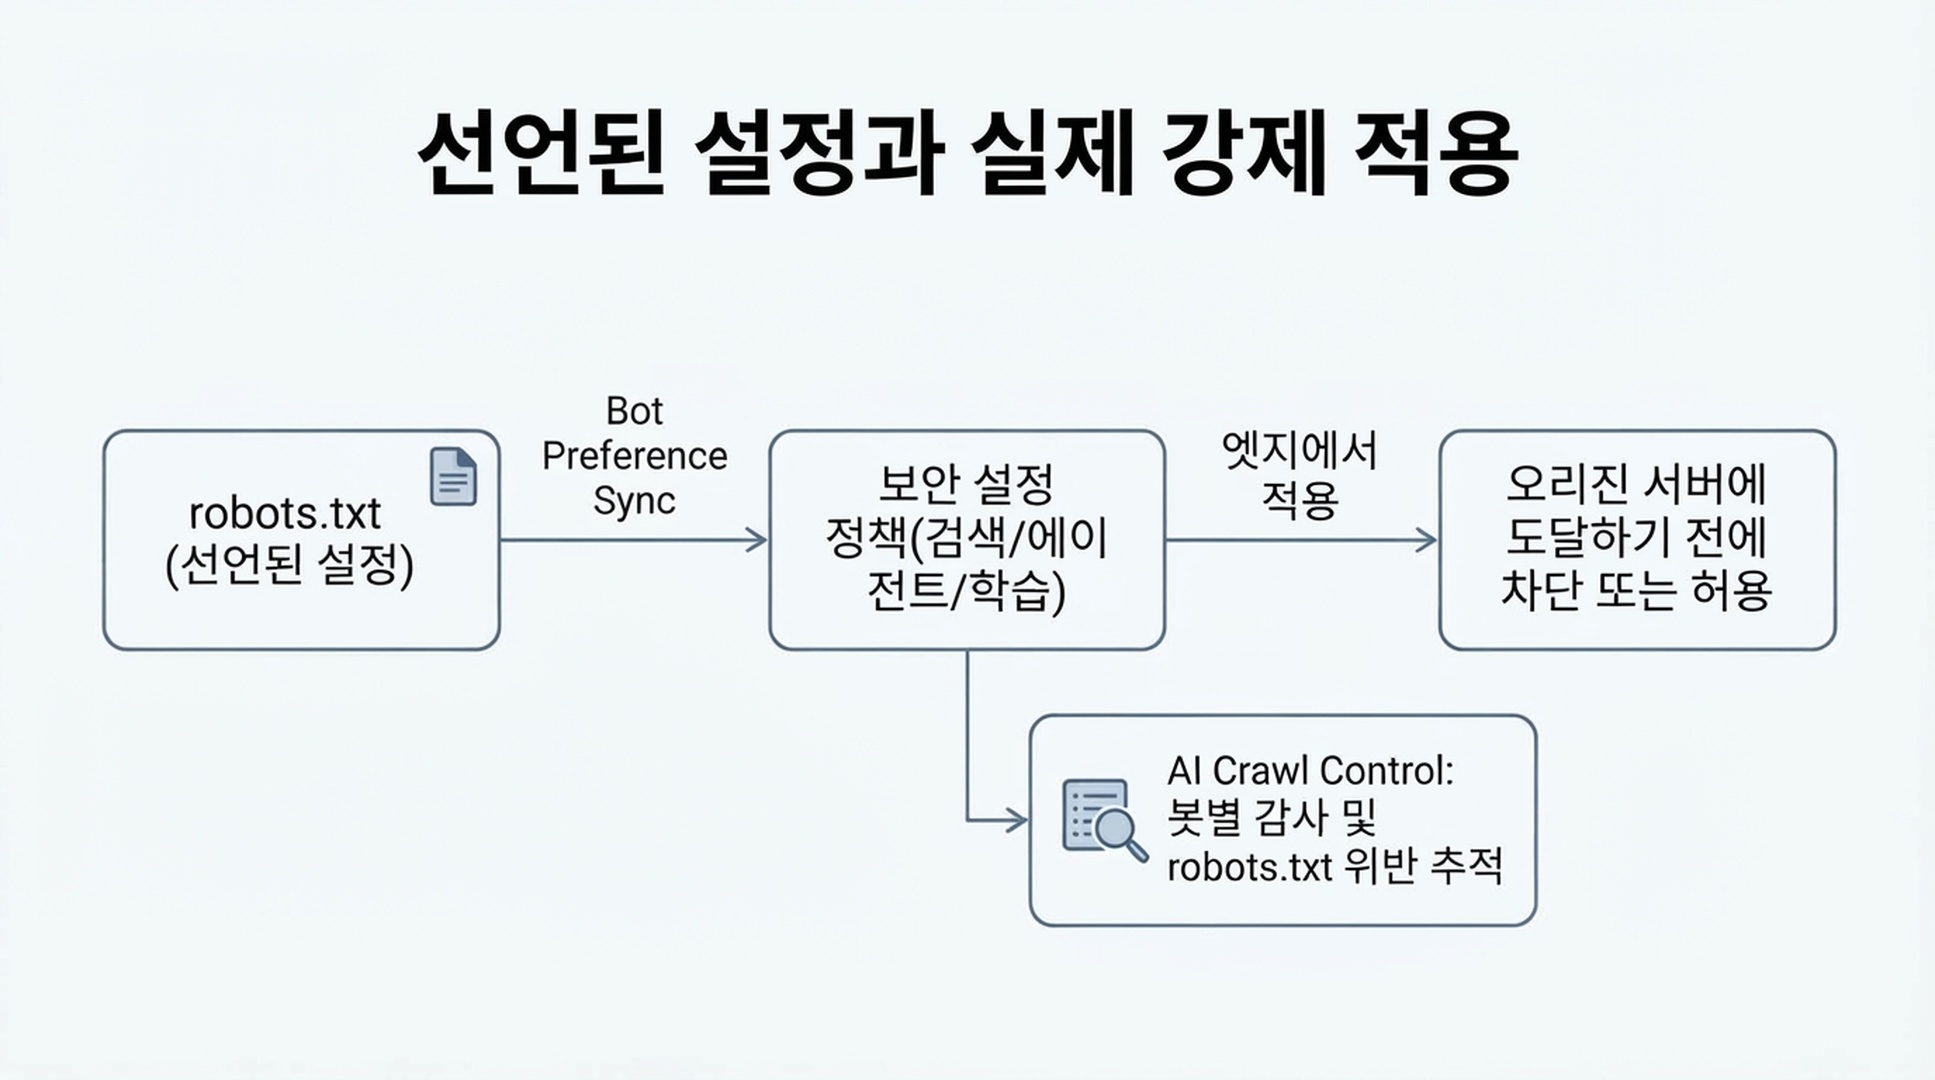
대시보드 설정과 robots.txt 파일은 서로 다른 시스템이고, 둘이 어긋나면 일부 크롤러는 그 불일치를 여러분의 의사를 무시할 구실로 씁니다. Cloudflare의 Bot Preference Sync는 보안 설정의 선택에서 robots.txt를 직접 생성해 이 틈을 메웁니다.
실행: 같은 AI 봇 정책 설정 영역에서 Bot Preference Sync를 활성화합니다(신규 고객은 기본으로 켜져 있고, 예전 관리형 robots.txt 기능을 쓰던 기존 고객은 마이그레이션 시 검토와 확인을 요청받습니다).
기대 결과: Cloudflare가 robots.txt 맨 앞에 관리 블록을 추가합니다. # BEGIN Cloudflare Bot Preference Sync / # END 주석으로 감싸이고, 영향을 받는 구체적 사용자 에이전트와 해당 Disallow 규칙이 나열됩니다. 여러분의 robots.txt에 이미 있던 사용자 지정 규칙은 삭제되지 않고 관리 블록 아래에 그대로 남습니다.
품질 점검: 활성화 후 /robots.txt를 다시 가져와 관리 블록이 나타나고 2단계 선택과 일치하는지 확인합니다. 예를 들어 학습을 AI 학습 불허로 설정했다면, 학습 전용 사용자 에이전트(Google-Extended, Applebot-Extended 등)에 Disallow 규칙이 붙고, 범용 Googlebot / Applebot / Bingbot 사용자 에이전트는 검색을 위해 막히지 않은 상태가 보여야 합니다.
복구 경로: 특정 크롤러 운영자와 별도의 특별한 합의가 있어서(예: 유료 콘텐츠 라이선스 계약) 범주 단위 정책이 그것을 깨뜨린다면, Bot Preference Sync를 끄고 자기 robots.txt를 직접 편집하십시오. 범주 토글은 존 전체 정책을 위한 것이지 운영자별 예외를 위한 것이 아닙니다.
4단계: 정책이 요청되는 것을 넘어 실제로 적용되는지 확인하기
robots.txt는 요청일 뿐입니다. 기술적으로 크롤러가 무시하는 것을 막아주지 않습니다. 사람들이 건너뛰는 단계가 바로 여기이고, 2단계 결정이 실재하는지 이론에 그치는지 알려주는 단계도 여기입니다.
실행: 존의 AI Crawl Control을 엽니다(Free를 포함한 모든 플랜에서 사용 가능합니다. 탐지 품질은 Bot Management가 있는 플랜에서 더 강하지만 가시성 기능은 어디서나 동작합니다). Crawlers 탭을 확인합니다. 사이트에 닿은 모든 봇이 Robots.txt violations 열과 함께 나열됩니다.
기대 결과: 봇별 요청 수와 위반 수가 담긴 표가 나옵니다. 불허나 차단으로 설정한 봇의 위반 수가 0이 아니라면, 그 봇은 현재 여러분의 robots.txt를 무시하고 있습니다.
품질 점검: 위반이 표시된 봇에 대해 "Most popular paths"에서 실제로 무엇에 접근하는지(플래그된 경로로 필터링해) 살펴보고, 정말로 지키고 싶은 콘텐츠를 건드리는지 확인합니다.
복구 경로: 봇이 선언한 설정을 무시한다면 robots.txt만으로는 멈출 수 없습니다. AI Crawl Control의 "Enforce robots.txt rules" 동작(내부 이름으로 Robotcop이라고도 합니다)을 사용해 선언한 규칙을 실제 WAF 규칙으로 변환하십시오. 그러면 비준수 봇이 오리진에 닿기 전에 Cloudflare 엣지에서 차단됩니다. 준수를 부탁하는 상태에서 준수를 강제하는 상태로 넘어가는 것입니다. 이 단계는 WAF를 사용하므로 이용 가능 여부는 플랜의 WAF 접근 권한을 따릅니다.
5단계: 그냥 차단할지, 수익화할지 정하기
학습에 대한 결정이 "학습 접근 불가"였다면, 일괄 차단 외에 두 번째 선택지가 있습니다. 과금하는 것입니다.
실행: 관심이 있다면 Cloudflare의 Pay Per Crawl 비공개 베타에 신청합니다(Cloudflare 신청 페이지에서, 또는 Enterprise 고객은 담당 영업을 통해). 계정 수준에서 활성화한 뒤(Manage Account → Settings → Pay Per Crawl → 도메인의 Visibility를 Visible로 설정) 존 전체에 단일 정액 요청당 가격을 정하고, 크롤러별로 허용(무료) / 과금(내 가격으로 청구) / 차단을 고를 수 있습니다.
기대 결과: Web Bot Auth(크롤러를 식별하는 Ed25519 서명 요청)로 인증하는 크롤러가 과금으로 설정한 페이지를 요청하면 crawler-price 헤더를 담은 HTTP 402 Payment Required를 받습니다. 지불에 동의하고 재시도하거나, 자기 가격을 감당하는 crawler-max-price 헤더를 처음부터 붙였다면 청구된 금액을 확인하는 crawler-charged 헤더와 함께 콘텐츠를 받습니다. Cloudflare가 merchant of record로서 결제를 처리합니다.
품질 점검: 이것은 Cloudflare에 결제 정보를 등록하고 402 흐름을 지원하는 크롤러에만 동작합니다. 모든 봇을 상대하는 만능 토글이 아닙니다. 그 외의 상대에게는 과금 설정이 사실상 차단처럼 동작합니다. Cloudflare는 그래도 그것이 향후 유료 관계에 열려 있다는 신호로 기능할 수 있다고 덧붙입니다.
복구 경로: 이 기능은 비공개 베타입니다. 승인되지 않았거나 기다리고 싶지 않다면, 같은 크롤러에 대해 오늘 쓸 수 있는 선택지는 AI 학습 불허 또는 차단입니다.
예외 처리: 특정 AI 사업자가 접근을 요청하면
존 전체 정책에도 불구하고 AI 기업에서 명시적 접근을 요청하는 연락 — 제휴, 인용 계약, 라이선스 논의 — 이 올 수 있습니다.
범주 전체를 다시 열지 않고 좁은 예외를 주는 방법은 두 가지입니다.
- Manage AI crawlers의 크롤러별 재정의: 그 특정 봇의 행을 차단/과금에서 허용으로 바꿉니다. 범주 전체의 학습·에이전트 설정과 무관하게 가능합니다.
- robots.txt 직접 편집: Bot Preference Sync를 껐거나 예외를 관리 블록 바깥에 두었다면, Cloudflare 관리 섹션 아래에 그 한 사용자 에이전트를 위한 표적 Allow를 추가할 수 있습니다.
어느 쪽이든 존 전체 범주 정책을 기본으로 두고, 이름을 붙인 예외는 기록으로 남기는 의도적 결정으로 다루십시오. 반대가 아닙니다.
완성된 결과 검증하기
설정이 반영되면 이 체크리스트를 한 번 돌립니다.
- [ ] 보안 설정에 검색·에이전트·학습 각각의 명시적이고 의도적인 값이 들어 있다(검토하지 않은 기본값이 아니다)
- [ ] 운영 중인 도메인의
/robots.txt에 그 설정과 일치하는 Cloudflare 관리 블록이 있다 - [ ] AI Crawl Control의 Crawlers 탭에 예상한 봇이 보이고, 차단/불허로 설정한 것의 위반이 0이거나 거의 0이다
- [ ] AI 학습 불허를 골랐다면 Googlebot / Applebot의 검색 크롤링이 평소대로 계속되는지 (Search Console / Bing Webmaster Tools로, 또는 유기 트래픽을 지켜보는 것만으로도) 확인했다
- [ ] robots.txt 적용(Robotcop)을 켰다면 생성된 WAF 규칙이 초안 상태로 남지 않고 배포되어 활성화되어 있다
- [ ] 어떤 설정을 왜 골랐는지 기록해 두었다. 다음 검토가 영에서 시작하지 않도록
결과 유지하기
한 번 설정하고 잊어버릴 구성이 아닙니다. 가벼운 주기로 다시 봅니다.
- 매월: AI Crawl Control의 Metrics 탭에서 정책을 정하지 않은 새 봇이 있는지 확인하고, 위반 수도 다시 확인합니다.
- Bing이 Bingbot용 학습 설정 지원을 출시할 때(Microsoft 기준 2027년 초 목표): 그 시점에 Bing이 Google과 Apple의 현재 동작을 따라잡으므로, 현재 설정이 의도한 "검색은 유지, 학습은 차단"이라는 결과를 여전히 주는지 재평가합니다.
- 광고 수익화 상태가 바뀔 때마다: 디스플레이 광고를 붙이거나 떼면 페이지가 따르는 기본값 계통이 바뀝니다. 명시한 설정이 그것에 비추어 여전히 타당한지 다시 확인할 가치가 있습니다.
FAQ
학습 크롤러를 차단하면 SEO 순위가 떨어지나요? 차단이 아니라 AI 학습 불허를 쓴다면 떨어지지 않습니다. AI 학습 불허는 Accountable 겸용 크롤러(Google, Apple, 그리고 장래의 Bing)가 학습을 건너뛰면서 검색을 위해 계속 크롤링하도록 특별히 만들어진 설정입니다. 반면 순수한 차단은 9월 15일 이후 같은 크롤러의 검색 동작까지 막기 때문에, 그들의 검색 제품에서 노출이 손상됩니다.
9월 15일 전에 이미 "Block AI Bots"를 켜 두었습니다. 제 설정은 어떻게 되었나요? Cloudflare가 자동으로 마이그레이션했습니다. 예전 Block AI Bots는 학습 = AI 학습 불허, 검색 = 허용, 에이전트 = 광고가 있는 페이지에서 차단이 되었습니다. 마이그레이션이 의도와 맞았다고 가정하지 말고 위의 1단계로 실제로 그렇게 되었는지 확인하십시오.
이것이 Free 플랜에서도 되나요? 됩니다. AI Crawl Control, 검색/에이전트/학습 범주 설정, Bot Preference Sync 모두 Free를 포함한 모든 플랜에서 사용할 수 있습니다. 일부 적용 세부 사항은 플랜에 따라 다릅니다. 예를 들어 robots.txt 적용은 WAF를 거치고, Free 플랜의 봇 탐지는 더 고급인 Bot Management 탐지 ID가 아니라 사용자 에이전트 문자열에 의존합니다.
AI Crawl Control과 AI 봇 보안 설정은 무엇이 다른가요? 보안 설정은 정책을 정하는 곳입니다(범주별로 허용 / 광고 페이지에서 차단 / 차단 / AI 학습 불허). AI Crawl Control은 실제로 무슨 일이 일어나는지 감사하는 곳입니다. 봇별 요청 수, robots.txt 위반, 경로 단위 세부 정보를 볼 수 있고, 선언한 robots.txt 정책을 적용되는 WAF 규칙으로 변환할 수 있습니다.
이 설정을 한 뒤 robots.txt를 직접 편집해야 하나요? Bot Preference Sync가 켜져 있다면 필요 없습니다. 대시보드 설정에 따라 알맞은 robots.txt 블록을 알아서 쓰고 유지합니다. 수동 편집이 필요한 경우는 관리 대상 범주 바깥에 운영자별 예외를 만들 때뿐입니다.
작성자: Julian Mercer, Auspia의 14년 차 테크니컬 SEO 실무자. 크롤링 가능성, 스키마, 렌더링, AI가 읽을 수 있는 콘텐츠의 기술적 기반에 대해 씁니다.