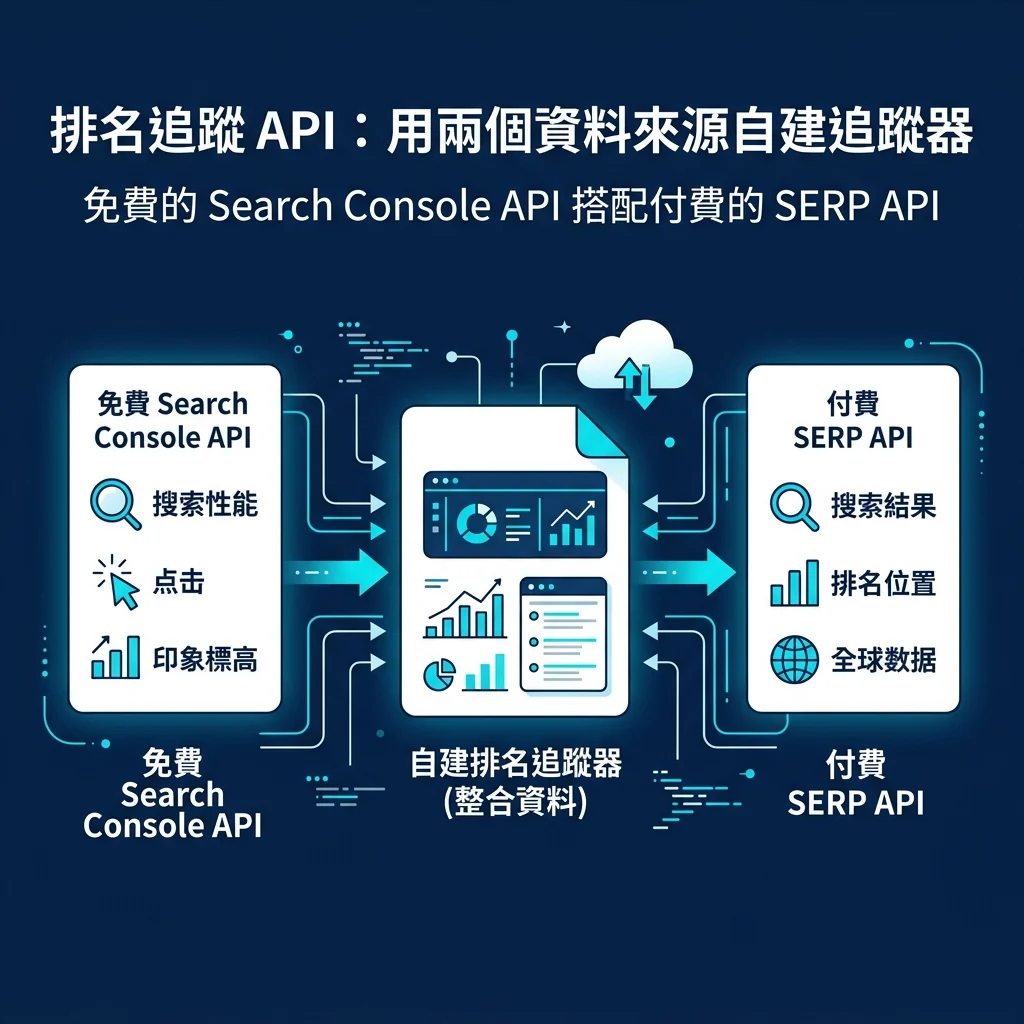
「排名追蹤 API」不是一個東西。開發者搜尋 “rank tracking API” 時,通常想要一個回傳排名的單一端點,而市場用供應商的清單文章來回應。誠實的答案是:你需要兩個資料來源,它們回答不同的問題。
Search Console API 免費、官方,並且永久限定於你能驗證的資源。SERP API 付費、非官方,可以查詢任何地方的任何關鍵字,包括你從未排上過的關鍵字。兩者單獨都不是排名追蹤器。合在一起,大約就是 120 行 Python 加一條 cron。
這就是那套建置方案。它假設你能跑腳本、能存檔案,不假設你想做一款產品。
完成後你會得到什麼
適合誰: 已經擁有 Search Console 權限,想按計畫拿到排名、又不想按席位付費的開發者或技術行銷人員。
完成時你手上會有什麼: 兩個能用的抓取函式,每次執行一個合併輸出檔,以及一條讓數字無法對你說謊的比較規則。
時間: 首次建置約 90 分鐘,之後每次執行約 10 分鐘複核。
完成的樣子: 一個帶日期的 JSON 檔,包含按查詢與按裝置劃分的自有排名、一份凍結關鍵字清單的即時 SERP 快照,以及與上一次執行的簡短差異。
開始之前:每個資料來源能做什麼、不能做什麼
把這個分工做對,剩下的建置就是機械勞動。做錯了,你會花一個月造出要嘛沒用、要嘛很貴的東西。
Search Console API | SERP API | |
|---|---|---|
誰的排名 | 僅你已驗證的資源 | 任何人,包括競爭對手 |
關鍵字 | 你已經出現過的查詢 | 你輸入的任何關鍵字 |
成本 | 免費 | 按請求計費 |
裝置拆分 | 有,作為維度 | 有,按請求 |
地區 | 你有排名的國家 | 供應商支援的任何地區 |
資料類型 | 點擊、曝光、平均排名的彙總 | 某一時刻的結果頁 |
歷史深度 | 你請求的區間 | 僅從你開始儲存那天起 |
官方性 | Google 自己的資料 | 第三方對公開頁面的讀取 |
兩個資料來源會互相矛盾,而這種矛盾是資訊而不是缺陷。Search Console 對區間內每一次曝光、每一台裝置取平均。SERP 抓取是某一刻的一個結果頁。直接把兩者相比,你會去追根本不存在的下跌。所以第 5 步定義了一條比較規則。
寫程式前值得知道的三個數字。 Search Console API 每次請求接受 1 到 25,000 的列數上限,預設 1,000,所以一個中型站點可以在一次呼叫裡抓取三個月的查詢與裝置資料。它允許每站點、每使用者每分鐘 1,200 次查詢。它還按 10 分鐘一段來計量負載配額,長區間比短區間更貴——這正是 Google 自己的指南說要避免重複查詢同一批資料的原因。
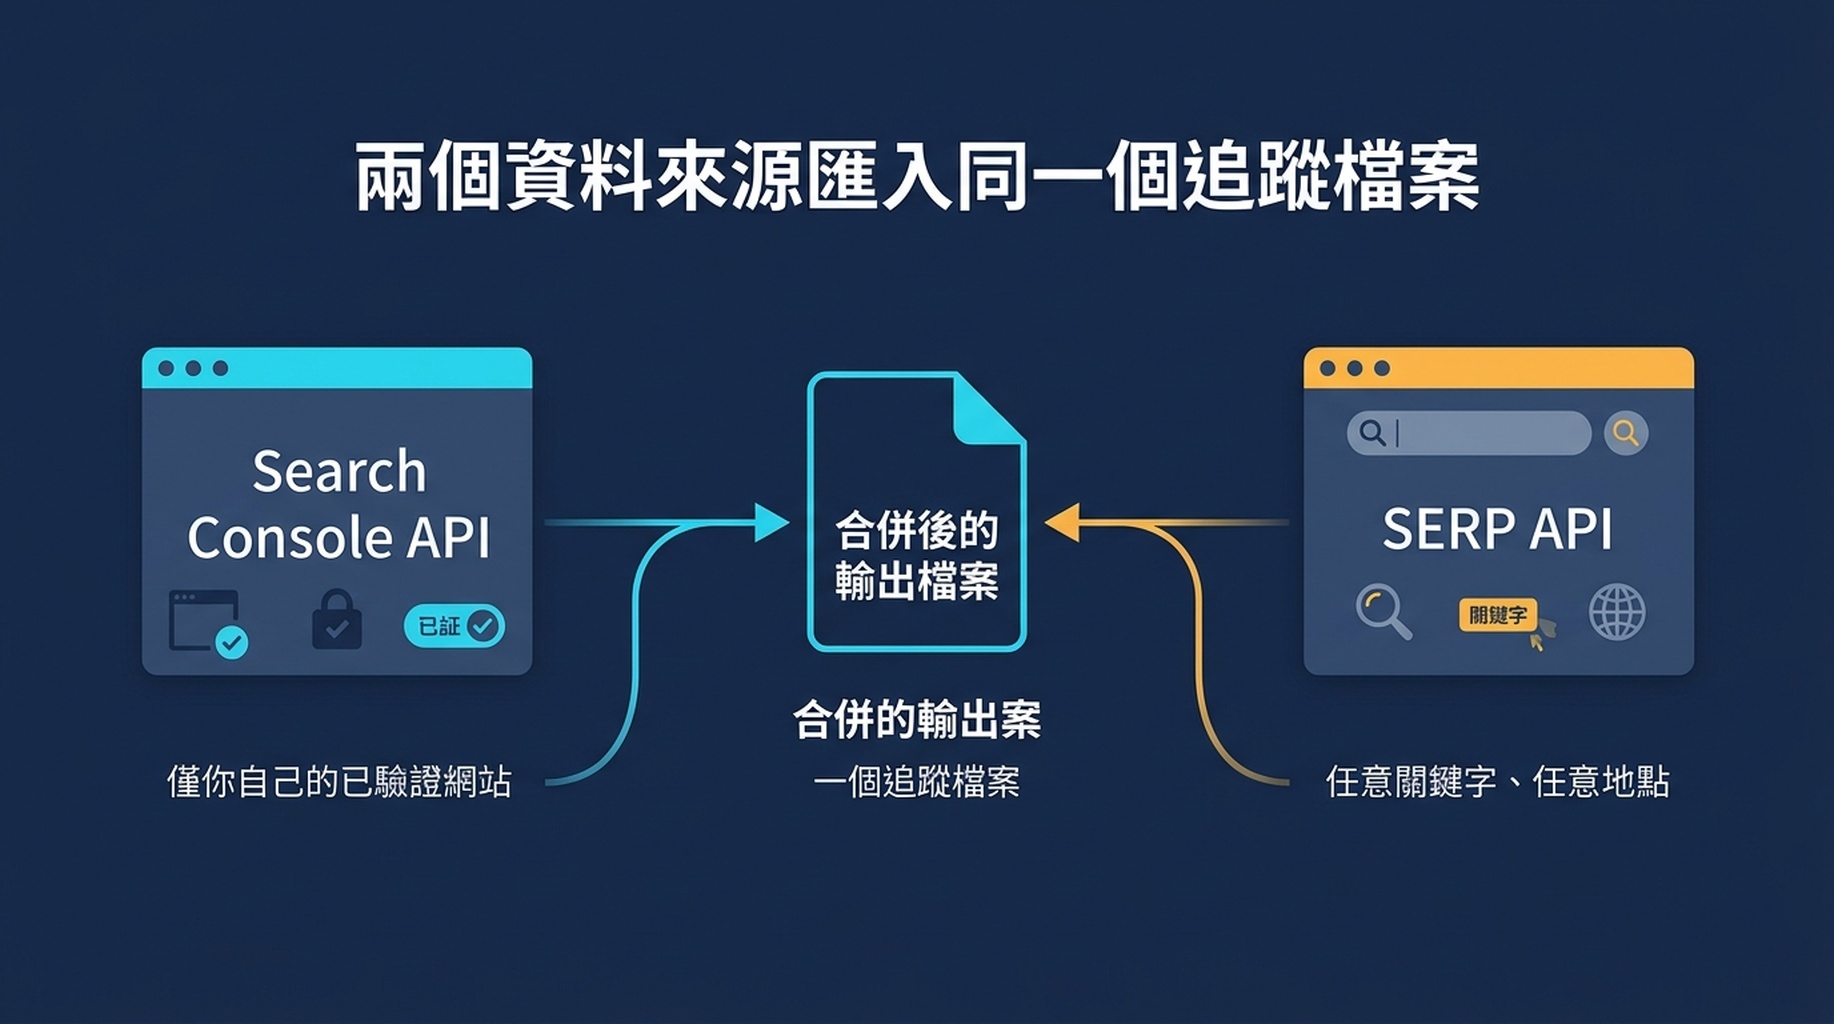
兩個資料來源,一個輸出。Search Console 回答「我出現在哪裡」,SERP API 回答「頁面長什麼樣」。
第 1 步:寫任何程式之前先凍結關鍵字集合
一個每次執行都抓取不同關鍵字清單的追蹤器,無法回答是否有任何變化。先把清單定下來,然後維持一個季度。
分三組,來源各不相同。
- 來自 Search Console: 過去 90 天曝光量至少 20 的每一個查詢。這些不是你選的,是你的曝光量選的。這一組的變動才有意義,因為背後已經掛著真實需求。
- 來自業務: 對應營收的 10 到 20 個查詢,無論你現在有沒有排名。
- 來自競爭對手: 競爭對手排上而你沒排上的查詢。這些需要 SERP API,因為 Search Console 永遠不會顯示它們。
把清單寫進檔案,納入版本管理,把新增當作一次有意的變更,而不是慢慢漂移。
第 2 步:免費抓取你自己的排名
這一半是官方的、免費的,並且給你任何 SERP API 都沒有的裝置拆分與點擊資料。
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
這個請求裡有兩個細節承擔了大部分工作。
dataState: "final" 排除 Google 可能還會修訂的新鮮資料。沒有它,最近兩三天的資料會在每次執行之間變動,你的差異裡就會出現從未發生過的波動。
dimensions: ["query", "device"] 是讓輸出在日後有用的那一項。現在加上裝置不花任何代價。日後再去重抓三個月歷史,要花一整次執行,而且對你已經跳過的那些天什麼也補不回來。
預期輸出: 每個查詢與裝置的組合一列,含點擊、曝光、CTR 與平均排名。
品質檢查: 列數應低於 25,000。如果正好是 25,000,表示被截斷了,需要用 startRow: 25000 再呼叫一次。
如果失敗: 403 通常意味著服務帳號電子郵件從未被加入為該資源的使用者。在 Search Console 裡加上,等幾分鐘,重試。
第 3 步:抓取你在自有資料裡看不到的 SERP
後半部分涵蓋 Search Console 在結構上做不到的一切。這是一個最小可用的呼叫。
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
把 `depth` 設為 100,不要設 200。 我們在 2026 年 9 月用六個查詢請求 200 筆來測過這件事。Google 回傳了 83 到 128 筆自然結果就停止了,整個測試中最深的排名是 142。完整測試在這裡。請求 200 並不會拿到 200 筆,而且視供應商而定,它可能仍按你請求的深度計費。請求 100,你幾乎總能收到存在的全部結果。
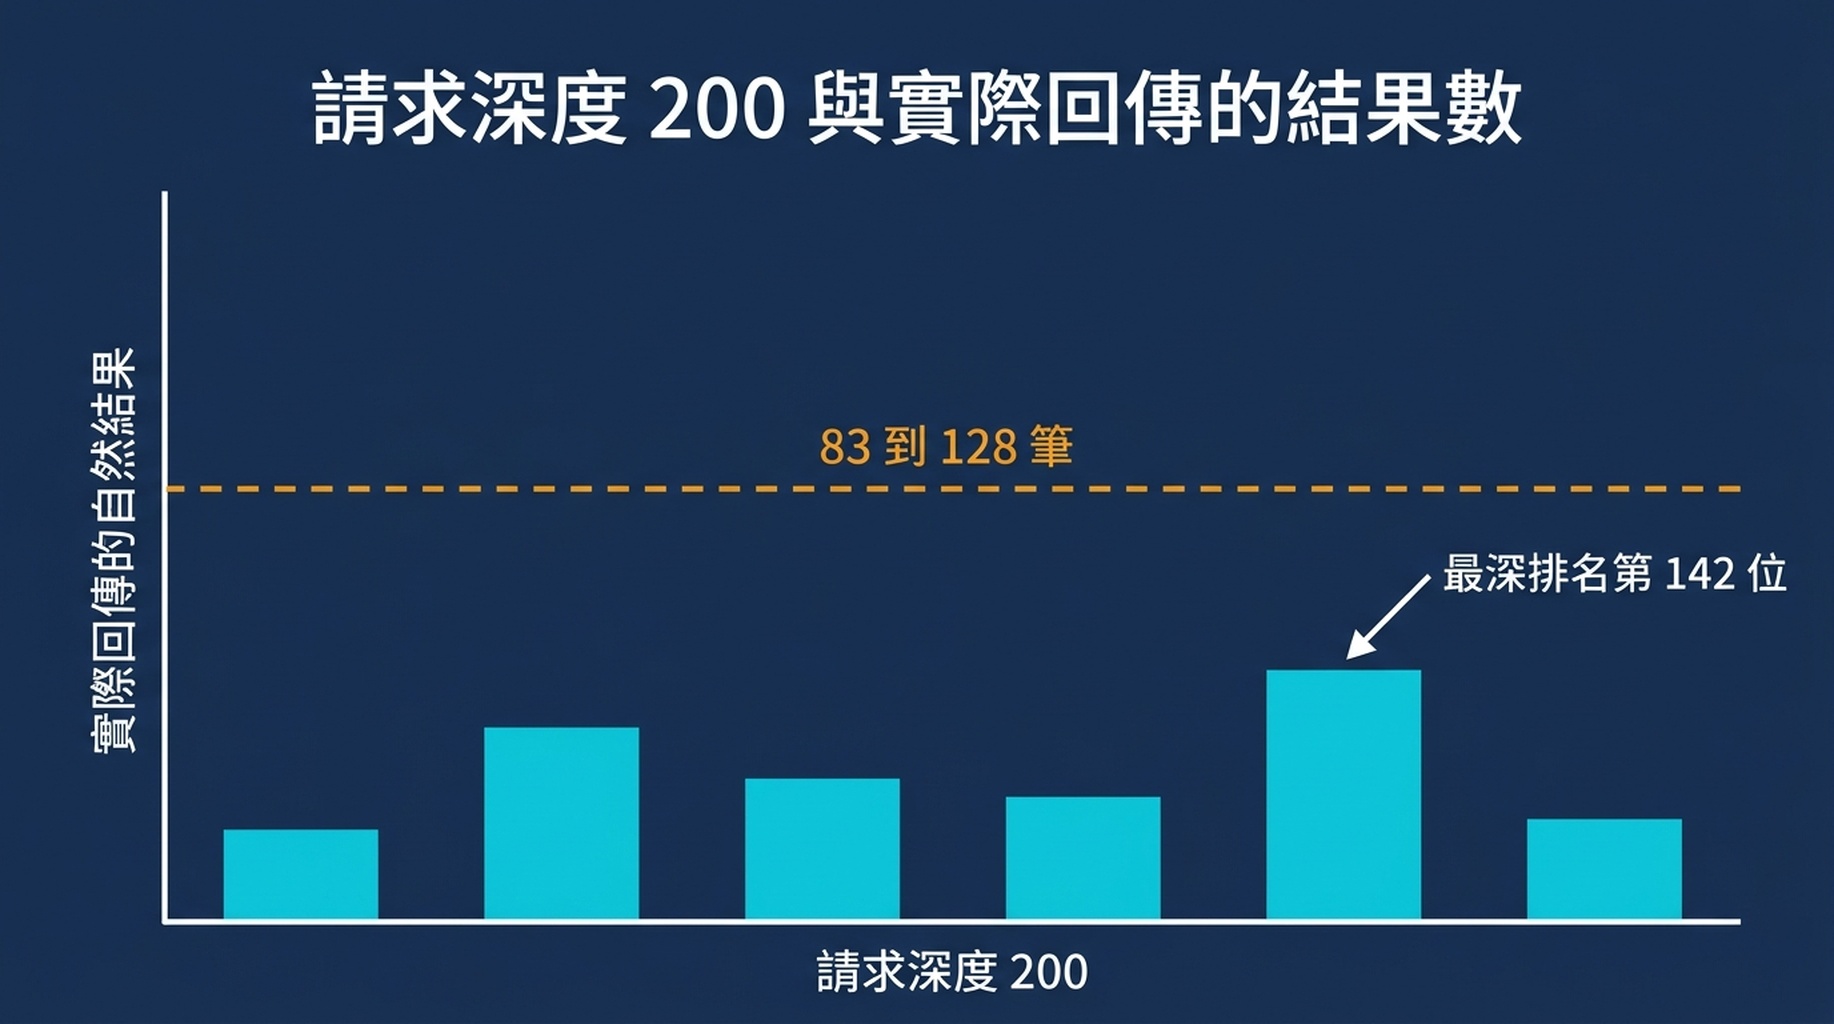
請求 200 筆,實際收到 83 到 128 筆。在多數商業查詢上,超過約 140 的深度買不到任何東西。
預期輸出: 一個 JSON 載荷,其中自然結果項目含排名、URL、標題與網域。
品質檢查: 確認載荷在存在 AI Overview 時含有 ai_overview 項目類型。如果你只擷取 organic 項目,就會漏掉一個頁面保住排名卻丟掉點擊的原因。
如果失敗: 401 是 base64 或憑證錯誤。40200 一類代碼表示帳戶餘額為空,這是第一個月最常見的失敗。
第 4 步:存原始載荷,而不是摘要
這是人們跳過之後會後悔的決定。
存一張排名表格,直到你需要問一個沒預料到的問題時就不夠用了:SERP 是不是變長了、影片是不是佔了上風、競爭對手是不是進場了、AI Overview 是不是出現在首屏上方。摘要回答不了這些。原始載荷可以,而且零額外成本。
務實版本是:每次執行寫一個檔案,以日期和時間命名,裝上合併後的輸出。保留最近 90 天。小到可以放進程式碼倉庫,完整到能重新回答舊問題。
第 5 步:排程之前先寫下比較規則
一個把上次執行和這次執行相比的追蹤器,大多數日子都會發出誤報。我們自己的數字說明了原因:在 124 個曝光量至少 30 的查詢中,平均每個查詢隔一天移動 4.57 個名次。掉四個名次,不過是又一個星期二。
所以規則需要一個門檻和一個方向。
僅在以下條件全部滿足時報告某個查詢:
  - 與上次執行相比的名次變化絕對值達到 5 或以上,並且
  - 該查詢在比較視窗內曝光量至少 20,並且
  - 該變化無法由裝置組成的變化解釋

按查詢類別分組輸出:money、comparison、brand、informational。
不要提出修正建議。
裝置那一條不是裝飾。同一個查詢在行動端與桌面端可以相差 11 個名次,如果兩次執行之間裝置組成發生變化,混合後的數字也會變。我們另外測過這件事,幅度大到足以偽造出一種趨勢。
成本
供應商價格會變,所以建模,別追報價。
- 一個關鍵字每天查一次、查 30 天,是每月 30 次請求。
- 200 個關鍵字的集合每天查,是每月 6,000 次請求。
- 同一個集合每週查,是每月約 860 次請求。
- Search Console 那一半是免費的,無論裡面裝多少個關鍵字,每次檢視都是一次請求。
這個乘法就是整個決策。「我該不該買個工具」幾乎總能坍縮成它:算出每月請求數,乘以你的單次請求價格,再和席位授權比一比。大關鍵字集合每天追蹤,通常訂閱更便宜。小集合每週追蹤,通常 API 更便宜。追蹤一份凍結的清單,API 這一側就會一直很小。
什麼時候該買而不是自己建
如果你想把排名放進自己的管道、已經持有 SERP API 憑證,或者出於排名之外的理由需要原始結果頁,那就自己建。
如果你需要今天之前的歷史排名、需要同一批關鍵字的十個地區與五種裝置,或者團隊裡沒人願意維護一個 cron 工作,那就買。供應商的清單文章正是因為這個原因值得一讀,而擁有一套「建它的人換團隊後就停擺」的基礎設施,是有真實成本的。
如果你真正需要的輸出是一份寫好的週報而不是 JSON 檔,Codex 報表工作流程從同樣的兩個資料來源出發,最終落到一份文件。要在檔案之上做告警,監控設計指南講了門檻。
Auspia 觀點:排名追蹤 API 這個問題,本質上是資料所有權問題。Search Console 免費給你自有資源的官方資料,而且永遠會給。其餘一切都是你付費買來的快照。先把免費的一半建起來,付費的一半只加在它確實回答了你真實問題的地方。
常見問題
Google 提供排名追蹤 API 嗎? 沒有公開的。Search Console API 回傳你已經出現過的查詢的平均排名,接近但不是同一回事。它查不了你沒有排名的關鍵字,也查不了競爭對手。
SERP API 能挖多深? 供應商會接受遠高於 200 的深度值,但 Google 在多數商業查詢上大約到 100 至 140 之間就不再提供結果。要求更多並不會產生更多結果。
我該用每日還是每週檢查? 普通關鍵字集合用每週。每日只用於一小串營收關鍵字。對大集合做每日檢查會把成本乘以七,而且大多是在測量雜訊,因為我們自己資料裡的日均移動是 4.57 個名次。
為什麼我的 API 數字和我的排名工具不一樣? 裝置不同、地區不同、時刻不同,資料來源往往也不同。那個數字是個樣本。在得出任何變化結論之前,先把請求裡的地區與裝置固定下來重抓一次。
代理程式能替我做這件事嗎? 能,而且很合適,因為這項任務每次執行的形狀都一樣。關於代理程式在排名工作中能承擔的範圍,見 SEO 代理程式實戰指南。把比較規則寫進一份指令檔,讓代理程式產出差異,而買還是建的决定留給人。
作者:Rowan Blake,Auspia 內容自動化分析師,負責 100 多條發布管道。Rowan 撰寫關於自動化資料管道、定時報表,以及在你不在時仍自行運轉的系統的維護成本。