AI 引用不會帶來點擊。你該改測這些指標
簡短回答: AI 引用是品牌記憶的訊號,而不是流量管道。點擊從來就不是重點——當模型在回答中引用你的頁面時,使用者已經得到他們想要的東西。繼續用推薦點擊來評判 GEO 的團隊,會在它即將開始奏效的前一刻得出「失敗」的結論。解決辦法不是放棄引用工作,而是換掉儀表板。
OpenAI 工程師到底說了什麼
2026 年 9 月 22 日,一個從業者帳號轉述了一位 OpenAI 工程師的說法:即使用者介面把引用連結醒目地展示出來,使用者也不會點擊。
這一點需要謹慎對待。它是對內部觀察的二手轉述,不是 OpenAI 的官方聲明,也沒有作為研究發表。但它與我們能找到的每一項獨立測量都一致,因此值得據此行動,而不是等一份新聞稿。
支撐證據並不薄弱:
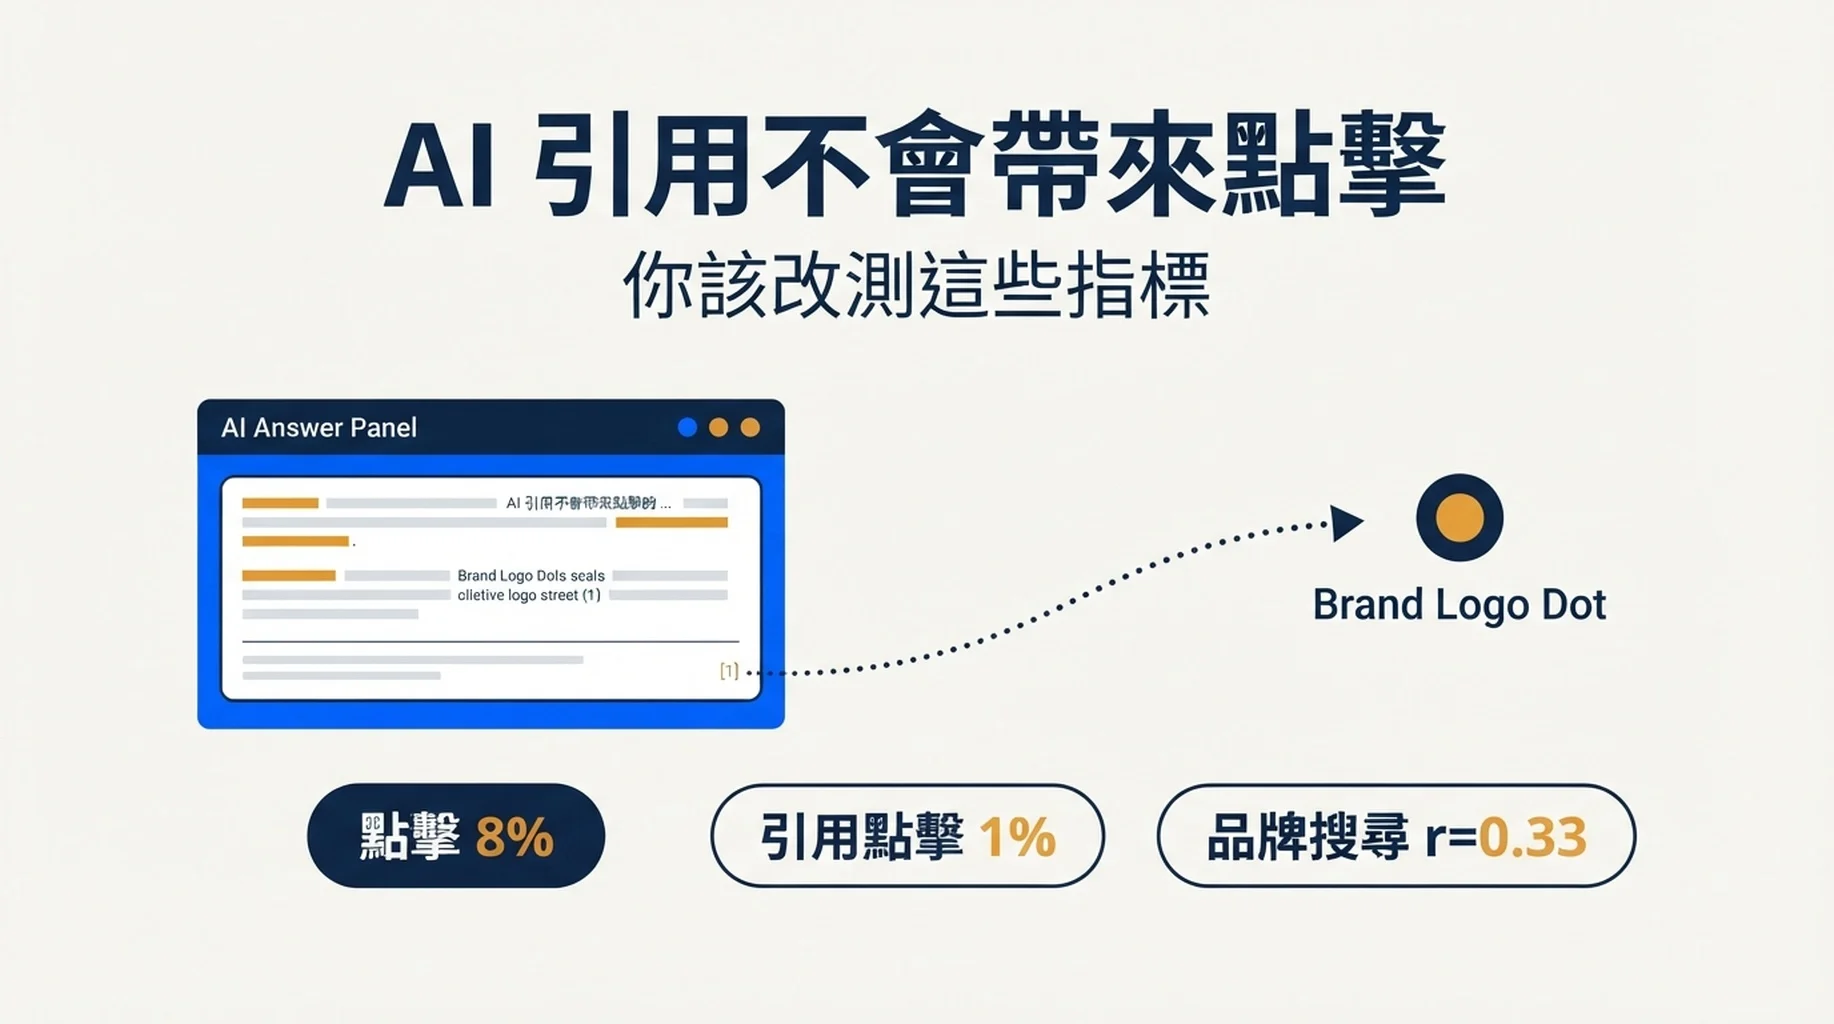
- Pew Research Center 在 2025 年 3 月追蹤了 900 名美國成年人的 68,879 次 Google 搜尋。當出現 AI 摘要時,使用者點擊進入一般結果的比率為造訪量的 8%,而沒有摘要時為15%。點擊摘要內部連結的比率僅為造訪量的 1%。
- Seer Interactive 分析了 42 個組織的 2,510 萬次曝光,發現出現 AI Overview 的查詢中,自然搜尋 CTR 從 1.76% 崩落至 0.61%——下降 61%。
- Ahrefs 的縱向資料發現,AI Overview 使自然搜尋第一名的點擊率下降 58%。
三個獨立資料集,三種不同方法,同一個方向。點擊消失不是因為使用者變懶了,而是因為答案已經送達。
為什麼引用不會轉化為點擊
大多數團隊仍然沿用的心智模型來自藍連結時代:
使用者有問題 → 搜尋 → 瀏覽十條連結 → 挑一條 → 點擊 → 閱讀。
在那個世界裡,排在清單最前面就是全部,因為點擊是傳遞價值的唯一方式。引用預設繼承了這套邏輯:被引用,就獲得點擊。
但 AI 回答的路徑更短:
使用者有問題 → 搜尋 → 答案已經在畫面上 → 使用者結束。
沒有剩下任何需要執行的導覽步驟。引用不是入口,而是註腳。它告訴使用者這句話來自哪裡,就像參考文獻條目一樣。沒有人會在判斷某一章是否回答了自己的問題之前,先去讀這本書的註腳。
這就是「AI 引用能帶來流量」這個說法站不住腳的原因。
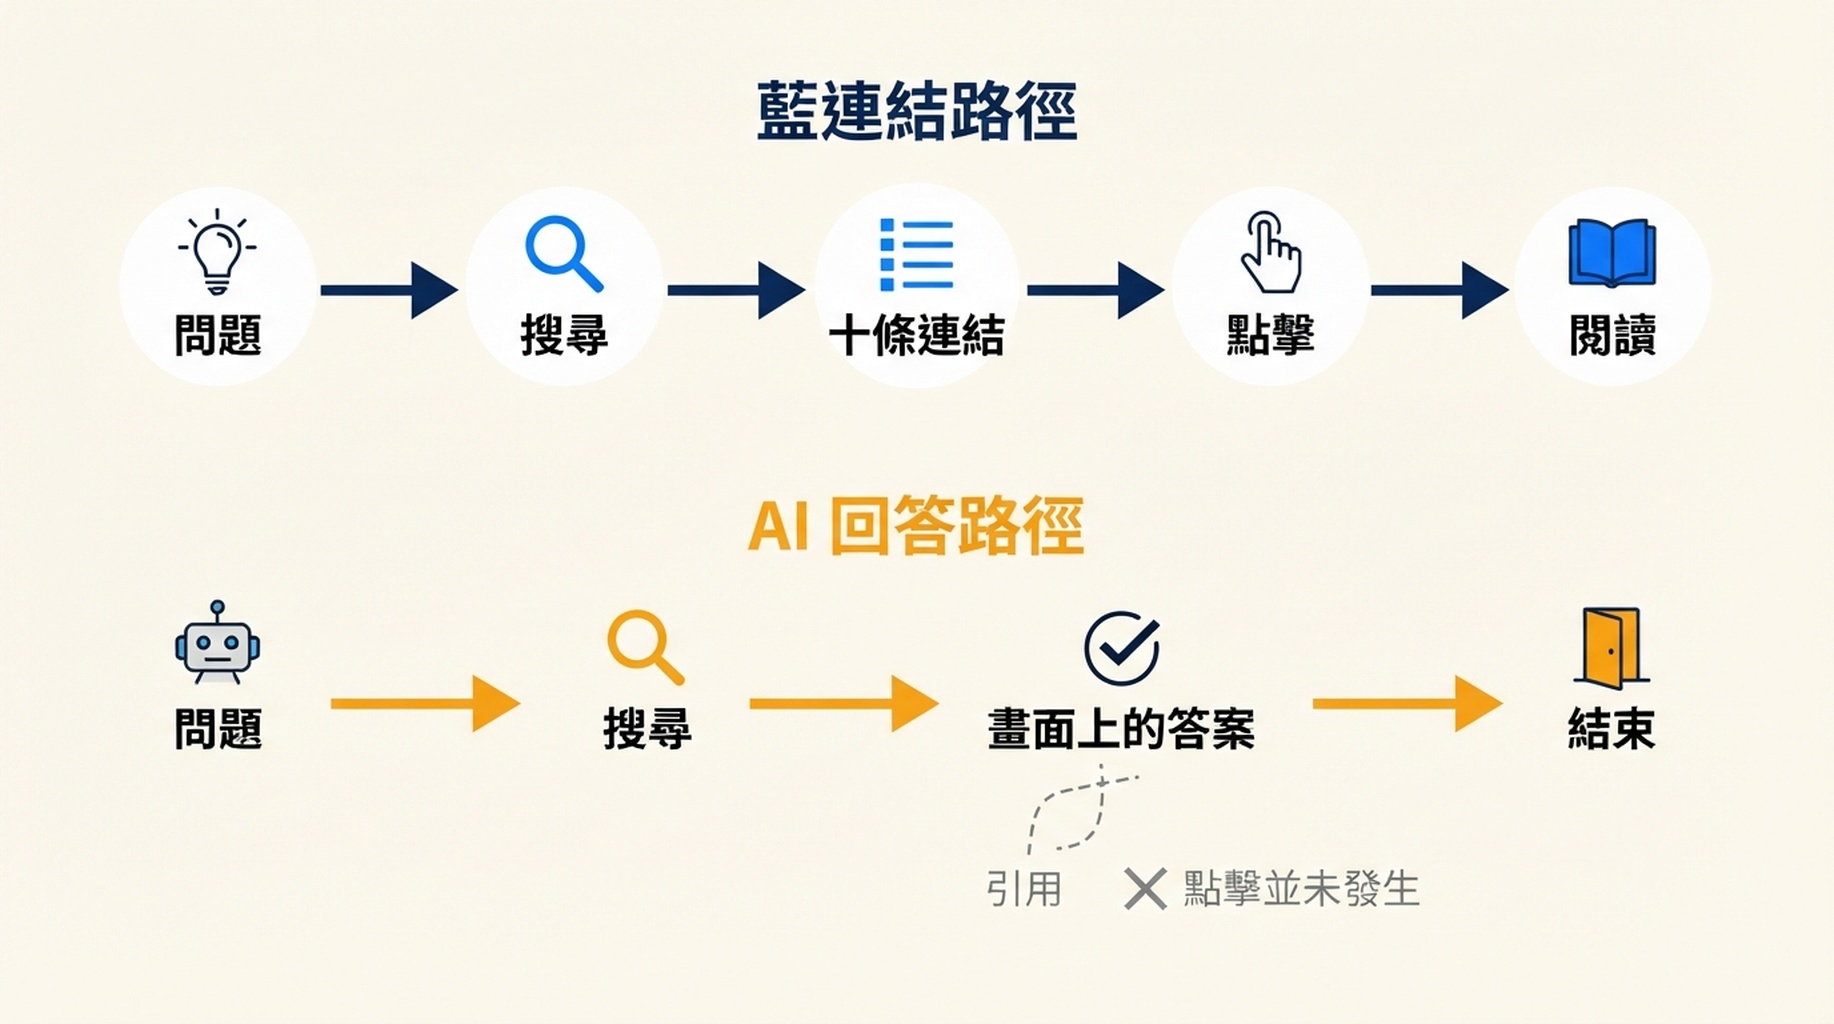
它假設了一種導覽需求,而答案本身已經滿足了這種需求。
第二個原因是結構性的。Google 自己的 Search Console 報表現在會顯示你的頁面被展示了多少次、哪些頁面出現在 AI 回答中——但它不會給出這些曝光的點擊資料,因為大多數情況下根本沒有點擊可數。當 Google 在 2026 年 8 月 31 日向所有網站擁有者開放 AI 功能報表時,它也同時提供了一個開關:退出 AI Overview、AI Mode 和 Discover 的生成式功能,而 Google 自己的文件說,你將無法從這些功能獲得任何流量和曝光。這個開關只能把你移出去,不能把你放進來。
真正起作用的東西:三個值得追蹤的訊號
如果推薦點擊是錯誤的儀器,應該用什麼來替代?有三個訊號能夠捕捉引用所創造、但點擊無法揭示的價值。
1. 答案收錄率
是什麼: 在你的目標提示詞中,你的品牌、頁面或主張出現在 AI 答案裡的比例——無論是否附帶連結。
為什麼優於點擊: 它衡量的是你真正能夠影響的東西。一次沒有帶來點擊的引用,仍然在決策的那一刻把你的名字放到了使用者面前。
如何衡量: 建立一套固定的提示詞集(20–50 個買家真正會問的問題),按固定頻率在 ChatGPT、Perplexity、Gemini 和 Google AI Overviews 上執行,並記錄你是否出現。追蹤比例的變化趨勢,而不是單次答案。
好的狀態是什麼樣: 你要找的是變化,而不是高絕對值。一個品牌從 40 個提示詞中出現 4 次提升到出現 11 次,即便原始百分比仍然很低,也已經是一個真實的訊號。
2. 品牌提及率(被點名但未被連結)
是什麼: 你的品牌在答案中被點名、但未被作為來源引用的頻率。這是與引用截然不同的訊號,而把兩者混為一談是 GEO 報告中最常見的衡量錯誤之一。
為什麼優於點擊: 一個能點出你品牌名字的模型,已經學會了你的品牌。這就是實體識別,也是日後被推薦的前提條件。它通常出現在引用之前。
如何衡量: 在同一套提示詞集上,為每個答案分別記錄兩個欄位——被點名和被引用。兩者會出現分歧,而分歧本身就是洞察。
好的狀態是什麼樣: 引用率持平而提及率上升,這不是失敗。這是模型正在建構對你的表徵。引用通常會隨後跟上。
3. 品牌搜尋成長
是什麼: 人們直接搜尋你品牌名稱的頻率變化。
為什麼優於點擊: 它是「有人在 AI 答案中看到了我們,沒有點擊,後來按名字回來了」這一情形最接近的代理指標。這就是 AI 中介世界裡的真實轉換路徑,而它對任何基於點擊的儀表板都是不可見的。
如何衡量: 在 Google Search Console 中追蹤品牌詞查詢,如果有資料,也在 Bing Webmaster Tools 中追蹤。把趨勢與你的 AI 可見性工作對比,而不是與內容行事曆對比。
好的狀態是什麼樣: 非品牌自然點擊下降,而品牌搜尋量保持或上升,在 2026 年是一個好的模式。它意味著即便點擊路徑被侵蝕,你仍然被記住了。
這裡有一個值得了解的支撐性資料點。當研究者測量什麼能預測 AI 引用時,品牌搜尋量的相關性為 r ≈ 0.33,而網域權威的相關性僅為 r ≈ 0.18——低於 2024 年的 r ≈ 0.43。訊號已經從「你的網域有多強」轉向「人們是否已經知道你的名字」。品牌記憶不是軟指標。它現在是更強的預測因子。
一份本週就能跑的 GEO 計分卡
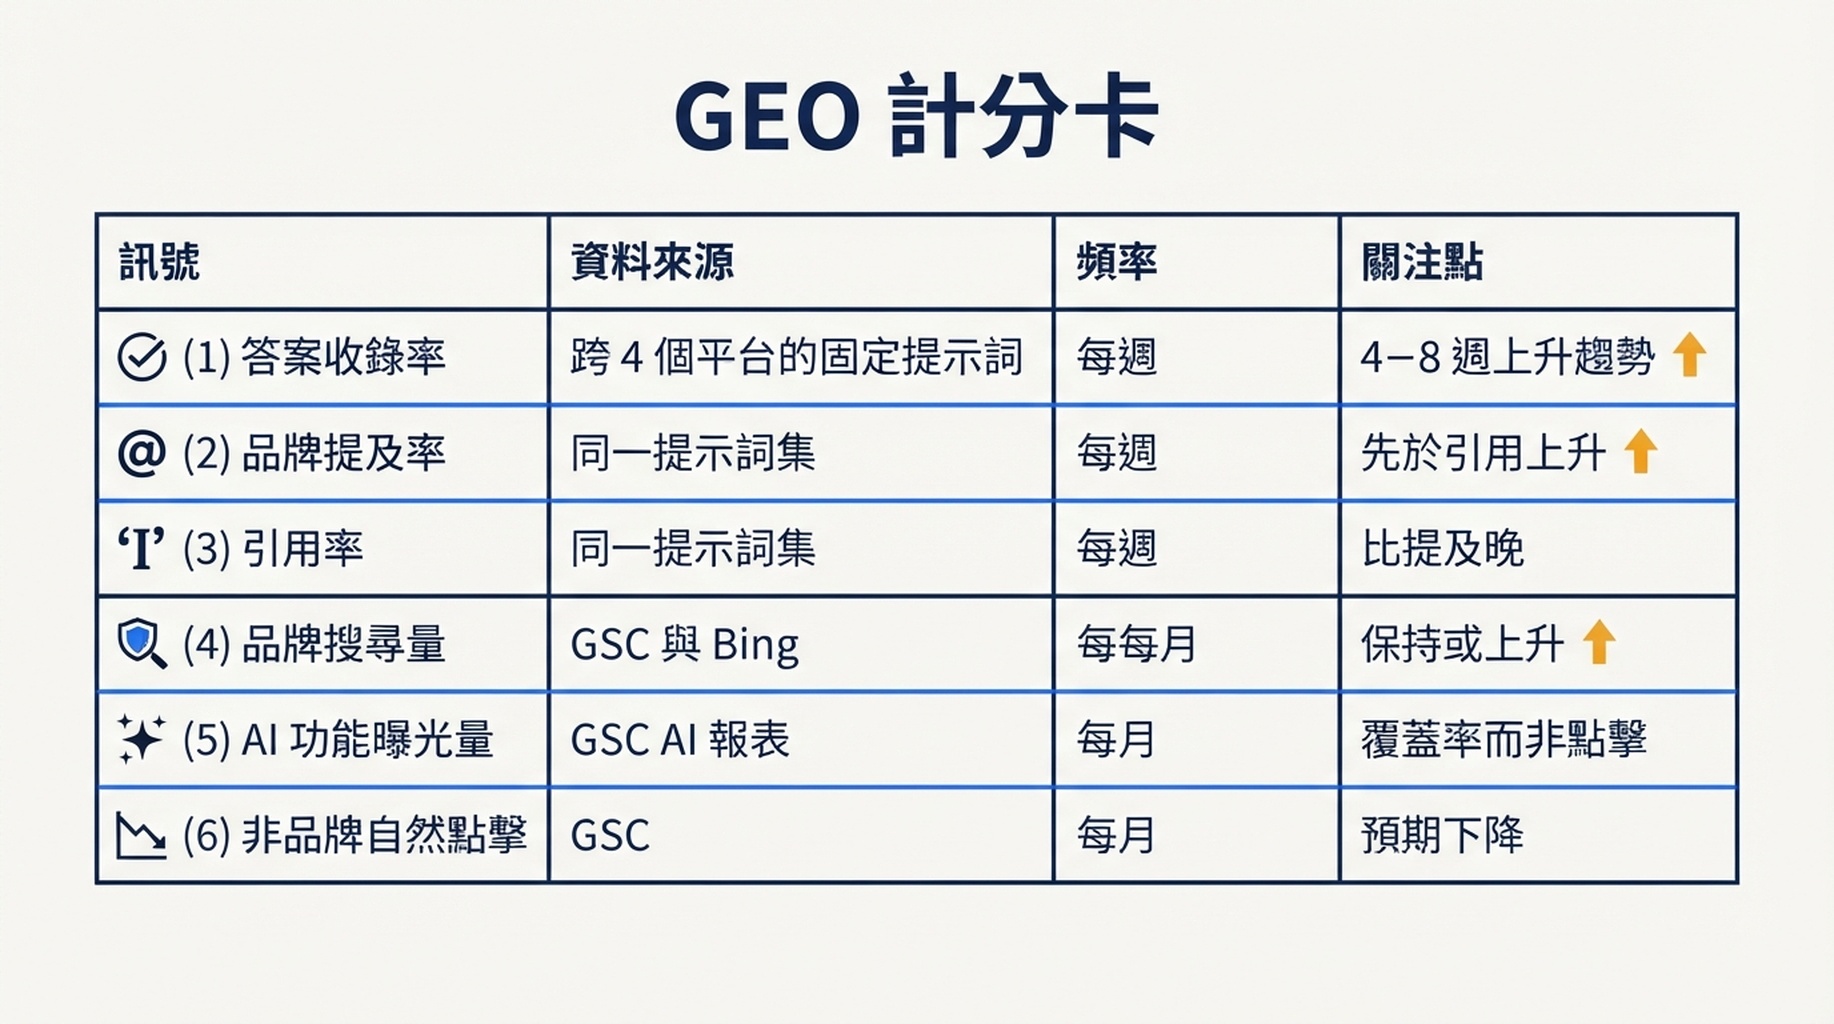
訊號 | 資料來源 | 頻率 | 關注點 |
|---|---|---|---|
答案收錄率 | 跨 4 個平台的固定提示詞集 | 每週 | 4–8 週的上升趨勢 |
品牌提及率(被點名,未被引用) | 同一提示詞集,第二個欄位 | 每週 | 先於引用上升 |
引用率 | 同一提示詞集,第三個欄位 | 每週 | 比提及晚數週,而非數天 |
品牌搜尋量 | GSC + Bing Webmaster | 每月 | 在非品牌點擊下降時保持或上升 |
AI 功能曝光量 | GSC AI 功能報表 | 每月 | 覆蓋率,而非點擊 |
非品牌自然點擊 | GSC | 每月 | 預期下降;不要驚慌地把它當作失敗 |
執行這套計分卡的兩條規則:
不要把「被點名」和「被引用」合併成一欄。 它們衡量不同的東西,並按不同的時間軸變化。合併它們,團隊最終就會把一次實際上只是提及的情況報告成「引用勝利」。
給它一個季度,而不是一週。 品牌記憶是慢訊號。如果你用 7 天的視窗來評估,你會得出它不起作用的結論,因為你所衡量的東西還沒有時間發生。
這套邏輯在哪裡會失效
「引用不帶來點擊」這一發現是真實的,但它並不普遍適用,過度套用會讓你損失流量。
高意圖比較類查詢仍然會轉換。 當有人讓 AI 比較兩個具體供應商,或問「X 值不值」,答案往往以使用者會立即行動的建議收尾。在這些情況下,引用確實能產生點擊——因為使用者仍然需要完成一件答案無法替他們完成的任務。
交易類和本地類查詢仍然會帶來流量。 「預訂」「購買」「附近的」「價格」這些意圖會導向一個目的地。答案無法替代交易本身。
點擊死掉的地方是資訊類查詢。 8% 這個數字就出自這裡,也是衡量方式最需要率先改變的地方。如果你的整個流量模型都依賴於資訊類查詢的點擊,那是商業模式問題,而不是 GEO 問題。
實際含義是:按意圖對衡量進行分段。不要把資訊類查詢的發現套用到你的整個流量組合上。
Auspia 的觀點
產業花了兩年時間建構引用可見性,然後用一個點擊計數器去衡量它。這種錯配正是為什麼許多 GEO 專案在自己的儀表板上看起來像失敗,而它們的品牌卻在悄然成為答案。
我們認為誠實的立場是這樣的:如果你做 GEO 是為了獲得點擊,那你的動機就是錯的,資料現在正在告訴你這一點。如果你做 GEO 是為了在買家向模型尋求推薦時成為被點名的品牌,那麼資料表明你走在正確的軌道上——只是在你舊的報表裡還看不到而已。
未來兩年勝出的團隊,會是那些在改變策略之前先改變儀器的團隊。從上面的計分卡開始。完整跑一個季度。然後用一個真正能偵測到它的指標,來判斷 GEO 是否有效。
作者:Ethan Marlowe,Auspia 的 GEO 衡量負責人,橫跨 500 多個提示詞。Ethan 撰寫關於提示詞追蹤、引用報表,以及建構能夠衡量 AI 答案真正改變了什麼的可見性儀表板的文章。