Правило, яке Google щойно записав
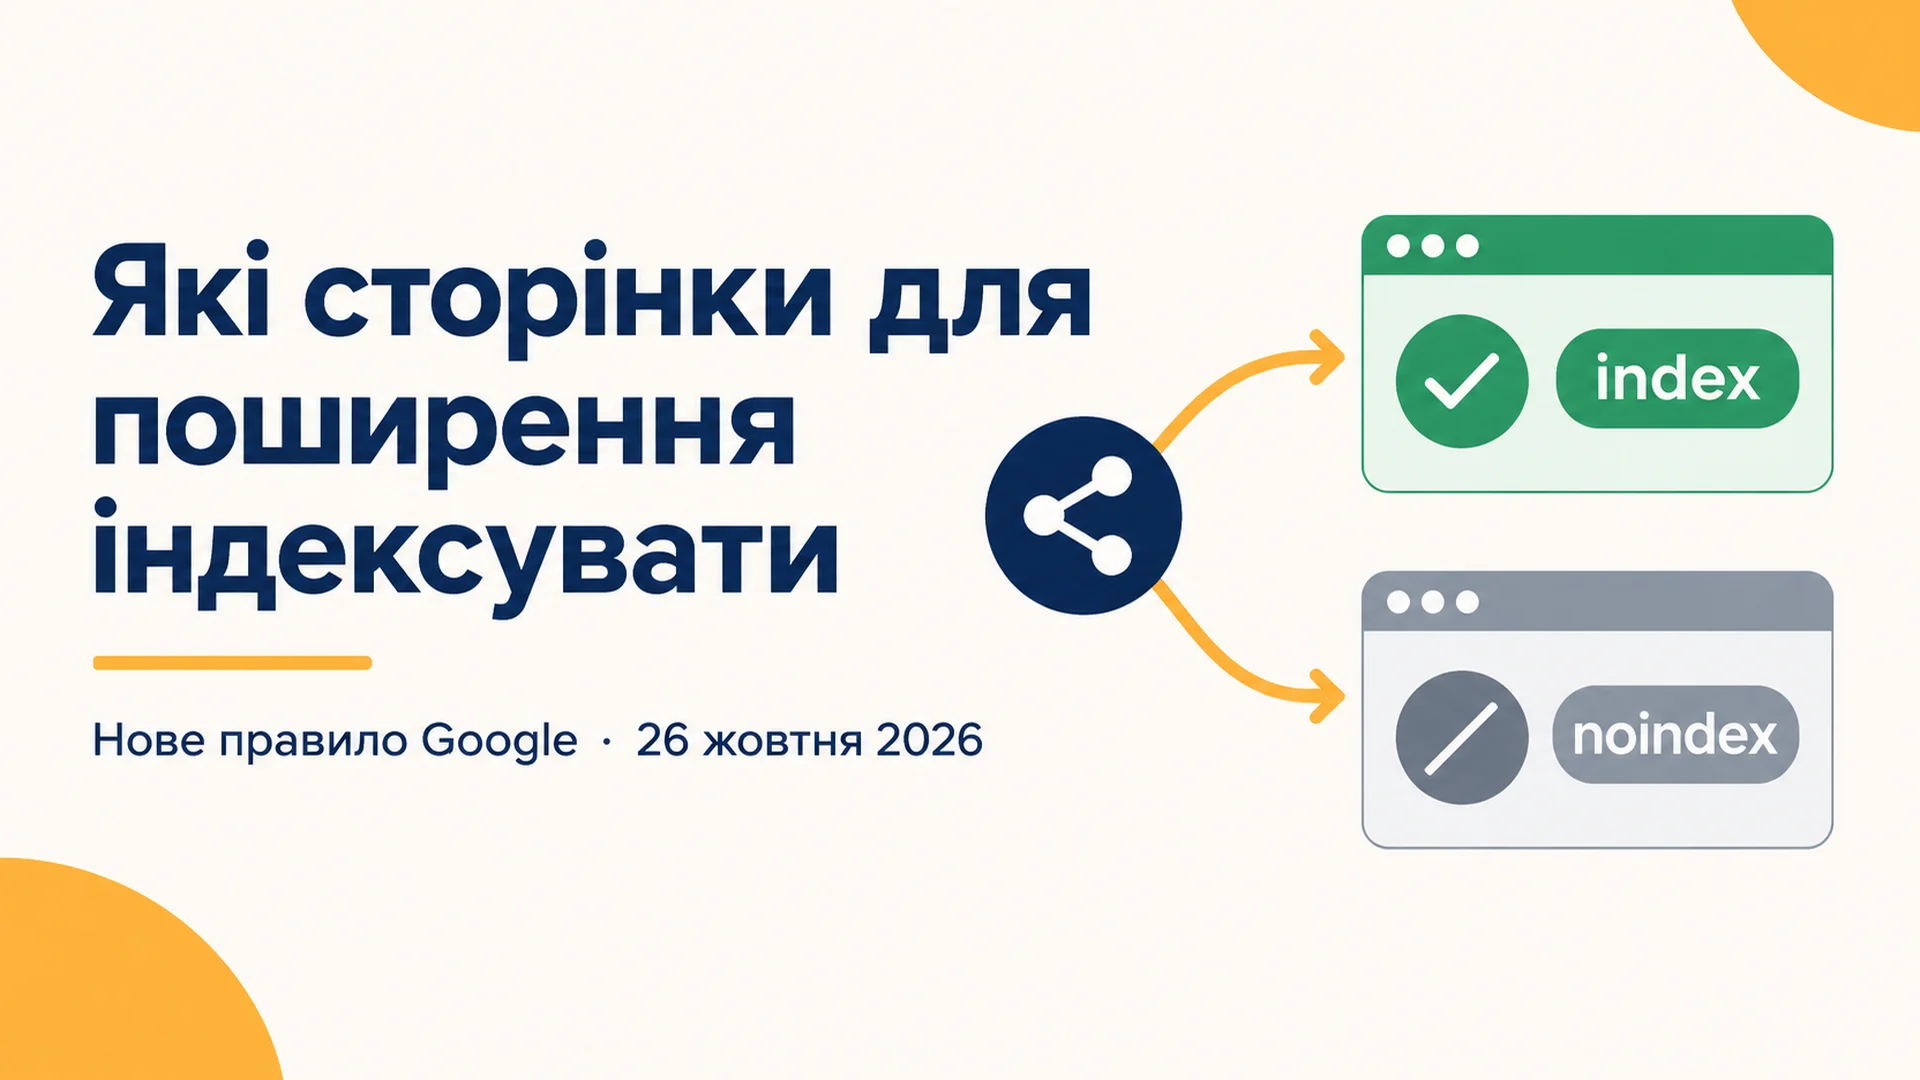
26 жовтня 2026 року Google додав до свого посібника про те, як уникати спаму, створеного користувачами, розділ на два абзаци. Це найкоротша частина сторінки і, ймовірно, та, що найбільше змінить дорожні карти продуктів, бо ставить питання, яке більшість команд ніколи не виносила на слайд: чи має цей URL бути в індексі Google?
Розділ називається "Only index content meant for Search" — індексуй лише контент, призначений для Пошуку. У перекладі це звучить так:
Якщо ваш сервіс дозволяє користувачам створювати сторінки для поширення, згенеровані результати або інтерактивні інструменти, подумайте, чи цей контент створено для того, щоб його знаходили пошукові системи, чи лише для того, щоб його відкривала безпосередньо людина з посиланням.
Коли сторінки створюються для прямого поширення, спільної роботи чи практичної користі, а не для виявлення в публічному пошуку, застосовуйте правило noindex за замовчуванням (через метатег robots або HTTP-заголовок X-Robots-Tag) або блокуйте сканування в robots.txt за замовчуванням.
Журнал змін Google того ж дня прямо говорить про намір: посібник оновлено «настановами про те, як блокувати індексацію контенту, поширеного за посиланням, і як відстежувати зловживання в Search Console», щоб платформи могли «тримати поза індексом сторінки, створені користувачами, які не призначені для Пошуку, і виявляти спам раніше».
Оце й усе. Жодної нової ручної дії, жодного анонсу системи ранжування, жодного переліку покарань. Є рекомендація щодо значення за замовчуванням — а майже всі інциденти з індексацією народжуються зі значень за замовчуванням.
Для кого це. Для команд, які публікують будь-який URL, який може створити користувач: посилання для поширення, збережені чати, публічні панелі, попередній перегляд моделей, збірки застосунків, згенеровані звіти, теми форумів, сторінки профілів, сторінки відгуків, сторінки оголошень.
Що ви отримаєте. Вердикт для кожного маршруту за кожним типом згенерованого URL, контроль, який справді прибирає сторінку з індексу, і правило моніторингу, що ловить описаний Google патерн зловживань.
Час. Від 45 до 90 хвилин на перший прохід в одному продукті. День, якщо у вас кілька генераторів URL і немає інвентаризації маршрутів.
Як виглядає «готово». Кожен згенерований маршрут позначено index, noindex або приватний. Маршрути noindex віддають директиву із сервера, а не після виконання JavaScript. Search Console показує ці URL як виключені через noindex, а не як «Проіндексовано, але заблоковано robots.txt».
Що змінилося і що лише виглядає новим
Важливі чотири зміни. Решта сторінки не зрушила, включно з настановами грудня 2025 року, які досі чинні.
Що змінив Google | Реальний текст | Чому це важливо для вас |
|---|---|---|
Обсяг посібника | Тепер називає хостингові платформи «та інструменти, які дозволяють користувачам публікувати сторінки для поширення, згенерований контент або вебзастосунки» | Буквально це охоплює експорти чатів зі штучним інтелектом, сторінки артефактів, конструктори застосунків і no-code інструменти, а не лише форуми та коментарі |
Одиниця зловживання | Спамери можуть створювати «велику кількість сторінок або сайтів» | Google говорить про обсяг, а не про хитрість. Один зловживаний акаунт може викарбувати тисячі URL |
Новий розділ | "Only index content meant for Search" | Найясніше на сьогодні твердження, що noindex — розумне значення за замовчуванням для контенту, доступного лише за посиланням |
Моніторинг | Перевірити сайт або піддомен у Search Console, стежити за стрибками в Індексації сторінок і Ефективності в пошуку, попереджати, коли «кілька користувачів» створюють «велику частину URL, які можна індексувати» | Роздуття індексу тепер має названий метод виявлення — і зазвичай саме це передує певній формі перевірки |
Що не змінилося: noindex для дописів нових користувачів, доки вони не здобудуть репутацію, і nofollow або ugc на посиланнях у ненадійному контенті. Якщо ви вже робите обидві речі, ви попереду цього оновлення.
Варто сказати прямо, бо реакція в X випередила документ: це настанови для платформ щодо їхнього власного запасу URL. Вони не створюють нового порушення для звичайного маркетингового сайту й не змінюють ранжування жодної сторінки. Вони змінюють те, що має бути в індексі.
Ще один шматок контексту пояснює час. Наприкінці липня 2026 року посилання для поширення та сторінки артефактів Claude з'явилися в індексі Google, і тогочасні матеріали описували медичні записи, API-ключі та інші приватні матеріали, що опинилися у відкритому доступі, перш ніж Anthropic закрив прогалину за кілька днів. Ті самі публікації згадували публічні URL застосунків у конструкторах на кшталт Replit і Lovable. Google рідко пише новий розділ заради гіпотези. Це вже сталося.
Питання, яке вирішує кожен згенерований URL
Тест Google вміщується в одне речення, і його можна застосувати, не вгадуючи намірів: цей контент створено для того, щоб його знаходили пошукові системи, чи лише для того, щоб його відкривала людина з посиланням?
На практиці відповідають чотири сигнали. Оцінюйте маршрут, а не окрему сторінку.
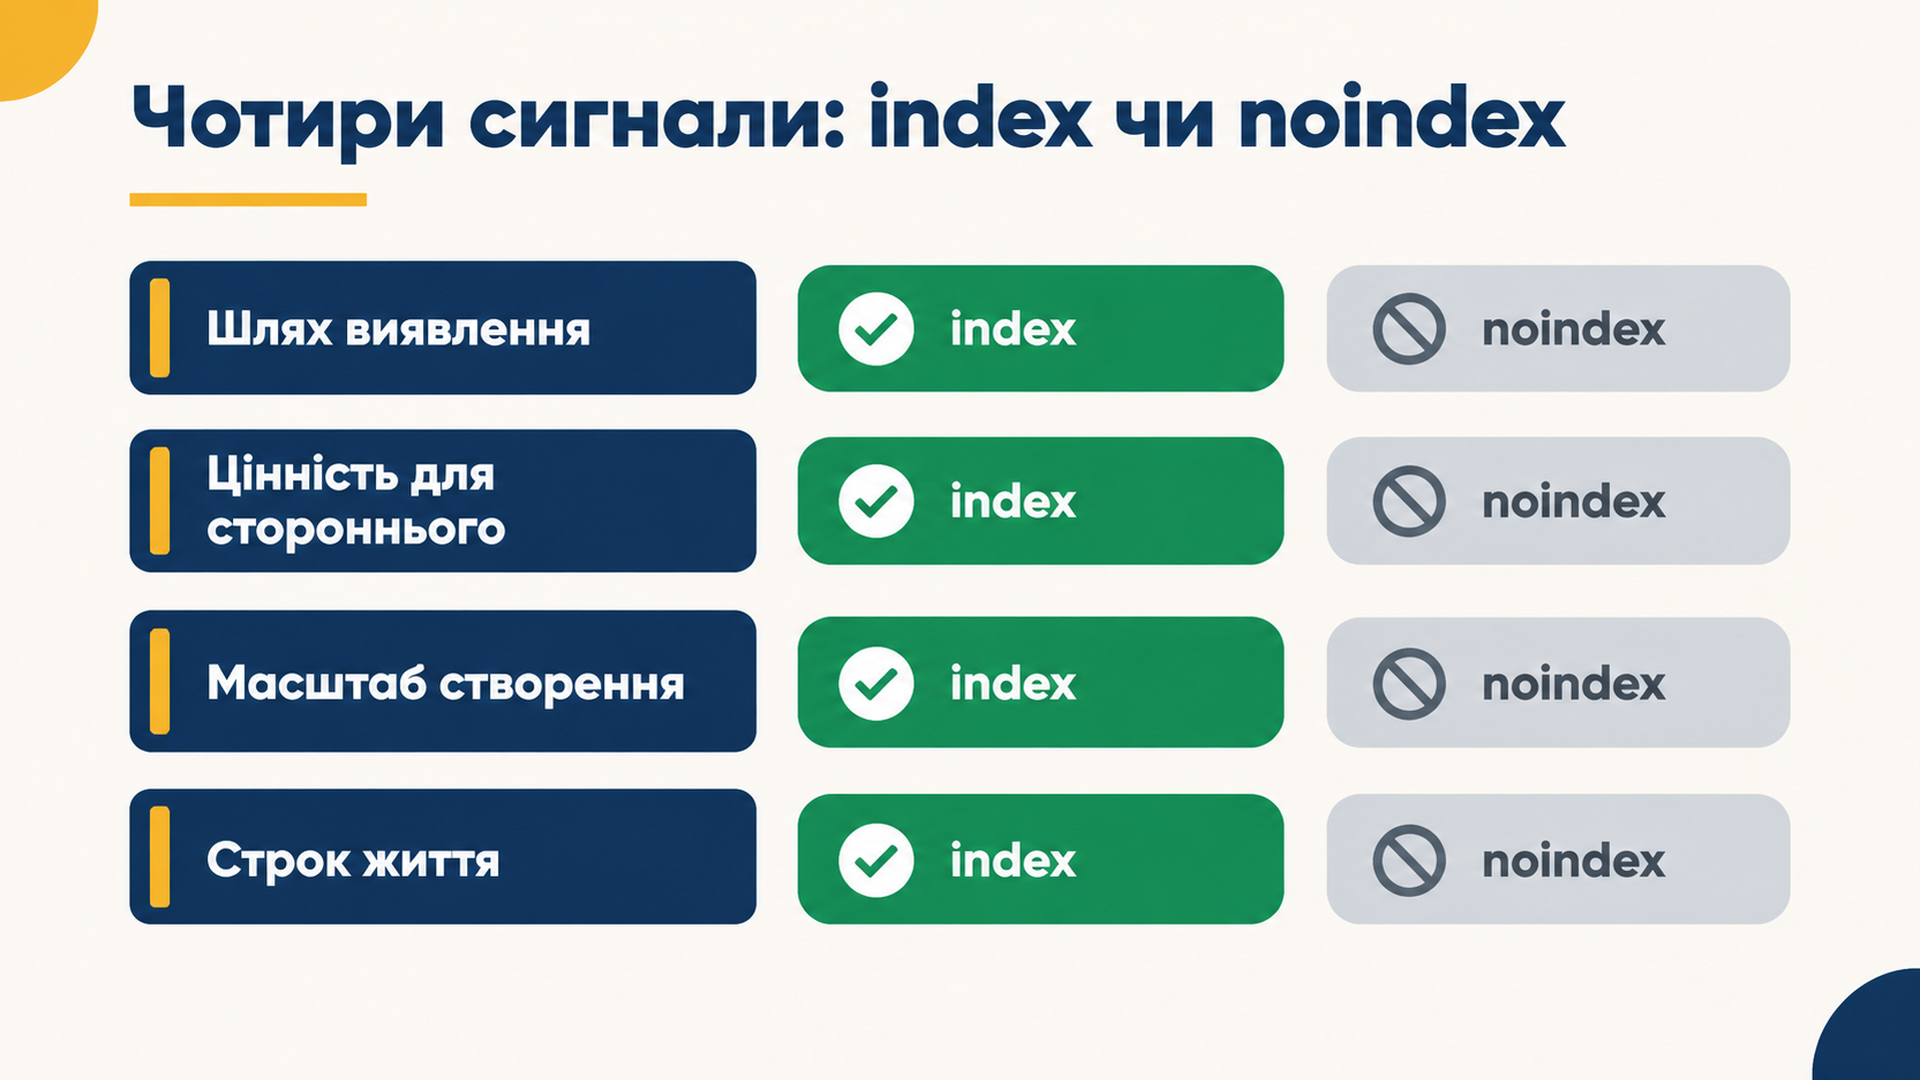
Сигнал | Схиляє до index | Схиляє до noindex |
|---|---|---|
Шлях виявлення | Посилання з публічної галереї, sitemap, сторінки категорії або профілю | Доступний лише за скопійованим посиланням або кнопкою «поділитися» |
Цінність для стороннього | Корисний без знайомства з автором | Має сенс лише для автора, його команди або одержувача |
Масштаб створення | Одна сторінка на тему або кураторський набір | Тисячі URL з одного акаунта, здебільшого майже однакові |
Строк життя | Залишається точним місяцями | Миттєвий: чат, збірка, чернетка, тимчасовий експорт |
Три з чотирьох у бік noindex — вердикт однозначний. Змішаний результат зазвичай означає, що маршрут треба розділити: публічна галерея, яку можна індексувати, і окремі результати під нею, які — ні. Цей поділ є найпоширенішою правильною відповіддю і водночас найчастіше пропущеною, бо вимагає двох шаблонів замість одного прапорця.
Корисний тест на відмову: якби сторонній побачив цей URL у результатах пошуку без контексту, чи мали б сенс заголовок і фрагмент? «Чат із Сем, 24 жовт» — ні. «Шаблон рахунку для дизайнерів-фрілансерів» — так. Відмова не про якість. Вона про те, чи сторінку створено, щоб її знаходили, чи щоб її надсилали.
Оберіть контроль, який справді прибирає URL
Саме тут можна дослухатися до нової настанови буквально і все одно зазнати невдачі. Google пропонує два варіанти в одному реченні, і вони не рівноцінні.
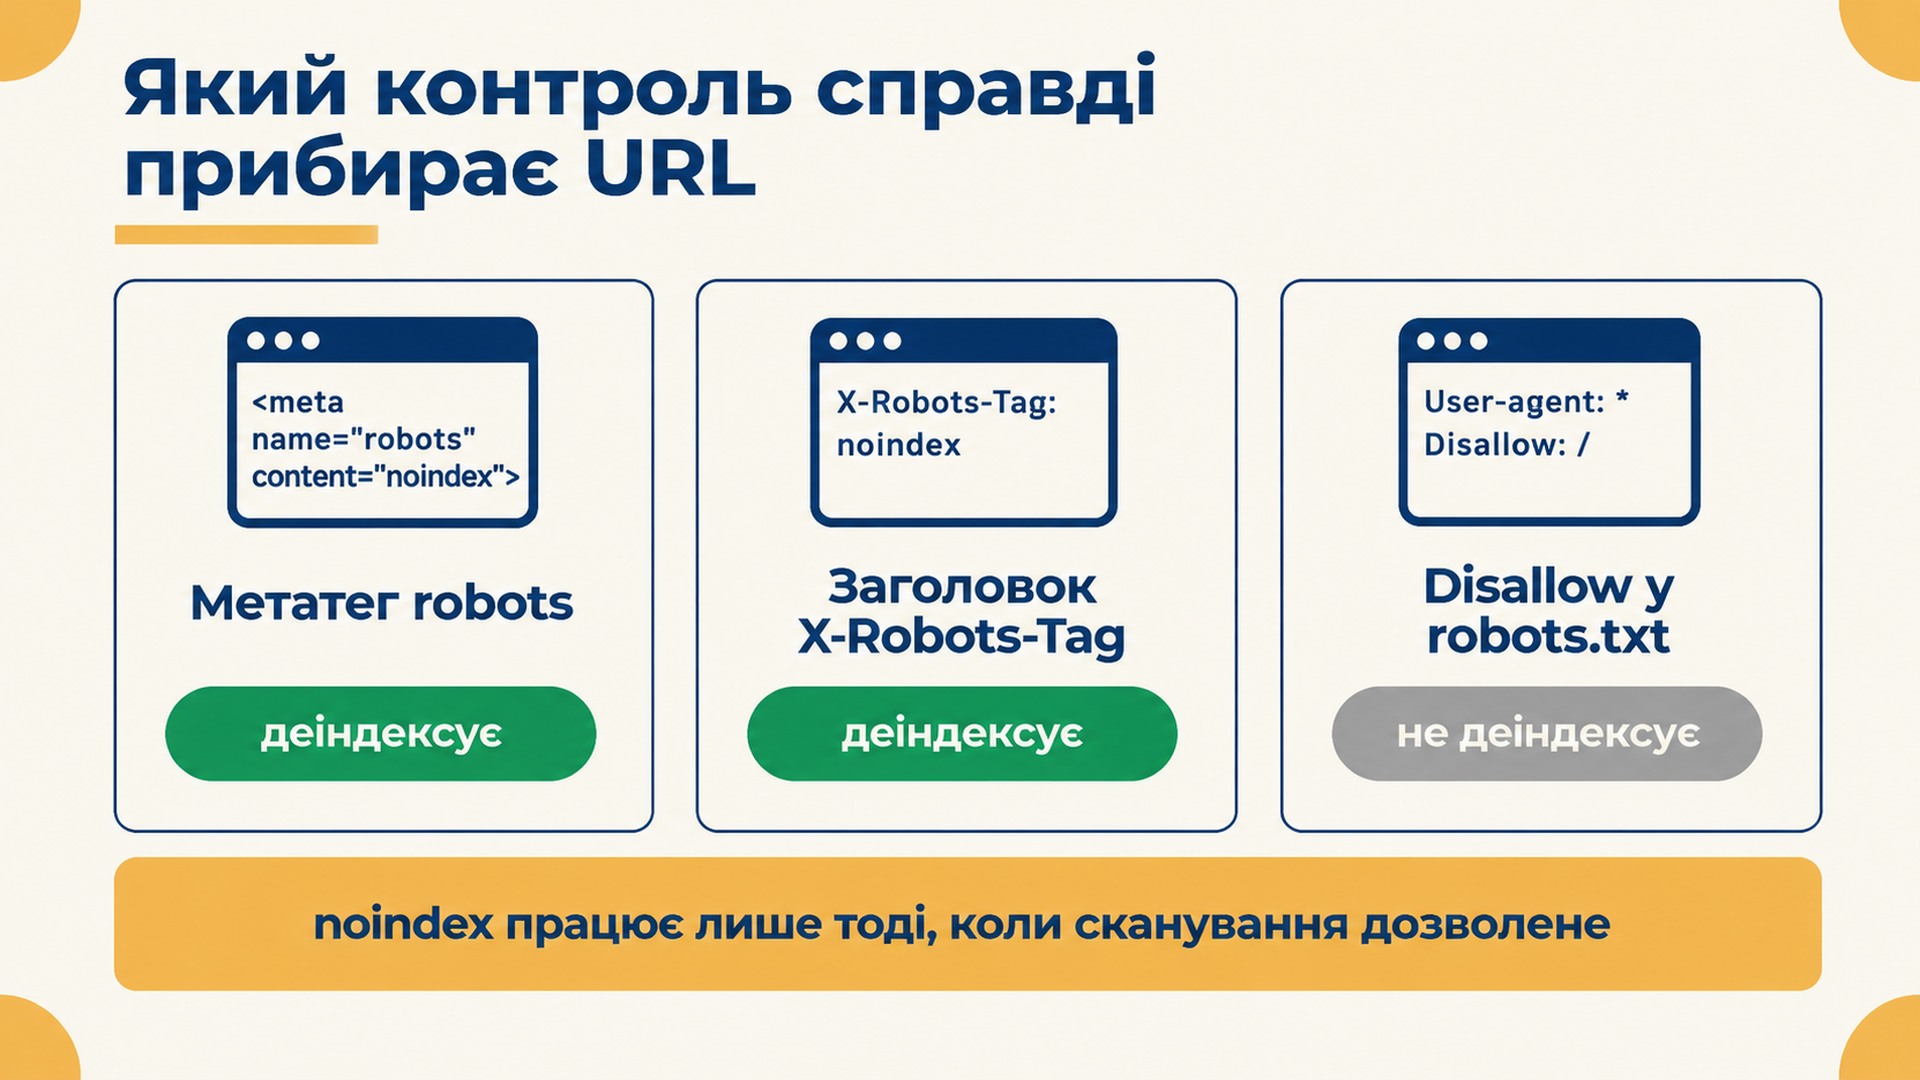
robots.txt керує скануванням. Він не прибирає URL з індексу, і Google сам це каже у вступі до robots.txt: сторінка, заблокована там, «може залишатися проіндексованою, якщо на неї посилаються інші сайти» — і в такому разі URL, а можливо й текст посилання, може з'явитися в результатах без опису.
noindex керує індексацією, але лише якщо Google може просканувати сторінку й прочитати директиву. Документація Google щодо noindex однозначна: щоб правило працювало, сторінка не повинна бути заблокована в robots.txt, бо інакше «сканер ніколи не побачить правило noindex».
З'єднайте обидва факти — і порядок стає важливим.
Контроль | Прибирає URL з індексу | Де дає збій | Для чого використовувати |
|---|---|---|---|
Заголовок відповіді | Так, після того як Google просканує й прочитає | Будь-що, заблоковане robots.txt або за логіном | Відповіді не в HTML (PDF, JSON, зображення) і правила на edge або CDN для багатьох маршрутів |
| Так, після того як Google просканує й прочитає | Теги, вставлені JavaScript після завантаження; сторінки, заблоковані robots.txt | Сторінки для поширення в HTML, відрендерені на сервері |
Disallow у | Ні | URL із посиланнями може залишитися в індексі без фрагмента | Зменшити навантаження на сканування, а не приватність |
Логін або підписаний URL | Так, унеможлививши доступ | Вимагає, щоб сторінка справді була приватною | Усе, що містить дані інших людей |
410 після завершення строку | Так, з часом | Повільніше за 404; не діє, доки URL ще відповідає | Миттєві поширення й збірки |
Один короткий шлях, якого варто уникати: X-Robots-Tag: none не є нейтральним значенням. Google трактує його як noindex плюс nofollow. Іноді це саме те, що потрібно, але команди копіюють його з конфігурації проксі, не знаючи про це.
Другий короткий шлях, якого варто уникати: теги canonical. Canonical — це підказка. Якщо сторінки не має бути в індексі, пишіть noindex.
Крок 1: інвентаризуйте маршрути, які створюють URL
Не можна класифікувати те, чого немає в списку, і більшість команд недооцінює кількість, бо думає про функції, а не про патерни маршрутів.
Відкрийте роутер або карту URL і перелічіть кожен динамічний сегмент. Звичні підозрювані виглядають так:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Потім звірте з тим, що Google уже знає, бо код та індекс розійдуться.
З sitemap. Завантажте й порахуйте:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
Друга команда дає приблизну гістограму за префіксом шляху. Якщо згенерований маршрут є у вашому sitemap, це вже помилка: sitemap — це список сторінок, які ви просите Google проіндексувати.
З Search Console. Відкрийте звіт про Індексацію сторінок, відфільтруйте за префіксом URL для кожного маршруту-кандидата й запишіть цифри. Це єдине джерело, яке каже, що Google насправді зробив із цими URL.
З логів сервера. Згрупуйте запити Googlebot за префіксом:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Очікуваний результат. Список патернів маршрутів із кількістю URL поруч, узятий щонайменше з двох джерел.
Перевірка якості. Кожен маршрут, який може віддати 200 відвідувачу поза командою, має бути в списку. Якщо цифри з sitemap і Search Console різняться більш ніж на кілька відсотків за одним префіксом, з'ясуйте чому, перш ніж щось змінювати.
Якщо нічого не знайшли. Ймовірно, у вас клієнтський роутер. Шукайте визначення маршрутів у фронтенді, а не в бекенді, і подивіться вкладку мережі на справжньому посиланні для поширення.
Крок 2: класифікуйте кожен маршрут у таблиці, а не на нараді
Запишіть вердикт туди, де його можна переглянути. Достатньо одного рядка на патерн маршруту.
Маршрут | Хто створює | Шлях виявлення | Цінність для стороннього | Вердикт | Контроль | Відповідальний |
|---|---|---|---|---|---|---|
| Будь-який користувач | Лише посилання | Немає | noindex | Заголовок | Платформа |
| Кураторство | Внутрішні посилання, sitemap | Висока | index | Немає | Контент |
| Будь-який користувач | Посилання з профілів | Низька, доки неактивний | noindex до появи репутації | Мета | Довіра й безпека |
| Будь-який користувач | Лише посилання | Немає | noindex | Заголовок | Платформа |
| Редактори | Sitemap | Висока | index | Немає | Контент |
Таблиця працює, лише якщо правдиві три речі.
Одна відповідальна особа на рядок. Нечітке володіння — причина, чому згенеровані маршрути залишаються індексованими роками.
Запишіть контроль поруч із вердиктом, а не після нього. «noindex» не є рішенням, доки хтось не знає, чи це заголовок, зміна шаблону чи правило CDN.
Занотуйте виняток. Якщо маршрут noindex, але невелика підмножина має бути публічною, запишіть умову цієї підмножини зараз. Вирізати її через пів року — це шлях, яким правило noindex зрештою знімають повністю, тихо.
Крок 3: впровадьте контроль на рівні шаблону
Виправлення сторінка за сторінкою не переживають наступного розгортання. Застосуйте контроль там, де рендериться маршрут.
Для HTML-сторінок поставте тег у head, відрендерений на сервері. В App Router Next.js це metadata; в Astro — head макета; у Rails чи Django — шаблон макета. Точний синтаксис менш важливий за місце: він має бути в HTML, який отримує Google, а не доданий ефектом на клієнті.
<meta name="robots" content="noindex">Для всього, що не є HTML, метатега немає, тож використовуйте заголовок:
X-Robots-Tag: noindexЦе охоплює експорти PDF, відповіді JSON, згенеровані зображення й завантаження CSV. Якщо ці файли віддає CDN, задайте заголовок на edge, щоб нові маршрути успадкували правило.
Для цілої родини маршрутів правило проміжного шару зазвичай чистіше, ніж чіпати кожен шаблон:
// Приклад для Express: noindex на всіх згенерованих URL для поширення
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Очікуваний результат. Розгортання, у якому кожен маршрут, позначений noindex, віддає директиву в першому байті для анонімних запитів.
Перевірка якості. Виконайте curl -sI для опублікованого URL. Ви маєте побачити x-robots-tag: noindex у заголовках відповіді, а curl -s має показати метатег у вихідному коді, до запуску будь-якого скрипта.
Шлях відновлення. Якщо тег з'являється лише після виконання JavaScript, перенесіть його в серверний рендеринг. Якщо фреймворк не рендерить head-теги для кожного маршруту, використовуйте заголовок. Не публікуйте noindex, вставлений через JS, і не припускайте, що він працює: Google описує поведінку відрендереного noindex як невизначену.
Ще дві речі належать до того самого pull request. Приберіть маршрути noindex із sitemap, бо надсилати URL, який ви не хочете індексувати, — це суперечність, яку Google вирішує на свою користь. І додайте правило завершення строку: коли посилання для поширення вмирає, віддавайте 410 замість того, щоб тримати сторінку 200 із порожнім станом.
Крок 4: переконайтеся, що Googlebot бачить директиву
Ніщо з переліченого не перевірено, доки ви не перевірите це так, як перевіряє Google.
Спочатку подивіться заголовки відповіді:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagПотім початковий HTML, до того як будь-який скрипт встиг запуститися:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Нарешті переконайтеся, що robots.txt не блокує шлях. Якщо блокує, Google ніколи не просканує сторінку й ніколи не прочитає директиву:
curl -s https://example.com/robots.txtSearch Console — остаточна перевірка. Запросіть перевірку URL у «Перевірці URL» і прочитайте вердикт.
Правильний результат — «Сторінку не проіндексовано: виключено тегом 'noindex'». Результат, який показує, що ви потрапили в пастку, — «Проіндексовано, але заблоковано robots.txt»: Google має URL, не може прочитати директиву й може продовжувати її показувати. Якщо це з'явилося, приберіть правило з robots.txt і дайте noindex зробити свою роботу.
Ви також можете отримати сторінку такою, як її бачить Googlebot, за допомогою симулятора сканера. Це швидше, ніж чекати нового сканування, коли перевіряєте двадцять маршрутів: Googlebot Spider Simulator.
Очікуваний результат. Кожен маршрут noindex показує статус виключення через noindex через кілька днів після наступного сканування. Маршрути, створені після зміни, взагалі не мають з'являтися в індексі.
Шлях відновлення. Якщо URL усе ще індексується через два тижні, перевірте, чи Google може його сканувати, чи сторінка віддає 200 для Googlebot і чи якийсь тег canonical або hreflang не скеровує пошукові системи в інше місце. Використовуйте інструмент «Видалення» лише як тимчасове блокування, поки виправляєте причину; він не замінює директиву.
Коли сторінка для поширення — це канал зростання
Деякі згенеровані сторінки справді мають бути проіндексовані, і noindex на все — це постріл у власну ногу. Ось ті, які варто захищати:
Патерн | Чому заслуговує на індекс | Запобіжник |
|---|---|---|
Публічні галереї шаблонів | Користувачі публікують дизайн, інші його використовують; результат унікальний і тривкий | Модерувати нові подання |
Конструктори з публічними вітринними сторінками | Реальний результат із відміткою «built with» — це канал дистрибуції | Тримати вітринний шаблон окремо від маркетингової сторінки |
Документація, що виростає з користувацьких тем | Питання, яке повторюється, заслуговує на постійну й відредаговану відповідь | Індексувати кураторську відповідь, а не сиру розмову |
Якщо ви в одній із цих категорій, старіша настанова Google досі чинна і є найкращим важелем: noindex на контенті користувачів без репутації, а потім відкриття, коли в акаунта є історія. Це дає стійкість до спаму, не відмовляючись від циклу залучення, і саме цей патерн посібник рекомендував до цього оновлення.
Тест для всіх трьох однаковий. Якщо сторінка отримує покази в Ефективності в пошуку за запитами, які ввів би сторонній, вона належить індексу. Якщо покази приходять лише від власного рядка URL і нізвідки більше — не належить.
Є ефект другого порядку, який варто назвати. Публічні URL для поширення роками були дешевою поверхнею для посилань: створити сторінку на платформі з сильним доменом, поставити посилання на власний сайт, повторити у двадцяти властивостях. Патрік Стокс нарахував понад 20 посилань із різних платформ у тій самій гілці. Якщо платформи дослухаються до настанови, ця поверхня звузиться. Якщо ні, у Google тепер є документ, на який можна послатися наступного разу, коли він вирішить, що ті сторінки — спам.
Крок 5: інструментуйте патерн, який описав Google
Розділ про моніторинг — це та частина оновлення, яку більшість команд пропустить, і саме вона ловить реальний інцидент до того, як він стане ручною дією.
Чотири перевірки, кожна з місцем, куди дивитися.
Властивість у Search Console. Перевірте сайт або піддомен, щоб попередження про ручні дії та безпеку надходили електронною поштою. Якщо ви керуєте платформою з піддоменами для кожного орендаря, перевірте батьківський і щонайменше вибірку дочірніх; попередження, яке нікуди не надходить, — це не моніторинг.
Тренд індексації сторінок. Зафіксуйте сьогодні базову лінію проіндексованих URL на кожен згенерований маршрут і стежте за східчастими змінами, а не за шумом. Подвоєння кількості проіндексованих URL за тиждень на маршруті, який має бути статичним, — це сигнал.
Аномалії в Ефективності в пошуку. Фільтруйте за запитами, не пов'язаними з продуктом. Спам-сторінки притягують спам-запити задовго до того, як хтось поскаржиться.
Співвідношення створення й індексації. Це метрика, яку називає Google і яку майже ніхто не міряє: скільки URL, які можна індексувати, здатен створити один акаунт за день і яка частка нових таких URL надходить від 1% найпродуктивніших акаунтів. Початкове попередження на рівні 3 медіан останніх семи днів для акаунта — довільне, але працює; налаштуйте під свій трафік.
Те саме співвідношення годиться як запобіжник продукту. Якщо функція дозволяє користувачу генерувати тисячу URL для індексації на день, це функція роздуття індексу, навіть якщо ніхто ще не зловживає нею.
Що оновлення насправді каже
Приберіть формулювання — і Google сперечається про пропозицію.
Двадцять років політика щодо спаму описувала сторінки: тонкі, зіскребені, замасковані, забиті ключовими словами. Ці категорії припускають, що людина або скрипт вирішує створити сторінку, а Google вирішує, чи заслуговує вона ранжування. Згенеровані результати ламають цю модель. Одне продуктове рішення може створити мільйон URL, усі технічно унікальні, усі технічно 200, більшість без цінності для тих, хто їх не створював. Google не може оцінити їх по одній і перестав вдавати, що може.
Реакція розділилася на два табори. Перший прочитав це як попереджувальний постріл: Марі Гейнс запитала, чи будуть нові ручні дії для інструментів штучного інтелекту й конструкторів застосунків, а Лілі Рей сприйняла розділ як знак того, з чим Google уже бореться в масштабі, посилаючись на артефакти Claude, сторінки для поширення ChatGPT і дописи в соцмережах. Другий знизав плечима. Уважні команди роками ставлять звіти, згенеровані користувачами, у noindex, аргументували кілька відповідей, і власні згенеровані сторінки Google — більша проблема. Обидва прочитання можуть бути правдивими. Настанову робить доречною не новизна поради, а те, що вона тепер записана там, куди можна послатися під час застосування політики.
Тож настанова переносить рішення вище в ланцюжку. Від платформ очікують рішення на рівні шаблону: чи клас URL належить індексу. Це питання управління, а не SEO, і саме тому порада в посібнику зі спаму, а не в документації про індексацію.
Для пошуку зі штучним інтелектом та сама логіка працює в обидва боки. Функції ШІ Google беруть із індексу Google, тож директива noindex прибирає сторінку і з пулу, і із синіх посилань. Якщо згенерована сторінка набирала цитування в AI Overviews, чекайте, що це припиниться. Для посилання для поширення це зазвичай правильно, для сторінки шаблону — ні. Інші сканери ШІ мають власні правила, тож окремо вирішіть, яким із них дозволити сканувати ці сторінки.
Практичний висновок — одне речення, яке можна принести на ревʼю дизайну: кожен URL, який може створити користувач, — це або продуктова поверхня, або зобов'язання перед індексом, і шаблон вирішує, що саме.
Поширені запитання
Чи стосується це звичайного маркетингового сайту?
Ні, якщо ваш сайт не генерує URL із введення користувача. Маркетинговий сайт публікує набір сторінок, про які людина вирішила, що вони мають існувати, — протилежність проблемі, яку описує посібник. Рядок про обсяг називає хостингові платформи та інструменти, які дозволяють користувачам публікувати сторінки для поширення, згенерований контент або вебзастосунки. Якщо у вас є коментарі, форум або профілі учасників, діє старіша настанова: nofollow або ugc на посиланнях ненадійних акаунтів і noindex для нових користувачів, доки вони не збудують репутацію.
Використовувати robots.txt чи тег noindex?
noindex, і лише одне з двох на маршрут. Речення Google перелічує обидва варіанти, але вони роблять різні речі. Disallow у robots.txt блокує сканування, і URL, заблокований, але з посиланнями ззовні, може залишитися в результатах без фрагмента. noindex працює лише тоді, коли Google може просканувати сторінку й прочитати її. На практиці це означає метатег або заголовок відповіді й ніколи — правило robots.txt на тому самому шляху.
Чи втрачу я трафік, поставивши noindex на сторінки для поширення?
Перевірте маршрут до рішення, а не після. Якщо сторінка отримує покази лише від власного рядка URL, вона не приносить органічного трафіку, і прибрати її нічого не коштує. Патерн, який втрачає трафік, — це коли разом із публічною галереєю зноситься й те, що всередині неї. Залиште галерею індексованою, поставте noindex на те, що за нею, і відстежуйте ефективність у пошуку для запитів галереї до і після.
Чи поважають пошукові системи зі штучним інтелектом noindex?
Функції ШІ Google — так, бо AI Overviews і AI Mode беруть із того самого індексу, тож директива прибирає сторінку і з синіх посилань, і з відповідей ШІ. Інші сканери ШІ — окреме рішення. Поведінка постачальників різниться й змінюється без журналу змін, тож читайте документацію кожного сканера й отримуйте сторінку з його user agent, а не припускайте, що одна директива покриває всіх.
Авторка: Ґрейс Міллер, аналітикиня ризиків AI Search в Auspia. Відстежує понад 200 змін політик. Пише про правила платформ, ризики контенту й оптимізацію з урахуванням політик.