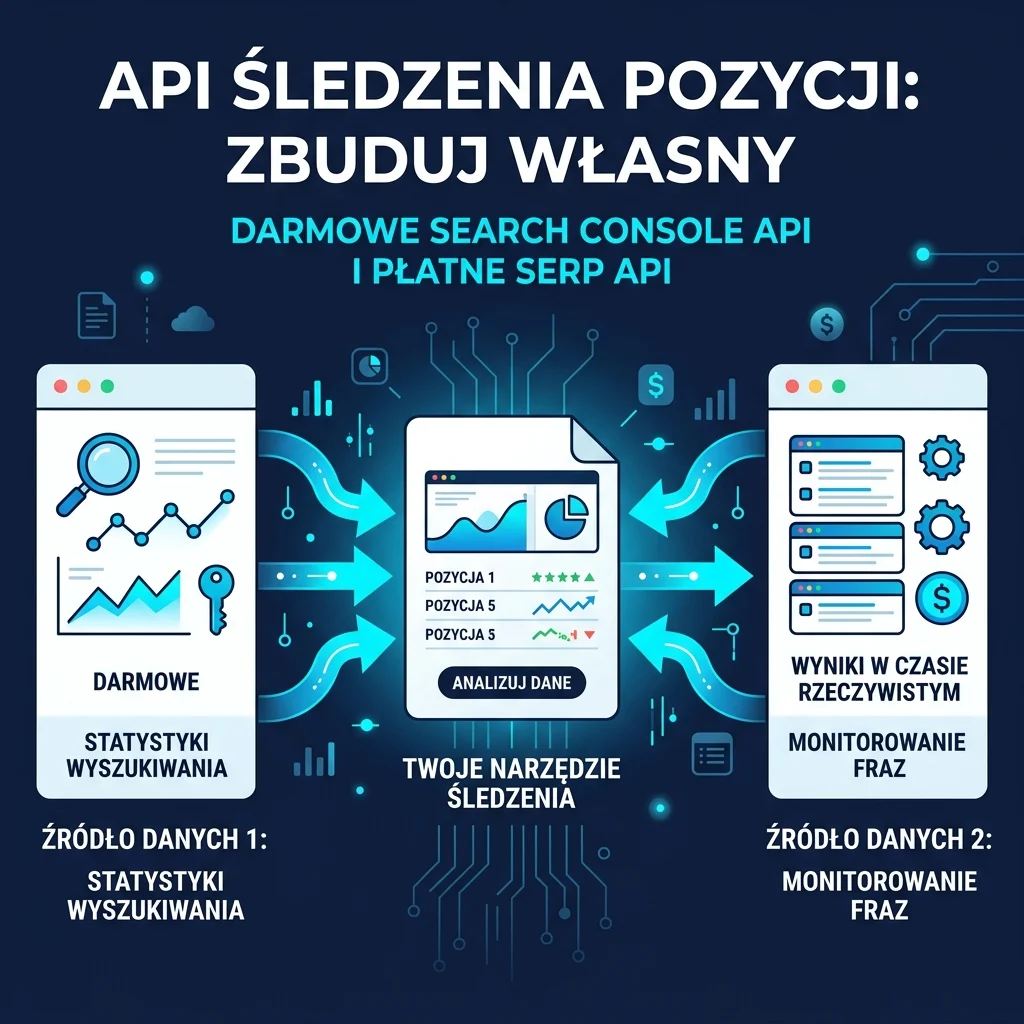
API do śledzenia pozycji to nie jedna rzecz. Deweloper szukający „rank tracking API" zwykle chce jednego punktu końcowego zwracającego pozycje, a rynek odpowiada listami dostawców. Uczciwa odpowiedź brzmi: potrzebne są dwa źródła i odpowiadają one na różne pytania.
Search Console API jest darmowe, oficjalne i na zawsze ograniczone do usług, które możesz zweryfikować. SERP API jest płatne, nieoficjalne i potrafi sprawdzić dowolne słowo kluczowe w dowolnym miejscu, także takie, na które nigdy się nie pozycjonowałeś. Żadne z nich osobno nie jest trackerem pozycji. Razem to około 120 linii Pythona i jeden wiersz crona.
Oto jak to złożyć. Zakłada, że umiesz uruchomić skrypt i zapisać plik. Nie zakłada, że chcesz budować produkt.
Co będziesz mieć na końcu
Dla kogo: dla dewelopera albo technicznego marketera, który ma już dostęp do Search Console i chce pozycji według harmonogramu, nie płacąc za stanowisko.
Co będzie gotowe po zakończeniu: dwie działające funkcje pobierające, jeden scalony plik wyjściowy na każde uruchomienie i reguła porównania, która nie pozwala liczbom kłamać.
Czas: około 90 minut na pierwsze złożenie, potem mniej więcej 10 minut przeglądu na każde uruchomienie.
Jak wygląda gotowe: datowany plik JSON z twoimi pozycjami według zapytań i urządzeń, do tego świeże zrzuty SERP dla zamrożonej listy słów kluczowych i krótki diff wobec poprzedniego uruchomienia.
Zanim zaczniesz: co każde źródło potrafi, a czego nie
Podziel to dobrze, a reszta składania będzie mechaniczna. Podziel źle, a spędzisz miesiąc na czymś albo bezużytecznym, albo drogim.
Search Console API | SERP API | |
|---|---|---|
Czyje pozycje | Tylko twoje zweryfikowane usługi | Każdego, w tym konkurenci |
Słowa kluczowe | Zapytania, na które już się wyświetlasz | Dowolne słowo kluczowe, które wpiszesz |
Koszt | Bezpłatnie | Opłata za zapytanie |
Podział na urządzenia | Jest, jako wymiar | Jest, na zapytanie |
Lokalizacja | Kraje, w których się pozycjonujesz | Każda lokalizacja wspierana przez dostawcę |
Typ danych | Zagregowane kliknięcia, wyświetlenia, pozycja | Strona wyników w danym momencie |
Głębokość historii | Żądany zakres | Tylko od dnia, w którym zacząłeś zapisywać |
Status oficjalny | Dane samego Google | Odczyt publicznej strony przez firmę trzecią |
Oba źródła będą się rozchodzić i ta rozbieżność to informacja, nie błąd. Search Console uśrednia każde wyświetlenie w zakresie dat i po wszystkich urządzeniach. Pobranie SERP to jedna strona wyników w jednej chwili. Jeśli porównasz je wprost, będziesz gonić za widmowymi spadkami. Właśnie dlatego krok piąty definiuje regułę porównania.
Trzy liczby warte poznania przed pisaniem kodu. Search Console API przyjmuje limit od 1 do 25 000 wierszy na żądanie, domyślnie 1000, więc średniej wielkości witryna może pobrać trzy miesiące danych o zapytaniach i urządzeniach jednym wywołaniem. Pozwala na 1200 zapytań na minutę na witrynę i na użytkownika. Stosuje też limity obciążenia mierzone dziesięciominutowymi oknami, gdzie długi zakres dat kosztuje więcej niż krótki — dokładnie dlatego wytyczne samego Google mówią, by unikać ponownego odpytowania tych samych danych.
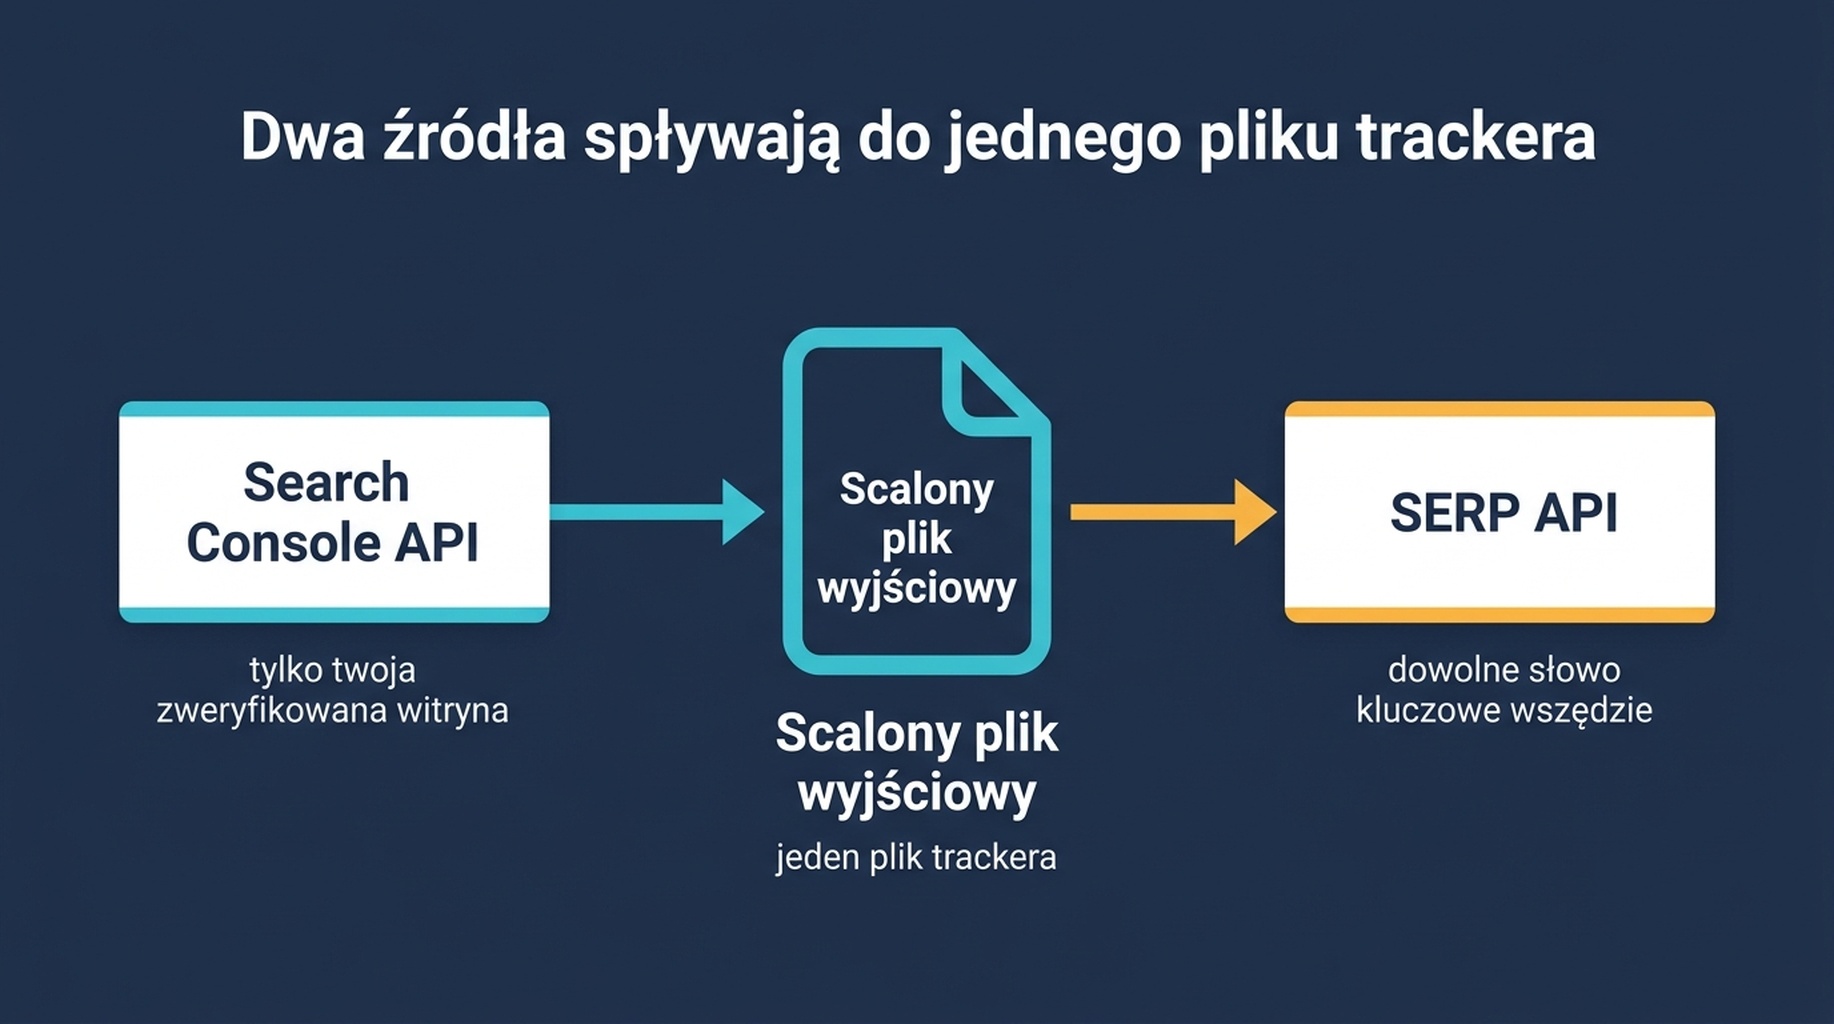
Dwa źródła, jedno wyjście. Search Console odpowiada „gdzie się wyświetlam", SERP API odpowiada „jak wygląda strona".
Krok 1: zamroź zestaw słów kluczowych przed pisaniem kodu
Tracker, który przy każdym uruchomieniu pobiera inną listę słów kluczowych, nie potrafi odpowiedzieć, czy coś się zmieniło. Najpierw wybierz listę i trzymaj ją przez kwartał.
Są trzy grupy i pochodzą z różnych miejsc.
- Z Search Console: każde zapytanie z co najmniej 20 wyświetleniami w ostatnich 90 dniach. Nie wybierasz ich ty; wybierają je twoje wyświetlenia. To grupa, w której ruch coś znaczy, bo stoi za nią popyt.
- Z biznesu: dziesięć do dwudziestu zapytań odpowiadających przychodowi, niezależnie od tego, czy się na nie pozycjonujesz.
- Od konkurencji: zapytania, na które pozycjonuje się konkurent, a ty nie. Wymagają SERP API, bo Search Console nigdy ich nie pokaże.
Zapisz listę do pliku, prowadź jej wersje i traktuj dopisania jako świadomą zmianę, a nie dryf.
Krok 2: pobierz własne pozycje za darmo
Ta połowa jest oficjalna, bezpłatna i daje podział na urządzenia oraz dane o kliknięciach, których nie ma żadne SERP API.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
Dwa szczegóły w tym żądaniu robią prawie całą robotę.
dataState: "final" wyklucza świeże dane, które Google może jeszcze zrewidować. Bez tego ostatnie dwa–trzy dni skaczą między uruchomieniami, a twój diff pokazuje ruchy, których nie było.
dimensions: ["query", "device"] to to, co czyni wyjście użytecznym później. Dodanie urządzenia teraz nic nie kosztuje. Ponowne pobranie trzech miesięcy historii później kosztuje pełne uruchomienie i nie daje nic za dni, które już pominąłeś.
Oczekiwane wyjście: jeden wiersz na zapytanie i urządzenie, z kliknięciami, wyświetleniami, CTR i średnią pozycją.
Kontrola jakości: liczba wierszy powinna być mniejsza niż 25 000. Jeśli wynosi dokładnie 25 000, zostałeś ucięty i potrzebne jest drugie wywołanie z startRow: 25000.
Jeśli się nie uda: 403 zwykle oznacza, że e-mail konta usługi nigdy nie został dodany do usługi jako użytkownik. Dodaj go w Search Console, odczekaj kilka minut, spróbuj ponownie.
Krok 3: pobierz SERP-y, których nie widzisz w swoich danych
Druga połowa obejmuje wszystko, czego Search Console strukturalnie nie potrafi. To najmniejsze działające wywołanie.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
Ustaw `depth` na 100, nie na 200. Sprawdziliśmy to we wrześniu 2026, żądając 200 wyników dla sześciu zapytań. Google zwracał od 83 do 128 wyników organicznych i przestawał, a najgłębsza pozycja w całym teście wyniosła 142. Pełny test tutaj. Żądanie 200 nie daje 200 wyników, a w zależności od dostawcy żądana głębokość i tak może zostać zafakturowana. Żądaj 100, a prawie zawsze dostaniesz wszystko, co istnieje.
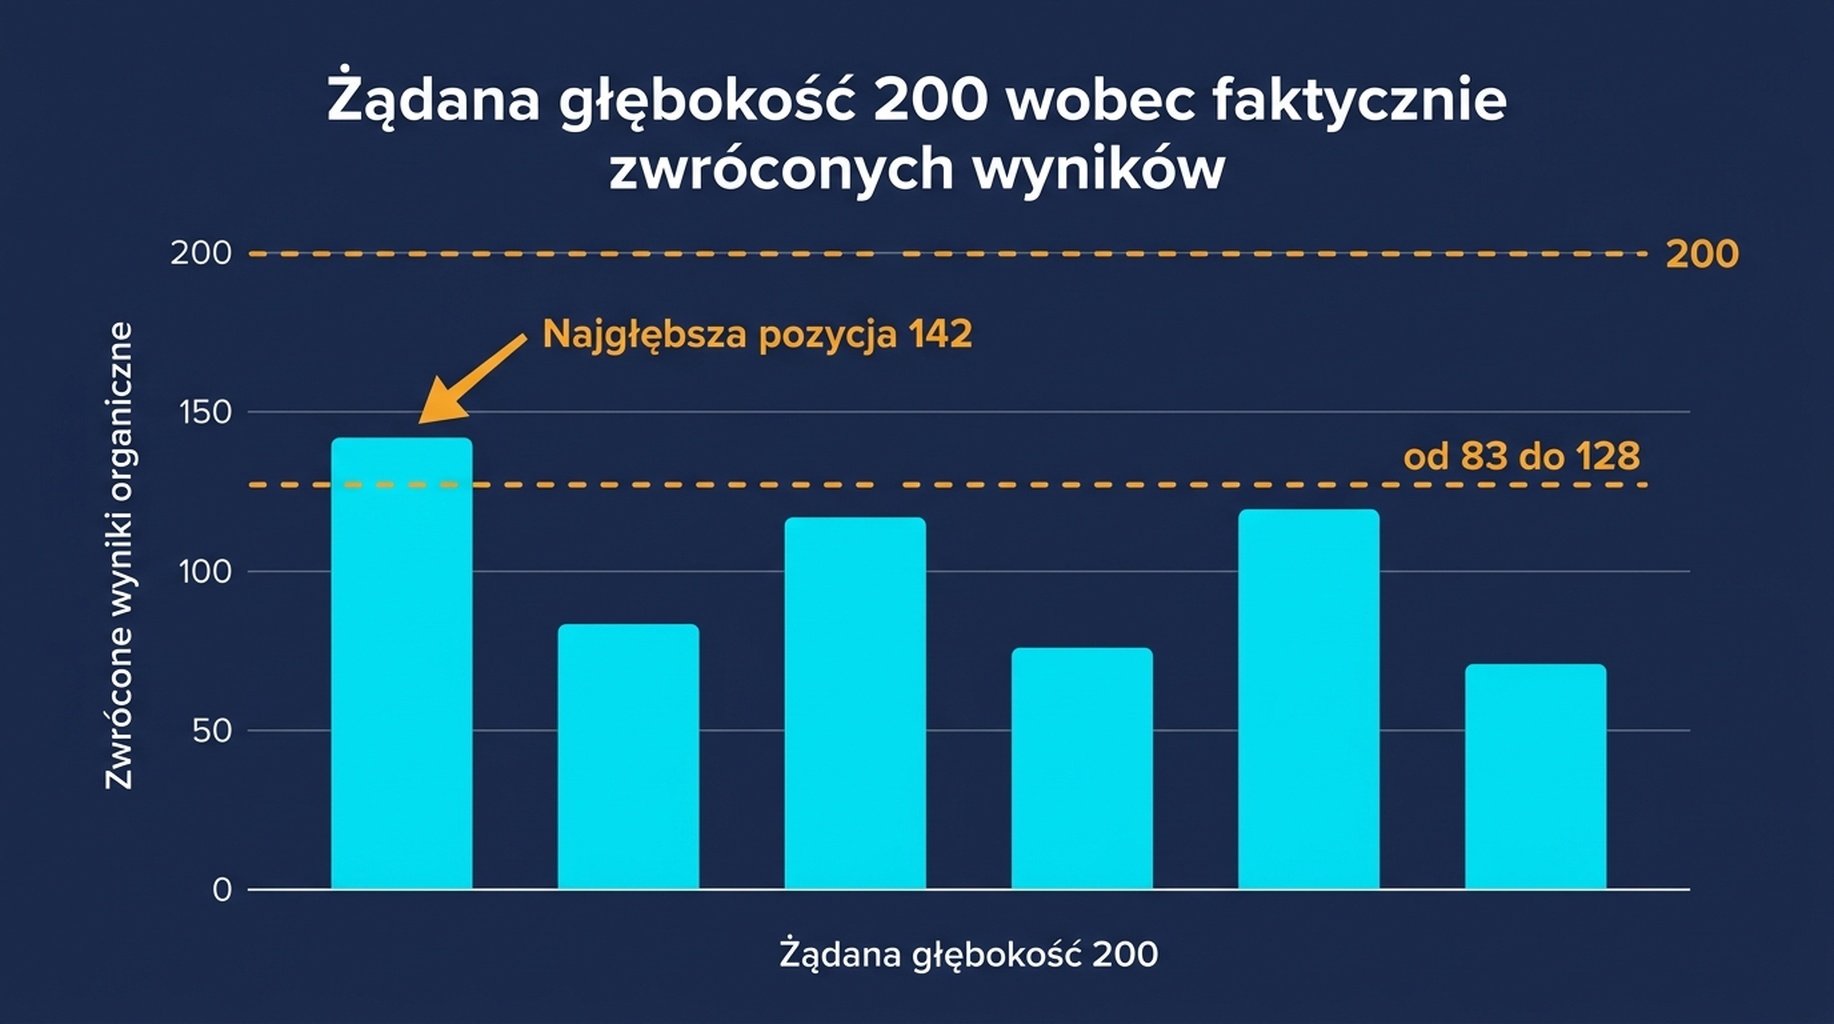
Żądamy 200 wyników, dostajemy od 83 do 128. Głębokość powyżej około 140 nie kupuje niczego przy większości komercyjnych zapytań.
Oczekiwane wyjście: ładunek JSON z elementami organicznymi zawierającymi pozycję, adres URL, tytuł i domenę.
Kontrola jakości: sprawdź, czy ładunek zawiera typ elementu ai_overview, gdy występuje. Wyciągając tylko elementy organic, przegapisz powód, dla którego strona traci kliknięcia, zachowując pozycję.
Jeśli się nie uda: 401 to błąd base64 albo danych uwierzytelniających. Kod w rodzaju 40200 oznacza, że saldo konta jest puste, i to najczęstsza porażka pierwszego miesiąca.
Krok 4: zapisuj surowy ładunek, nie podsumowanie
To decyzja, której pominięcia ludzie żałują.
Zapisywanie tabeli pozycji działa, dopóki nie musisz zadać pytania, którego nie przewidziałeś: czy wyniki się wydłużyły, czy wideo wszystko zajęło, czy wszedł konkurent, czy nad zgięciem pojawił się AI Overview. Podsumowanie tego nie odpowie. Surowy ładunek odpowie, przy zerowym dodatkowym koszcie.
Praktyczna wersja: zapisuj jeden plik na uruchomienie, nazwany datą i godziną, zawierający scalone wyjście. Trzymaj ostatnie 90 dni. To dość mało, by mieszkać w repozytorium, i dość pełne, by odpowiadać na stare pytania od nowa.
Krok 5: napisz regułę porównania, zanim cokolwiek zaplanujesz
Tracker porównujący ostatnie uruchomienie z bieżącym przez większość dni generuje fałszywy alarm. Nasze własne liczby pokazują dlaczego: na 124 zapytaniach z co najmniej 30 wyświetleniami średnie zapytanie przesuwało się o 4,57 pozycji dzień do dnia. Spadek o cztery pozycje to wtorek.
Reguła potrzebuje więc progu i kierunku.
Zgłaszaj zapytanie tylko gdy:
  - bezwzględna zmiana pozycji wobec poprzedniego uruchomienia wynosi 5 lub więcej, ORAZ
  - zapytanie miało co najmniej 20 wyświetleń w oknie porównania, ORAZ
  - zmiany nie tłumaczy przesunięcie w składzie urządzeń

Grupuj wyjście według klasy zapytania: money, comparison, brand, informational.
Nie proponuj poprawek.
Zastrzeżenie o urządzeniach to nie ozdoba. To samo zapytanie może stać o 11 pozycji inaczej na telefonie i na desktopie, a jeśli skład urządzeń przesunie się między uruchomieniami, mieszana liczba też się przesunie. Zmierzyliśmy to osobno i to dość, by podrobić trend.
Ile to kosztuje
Ceny dostawców się zmieniają, więc zbuduj model, a nie gonitwę za ofertą.
- Jedno słowo kluczowe sprawdzane raz dziennie przez 30 dni to 30 zapytań miesięcznie.
- Zestaw 200 słów kluczowych sprawdzany codziennie to 6000 zapytań miesięcznie.
- Ten sam zestaw sprawdzany co tydzień to około 860 zapytań miesięcznie.
- Połowa z Search Console jest bezpłatna i to jedno zapytanie na wyświetlenie, niezależnie od liczby słów kluczowych w środku.
Cała decyzja to to mnożenie. Pytanie „czy kupić narzędzie" prawie zawsze się do niego sprowadza: policz zapytania miesięcznie, pomnóż przez swoją cenę za zapytanie i porównaj z licencją na stanowisko. Codzienne śledzenie dużego zestawu jest zwykle tańsze w abonamencie. Cotygodniowe śledzenie małego zestawu jest zwykle tańsze przez API. Śledź zamrożoną listę, a strona API pozostanie mała.
Kiedy kupić, a nie budować
Buduj, jeśli chcesz pozycji we własnym potoku, jeśli masz już dane uwierzytelniające do SERP API, albo jeśli surowa strona wyników jest ci potrzebna z powodów innych niż pozycja.
Kup zamiast tego, jeśli potrzebujesz historycznych pozycji sprzed dzisiaj, jeśli potrzebujesz dziesięciu lokalizacji i pięciu urządzeń dla tych samych słów kluczowych, albo jeśli nikt w zespole nie utrzyma crona. Listy dostawców warto czytać właśnie z tego powodu, a posiadanie infrastruktury, która zatrzymuje się, gdy jej autor przechodzi do innego zespołu, ma realny koszt.
Jeśli wyjściem, którego naprawdę potrzebujesz, jest pisany raport tygodniowy, a nie plik JSON, proces raportowania w Codex zaczyna od tych samych dwóch źródeł i kończy dokumentem. Do alertów nad plikiem przewodnik po projektowaniu monitoringu omawia progi.
Stanowisko Auspia: pytanie o API do śledzenia pozycji jest w istocie pytaniem o własność danych. Search Console daje oficjalne dane o twojej usłudze bezpłatnie i zawsze będzie. Wszystko inne to zrzut, za który płacisz. Zbuduj najpierw darmową połowę, a płatną dodawaj tylko tam, gdzie odpowiada na pytanie, które naprawdę masz.
Częste pytania
Czy Google oferuje API do śledzenia pozycji? Publicznego nie. Search Console API zwraca twoją średnią pozycję dla zapytań, na które już się wyświetlasz; to blisko, ale nie to samo. Nie sprawdzi słowa kluczowego, na które się nie pozycjonujesz, ani nie sprawdzi konkurenta.
Jak głęboko może sięgnąć SERP API? Dostawcy przyjmą wartości głębokości znacznie powyżej 200, ale Google przestaje zwracać wyniki gdzieś między 100 a 140 przy większości komercyjnych zapytań. Żądanie więcej nie daje więcej wyników.
Sprawdzać codziennie czy co tydzień? Co tydzień dla zwykłego zestawu słów kluczowych. Codziennie tylko dla krótkiej listy zapytań pieniężnych. Codzienne sprawdzanie dużego zestawu mnoży koszt przez siedem i w większości mierzy szum, bo średnie dzienne przesunięcie w naszych danych wyniosło 4,57 pozycji.
Dlaczego moja liczba z API różni się od mojego trackera pozycji? Inne urządzenia, inne lokalizacje, inne momenty i często inne źródła danych. Liczba jest próbą. Ustal lokalizację i urządzenie w żądaniu i pobierz ponownie, zanim uznasz, że coś się zmieniło.
Czy agent może to uruchamiać za mnie? Tak i dobrze pasuje, bo zadanie ma ten sam kształt przy każdym uruchomieniu. Szerszy obraz tego, co agent może przejąć w pracy nad pozycjami, jest w praktycznym przewodniku po agencie SEO. Trzymaj regułę porównania w pisemnym pliku instrukcji i pozwól agentowi tworzyć diff; decyzję „budować czy kupić" zostaw człowiekowi.
Autor: Rowan Blake, analityk automatyzacji treści w Auspia, odpowiada za ponad 100 potoków wydawniczych. Pisze o zautomatyzowanych potokach danych, raportowaniu według harmonogramu i koszcie utrzymania systemów, które działają bez ciebie.