Co będziesz mieć na koniec
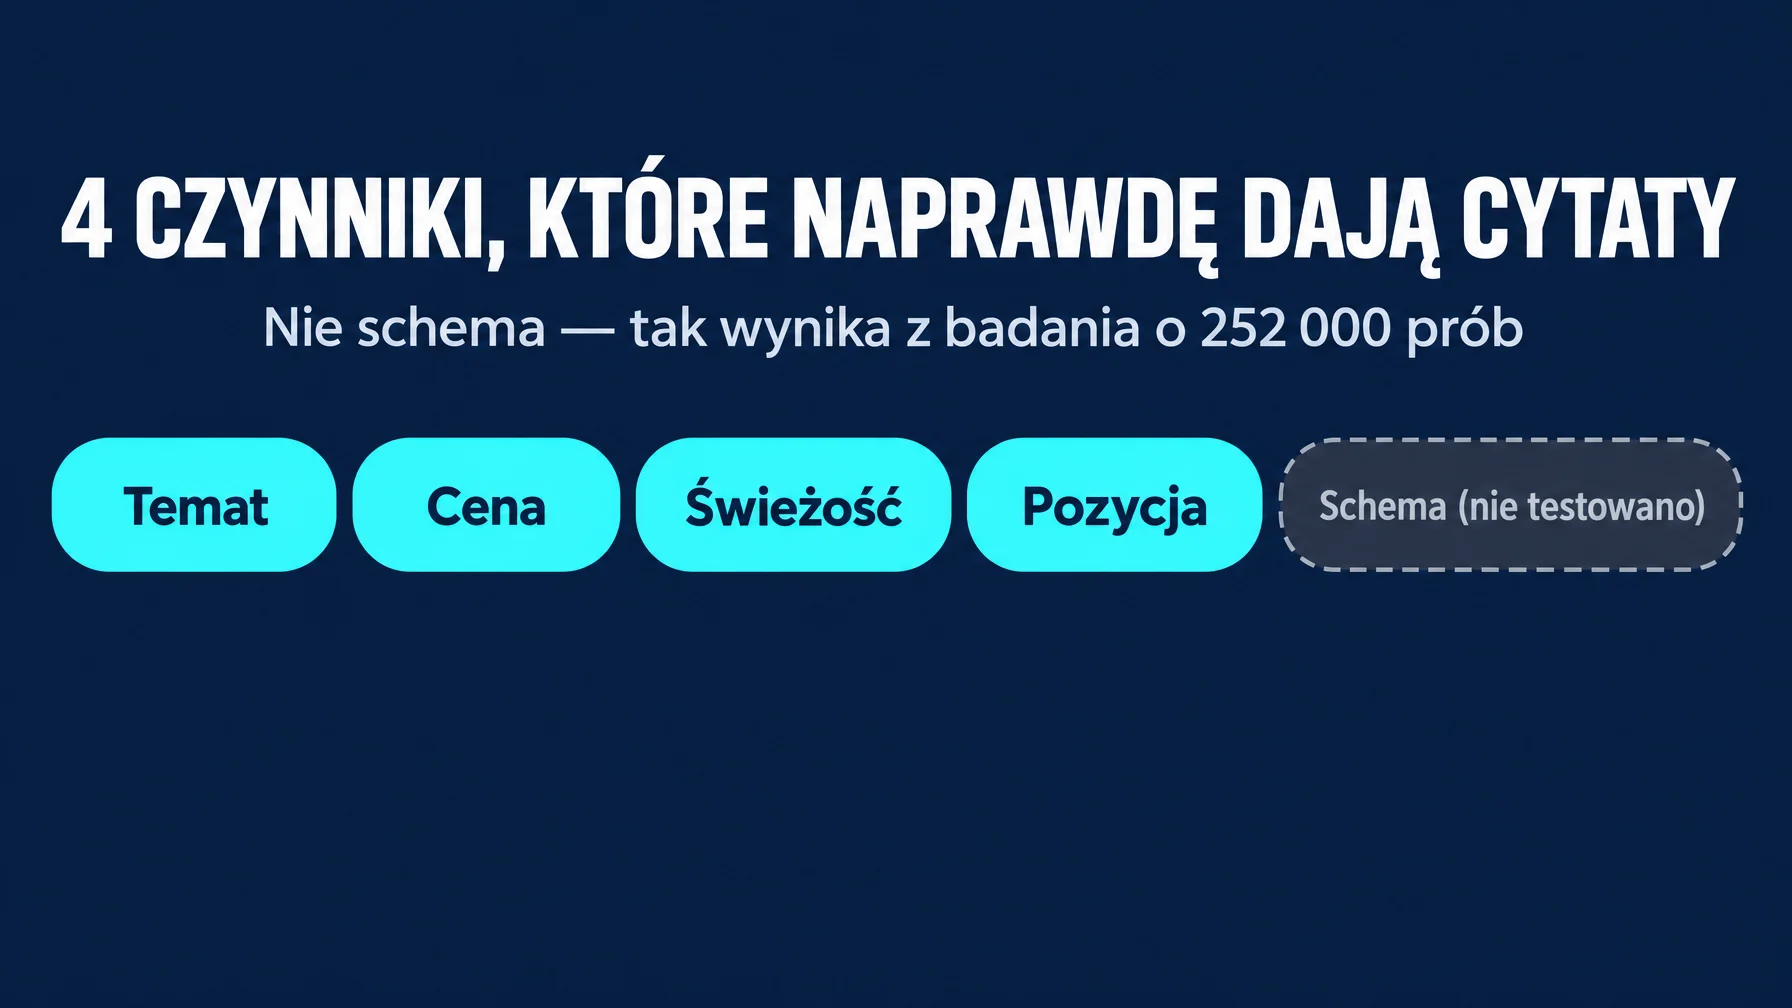
Audyt strona po stronie względem czterech czynników, które kontrolowane badanie z 252 000 prób wskazało jako rozstrzygające dla cytowań w AI, plus kolejność naprawiania siedmiu czynników drugorzędnych, które zaczynają działać dopiero wtedy, gdy te cztery są na miejscu. Zrozumiesz też, wraz ze źródłami, dlaczego viralne twierdzenie, że „znaczniki schema nie mają żadnego wpływu na cytowania w AI", nie jest rzeczywistym wnioskiem tamtego badania — żeby nie spalić całego sprintu na naprawianie nie tego.
Dla kogo: dla każdego, kto odpowiada za SEO lub GEO na poziomie strony w serwisie, który chce być cytowany w ChatGPT, Gemini, Perplexity, Claude albo w odpowiedziach AI Google.
Potrzebny czas: 30 do 45 minut na stronę, wraz z audytem i pierwszą rundą poprawek.
Gotowe, gdy: sprawdzana strona przechodzi wszystkie cztery filtry odsiewające, a ty masz na piśmie listę czynników drugorzędnych, które jeszcze zostały do naprawy.
Zanim zaczniesz: na czym opiera się ta lista i co koryguje
W środowisku SEO/GEO krąży post twierdzący, że badanie SIGIR przeprowadziło 252 000 prób na sześciu LLM-ach i odkryło, że znaczniki schema oraz JSON-LD mają „zerowy zmierzony efekt" na cytowania w AI, podczas gdy cena, świeżość, specyfikacja i głębokość mocno ruszają wynikiem.
Badanie istnieje. Liczba prób jest poprawna. Ilorazy szans podane w tym poście są bliskie prawdziwym liczbom. Nie broni się tylko jedno: tamto badanie nigdy nie testowało znaczników schema. Nie chodzi o to, że schema „wyszła na zero w pomiarze", tylko o to, że schema w ogóle nie było na liście tego, co mierzono.
Praca nosi tytuł „What Gets Cited: Competitive GEO in AI Answer Engines" (Vishwakarma, Kumar, Jamidar, Sprinklr; SIGIR '26, Melbourne). Projekt polega na wstrzyknięciu dokładnie dwóch źródeł-kandydatów do sześciu LLM-ów (Gemini-2.5-Flash, Claude-3.5-Sonnet, Kimi-K2-Thinking oraz trzy warianty GPT-5), przy czym każda para różni się dokładnie jednym z 18 czynników treści, i zapisaniu, które źródło zostało zacytowane pierwsze. Te 18 czynników obejmuje zgodność treści, kompletność, wiarygodność, czytelność, pozycję konkurencyjną i świeżość. Format danych strukturalnych nie występuje wśród tych 18 — potwierdzone bezpośrednim porównaniem z tabelą taksonomii samej pracy.
Jeśli chcesz prawdziwej odpowiedzi o schema, przychodzi ona z innego miejsca: kontrolowanego badania Ahrefs z maja 2026 roku, które porównało 1 885 stron z dodanym JSON-LD z 4 000 dopasowanych stron kontrolnych. Wynik to brak istotnego wzrostu cytowań w Google AI Overviews (−4,6%, niewielki, ale statystycznie istotny spadek), Google AI Mode (+2,4%, nieistotny) i ChatGPT (+2,2%, nieistotny). Osobny test searchVIU wykazał, że ChatGPT, Claude, Perplexity, Gemini i Google AI Mode w ogóle nie czytają JSON-LD, ukrytego Microdata ani ukrytego RDFa podczas wyszukiwania w czasie rzeczywistym.
Rozdziel obie sprawy, zanim zaczniesz audyt: badanie SIGIR mówi, co na stronie ma priorytet. Badanie Ahrefs mówi, że schema nie należy do tych priorytetów, jeśli chodzi o wolumen cytowań, choć wciąż ma znaczenie dla wyników rozszerzonych i jasności encji w innych kontekstach.
Krok 1: przeprowadź audyt filtrów odsiewających
Sprawdź swoją stronę względem tych czterech czynników. Badanie SIGIR wykazało, że wszystkie cztery były jednomyślne na sześciu modelach, z bardzo dużymi efektami (iloraz szans powyżej 100 w większości modeli). Porażka choćby jednego może wyzerować szanse na cytowanie, niezależnie od tego, jak mocna jest reszta strony.
Filtr | Co sprawdzamy | Zakres ilorazu szans (na sześciu testowanych modelach) |
|---|---|---|
Zgodność tematu | Czy strona odpowiada wprost na zapytanie, o które walczy, a nie na pokrewny temat? | Rozstrzygający w 5 z 6 modeli |
Podana cena | Czy na stronie widać konkretną cenę, a nie ukrytą za „skontaktuj się z nami"? | Od 6,26 do ponad 10 000 |
Świeża data | Czy widnieje aktualna i poprawna data publikacji lub ostatniego przeglądu? | Od 14,4 do ponad 10 000 |
Pozycja na liście | Czy strona zwykle zajmuje pierwsze miejsce wśród kandydatów na to zapytanie, a nie drugie? | Od 1 795 do ponad 10 000 |
Działanie: otwórz stronę obok docelowego zapytania. Przeczytaj pierwsze 150 słów i zapytaj, czy odpowiadają na to zapytanie wprost. Poszukaj ceny na stronie; jeśli trzeba wypełnić formularz albo zadzwonić, to porażka. Porównaj widoczną datę z tym, kiedy treść faktycznie została ostatnio zaktualizowana. Sprawdź swoją obecną pozycję lub udział w cytowaniach dla tego zapytania.
Oczekiwany wynik: zaliczone lub niezaliczone dla każdego z czterech wierszy.
Kontrola jakości: jeśli zgodność tematu nie przechodzi, zatrzymaj się tutaj — żaden kolejny krok nie uratuje strony, która odpowiada na niewłaściwe pytanie.
Ścieżka naprawy: porażki cenowe i datowe naprawia się tego samego dnia (krok 2). Porażka pozycji na liście nie jest problemem treści; oznacza, że podstawy SEO trzeba naprawić, zanim strona w ogóle zacznie konkurować o cytowania, i żadne szlifowanie wewnątrz strony tego nie zastąpi.
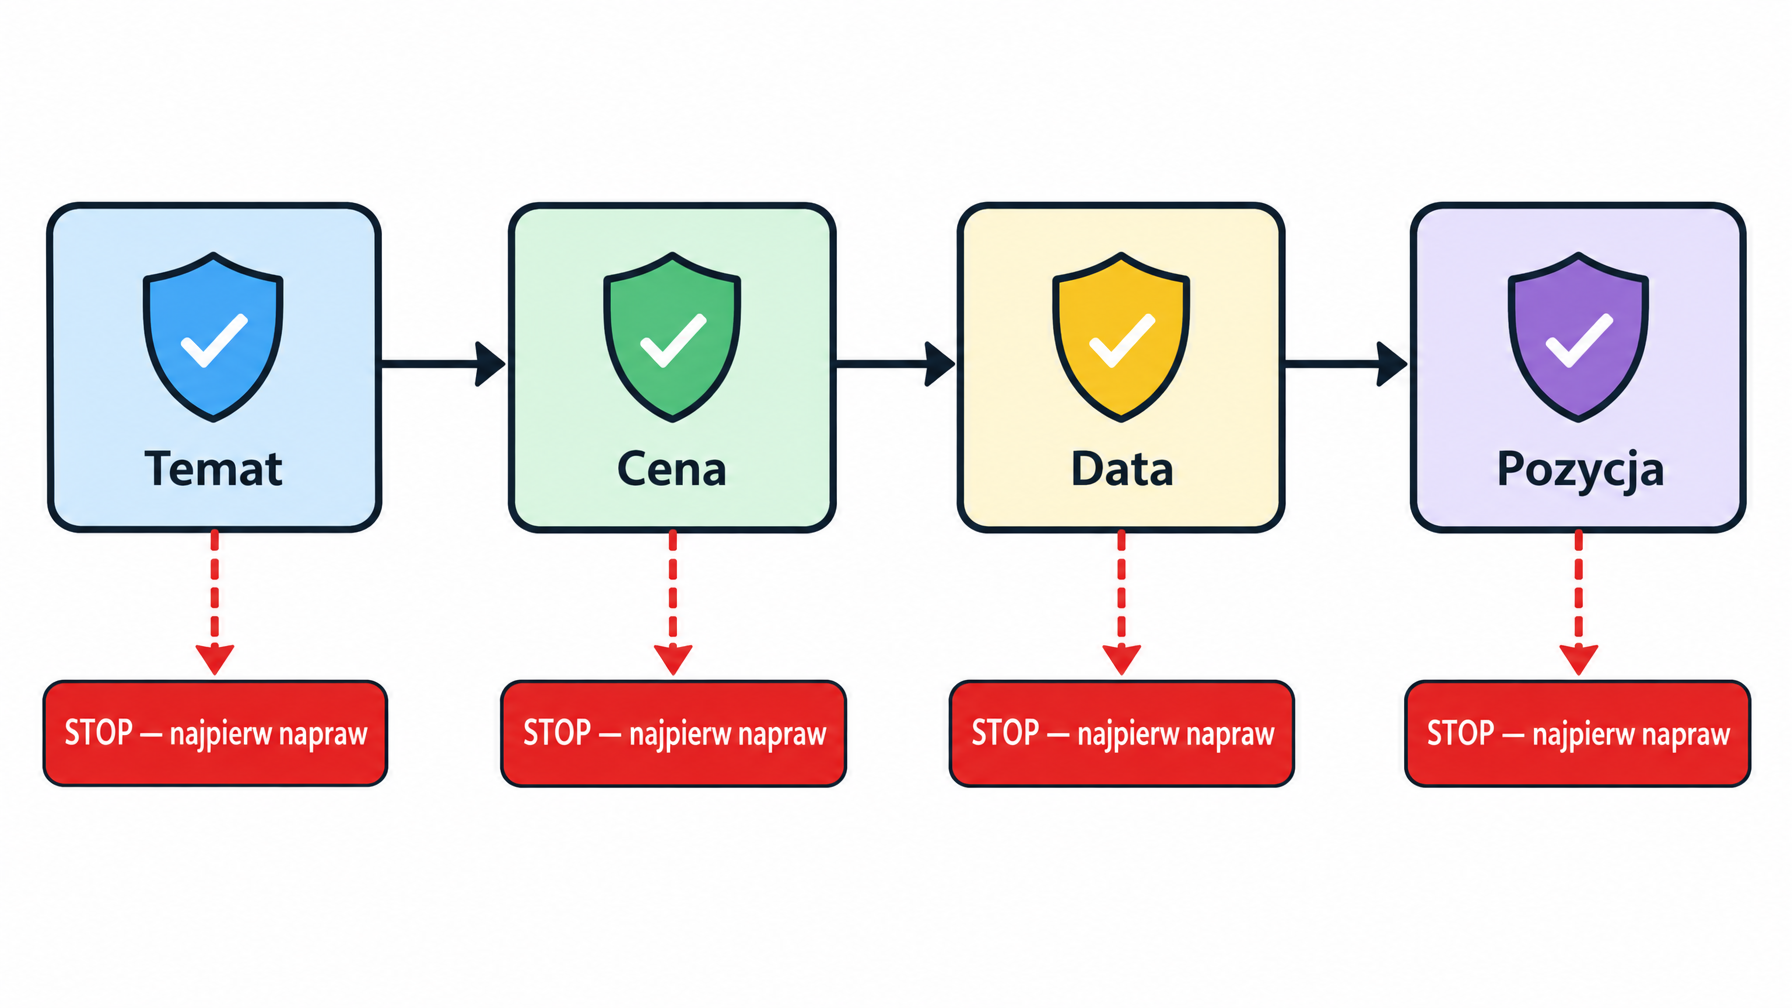
Krok 2: najpierw napraw filtry, które nie przeszły
Zrób to, zanim tkniesz cokolwiek innego. To pozycje o największej dźwigni i najmniejszym nakładzie na całej liście.
Jeśli brakuje ceny: wpisz prawdziwą liczbę. Jeśli cena się zmienia, opublikuj rzeczywistą cenę startową albo jasny zakres zamiast formularza kontaktowego. To był jeden z czterech filtrów w badaniu.
Jeśli data jest nieaktualna lub jej nie ma: zaktualizuj datę publikacji lub ostatniego przeglądu, ale dopiero po tym, jak naprawdę przerobisz treść. Zmiana daty bez realnej aktualizacji to sygnał świeżości, którego nie obronisz, jeśli ktoś sprawdzi.
Jeśli zgodność tematu jest słaba: przepisz pierwsze 150 słów tak, żeby odpowiadały wprost na zadanie tego zapytania, a nie na pokrewny temat. Nie doklejaj nowego wstępu do starej struktury — wymień go.
Kontrola jakości: przeczytaj stronę jeszcze raz, wcielając się w to zapytanie. Czy obcy człowiek dostaje konkretną odpowiedź już w pierwszym akapicie?
Ścieżka naprawy: jeśli prawdziwej ceny nie da się opublikować (wyceny indywidualne, umowy korporacyjne), opublikuj reprezentatywną cenę startową albo typowy zakres zamiast pustego miejsca — badanie mierzyło jako stan porażki „brak wzmianki o cenie", a nie „cena się zmienia".
Krok 3: przejdź przez czynniki różnicujące drugorzędne
Gdy cztery filtry są zaliczone, te siedem czynników daje drugorzędne zróżnicowanie, z ilorazami szans od około 2 do 243 w zależności od modelu. Naprawiaj je w tej kolejności:
- Brak specyfikacji. Dodaj specyfikację techniczną, którą kupujący naprawdę porówna (wymiary, materiały, pojemność, kompatybilność). Iloraz szans od 8,63 do 243 zależnie od modelu — jeden z największych efektów drugorzędnych.
- Brak porównań. Dodaj bezpośrednie porównanie z co najmniej jedną nazwaną alternatywą. Iloraz szans od 1,61 do 7,45.
- Niepewne sformułowania. Zamień „być może", „może", „prawdopodobnie" na wprost wyrażone twierdzenia, które strona naprawdę jest w stanie udźwignąć.
- Twierdzenia bez dowodów. Dołącz dowody do twierdzeń: wyniki testów, certyfikaty, nazwaną metodologię.
- Sprzeczności wewnętrzne. Sprawdź, czy liczby i twierdzenia są spójne między sekcjami tej samej strony; to łatwo wprowadzić przy edycji i łatwo przeoczyć przy przeglądzie.
- Luki w słowach kluczowych. Upewnij się, że na stronie są konkretne sformułowania z docelowego zapytania, a nie tylko synonimy.
- Słabsza propozycja wartości. Wyostrz swoje konkretne twierdzenie o korzyści wobec tego, co oferuje strona konkurencji.
Działanie: przejdź listę od góry do dołu i napraw to, co pasuje. Nie każda strona będzie mieć wszystkie siedem problemów.
Oczekiwany wynik: strona, na której każde twierdzenie jest konkretne, porównywalne albo poparte dowodami.
Kontrola jakości: czy sceptyczny czytelnik znajdzie na stronie choćby jedno niejasne lub niczym niepoparte zdanie?
Ścieżka naprawy: jeśli czasu mało, zatrzymaj się na punktach 1 i 2 (specyfikacja i porównania) — mają najwyższe ilorazy szans z całej siódemki.
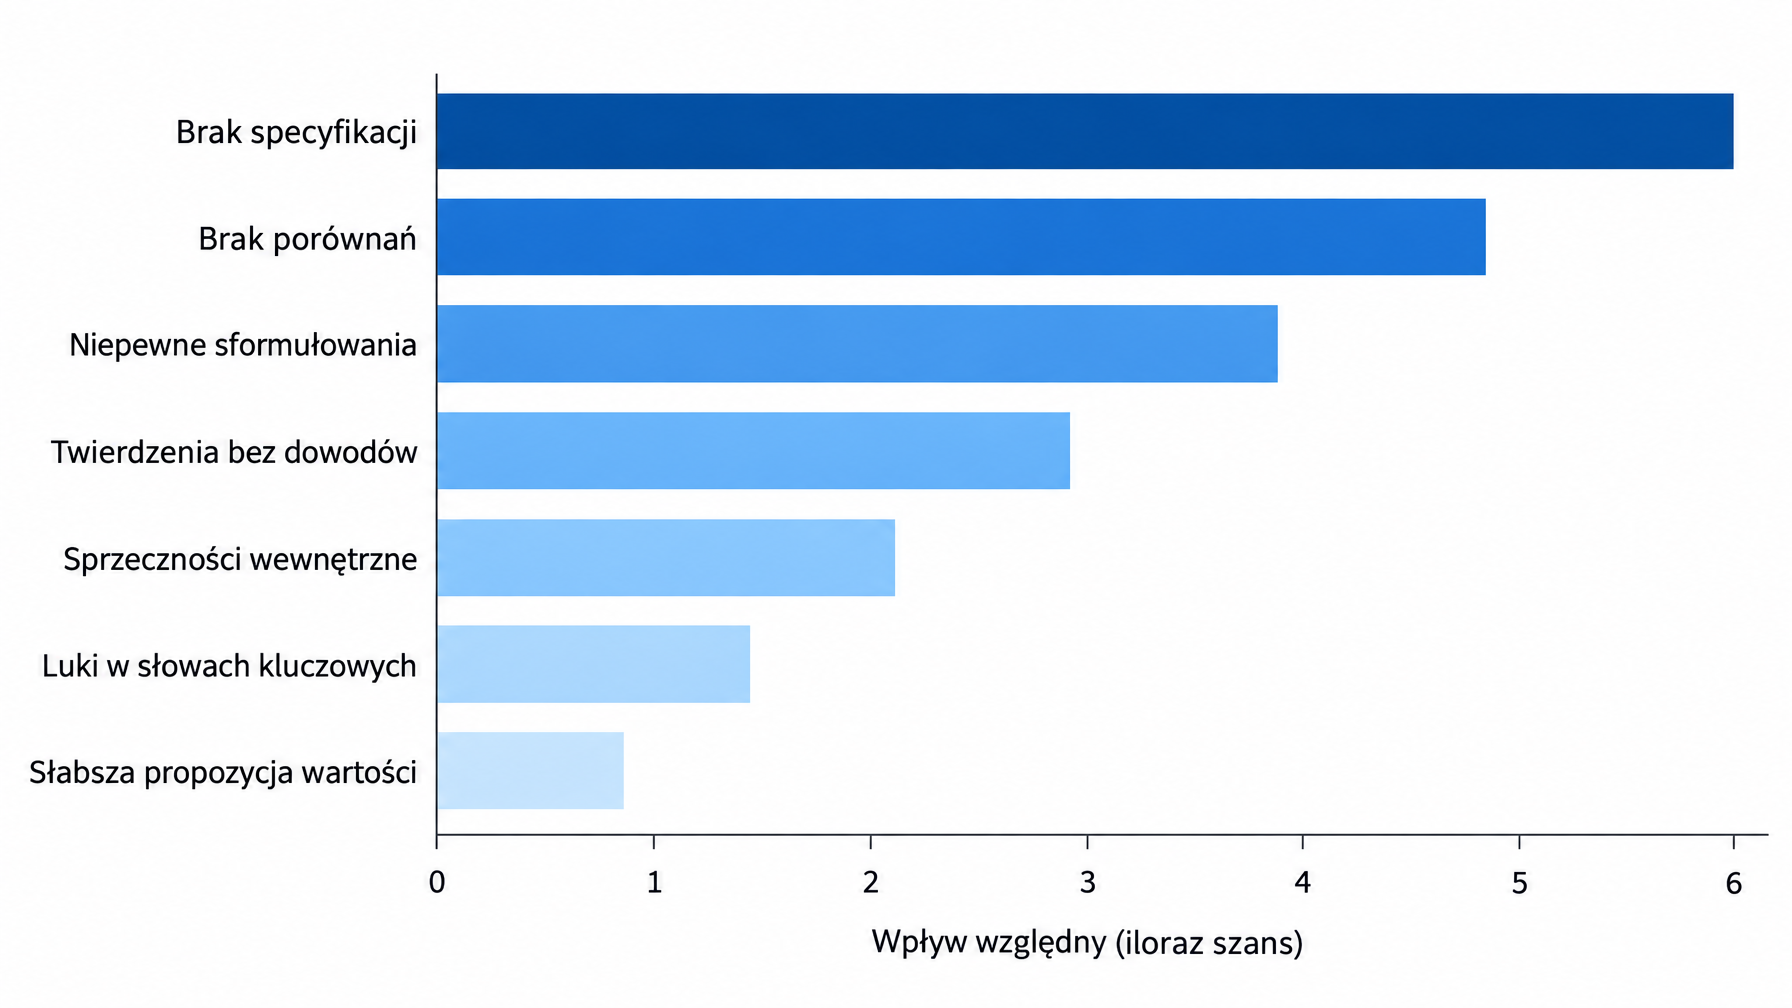
Krok 4: pomiń zmiany wyłącznie formatujące
Badanie wprost pokazało, że nie ma spójnego efektu w zamienianiu akapitów na listy punktowane, dodawaniu podnagłówków dla czytelności ani przestawianiu rozproszonych informacji, bo testowane modele interpretowały treść niezależnie od struktury wizualnej. Jeśli twoja strona przechodzi powyższe sprawdzenia, nie pal sprintu na szlifowanie formatowania w nadziei na wzrost cytowań. Formatuj dla swoich ludzkich czytelników, nie dla przyrostu cytowań, którego dane nie potwierdzają.
Krok 5: zostaw schema tam, gdzie jej miejsce
Utrzymuj znaczniki schema technicznie poprawne, bo robią prawdziwą robotę: pomagają Google i Bingowi interpretować wyniki rozszerzone i dają systemom wyszukiwania jednoznaczne zrozumienie, czym są strona i encja. Czego nie robią, według najlepszych dostępnych dowodów kontrolowanych, to nie ruszają szans na cytowanie w AI. Nie stawiaj pracy nad schema przed krokami 1–3 w oparciu o założenie, że to dźwignia cytowań: żadne kontrolowane badanie tego nie potwierdza, a jedyne badanie przywoływane na jej poparcie nigdy nie testowało schema. Jeśli chcesz pełnego rozbioru tego, co badanie Ahrefs o schema naprawdę mierzyło, zobacz nasz przewodnik po SEO semantycznym 2026.
Zweryfikuj gotowy wynik
Uruchom ponownie audyt z kroku 1 na stronie po poprawkach. Wszystkie cztery filtry powinny teraz przechodzić. Sprawdź wyrywkowo dwa albo trzy czynniki drugorzędne z kroku 3, które naprawiłeś. Jeśli masz dostęp do narzędzia widoczności w AI albo śledzenia cytowań, takiego jak AI Search Visibility Checker, zapisz obecny udział strony w cytowaniach dla docelowego zapytania jako punkt odniesienia, zanim przejdziesz do kolejnej strony — żeby później móc powiedzieć, czy zmiany coś ruszyły.
Utrzymuj wynik
Sprawdzaj ponownie filtr daty za każdym razem, gdy strona dostanie istotną aktualizację, a nie według sztywnego kalendarza. W przypadku stron, które straciły udział w cytowaniach, zrób audyt od nowa, zaczynając od czterech filtrów, zanim założysz, że obsunął się któryś czynnik drugorzędny.
Częste pytania
Czy badanie SIGIR testowało znaczniki schema albo JSON-LD? Nie. Jego taksonomia 18 czynników obejmuje zgodność treści, kompletność, wiarygodność, czytelność, pozycję konkurencyjną, świeżość i pozycję na liście. Formatu danych strukturalnych nie ma ani wśród kategorii, ani wśród testowanych czynników — potwierdzone bezpośrednim odczytem tabeli taksonomii pracy.
To znaczniki schema pomagają w cytowaniach w AI, czy nie? Najlepsze dostępne dowody kontrolowane — badanie Ahrefs z maja 2026, 1 885 stron przeciw 4 000 dopasowanym kontrolom — nie wykazały istotnego wzrostu cytowań po dodaniu JSON-LD ani w Google AI Overviews, ani w Google AI Mode, ani w ChatGPT. Inny test wykazał, że kilka dużych modeli AI nie czyta danych strukturalnych podczas wyszukiwania w czasie rzeczywistym. To nie czyni schema bezużyteczną gdzie indziej; po prostu nie jest dźwignią wolumenu cytowań.
Skąd wzięły się konkretne liczby z viralnego posta (6,3; 14; 4 do 8,6)? Przypominają prawdziwe ilorazy szans z tabeli wyników pracy SIGIR, ale należą do czynników cenowych, świeżości i specyfikacji/porównań, nie do schema. Praca podaje liczby osobno dla każdego modelu, a nie jako jedną średnią, a zakresy różnią się między sześcioma testowanymi LLM-ami.
Co naprawić najpierw, jeśli mam tylko godzinę? Cztery filtry odsiewające: zgodność tematu, cenę, datę i pozycję na liście. Porażka któregokolwiek może wyzerować szanse na cytowanie, niezależnie od wszystkiego innego na stronie.
Czy powinienem całkiem zrezygnować z pracy nad schema? Nie. Utrzymuj ją poprawną ze względu na wyniki rozszerzone i jasność encji. Tylko nie stawiaj nowej pracy nad schema ponad naprawieniem czterech filtrów, jeśli wolumen cytowań w AI jest prawdziwym celem.
Autor: Bennett Hayes, Applied GEO Analyst w Auspia, ponad 400 przeglądów wdrożeń. Bennett pisze o praktycznym wdrażaniu GEO, audytach i notatkach wdrożeniowych opartych na tym, co kontrolowane badania naprawdę mierzyły.