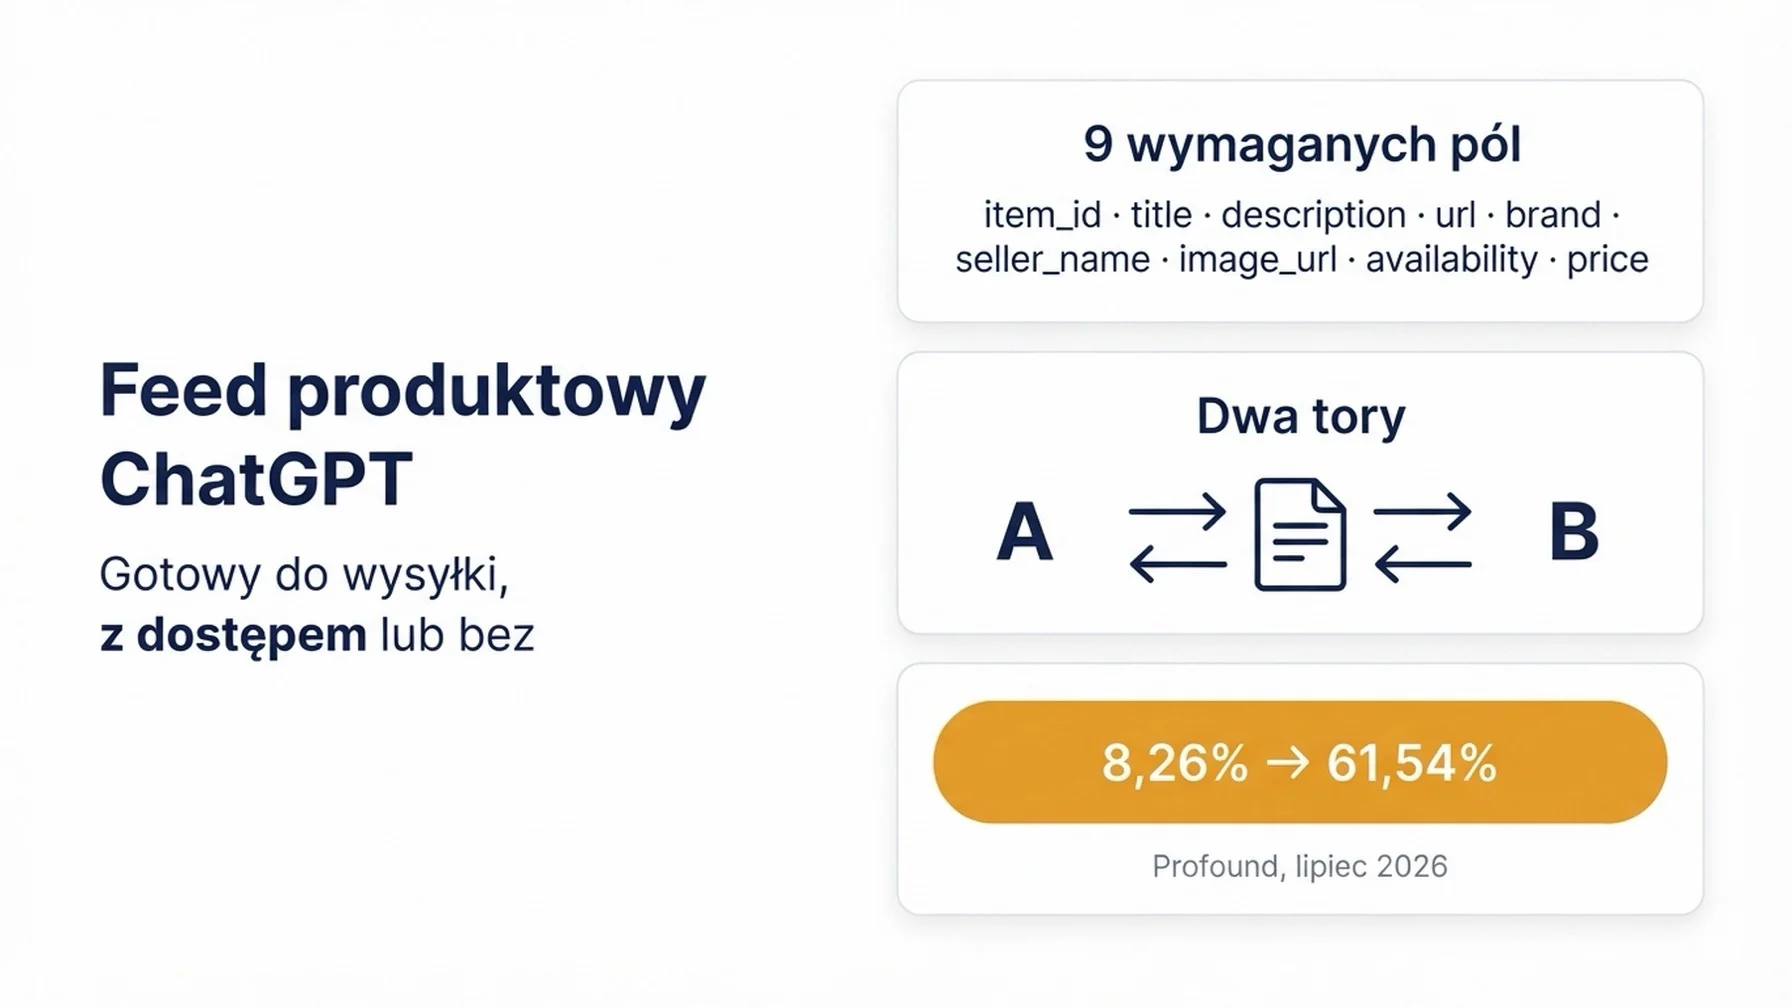
W lipcu 2026 roku rekomendacje zakupowe ChatGPT zmieniły swoje główne źródło. Jeśli Twoje dane katalogowe nie są na to gotowe, żadna optymalizacja stron produktowych tego nie zrekompensuje. Ten workflow doprowadza katalog do zweryfikowanego, gotowego do wysyłki stanu, i działa niezależnie od tego, czy możesz dziś wysłać feed.
Dla kogo | Menedżerowie SEO w e-commerce, menedżerowie feedów i właściciele operacji sprzedawcy odpowiedzialni za dane produktowe w skali od około 500 do 100 000 SKU |
Rezultat | Zweryfikowany plik produktowy, który przechodzi wszystkie dziewięć kontroli wymaganych pól, plus lista wyjątków zablokowanych SKU z przypisanymi właścicielami |
Warunki wstępne | Możliwość wyeksportowania katalogu jako CSV, TSV lub JSONL; katalog roboczy; możliwość edycji |
Założenie o dostępie | Możesz nie mieć dziś możliwości wysłania feedu. Program feedów OpenAI jest ograniczony, checkout to osobno włączana integracja, a standardowa wysyłka na razie dotyczy rynku USA. Ten workflow tworzy plik tak czy inaczej |
Czas | Od czterech do sześciu godzin na pierwsze przejście w katalogu poniżej 5 000 SKU. Wolna część to audyt pól, a nie konfiguracja techniczna |
Definicja ukończenia | Każdy wiersz przechodzi kontrole dziewięciu wymaganych pól, każde pominięte SKU trafia na nazwaną listę wyjątków, robot wyszukiwania OpenAI potrafi pobrać próbkowy URL produktu i odczytać z niego prawdziwe dane, a przebieg da się powtórzyć z zapisanego eksportu |
Co się zmieniło i jedna decyzja, którą to wymusza
OpenAI udostępniło modele ChatGPT 5.6 9 lipca 2026 roku. Następnego dnia udział rekomendacji zakupowych ChatGPT pochodzących z feedów produktowych sprzedawców, a nie z otwartego wyszukiwania w sieci, skoczył z 8,26% do 61,54%, zgodnie z badaniem opublikowanym przez Profound, które objęło 1 757 723 zapytań zakupowych w ChatGPT w lipcu 2026 roku. W ciągu jednego dnia wyszukiwanie oparte na feedach przeszło od źródła mniejszościowego do dominującego.
Ta liczba to pomiar zewnętrzny, a nie ujawnienie OpenAI. OpenAI nie potwierdziło zmiany z 10 lipca ani nie opublikowało żadnego podziału źródeł pobrania, a sekcje na końcu tego artykułu opisują, czego dane dowodzą, a czego nie. Kierunek traktuj poważnie, a precyzję swobodnie.
Ten kierunek wymusza jedną zmianę perspektywy: dane produktowe muszą być teraz poprawne jako dane, a nie tylko jako treść. Pięknie napisana strona produktu z brakującą cyfrą kontrolną GTIN jest dla rekomendera opartego na feedzie wierszem, który nie przeszedł walidacji.
Wszystko poniżej to workflow. Każdy jego krok warto wykonać niezależnie od tego, czy liczby z 10 lipca się obronią, bo czysty, kompletny i czytelny maszynowo katalog przydaje się na każdej powierzchni zakupowej, która kiedykolwiek będzie dla Ciebie istotna.
Sprawdź, na którym torze jesteś
Workflow dzieli się na dwa tory i musisz znać swój, zanim zaczniesz, bo to zmienia znaczenie słowa gotowe. Tor A może udowodnić przyjęcie danych. Tor B może udowodnić wyłącznie gotowość. Oba dają ten sam plik.
Test dostępu z czterech pytań
Odpowiedz na każde z nich uczciwie.
Pytanie | Co liczy się jako tak | Co się nie liczy |
|---|---|---|
Czy zarejestrowałeś się w OpenAI i otrzymałeś pisemne potwierdzenie dostępu do feedu? | Potwierdzenie wymieniające Twój feed | "Wypełniłem formularz zainteresowania" |
Czy Twój katalog kwalifikuje się do rynku USA? | Potwierdzenie dla obecnego zakresu standardowej wysyłki | Założenie, że obejmuje on Twój rynek |
Czy integracja checkout została dla Ciebie osobno włączona? | Wyraźne potwierdzenie podczas onboardingu | Samodzielne włączenie flagi |
Czy wysłałeś próbkę lub pełny plik i dostałeś potwierdzenie? | Odpowiedź odnosząca się do Twojej wysyłki | Wysłanie i brak jakiejkolwiek odpowiedzi |
Jeśli którakolwiek odpowiedź nie ma pokrycia w czymś, na co możesz wskazać, jesteś na torze B. To pozycja domyślna i nie jest stanem porażki. Dwa ważne doprecyzowania: włączenie flagi kwalifikowalności nie kończy onboardingu checkout, a rejestracja dostarcza wyłącznie nazwę wyświetlaną sprzedawcy, nie resztę feedu.
Tor A: masz potwierdzony dostęp do feedu
Otrzymasz listę pól właściwą dla swojej rejestracji oraz kanał wysyłki potwierdzony podczas onboardingu. Sam mechanizm wysyłki jest potwierdzany podczas onboardingu. Publikowane relacje dostawców nie zgadzają się, czy to SFTP, czy szyfrowany push HTTPS do endpointu z listy dozwolonych, więc nie buduj pipeline'u pod żaden z tych opisów, dopóki OpenAI nie powie, który dotyczy Ciebie.
Tor B: nie masz dostępu i oto co nie idzie na marne
Trzy rzeczy są dla Ciebie otwarte już dziś, bez żadnych pozwoleń: dostęp robotów, dane strukturalne i jakość opisów na samych stronach produktowych oraz zweryfikowany plik. Praca nad katalogiem w środku tego artykułu nie ma żadnej bramki. Budujesz i sprawdzasz plik teraz, a w dniu, w którym pojawi się dostęp, wysyłasz coś, co już przechodzi walidację.
Jeśli działasz na Shopify, dane produktowe trafiają do ChatGPT przez Shopify Catalog bez dodatkowej pracy po stronie sprzedawcy. Bezpośredni feed służy świeżości i polom, których domyślne rozwiązanie nie przenosi. Jedno zastrzeżenie: źródło wtórne datuje tę syndykację na marzec 2026 i data ta jest niepotwierdzona, więc traktuj ją jako temat do rozmowy, a nie fakt, na którym można planować.
Otwórz drzwi robotowi, który czyta Twoje produkty
To pierwszy krok, który działa natychmiast na obu torach, i najtańsza dostępna wygrana.
Otwórz robots.txt i sprawdź dyrektywy dla agentów OpenAI. OAI-SearchBot to ten, który liczy się dla widoczności produktów. Jeśli jest zablokowany, Twoje treści nie pojawią się w wynikach produktowych ChatGPT niezależnie od tego, jak czysty jest feed. Nie służy do trenowania modeli, więc blokowanie go niczego nie chroni.
Cztery nazwy agentów warte wyraźnej decyzji:
Agent | Co robi | Wpływ na widoczność produktów |
|---|---|---|
| Indeksuje treści na potrzeby powierzchni wyszukiwania | Zablokowanie go ukrywa Twoje produkty niezależnie od jakości feedu |
| Pobiera strony, o które użytkownik wprost pyta | Zablokowanie go psuje odczyty stron na żywo |
| Robot treningowy | Bez związku z widocznością zakupową |
| Przeglądanie agentowe | Wpływa na ścieżki checkout prowadzone przez agentów |
Kontrola jakości, która liczy się tu najbardziej, nie dotyczy `robots.txt`. Chodzi o to, czy dopuszczony robot po przybyciu faktycznie coś odczyta. Pobierz reprezentatywny URL produktu z nagłówkiem user agent robota i obejrzyj treść odpowiedzi. Jeśli dostaniesz szkielet aplikacji bez renderowanego po stronie serwera tytułu, ceny, dostępności i opisu, indeksowanie się udaje i zwraca nic użytecznego. Wiele sklepów renderuje dane produktowe wyłącznie po stronie klienta i takie sklepy są niewidoczne dla odkrywania bez feedu niezależnie od treści pliku robots.
Możesz przeprowadzić tę kontrolę za pomocą symulatora robota wyszukiwania OpenAI od Auspii, który pobiera publiczną stronę jako robot OpenAI i pokazuje, co potrafi odczytać.
Ścieżka naprawcza. Jeśli robots.txt jest zablokowany przez Twoją platformę albo agencję, zapisz wniosek o zmianę z datą i idź dalej. Krok staje się dowodem do Twojej dokumentacji toru B, a nie blokadą.
Uczyń strony produktowe czytelnymi maszynowo
Feed nie jest jedyną drogą do rekomendacji zakupowych, a dla sprzedawców z toru B obecnie nie jest dostępny wcale. Dane strukturalne na stronie są.
Dodaj dane strukturalne Product w JSON-LD do każdego szablonu produktu i wypełniaj je z tego samego źródła, z którego korzysta eksport katalogu. To ostatnie zdanie jest tym, co zespoły pomijają. Jeśli Twoje dane strukturalne są utrzymywane ręcznie w motywie, a feed pochodzi z PIM, oba źródła rozjadą się w ciągu kwartału, a sprzeczne sygnały o cenie i dostępności są gorsze niż ich brak.
Uwzględnij co najmniej nazwę, opis, obraz, SKU, markę oraz blok offers z ceną, walutą ceny i dostępnością. Odbij te same wartości, które trafiłyby do feedu. Tam, gdzie katalog ma GTIN, stan, materiał, kolor, rozmiar lub wymiary, też je dodaj, bo właśnie tych atrybutów używają zapytania konwersacyjne.
Kontrola jakości. Zweryfikuj trzy adresy URL produktów, po jednym z każdej z Twoich najbardziej różnych kategorii, na tej samej ścieżce renderowania, którą widzi robot, a nie w przeglądarce z Twoim zalogowaniem.
Ścieżka naprawcza. Jeśli platforma nie pozwala wstrzyknąć JSON-LD do szablonu produktu, umieść go w sekcji head przez menedżer tagów i zapisz to jako dług techniczny. To działa, jest kruche i ktoś powinien odpowiadać za jego usunięcie.
Przepisz opisy pod zapytania konwersacyjne
To krok, w którym dyscyplina SEO aktywnie Ci szkodzi.
Opisy katalogowe są zwykle pisane pod pokrycie słów kluczowych i atrakcyjność na półce: głos marki, upchany słowami kluczowymi tytuł, lista twierdzeń w punktach. Konwersacyjne zapytania zakupowe nie wyglądają tak wcale. Ktoś pyta o cichą klawiaturę mechaniczną do biura open space do 150 dolarów, a atrybutami, które odpowiadają na to pytanie, są poziom hałasu, typ przełączników i format. Te atrybuty muszą być obecne i zgodne z faktami, żeby dały się wyodrębnić.
Pisz opisy produktów jak specyfikację faktograficzną z krótkim ludzkim wstępem. Zacznij od jednego zdania o tym, czym produkt jest i dla kogo. Potem podaj atrybuty wprost, bez marketingowych ozdobników. "Waga: 780 g" bije "niezwykle lekką konstrukcję". Jeśli formułujesz twierdzenie, zrób je konkretnym i sprawdzalnym.
Jedna rzecz do wiedzenia, zanim zainwestujesz tu dużo czasu: dokumentacja zakupowa OpenAI zauważa, że ChatGPT może generować uproszczone tytuły i opisy produktów. Twój tekst jest wejściem dla rekomendacji, a nie gwarantowanym wyjściem. Pisz czyste, faktograficzne dane źródłowe i przyjmij, że powierzchnia może je sparafrazować.
Kontrola jakości. Weź dziesięć produktów o najwyższym przychodzie i dla każdego wypisz cztery atrybuty, których kupujący potrzebowałby do podjęcia decyzji. Jeśli w opisie pojawiają się mniej niż trzy, opis nie wykonuje swojej pracy.
Ścieżka naprawcza. Jeśli opisy pochodzą z feedu dostawcy, którego nie kontrolujesz, przepisz ręcznie górny decyl według przychodu, a ogon niech podąży za nim. Częściowe pokrycie jest lepsze niż zatrzymany projekt.
Zbuduj kontrakt pól, zanim dotkniesz wiersza
Teraz sam feed. Zanim cokolwiek wyeksportujesz, zapisz raz, co znaczy poprawne. To zamienia audyt w mechaniczne przejście, a nie spór.
Dziewięć wymaganych pól i to, gdzie każde z nich się psuje
Każdy wiersz potrzebuje tych dziewięciu. Ta tabela jest kontraktem.
Pole | Akceptowana forma | Najczęstsza awaria | Konsekwencja |
|---|---|---|---|
| Stabilny unikalny ciąg na pozycję lub wariant | Wielokrotne użycie w wariantach albo generowanie od nowa przy każdym eksporcie | Zduplikowane i osierocone wiersze |
| Zwykły ciąg, celuj w 150 znaków lub mniej | Ucięcie w środku słowa albo tytuł zawierający cenę | Wiersz odrzucony lub źle dopasowany |
| Zwykły tekst, do 5 000 znaków | HTML albo markdown pozostawiony z CMS | Wiersz odrzucony |
| Adres URL strony produktu | Parametry śledzące albo adres, który przekierowuje | Wiersz prowadzi donikąd |
| Ciąg z nazwą marki | Całkowity brak przy SKU bez marki | Wiersz odrzucony |
| Ciąg z nazwą sprzedawcy | Niespójna pisownia w całym katalogu | Słaby sygnał o sprzedawcy |
| Bezpośredni adres URL obrazu | Zaślepka albo adres wymagający sesji | Wiersz bez warstwy wizualnej |
| Jedna z wartości | Własna wartość ze słownika stanów magazynowych | Wiersz odrzucony |
|
| Separatory tysięcy albo sama liczba bez waluty | Wiersz odrzucony |
Dwa wpisy zasługują na podkreślenie, bo zawodzą po cichu i zabierają ze sobą całe linie produktowe.
Pole availability przyjmuje dokładnie pięć wartości. Pominięte, puste lub nierozpoznane wartości odrzucają wiersz. Jeśli Twoja platforma eksportuje IN STOCK, available albo 1, każdy z tych wierszy przepada. Zmapuj swój wewnętrzny słownik na pięć akceptowanych wartości wprost, a wszystko, czego nie umiesz zmapować, skieruj do ręcznej kolejki, zamiast domyślnie ustawiać unknown. unknown jest legalną wartością, ale to świadomy stan, a nie worek na resztę.
Pole price to amount, spacja, a potem trzyliterowy kod waluty wielkimi literami. Czyli 79.99 USD, nie $79.99, nie 79,99 USD i nie 7.999e1. Żadnych separatorów tysięcy, żadnej notacji wykładniczej.
Zasady, które po cichu odrzucają wiersze
Cztery kolejne ograniczenia warte wpisania w kontrole walidacyjne:
GTIN. Dokładnie 8, 12, 13 lub 14 cyfr wraz z poprawną cyfrą kontrolną. ISBN-10 nie jest akceptowany. Zachowaj zera wiodące, co oznacza trzymanie kolumny jako tekstu wszędzie, gdzie wędruje. To najczęstszy cichy zabójca w całej specyfikacji, bo arkusze kalkulacyjne i eksporty CSV domyślnie usuwają zera wiodące.
Cena promocyjna. Musi być większa od zera i ściśle mniejsza od ceny regularnej, w tej samej walucie. Cena promocyjna równa cenie regularnej albo wiersz promocyjny z pustą ceną regularną przepada.
Długość tytułu. Celuj w 150 znaków lub mniej. Skracając, tnij na granicy słowa.
Pola dat niczego nie planują. Specyfikacja mówi wprost, że daty w kontrakcie nie planują zmian ceny ani dostępności. Jeśli chcesz, żeby promocja włączyła się o północy, Twój pipeline musi wypchnąć nową wartość.
Zdecyduj o flagach kwalifikowalności świadomie
Trzy flagi decydują o tym, co dzieje się z wierszem po walidacji.
Flaga | Domyślna wartość przy pominięciu lub pustce | Co robi |
|---|---|---|
|
|
|
| Wymaga kwalifikowalności wyszukiwania |
|
| Wyłączona | Steruje osobną ścieżką przetwarzania reklam |
Możesz też spotkać je jako enable_search, enable_checkout i is_eligible_ads. To aliasy, więc nie traktuj szablonu ze starszą pisownią jako innego pola.
Praktyczna rada: zsynchronizuj is_eligible_search z tym systemem, który już wie, że produkt został wycofany albo wyciszony. Jeśli prowadzisz osobną listę ukrytych kanałów i nigdy nie trafia ona do feedu, będziesz wysyłać nieaktualne oferty do rekomendacji.
Które grupy opcjonalne włączyć i w jakiej kolejności
Pól opcjonalnych jest około pięćdziesięciu. Uszeregowane według zwrotu na godzinę pracy, a nie według kolejności w specyfikacji:
- Warianty (
group_id,listing_has_variations,variant_dict,offer_id,gtin,mpn). Najwyższy priorytet, jeśli sprzedajesz odzież, obuwie, wyposażenie domu albo cokolwiek z rozmiarem lub kolorem. - Informacje o pozycji (
condition,product_category,material,color,size,gender,age_grouporaz pola wymiarów i wagi). To one sprawiają, że dopasowanie konwersacyjne działa. - Media (
additional_image_urls). - Zwroty (
accepts_returns,return_deadline_in_days,return_policy). - Opinie (
review_count,star_rating) oraz na poziomie sklepustore_review_countistore_star_rating. - Realizacja, sprzedawca i geografia (
shipping_price,shipping,seller_url,target_countries,store_country). - Pola zależne od konfiguracji.
marketplace_seller,size_system,accepts_exchanges,is_digital, para reklamowa (is_ads_eligible,ads_metadata) oraz para checkout (is_eligible_checkout,seller_privacy_policy,seller_tos) wymagają potwierdzenia podczas onboardingu. Nie są samoobsługowe. Zostaw je poza pierwszym przejściem.
Kontrola jakości. Każde z dziewięciu wymaganych pól powinno mapować się na kolumnę katalogu, która zwraca prawdziwe dane w co najmniej 95% Twoich SKU. Pola poniżej tego progu nie są zadaniami mapowania, to decyzje o źródle danych.
Ścieżka naprawcza. Jeśli wymagane pole nie ma żadnego źródła, na przykład brand w linii produktów bez marki, zatrzymaj się i rozstrzygnij kwestię źródła z właścicielem biznesowym, zanim zbudujesz plik. Praca nad formatem nie naprawi brakujących danych.
Który format pliku wolno Ci faktycznie wysłać
Użyj formatu, który OpenAI potwierdzi dla Twojego zarejestrowanego feedu podczas onboardingu. Poza tym istnieje ścieżka zgodna z Google, która przyjmuje pliki .txt albo .tsv rozdzielane tabulatorami w UTF-8, bądź .csv rozdzielane przecinkami, z obsługą gzip dla .txt.gz, .txt.gzip, .tsv.gz i .csv.gz.
JSON, arkusze kalkulacyjne, XML, RSS i Atom nie są obsługiwane na tej ścieżce zgodności. Użyj jednego formatu dla całej wysyłki, zamiast mieszać formaty wiersz po wierszu.
Znormalizuj cztery pola, które psują najwięcej wierszy
Pobierz jeden zamrożony eksport
Eksportuj raz, oznacz plik znacznikiem czasu i policz jego hash. Każdy kolejny krok działa na tym zamrożonym pliku. Powtarzalność jest tym, co czyni audyt obronnym trzy tygodnie później, gdy ktoś zapyta, dlaczego jakiegoś SKU brakuje.
Cztery normalizacje
Zera wiodące GTIN. Eksportuj kolumnę jako tekst, potem sprawdź, czy liczba cyfr wynosi 8, 12, 13 albo 14, i zweryfikuj cyfrę kontrolną. Tu mieszka większość cichych awarii.
Formatowanie ceny. Usuń separatory tysięcy, zachowaj kropkę dziesiętną, usuń notację wykładniczą i dopisz kod waluty jako osobny token. Przepuść wynik przez wyrażenie regularne, które przyjmuje wyłącznie ^\d+\.\d{2} [A-Z]{3}$, a resztę skieruj do kolejki.
Mapowanie dostępności. Zmapuj wewnętrzny słownik na pięć akceptowanych wartości wprost. Policz, ile wierszy trafia do każdego koszyka, a ile spada do ręcznego przeglądu. Wysoka liczba ręcznych przeglądów oznacza, że Twój słownik stanów potrzebuje tabeli mapowania, a nie że feed jest zepsuty.
Porządki w tytułach i opisach. Skracaj tytuły do 150 znaków na granicy słowa. Usuń znaczniki z opisów i ogranicz je do 5 000 znaków zwykłego tekstu.
Kontrola jakości. Zaimportuj ponownie znormalizowany plik do świeżego arkusza i potwierdź, że kolumna GTIN nadal pokazuje zera wiodące. To wyłapuje pułapkę eksportu jako liczba, która przechodzi wszystkie inne kontrole.
Ścieżka naprawcza. Jeśli Twoja platforma feedu albo PIM wykonuje te normalizacje za Ciebie, zweryfikuj jej wynik tymi samymi kontrolami, zamiast ufać komunikatowi o sukcesie.
Zaudytuj każdy wiersz i prowadź listę wyjątków
Teraz uruchom kontrole na całym pliku. To krok, który zamienia katalog w plan pracy.
Dziewięć mechanizmów, które sprawdzisz bez walidatora
Dla każdego wiersza: wszystkie dziewięć wymaganych pól obecne i niepuste; availability w pięciowartościowym enumie; liczba cyfr gtin i cyfra kontrolna poprawne; price zgodne ze wzorcem kwoty i waluty; sale_price ściśle mniejsza od price i większa od zera, w tej samej walucie; title na poziomie 150 znaków lub mniej; description jako zwykły tekst do 5 000 znaków; url zwracający 200 i renderujący dane produktu po stronie serwera; image_url prowadzący do prawdziwego obrazu, a nie zaślepki.
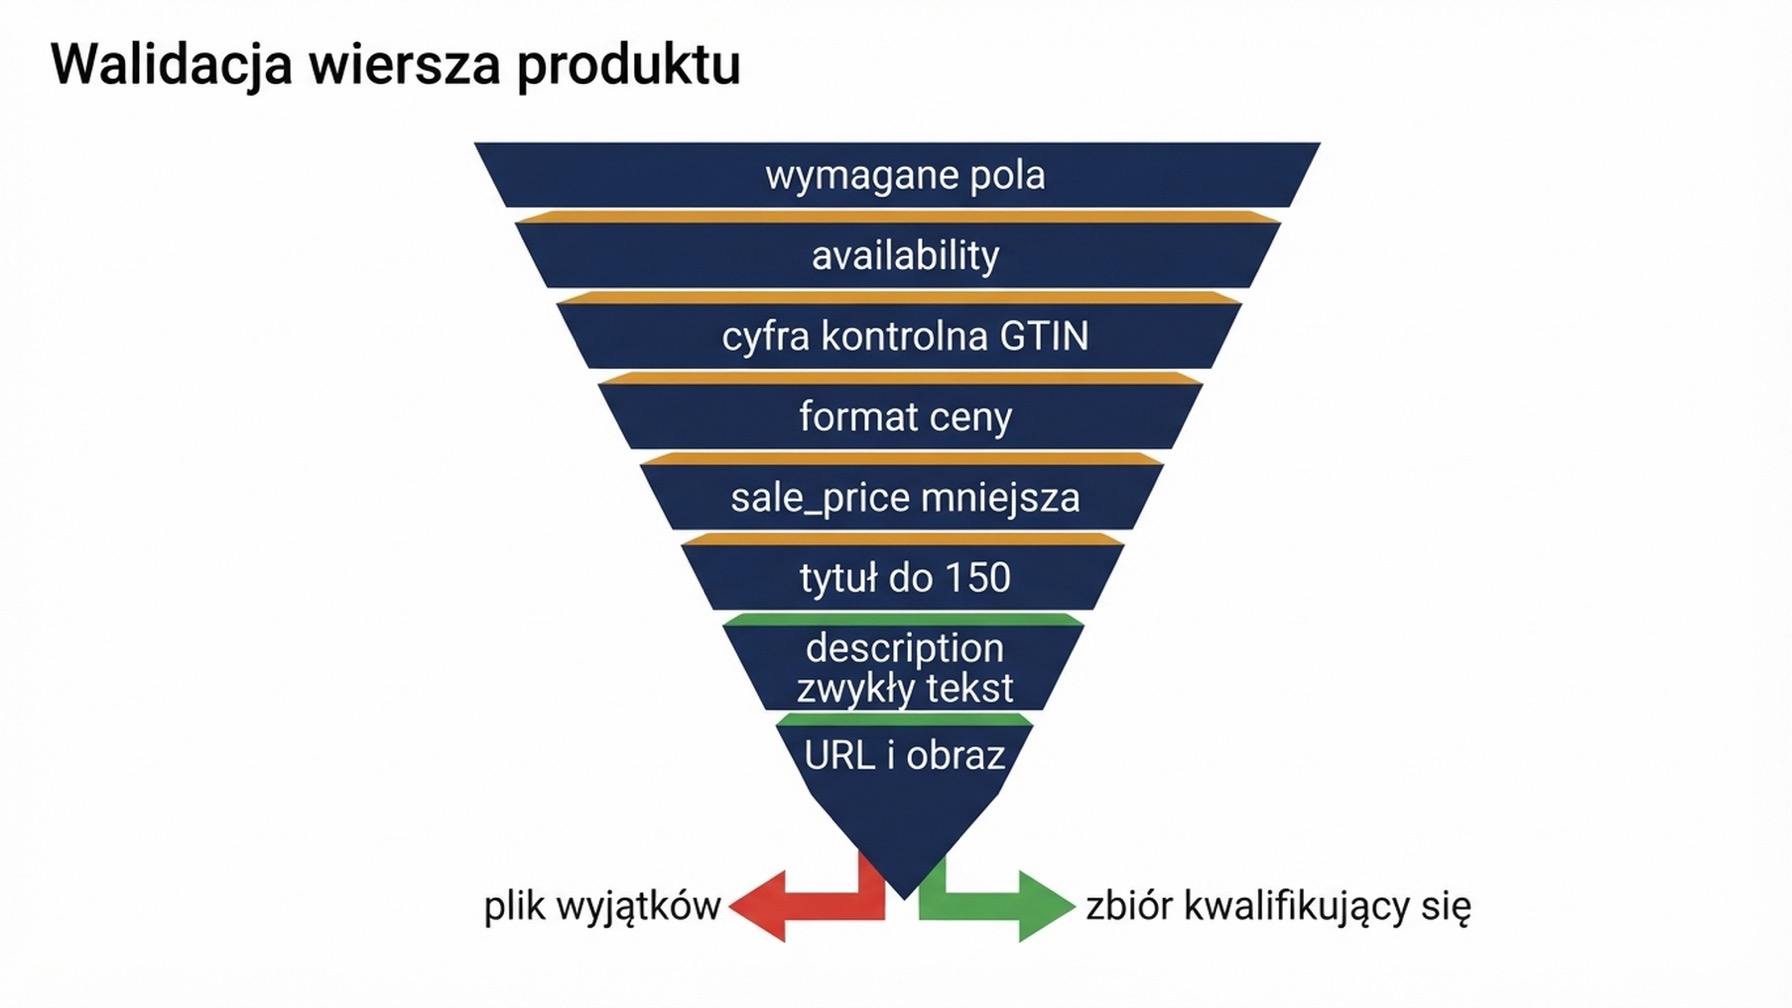
Pojedynczy wiersz albo przechodzi każdą bramkę, albo ląduje w pliku wyjątków z nazwą bramki, która go zatrzymała. Bramka dostępności odrzuca najwięcej wierszy, bo własny słownik stanów magazynowych jest najczęstszym sposobem, w jaki katalog przepada.
Zbuduj plik wyjątków, a nie idealny katalog
Dwie kolumny i właściciel: item_id, blokada i kto to naprawia.
Kontrola jakości. W rozsądnie czystym katalogu plik wyjątków powinien obejmować mniej niż 10% wierszy. Jeśli przekracza 30%, problem leży wyżej, w zarządzaniu danymi, i uczciwym ruchem jest naprawa systemu źródłowego, a nie łatanie pliku.
Ścieżka naprawcza. Jeśli wymaganego pola brakuje w całej kategorii, a nie w rozproszonych SKU, potraktuj to jako decyzję o źródle z właścicielem biznesowym. Nie oznaczaj tych wierszy jako unknown, żeby zamknąć audyt, bo unknown to legalna wartość o konkretnym znaczeniu, a używanie jej do przejścia kontroli zanieczyszcza Twoje własne dane.
Jedna uczciwa uwaga o odświeżaniu: specyfikacja nie podaje żadnego rytmu aktualizacji i nie mówi, czy feedy to pełne migawki, czy aktualizacje przyrostowe. Publikowane relacje dostawców pewnie twierdzą jedno i drugie, czego nie ma w dokumentacji OpenAI. Specyfikacja mówi natomiast, żeby wysyłać aktualną cenę, aktualizować przy starcie i końcu promocji oraz aktualizować dostępność, gdy pozycja się wyprzeda albo wróci. Zbuduj pipeline wokół tych dwóch zdarzeń, a kwestię rytmu potwierdź podczas onboardingu.
Zwaliduj plik tak, jak zrobi to platforma
Przeparsuj dokładnie te bajty, które zamierzasz wysłać, w formacie, w którym zamierzasz wysłać, i policz wiersze na wejściu oraz na wyjściu.
To wyłapuje awarię, którą arkusz ukrywa. Plik, który otwiera się czysto w Excelu, to nie ten sam plik, który parsuje się jako CSV, bo nieescapowane separatory i złamania wiersza wewnątrz pól opisu psują parsowanie, wyglądając przy tym dobrze na ekranie.
Kontrola jakości. Wiersze na wejściu równają się wierszom na wyjściu, a automatyczne kontrole zgadzają się z Twoim ręcznym audytem. Rozbieżność między nimi oznacza, że jedno z nich jest błędne, i zwykle jest to przejście ręczne.
Ścieżka naprawcza. Awarie kodowania rozwiązuje prawie zawsze ponowny eksport w UTF-8. Awarie cytowania to prawie zawsze nieescapowane separatory albo zabłąkane złamania wiersza w opisach.
Jeśli Twój zespół ma dostępnego agenta kodującego, to jedyne miejsce, w którym mały skrypt na siebie zarabia, bo zamienia audyt z kwartalnego projektu w powtarzalne uruchomienie.
Zweryfikuj, że to zadziałało
To, co możesz udowodnić, zależy od Twojego toru, i warto być precyzyjnym co do różnicy, zamiast ją rozmywać.
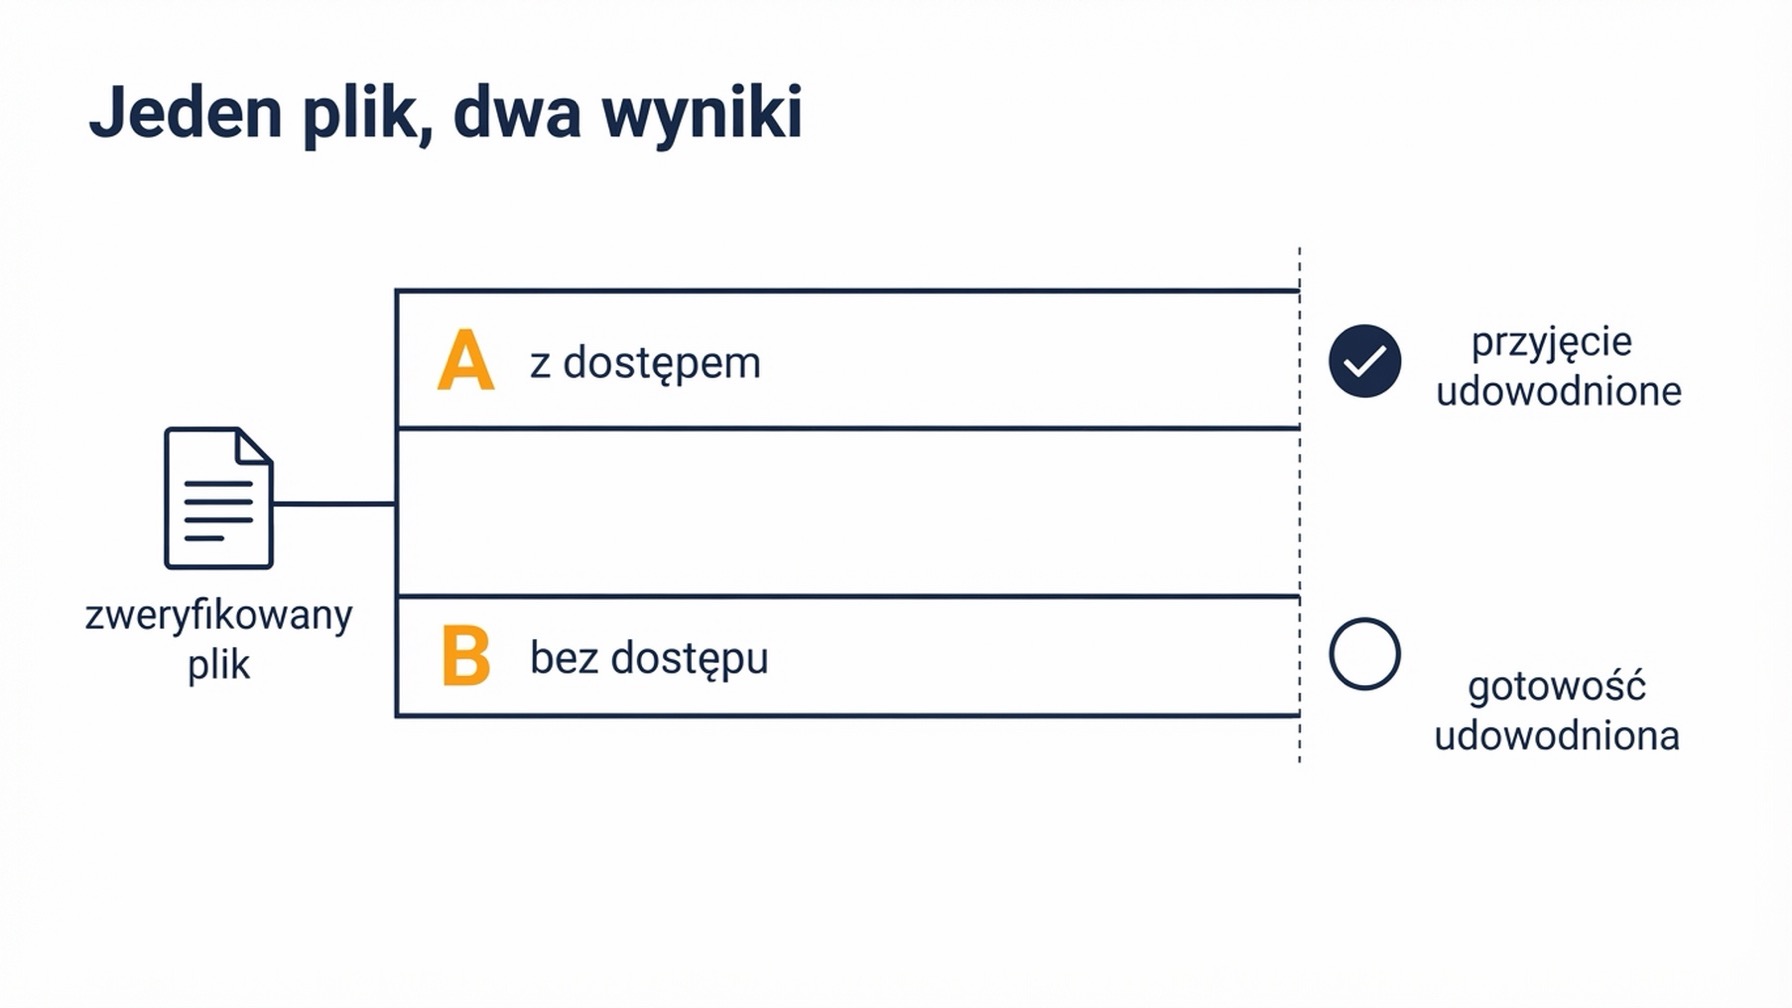
Tor A może udowodnić przyjęcie danych. Tor B może udowodnić gotowość. Ani tor, ani rozgałęzienie nie zmieniają pliku, i właśnie po to buduje się go, zanim ma się dostęp.
Jeśli masz dostęp (tor A)
Cztery kontrole. Twoja wysyłka została potwierdzona. Raport odrzuceń na poziomie wierszy został przeczytany, a każde odrzucenie rozwiązane albo zapisane. Próbkowe zapytanie zakupowe pokazuje teraz jeden z Twoich produktów. Logi serwera pokazują, jak agent wyszukiwania pobiera adresy URL produktów.
Jeśli nie masz (tor B)
Cztery kontrole. Pobranie robots.txt zwraca adres URL produktu dla OAI-SearchBot. Pobranie tego adresu po stronie serwera zawiera tytuł, cenę, dostępność i opis. Audyt dziewięciu kontroli przechodzi. Zamrożony eksport i przebieg kontroli są zapisane tam, gdzie następna osoba może je odtworzyć.
Gotowość jest prawdziwym, falsyfikowalnym wynikiem. Po prostu nie tym samym co przyjęcie danych, i nie powinieneś raportować jej tak, jakby była tym samym.
Jedna liczba, która liczy się na końcu
Linki wychodzące z ChatGPT niosą automatycznie utm_source=chatgpt.com. To czyni Twoją własną analitykę jedynym dowodem z pierwszej ręki, że kliknięcie nastąpiło. Skonfiguruj filtr teraz, zanim dane będą potrzebne.
Bądź jasny co do tego, co mierzy. To atrybucja ruchu z kliknięcia, a nie metryka widoczności. Produkt może być rekomendowany wiele razy i kliknięty zero razy, a produkt niekwalifikujący się nigdy nie może zostać kliknięty.
Czego ten workflow nie kontroluje
Nie kontroluje pozycjonowania wewnątrz zbioru feedu. Specyfikacja definiuje kontrakt wiersza. Nie definiuje reguły porządkowania. Przejście wszystkich kontroli pól czyni produkt kwalifikowalnym do pobrania. Nie mówi nic o tym, który z dziesięciu zgodnych wierszy zostanie pokazany. Badanie przywołane na początku mierzy źródło pobrania, a nie pozycjonowanie w obrębie pobranego zbioru.
Liczby z 10 lipca są obserwacyjne i pochodzą od jednego dostawcy. Opisują panel śledzonych zapytań Profound, a nie prawdziwe sesje kupujących czy ścieżki zakupowe. OpenAI nie potwierdziło zmiany ani nie ujawniło żadnego podziału źródeł pobrania. Wdrożenie GPT-6 Astra rozpoczęło się 3 września 2026 roku, co pokrywa się z późniejszym oknem pomiarowym w tym badaniu i jest prawdziwym czynnikiem zakłócającym.
Liczby o koncentracji niosą te same ograniczenia. Wzrost udziału odniesień do sklepów z pierwszej 10 z 22,5% do 41,8% oraz spadek liczby unikalnych sprzedawców z 13 524 do 10 607 pochodzą z tego samego panelu. A ustalenie, że zmiany źródła pobrania wyjaśniały 83% zmienności widoczności wśród 517 zmieniających się klientów, jest udziałem wyjaśnionym w obrębie panelu, a nie współczynnikiem przyczynowym, pod który można planować.
Niektóre twierdzenia krążące po blogach dostawców nie występują w specyfikacji. Każde z nich traktuj ostrożnie:
Twierdzenie | Źródło | Status |
|---|---|---|
Feedy odświeżają się co 15 minut, 96 razy częściej niż feedy dzienne | Blogi dostawców | Nie ma tego w specyfikacji OpenAI, która nie podaje żadnego rytmu |
Feedy to pełne migawki, a nie aktualizacje przyrostowe | Jeden dostawca, bez powołania na dokumentację OpenAI | Nierozstrzygnięte; potwierdź podczas onboardingu |
Wymagana jest próbka około 100 produktów | Blogi dostawców | Tekst pomocy OpenAI wspomina o początkowej próbce albo pełnym feedzie, bez podania liczby |
Wysyłka odbywa się przez SFTP | Jeden dostawca; inny mówi o szyfrowanym pushu HTTPS | Źródła są sprzeczne; mechanizm jest potwierdzany podczas onboardingu |
| Jedno zagregowane źródło | Nie ma ich na liście pól specyfikacji. Pola opinii w specyfikacji to |
Ustrukturyzowane feedy konwertują około dwa razy lepiej niż dane zeskrobane | Nieudokumentowane twierdzenie dostawcy | Nie planuj pod to |
Nie kontroluje tego, jak renderowany jest Twój tekst. ChatGPT może generować uproszczone tytuły i opisy produktów. A wyniki zakupowe są wybierane przez ChatGPT niezależnie i nie są reklamami, co odpowiada na pytanie o wpływy komercyjne, a nie o źródło pobrania. Jeśli zależy Ci na płatnej ekspozycji, OpenAI prowadzi osobno ścieżkę reklam budowaną z feedów produktowych. To inny workflow i ten artykuł nim nie jest.
FAQ
Czy mogę dziś wysłać feed produktowy do ChatGPT?
Nie na żądanie. Dostęp jest potwierdzany dla każdego sprzedawcy osobno, checkout wymaga osobno włączonej integracji, a standardowa wysyłka na razie dotyczy USA. Rejestracja dostarcza wyłącznie nazwę wyświetlaną sprzedawcy i możesz być zarejestrowany bez dostępu do wysyłki na żywo. Wykonaj powyższy test dostępu z czterech pytań, żeby określić swoją pozycję.
Jak często powinienem odświeżać feed?
Specyfikacja nie podaje żadnego rytmu. Dwa blogi dostawców twierdzą, że piętnaście minut, i ta liczba nie pojawia się w dokumentacji OpenAI. Praktyczna odpowiedź to oprzeć odświeżanie na własnych zdarzeniach ceny i dostępności, bo to jedyne dwie rzeczy, które specyfikacja wprost każe utrzymywać w aktualnym stanie.
Wysyłać pełny plik czy tylko wiersze, które się zmieniły?
Nierozstrzygnięte. Jeden dostawca twierdzi, że to pełne migawki, i nie powołuje się przy tym na żadną dokumentację OpenAI. Potwierdź to podczas onboardingu, zanim zbudujesz pipeline zależny od którejkolwiek odpowiedzi.
Czy wymóg próbki 100 produktów jest prawdziwy?
Tekst pomocy OpenAI wspomina o początkowej próbce albo pełnym feedzie bez podania liczby. Liczba 100 produktów pochodzi z blogów dostawców. Jeśli przygotowujesz próbkę, zrób ją reprezentatywną, pokrywając każdy przypadek grupy opcjonalnej, zamiast trafiać w konkretny licznik.
Czy dobry feed sprawi, że moje produkty będą wyżej w wynikach zakupowych ChatGPT?
Nie w sensie, który zwykle sugeruje to pytanie. Feed czyni produkt kwalifikowalnym i opisywalnym. Pozycjonowanie wewnątrz pobranego zbioru nie jest udokumentowane, a publiczne badanie mierzy źródło pobrania, a nie porządkowanie. Traktuj zgodność pól jako warunek wstępny, a nie dźwignię.
Czy potrzebuję tego, jeśli sprzedaję na Shopify?
Nie w przypadku podstawowej syndykacji, bo dane produktowe trafiają do ChatGPT przez Shopify Catalog bez pracy po stronie sprzedawcy. Bezpośredni feed służy świeżości i polom, których domyślne rozwiązanie nie przenosi.
Autor: Eva Laurent, Ecommerce Search Strategist for 10k+ Product Pages w Auspia. Eva pisze o wyszukiwaniu w e-commerce, odkrywaniu produktów i o tym, jak dane produktowe trafiają na zakupowe powierzchnie AI.