Що ви отримаєте в результаті
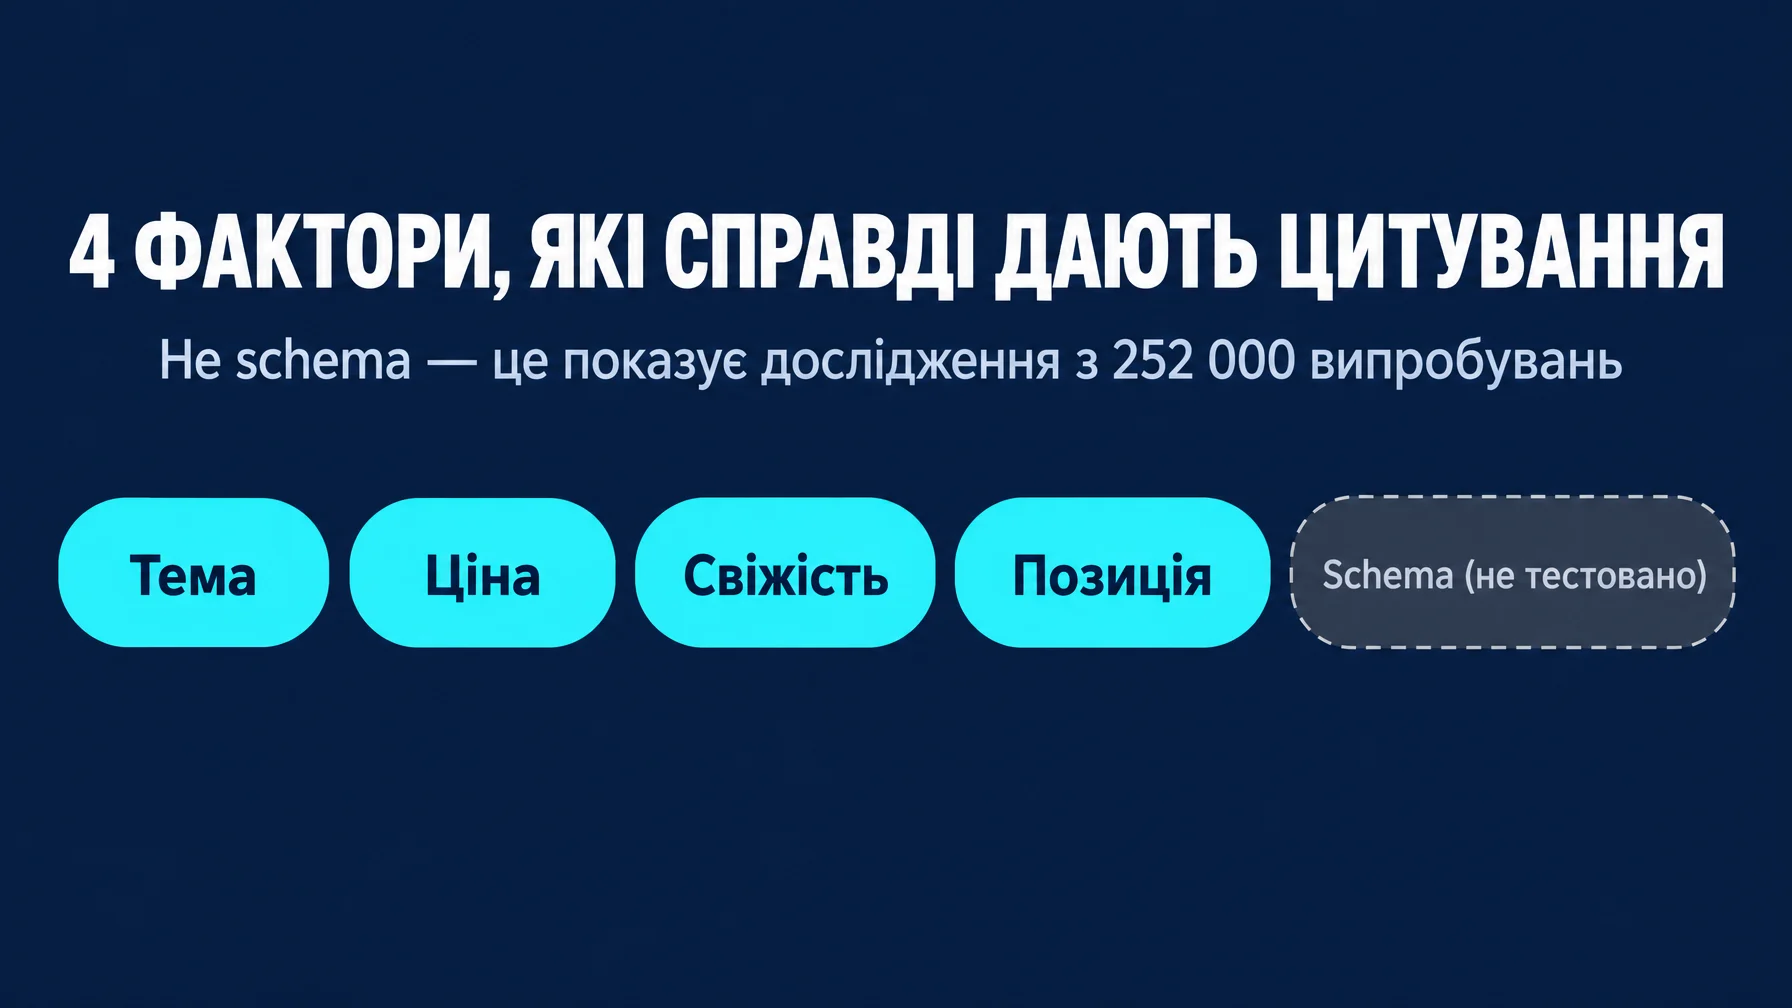
Аудит за сторінками за чотирма факторами, які контрольоване дослідження з 252 000 випробувань визначило як вирішальні для цитування в AI, а також порядок виправлення семи другорядних факторів, які починають працювати після того, як ці чотири на місці. Ви також дізнаєтеся з посиланнями на джерела, чому поширене твердження «розмітка schema ніяк не впливає на цитування в AI» не є реальним висновком того дослідження, і не витратите спринт на виправлення не того.
Для кого це: для всіх, хто відповідає за SEO або GEO на рівні сторінок для сайту, який хоче потрапляти в цитування в ChatGPT, Gemini, Perplexity, Claude або в AI-відповідях Google.
Потрібний час: 30–45 хвилин на сторінку, включно з аудитом і першим проходом виправлень.
Готово, коли: перевірена сторінка проходить усі чотири ключові фільтри, а у вас на руках письмовий список другорядних факторів, які ще потрібно виправити.
Перед початком: на чому ґрунтується цей чек-лист і що він виправляє
У колах SEO/GEO ходить допис, який стверджує, що дослідження SIGIR провело 252 000 випробувань на шести LLM і виявило, що розмітка schema та JSON-LD дають «нульовий виміряний ефект» на цитування в AI, тоді як ціна, свіжість, характеристики й глибина сильно рухають результат.
Дослідження реальне. Кількість випробувань правильна. Відношення шансів у тому дописі близькі до справжніх цифр. Не витримує перевірки одне: те дослідження ніколи не тестувало розмітку schema. Річ не в тому, що schema «показала нуль при вимірюванні», а в тому, що schema взагалі не було в списку того, що вимірювали.
Праця називається "What Gets Cited: Competitive GEO in AI Answer Engines" (Vishwakarma, Kumar, Jamidar, Sprinklr; SIGIR '26, Мельбурн). Дизайн подає рівно два джерела-кандидати в шість LLM (Gemini-2.5-Flash, Claude-3.5-Sonnet, Kimi-K2-Thinking і три варіанти GPT-5), кожна пара відрізняється рівно за одним із 18 факторів контенту, і фіксується, яке джерело процитовано першим. Ці 18 факторів охоплюють відповідність контенту, повноту, достовірність, читабельність, конкурентну позицію та свіжість. Формат структурованих даних відсутній серед цих 18 — це підтверджено прямим зіставленням із таблицею таксономії самої праці.
Якщо вам потрібна справжня відповідь щодо schema, вона приходить з іншого місця: контрольоване дослідження Ahrefs від травня 2026 року, яке порівняло 1 885 сторінок із доданим JSON-LD проти 4 000 підібраних контрольних сторінок. Результат — жодного значущого зростання цитування в Google AI Overviews (−4,6%, невелике, але статистично значуще зниження), Google AI Mode (+2,4%, незначуще) і ChatGPT (+2,2%, незначуще). Окремий тест searchVIU виявив, що ChatGPT, Claude, Perplexity, Gemini та Google AI Mode взагалі не читають JSON-LD, прихований Microdata чи прихований RDFa під час пошуку в реальному часі.
Тримайте ці дві речі окремо, перш ніж братися до аудиту: дослідження SIGIR каже, чому надавати пріоритет на сторінці. Дослідження Ahrefs каже, що schema не належить до цих пріоритетів саме щодо обсягу цитування, хоч і залишається важливою для розширених результатів і ясності сутностей в інших контекстах.
Крок 1: проведіть аудит за ключовими фільтрами
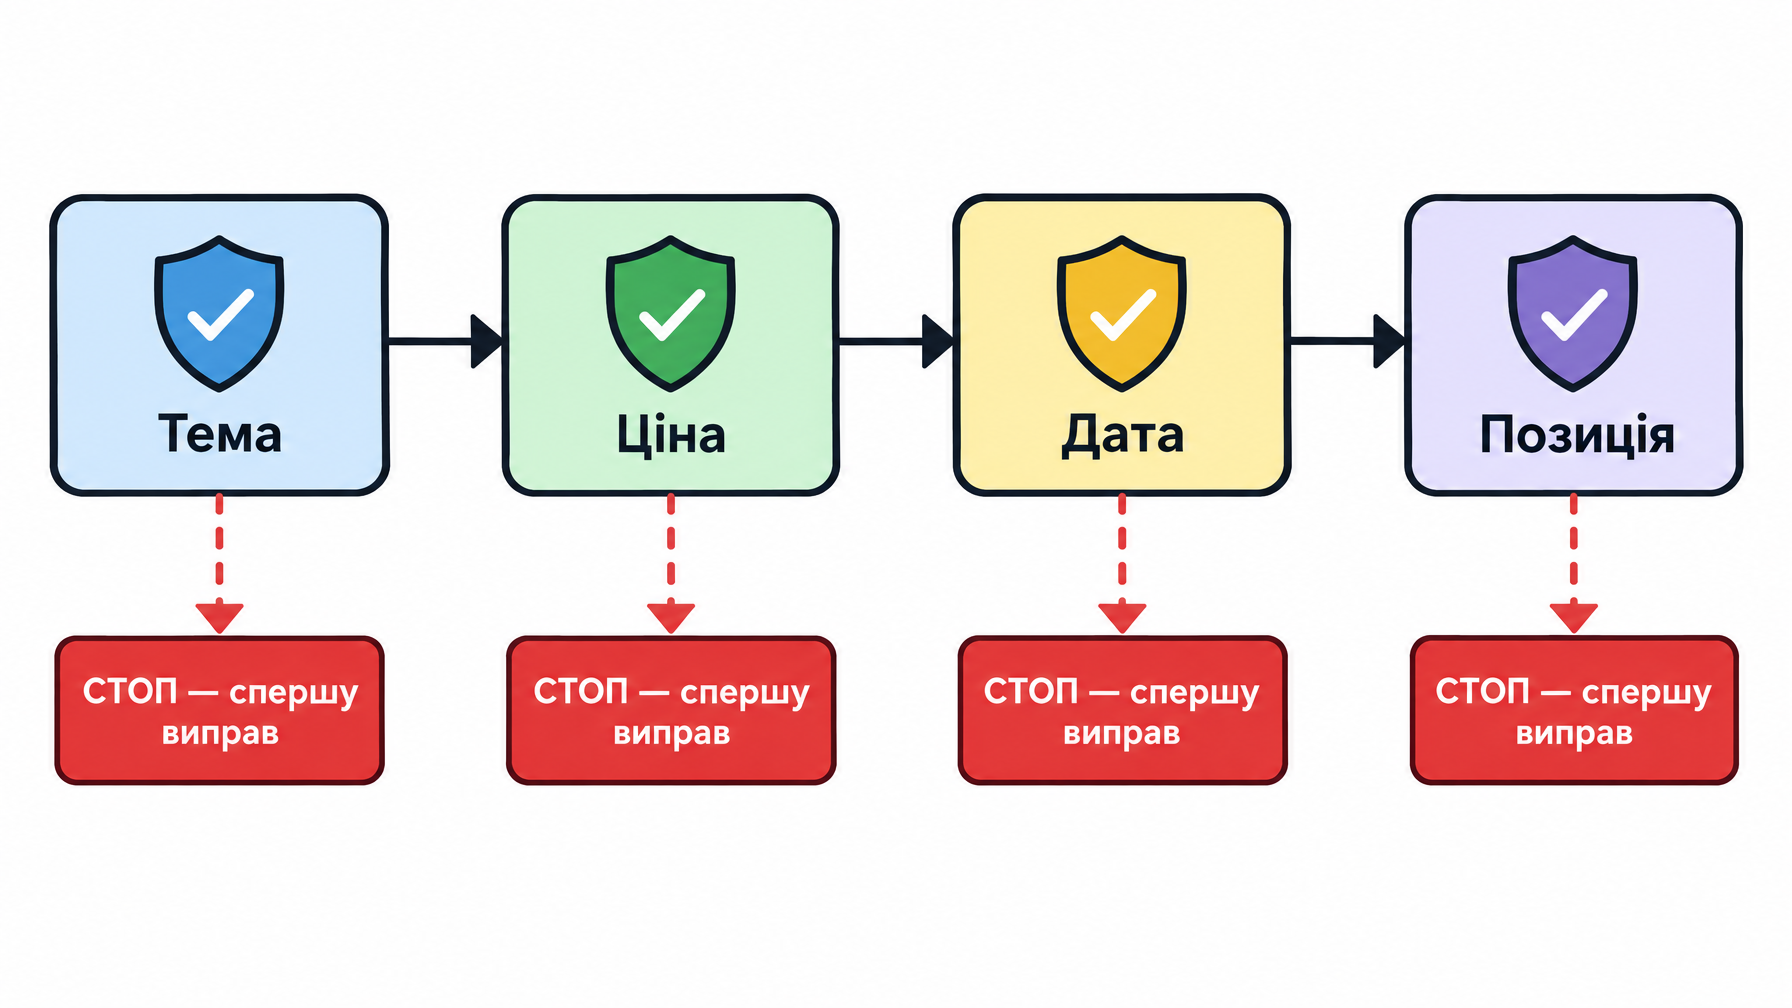
Перевірте свою сторінку за цими чотирма факторами. Дослідження SIGIR виявило, що всі чотири були одностайними на всіх шести моделях, з дуже великими ефектами (відношення шансів понад 100 у більшості моделей). Провал хоча б одного може обнулити шанси на цитування, хоч би якою сильною була решта сторінки.
Фільтр | Що перевіряємо | Діапазон відношення шансів (за шістьма моделями) |
|---|---|---|
Відповідність темі | Чи відповідає сторінка безпосередньо на запит, під який її просувають, а не на суміжну тему? | Вирішальний у 5 з 6 моделей |
Вказана ціна | Чи видно на сторінці конкретну ціну, а не сховано за «Зв'яжіться з нами»? | Від 6,26 до понад 10 000 |
Свіжа дата | Чи видно актуальну й точну дату публікації або останньої перевірки? | Від 14,4 до понад 10 000 |
Позиція в списку | Чи схильна сторінка посідати перше місце серед кандидатів за запитом, а не друге? | Від 1 795 до понад 10 000 |
Дія: відкрийте сторінку поруч із цільовим запитом. Прочитайте перші 150 слів і запитайте себе, чи відповідають вони на запит безпосередньо. Знайдіть ціну на сторінці; якщо для цього потрібна форма чи дзвінок — це провал. Порівняйте показану дату з тим, коли контент справді востаннє оновлювали. Перевірте свою поточну позицію або частку цитування за цим запитом.
Очікуваний результат: пройдено або провалено за кожним із чотирьох рядків.
Перевірка якості: якщо відповідність темі провалено, зупиніться тут — жоден наступний крок не врятує сторінку, яка відповідає не на те питання.
Шлях відновлення: провали за ціною та датою виправляються того ж дня (крок 2). Провал за позицією в списку — це не проблема контенту; це означає, що базові основи SEO треба підтягнути перш ніж сторінка взагалі зможе конкурувати за цитування, і жодне шліфування на сторінці цього не замінить.
Крок 2: спершу виправте ті фільтри, які не пройдено
Зробіть це, перш ніж чіпати будь-що інше. Це пункти з найбільшим важелем і найменшими зусиллями в усьому списку.
Якщо немає ціни: поставте фактичну цифру. Якщо ціна змінюється, опублікуйте реальну початкову ціну або чіткий діапазон замість форми зворотного зв'язку. Це був один із чотирьох ключових фільтрів у дослідженні.
Якщо дата застаріла або відсутня: оновіть дату публікації чи останньої перевірки, але лише після того, як ви справді переробили контент. Зміна дати без реального оновлення — це сигнал свіжості, який ви не зможете підтвердити, якщо хтось перевірить.
Якщо відповідність темі слабка: перепишіть перші 150 слів так, щоб вони відповідали на завдання цього запиту безпосередньо, а не на споріднену тему. Не прилаштовуйте новий вступ до старої структури — замініть його.
Перевірка якості: перечитайте сторінку так, ніби ви і є цей запит. Чи отримає стороння людина конкретну відповідь уже в першому абзаці?
Шлях відновлення: якщо реальну ціну опублікувати не можна (індивідуальні прорахунки, корпоративні угоди), опублікуйте репрезентативну початкову ціну або типовий діапазон замість порожнечі — дослідження вимірювало як стан провалу саме «ціну не згадано», а не «ціна змінюється».
Крок 3: опрацюйте другорядні фактори диференціації
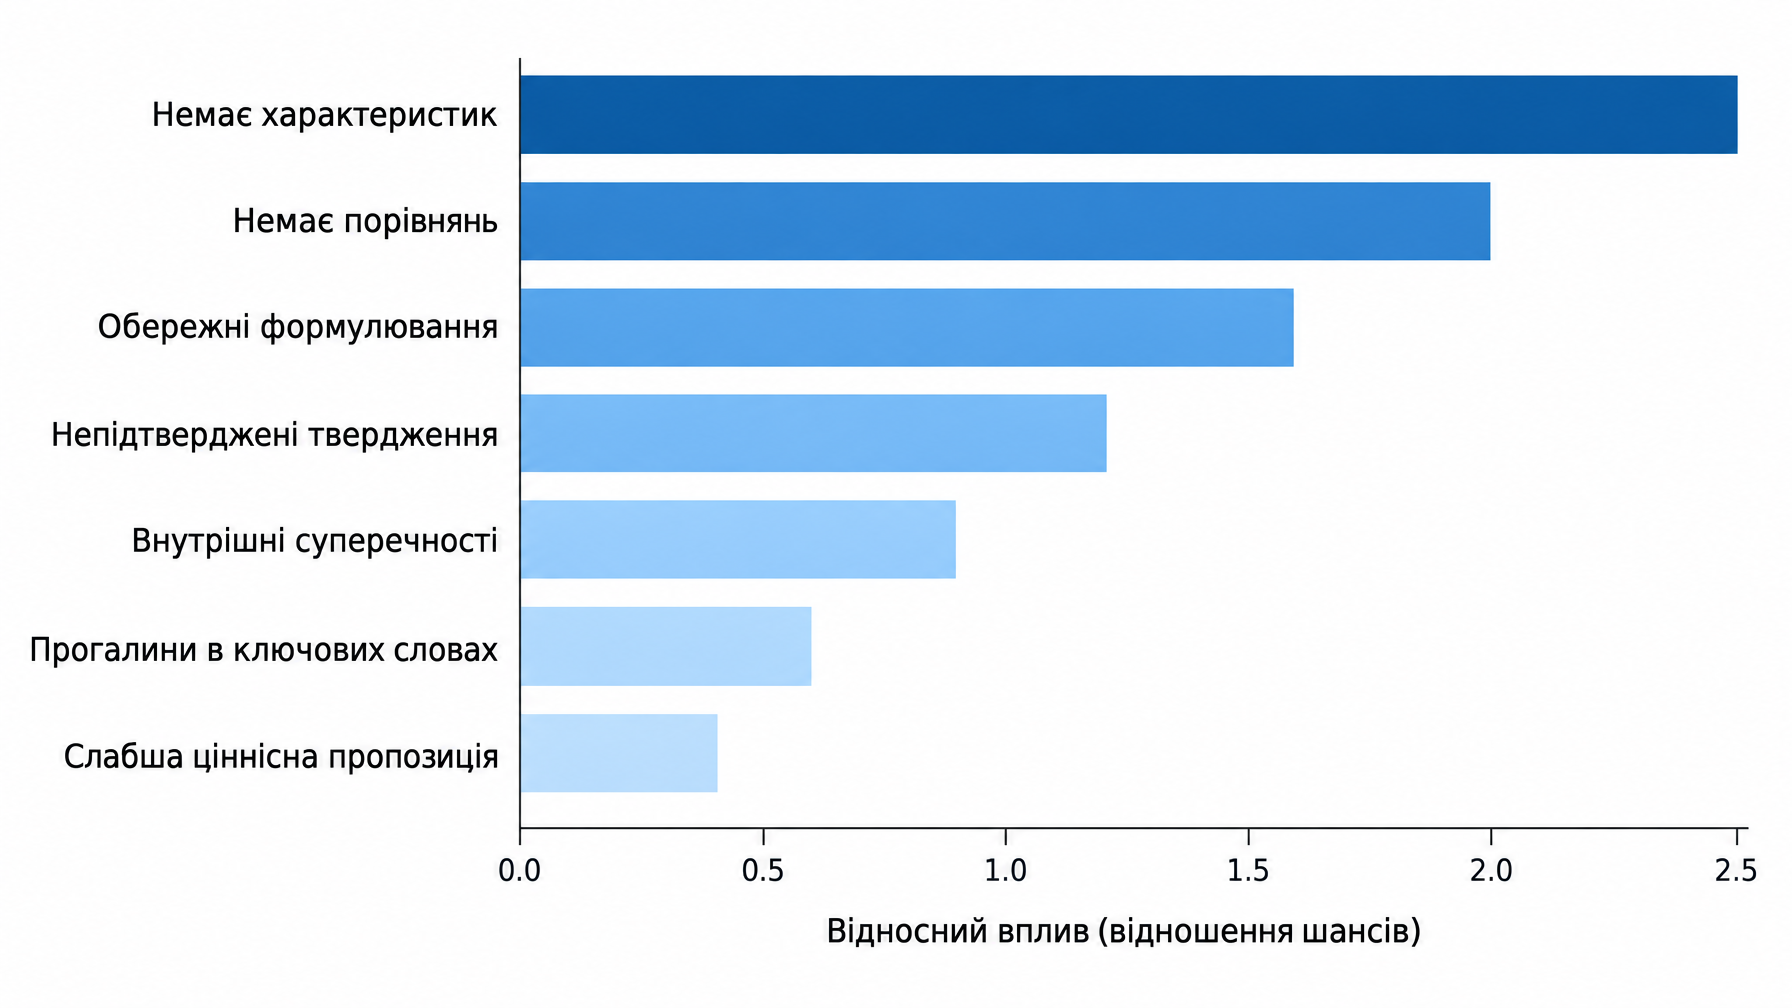
Коли чотири ключові фільтри пройдено, ці сім факторів дають другорядну диференціацію, з відношенням шансів приблизно від 2 до 243 залежно від моделі. Виправляйте їх у такому порядку:
- Відсутні характеристики. Додайте технічні характеристики, які покупець справді буде порівнювати (розміри, матеріали, ємність, сумісність). Відношення шансів від 8,63 до 243 за моделями — один із найбільших другорядних ефектів.
- Немає порівнянь. Додайте пряме порівняння принаймні з однією названою альтернативою. Відношення шансів від 1,61 до 7,45.
- Обережні формулювання. Замініть «можливо», «може бути», «ймовірно» на прямі впевнені твердження, які сторінка справді може підкріпити.
- Непідтверджені твердження. Додайте до тверджень докази: результати тестів, сертифікації, названу методологію.
- Внутрішні суперечності. Перевірте, що цифри й твердження узгоджуються між розділами однієї сторінки; це легко внести під час редагування й легко проґавити під час вичитки.
- Прогалини в ключових словах. Переконайтеся, що на сторінці справді є конкретні формулювання цільового запиту, а не лише синоніми.
- Слабша ціннісна пропозиція. Загостріть конкретне твердження про вигоду на тлі того, що пропонує сторінка конкурента.
Дія: йдіть списком згори вниз і виправляйте те, що застосовно. Не в кожної сторінки будуть усі сім проблем.
Очікуваний результат: сторінка, де кожне твердження або конкретне, або порівнянне, або підкріплене доказами.
Перевірка якості: чи знайде скептичний читач на сторінці хоч одне розпливчасте чи нічим не підкріплене речення?
Шлях відновлення: якщо часу обмаль, зупиніться після пунктів 1 і 2 (характеристики та порівняння) — у них найбільші відношення шансів із семи.
Крок 4: пропустіть зміни, що стосуються лише оформлення
Дослідження прямо показало, що немає сталого ефекту від перетворення абзаців на марковані списки, додавання підзаголовків для зручності читання або перевпорядкування розрізненої інформації, бо протестовані моделі розбирали контент незалежно від візуальної структури. Якщо ваша сторінка проходить перевірки вище, не витрачайте спринт на шліфування оформлення в надії на зростання цитування. Оформлюйте для своїх живих читачів, а не заради приросту цитування, якого дані не підтверджують.
Крок 5: залиште schema там, де їй місце
Тримайте розмітку schema технічно коректною, бо вона робить реальну роботу: допомагає Google і Bing розбирати розширені результати й дає пошуковим системам однозначне розуміння того, чим є сторінка та сутність. Чого вона не робить, згідно з найкращими доступними контрольованими даними, — так це не рухає шанси на цитування в AI. Не ставте роботу над schema попереду кроків 1–3 виходячи з думки, що це важіль цитування: жодне контрольоване дослідження цього не підтверджує, а єдине дослідження, на яке посилаються на підтримку цієї думки, schema взагалі не тестувало. Якщо хочете повний розбір того, що насправді вимірювало дослідження Ahrefs про schema, дивіться наш посібник із семантичного SEO 2026 року.
Перевірте готовий результат
Перезапустіть аудит із кроку 1 на сторінці після виправлень. Усі чотири фільтри тепер мають бути пройдені. Вибірково перевірте два-три другорядні фактори з кроку 3, які ви виправили. Якщо у вас є доступ до інструменту видимості в AI або відстеження цитування, наприклад AI Search Visibility Checker, зафіксуйте поточну частку цитування сторінки за цільовим запитом як базову позначку, перш ніж переходити до наступної сторінки, щоб потім можна було сказати, чи зміни щось зрушили.
Підтримуйте результат
Переперевіряйте фільтр за датою щоразу, коли на сторінці відбувається змістовне оновлення, а не за фіксованим календарем. Для сторінок, що втратили частку цитування, аудит робіть заново, починаючи з чотирьох ключових фільтрів, перш ніж припускати, що просів якийсь другорядний фактор.
Часті запитання
Чи тестувало дослідження SIGIR розмітку schema або JSON-LD? Ні. Його таксономія з 18 факторів охоплює відповідність контенту, повноту, достовірність, читабельність, конкурентну позицію, свіжість і позицію в списку. Формату структурованих даних немає ні серед категорій, ні серед протестованих факторів — це підтверджено прямим прочитанням таблиці таксономії праці.
То розмітка schema допомагає цитуванню в AI чи ні? Найкращі доступні контрольовані дані — дослідження Ahrefs від травня 2026 року, 1 885 сторінок проти 4 000 підібраних контрольних — не виявили значущого зростання цитування від додавання JSON-LD ні в Google AI Overviews, ні в Google AI Mode, ні в ChatGPT. Інший тест виявив, що кілька великих AI-моделей не читають структуровані дані під час пошуку в реальному часі. Це не робить schema марною в інших місцях; вона просто не є важелем обсягу цитування.
Звідки взялися конкретні цифри з вірального допису (6,3; 14; 4–8,6)? Вони схожі на справжні відношення шансів із таблиці результатів праці SIGIR, але ці цифри належать факторам ціни, свіжості та характеристик/порівнянь, а не schema. Праця наводить цифри за кожною моделлю, а не як одне усереднене значення, і діапазони суттєво різняться між шістьма протестованими LLM.
Що виправляти першим, якщо у мене лише година? Чотири ключові фільтри: відповідність темі, ціна, дата й позиція в списку. Провал будь-якого з них може обнулити шанси на цитування незалежно від усього іншого на сторінці.
Чи варто взагалі відмовитися від роботи над schema? Ні. Тримайте її коректною заради розширених результатів і ясності сутностей. Просто не ставте нову роботу над schema вище за виправлення чотирьох ключових фільтрів, якщо обсяг цитування в AI — справжня мета.
Автор: Bennett Hayes, Applied GEO Analyst в Auspia, понад 400 перевірок впроваджень. Bennett пише про практичне впровадження GEO, аудити та нотатки з упровадження, що ґрунтуються на тому, що контрольовані дослідження справді вимірювали.