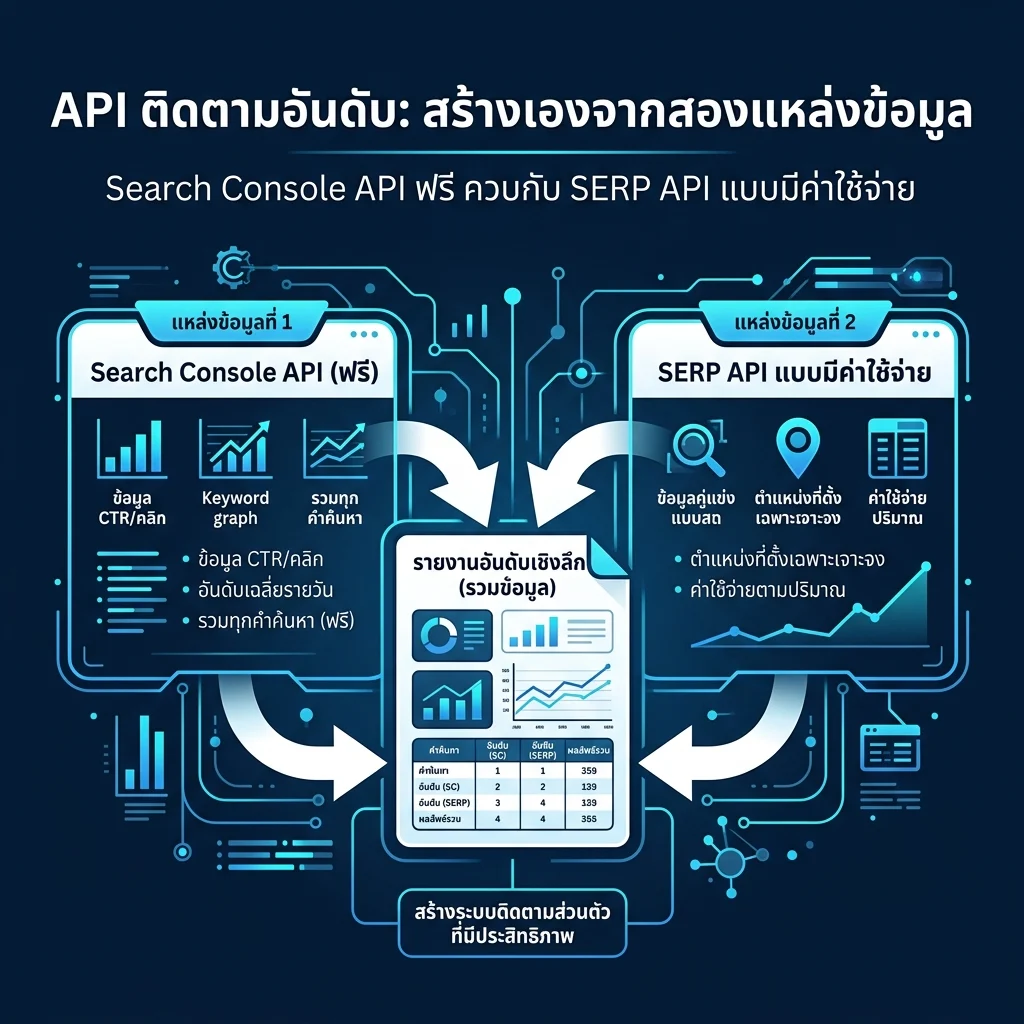
«API ติดตามอันดับ» ไม่ใช่สิ่งเดียว นักพัฒนาที่ค้นหา "rank tracking API" มักต้องการปลายทางเดียวที่คืนค่าอันดับ และตลาดก็ตอบด้วยบทความรวมเครื่องมือของผู้ขาย คำตอบที่ตรงไปตรงมาคือคุณต้องใช้สองแหล่ง และทั้งสองตอบคำถามคนละข้อ
Search Console API ฟรี เป็นทางการ และถูกจำกัดถาวรเฉพาะทรัพย์สินที่คุณยืนยันได้ ส่วน SERP API มีค่าใช้จ่าย ไม่เป็นทางการ และตรวจสอบคำค้นใดก็ได้ในที่ใดก็ได้ รวมถึงคำที่คุณไม่เคยติดอันดับเลย สักอย่างเดียวยังไม่ใช่เครื่องมือติดตามอันดับ แต่เมื่อรวมกันแล้วจะกลายเป็นโค้ด Python ราว 120 บรรทัดกับ cron อีกหนึ่งบรรทัด
นี่คือวิธีสร้าง มันตั้งสมมติฐานว่าคุณรันสคริปต์และเก็บไฟล์ได้ และไม่ได้ตั้งสมมติฐานว่าคุณอยากสร้างผลิตภัณฑ์
สิ่งที่คุณจะได้เมื่อทำเสร็จ
เหมาะกับใคร: นักพัฒนาหรือนักการตลาดสายเทคนิคที่มีสิทธิ์เข้า Search Console อยู่แล้ว และอยากได้อันดับตามรอบโดยไม่ต้องจ่ายรายที่นั่ง
สิ่งที่คุณจะมีเมื่อเสร็จ: ฟังก์ชันดึงข้อมูลสองตัวที่ใช้งานได้ ไฟล์ผลลัพธ์รวมหนึ่งไฟล์ต่อการรันหนึ่งครั้ง และกฎการเปรียบเทียบที่กันไม่ให้ตัวเลขโกหกคุณ
เวลา: ประมาณ 90 นาทีสำหรับการสร้างครั้งแรก หลังจากนั้นประมาณ 10 นาทีต่อการตรวจหนึ่งรอบ
หน้าตาของคำว่าเสร็จ: ไฟล์ JSON ที่มีวันที่กำกับ บรรจุอันดับของคุณเองแยกตามคำค้นและอุปกรณ์ พร้อมสแนปช็อต SERP สดของรายการคำค้นที่ตรึงไว้ และส่วนต่างสั้น ๆ เทียบกับการรันก่อนหน้า
ก่อนเริ่ม: แต่ละแหล่งทำอะไรได้และทำอะไรไม่ได้
แบ่งงานตรงนี้ให้ถูก ที่เหลือของการสร้างจะเป็นงานกลไก แบ่งผิดคุณจะเสียเวลาหนึ่งเดือนไปกับสิ่งที่ไร้ประโยชน์หรือแพงเกิน
Search Console API | SERP API | |
|---|---|---|
อันดับของใคร | เฉพาะทรัพย์สินที่คุณยืนยันแล้ว | ใครก็ได้ รวมถึงคู่แข่ง |
คำค้น | คำค้นที่คุณปรากฏอยู่แล้ว | คำค้นใดก็ได้ที่คุณพิมพ์ |
ค่าใช้จ่าย | ฟรี | คิดเงินตามคำขอ |
แยกตามอุปกรณ์ | ได้ ในฐานะมิติ | ได้ ตามคำขอ |
ภูมิภาค | ประเทศที่คุณติดอันดับ | ภูมิภาคใดก็ได้ที่ผู้ขายรองรับ |
ประเภทข้อมูล | ยอดคลิก การแสดงผล อันดับแบบรวม | หน้าผลลัพธ์ ณ ช่วงเวลาหนึ่ง |
ความลึกของประวัติ | ช่วงที่คุณขอ | ตั้งแต่บัญชีที่คุณเริ่มเก็บเท่านั้น |
สถานะความเป็นทางการ | ข้อมูลของ Google เอง | การอ่านหน้าสาธารณะโดยบุคคลที่สาม |
สองแหล่งจะขัดกัน และความขัดแย้งนั้นคือข้อมูล ไม่ใช่บั๊ก Search Console เฉลี่ยทุกการแสดงผลตลอดช่วงวันที่และทุกอุปกรณ์ ส่วนการดึง SERP คือหน้าผลลัพธ์หนึ่งหน้าในหนึ่งขณะ ถ้าเทียบกันตรง ๆ คุณจะไล่ตามการร่วงที่ไม่มีอยู่จริง นี่คือเหตุผลที่ขั้นที่ห้ากำหนดกฎการเปรียบเทียบ
สามตัวเลขที่ควรรู้ก่อนเขียนโค้ด Search Console API รับขีดจำกัดแถวระหว่าง 1 ถึง 25,000 ต่อคำขอ และค่าเริ่มต้นคือ 1,000 ฉะนั้นเว็บขนาดกลางดึงข้อมูลคำค้นและอุปกรณ์สามเดือนได้ในคำขอเดียว มันอนุญาต 1,200 คำขอต่อนาทีต่อเว็บไซต์และต่อผู้ใช้ และบังคับโควตาภาระที่วัดเป็นช่วงละ 10 นาที โดยช่วงวันที่ยาวมีต้นทุนสูงกว่าช่วงสั้น ซึ่งเป็นเหตุผลที่แนวทางของ Google เองบอกให้เลี่ยงการดึงข้อมูลชุดเดิมซ้ำ
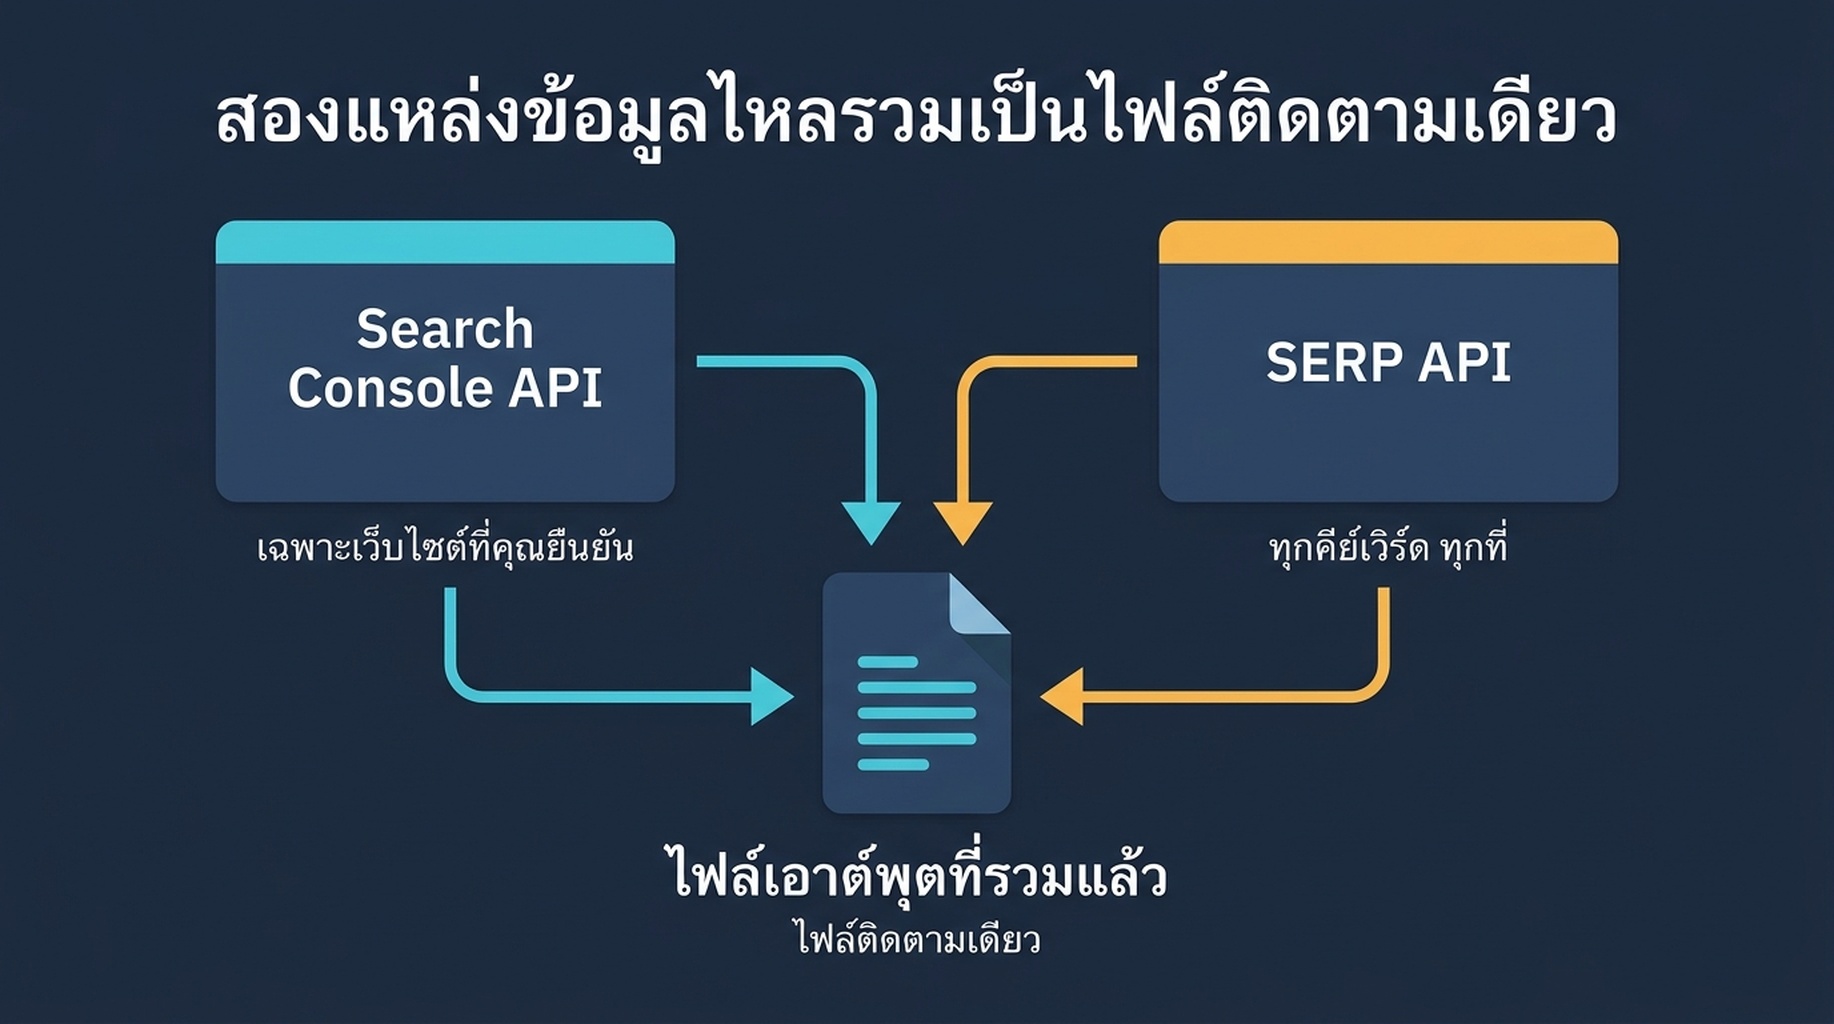
สองแหล่ง หนึ่งผลลัพธ์ Search Console ตอบว่า «ฉันปรากฏที่ไหน» ส่วน SERP API ตอบว่า «หน้าผลลัพธ์หน้าตาเป็นอย่างไร»
ขั้นที่ 1: ตรึงชุดคำค้นก่อนเขียนโค้ดบรรทัดแรก
เครื่องมือติดตามที่ดึงรายการคำค้นต่างกันทุกครั้งที่รันย่อมตอบไม่ได้ว่ามีอะไรเปลี่ยนไป เลือกรายการก่อนแล้วใช้ต่อหนึ่งไตรมาส
สามกลุ่ม และมาจากต่างที่กัน
- จาก Search Console: ทุกคำค้นที่มีการแสดงผลอย่างน้อย 20 ครั้งใน 90 วันล่าสุด คุณไม่ได้เป็นคนเลือกมัน แต่การแสดงผลของคุณเป็นตัวเลือก นี่คือกลุ่มที่การขยับมีความหมาย เพราะมีอุปสงค์ผูกอยู่แล้ว
- จากธุรกิจ: คำค้นสิบถึงยี่สิบคำที่โยงกับรายได้ ไม่ว่าคุณจะติดอันดับอยู่แล้วหรือยัง
- จากคู่แข่ง: คำค้นที่คู่แข่งติดอันดับและคุณไม่ติด กลุ่มนี้ต้องใช้ SERP API เพราะ Search Console จะไม่แสดงให้เห็นเลย
เขียนรายการลงไฟล์ ทำเวอร์ชัน และมองการเพิ่มว่าเป็นการเปลี่ยนแปลงโดยเจตนา ไม่ใช่การเลื่อนไหล
ขั้นที่ 2: ดึงอันดับของคุณเองแบบฟรี
ครึ่งนี้เป็นทางการ ฟรี และให้การแยกตามอุปกรณ์กับข้อมูลคลิกที่ SERP API ใดก็ไม่มี
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
สองรายละเอียดในคำขอนี้ทำงานเกือบทั้งหมด
dataState: "final" ตัดข้อมูลสดที่ Google อาจยังแก้ไขได้ ถ้าไม่มีมัน สองสามวันล่าสุดจะขยับไปมาระหว่างการรัน และส่วนต่างของคุณจะแสดงการเคลื่อนไหวที่ไม่เคยเกิดขึ้น
dimensions: ["query", "device"] คือสิ่งที่ทำให้ผลลัพธ์มีประโยชน์ในภายหลัง การเพิ่มอุปกรณ์ตอนนี้ไม่มีค่าใช้จ่าย ส่วนการดึงประวัติสามเดือนใหม่ภายหลังมีค่าใช้จ่ายเท่าการรันเต็มรอบหนึ่ง และไม่ได้อะไรตอบแทนสำหรับวันที่คุณข้ามไปแล้ว
ผลลัพธ์ที่คาดหวัง: หนึ่งแถวต่อคำค้นและอุปกรณ์ ประกอบด้วยคลิก การแสดงผล CTR และอันดับเฉลี่ย
ตรวจคุณภาพ: จำนวนแถวควรต่ำกว่า 25,000 ถ้าได้พอดี 25,000 แสดงว่าถูกตัด และต้องเรียกครั้งที่สองด้วย startRow: 25000
ถ้าล้มเหลว: 403 มักหมายความว่าอีเมลบัญชีบริการยังไม่ถูกเพิ่มเป็นผู้ใช้ในทรัพย์สิน เพิ่มใน Search Console รอสักสองสามนาที แล้วลองใหม่
ขั้นที่ 3: ดึง SERP ที่มองไม่เห็นในข้อมูลของคุณเอง
ครึ่งหลังครอบคลุมทุกอย่างที่ Search Console ทำไม่ได้เชิงโครงสร้าง นี่คือคำขอทำงานแบบน้อยที่สุด
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
ตั้ง `depth` เป็น 100 ไม่ใช่ 200 เรา ทดสอบเรื่องนี้เมื่อกันยายน 2026 ด้วยการขอ 200 ผลลัพธ์จากหกคำค้น Google คืนผลลัพธ์ออร์แกนิก 83 ถึง 128 รายการแล้วหยุด โดยอันดับที่ลึกที่สุดในทั้งการทดสอบอยู่ที่ 142 การทดสอบฉบับเต็มอยู่ที่นี่ การขอ 200 ไม่ได้ 200 ผลลัพธ์ และขึ้นกับผู้ขาย คุณอาจยังถูกคิดเงินตามความลึกที่ขอไป ขอ 100 แล้วคุณจะได้ทุกอย่างที่มีอยู่เกือบเสมอ
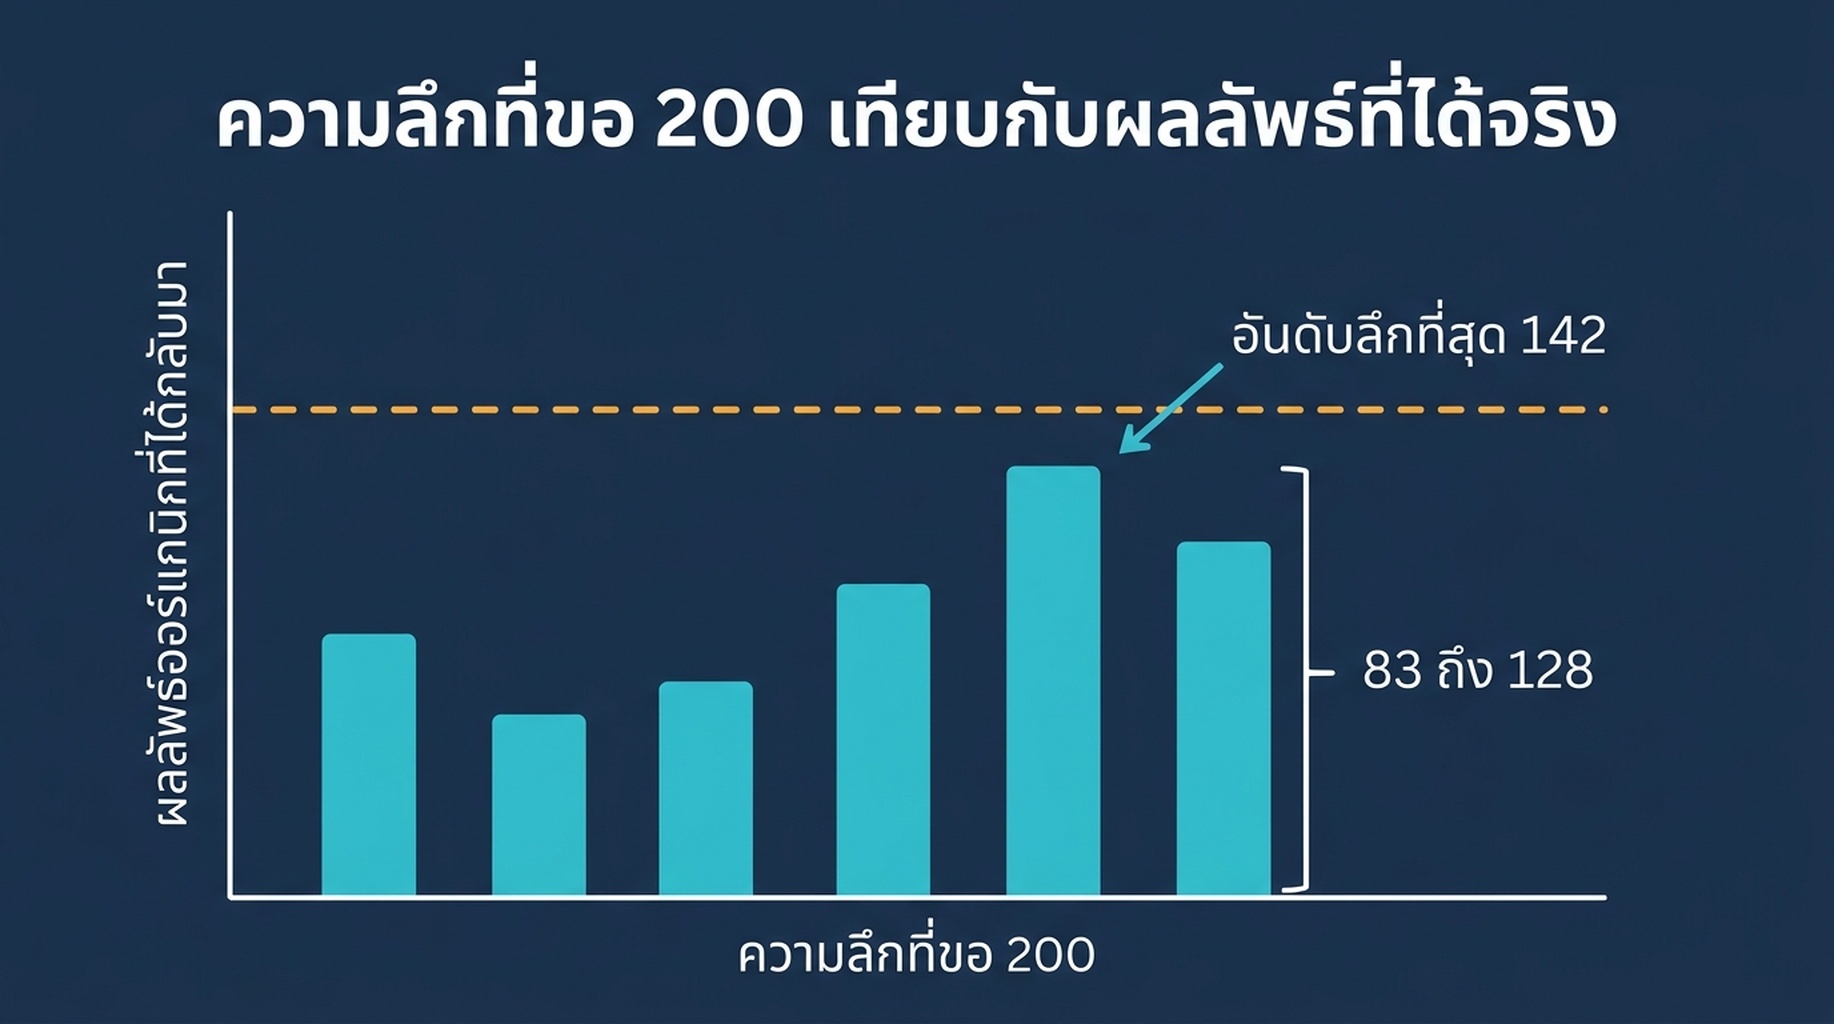
ขอ 200 ผลลัพธ์ ได้รับ 83 ถึง 128 ความลึกเกินราว 140 ไม่ได้อะไรเพิ่มในคำค้นเชิงพาณิชย์ส่วนใหญ่
ผลลัพธ์ที่คาดหวัง: เพย์โหลด JSON ที่มีรายการออร์แกนิกซึ่งมีอันดับ URL ชื่อเรื่อง และโดเมน
ตรวจคุณภาพ: ยืนยันว่าเพย์โหลดมีชนิดรายการ ai_overview เมื่อมี ถ้าคุณดึงเฉพาะรายการ organic คุณจะพลาดเหตุผลที่หน้าเว็บเสียคลิกไปทั้งที่อันดับยังอยู่
ถ้าล้มเหลว: 401 คือข้อผิดพลาด base64 หรือข้อมูลรับรอง โค้ดแนว 40200 หมายความว่ายอดเงินในบัญชีหมด ซึ่งเป็นความล้มเหลวที่พบบ่อยที่สุดในเดือนแรก
ขั้นที่ 4: เก็บเพย์โหลดดิบ ไม่ใช่บทสรุป
นี่คือการตัดสินใจที่คนมักเสียใจที่ข้ามไป
การเก็บตารางอันดับใช้ได้จนถึงวันที่คุณต้องถามคำถามที่ไม่ได้คาดไว้ เช่น หน้าผลลัพธ์ยาวขึ้นไหม วิดีโอเข้ามาครองไหม คู่แข่งเข้ามาไหม AI Overview ขึ้นเหนือเส้นพับไหม บทสรุปตอบคำถามเหล่านี้ไม่ได้ เพย์โหลดดิบตอบได้ ในต้นทุนเพิ่มเป็นศูนย์
เวอร์ชันใช้งานจริงคือ เขียนหนึ่งไฟล์ต่อการรันหนึ่งครั้ง ตั้งชื่อตามวันที่และเวลา บรรจุผลลัพธ์รวม เก็บไว้ 90 วันล่าสุด เล็กพอจะอยู่ในรีโปและครบพอจะตอบคำถามเก่าได้อีกครั้ง
ขั้นที่ 5: เขียนกฎการเปรียบเทียบก่อนตั้งเวลาอะไรทั้งสิ้น
เครื่องมือติดตามที่เทียบการรันก่อนกับรอบนี้จะสร้างสัญญาณเตือนเท็จเกือบทุกวัน ตัวเลขของเราเองแสดงเหตุผล ในการรัน 124 คำค้นที่มีการแสดงผลอย่างน้อย 30 ครั้ง คำค้นโดยเฉลี่ยขยับ 4.57 อันดับจากวันหนึ่งไปอีกวัน ตกสี่อันดับคือเรื่องปกติของวันอังคาร
ดังนั้นกฎต้องมีเกณฑ์ขั้นต่ำและทิศทาง
รายงานคำค้นเฉพาะเมื่อ:
  - ค่าสัมบูรณ์ของการเปลี่ยนอันดับเทียบกับการรันก่อนหน้าตั้งแต่ 5 ขึ้นไป และ
  - คำค้นนั้นมีการแสดงผลอย่างน้อย 20 ครั้งในช่วงเปรียบเทียบ และ
  - การเปลี่ยนแปลงนั้นไม่ได้อธิบายได้ด้วยการเปลี่ยนสัดส่วนอุปกรณ์

จัดกลุ่มผลลัพธ์ตามชั้นของคำค้น: money, comparison, brand, informational
อย่าเสนอวิธีแก้ไข
เงื่อนไขเรื่องอุปกรณ์ไม่ใช่ของประดับ คำค้นเดียวกันห่างกันได้ถึง 11 อันดับระหว่างมือถือกับเดสก์ท็อป และถ้าสัดส่วนอุปกรณ์ขยับระหว่างการรัน ตัวเลขผสมก็ขยับตาม เราวัดเรื่องนี้แยกไว้ และมันใหญ่พอจะปลอมแนวโน้มได้
ค่าใช้จ่าย
ราคาผู้ขายเปลี่ยนได้ ฉะนั้นจงสร้างแบบจำลองแทนการไล่ตามใบเสนอราคา
- คำค้นหนึ่งคำตรวจวันละครั้งเป็นเวลา 30 วัน คือ 30 คำขอต่อเดือน
- ชุด 200 คำค้นตรวจทุกวัน คือ 6,000 คำขอต่อเดือน
- ชุดเดิมตรวจทุกสัปดาห์ คือราว 860 คำขอต่อเดือน
- ครึ่งของ Search Console ฟรี และเป็นหนึ่งคำขอต่อหนึ่งวิว ไม่ว่าข้างในจะมีกี่คำค้น
การคูณนี้คือการตัดสินใจทั้งหมด คำถามว่า «ควรซื้อเครื่องมือไหม» เกือบทุกครั้งยุบลงเหลือแค่นี้ คำนวณคำขอต่อเดือน คูณราคาต่อคำขอของคุณ แล้วเทียบกับค่าลิขสิทธิ์รายที่นั่ง การติดตามชุดคำค้นใหญ่แบบรายวันมักถูกกว่าถ้าเป็นสมาชิก ส่วนการติดตามชุดเล็กแบบรายสัปดาห์มักถูกกว่าถ้าใช้ API ติดตามรายการที่ตรึงไว้แล้วฝั่ง API จะยังเล็กอยู่
เมื่อไรควรซื้อแทนที่จะสร้าง
สร้างถ้าคุณอยากได้อันดับในไปป์ไลน์ของตัวเอง มีข้อมูลรับรอง SERP API อยู่แล้ว หรือต้องการหน้าผลลัพธ์ดิบด้วยเหตุผลอื่นนอกเหนือจากอันดับ
ซื้อแทนถ้าคุณต้องการอันดับย้อนหลังก่อนวันนี้ ต้องการสิภูมิภาคกับห้าอุปกรณ์สำหรับคำค้นชุดเดียวกัน หรือไม่มีใครในทีมดูแล cron บทความรวมเครื่องมือของผู้ขายมีค่าอ่านด้วยเหตุผลนี้เอง และการถือโครงสร้างพื้นฐานที่หยุดทำงานเมื่อคนสร้างย้ายทีมมีต้นทุนจริง
ถ้าผลลัพธ์ที่คุณต้องการจริง ๆ คือรายงานรายสัปดาห์แบบเป็นลายลักษณ์อักษรไม่ใช่ไฟล์ JSON เวิร์กโฟลว์รายงานใน Codex เริ่มจากสองแหล่งเดิมและจบที่เอกสาร ส่วนการแจ้งเตือนเหนือไฟล์ขึ้นไป คู่มือออกแบบระบบมอนิเตอร์ ครอบคลุมเรื่องเกณฑ์
มุมมอง Auspia: คำถามเรื่อง API ติดตามอันดับแท้จริงคือคำถามเรื่องความเป็นเจ้าของข้อมูล Search Console ให้ข้อมูลทางการเกี่ยวกับทรัพย์สินของคุณฟรี และจะให้อย่างนั้นตลอดไป ที่เหลือคือสแนปช็อตที่คุณจ่ายเงินซื้อ สร้างครึ่งที่ฟรีก่อน แล้วเติมครึ่งที่มีค่าใช้จ่ายเฉพาะจุดที่มันตอบคำถามที่คุณมีจริง
คำถามที่พบบ่อย
Google มี API ติดตามอันดับไหม ไม่มีแบบสาธารณะ Search Console API คืนอันดับเฉลี่ยของคุณสำหรับคำค้นที่คุณปรากฏอยู่แล้ว ซึ่งใกล้เคียงแต่ไม่ใช่สิ่งเดียวกัน มันตรวจคำค้นที่คุณไม่ติดอันดับไม่ได้ และตรวจคู่แข่งไม่ได้
SERP API ลงลึกได้แค่ไหน ผู้ขายรับค่าความลึกเกิน 200 ได้มาก แต่ Google หยุดให้ผลลัพธ์ราว 100 ถึง 140 ในคำค้นเชิงพาณิชย์ส่วนใหญ่ ขอมากกว่าไม่ได้ผลลัพธ์มากกว่า
ควรตรวจรายวันหรือรายสัปดาห์ รายสัปดาห์สำหรับชุดคำค้นทั่วไป รายวันเฉพาะรายการคำค้นทำเงินสั้น ๆ การตรวจรายวันบนชุดใหญ่ทำให้ต้นทุนคูณเจ็ดและส่วนใหญ่เป็นการวัดสัญญาณรบกวน เพราะการขยับเฉลี่ยต่อวันในข้อมูลของเราคือ 4.57 อันดับ
ทำไมตัวเลขจาก API ต่างจากเครื่องมือติดตามอันดับของฉัน อุปกรณ์ต่าง ภูมิภาคต่าง ช่วงเวลาต่าง และบ่อยครั้งแหล่งข้อมูลก็ต่าง ตัวเลขนั้นคือตัวอย่าง จงตรึงภูมิภาคและอุปกรณ์ในคำขอแล้วดึงใหม่ก่อนจะสรุปว่ามีอะไรเปลี่ยน
ให้เอเจนต์รันแทนได้ไหม ได้ และเหมาะมากเพราะงานมีรูปแบบเดิมทุกครั้ง ภาพรวมว่าเอเจนต์รับงานด้านอันดับได้แค่ไหนดูได้ที่คู่มือภาคสนามว่าด้วยเอเจนต์ SEO เก็บกฎการเปรียบเทียบไว้ในไฟล์คำสั่งและให้เอเจนต์ผลิตส่วนต่าง ส่วนการตัดสินใจสร้างหรือซื้อให้เป็นของคน
ผู้เขียน: Rowan Blake นักวิเคราะห์ระบบอัตโนมัติด้านเนื้อหาของ Auspia ดูแลไปป์ไลน์การเผยแพร่มากกว่า 100 ราย เธอเขียนเกี่ยวกับไปป์ไลน์ข้อมูลอัตโนมัติ การรายงานตามรอบ และต้นทุนการดูแลระบบที่ทำงานแทนคุณ