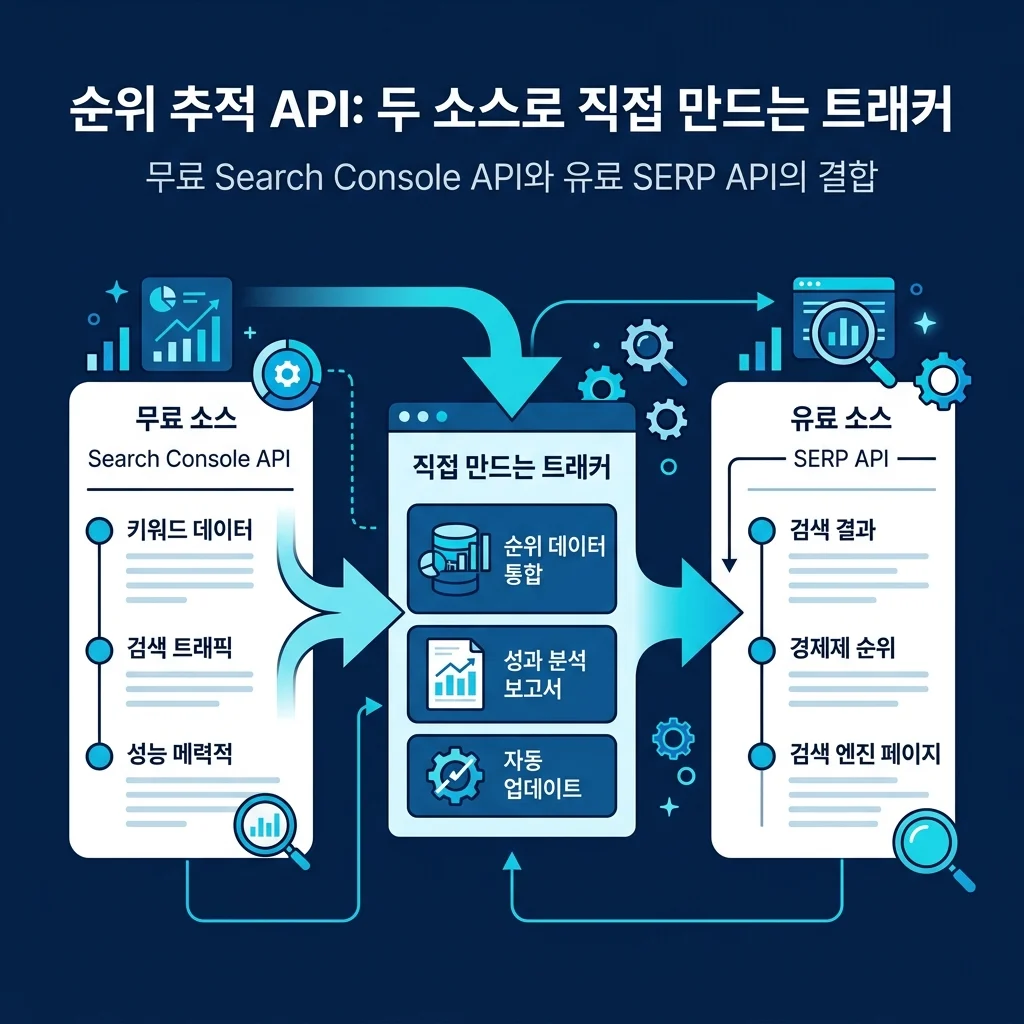
'랭크 트래킹 API'는 하나가 아닙니다. 개발자가 "rank tracking API"를 검색할 때 보통 원하는 것은 순위를 돌려주는 단일 엔드포인트이고, 시장은 벤더 목록 글로 답합니다. 정직한 답은 이렇습니다. 두 개의 출처가 필요하고, 둘은 서로 다른 질문에 답합니다.
Search Console API는 무료이고 공식이며, 인증할 수 있는 속성으로 영구히 제한됩니다. SERP API는 유료이고 비공식이며, 한 번도 순위에 든 적 없는 키워드를 포함해 어디서든 어떤 키워드든 확인할 수 있습니다. 어느 하나만으로는 랭크 트래커가 아닙니다. 둘을 합치면 약 120줄의 파이썬과 cron 한 줄입니다.
이것이 그 구축 과정입니다. 스크립트를 돌리고 파일을 저장할 수 있다고 가정합니다. 제품을 만들고 싶은 것은 아니라고 가정합니다.
완성하면 남는 것
대상 독자: 이미 Search Console 접근 권한이 있고, 좌석당 요금을 내지 않으면서 정기적으로 순위를 받고 싶은 개발자나 기술 마케터.
완료 시 손에 있는 것: 동작하는 두 개의 수집 함수, 실행 한 번당 하나의 병합 출력 파일, 그리고 숫자가 거짓말하지 못하게 막는 비교 규칙.
시간: 첫 구축에 약 90분, 이후 실행 한 번당 약 10분의 검토.
완료된 모습: 쿼리별·기기별 자사 순위와, 고정한 키워드 목록의 실시간 SERP 스냅샷, 그리고 직전 실행 대비 짧은 차이를 담은 날짜가 붙은 JSON 파일.
시작하기 전에: 각 출처가 할 수 있는 것과 없는 것
이 분담만 제대로 하면 나머지 구축은 기계적입니다. 틀리면 쓸모없거나 값비싼 것을 만드는 데 한 달을 씁니다.
Search Console API | SERP API | |
|---|---|---|
누구의 순위인가 | 인증한 자사 속성만 | 경쟁사 포함 누구나 |
키워드 | 이미 노출되는 쿼리 | 입력하는 모든 키워드 |
비용 | 무료 | 요청당 과금 |
기기 분할 | 가능(디멘션으로) | 가능(요청마다) |
지역 | 순위가 잡히는 국가 | 벤더가 지원하는 모든 지역 |
데이터 유형 | 클릭·노출·평균 게재순위 집계 | 특정 시점의 검색결과 페이지 |
이력 깊이 | 요청한 기간 | 저장을 시작한 날부터만 |
공식성 | Google 자체 데이터 | 제3자가 공개 페이지를 읽은 것 |
두 출처는 어긋나며, 그 어긋남은 버그가 아니라 정보입니다. Search Console은 기간 내 모든 노출과 모든 기기를 평균합니다. SERP 수집은 한 순간의 검색결과 페이지 하나입니다. 둘을 직접 비교하면 존재하지 않는 하락을 쫓게 됩니다. 그래서 5단계에서 비교 규칙을 정의합니다.
코드를 쓰기 전에 알아둘 세 가지 숫자. Search Console API는 요청당 1~25,000행 한도를 받아들이고 기본값은 1,000입니다. 따라서 중간 규모 사이트는 쿼리와 기기 데이터 3개월치를 한 번의 호출로 가져올 수 있습니다. 사이트당·사용자당 분당 1,200쿼리를 허용합니다. 그리고 10분 단위로 측정되는 부하 할당량을 적용하는데, 긴 기간이 짧은 기간보다 더 비쌉니다. Google 자체 가이드가 같은 데이터를 다시 조회하지 말라고 하는 이유가 바로 이것입니다.
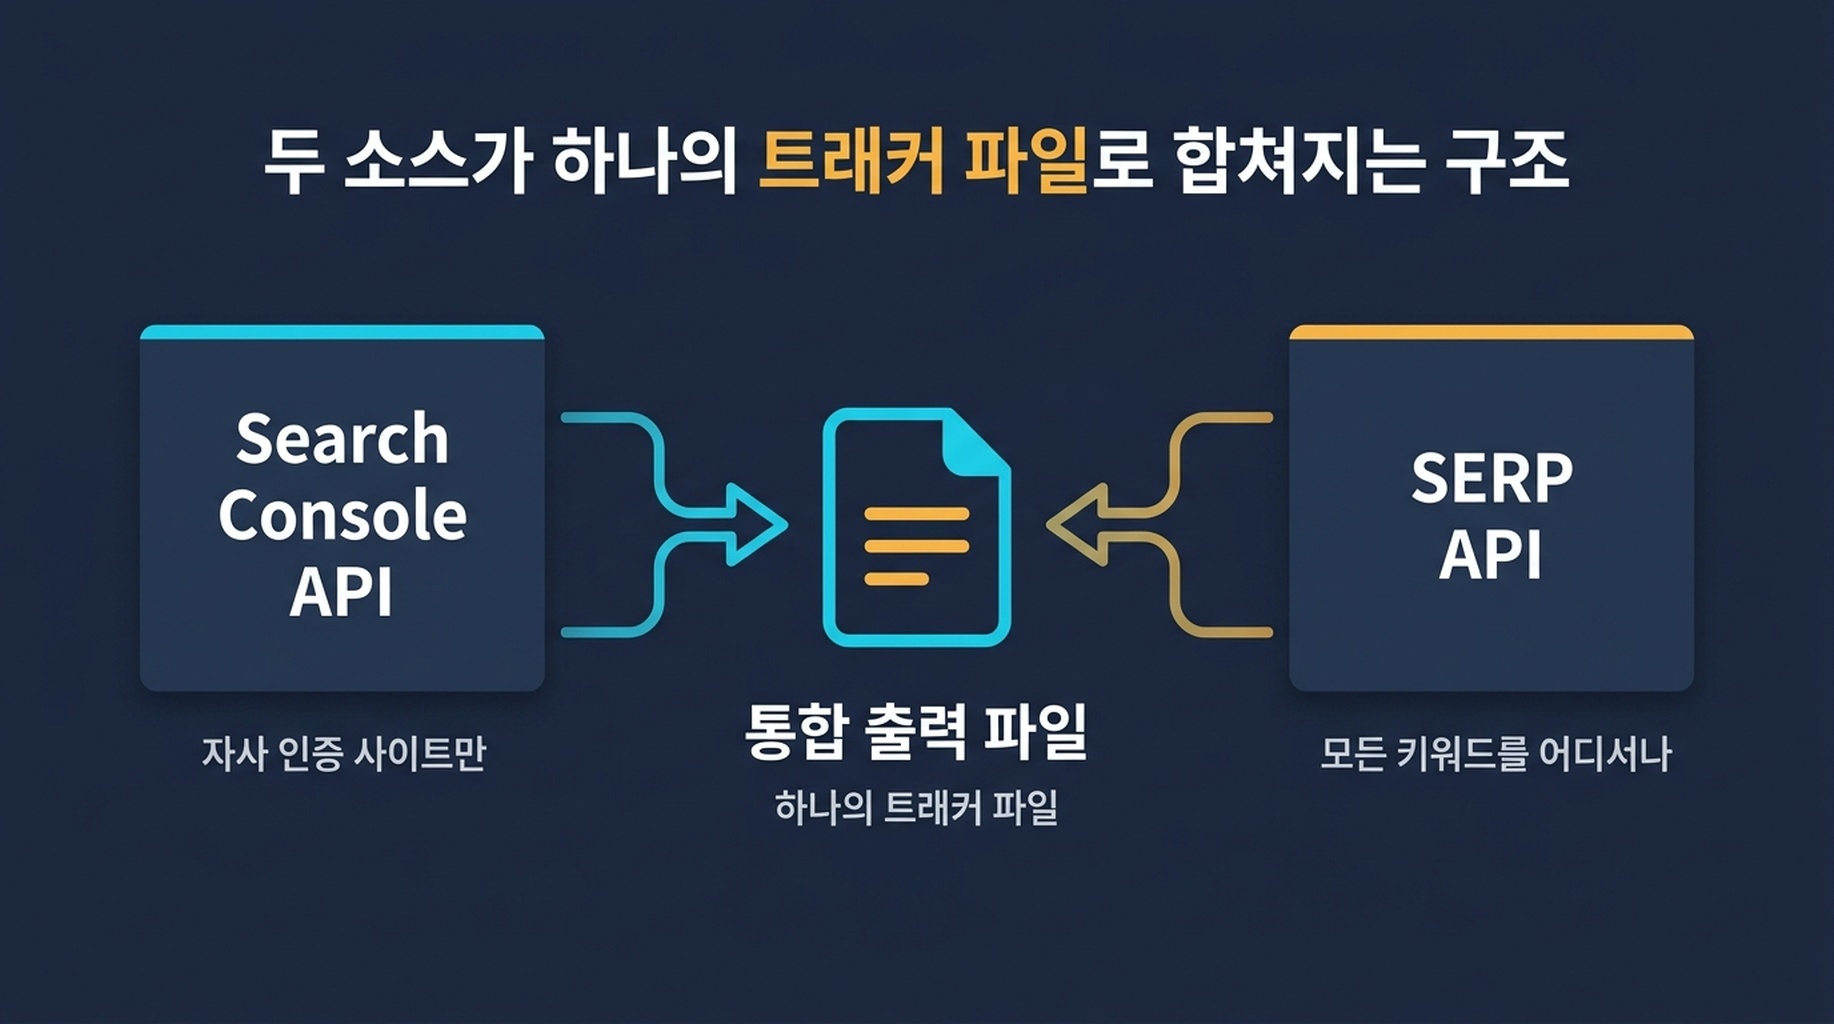
두 출처, 하나의 출력. Search Console은 "내가 어디에 나타나는가"에, SERP API는 "페이지가 어떻게 보이는가"에 답합니다.
1단계: 코드를 쓰기 전에 키워드 집합을 고정한다
실행마다 다른 키워드 목록을 가져오는 트래커는 무엇이 바뀌었는지에 답할 수 없습니다. 먼저 목록을 고르고 한 분기 동안 유지하세요.
세 그룹이 있고, 출처가 각각 다릅니다.
- Search Console에서: 지난 90일 동안 노출이 20 이상인 모든 쿼리. 이것은 내가 고르는 것이 아니라 노출이 고릅니다. 이미 수요가 붙어 있으므로 변동이 의미를 갖는 그룹입니다.
- 비즈니스에서: 매출에 대응하는 10~20개의 쿼리. 아직 순위에 들지 않았어도 됩니다.
- 경쟁사에서: 경쟁사는 순위에 들고 나는 들지 못한 쿼리. Search Console은 절대 보여주지 않으므로 SERP API가 필요합니다.
목록을 파일로 쓰고 버전을 관리하며, 추가는 표류가 아니라 의도적 변경으로 다루세요.
2단계: 내 순위를 무료로 가져온다
이 절반은 공식이고 무료이며, 어떤 SERP API에도 없는 기기 분할과 클릭 데이터를 줍니다.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
이 요청의 두 가지 세부가 일의 대부분을 합니다.
dataState: "final"은 Google이 아직 수정할 수 있는 최신 데이터를 제외합니다. 이것이 없으면 최근 2~3일치가 실행마다 움직여, 실제로 일어나지 않은 변동이 차이에 나타납니다.
dimensions: ["query", "device"]가 나중에 출력을 쓸모 있게 만드는 부분입니다. 지금 기기를 더하는 것은 무료입니다. 나중에 3개월 이력을 다시 가져오는 것은 실행 한 번 값이 들고, 이미 건너뛴 날에 대해서는 아무것도 얻지 못합니다.
예상 출력: 쿼리와 기기 조합마다 한 행, 클릭·노출·CTR·평균 게재순위 포함.
품질 점검: 행 수가 25,000 미만이어야 합니다. 정확히 25,000이면 잘린 것이고 startRow: 25000을 붙인 두 번째 호출이 필요합니다.
실패하면: 403은 대개 서비스 계정 이메일이 속성 사용자로 추가되지 않았다는 뜻입니다. Search Console에서 추가하고 몇 분 기다린 뒤 재시도하세요.
3단계: 자사 데이터로는 보이지 않는 SERP를 가져온다
후반부는 Search Console이 구조적으로 못 하는 모든 것을 다룹니다. 이것은 최소한의 동작하는 호출입니다.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
`depth`는 200이 아니라 100으로 두세요. 우리는 2026년 9월 여섯 개 쿼리로 200건을 요청해 이것을 검증했습니다. Google은 83~128건의 오가닉 결과를 반환하고 멈췄고, 테스트 전체에서 가장 깊은 순위는 142였습니다. 전체 검증은 여기에 있습니다. 200을 요청해도 200건이 오지 않으며, 벤더에 따라 요청한 깊이만큼 계속 과금될 수 있습니다. 100을 요청하면 존재하는 것은 거의 항상 전부 받습니다.
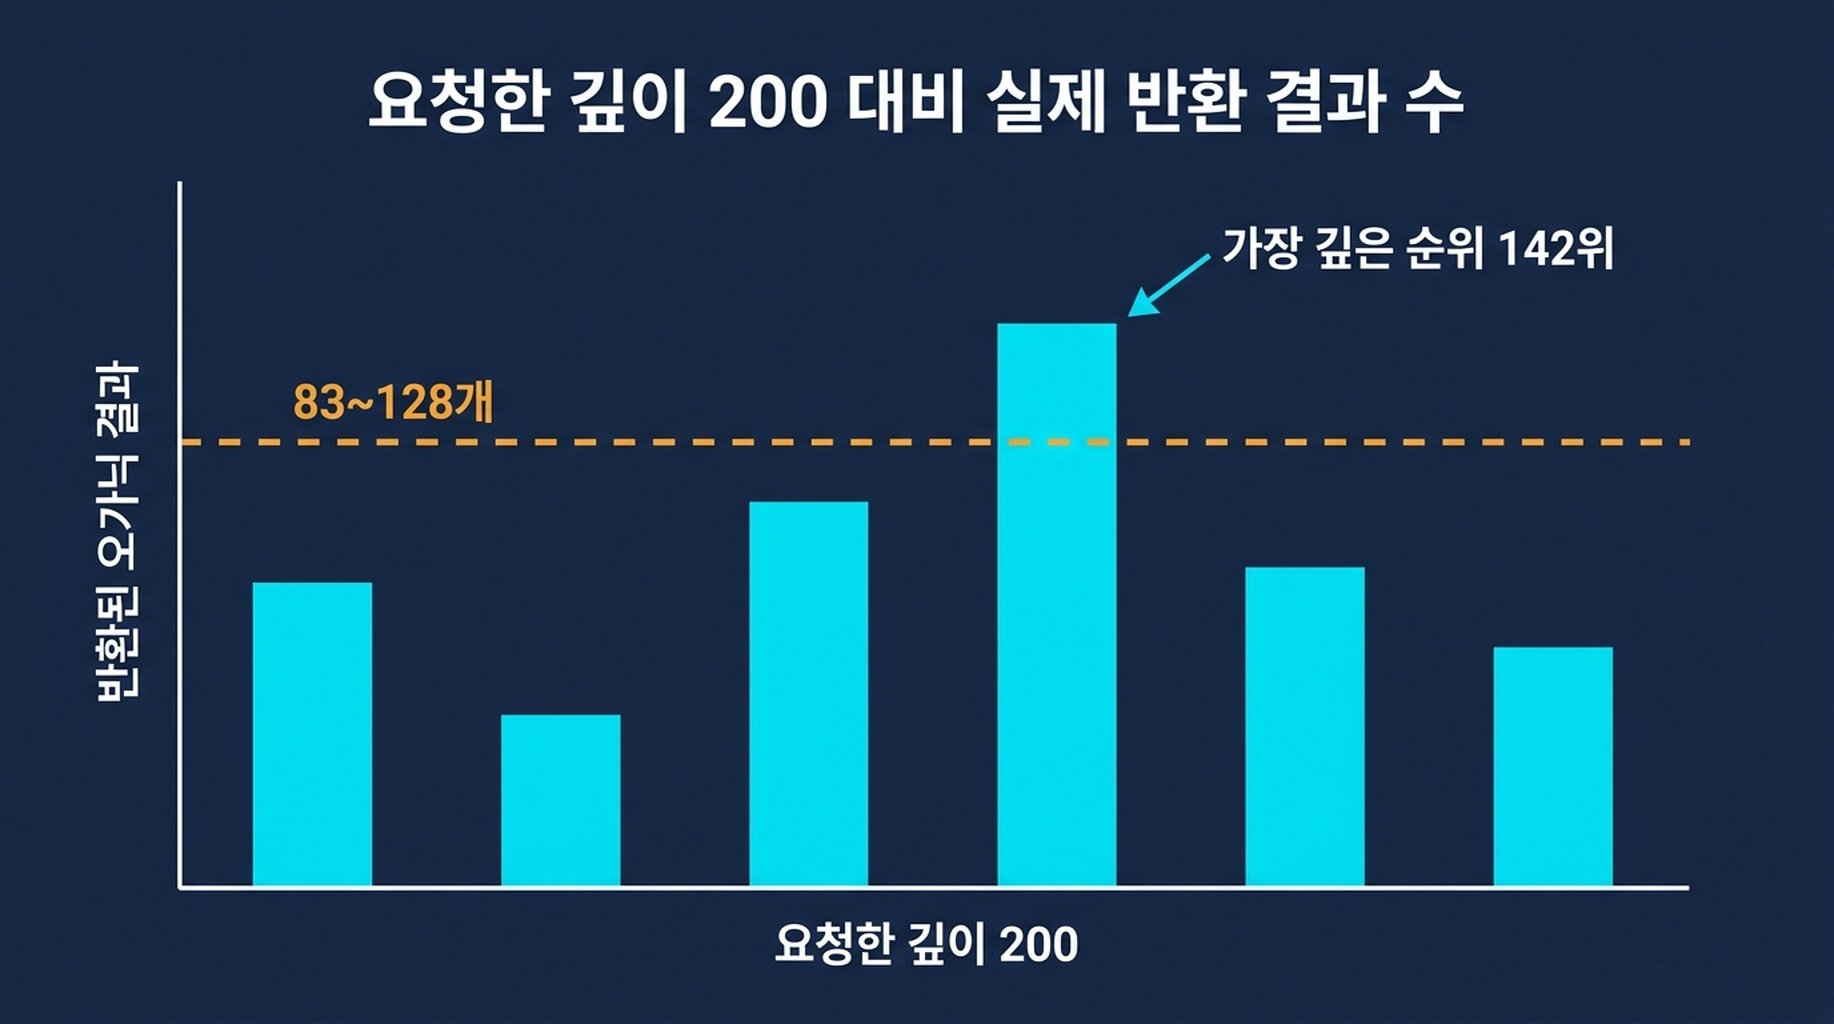
200건을 요청하고 83~128건을 받는다. 대략 140을 넘는 깊이는 대부분의 상업 쿼리에서 아무것도 사지 않습니다.
예상 출력: 순위·URL·제목·도메인을 담은 오가닉 항목이 들어 있는 JSON 페이로드.
품질 점검: AI Overview가 있을 때 페이로드에 ai_overview 항목 유형이 들어 있는지 확인하세요. organic 항목만 추출하면 순위를 지키면서 클릭을 잃은 이유를 놓칩니다.
실패하면: 401은 base64나 자격 증명 오류입니다. 40200 계열 코드는 계정 잔액이 비었다는 뜻이고, 첫 달에 가장 흔한 실패입니다.
4단계: 요약이 아니라 원본 페이로드를 저장한다
건너뛰고 나서 후회하는 결정입니다.
순위 표를 저장하는 방식은 예상하지 못한 질문이 생길 때까지 작동합니다. SERP가 길어졌는가, 동영상이 장악했는가, 경쟁사가 들어왔는가, AI Overview가 첫 화면 위에 나왔는가. 요약은 이에 답하지 못합니다. 원본 페이로드는 추가 비용 없이 답합니다.
실무적인 형태는 이렇습니다. 실행 한 번당 파일 하나를, 날짜와 시각을 이름으로 붙여 병합 출력을 담아 씁니다. 최근 90일치를 보관합니다. 저장소에 둘 만큼 작고, 옛 질문에 다시 답할 만큼 완전합니다.
5단계: 무엇이든 예약하기 전에 비교 규칙을 쓴다
직전 실행과 이번 실행을 비교하는 트래커는 대부분의 날에 잘못된 경보를 냅니다. 우리 자체 수치가 그 이유를 보여줍니다. 노출 30 이상인 124개 쿼리에서 평균적인 쿼리는 하루 사이에 4.57순위 움직였습니다. 네 순위 하락은 화요일의 일입니다.
그래서 규칙에는 임계값과 방향이 필요합니다.
다음 조건을 모두 만족하는 쿼리만 보고한다:
  - 직전 실행 대비 순위 변화의 절댓값이 5 이상, 그리고
  - 비교 창에서 노출이 20 이상, 그리고
  - 그 변화가 기기 구성 변화로 설명되지 않음

출력은 쿼리 등급별로 묶는다: money, comparison, brand, informational.
수정안은 제안하지 않는다.
기기 조항은 장식이 아닙니다. 같은 쿼리가 모바일과 데스크톱에서 11순위 벌어질 수 있고, 실행 사이에 기기 구성이 움직이면 혼합 수치도 움직입니다. 우리는 그것을 따로 측정했고, 추세를 위조할 만큼 큽니다.
비용
벤더 가격은 바뀌므로 견적을 쫓지 말고 모델을 세우세요.
- 키워드 하나를 30일 동안 매일 확인하면 월 30회 요청.
- 200개 키워드 집합을 매일 확인하면 월 6,000회 요청.
- 같은 집합을 주간으로 확인하면 월 약 860회 요청.
- Search Console 쪽은 무료이고, 안에 키워드가 몇 개든 조회 한 건당 요청 하나입니다.
이 곱셈이 판단의 전부입니다. "도구를 사야 하나"라는 질문은 거의 모두 여기로 접힙니다. 월 요청 수를 계산하고, 요청당 단가를 곱하고, 좌석 라이선스와 비교하세요. 큰 키워드 집합의 매일 추적은 보통 구독이 더 싸고, 작은 집합의 주간 추적은 보통 API가 더 쌉니다. 고정한 목록을 추적하면 API 쪽은 작게 유지됩니다.
만들지 말고 사야 할 때
내 파이프라인에 순위가 필요하거나, 이미 SERP API 자격 증명이 있거나, 순위 외의 이유로 원본 검색결과 페이지가 필요하면 만드세요.
오늘 이전의 과거 순위가 필요하거나, 같은 키워드에 지역 10곳과 기기 5종이 필요하거나, 팀에 cron 작업을 유지할 사람이 아무도 없으면 사세요. 벤더 목록 글이 바로 이 이유로 읽을 가치가 있고, 만든 사람이 팀을 옮기면 멈추는 인프라를 소유하는 데는 실제 비용이 듭니다.
정말 필요한 출력이 JSON 파일이 아니라 작성된 주간 보고서라면, Codex 보고 워크플로가 같은 두 출처에서 시작해 문서로 끝납니다. 파일 위에 경보를 얹으려면 모니터 설계 가이드가 임계값을 다룹니다.
Auspia 시각: 랭크 트래킹 API 질문은 사실 데이터 소유권 질문입니다. Search Console은 자사 속성에 대한 공식 데이터를 무료로 주고 앞으로도 그럴 것입니다. 나머지는 모두 값을 치르고 얻는 스냅샷입니다. 무료 절반을 먼저 만들고, 유료 절반은 실제로 가진 질문에 답하는 곳에만 더하세요.
FAQ
Google이 랭크 트래킹 API를 제공하나요? 공개된 것은 없습니다. Search Console API는 이미 노출되는 쿼리의 평균 게재순위를 반환하는데, 비슷할 뿐 같은 것은 아닙니다. 순위에 없는 키워드는 확인할 수 없고 경쟁사도 확인할 수 없습니다.
SERP API는 얼마나 깊이 갈 수 있나요? 벤더는 200을 크게 넘는 깊이 값을 받아들이지만, Google은 대부분의 상업 쿼리에서 대략 100~140 근처에서 결과 제공을 멈춥니다. 더 요청해도 더 많은 결과가 나오지 않습니다.
매일 확인과 주간 확인 중 무엇을 써야 하나요? 일반적인 키워드 집합에는 주간입니다. 매일은 수익 쿼리의 짧은 목록에만 쓰세요. 큰 집합을 매일 확인하면 비용이 7배가 되고 대부분 잡음을 측정합니다. 우리 데이터의 하루 평균 변동은 4.57순위였습니다.
제 API 수치가 쓰는 랭크 트래커와 다른 이유는 무엇인가요? 기기가 다르고, 지역이 다르고, 시점이 다르고, 대개 데이터 출처도 다릅니다. 그 수치는 표본입니다. 무엇이 바뀌었다고 결론 내리기 전에 요청의 지역과 기기를 고정해 다시 가져오세요.
에이전트가 이걸 대신 돌릴 수 있나요? 네, 매번 같은 형태의 작업이라 잘 맞습니다. 랭킹 업무에서 에이전트가 맡을 수 있는 범위의 전체 그림은 SEO 에이전트 실전 가이드를 보세요. 비교 규칙은 적어 둔 지시 파일에 두고 차이는 에이전트가 만들게 하되, 만들지 살지의 결정은 사람에게 남기세요.
글쓴이: Rowan Blake, Auspia에서 100개 이상의 발행 파이프라인을 맡은 콘텐츠 자동화 분석가. 자동화된 데이터 파이프라인, 정기 보고, 그리고 당신 없이도 도는 시스템의 유지 비용에 대해 씁니다.