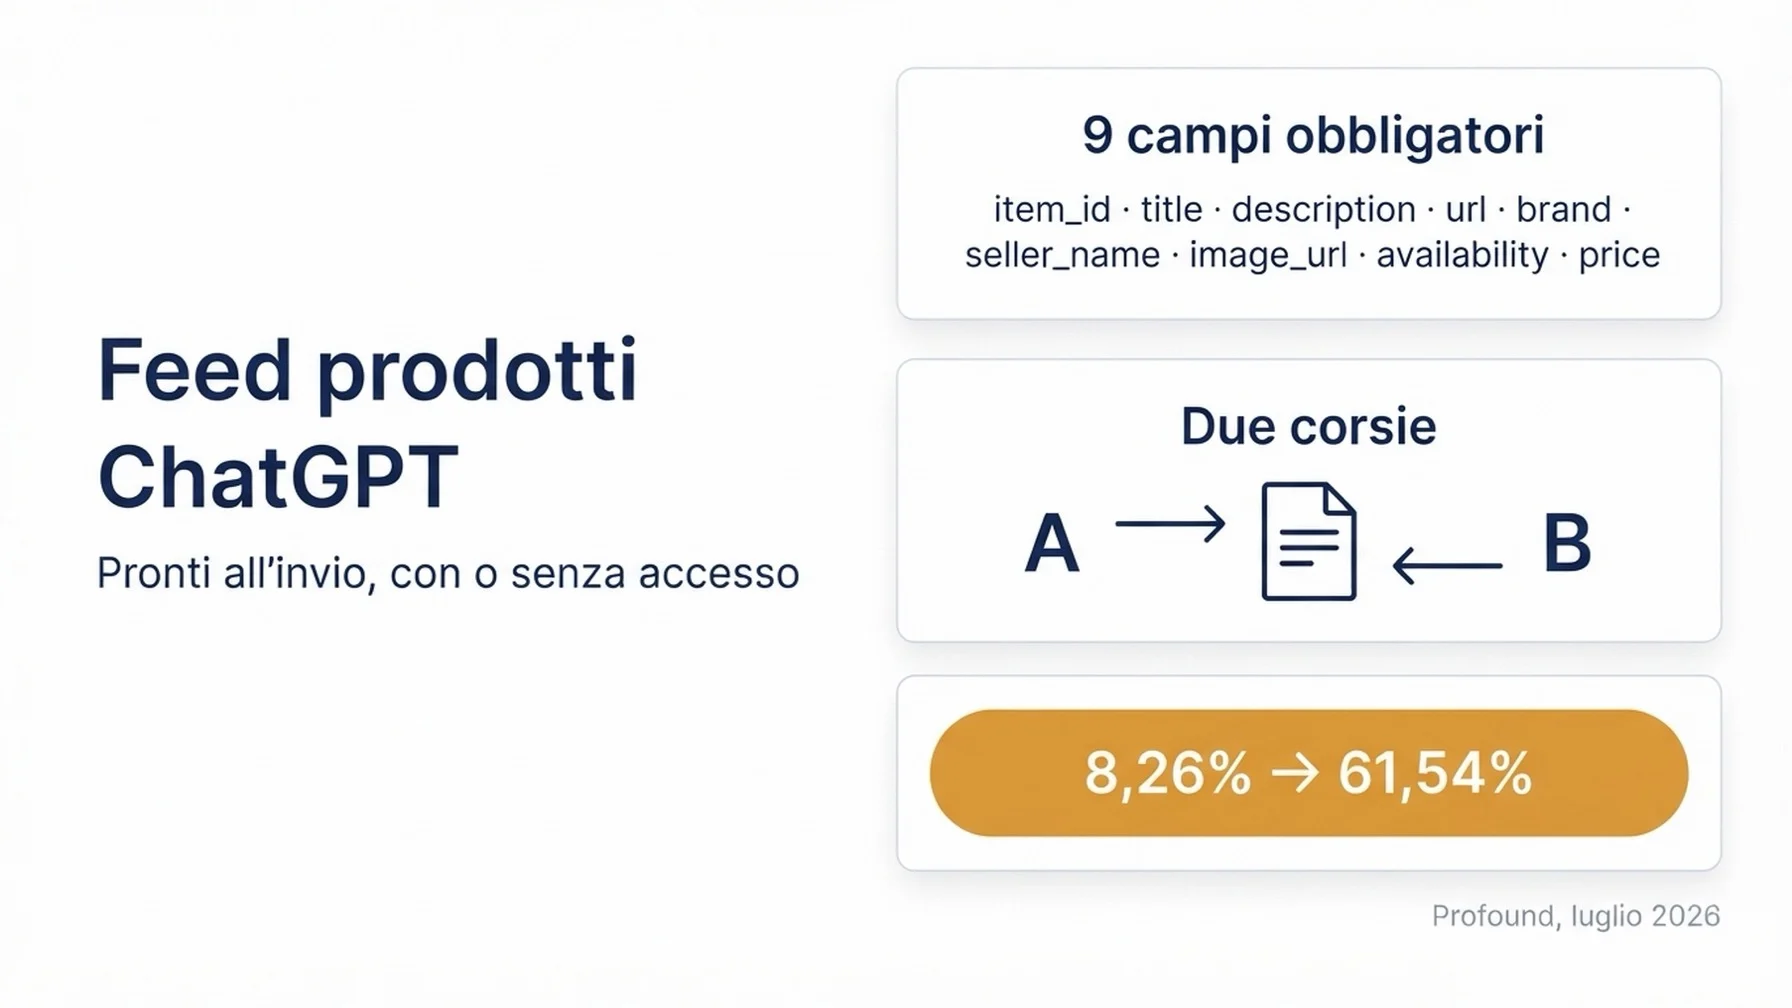
A luglio 2026 le raccomandazioni di acquisto di ChatGPT hanno cambiato la loro fonte principale. Se i dati del tuo catalogo non sono pronti per questo, nessuna ottimizzazione delle pagine prodotto lo compenserà. Questo flusso di lavoro porta il catalogo a uno stato validato e pronto all'invio, e funziona sia che tu possa inviare un feed oggi sia che tu non possa.
A chi è rivolto | Responsabili SEO ecommerce, feed manager e responsabili delle operazioni merchant che gestiscono i dati prodotto su circa 500-100.000 SKU |
Il risultato | Un file prodotti validato che supera tutti e nove i controlli sui campi obbligatori, più un elenco delle eccezioni con gli SKU bloccati e i responsabili indicati per nome |
Prerequisiti | Possibilità di esportare il catalogo in CSV, TSV o JSONL. Una directory di staging. Possibilità di modificare |
Sull'accesso | Potresti non poter inviare un feed oggi. Il programma feed di OpenAI è a invito, il checkout è un'integrazione abilitata separatamente e l'upload standard al momento è rivolto agli Stati Uniti. Questo flusso di lavoro produce il file in ogni caso |
Tempo | Da quattro a sei ore per un primo passaggio su un catalogo sotto i 5.000 SKU. La parte lenta è l'audit dei campi, non la configurazione tecnica |
Definizione di fatto | Ogni riga supera i nove controlli sui campi obbligatori; ogni SKU saltato è su un elenco di eccezioni con un responsabile indicato; il crawler di ricerca di OpenAI riesce a recuperare un URL prodotto campione e a leggerne i dati reali; e l'esecuzione è riproducibile da un export salvato |
Cosa è cambiato, e l'unica decisione che impone
OpenAI ha rilasciato i modelli ChatGPT 5.6 il 9 luglio 2026. Il giorno dopo, la quota di raccomandazioni di ChatGPT Shopping tratte dai feed prodotto dei merchant anziché dalla ricerca web aperta è passata dall'8,26% al 61,54%, secondo una ricerca pubblicata da Profound, che ha tracciato 1.757.723 prompt di shopping su ChatGPT nel corso di luglio 2026. In un solo giorno, il recupero basato sui feed è passato da fonte minoritaria a fonte dominante.
Quel numero è una misurazione di terze parti, non una comunicazione di OpenAI. OpenAI non ha confermato un cambiamento del 10 luglio né ha pubblicato alcuna ripartizione del recupero, e le sezioni in fondo a questo articolo spiegano cosa i dati sostengono e cosa no. Prendi sul serio la direzione e alla larga la precisione.
Ciò che la direzione impone è un'unica riformulazione: i dati prodotto ora devono essere corretti come dati, non solo come contenuti. Una pagina prodotto scritta benissimo ma con una cifra di controllo GTIN mancante è, per un sistema di raccomandazione basato sui feed, una riga che non ha superato la validazione.
Tutto quello che segue è un flusso di lavoro. Vale la pena eseguirlo che i numeri del 10 luglio reggano o no, perché un catalogo pulito, completo e leggibile dalle macchine serve a ogni superficie di acquisto che ti interesserà in futuro.
Scopri in quale corsia ti trovi
Il flusso di lavoro si divide in due corsie, e devi sapere la tua prima di iniziare, perché cambia cosa significa "fatto" per te. La corsia A può dimostrare l'acquisizione. La corsia B può dimostrare solo la preparazione. Entrambe producono lo stesso file.
Il test di accesso in quattro punti
Rispondi a ciascuno con onestà.
Domanda | Cosa vale come sì | Cosa non vale |
|---|---|---|
Ti sei registrato con OpenAI e hai ricevuto una conferma scritta dell'accesso al feed? | Una conferma che nomina il tuo feed | "Ho compilato il modulo di interesse" |
Il tuo catalogo è idoneo al mercato statunitense? | Conferma per l'attuale ambito di upload standard | Un'assunzione che valga per il tuo mercato |
Ti è stata abilitata separatamente un'integrazione di checkout? | Conferma esplicita durante l'onboarding | Aver acceso tu stesso un flag |
Hai inviato un file campione o completo e hai ricevuto un riscontro? | Una risposta che fa riferimento al tuo invio | Averlo inviato e non aver saputo più nulla |
Se una risposta non è supportata da qualcosa che puoi indicare, sei in corsia B. È la posizione predefinita e non è uno stato di fallimento. Due precisazioni importanti: abilitare un flag di idoneità non completa l'onboarding del checkout, e la registrazione fornisce solo il nome visualizzato del merchant, non il resto del feed.
Corsia A: hai confermato l'accesso al feed
Riceverai un elenco di campi specifico per la tua registrazione e un canale di invio confermato durante l'onboarding. Il meccanismo di invio stesso viene confermato durante l'onboarding. Le descrizioni pubbliche dei fornitori non concordano se sia SFTP o un invio HTTPS cifrato verso un endpoint autorizzato, quindi non costruire una pipeline seguendo nessuna delle due descrizioni prima che OpenAI ti dica quale vale per te.
Corsia B: non ce l'hai, ed ecco cosa non va sprecato
Tre cose sono aperte oggi senza alcun permesso: l'accesso dei crawler, i dati strutturati e la qualità delle descrizioni sulle pagine prodotto stesse, e il file validato. Il lavoro sul catalogo nella parte centrale di questo articolo non ha alcun cancello. Costruisci e verifichi il file adesso, e il giorno in cui arriva l'accesso invii qualcosa che passa già.
Se sei su Shopify, i dati prodotto raggiungono ChatGPT tramite Shopify Catalog senza lavoro aggiuntivo lato merchant. Un feed diretto serve per l'aggiornamento tempestivo e per i campi che il default non porta con sé. Una precisazione: una fonte secondaria data quella sindacazione a marzo 2026 e la data non è confermata, quindi trattala come uno spunto di conversazione e non come un fatto su cui pianificare.
Apri la porta al crawler che legge i tuoi prodotti
Questo è il primo passo che ha effetto immediato in entrambe le corsie, ed è il guadagno più economico che hai a disposizione.
Apri il tuo robots.txt e controlla le direttive per gli agenti di OpenAI. OAI-SearchBot è quello che conta per la visibilità dei prodotti. Se è bloccato, i tuoi contenuti non compariranno nei risultati prodotto di ChatGPT, per quanto pulito sia il tuo feed. Non viene usato per l'addestramento dei modelli, quindi bloccarlo non protegge nulla.
I quattro nomi di agente su cui vale la pena decidere esplicitamente:
Agente | Cosa fa | Impatto sulla visibilità dei prodotti |
|---|---|---|
| Indicizza i contenuti per le superfici di ricerca | Bloccarlo nasconde i tuoi prodotti a prescindere dalla qualità del feed |
| Recupera le pagine che un utente chiede esplicitamente | Bloccarlo interrompe la lettura delle pagine in tempo reale |
| Crawler di addestramento | Non ha rapporto con la visibilità di acquisto |
| Navigazione agentica | Influisce sui percorsi di checkout guidati da agenti |
Il controllo di qualità che conta di più qui non è `robots.txt`. È se un crawler autorizzato riesce davvero a leggere qualcosa quando arriva. Recupera un URL prodotto rappresentativo con lo user agent di quel crawler e ispeziona il corpo della risposta. Se ottieni un guscio applicativo senza titolo, prezzo, disponibilità o descrizione renderizzati sul server, la scansione riesce e non restituisce nulla di utile. Molti storefront renderizzano i dati prodotto solo lato client, e quei negozi sono invisibili alla scoperta senza feed, qualunque cosa dica il loro file robots.
Puoi eseguire quel controllo con il simulatore del crawler di ricerca OpenAI di Auspia, che recupera una pagina pubblica come farebbe il crawler di OpenAI e ti mostra cosa riesce a leggere.
Percorso di recupero. Se robots.txt è bloccato dalla tua piattaforma o dalla tua agenzia, registra la richiesta di modifica con una data e vai avanti. Il passo diventa una prova per il tuo registro di corsia B invece che un blocco.
Rendi leggibili alle macchine le tue pagine prodotto
Il feed non è l'unica via verso le raccomandazioni di acquisto, e per i merchant in corsia B al momento non è disponibile affatto. I dati strutturati sulla pagina sì.
Aggiungi dati strutturati Product in JSON-LD a ogni template prodotto, e popolali dalla stessa fonte che usa l'export del catalogo. Quest'ultima clausola è la parte che i team saltano. Se il tuo schema è mantenuto a mano nel tema e il feed arriva dal PIM, i due saranno in disaccordo entro un trimestre, e segnali di prezzo e disponibilità in conflitto sono peggio di segnali assenti.
Includi come minimo name, description, image, SKU, brand e un blocco offers che porti price, valuta del prezzo e disponibilità. Rispecchia i valori che inseriresti nel feed. Dove il tuo catalogo ha GTIN, condition, material, color, size o dimensioni, includi anche quelli, perché sono gli attributi che le query conversazionali usano davvero.
Controllo di qualità. Valida tre URL prodotto, uno per ciascuna delle tue categorie più diverse, usando lo stesso percorso di rendering che vede un crawler e non il tuo browser con la sessione attiva.
Percorso di recupero. Se la tua piattaforma non ti permette di iniettare JSON-LD nel template prodotto, inseriscilo nell'head tramite il tag manager e registralo come debito tecnico. Funziona, è fragile, e qualcuno dovrebbe occuparsi di rimuoverlo.
Riscrivi le descrizioni per le query conversazionali
Questo è il passo in cui la disciplina SEO ti danneggia attivamente.
Le descrizioni di catalogo di solito sono scritte per la copertura delle parole chiave e per l'appeal sullo scaffale: voce del brand, un titolo pieno di parole chiave, un elenco puntato di promesse. Le query di acquisto conversazionali non somigliano per niente a questo. Qualcuno chiede "una tastiera meccanica silenziosa per un ufficio open space sotto i 150 euro" e gli attributi che rispondono alla domanda sono il livello di rumorosità, il tipo di switch e il formato. Quegli attributi devono essere presenti e fattuali per essere estraibili.
Scrivi le descrizioni prodotto come una scheda tecnica fattuale con una breve apertura umana. Apri con una frase su cos'è il prodotto e a chi è adatto. Poi elenca gli attributi in modo piano, senza modificatori di marketing. "Peso: 780 g" batte "costruzione incredibilmente leggera". Se fai un'affermazione, rendila specifica e verificabile.
Una cosa da sapere prima di investire molto qui: la documentazione di OpenAI sullo shopping segnala che ChatGPT può generare titoli e descrizioni prodotto semplificati. Il tuo testo è un input per la raccomandazione, non un output garantito. Scrivi dati di origine puliti e fattuali e accetta che la superficie possa parafrasarli.
Controllo di qualità. Prendi i tuoi dieci prodotti con il fatturato più alto e, per ciascuno, elenca i quattro attributi che un acquirente vorrebbe per decidere. Se ne compaiono meno di tre nella descrizione, la descrizione non sta facendo il suo lavoro.
Percorso di recupero. Se le tue descrizioni arrivano da un feed del fornitore che non controlli, riscrivi a mano il decile superiore per fatturato e lascia che la coda lunga segua. Una copertura parziale batte un progetto fermo.
Definisci il contratto dei campi prima di toccare una riga
Ora passiamo al feed vero e proprio. Prima di esportare qualsiasi cosa, metti per iscritto una volta sola cosa significa "corretto". Questo trasforma l'audit in un passaggio meccanico invece che in una discussione.
I nove campi obbligatori e dove ciascuno si rompe
Ogni riga ha bisogno di questi nove. Questa tabella è il contratto.
Campo | Forma accettata | Errore più comune | Conseguenza |
|---|---|---|---|
| Stringa univoca e stabile per articolo o variante | Riusata tra varianti, o rigenerata a ogni export | Righe duplicate e orfane |
| Stringa semplice, meglio 150 caratteri o meno | Troncamento a metà parola, o un titolo che contiene il prezzo | Riga scartata o abbinata male |
| Testo semplice, fino a 5.000 caratteri | HTML o markdown rimasti dal CMS | Riga scartata |
| URL della pagina prodotto | Parametri di tracciamento, o un URL che reindirizza | La riga non porta da nessuna parte |
| Stringa con il nome del brand | Del tutto assente sugli SKU senza brand | Riga scartata |
| Stringa con il nome del merchant | Grafie incoerenti nel catalogo | Segnale merchant debole |
| URL diretto di un'immagine | Un segnaposto, o un URL che richiede una sessione | Riga senza parte visiva |
| Uno tra | Un valore personalizzato dal tuo vocabolario di magazzino interno | Riga scartata |
|
| Separatori delle migliaia, o un numero nudo senza valuta | Riga scartata |
Due voci meritano enfasi perché falliscono in silenzio e si portano dietro intere linee di prodotto.
Il campo availability accetta esattamente cinque valori. Valori omessi, vuoti o non riconosciuti scartano la riga. Se la tua piattaforma esporta IN STOCK o available o 1, tutte quelle righe falliscono. Mappa il tuo vocabolario interno sui cinque valori accettati in modo esplicito, e instrada tutto ciò che non riesci a mappare verso una coda manuale invece di impostarlo a unknown per default. unknown è un valore legittimo, ma è uno stato deliberato, non un contenitore di scarto.
Il campo price è un importo, uno spazio, poi un codice valuta in maiuscolo. Significa 79.99 USD, non 79,99 €, non 79,99 USD e non 7.999e1. Nessun separatore delle migliaia, nessuna notazione esponenziale.
Le regole che scartano le righe in silenzio
Altri quattro vincoli che vale la pena scrivere nei tuoi controlli di validazione:
GTIN. Esattamente 8, 12, 13 o 14 cifre, cifra di controllo valida inclusa. L'ISBN-10 non è accettato. Conserva gli zeri iniziali, il che significa tenere la colonna come testo ovunque passi. È il punto di rottura silenzioso più comune dell'intera specifica, perché i fogli di calcolo e gli export CSV eliminano gli zeri iniziali per default.
Prezzo scontato. Deve essere maggiore di zero e strettamente inferiore al prezzo normale, nella stessa valuta. Un prezzo scontato uguale al prezzo normale, o una riga promozionale in cui il prezzo normale è stato lasciato vuoto, non passa.
Lunghezza del titolo. Meglio 150 caratteri o meno. Quando tronchi, tronca su un confine di parola.
I campi data non pianificano nulla. La specifica è esplicita: le date nel contratto non pianificano variazioni di prezzo o disponibilità. Se vuoi che una promozione si attivi a mezzanotte, è la tua pipeline a dover inviare il nuovo valore.
Decidi deliberatamente i flag di idoneità
Tre flag controllano cosa succede a una riga dopo che è stata validata.
Flag | Default se omesso o vuoto | Cosa fa |
|---|---|---|
|
|
|
| Richiede l'idoneità alla ricerca |
|
| Disattivato | Controlla il percorso separato di elaborazione degli annunci |
Potresti anche incontrarli come enable_search, enable_checkout e is_eligible_ads. Sono alias, quindi non trattare un template che usa la grafia più vecchia come se fosse un campo diverso.
Il consiglio pratico: sincronizza is_eligible_search con qualunque sistema sappia già che un prodotto è fuori produzione o soppresso. Se gestisci un elenco separato di "nascondi dal canale" e quell'elenco non arriva mai al feed, spedirai inserzioni obsolete dentro le raccomandazioni.
Quali gruppi opzionali attivare, e in quale ordine
Ci sono circa cinquanta campi opzionali. In ordine di resa per ora di lavoro, non di ordine della specifica:
- Varianti (
group_id,listing_has_variations,variant_dict,offer_id,gtin,mpn). Priorità massima se vendi abbigliamento, calzature, casa o qualsiasi cosa con taglia o colore. - Informazioni sull'articolo (
condition,product_category,material,color,size,gender,age_group, più i campi di dimensioni e peso). È ciò che fa funzionare l'abbinamento conversazionale. - Media (
additional_image_urls). - Resi (
accepts_returns,return_deadline_in_days,return_policy). - Recensioni (
review_count,star_rating), piùstore_review_countestore_star_ratinga livello di negozio. - Evassione, merchant e geo (
shipping_price,shipping,seller_url,target_countries,store_country). - Campi vincolati alla configurazione.
marketplace_seller,size_system,accepts_exchanges,is_digital, la coppia annunci (is_ads_eligible,ads_metadata) e la coppia checkout (is_eligible_checkout,seller_privacy_policy,seller_tos) richiedono tutti una conferma durante l'onboarding. Non sono self-service. Lasciali fuori dal primo passaggio.
Controllo di qualità. Ognuno dei nove campi obbligatori dovrebbe mappare su una colonna del catalogo che risolve su dati reali per almeno il 95% dei tuoi SKU. I campi sotto quella soglia non sono attività di mappatura, sono decisioni di approvvigionamento dei dati.
Percorso di recupero. Se un campo obbligatorio non ha alcuna fonte, come brand su una linea senza brand, fermati e risolvi la questione con un responsabile di business prima di costruire il file. Il lavoro sul formato non può riparare dati assenti.
Quale formato di file ti è effettivamente consentito inviare
Usa il formato che OpenAI conferma per il tuo feed registrato durante l'onboarding. Oltre a quello, esiste un percorso compatibile con Google che accetta file .txt o .tsv delimitati da tab in UTF-8, oppure .csv delimitati da virgola, con supporto gzip per .txt.gz, .txt.gzip, .tsv.gz e .csv.gz.
JSON, fogli di calcolo, XML, RSS e Atom non sono supportati su quel percorso di compatibilità. Usa un solo formato per l'intero upload invece di mescolare formati riga per riga.
Normalizza i quattro campi che rompono più righe
Preleva un unico export congelato
Esporta una volta, metti una marca temporale al file e calcola un hash. Ogni passaggio successivo gira su quel file congelato. La riproducibilità è ciò che rende l'audit difendibile tre settimane dopo, quando qualcuno chiede perché manca uno SKU.
Le quattro normalizzazioni
Zeri iniziali del GTIN. Esporta la colonna come testo, poi verifica che il numero di cifre sia 8, 12, 13 o 14 e verifica la cifra di controllo. È qui che vive la maggior parte dei fallimenti silenziosi.
Formattazione del prezzo. Elimina i separatori delle migliaia, mantieni il punto decimale, rimuovi qualsiasi notazione esponenziale e aggiungi il codice valuta come token separato. Fai passare il risultato attraverso una regex che accetta solo ^\d+\.\d{2} [A-Z]{3}$ e metti il resto in coda.
Mappatura della disponibilità. Mappa il tuo vocabolario interno sui cinque valori accettati in modo esplicito. Conta quante righe finiscono in ciascun gruppo e quante cadono nella revisione manuale. Un numero alto di revisioni manuali significa che il tuo vocabolario di magazzino ha bisogno di una tabella di mappatura, non che il tuo feed sia rotto.
Pulizia di titoli e descrizioni. Tronca i titoli a 150 caratteri su un confine di parola. Rimuovi il markup dalle descrizioni e limita a 5.000 caratteri di testo semplice.
Controllo di qualità. Reimporta il file normalizzato in un foglio di calcolo nuovo e conferma che la colonna GTIN mostri ancora gli zeri iniziali. Questo intercetta la trappola dell'esportazione come numero che sopravvive a ogni altro controllo.
Percorso di recupero. Se è la tua piattaforma feed o il tuo PIM a eseguire queste normalizzazioni, valida il suo output con gli stessi controlli invece di fidarti del suo messaggio di successo.
Verifica ogni riga e tieni un elenco delle eccezioni
Adesso esegui i controlli su tutto il file. Questo è il passaggio che trasforma un catalogo in un piano di lavoro.
Le nove verifiche meccaniche che puoi fare senza un validatore
Per ogni riga: tutti e nove i campi obbligatori presenti e non vuoti; availability dentro l'enum a cinque valori; numero di cifre e cifra di controllo di gtin validi; price conforme alla forma importo-e-valuta; sale_price strettamente inferiore a price e maggiore di zero, stessa valuta; title pari o sotto i 150 caratteri; description testo semplice pari o sotto i 5.000 caratteri; url che restituisce 200 e rende i dati prodotto lato server; image_url che risolve su un'immagine reale e non su un segnaposto.
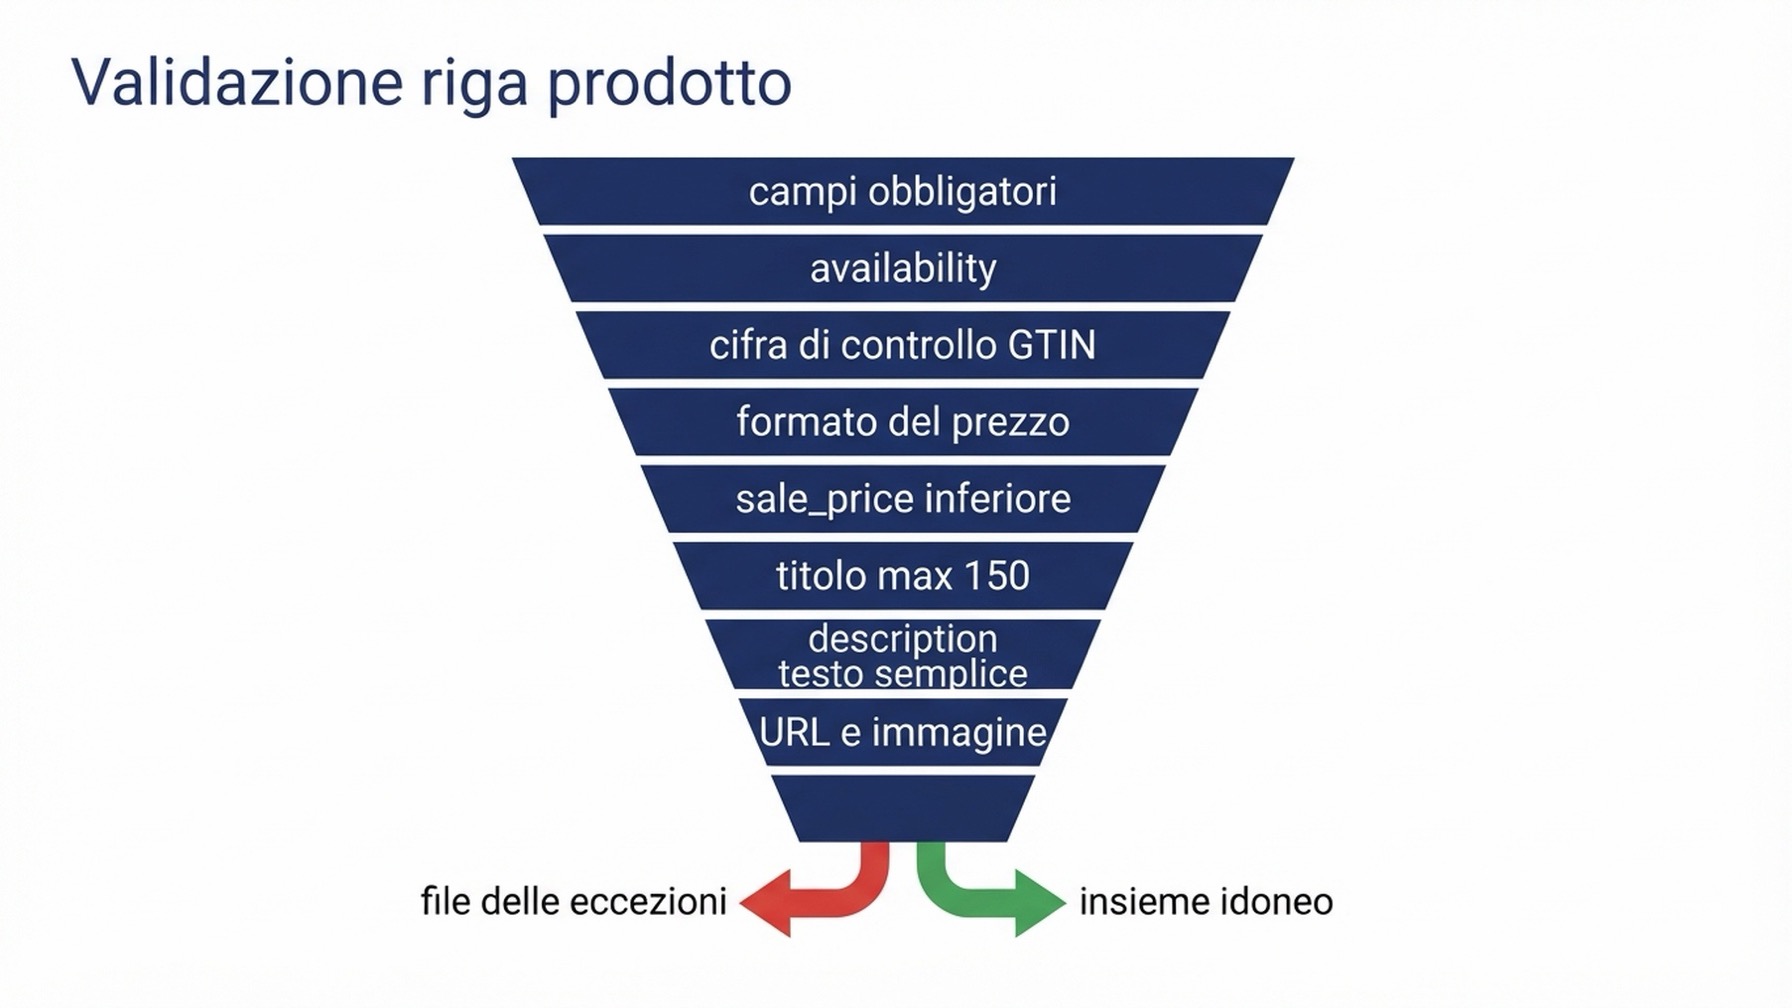
Una riga o supera tutti i cancelli o finisce nel file delle eccezioni con il cancello che l'ha respinta indicato per nome. Il cancello della disponibilità respinge più righe di tutti, perché il vocabolario di magazzino personalizzato è il modo più comune in cui un catalogo fallisce.
Costruisci il file delle eccezioni, non un catalogo perfetto
Due colonne e un responsabile: item_id, l'ostacolo e chi lo risolve.
Controllo di qualità. Su un catalogo ragionevolmente pulito, il file delle eccezioni dovrebbe stare sotto il 10% delle righe. Se è sopra il 30%, il problema è la governance dei dati a monte, e la mossa onesta è riparare il sistema di origine invece di rattoppare il file.
Percorso di recupero. Se un campo obbligatorio manca su un'intera categoria invece che su SKU sparsi, trattalo come una decisione di approvvigionamento dei dati con un responsabile di business. Non marcare quelle righe come unknown per far passare l'audit, perché unknown è un valore legittimo che significa qualcosa di specifico, e usarlo per superare un controllo inquina i tuoi stessi dati.
Una nota onesta sull'aggiornamento: la specifica non indica alcuna cadenza di aggiornamento e non dice se i feed siano snapshot completi o aggiornamenti incrementali. Le descrizioni pubbliche dei fornitori fanno affermazioni sicure su entrambe le cose che non stanno nella documentazione di OpenAI. Quello che la specifica ti dice di fare è inviare il prezzo corrente, aggiornare quando una promozione inizia o finisce e aggiornare la disponibilità quando un articolo si esaurisce o torna. Costruisci la tua pipeline intorno a questi due eventi e chiarisci la questione della cadenza all'onboarding.
Valida il file come farà la piattaforma
Riparsa gli stessi byte esatti che intendi inviare, nel formato in cui intendi inviarli, e conta le righe in entrata contro quelle in uscita.
Questo intercetta il fallimento che un foglio di calcolo nasconde. Un file che si apre pulito in Excel non è lo stesso file che si parsa come CSV, perché delimitatori non sottoposti a escape e interruzioni di riga dentro i campi descrizione rompono il parsing mentre sullo schermo sembra tutto a posto.
Controllo di qualità. Righe in entrata uguali a righe in uscita, e i controlli automatici concordano con il tuo audit manuale. Una differenza tra i due significa che uno dei due è sbagliato, e di solito è quello manuale.
Percorso di recupero. I fallimenti di codifica si risolvono quasi sempre riesportando in UTF-8. I fallimenti di quoting sono quasi sempre delimitatori non sottoposti a escape o interruzioni di riga sfuggite nelle descrizioni.
Se il tuo team ha a disposizione un agente di coding, questo è l'unico punto in cui uno script piccolo ripaga il tempo speso, perché trasforma l'audit da progetto trimestrale a riesecuzione.
Verifica che abbia funzionato
Ciò che puoi dimostrare dipende dalla tua corsia, e vale la pena essere precisi sulla differenza invece di confonderla.
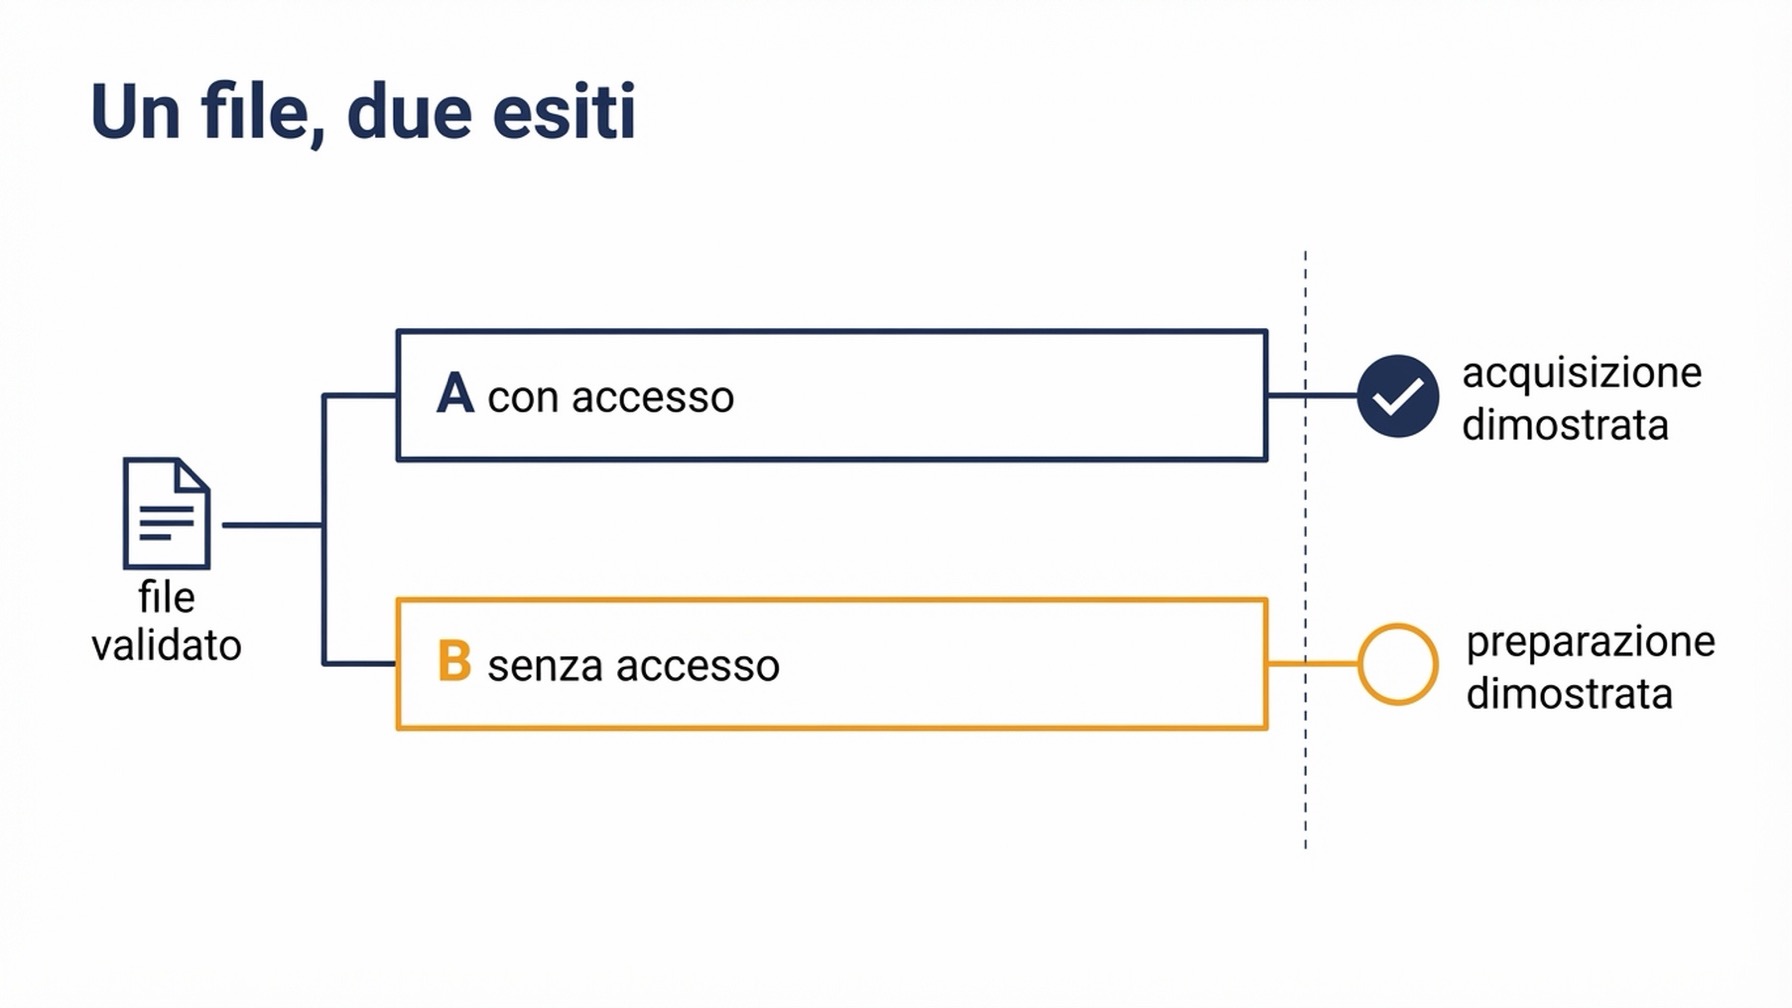
La corsia A può dimostrare l'acquisizione. La corsia B può dimostrare la preparazione. Né la corsia né la diramazione cambiano il file, ed è esattamente il motivo per cui conviene costruirlo prima di avere accesso.
Se hai accesso (corsia A)
Quattro controlli. Il tuo invio è stato confermato. Il rapporto di rifiuto per riga è stato letto e ogni rifiuto è stato risolto o registrato. Un prompt di shopping di esempio ora mostra uno dei tuoi prodotti. I log del tuo server mostrano l'agente di recupero che scarica URL prodotto.
Se non ce l'hai (corsia B)
Quattro controlli. Un recupero di robots.txt restituisce un URL prodotto a OAI-SearchBot. Un recupero renderizzato lato server di quell'URL contiene titolo, prezzo, disponibilità e descrizione. L'audit delle nove verifiche passa. L'export congelato e l'esecuzione dei controlli sono conservati dove la persona successiva può riprodurli.
La preparazione è un risultato reale e falsificabile. Solo che non è lo stesso risultato dell'acquisizione, e non dovresti riportarla come se lo fosse.
L'unico numero che conta alla fine
I link in uscita da ChatGPT portano automaticamente utm_source=chatgpt.com. Questo rende i tuoi analytics l'unica prova di prima parte che un clic è avvenuto. Configura il filtro adesso, prima di averne bisogno.
Ed è chiaro cosa misura. È attribuzione di traffico da un clic, non una metrica di visibilità. Un prodotto può essere raccomandato molte volte e cliccato zero volte, e un prodotto non idoneo non potrà mai essere cliccato.
Cosa questo flusso di lavoro non controlla
Non controlla la posizione dentro l'insieme dei feed. La specifica definisce un contratto di riga. Non definisce una regola di ordinamento. Superare ogni controllo sui campi rende un prodotto idoneo a essere recuperato. Non dice nulla su quale, tra dieci righe conformi, venga mostrata. La ricerca citata all'inizio misura la fonte del recupero, non la posizione dentro un insieme recuperato.
I numeri del 10 luglio sono osservazionali e vengono da un solo fornitore. Descrivono il panel di prompt tracciati di Profound, non sessioni reali di acquirenti o percorsi di acquisto. OpenAI non ha confermato il cambiamento e non ha divulgato alcuna ripartizione del recupero. Un rilascio di GPT-6 Astra è iniziato il 3 settembre 2026, si sovrappone alla finestra di misurazione più tarda di quella ricerca ed è un fattore di confusione reale.
Le cifre sulla concentrazione portano gli stessi limiti. La crescita dei riferimenti a negozi nella top 10 dal 22,5% al 41,8% e il calo dei merchant unici da 13.524 a 10.607 vengono entrambi da quello stesso panel. E il risultato che i cambiamenti nella fonte di recupero spiegano l'83% della variazione di visibilità su 517 clienti in movimento è una quota esplicativa dentro il panel, non un coefficiente causale su cui pianificare.
Alcune affermazioni che circolano nei blog dei fornitori non stanno nella specifica. Tratta ciascuna con cautela:
Affermazione | Fonte | Stato |
|---|---|---|
I feed si aggiornano ogni 15 minuti, 96 volte più spesso dei feed giornalieri | Blog di fornitori | Non è nella specifica di OpenAI, che non indica alcuna cadenza |
I feed sono snapshot completi, non aggiornamenti incrementali | Un fornitore, che non cita alcuna documentazione OpenAI | Irrisolto; da chiarire all'onboarding |
Serve un campione di circa 100 prodotti | Blog di fornitori | Il testo di aiuto di OpenAI menziona un campione iniziale o un feed completo senza alcuna quantità |
L'invio avviene via SFTP | Un fornitore; un altro dice invio HTTPS cifrato | Le fonti sono in conflitto; il meccanismo si conferma durante l'onboarding |
| Una fonte aggregata | Non è nell'elenco dei campi della specifica. I campi recensione della specifica sono |
I feed strutturati convertono circa il doppio rispetto ai dati raschiati | Affermazione di un fornitore senza fonte | Non pianificare su questa base |
Non controlla come viene renderizzato il tuo testo. ChatGPT può generare titoli e descrizioni prodotto semplificati. E i risultati di shopping sono selezionati in modo indipendente da ChatGPT e non sono annunci, il che risponde a una domanda sull'influenza commerciale e non sulla fonte del recupero. Se quello che cerchi è la collocazione a pagamento, OpenAI gestisce effettivamente un percorso annunci separato costruito dai feed prodotto. È un flusso di lavoro diverso e non è questo articolo.
FAQ
Posso inviare un feed prodotto a ChatGPT oggi?
Non su richiesta. L'accesso viene confermato per singolo merchant, il checkout richiede un'integrazione abilitata separatamente e l'upload standard al momento è rivolto agli Stati Uniti. La registrazione fornisce solo il nome visualizzato del merchant, e puoi essere registrato senza avere un accesso di upload attivo. Esegui il test di accesso in quattro punti qui sopra per capire dove sei.
Con che frequenza dovrei aggiornare il feed?
La specifica non indica alcuna cadenza. Due blog di fornitori sostengono quindici minuti, e quel numero non compare nella documentazione di OpenAI. La risposta pratica è far partire gli aggiornamenti dai tuoi eventi di prezzo e disponibilità, perché sono le due cose che la specifica ti dice esplicitamente di mantenere correnti.
Invio un file completo o solo le righe che sono cambiate?
Irrisolto. Un fornitore afferma che sono snapshot completi e non cita alcuna documentazione OpenAI a supporto. Chiariscilo all'onboarding prima di costruire una pipeline che dipende da una delle due risposte.
Il requisito del campione di 100 prodotti è reale?
Il testo di aiuto di OpenAI menziona l'invio di un campione iniziale o di un feed completo senza alcuna quantità associata. La cifra di 100 prodotti viene dai blog dei fornitori. Se prepari un campione, rendilo rappresentativo coprendo ogni caso dei gruppi opzionali invece di inseguire un numero preciso.
Un buon feed farà salire i miei prodotti nei risultati di shopping di ChatGPT?
Non nel senso che la domanda di solito implica. Un feed rende un prodotto idoneo e descrivibile. La posizione dentro l'insieme recuperato non è documentata, e la ricerca pubblica misura la fonte del recupero e non l'ordinamento. Tratta la conformità dei campi come un prerequisito, non come una leva.
Mi serve qualcosa di tutto questo se vendo su Shopify?
Non per la sindacazione di base, perché i dati prodotto raggiungono ChatGPT tramite Shopify Catalog senza lavoro lato merchant. Un feed diretto serve per l'aggiornamento tempestivo e per i campi che il default non porta con sé.
Autore: Eva Laurent, Ecommerce Search Strategist per oltre 10.000 pagine prodotto in Auspia. Eva scrive di ricerca ecommerce, scoperta dei prodotti e di come i dati prodotto raggiungono le superfici di acquisto basate sull'AI.