La maggior parte dei team che dice di "fare SEO agentico" in realtà incolla un prompt lungo in una finestra di chat. La prima volta funziona. Il problema arriva alla seconda: la struttura dell'output cambia, i dati hanno una settimana di ritardo e nessuno sa dire se si sono mossi i numeri o se il prompt è andato alla deriva.
La versione che regge si distingue per una sola cosa: il metodo vive in un file, non nel tuo messaggio. Scrivi la procedura una volta, la affidi a un agente e da quel momento gli stessi controlli vengono eseguiti a ogni esecuzione, che tu ti sia ricordato di chiederli o no.
È tutta qui l'idea. Quello che segue spiega come costruirla, quale agente si adatta a quale attività e dove si rompe in silenzio.
Cosa cambia davvero l'"agentico"
Ci sono tre cose che si possono automatizzare, e non sono la stessa cosa.
Automazione del flusso | SEO assistito dall'IA | SEO agentico | |
|---|---|---|---|
Chi sceglie i passaggi | Tu, in anticipo | Tu, a ogni conversazione | Tu, una volta, in un metodo scritto |
Da dove vengono i dati | Integrazioni già collegate | Quello che incolli | L'agente li recupera |
Davanti a un input inatteso | Si rompe | Dipende da come lo formuli | Segue una regola o escala |
Coerenza tra un'esecuzione e l'altra | Perfetta e rigida | Bassa | Alta e comunque adattiva |
Ideale per | Attività massive e invariabili | Esplorazione e domande una tantum | Analisi ricorrenti che richiedono giudizio |
La differenza pratica si vede in quello che smetti di fare. In un flusso di chat rispieghi il sito, il pubblico, le regole di priorità e il formato di output ogni volta. Ogni rispiegazione è un'occasione per dimenticare qualcosa. In un flusso agentico tutto questo vive in file che l'agente legge a ogni esecuzione, e il tuo prompt si riduce a una riga: esegui il controllo di degrado dei contenuti di settembre.
C'è anche un costo. Se l'attività è davvero diversa ogni volta, non c'è un metodo da scrivere e costruirlo è un onere senza ritorno. Verificare il codice di stato di 50.000 URL è lavoro da script, non da agente. La linea di demarcazione sono due domande: l'attività si ripete e richiede giudizio? Se la risposta è sì a entrambe, vince l'agentico. Se una delle due manca, lascia perdere.
I quattro livelli e a cosa serve ciascuno
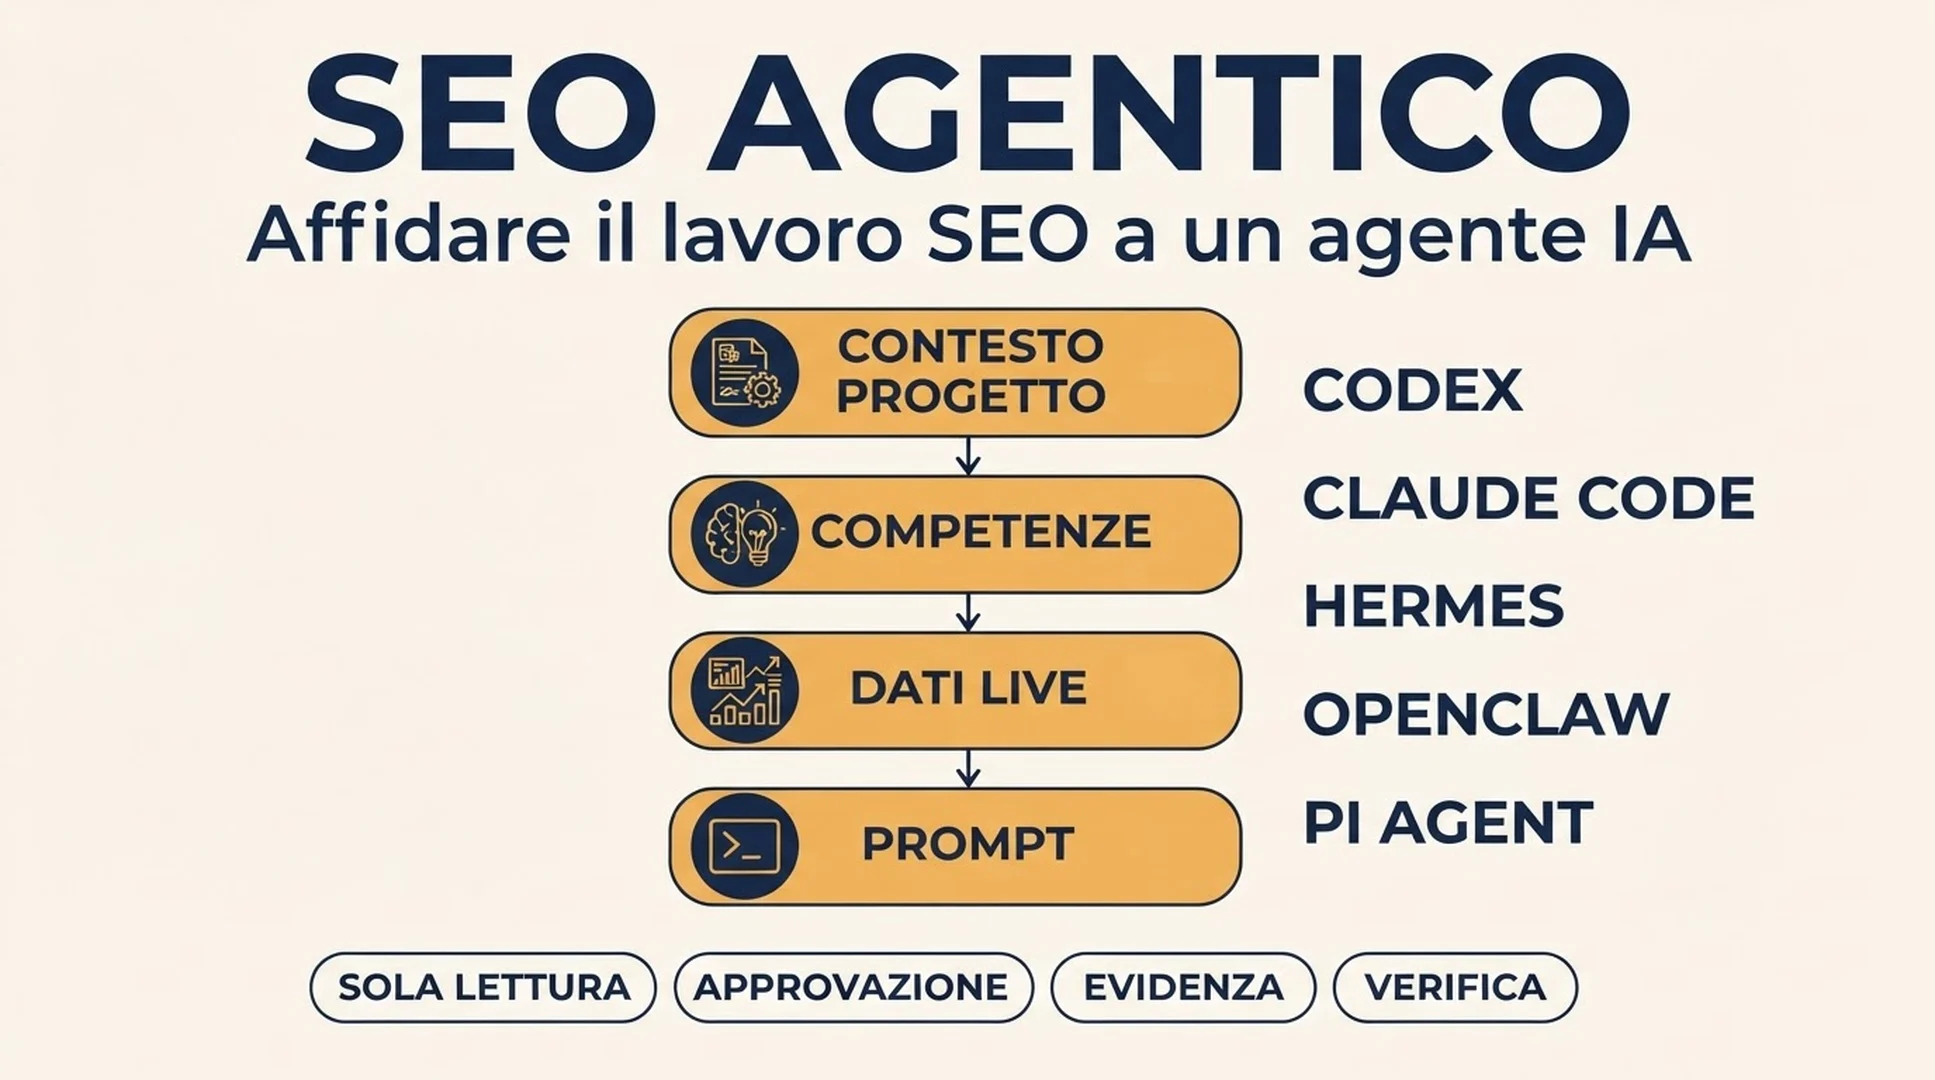
Ogni configurazione di SEO agentico che sopravvive ha gli stessi quattro pezzi. Togline uno e ottieni un tipo di fallimento prevedibile.
Contesto di progetto. Una cartella con ciò che non cambia: il sito, i mercati serviti, chi compra e perché, cosa conta come conversione, chi sono i concorrenti reali, le regole editoriali. È questo che impedisce all'agente di scrivere consigli generici per un'attività che non capisce. Salta questo livello e ottieni un output sicuro, plausibile e inutile.
Competenze. Procedure scritte. Ognuna indica quando usarla, di quali dati ha bisogno, l'ordine dei passaggi, le regole di punteggio, il formato di output e quali azioni richiedono la tua approvazione. È questo il livello che rende ripetibile il flusso, ed è quello che quasi tutti i team saltano.
Accesso ai dati in tempo reale. Connessioni che permettono all'agente di recuperare da solo i numeri attuali invece di aspettare che tu esporti e incolli. Search Console per la tua performance. Analytics per il comportamento. Una fonte di posizioni o di SERP per ciò che non vedi sul tuo dominio. Un crawler o una connessione al CMS per i fatti a livello di pagina. Senza questo livello hai un ottimo analista che lavora sul foglio del mese scorso.
Il prompt. L'attività corrente, nient'altro. Se il tuo prompt trasporta contesto o metodo, appartengono al primo e al secondo livello.
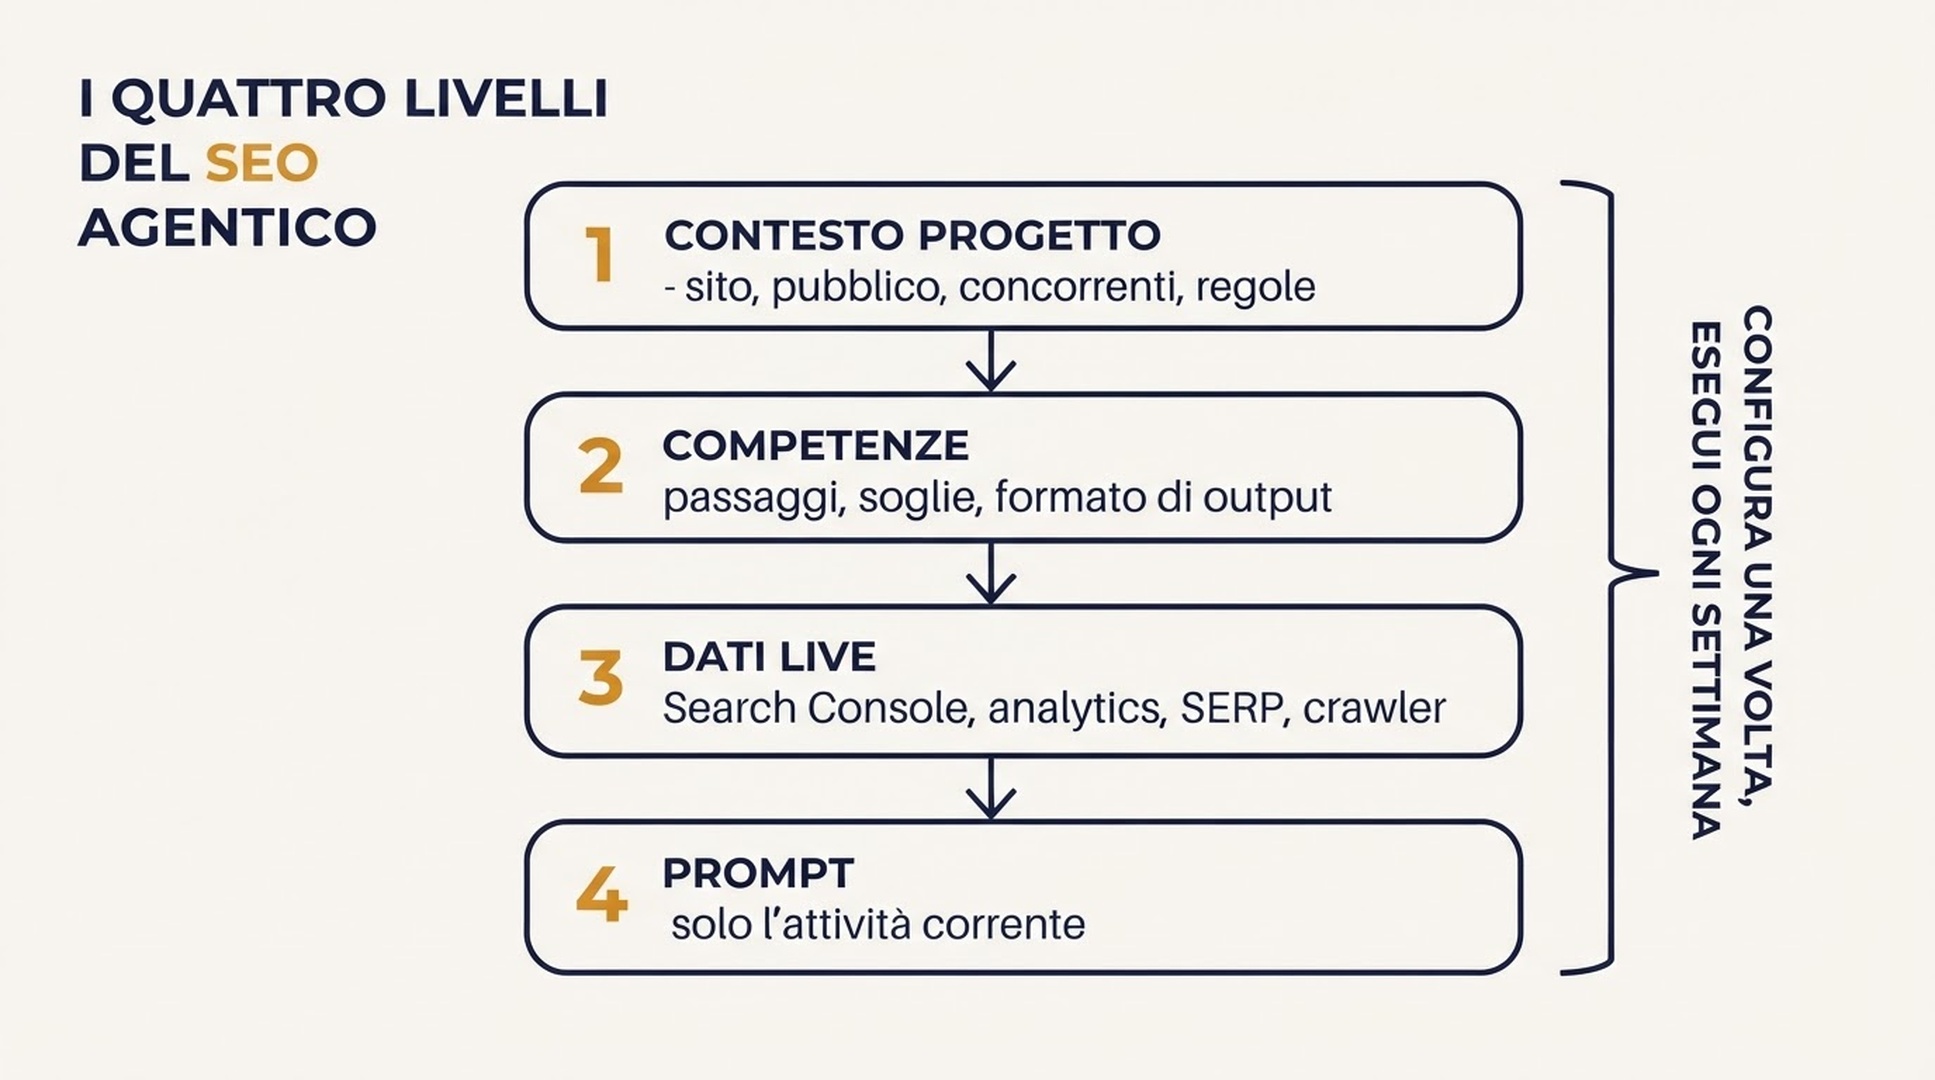
Configura i quattro livelli una volta e l'esecuzione settimanale si riduce a una riga. Quando il risultato è sbagliato, controlla quale livello ha fallito prima di riscrivere il prompt.
La posizione di Auspia: il modello a quattro livelli è l'idea più utile di questa categoria e, allo stesso tempo, il punto in cui la maggior parte dei team si ferma troppo presto. Creano la cartella di contesto, saltano le competenze e finiscono con un chatbot ben informato. Il prodotto è la competenza. Tutto il resto è impiantistica.
Quale agente per quale attività
È la domanda che ci fanno più spesso, e la risposta onesta è che le differenze contano meno della configurazione. Tutti quelli elencati qui se la cavano con la maggior parte delle attività SEO se insisti abbastanza. Ciò che li separa è il punto in cui ciascuno è meno goffo, e questo decide se lo stai ancora usando alla terza settimana.
Agente | Più forte in | Modello di accesso | Prima attività SEO sensata |
|---|---|---|---|
Codex | Lavoro su repository, esecuzioni pianificate, modifiche revisionabili | File locali, terminale, git, automazione | Salvare gli snapshot settimanali in un repository e aprire una pull request con il report |
Claude Code | Revisione di contesto lungo rispetto a una policy scritta esplicita | Terminale, file di memoria del progetto, connettori MCP | Leggere gli export di Search Console e il codice della pagina e produrre un verdetto documentato |
Hermes Agent | Competenze ripetibili con memoria tra le sessioni | Agente open source con sistema di competenze e memoria persistente | Installare una competenza ed eseguire lo stesso flusso con la stessa cadenza |
OpenClaw | Raccolta di prove dal browser con permessi rigidi | Prima il browser, poi i file locali | Catturare cosa restituisce davvero la ricerca su mobile e fermarsi lì |
Pi Agent | Restare piccolo e prevedibile per mesi | Nucleo minimo, competenze Markdown come punto di estensione | Eseguire una procedura ristretta e leggibile dove vuoi verificare tutto ciò che sa fare |
Due avvertenze. Questa categoria cambia ogni mese, quindi controlla i limiti e i prezzi attuali nella documentazione ufficiale di ciascun fornitore prima di impegnare un team. E questa tabella è un punto di partenza, non un tetto.
Per ognuno teniamo una guida all'avvio sicuro: Codex, Claude Code, Hermes Agent e OpenClaw. Tutte e quattro seguono la stessa forma: prima sola lettura, una modifica approvata alla volta, verifica prima di pubblicare.
La regola pratica di scelta dipende da dove vive già il tuo lavoro. Se il sito è in un repository git e le modifiche alle pagine sono modifiche al codice, parti da Codex o Claude Code. Se il lavoro è soprattutto export, conversazioni e giudizio, parti da un agente basato su competenze. Se devi vedere cosa restituisce un browser reale, ti servono accesso al browser e un limite di permessi rigido. Se vuoi la superficie più piccola possibile, leggibile dall'inizio alla fine in una sola seduta, il nucleo minimo di Pi Agent è progettato esattamente per questo, e il prezzo è che tutto ciò che ti serve vive in una competenza che aggiungi tu.
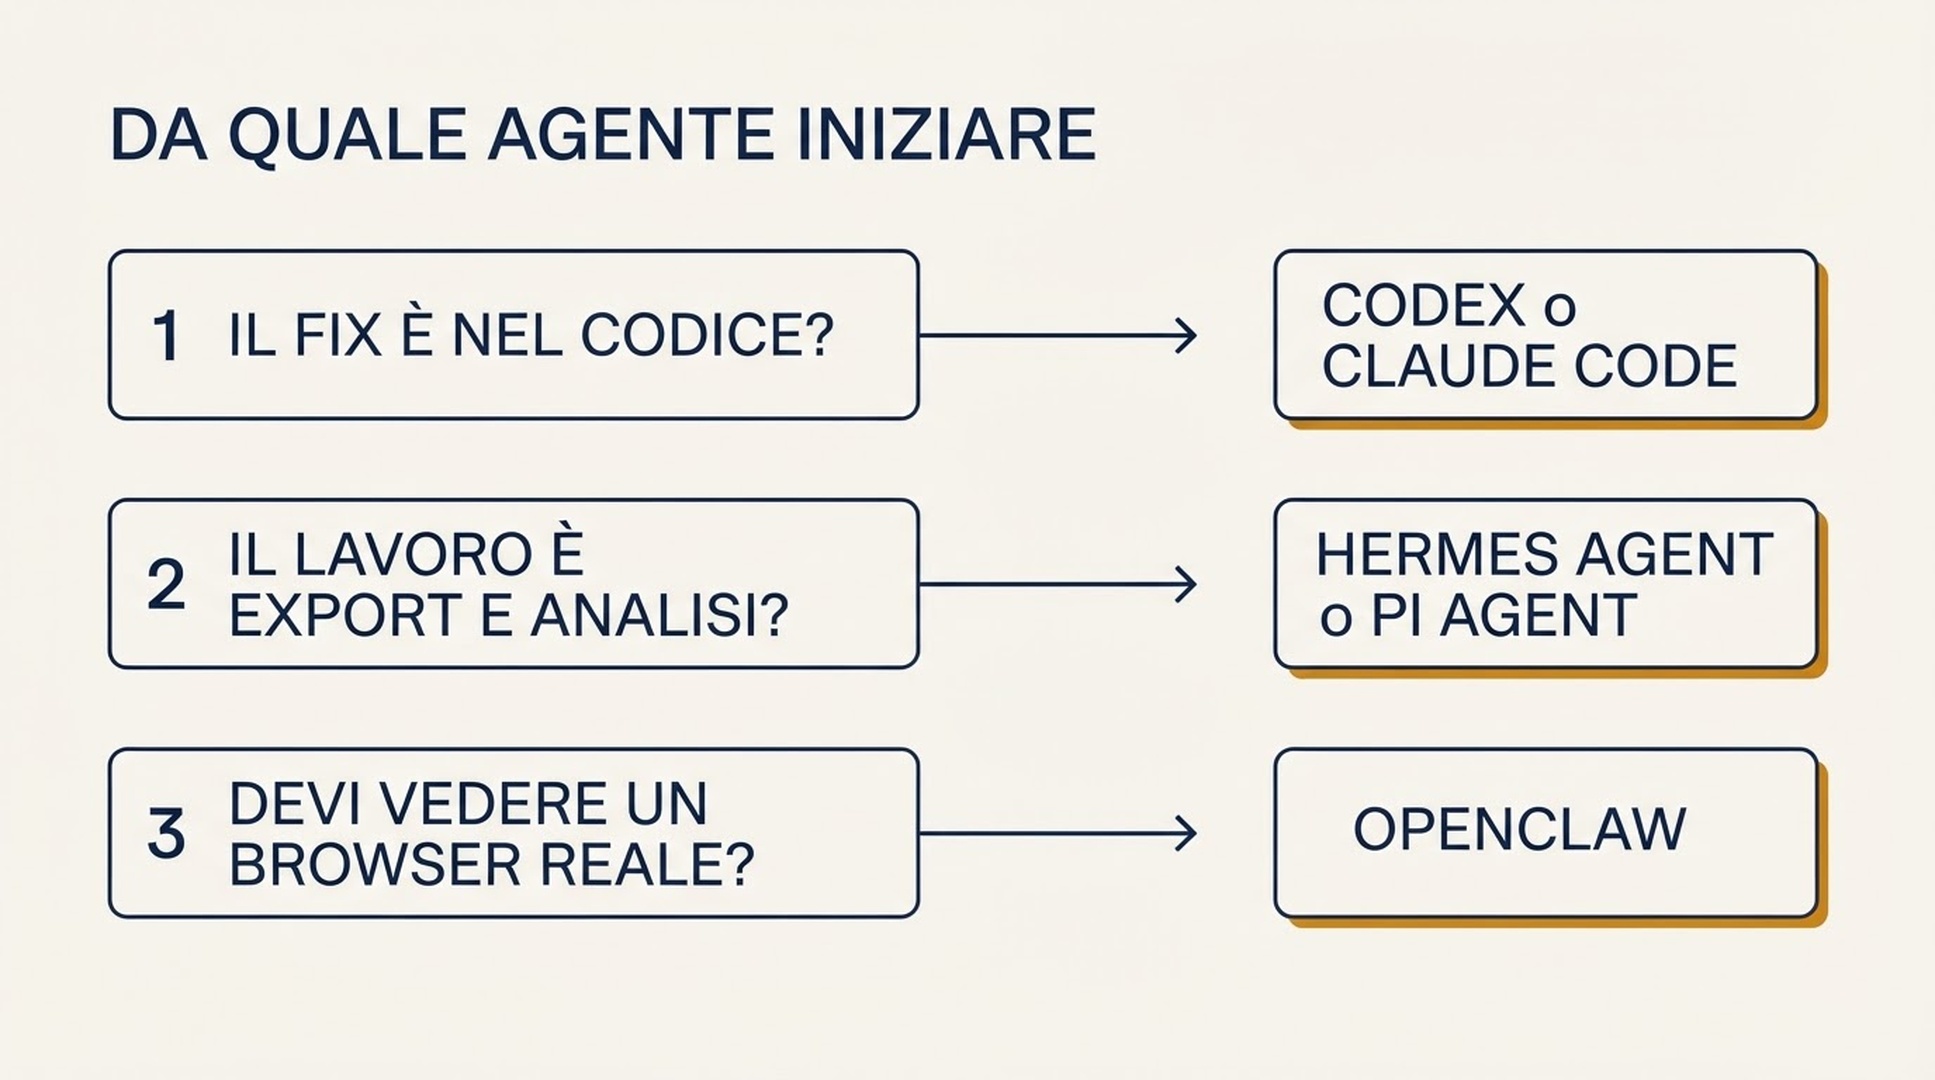
Tre domande riducono cinque agenti a uno. Rispondi prima di confrontare gli elenchi di funzionalità.
Le attività da delegare per prime
Non partire dalla più interessante. Parti da quella noiosa, che si ripete secondo un calendario e produce qualcosa che qualcuno legge. Quelle si ripagano più in fretta.
Triage del degrado dei contenuti. Prendi la performance periodo su periodo, scarta tutto ciò che sta sotto la soglia di materialità, controlla l'indicizzazione prima di ogni altra cosa e poi guarda posizioni, domanda, link e cannibalizzazione. Ottieni una tabella di URL con i clic persi, la causa probabile, l'evidenza e un'azione principale e una di riserva. Una pagina che ha perso posizioni va riscritta. Una che ha perso domanda non ha bisogno di nulla. Una che ha perso il canonical si sistema in cinque minuti. I team confondono questi tre casi di continuo, e la confusione non è economica.
Triage dei problemi tecnici. Raggruppa i problemi per causa radice invece che per tipo, collega gli URL interessati a traffico e posizioni, valuta l'impatto rispetto allo sforzo e verifica i primi punti su pagine reali prima di scrivere la lista dei fix. Il valore sta in quel raggruppamento. Dieci righe di "redirect temporaneo" di solito hanno una sola causa radice, e sistemare un template è meglio che sistemare dieci URL.
Movimenti dei concorrenti. Isola le pagine e le keyword dietro una variazione di traffico, separa il brand dal non brand e verifica ogni cambiamento rispetto a un fattore con un nome: contenuto nuovo, posizioni migliorate, stagionalità, una migrazione o un artefatto di dati. La risposta sono il fattore e il livello di confidenza. Un numero grande con bassa confidenza è un motivo per guardare più da vicino, non per reagire.
Link interni e pagine orfane. Costruisci un bacino di candidate dalle pagine che già si posizionano o guadagnano link, trova i passaggi direttamente collegati a ogni destinazione e applica un test di valore per il lettore: qualcuno a metà di questa frase vorrebbe davvero andarci? La metà strutturale del risultato spesso vale più dei link stessi. Scoprire che la seconda pagina più grande non ha nessun link interno che la punta è un fix da cinque minuti con un effetto sproporzionato.
Mappatura dei gap di citazione. Raggruppa i prompt per tema e fase di acquisto, trova i domini e le pagine più citati, separa i tipi di fonte e leggi le pagine citate per capire cosa porterebbe davvero una menzione. Aspettati che buona parte dell'output siano fonti dove la risposta giusta è non contattare nessuno. I forum e le proprietà dei concorrenti non sono obiettivi di outreach.
Controllo delle regressioni dopo il rilascio. Confronta un crawl prima e uno dopo con impostazioni identiche, conferma che siano confrontabili prima di differenziare qualsiasi cosa e classifica ogni differenza come attesa, attesa ma implementata male o non pianificata. È questa classificazione a rendere utilizzabile il report. Senza, resta un muro di differenze e nessuna decisione.
Sulle più frequenti abbiamo guide più dettagliate<|placeholdermmspan0442|>: report settimanali sulle posizioni, monitoraggio giornaliero, lavoro sul profilo dei link e progettazione di avvisi che non ti sommergono.
Parti da una competenza, non da un reparto
Il fallimento più comune è montare otto competenze, sette connessioni e uno scheduler prima di aver eseguito qualcosa anche solo una volta. Poi niente funziona e non è chiaro quale dei sedici pezzi sia la causa.
Fai invece in questo ordine.
Scegli un'attività con un output visibile. La più rapida da validare è il triage dei problemi tecnici, perché puoi puntarla su un crawl che hai già e giudicare il risultato in pochi minuti. Il degrado dei contenuti è il secondo più semplice se hai storico in Search Console.
Scrivi la competenza prima di collegare qualsiasi cosa. Il file della competenza deve stare in una pagina e rispondere a sei domande: quando usarla, di quali dati ha bisogno, l'ordine dei passaggi, le regole di punteggio o soglia, il formato di output e quali azioni richiedono approvazione. Se non ci sta in una pagina, l'attività non è ancora definita abbastanza chiaramente per essere automatizzata.
Collega una sola fonte di dati. Quella che la competenza richiede davvero. I connettori che non usi allargano solo la superficie senza aggiungere valore.
Eseguila in sola lettura e controlla l'output a mano. Prendi due riscontri e verificali tu stesso rispetto ai dati di origine. Se la spiegazione dell'agente non corrisponde a quello che vedi, il problema è nella competenza, non nel modello.
Aggiungi il gate di approvazione prima di aggiungere la seconda competenza. Ogni azione di scrittura (pubblicare, reindirizzare, eliminare, modificare codice, fare merge, inviare all'esterno) deve fermarsi e aspettare. Costruisci questa abitudine finché la posta in gioco è una sola competenza.
Le protezioni che evitano che vada storto
Queste sono le regole che metteremmo nelle istruzioni di progetto il primo giorno. Sono noiose di proposito, ed è proprio questo il punto.
- Tieni gli strumenti di produzione in sola lettura finché non approvi un'azione di scrittura.
- Pretendi un piano prima di iniziare qualsiasi flusso a più passaggi.
- Ottieni le prove con gli strumenti collegati invece di affidarti a supposizioni.
- Segui la competenza pertinente quando esiste, invece di improvvisare.
- Se una chiamata a uno strumento fallisce, riprova una volta e poi mostra l'errore invece di aggirarlo.
- Pretendi che ogni riscontro motivi la propria evidenza in una frase.
- Separa i riscontri confermati dalle ipotesi, direttamente nell'output.
- Segnala i dati mancanti e le conclusioni a bassa confidenza invece di riempire il vuoto.
- Fermati quando il flusso supera un limite concordato di URL, righe o unità API.
- Chiedi approvazione prima di pubblicare, reindirizzare, eliminare, modificare codice, fare merge o inviare qualcosa all'esterno.
Due di queste fanno più lavoro del resto. Separare i riscontri confermati dalle ipotesi rende l'output abbastanza affidabile da agirci sopra. Il limite di spesa impedisce a un ciclo mal configurato di bruciare il budget API in una notte.
Dove si rompe
Dati di conversione scarni. Un motore decisionale per il portafoglio contenuti che classifica ogni URL come mantenere, aggiornare, consolidare, reindirizzare, rimuovere o investigare ha bisogno di dati di conversione per decidere. Se il tracciamento non è configurato bene, restituirà molti zeri e il report è inutile finché non si sistema. L'agente ha fatto il suo lavoro. L'input era sbagliato.
Giudizio strutturale. Un agente può trovare quattro cose che un brief umano ha mancato, tra cui una keyword che porta a un tipo di risultato completamente diverso e quindi non dovrebbe stare su quella pagina. Ma non può decidere come strutturare l'articolo. Quella decisione resta a una persona, e fingere il contrario produce contenuti che si leggono come se fossero stati assemblati da pezzi.
Errori di spiegazione silenziosi. Gli agenti falliscono in modo rumoroso nella fase dati e in modo silenzioso in quella di spiegazione. Un export mancante genera un errore. Una causa sbagliata detta con sicurezza, no. Per questo la regola dell'evidenza per riscontro conta più di quanto sembri.
Lacune negli strumenti che non avevi previsto. Alcuni dati semplicemente non sono raggiungibili tramite un connettore. Un connettore di dati sulle posizioni può non essere in grado di creare un progetto di crawl, avviare un crawl o esportare l'intero insieme di URL scansionati. Progetta il flusso intorno a ciò che la connessione può realmente restituire, altrimenti la competenza si blocca a metà strada.
Verifica il risultato prima di fidarti del ciclo
Esegui questo controllo le prime tre volte, poi una volta al mese.
- Scegli due riscontri a caso e verificali a mano rispetto ai dati di origine.
- Conferma che l'agente abbia citato una fonte e una data per ogni affermazione che dipende dai dati.
- Verifica che almeno un riscontro sia etichettato come a bassa confidenza. Un agente sicuro di tutto non sta discriminando.
- Conferma che la forma dell'output corrisponda all'esecuzione precedente. Se è andata alla deriva, il file della competenza è cambiato o l'agente ha smesso di seguirlo.
- Conferma che nulla sia stato scritto, pubblicato o inviato senza che sia scattato un gate di approvazione.
Se tutti e cinque passano per tre esecuzioni di fila, hai un flusso di lavoro. Se qualcuno fallisce, sistema il livello che l'ha causato invece di riscrivere il prompt.
Domande frequenti
Cos'è il SEO agentico? Il SEO agentico è affidare un flusso di lavoro SEO definito a un agente IA che recupera da sé i propri dati, segue un metodo scritto e restituisce un'analisi della stessa forma a ogni esecuzione. Il tratto decisivo non è l'autonomia, è la ripetibilità: il metodo vive fuori dalla conversazione, quindi gli stessi controlli si applicano che tu ti sia ricordato di chiederli o no.
In cosa differisce dal SEO assistito dall'IA? La differenza sta in chi decide cosa succede dopo. Nel SEO assistito dall'IA scegli i passaggi a ogni conversazione e incolli i dati. Nel SEO agentico definisci il metodo una volta, l'agente recupera i propri dati e, davanti a un input inatteso, segue una regola documentata. L'automazione del flusso è una terza cosa: coerenza perfetta senza adattività.
Serve un agente di programmazione? No. Agenti come Codex e Claude Code si adattano meglio quando il fix è una modifica al codice o il sito vive in un repository. Se il tuo lavoro è soprattutto export, analisi e giudizio, un agente basato su competenze lo copre senza toccare il<|placeholdermmspan0442|> terminale.
<|place_holder_mm_span_0442|> Quante competenze creare all'inizio? Una. Scegli un'attività con un output visibile, scrivi la competenza perché stia in una pagina, collega solo la fonte di dati che le serve ed eseguila in sola lettura finché l'output non è affidabile. I team che creano otto competenze senza averne eseguita una di solito abbandonano il progetto.
Un flusso di SEO agentico può pubblicare contenuti da solo? Può, e non dovrebbe. Tieni pubblicazione, reindirizzamenti, eliminazione, modifica del codice, merge e messaggi esterni dietro un gate di approvazione esplicito. Il valore del flusso sta nelle prove che mette insieme, non nel permesso che ha.
Quanto costa gestirlo? Dipende dalle fonti di dati, non dall'agente. Search Console è gratuito per il tuo dominio. Il costo ricorrente sta nei dati sulle posizioni, nei dati SERP e nei servizi di crawl, e la maggior parte ha piani gratuiti sufficienti a validare un flusso prima di impegnarti.
Autore: Aaron Wolfe, progettista di sistemi di crescita organica in Auspia con 15 anni di esperienza in SEO/GEO. Scrive di come i team integrano agenti IA, dati e passaggi di revisione in flussi di ricerca che sopravvivono a un ciclo di pianificazione trimestrale.