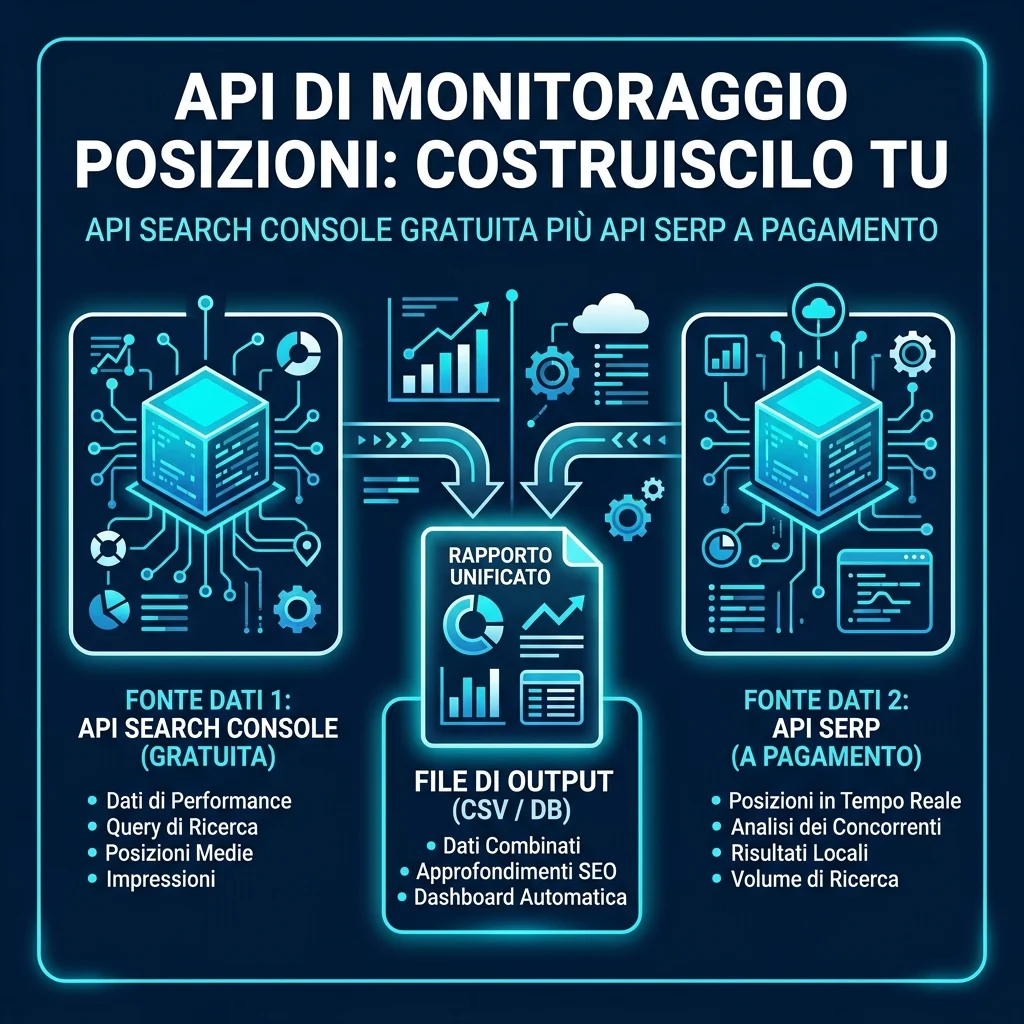
Un'API di rank tracking non è una cosa sola. Lo sviluppatore che cerca "rank tracking API" di solito vuole un singolo endpoint che restituisca posizioni, e il mercato risponde con liste di fornitori. La risposta onesta è che servono due fonti, e rispondono a domande diverse.
L'API di Search Console è gratuita, ufficiale e permanentemente limitata alle proprietà che riesci a verificare. Un'API SERP è a pagamento, non ufficiale e può controllare qualsiasi parola chiave ovunque, comprese parole chiave per cui non ti sei mai posizionato. Nessuna delle due da sola è un rank tracker. Insieme sono circa 120 righe di Python e una voce in cron.
Questa è la costruzione. Presuppone che tu sappia eseguire uno script e salvare un file. Non presuppone che tu voglia costruire un prodotto.
Con cosa finisci
Per chi è: uno sviluppatore o un marketer tecnico che ha già accesso a Search Console e vuole posizioni con una cadenza senza pagare per postazione.
Cosa avrai alla fine: due funzioni di estrazione funzionanti, un file di output unito per esecuzione e una regola di confronto che impedisce ai numeri di mentirti.
Tempo: circa 90 minuti per la prima costruzione, poi all'incirca 10 minuti di revisione per esecuzione.
Come si presenta "fatto": un file JSON datato che contiene le tue posizioni per query e dispositivo, più istantanee SERP dal vivo per una lista di parole chiave congelata, e un breve diff rispetto all'esecuzione precedente.
Prima di iniziare: cosa può e cosa non può fare ciascuna fonte
Azzecca questa divisione e il resto della costruzione diventa meccanico. Sbagliala e passerai un mese a costruire qualcosa di inutile o costoso.
API di Search Console | API SERP | |
|---|---|---|
Posizioni di chi | Solo le tue proprietà verificate | Chiunque, concorrenti compresi |
Parole chiave | Query in cui compari già | Qualsiasi parola chiave tu digiti |
Costo | Gratuito | Addebitato per richiesta |
Suddivisione per dispositivo | Sì, come dimensione | Sì, per richiesta |
Località | I paesi in cui ti posizioni | Qualsiasi località supportata dal fornitore |
Tipo di dato | Clic, impression e posizione aggregati | Pagina dei risultati in un istante |
Profondità storica | L'intervallo che richiedi | Solo dal giorno in cui inizi a conservare |
Stato ufficiale | I dati di Google stesso | La lettura di una pagina pubblica da parte di terzi |
Le due fonti saranno in disaccordo, e quel disaccordo è informativo, non un bug. Search Console fa la media di ogni impression sull'intervallo di date e su tutti i dispositivi. Un'estrazione SERP è una pagina dei risultati in un momento. Se le confronti direttamente inseguirai cali fantasma, ed è per questo che il passo cinque definisce una regola di confronto.
Tre numeri che vale la pena conoscere prima di scrivere codice. L'API di Search Console accetta un limite di righe tra 1 e 25.000 per richiesta e ne usa 1.000 come predefinito, quindi un sito di medie dimensioni può estrarre tre mesi di dati su query e dispositivi in una sola chiamata. Consente 1.200 query al minuto per sito e per utente. E impone quote di carico misurate in blocchi di 10 minuti, dove un intervallo di date lungo costa più di uno corto — esattamente il motivo per cui le indicazioni di Google stesso dicono di evitare di interrogare più volte gli stessi dati.
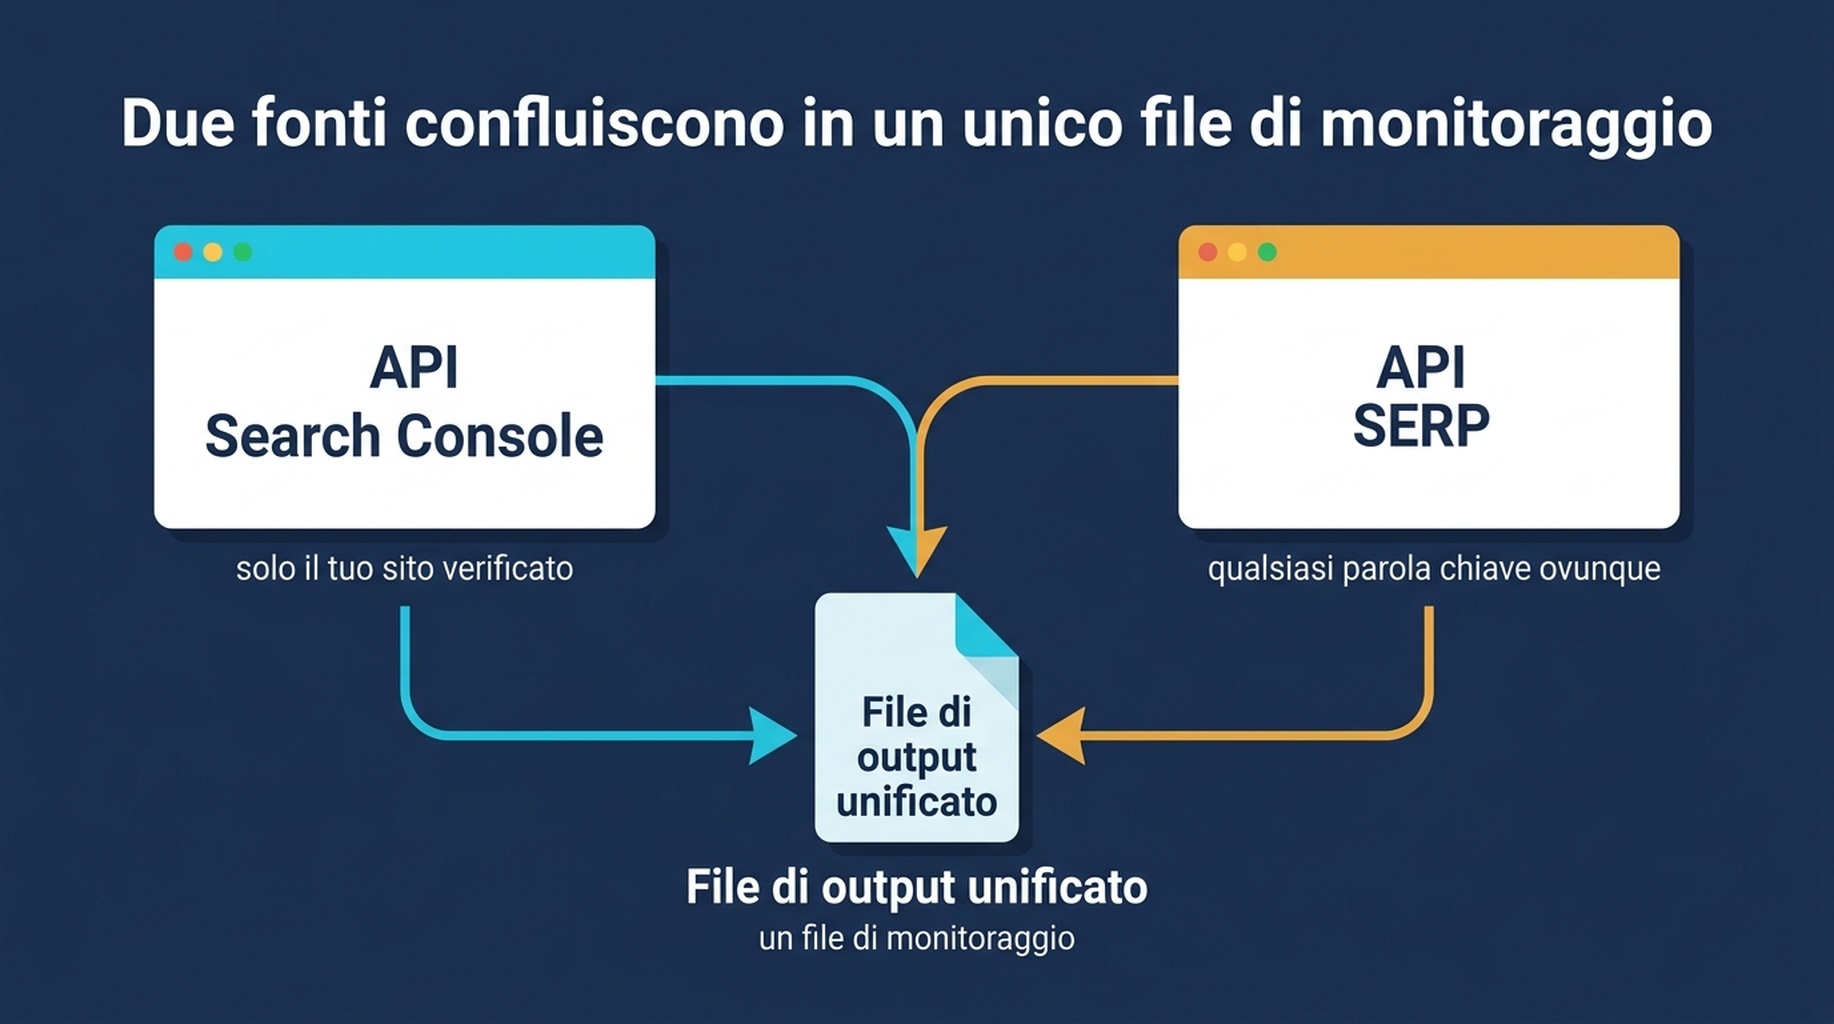
Due fonti, un output. Search Console risponde "dove compaio", un'API SERP risponde "come appare la pagina".
Passo 1: congela l'insieme di parole chiave prima di scrivere codice
Un tracker che estrae una lista di parole chiave diversa a ogni esecuzione non può rispondere se qualcosa è cambiato. Scegli prima la lista e mantienila per un trimestre.
Tre gruppi, e vengono da fonti diverse.
- Da Search Console: ogni query con almeno 20 impression negli ultimi 90 giorni. Queste non le scegli tu; le scelgono le tue impression. È il gruppo in cui il movimento significa qualcosa, perché c'è già domanda collegata.
- Dal business: le dieci-venti query che corrispondono a ricavi, che tu ti posizioni o meno.
- Dai concorrenti: le query per cui si posiziona un concorrente e tu no. Queste richiedono un'API SERP, perché Search Console non le mostrerà mai.
Scrivi la lista in un file, versionarla e tratta le aggiunte come un cambiamento deliberato e non come una deriva.
Passo 2: estrai le tue posizioni gratis
Questa metà è ufficiale, gratuita e ti dà la suddivisione per dispositivo e i dati sui clic che nessuna API SERP possiede.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
Due dettagli in quella richiesta fanno quasi tutto il lavoro.
dataState: "final" esclude i dati freschi che Google potrebbe ancora rivedere. Senza, i due o tre giorni più recenti oscillano tra le esecuzioni e il tuo diff mostra movimenti che non sono mai avvenuti.
dimensions: ["query", "device"] è ciò che rende utile l'output più avanti. Aggiungere il dispositivo adesso non costa nulla. Riesumare tre mesi di cronologia dopo costa un'esecuzione intera e non ti dà nulla per i giorni che hai già saltato.
Output atteso: una riga per query e dispositivo, con clic, impression, CTR e posizione media.
Controllo di qualità: il numero di righe dovrebbe essere sotto 25.000. Se arriva esattamente a 25.000, sei troncato e serve una seconda chiamata con startRow: 25000.
Se fallisce: un 403 di solito significa che l'email dell'account di servizio non è mai stata aggiunta come utente sulla proprietà. Aggiungila in Search Console, aspetta qualche minuto, riprova.
Passo 3: estrai le SERP che non vedi nei tuoi dati
La seconda metà copre tutto ciò che Search Console strutturalmente non può fare. Questa è una chiamata minima funzionante.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
Imposta `depth` a 100, non 200. L'abbiamo testato a settembre 2026 chiedendo 200 risultati su sei query. Google ha restituito da 83 a 128 risultati organici e si è fermato, con la posizione più profonda dell'intero test a 142. Il test completo è qui. Chiedere 200 non ti dà 200 risultati, e a seconda del fornitore potresti comunque essere fatturato per la profondità richiesta. Chiedi 100 e quasi sempre riceverai tutto ciò che esiste.
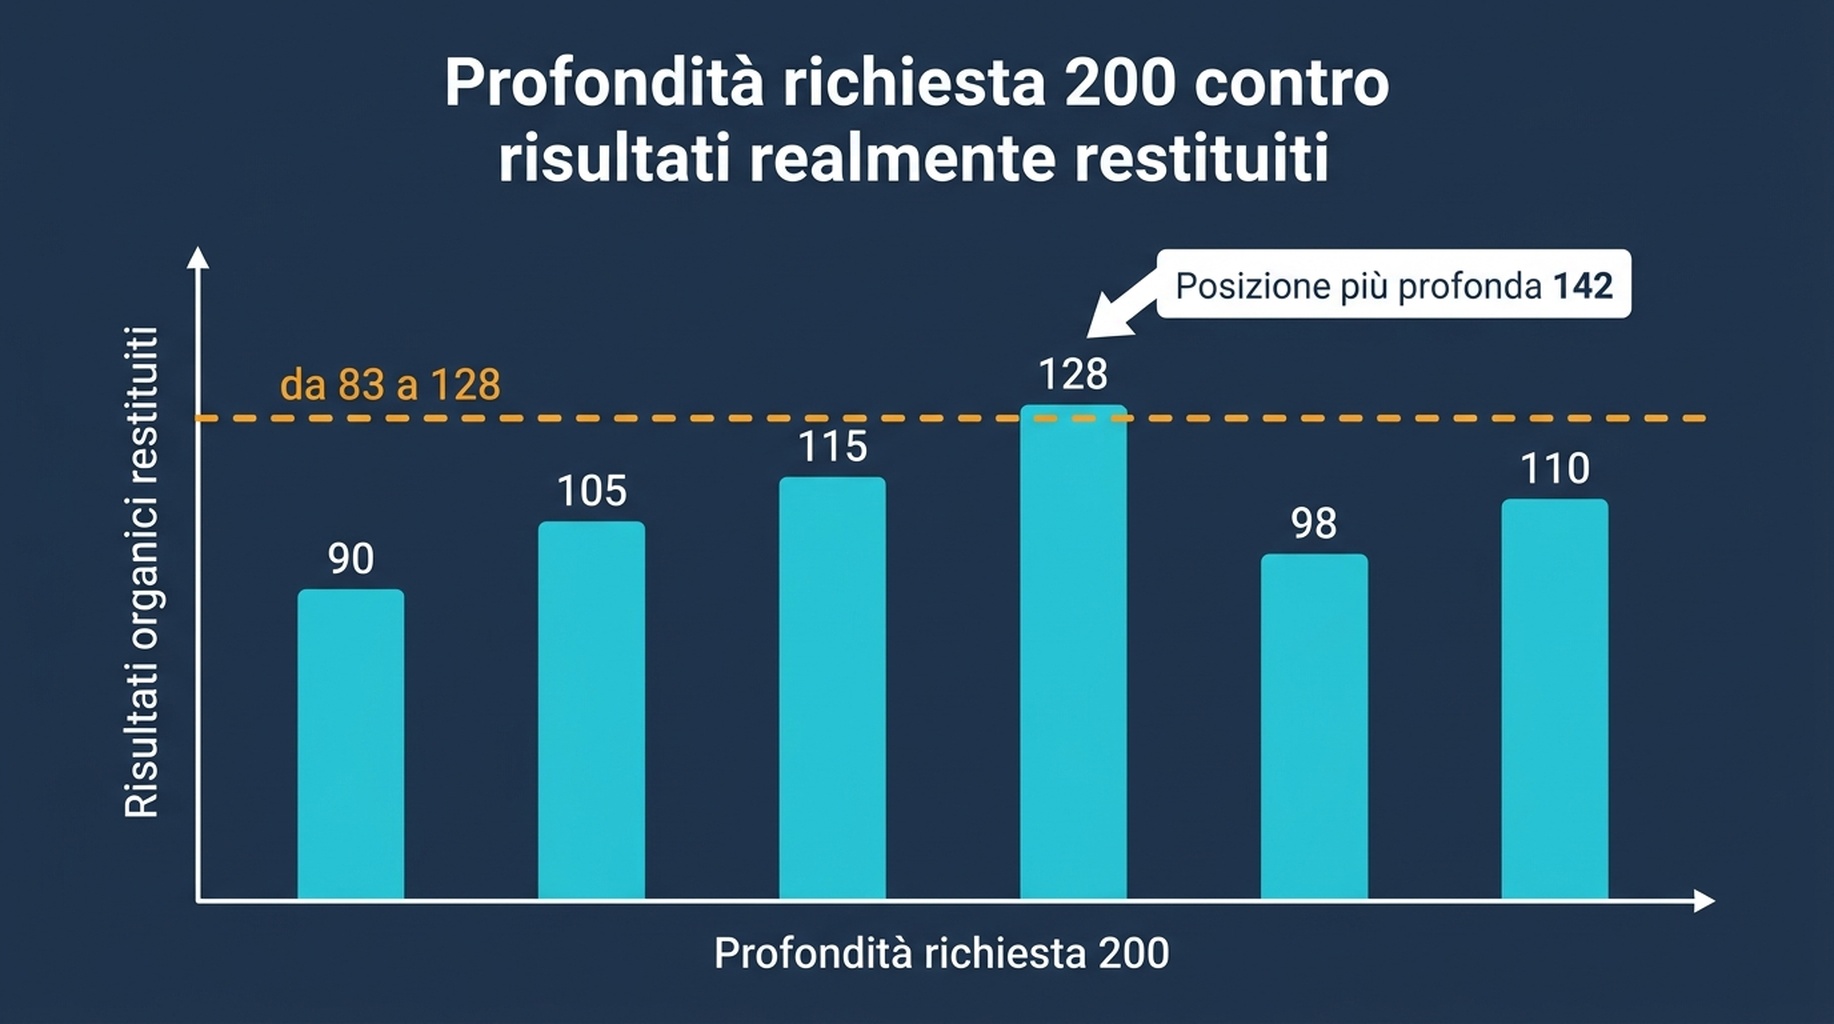
Chiedere 200 risultati e riceverne da 83 a 128. Una profondità oltre circa 140 non compra nulla sulla maggior parte delle query commerciali.
Output atteso: un payload JSON contenente elementi organici con posizione, URL, titolo e dominio.
Controllo di qualità: verifica che il payload contenga un tipo di elemento ai_overview quando ce n'è uno. Se estrai solo elementi organic, ti perderai perché una pagina ha perso clic pur mantenendo la posizione.
Se fallisce: un 401 è un errore di base64 o di credenziali. Un codice tipo 40200 significa che il saldo del tuo account è vuoto, ed è il fallimento più comune nel primo mese.
Passo 4: conserva il payload grezzo, non il riassunto
Questa è la decisione che la gente rimpiange di aver saltato.
Conservare una tabella di posizioni funziona finché non ti serve porre una domanda che non avevi previsto: la SERP si è allungata, il video ha preso il sopravvento, è entrato un concorrente, è comparso un AI Overview sopra la piega. Un riassunto non può rispondere. Il payload grezzo può, a costo aggiuntivo zero.
La versione pratica: scrivi un file per esecuzione, nominato per data e ora, contenente l'output unito. Conserva gli ultimi 90 giorni. È abbastanza piccolo da vivere in un repository e abbastanza completo da rispondere di nuovo a domande vecchie.
Passo 5: scrivi la regola di confronto prima di pianificare qualsiasi cosa
Un tracker che confronta l'ultima esecuzione con questa produce un falso allarme quasi ogni giorno. I nostri stessi numeri mostrano perché: su 124 query con almeno 30 impression, la query media si è spostata di 4,57 posizioni da un giorno all'altro. Un calo di quattro posizioni è un martedì.
Quindi la regola ha bisogno di una soglia e di una direzione.
Segnala una query solo quando:
  - il cambiamento assoluto di posizione rispetto all'esecuzione precedente è 5 o più, E
  - la query aveva almeno 20 impression nella finestra di confronto, E
  - il cambiamento non è spiegato da uno spostamento nel mix di dispositivi

Raggruppa l'output per classe di query: money, comparison, brand, informational.
Non suggerire correzioni.
La clausola sui dispositivi non è decorativa. La stessa query può stare a 11 posizioni di distanza tra mobile e desktop, e se il mix di dispositivi si sposta tra le esecuzioni, si sposta anche il numero combinato. L'abbiamo misurato separatamente ed è abbastanza grande da falsificare una tendenza.
Quanto costa
I prezzi dei fornitori cambiano, quindi costruisci il modello invece di inseguire un preventivo.
- Una parola chiave controllata una volta al giorno per 30 giorni sono 30 richieste al mese.
- Un insieme di 200 parole chiave controllato quotidianamente sono 6.000 richieste al mese.
- Lo stesso insieme controllato settimanalmente sono circa 860 richieste al mese.
- La metà di Search Console è gratuita ed è una richiesta per visualizzazione, non importa quante parole chiave contenga.
Quella moltiplicazione è l'intera decisione. Quasi ogni domanda "dovrei comprare uno strumento" si riduce a essa: calcola le richieste al mese, moltiplicale per il tuo prezzo per richiesta e confrontale con la licenza per postazione. Il monitoraggio quotidiano di un grande insieme di parole chiave di solito è più economico come abbonamento. Il monitoraggio settimanale di un insieme piccolo di solito è più economico come API. Segui una lista congelata e il lato API resta piccolo.
Quando comprare invece di costruire
Costruisci questo se vuoi le posizioni nella tua pipeline, se possiedi già una credenziale API SERP, o se ti serve la pagina dei risultati grezza per ragioni che vanno oltre la posizione.
Compra invece se ti servono posizioni storiche precedenti a oggi, se ti servono dieci località e cinque dispositivi per le stesse parole chiave, o se nessuno nel team manterrà un cron. Le liste dei fornitori valgono la lettura esattamente per questo motivo, e possedere infrastruttura che si ferma quando chi l'ha costruita cambia team ha un costo reale.
Se l'output che ti serve davvero è un report settimanale scritto e non un file JSON, il flusso di reporting in Codex parte dalle stesse due fonti e finisce in un documento. Per gli avvisi sopra il file, la guida alla progettazione del monitoraggio copre le soglie.
Visione Auspia: la domanda sull'API di rank tracking è in realtà una domanda sulla proprietà dei dati. Search Console ti dà dati ufficiali sulla tua proprietà gratis e continuerà sempre a farlo. Tutto il resto è un'istantanea che paghi. Costruisci prima la metà gratuita, e aggiungi la metà a pagamento solo dove risponde a una domanda che hai davvero.
Domande frequenti
Google offre un'API di rank tracking? Non una pubblica. L'API di Search Console restituisce la tua posizione media per query in cui compari già, il che è vicino ma non la stessa cosa. Non può controllare una parola chiave per cui non ti posizioni, né controllare un concorrente.
Quanto in profondità può arrivare un'API SERP? I fornitori accettano valori di profondità ben oltre 200, ma Google smette di servire risultati da qualche parte tra 100 e 140 sulla maggior parte delle query commerciali. Chiedere di più non produce più risultati.
Devo usare controlli giornalieri o settimanali? Settimanali per un insieme normale di parole chiave. Giornalieri solo per una lista breve di query che portano soldi. I controlli giornalieri su un insieme grande moltiplicano il costo per sette e misurano soprattutto rumore, dato che il movimento giornaliero medio nei nostri dati era di 4,57 posizioni.
Perché il mio numero dall'API differisce dal mio rank tracker? Dispositivi diversi, località diverse, momenti diversi e spesso fonti di dati diverse. Il numero è un campione. Fissa località e dispositivo nella tua richiesta e riestrai prima di concludere che qualcosa è cambiato.
Un agente può eseguirlo per me? Sì, e si adatta bene perché il compito ha la stessa forma a ogni esecuzione. Per il quadro più ampio di cosa un agente può prendersi in carico nel lavoro di posizionamento, vedi la guida sul campo all'agente SEO. Tieni la regola di confronto in un file di istruzioni scritto e lascia che l'agente produca il diff; tieni la decisione comprare-o-costruire in mano a una persona.
Autore: Rowan Blake, analista di automazione dei contenuti per oltre 100 pipeline di pubblicazione in Auspia. Rowan scrive di pipeline di dati automatizzate, reportistica pianificata e il costo di manutenzione dei sistemi che girano senza di te.