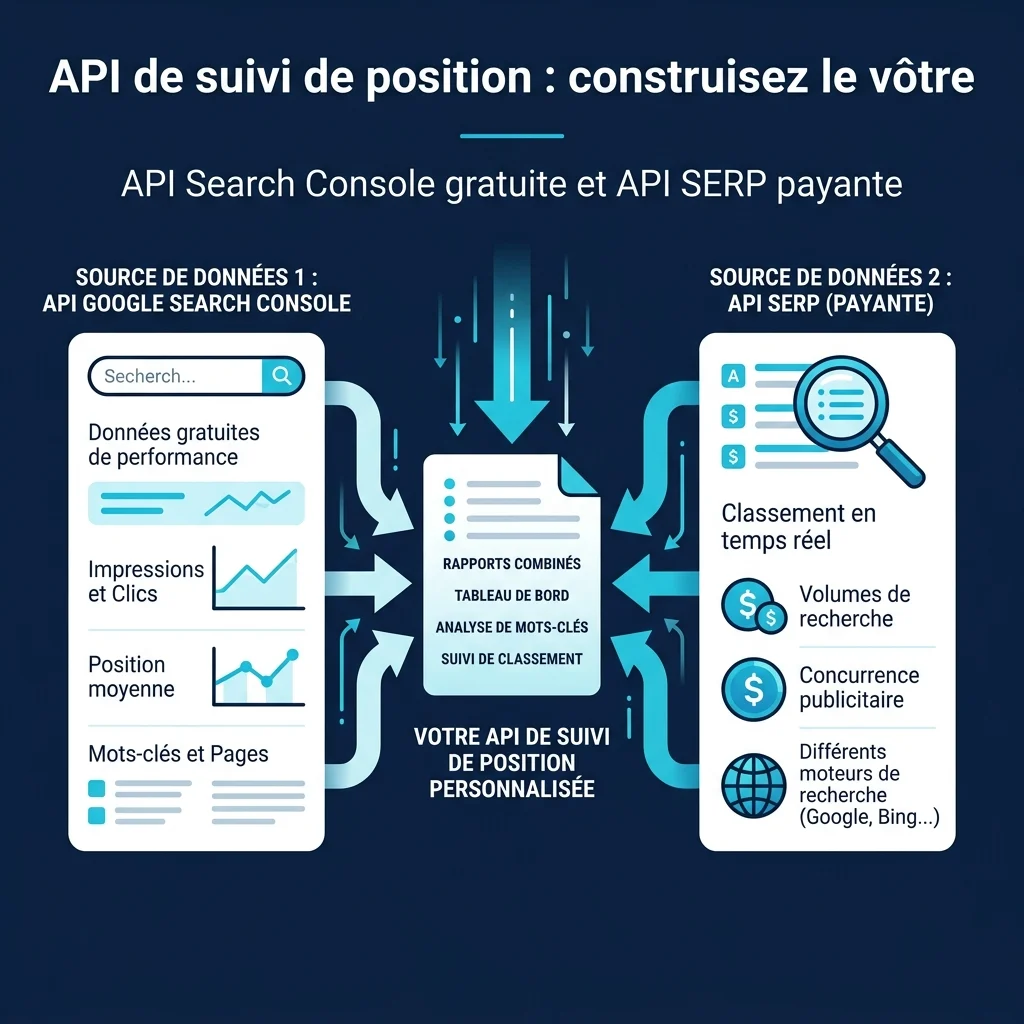
Une API de suivi de position n'est pas une seule chose. Le développeur qui cherche « rank tracking API » veut en général un point de terminaison unique qui renvoie des positions, et le marché répond avec des listicles de fournisseurs. La réponse honnête est qu'il faut deux sources, et qu'elles répondent à des questions différentes.
L'API Search Console est gratuite, officielle et définitivement limitée aux propriétés que vous pouvez valider. Une API SERP est payante, non officielle et peut vérifier n'importe quel mot-clé n'importe où, y compris des mots-clés sur lesquels vous ne vous êtes jamais positionné. Aucune des deux seule n'est un outil de suivi de position. Ensemble, ce sont environ 120 lignes de Python et une entrée cron.
Voici la construction. Elle suppose que vous savez exécuter un script et stocker un fichier. Elle ne suppose pas que vous voulez construire un produit.
Ce que vous aurez au final
Pour qui : un développeur ou un marketeur technique qui a déjà accès à la Search Console et veut des positions selon un calendrier sans payer au siège.
Ce que vous aurez à la fin : deux fonctions de collecte fonctionnelles, un fichier de sortie fusionné par exécution et une règle de comparaison qui empêche les chiffres de vous mentir.
Temps : environ 90 minutes pour la première construction, puis à peu près 10 minutes de relecture par exécution.
À quoi ressemble « terminé » : un fichier JSON daté contenant vos positions par requête et par appareil, plus des instantanés SERP en direct pour une liste de mots-clés figée, et un court diff par rapport à l'exécution précédente.
Avant de commencer : ce que chaque source peut et ne peut pas faire
Réussissez cette répartition et le reste de la construction devient mécanique. Ratez-la et vous passerez un mois à construire quelque chose d'inutile ou de coûteux.
API Search Console | API SERP | |
|---|---|---|
Positions de qui | Uniquement vos propriétés validées | N'importe qui, concurrents compris |
Mots-clés | Requêtes sur lesquelles vous apparaissez déjà | N'importe quel mot-clé que vous saisissez |
Coût | Gratuit | Facturé à la requête |
Ventilation par appareil | Oui, comme dimension | Oui, par requête |
Localisation | Les pays où vous vous positionnez | Toute localisation prise en charge par le fournisseur |
Type de données | Clics, impressions et position agrégés | Page de résultats à un instant donné |
Profondeur historique | La plage que vous demandez | Uniquement depuis le jour où vous commencez à stocker |
Statut officiel | Les données de Google lui-même | La lecture d'une page publique par un tiers |
Les deux sources vont diverger, et cette divergence est informative et non un bug. La Search Console fait la moyenne de chaque impression sur la plage de dates et sur tous les appareils. Une collecte SERP est une page de résultats à un moment donné. Si vous les comparez directement, vous courrez après des baisses fantômes, et c'est pourquoi l'étape cinq définit une règle de comparaison.
Trois chiffres à connaître avant d'écrire du code. L'API Search Console accepte une limite de lignes entre 1 et 25 000 par requête et vaut 1 000 par défaut, donc un site de taille moyenne peut extraire trois mois de données de requête et d'appareil en un seul appel. Elle autorise 1 200 requêtes par minute par site et par utilisateur. Et elle applique des quotas de charge mesurés par tranches de 10 minutes, où une longue plage de dates coûte plus cher qu'une courte — c'est exactement pourquoi les recommandations de Google lui-même disent d'éviter de réinterroger les mêmes données.
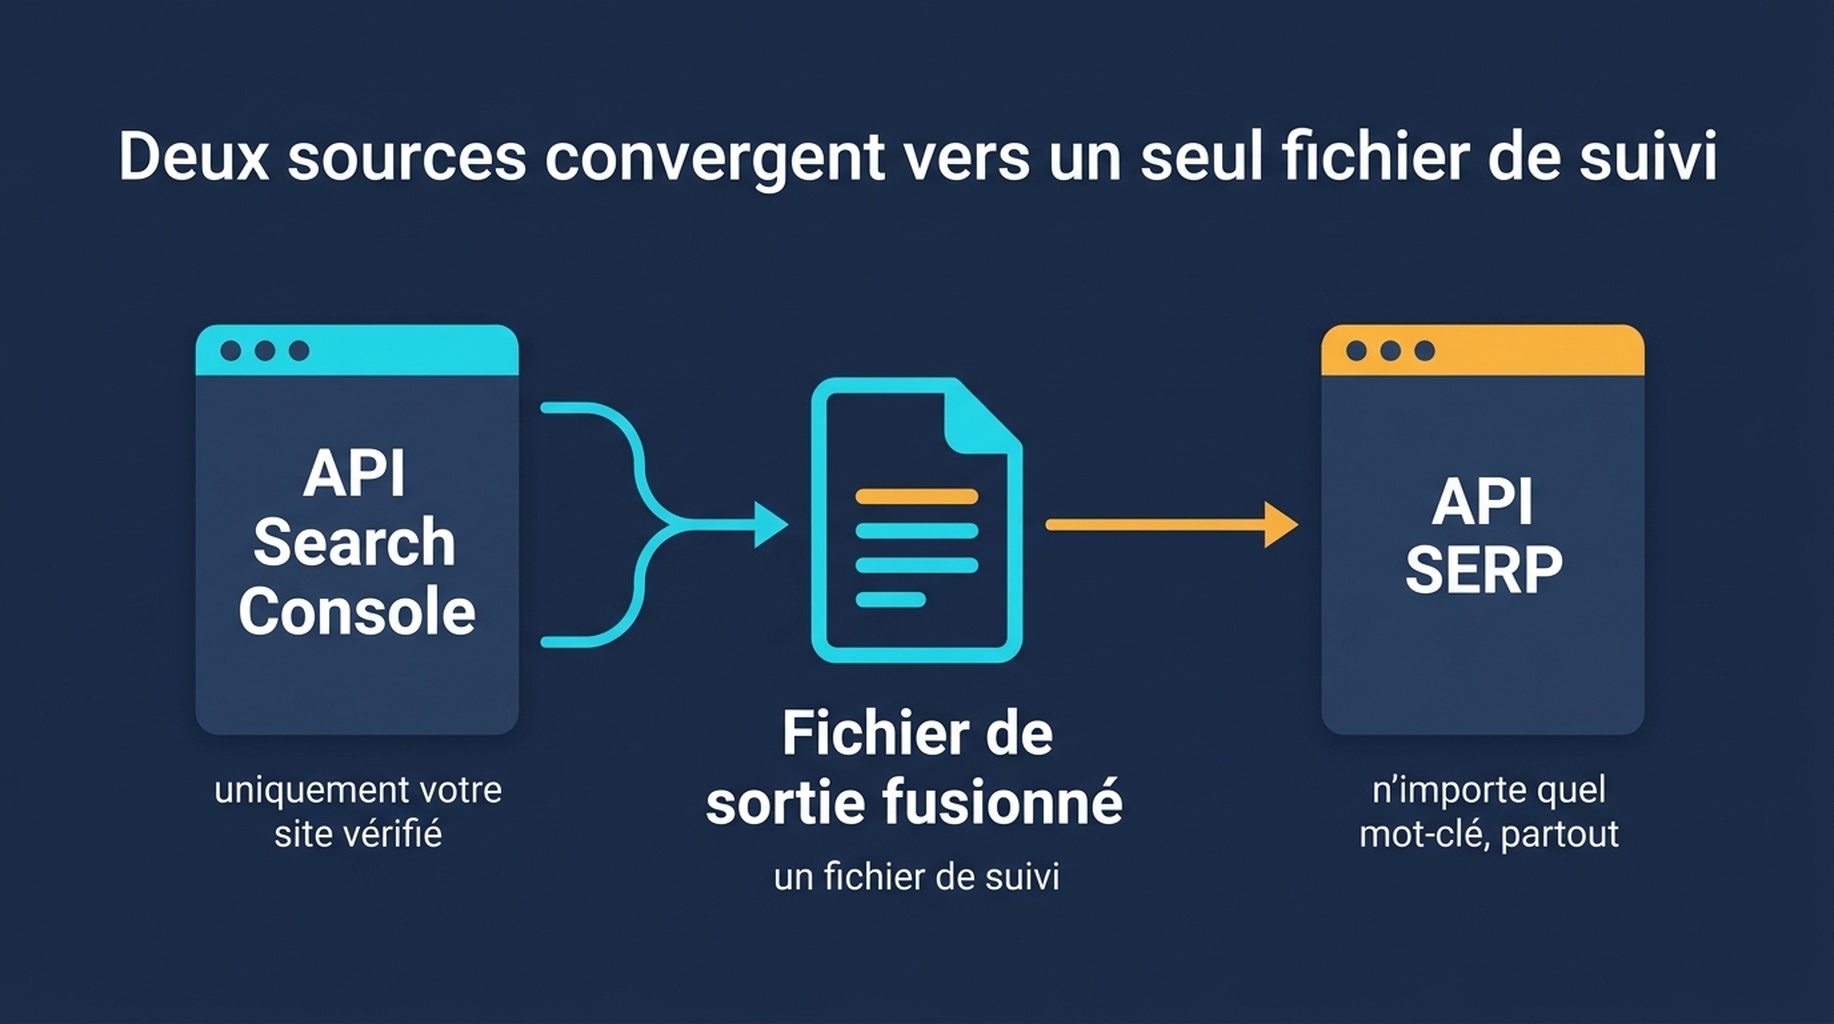
Deux sources, une sortie. La Search Console répond « où j'apparais », une API SERP répond « à quoi ressemble la page ».
Étape 1 : figez l'ensemble de mots-clés avant d'écrire la moindre ligne de code
Un outil qui extrait une liste de mots-clés différente à chaque exécution ne peut pas répondre si quelque chose a changé. Choisissez la liste d'abord et gardez-la un trimestre.
Trois groupes, et ils viennent de sources différentes.
- Depuis la Search Console : chaque requête avec au moins 20 impressions sur les 90 derniers jours. Ce n'est pas vous qui les choisissez ; ce sont vos impressions. C'est le groupe où le mouvement signifie quelque chose, parce qu'une demande y est déjà attachée.
- Depuis le métier : les dix à vingt requêtes qui correspondent à du chiffre d'affaires, que vous vous positionniez dessus ou non.
- Depuis les concurrents : les requêtes sur lesquelles un concurrent se positionne et pas vous. Celles-ci exigent une API SERP, parce que la Search Console ne les montrera jamais.
Écrivez la liste dans un fichier, versionnez-la et traitez les ajouts comme un changement délibéré plutôt qu'une dérive.
Étape 2 : récupérez vos propres positions gratuitement
Cette moitié est officielle, gratuite et vous donne la ventilation par appareil et les données de clic qu'aucune API SERP ne possède.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
Deux détails de cette requête font presque tout le travail.
dataState: "final" exclut les données fraîches que Google peut encore réviser. Sans cela, les deux ou trois jours les plus récents bougent entre les exécutions et votre diff affiche des mouvements qui n'ont jamais eu lieu.
dimensions: ["query", "device"] est ce qui rend la sortie utile plus tard. Ajouter l'appareil maintenant ne coûte rien. Réextraire trois mois d'historique plus tard coûte une exécution complète et ne vous apporte rien pour les jours que vous avez déjà sautés.
Sortie attendue : une ligne par requête et par appareil, avec clics, impressions, CTR et position moyenne.
Contrôle qualité : le nombre de lignes doit être inférieur à 25 000. S'il tombe exactement à 25 000, vous êtes tronqué et il faut un second appel avec startRow: 25000.
En cas d'échec : un 403 signifie en général que l'e-mail du compte de service n'a jamais été ajouté comme utilisateur sur la propriété. Ajoutez-le dans la Search Console, attendez quelques minutes, réessayez.
Étape 3 : récupérez les SERP que vous ne voyez pas dans vos propres données
La seconde moitié couvre tout ce que la Search Console ne peut structurellement pas faire. Voici un appel minimal qui fonctionne.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
Réglez `depth` sur 100, pas 200. Nous l'avons testé en septembre 2026 en demandant 200 résultats sur six requêtes. Google a renvoyé de 83 à 128 résultats organiques puis s'est arrêté, la position la plus profonde de tout le test étant à 142. Le test complet est ici. Demander 200 ne donne pas 200 résultats, et selon le fournisseur, la profondeur demandée peut vous être facturée quand même. Demandez 100 et vous recevrez presque toujours tout ce qui existe.
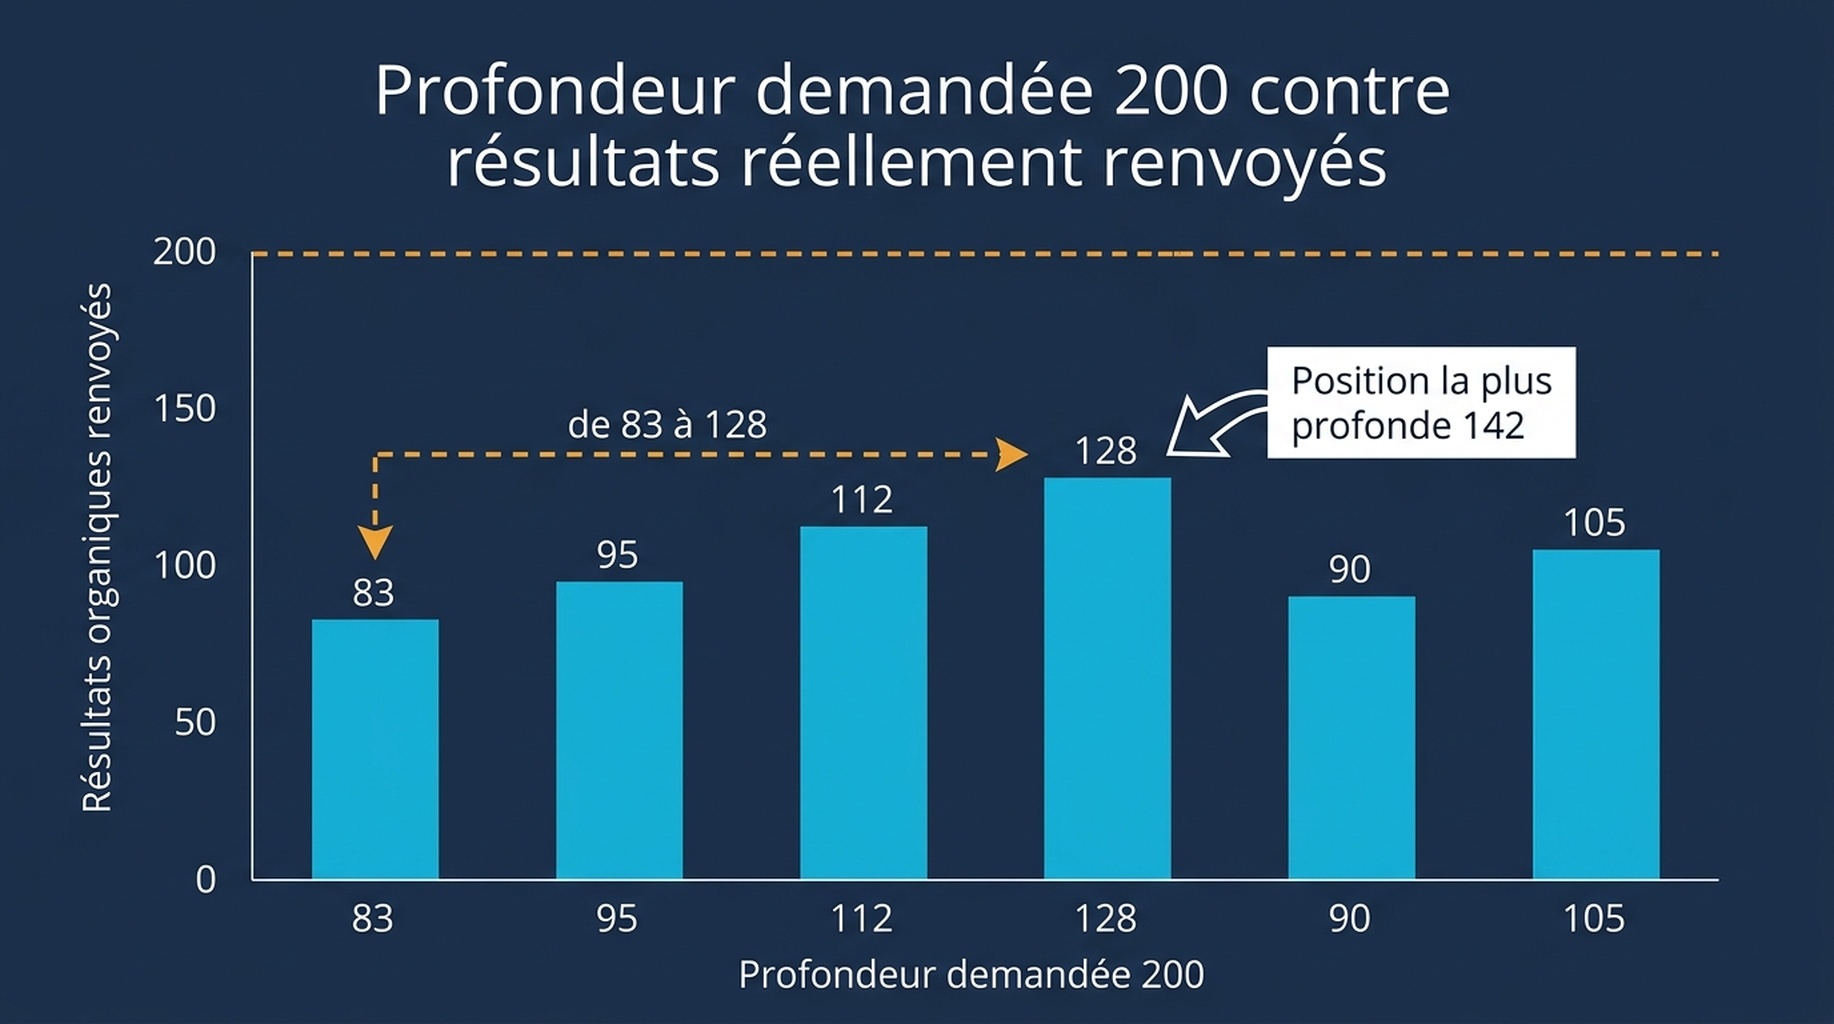
Demander 200 résultats et en recevoir de 83 à 128. Une profondeur au-delà d'environ 140 n'achète rien sur la plupart des requêtes commerciales.
Sortie attendue : une charge utile JSON contenant des éléments organiques avec position, URL, titre et domaine.
Contrôle qualité : vérifiez que la charge utile contient un type d'élément ai_overview quand il y en a un. Si vous n'extrayez que les éléments organic, vous manquerez pourquoi une page a perdu des clics tout en gardant sa position.
En cas d'échec : un 401 est une erreur base64 ou d'identifiants. Un code de type 40200 signifie que le solde de votre compte est vide, ce qui est l'échec le plus courant le premier mois.
Étape 4 : stockez la charge utile brute, pas le résumé
C'est la décision que les gens regrettent d'avoir sautée.
Stocker un tableau de positions fonctionne jusqu'à ce que vous ayez besoin de poser une question que vous n'aviez pas prévue : la SERP s'est-elle allongée, la vidéo a-t-elle pris le dessus, un concurrent est-il entré, un AI Overview est-il apparu au-dessus de la ligne de flottaison. Un résumé ne peut pas y répondre. La charge utile brute le peut, à coût supplémentaire nul.
La version pratique : écrivez un fichier par exécution, nommé par la date et l'heure, contenant la sortie fusionnée. Conservez les 90 derniers jours. C'est assez petit pour vivre dans un dépôt et assez complet pour répondre à nouveau à d'anciennes questions.
Étape 5 : écrivez la règle de comparaison avant de planifier quoi que ce soit
Un outil qui compare la dernière exécution à celle-ci produit une fausse alerte la plupart des jours. Nos propres chiffres montrent pourquoi : sur 124 requêtes avec au moins 30 impressions, la requête moyenne s'est déplacée de 4,57 positions d'un jour à l'autre. Une baisse de quatre positions, c'est un mardi.
La règle a donc besoin d'un seuil et d'une direction.
Signaler une requête seulement lorsque :
  - le changement absolu de position par rapport à l'exécution précédente est de 5 ou plus, ET
  - la requête avait au moins 20 impressions dans la fenêtre de comparaison, ET
  - le changement n'est pas expliqué par un décalage du mix d'appareils

Regrouper la sortie par classe de requête : money, comparison, brand, informational.
Ne pas suggérer de corrections.
La clause sur les appareils n'est pas décorative. La même requête peut se situer à 11 positions d'écart entre mobile et ordinateur, et si le mix d'appareils bouge entre les exécutions, le chiffre combiné bouge aussi. Nous avons mesuré cela séparément et c'est assez important pour falsifier une tendance.
Ce que cela coûte
Les prix des fournisseurs changent, alors construisez le modèle au lieu de courir après un devis.
- Un mot-clé vérifié une fois par jour pendant 30 jours, c'est 30 requêtes par mois.
- Un ensemble de 200 mots-clés vérifié quotidiennement, c'est 6 000 requêtes par mois.
- Le même ensemble vérifié chaque semaine, c'est environ 860 requêtes par mois.
- La moitié Search Console est gratuite et représente une requête par vue, quel que soit le nombre de mots-clés qu'elle contient.
Cette multiplication est toute la décision. Presque toute question « dois-je acheter un outil » s'y réduit : calculez les requêtes par mois, multipliez par votre prix à la requête et comparez avec la licence au siège. Le suivi quotidien d'un grand ensemble est généralement moins cher en abonnement. Le suivi hebdomadaire d'un petit ensemble est généralement moins cher en API. Suivez une liste figée et le côté API reste petit.
Quand acheter plutôt que construire
Construisez ceci si vous voulez les positions dans votre propre pipeline, si vous possédez déjà un identifiant d'API SERP, ou si vous avez besoin de la page de résultats brute pour des raisons au-delà de la position.
Achetez plutôt si vous avez besoin de positions historiques antérieures à aujourd'hui, s'il vous faut dix localisations et cinq appareils pour les mêmes mots-clés, ou si personne dans l'équipe ne maintiendra une tâche cron. Les listicles de fournisseurs valent la lecture exactement pour cette raison, et posséder une infrastructure qui s'arrête quand la personne qui l'a construite change d'équipe a un coût réel.
Si la sortie dont vous avez réellement besoin est un rapport hebdomadaire écrit plutôt qu'un fichier JSON, le flux de reporting dans Codex part des deux mêmes sources et aboutit à un document. Pour l'alerte par-dessus le fichier, le guide de conception du monitoring couvre les seuils.
Point de vue Auspia : la question de l'API de suivi de position est en réalité une question de propriété des données. La Search Console vous donne gratuitement des données officielles sur votre propre propriété et continuera toujours de le faire. Tout le reste est un instantané que vous payez. Construisez d'abord la moitié gratuite, et n'ajoutez la moitié payante que là où elle répond à une question que vous avez réellement.
Questions fréquentes
Google propose-t-il une API de suivi de position ? Pas publiquement. L'API Search Console renvoie votre position moyenne pour les requêtes sur lesquelles vous apparaissez déjà, ce qui s'en approche sans être la même chose. Elle ne peut pas vérifier un mot-clé sur lequel vous ne vous positionnez pas, ni vérifier un concurrent.
Jusqu'où une API SERP peut-elle aller ? Les fournisseurs acceptent des valeurs de profondeur bien au-delà de 200, mais Google cesse de servir des résultats quelque part entre 100 et 140 sur la plupart des requêtes commerciales. Demander plus ne produit pas plus de résultats.
Faut-il des vérifications quotidiennes ou hebdomadaires ? Hebdomadaires pour un ensemble de mots-clés normal. Quotidiennes uniquement pour une courte liste de requêtes à enjeu. Les vérifications quotidiennes sur un grand ensemble multiplient le coût par sept et mesurent surtout du bruit, puisque le mouvement quotidien moyen dans nos données était de 4,57 positions.
Pourquoi mon chiffre d'API diffère-t-il de mon outil de suivi ? Appareils différents, localisations différentes, moments différents et souvent sources de données différentes. Le chiffre est un échantillon. Fixez la localisation et l'appareil dans votre requête et réextrayez avant de conclure que quelque chose a changé.
Un agent peut-il faire tourner cela pour moi ? Oui, et cela convient bien parce que la tâche a la même forme à chaque exécution. Pour la vue d'ensemble de ce qu'un agent peut porter dans le travail de position, voir le guide de terrain de l'agent SEO. Gardez la règle de comparaison dans un fichier d'instructions écrit et laissez l'agent produire le diff ; gardez la décision d'acheter ou de construire chez une personne.
Auteur : Rowan Blake, analyste en automatisation de contenu pour plus de 100 pipelines de publication chez Auspia. Rowan écrit sur les pipelines de données automatisés, le reporting planifié et le coût de maintenance des systèmes qui tournent sans vous.