Con qué vas a terminar
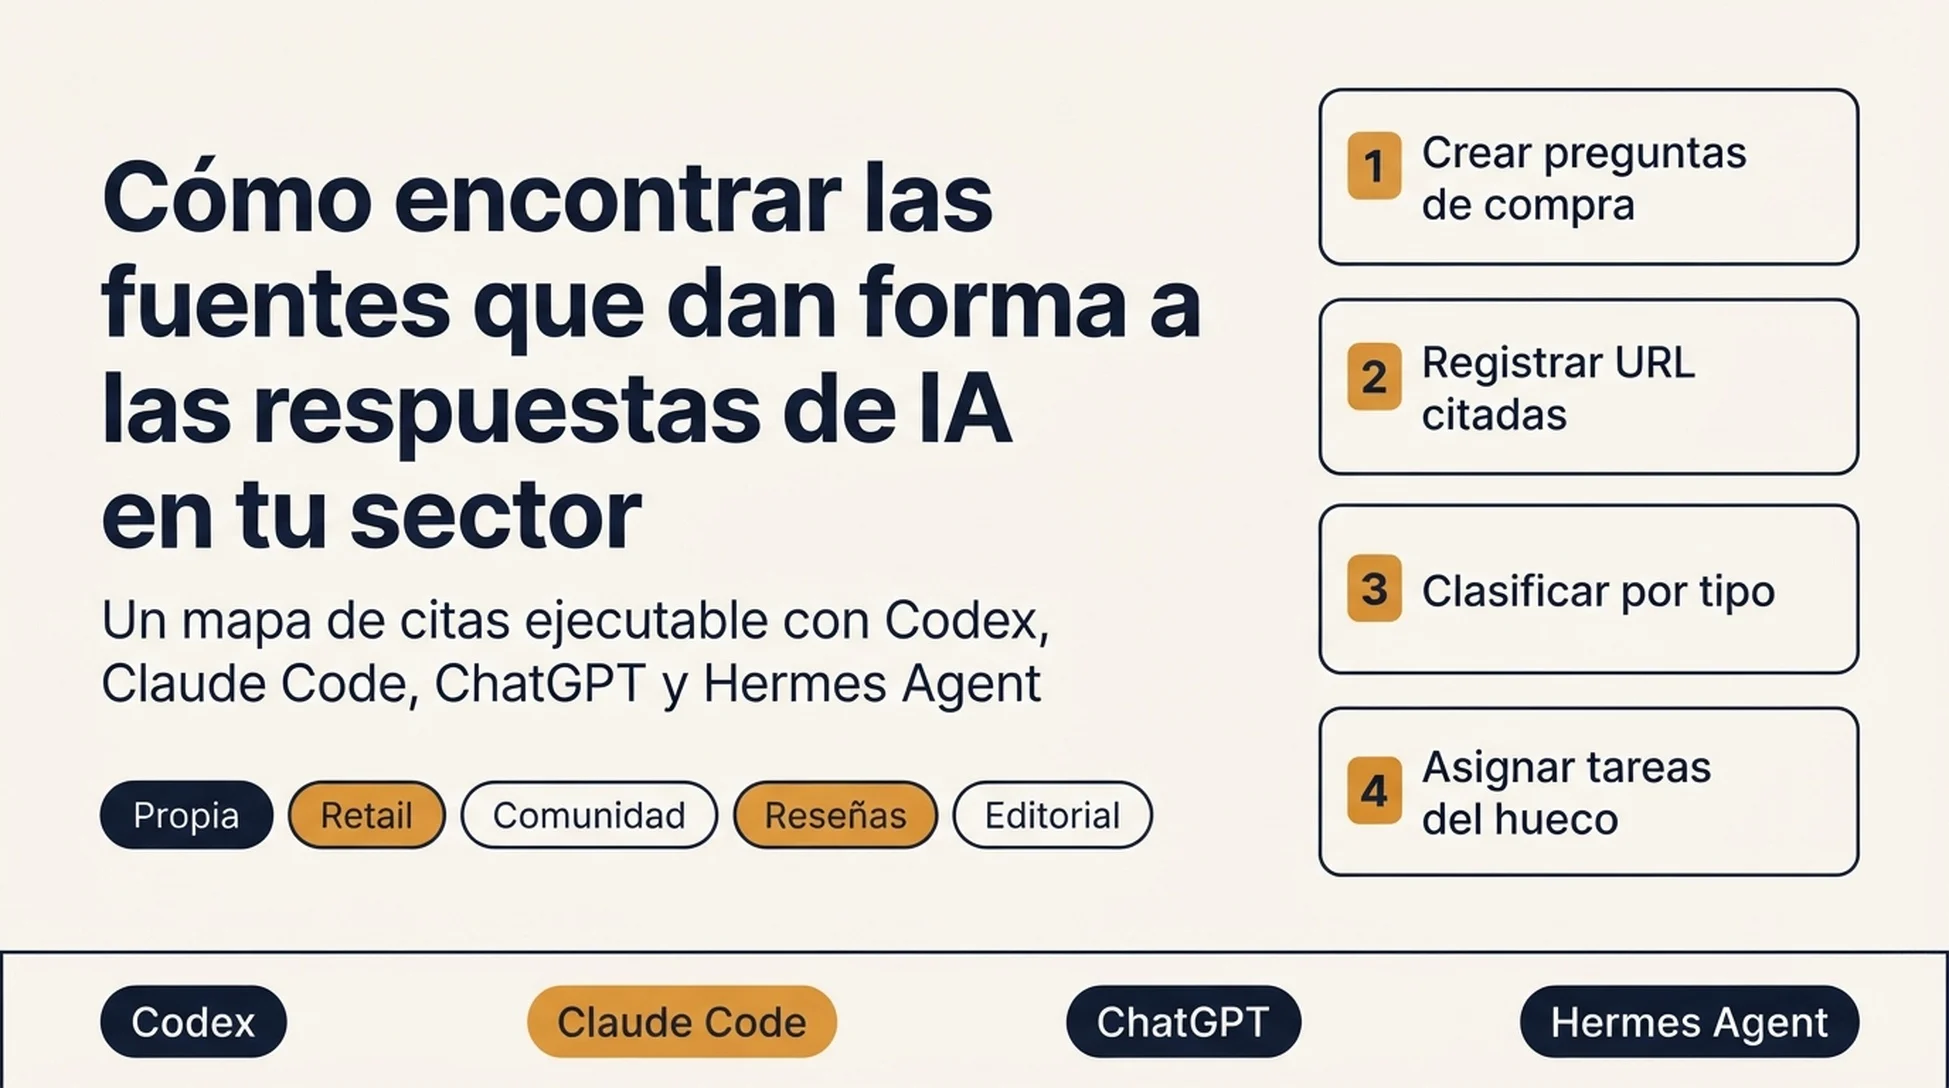
Un mapa de citas es un registro de las páginas que un motor de IA realmente tomó cuando respondió a las preguntas de tus compradores. No es si tu marca apareció en la respuesta. Es de qué fuentes se armó esa respuesta.
He corrido esto en suficientes categorías como para saber que el primer resultado suele ser incómodo. Los equipos asumen que su propio sitio sostiene esas respuestas. Con frecuencia no es así. En una categoría B2B, las páginas del propio proveedor representaban una parte mínima mientras un sitio de reseñas que nadie había reclamado hacía la mayor parte del trabajo.
Ese es el punto de hacer esto. Dejas de adivinar y empiezas a mirar las páginas reales.
Al terminar este recorrido tendrás:
- De 10 a 20 preguntas de compra reales para una categoría de producto o servicio, escritas como las formularía un cliente
- Cada pregunta ejecutada en los motores de IA que tus compradores realmente usan, con las fuentes citadas registradas y fechadas
- Esas fuentes ordenadas por tipo, para que veas de dónde vienen las respuestas de tu categoría
- Una lista corta de páginas donde cita un competidor y tú no apareces, cada una con un siguiente paso legítimo
- Responsables y una fecha de revisión, para que el mapa no se pudra en una carpeta compartida
Para quién es: un responsable interno de SEO, GEO o contenido, o un estratega de agencia que puede recomendar trabajo aunque lo ejecute otra persona. No hace falta ninguna herramienta de pago, aunque ayuda a escala.
Requisitos previos: un navegador, una hoja de cálculo y permiso de lectura sobre tu propio sitio. Para las versiones con agente, una instalación funcionando del agente que elijas y una carpeta a la que puedas apuntarlo.
Tiempo: unas dos horas para la primera pasada en una categoría. Unos 45 minutos de eso son ejecutar prompts y copiar fuentes. Esos 45 minutos son justo la parte que vale la pena entregar a un agente, y el resto es la parte que necesita tu criterio.
Qué significa estar terminado: puedes nombrar los tres o cuatro tipos de fuente que sostienen las respuestas en tu categoría, señalar páginas concretas donde tú no estás y un competidor sí, y entregarle a alguien una tarea con una URL adjunta. Si solo tienes una lista de dominios y la vaga sensación de que Reddit importa, no has terminado.
La visión de Auspia: la mayoría de los equipos va directo a "necesitamos más menciones de marca" porque nunca miró de qué se armó realmente la respuesta. El mapa es lo que convierte ese instinto vago en una página sobre la que se puede actuar.
Antes de empezar: las dos decisiones que lo determinan todo
Dos elecciones determinan lo que produce el resto. Las dos son fáciles de equivocar y las dos son molestas de deshacer después.
Elige una categoría, no todo tu negocio. Una empresa que vende software y además tiene un brazo de servicios tiene dos ecosistemas de fuentes distintos. Mapear ambos a la vez produce un promedio que no describe a ninguno. Elige la categoría con más ingresos en juego y deja el resto para el próximo trimestre.
Elige los motores con criterio. Google AI Overview, ChatGPT, Perplexity y Gemini no beben del mismo pozo. Una fuente que perdió peso en un motor puede seguir contando en otro. Ejecuta al menos dos. Si no sabes cuáles dos, pregunta al equipo de ventas qué superficie mencionan los clientes, o revisa tu tráfico de referencia desde dominios de IA.
Traza una frontera ahora mismo. Esto es un ejercicio de observación, no de prueba. Estás registrando lo que un motor devolvió un día concreto. Las respuestas cambian entre ejecuciones, así que una sola observación es un dato, no una tendencia. Pon fecha a todo, o el archivo entero deja de servir en un mes.
Paso 1: construir el conjunto de preguntas
Escribe de 10 a 20 preguntas que un cliente haría al elegir. No palabras clave. Preguntas, en las palabras del propio cliente.
Este es el paso que la gente apura, y es el paso que decide si el resto vale la pena. Un conjunto de preguntas hecho a partir de exportaciones de palabras clave produce un mapa de cómo busca la gente. Un conjunto hecho a partir de notas de llamadas de ventas produce un mapa de cómo compra la gente. No son la misma lista.
Materiales que puedes usar:
- Las preguntas previas a la compra que más recibe tu equipo de ventas
- Tickets de soporte de los primeros 30 días tras la compra
- El bloque de "otras preguntas" de tus consultas comerciales principales
- Tu propia investigación de palabras clave, reescrita en forma de pregunta
- Búsquedas comparativas de competidores que hacen tus compradores
Mezcla formas de pregunta, porque cada una arrastra fuentes distintas.
Forma de la pregunta | Ejemplo | Fuentes que suele sacar |
|---|---|---|
Encaje de categoría | "¿Qué debería mirar una empresa logística mediana al elegir una herramienta de rutas?" | Listas editoriales, sitios de reseñas |
Comparación directa | "¿Herramienta A o herramienta B para un equipo de 20 personas?" | Páginas comparativas, hilos de comunidad |
Riesgo y objeción | "¿Es la herramienta A lo bastante segura para datos médicos?" | Foros, análisis de cumplimiento, documentación del proveedor |
Precio y valor | "¿Cuánto cuesta realmente la herramienta A por asiento?" | Páginas de precios, hilos de comunidad, sitios de reseñas |
Implementación | "¿Cuánto se tarda en migrar desde la herramienta B?" | Documentación, tutoriales de YouTube, foros |
Resultado esperado: una hoja de cálculo con una fila por pregunta, una columna para la forma de la pregunta y otra para el motor en el que la vas a ejecutar.
Control de calidad: relee la lista y pregúntate si un comprador real escribiría cada una. Si una pregunta solo tiene sentido para alguien que ya conoce la taxonomía de tu producto, reescríbela. Diez preguntas que un comprador haría de verdad superan a cincuenta que suenan a exportación de palabras clave.
Ruta de recuperación: si no llegas a diez preguntas, tienes un problema de investigación, no de mapeo. Saca las últimas 20 notas de llamadas de ventas o los últimos 50 tickets de soporte y extrae preguntas de ahí antes de continuar.
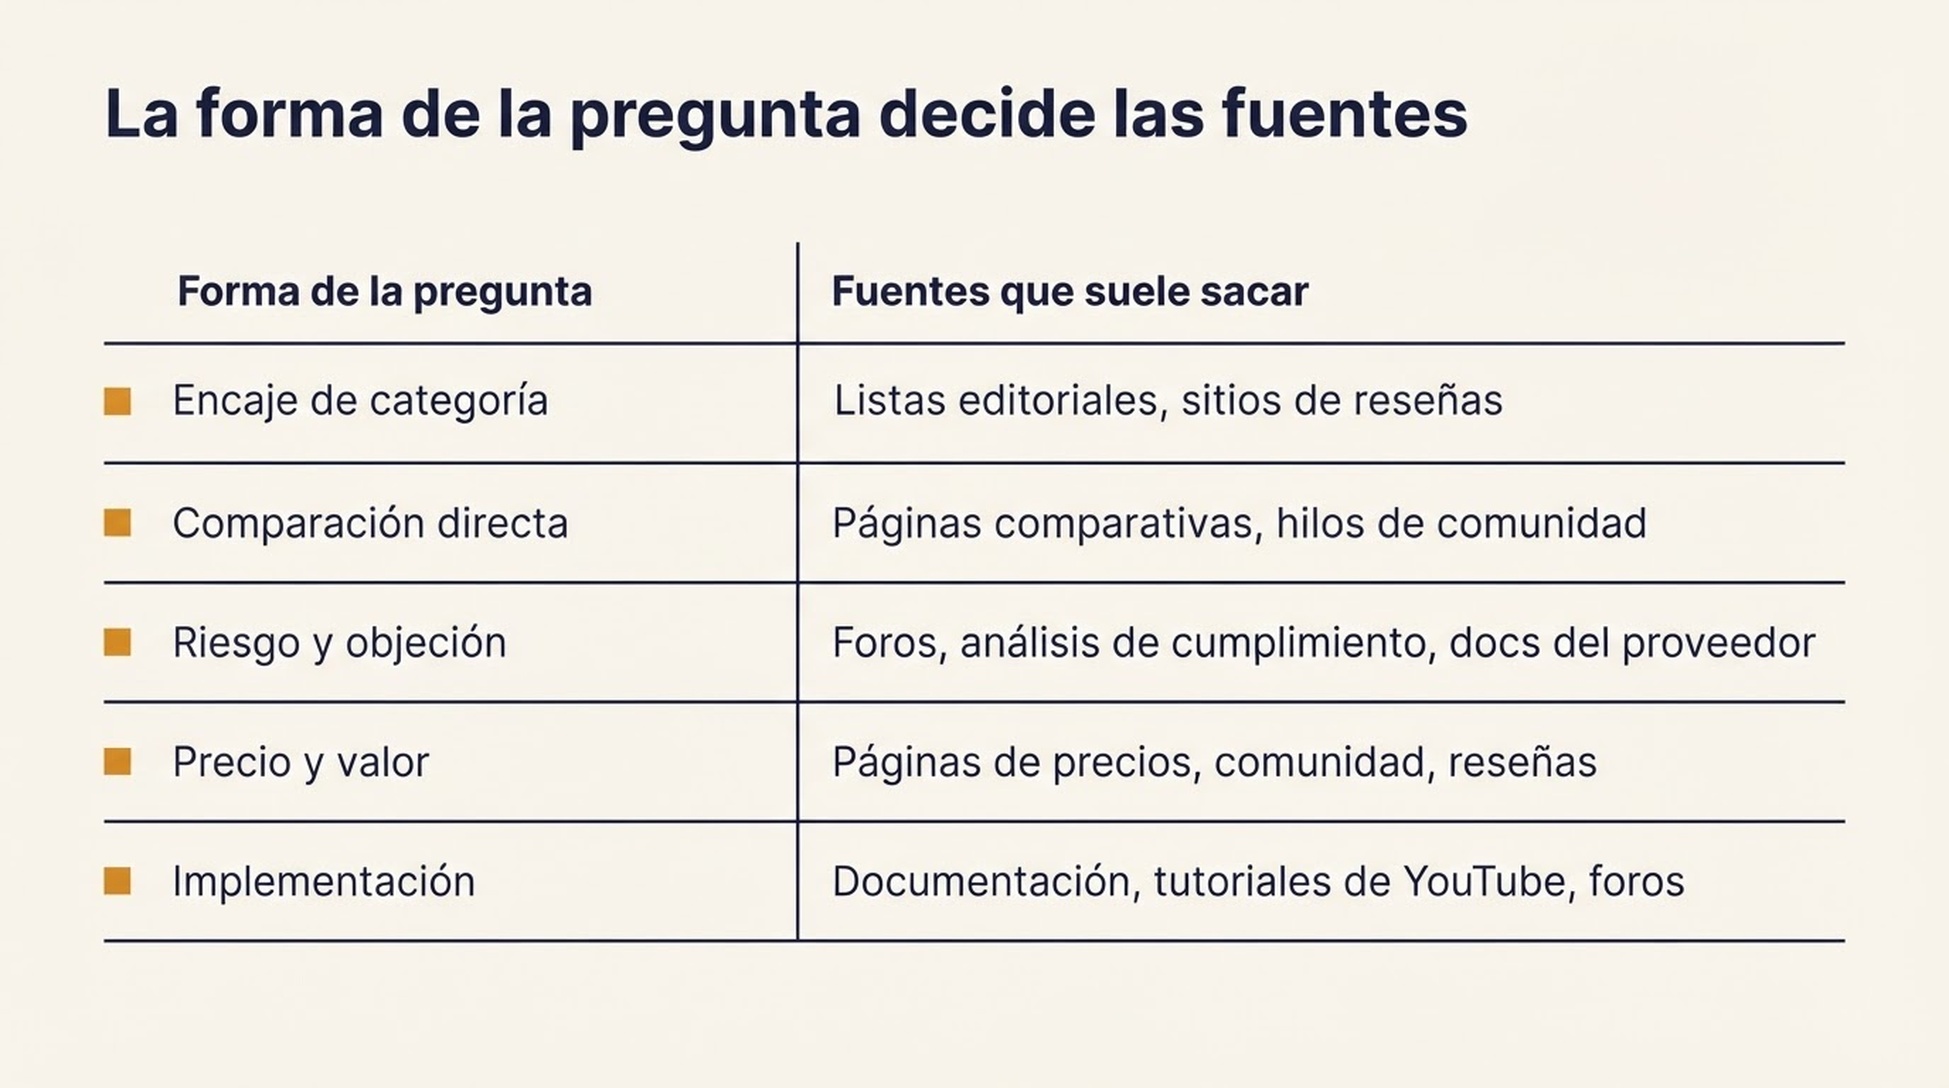
La forma de la pregunta es la variable oculta. Una pregunta de comparación directa y una de riesgo sobre el mismo producto no devuelven las mismas fuentes.
Paso 2: ejecutar las preguntas y capturar las fuentes
Aquí está el núcleo mecánico, y aquí es donde se cae el trabajo manual. Haz cinco preguntas a mano para entender cómo debe verse el resultado. Después automatiza el resto.
Para cada pregunta, en cada motor:
- Abre una conversación nueva. El contexto previo cambia lo que recupera el motor.
- Formula la pregunta exactamente como la escribiste.
- Abre el panel de citas o la lista de fuentes. En la mayoría de los motores es un icono pequeño junto a la respuesta, no una lista visible.
- Registra cada URL citada, más el dominio y el tipo de fuente.
- Anota la fecha, el motor y si la respuesta citó algo o no.
Registra con esta estructura:
Campo | Por qué importa |
|---|---|
ID de pregunta | Vincula cada observación con la pregunta de compra |
Motor | Permite separar patrones por motor más adelante |
Fecha y hora | Las respuestas derivan; una fila sin fecha no sirve en un mes |
URL citada | La página real, no solo el dominio |
Dominio | Para agrupar y contar frecuencias |
Tipo de fuente | propia, retail/marketplace, comunidad, directorio de reseñas, editorial |
Competidor presente | Sí/no, y cuál |
Nuestra marca presente | En la respuesta, en las fuentes, en ambas o en ninguna |
Vale la pena detenerse en la última fila. Una marca puede ser nombrada en la respuesta sin que se cite ninguna de sus páginas. También puede ser citada sin aparecer de forma destacada. Son dos señales distintas, y si solo sigues "¿aparecimos?", vas a leer mal las dos. He visto equipos celebrar una mención que venía de una página que argumentaba en su contra.
Resultado esperado: una tabla larga, una fila por fuente citada, por pregunta y por motor.
Control de calidad: en al menos tres filas, entra y confirma que la página citada realmente sostiene la afirmación por la que fue citada. Los motores a veces citan una página que menciona el tema sin responder a la pregunta. Esas filas son ruido y hay que marcarlas.
Ruta de recuperación: si un motor no devuelve citas para una pregunta, eso es un hallazgo, no un fallo. Regístralo como cero fuentes y sigue. Las preguntas que se responden sin recuperación son preguntas que tu propio contenido no puede influir.
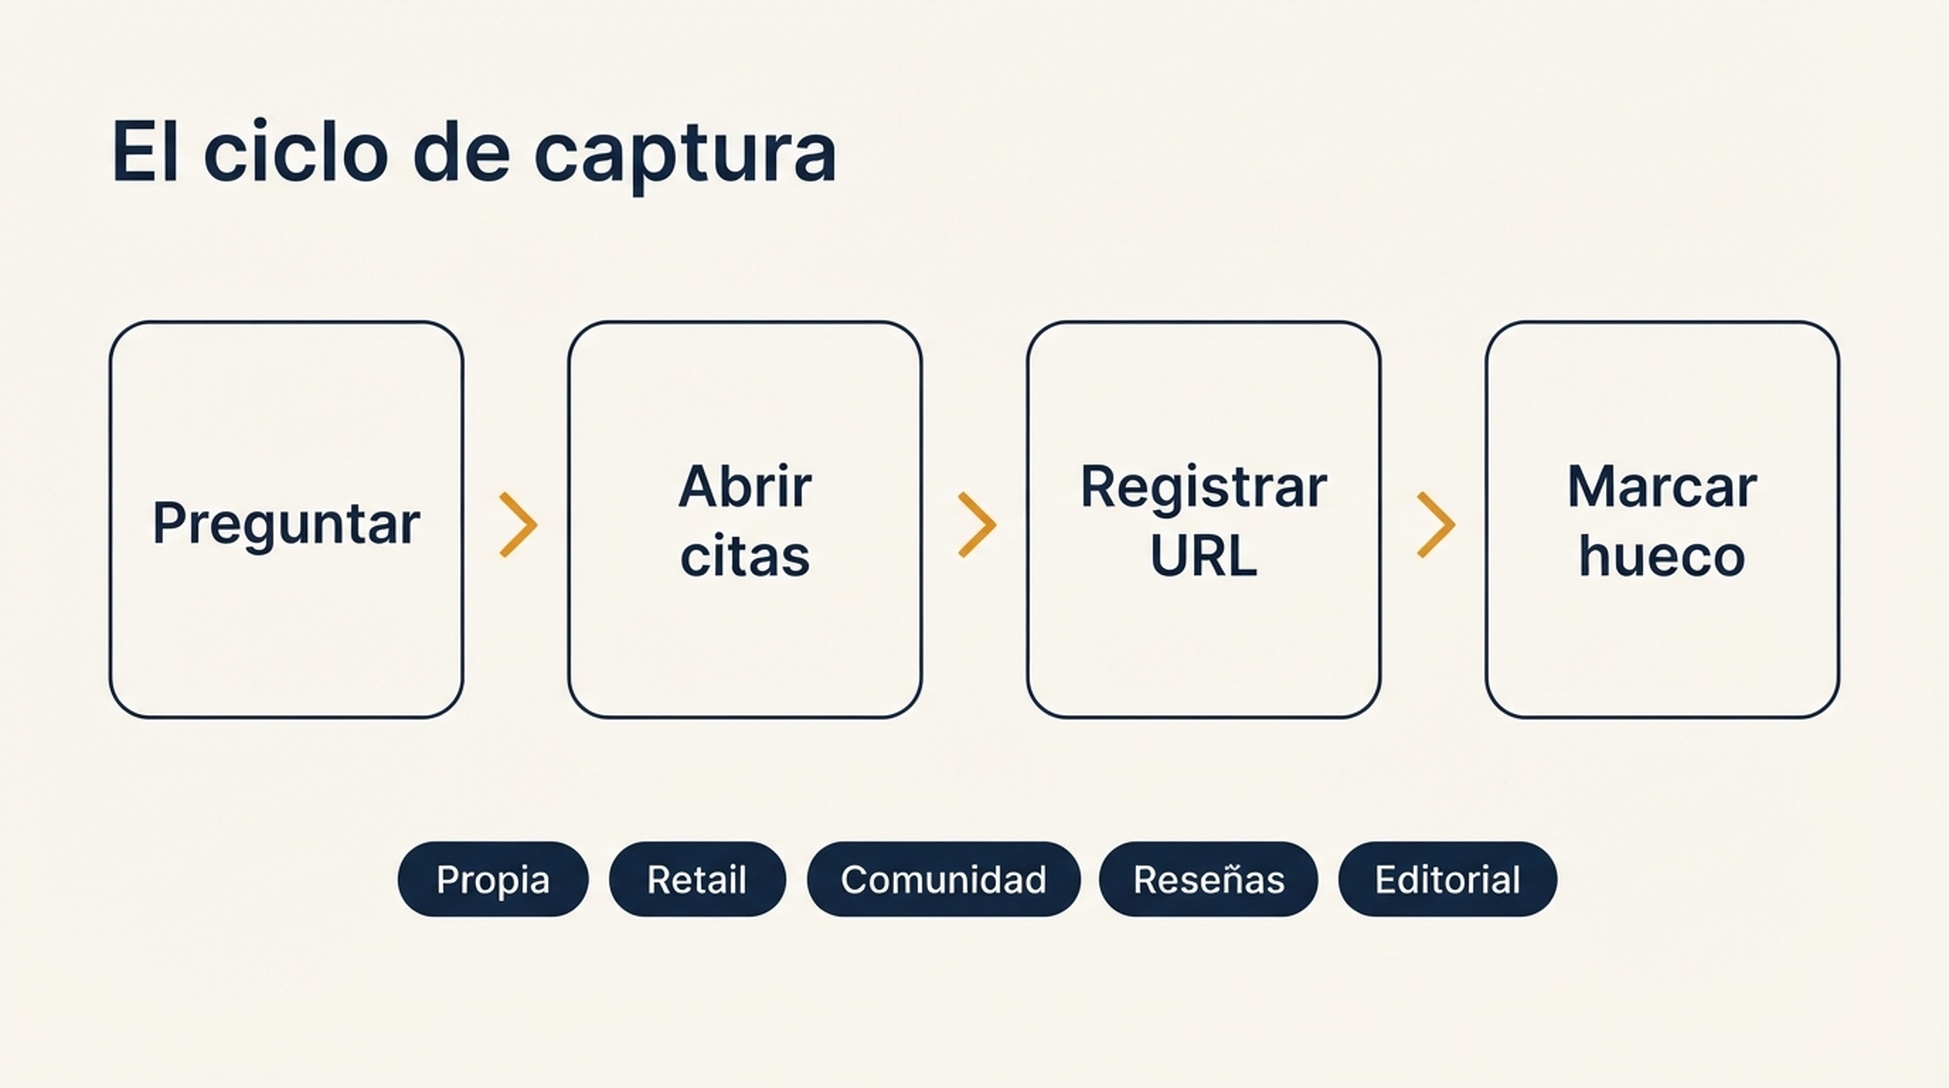
El ciclo es simple y tedioso. Esa combinación es exactamente lo que lo convierte en buen candidato para un agente.
Paso 3: ordenar las fuentes por tipo
Ahora comprime la tabla larga en una imagen de tu categoría. Clasifica cada URL citada en uno de cinco cubos:
- Propia: tu sitio, o el de un competidor
- Retail y marketplace: fichas de producto, páginas de comparación de precios, tiendas de aplicaciones
- Comunidad y UGC: Reddit, YouTube, Quora, foros, hilos de Discord indexados
- Directorios de reseñas y plataformas B2B: G2, Capterra, Clutch, Trustpilot, directorios sectoriales
- Editorial independiente y referencia: prensa sectorial, noticias, Wikipedia, análisis de analistas, blogs independientes
Cuenta por cubo y por motor, y ya tienes tu mapa de citas.
Lo que buscas no es un número único. Es la forma. Algunas categorías se sostienen casi por completo en hilos de comunidad y prensa sectorial, y el sitio propio de la marca apenas aparece. Otras están dominadas por fichas de producto, porque la ficha misma contiene la respuesta. Esa mezcla depende de lo que preguntan los compradores, no de lo bueno que sea el sitio de nadie. Es difícil de aceptar cuando llevas dos años trabajando en el sitio.
Resultado esperado: una tabla pequeña, una fila por tipo de fuente, una columna por motor, mostrando la proporción de fuentes citadas.
Control de calidad: si un cubo concentra más del 70% de tus citas, revisa cinco URL de dentro para confirmar que son de verdad de ese tipo. Un agregador de mucho tráfico puede disfrazarse de fuente editorial cuando en realidad es un directorio.
Ruta de recuperación: si los recuentos parecen aleatorios, probablemente mezclaste formas de pregunta y eso esconde el patrón. Divide la tabla por forma de pregunta y vuelve a mirar. Las preguntas de precio y las de riesgo suelen tener perfiles de fuente completamente distintos.
Paso 4: encontrar los huecos donde cita un competidor y tú no
Filtra la tabla larga a las filas donde aparece un competidor y tu marca no. Esa lista filtrada es tu lista de trabajo. Es mucho más útil que un mandato genérico de "necesitamos más menciones", porque cada fila ya tiene una URL y una pregunta de cliente asociadas. Se la pasas a alguien el lunes y puede empezar.
Para cada fila, abre la página citada y responde tres preguntas:
- ¿Nuestro producto pertenece de verdad a esta página?
- Si pertenece, ¿qué falta: una ficha que nunca reclamamos, una comparación en la que no estamos, un hilo donde nadie nos mencionó, una reseña que nunca pedimos?
- ¿Cuál es la acción legítima más pequeña que nos pondría ahí?
La tercera pregunta es donde entra la disciplina. La acción cambia según el cubo. Equivocarse aquí es como acabar con un SEO enviando correos en frío a periodistas sobre un hilo de Reddit.
Tipo de fuente | Acción legítima | Qué no hacer |
|---|---|---|
Directorio de reseñas | Reclamar y completar el perfil, pedir reseñas a clientes | Comprar reseñas o sembrar falsas |
Hilo de comunidad | Responder con honestidad como empleado identificado, declarando la afiliación | Hacer astroturfing o soltar un enlace sin aportar |
Editorial | Proponer un ángulo realmente útil que el medio no haya cubierto | Enviar el mismo comunicado a 200 dominios |
Marketplace o ficha retail | Arreglar especificaciones, imágenes y descripción para que los datos se puedan recuperar | Meter palabras clave a la fuerza |
Página propia | Reestructurar para que el dato concreto sea fácil de encontrar y citar | Añadir un bloque de FAQ que no responde nada |
Resultado esperado: una lista filtrada y priorizada. Ordena por la frecuencia con que aparece la fuente en tu conjunto de preguntas, no por lo prestigioso que suene el dominio. Un hilo de foro citado en seis de tus veinte preguntas va por delante de una publicación sectorial citada una vez, y además es mucho más fácil de abordar.
Control de calidad: para cada fila que conserves, confirma que puedes enunciar la pregunta de cliente a la que corresponde. Si no puedes, descarta la fila. Las páginas citadas para preguntas que nadie en tu pipeline hace solo distraen.
Ruta de recuperación: si la lista filtrada sigue siendo enorme, no has filtrado lo suficiente. Limita la primera pasada a diez filas, ordenadas por frecuencia de cita, y trabájalas antes de reabrir la lista completa.
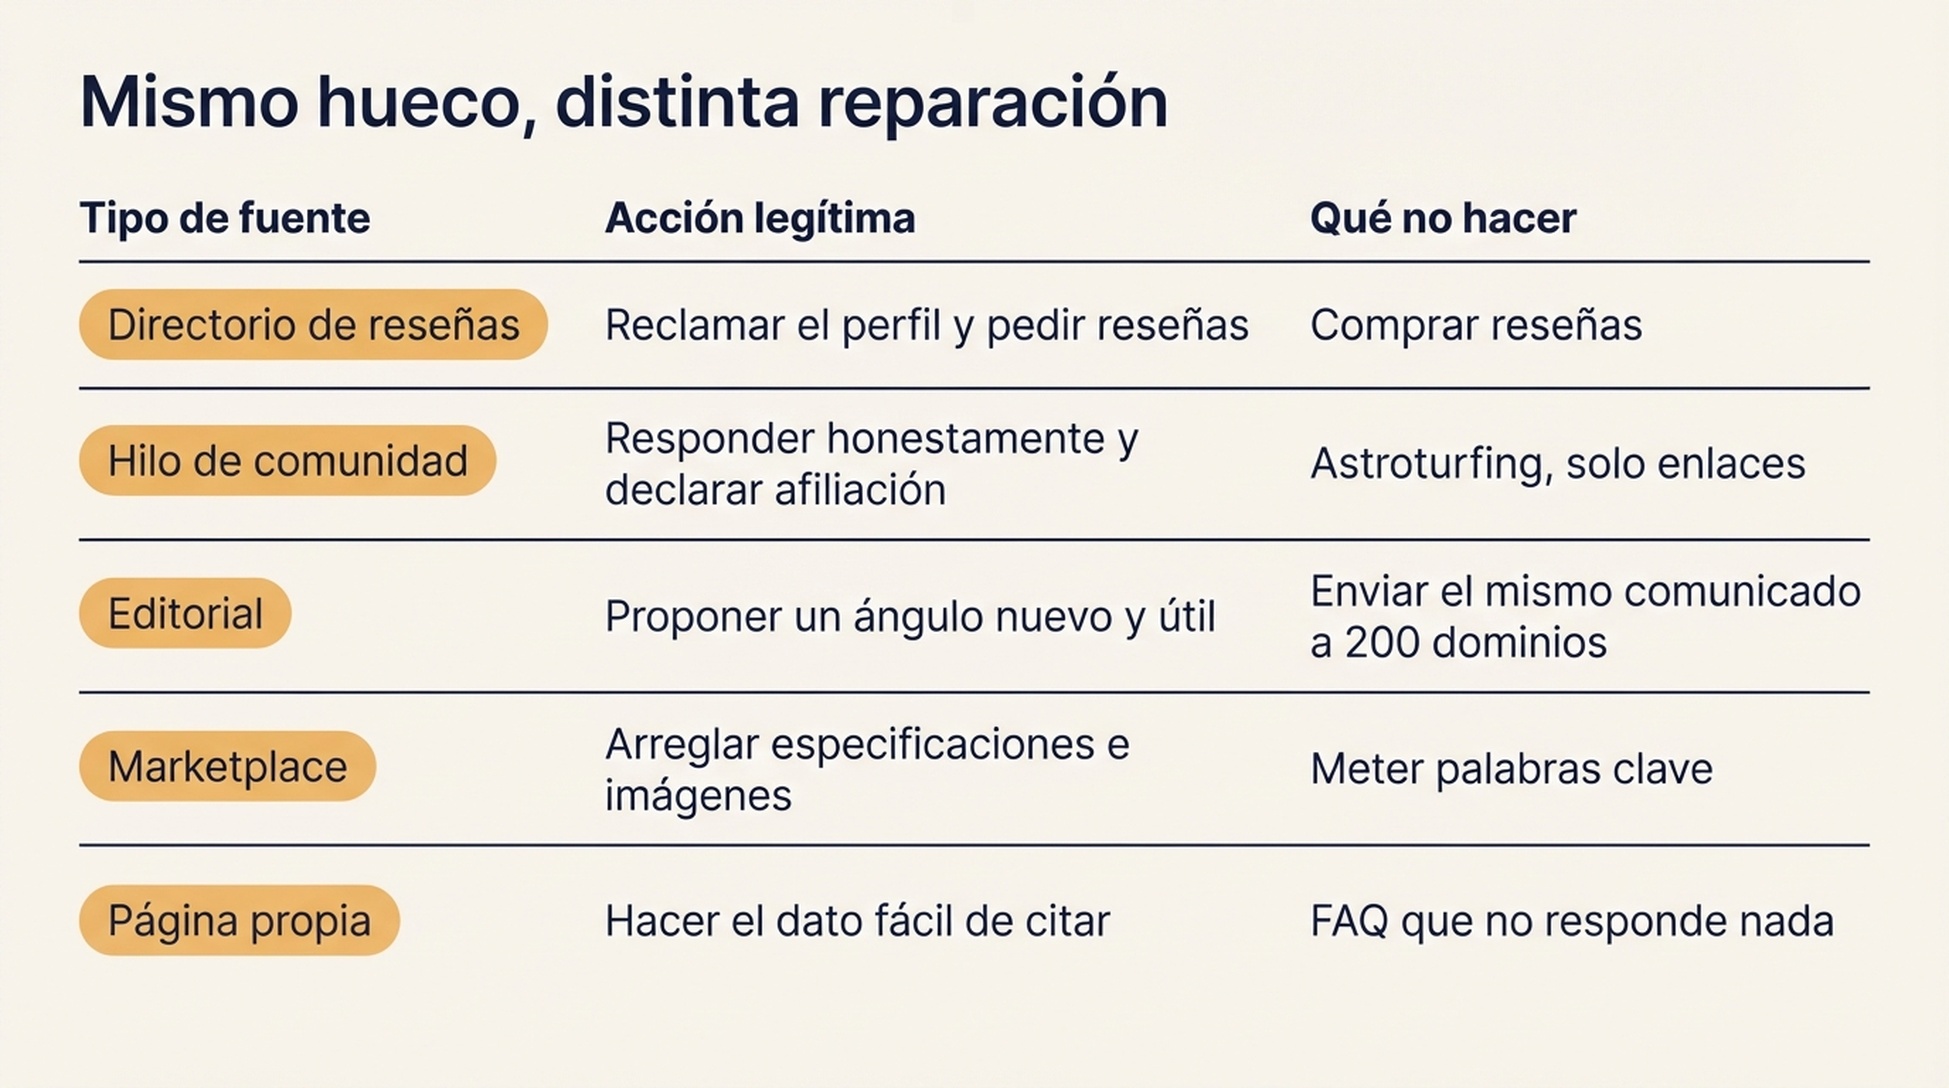
El mismo hueco, distinta reparación. Tratar cada cita ausente como un problema de outreach es como los equipos acaban vendiéndole a un editor un hilo de Reddit.
Paso 5: entregarle la mitad mecánica a un agente
Los pasos 2 y 3 son los que más tiempo consumen y menos criterio exigen. Esa es la definición de trabajo que vale la pena delegar. El conjunto de preguntas y la priorización se quedan con una persona, porque son los dos puntos donde un error de criterio tira todo el ejercicio.
Los cuatro agentes de abajo pueden ejecutar el mismo método. Lo que cambia es dónde vive el método y cómo vuelve el resultado. Elige por eso, no por qué modelo ganó un benchmark este mes.
Codex
Ideal cuando quieres que el mapa viva en un repositorio y produzca un artefacto revisado en cada ejecución. Si tu sitio ya está en git, esta es la vía con menos fricción.
Monta una carpeta de proyecto con un directorio citation-map/, un questions.csv con tu conjunto de preguntas y un SKILL.md que declare el método: qué motores revisar, qué campos registrar, cómo clasificar una fuente y cómo debe verse el archivo de salida. Guarda un archivo por ejecución, nombrado por fecha, para acumular historial en lugar de sobrescribir.
Pídele a Codex que ejecute las preguntas, añada filas al archivo de la ejecución actual y produzca una tabla resumen de la proporción de fuentes por motor. Como la salida es un archivo dentro de un repositorio, obtienes un diff que puedes revisar antes de dar nada por definitivo. Ese paso de revisión es el punto: estás comprobando las clasificaciones, no rehaciendo la captura.
Hay una regla que debe ir en el SKILL.md pase lo que pase: el agente registra lo que observó y no infiere una cita que no vio. Inventar fuentes es el modo de fallo más dañino de este flujo. Una regla escrita más una comprobación por muestreo de tres filas detiene la mayor parte, y las tres filas que revisas deben cambiar en cada ejecución.
Claude Code
Ideal cuando el método necesita leerse contra una política escrita explícita, y cuando quieres revisar con contexto largo las páginas capturadas.
Pon el método en un CLAUDE.md o en un skill de proyecto, incluyendo tus definiciones de tipo de fuente y el esquema de salida exacto. Apunta Claude Code a la carpeta de ejecución y pídele que clasifique cada URL citada y que marque cualquier fila donde el contenido de la página no sostenga realmente la cita.
El segundo trabajo es el que vale la pena pagar. Leer 200 páginas citadas y juzgar si cada una responde de verdad a la pregunta es penoso para una persona y razonable para un agente con un estándar escrito. Pídele un indicador de confianza por fila y revisa tú solo las de baja confianza.
ChatGPT
Ideal cuando quieres el coste de montaje más bajo y el trabajo es una sesión única en lugar de una ejecución recurrente.
Pega el método como instrucción personalizada o como prompt de proyecto guardado, adjunta tu lista de preguntas y trabaja por lotes de motores. Pide la salida como tabla con las mismas columnas del paso 2, para que se pegue directo en tu hoja de cálculo.
El problema es que ChatGPT también es una de las superficies que estás midiendo. Si estás mapeando las citas del propio ChatGPT, hazlo en una sesión limpia sin tu método cargado, o contaminas la observación. Usa una sesión para capturar y otra distinta para organizar.
Hermes Agent
Ideal cuando quieres que el método persista como skill y mejore entre ejecuciones sin que tengas que volver a explicarlo.
Instala el método del mapa de citas como skill de Hermes con el conjunto de preguntas y el esquema de salida, y ejecútalo con una cadencia; mensual suele ser lo correcto. Como el skill y su memoria persisten, las correcciones que hagas el primer mes pasan al segundo. Si el agente clasificó mal un directorio como fuente editorial, arreglas la regla una vez.
El coste es que la memoria persistente necesita revisión periódica. Cada pocas ejecuciones, lee el archivo del skill y comprueba que las correcciones acumuladas siguen describiendo el método que quieres, y no un montón de excepciones puntuales que nadie sabe explicar.
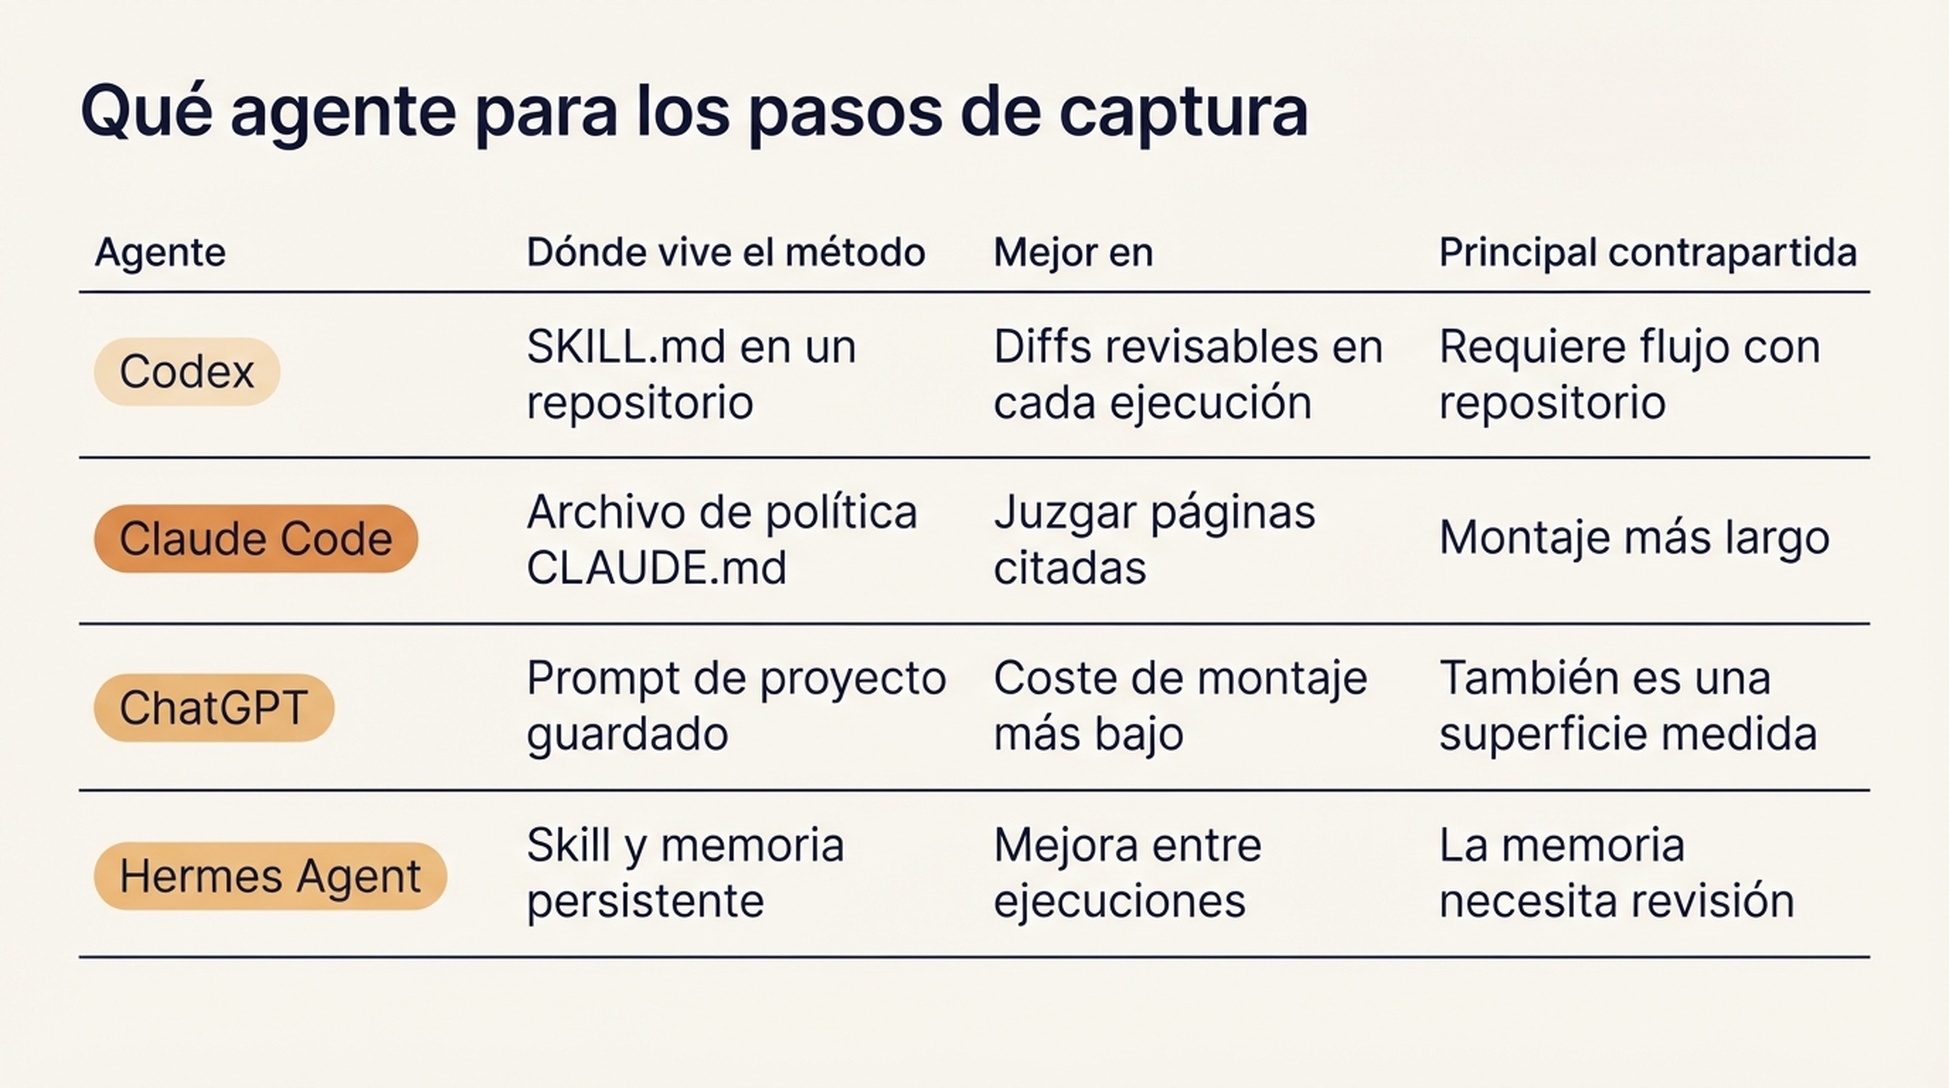
Los cuatro ejecutan los mismos cinco pasos. Elige por dónde debe vivir el método, no por qué modelo puntúa más alto en un benchmark.
Paso 6: verificar el mapa antes de actuar sobre él
No asignes trabajo a partir de un mapa sin verificar. Ejecuta esta comprobación primero. Cinco minutos aquí ahorran un trimestre de esfuerzo mal dirigido.
- Vuelve a ejecutar tres preguntas una semana después. Si la mezcla de fuentes cambia por completo, tu conjunto de preguntas es demasiado volátil o tu muestra es demasiado pequeña. Registra la variación en lugar de tratar la primera pasada como verdad absoluta. Cierta variación es normal; una rotación total es una advertencia.
- Confirma el motor, no solo la respuesta. Una fuente que aparece en Perplexity puede faltar en ChatGPT para la misma pregunta. Mantén las columnas de motor separadas en el resumen; un total combinado esconde justo la señal que necesitas.
- Revisa también tus propias citas. Si tu marca está citada, abre la página. A veces el motor cita una página donde se habla de ti de forma crítica, o una que no controlas. Es información útil, no una victoria.
- Confirma la fecha en cada fila. Un mapa de citas sin fechas no se puede comparar con nada después.
- Comprueba el recuento de fuentes. Si una pregunta devolvió 40 fuentes y el resto tres, revisa si capturaste un panel de "relacionados" en lugar de las citas reales.
Qué significa estar terminado: puedes entregarle a un colega la tabla resumen y una lista de trabajo filtrada, y puede actuar sin preguntarte qué significa ninguna fila.
Mantener el mapa
Ejecuta la pasada completa cada trimestre con el mismo conjunto de preguntas, y una pasada ligera mensual sobre las cinco preguntas con más valor comercial. Conserva las ejecuciones antiguas. La señal interesante rara vez es la foto fija. Es la deriva: un tipo de fuente que crece en silencio, o un competidor que empieza a aparecer en un cubo donde antes no estaba.
Revisa el conjunto de preguntas dos veces al año. Las preguntas de compra cambian con tu producto y tu mercado, y un conjunto obsoleto produce el mapa de una categoría que ya no vendes.
Una cosa que hay que resistir: convertir esto en un panel. El resultado es una lista de trabajo con responsables y URL. Si al final nadie tiene una tarea, el mapa no ha hecho su trabajo.
Preguntas frecuentes
¿Necesito una herramienta de pago de visibilidad en IA para hacer esto? No. La versión manual funciona para una categoría y lleva media tarde. Las herramientas se ganan su coste cuando sigues muchas categorías o mercados, o cuando quieres líneas de tendencia históricas sin mantener tú mismo la hoja de cálculo.
¿Cuántas preguntas son suficientes? De 10 a 20 por categoría. Con menos de diez no distingues un patrón de una casualidad. Con más de veinte en una primera pasada no terminarás el análisis, que es la parte que produce la lista de trabajo.
¿Debería incluir preguntas donde ya aparecemos? Sí. Saber qué fuentes te sostienen es tan útil como saber cuáles te ignoran, y te dice qué proteger cuando cambies tu contenido.
¿Y si el motor da una respuesta distinta cada vez que pregunto? Es normal y merece registrarse. Ejecuta la misma pregunta tres veces y anota la variación. Si el conjunto de fuentes es completamente distinto cada vez, trata esa pregunta como de baja confianza y dale menos peso al priorizar.
¿Puedo usar la lista de fuentes del propio motor sin abrir las páginas? Para la captura inicial, sí. Para las filas sobre las que vas a actuar, no. Necesitas leer la página para juzgar si tu marca pertenece de verdad ahí y qué sería una contribución útil.
¿En qué se diferencia esto del seguimiento de posiciones? El seguimiento de posiciones te dice dónde aparecen tus páginas en una lista de resultados. Un mapa de citas te dice de qué páginas se armó una respuesta. Una página puede ser la número uno y no ser citada nunca, y una que no posiciona en ningún lado puede ser la columna vertebral de una respuesta. Esa diferencia es lo que hace que valga la pena dedicarle media tarde.
Autor: Ethan Marlowe, responsable de medición GEO en Auspia con más de 500 prompts analizados. Escribe sobre seguimiento de prompts, informes de citas, paneles de visibilidad y cómo distinguir un cambio real de visibilidad en IA del ruido entre ejecuciones.