La mayoría de los equipos que dicen "hacer SEO agéntico" en realidad pegan un prompt largo en una ventana de chat. La primera vez funciona. El problema empieza en la segunda: la estructura de la respuesta cambia, los datos tienen una semana de antigüedad y nadie distingue si se movieron los números o se desvió el prompt.
La versión que aguanta se diferencia en una sola cosa: el método vive en un archivo, no en tu mensaje. Escribes el procedimiento una vez, se lo entregas a un agente y, a partir de ahí, las mismas comprobaciones se ejecutan siempre, te hayas acordado de pedirlas o no.
Esa es toda la idea. Lo que sigue es cómo montarlo, qué agente encaja con cada tarea y dónde se rompe en silencio.
Qué cambia realmente lo "agéntico"
Hay tres cosas que se pueden automatizar y no son lo mismo.
Automatización de flujos | SEO asistido por IA | SEO agéntico | |
|---|---|---|---|
Quién elige los pasos | Tú, de antemano | Tú, en cada conversación | Tú, una vez, en un método escrito |
De dónde vienen los datos | Integraciones ya conectadas | Lo que tú pegas | El agente los obtiene |
Ante una entrada inesperada | Se rompe | Depende de cómo lo formules | Sigue una regla o escala el caso |
Consistencia entre ejecuciones | Perfecta y rígida | Baja | Alta y, aun así, adaptable |
Para qué sirve mejor | Tareas masivas y sin cambios | Exploración y preguntas puntuales | Análisis recurrente que exige criterio |
La diferencia práctica se ve en lo que dejas de hacer. En un flujo de chat vuelves a explicar el sitio, la audiencia, las reglas de prioridad y el formato de salida cada vez. Cada explicación es una oportunidad de olvidar algo. En un flujo agéntico todo eso vive en archivos que el agente lee en cada ejecución, y tu prompt se reduce a una línea: ejecuta la comprobación de deterioro de contenido de septiembre.
Esto también tiene un costo. Si la tarea es de verdad distinta cada vez, no hay método que escribir y montarlo es una carga sin retorno. Comprobar el código de estado de 50.000 URL es trabajo de un script, no de un agente. La línea divisoria son dos preguntas: ¿la tarea se repite? ¿necesita criterio? Si la respuesta es sí a ambas, gana lo agéntico. Si falla una, no vale la pena.
Las cuatro capas y para qué sirve cada una
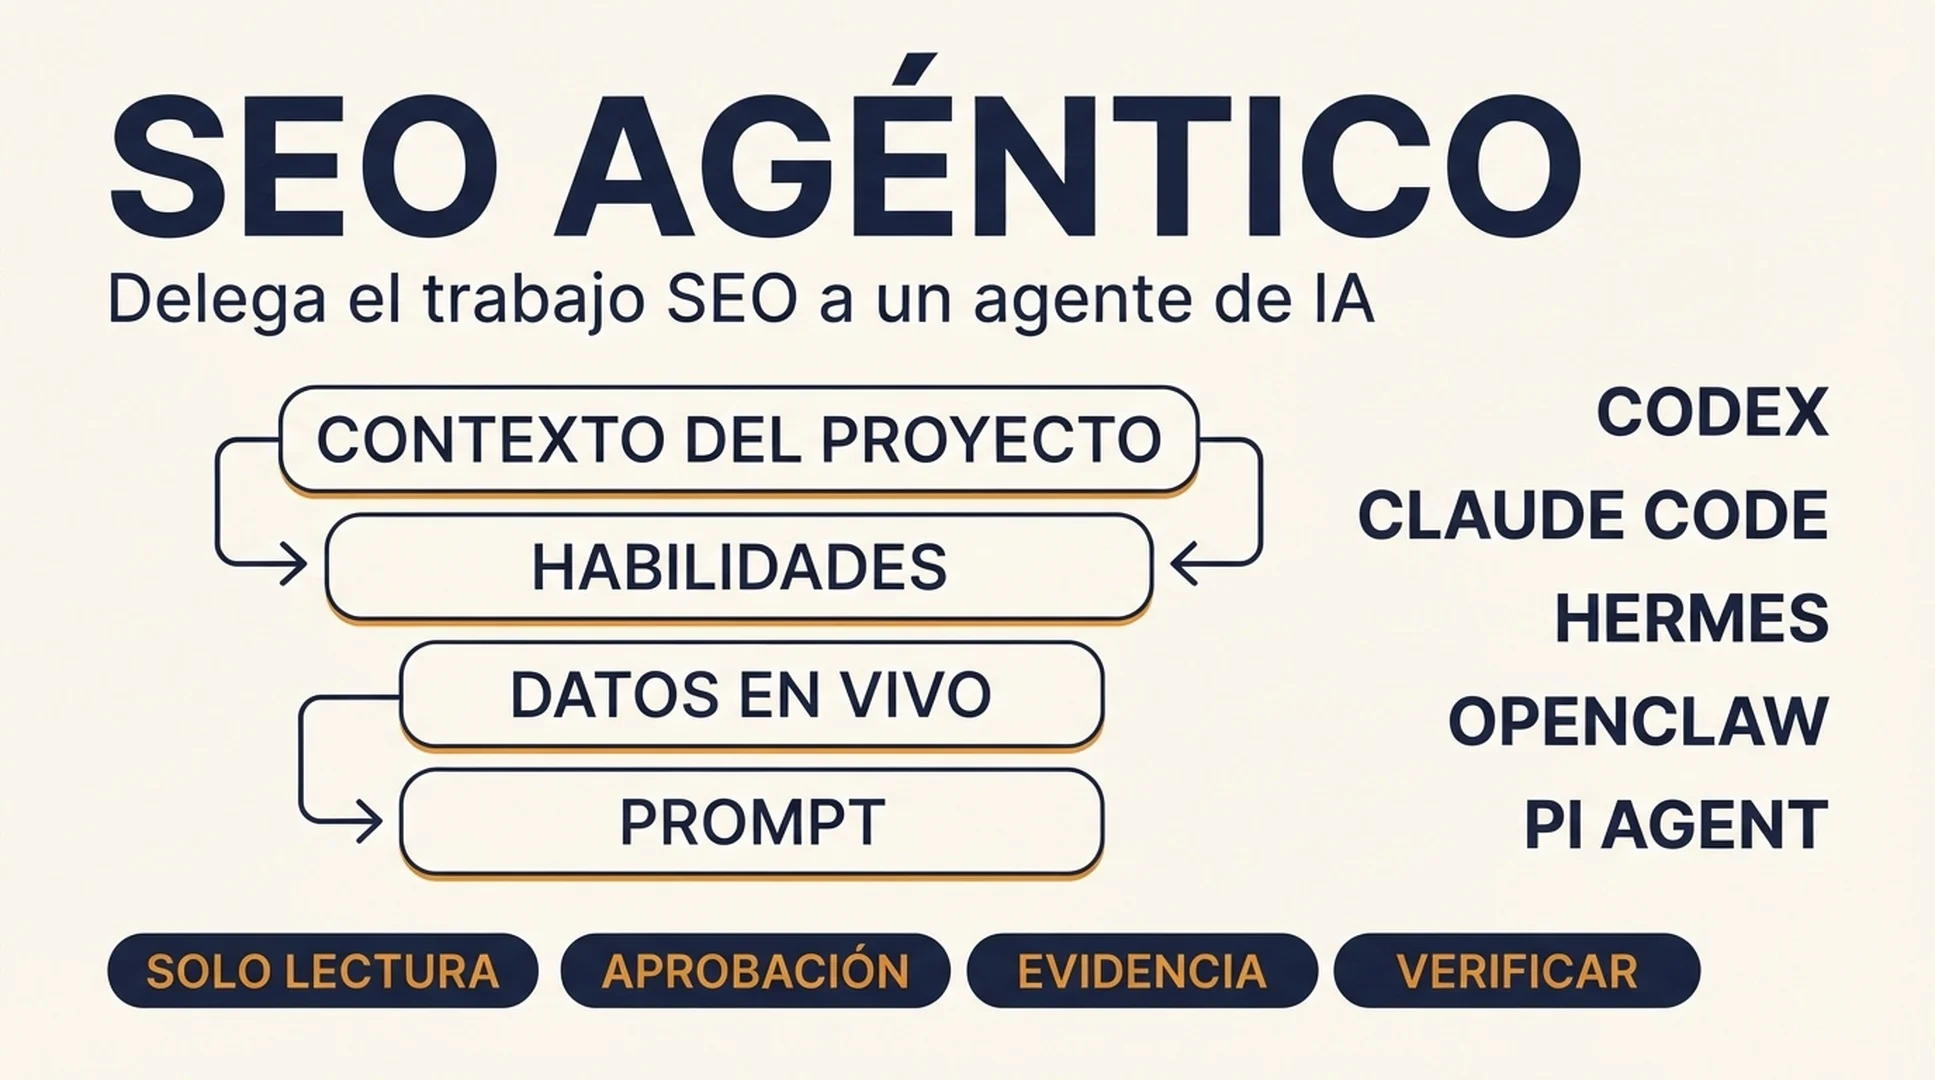
Toda configuración de SEO agéntico que sobrevive tiene las mismas cuatro piezas. Quita una y obtienes un tipo de fallo predecible.
Contexto del proyecto. Una carpeta con lo que no cambia: el sitio, los mercados que atiende, quién compra y por qué, qué cuenta como conversión, quiénes son los competidores reales, las reglas editoriales. Esto es lo que impide que el agente escriba consejos genéricos para un negocio que no entiende. Si te saltas esta capa, obtienes una salida segura, plausible e inútil.
Habilidades. Procedimientos escritos. Cada una indica cuándo usarla, qué datos necesita, el orden de los<|placeholdermmspan0442|> pasos, las reglas de puntuación, el formato de salida y qué acciones requieren tu aprobación. Esta es la capa que hace repetible el flujo, y es la que casi todos los equipos se saltan.
Acceso a datos en vivo. Conexiones que permiten al agente obtener cifras actuales en lugar de esperar a que exportes y pegues. Search Console para tu propio rendimiento. Analítica para el comportamiento. Una fuente de posiciones o de SERP para lo que no ves en tu propio dominio. Un rastreador o una conexión al CMS para hechos a nivel de página. Sin esta capa tienes un analista excelente trabajando con la hoja de cálculo del mes pasado.
El prompt. La tarea actual, nada más. Si tu prompt carga contexto o método, eso pertenece a la primera y la segunda capa.
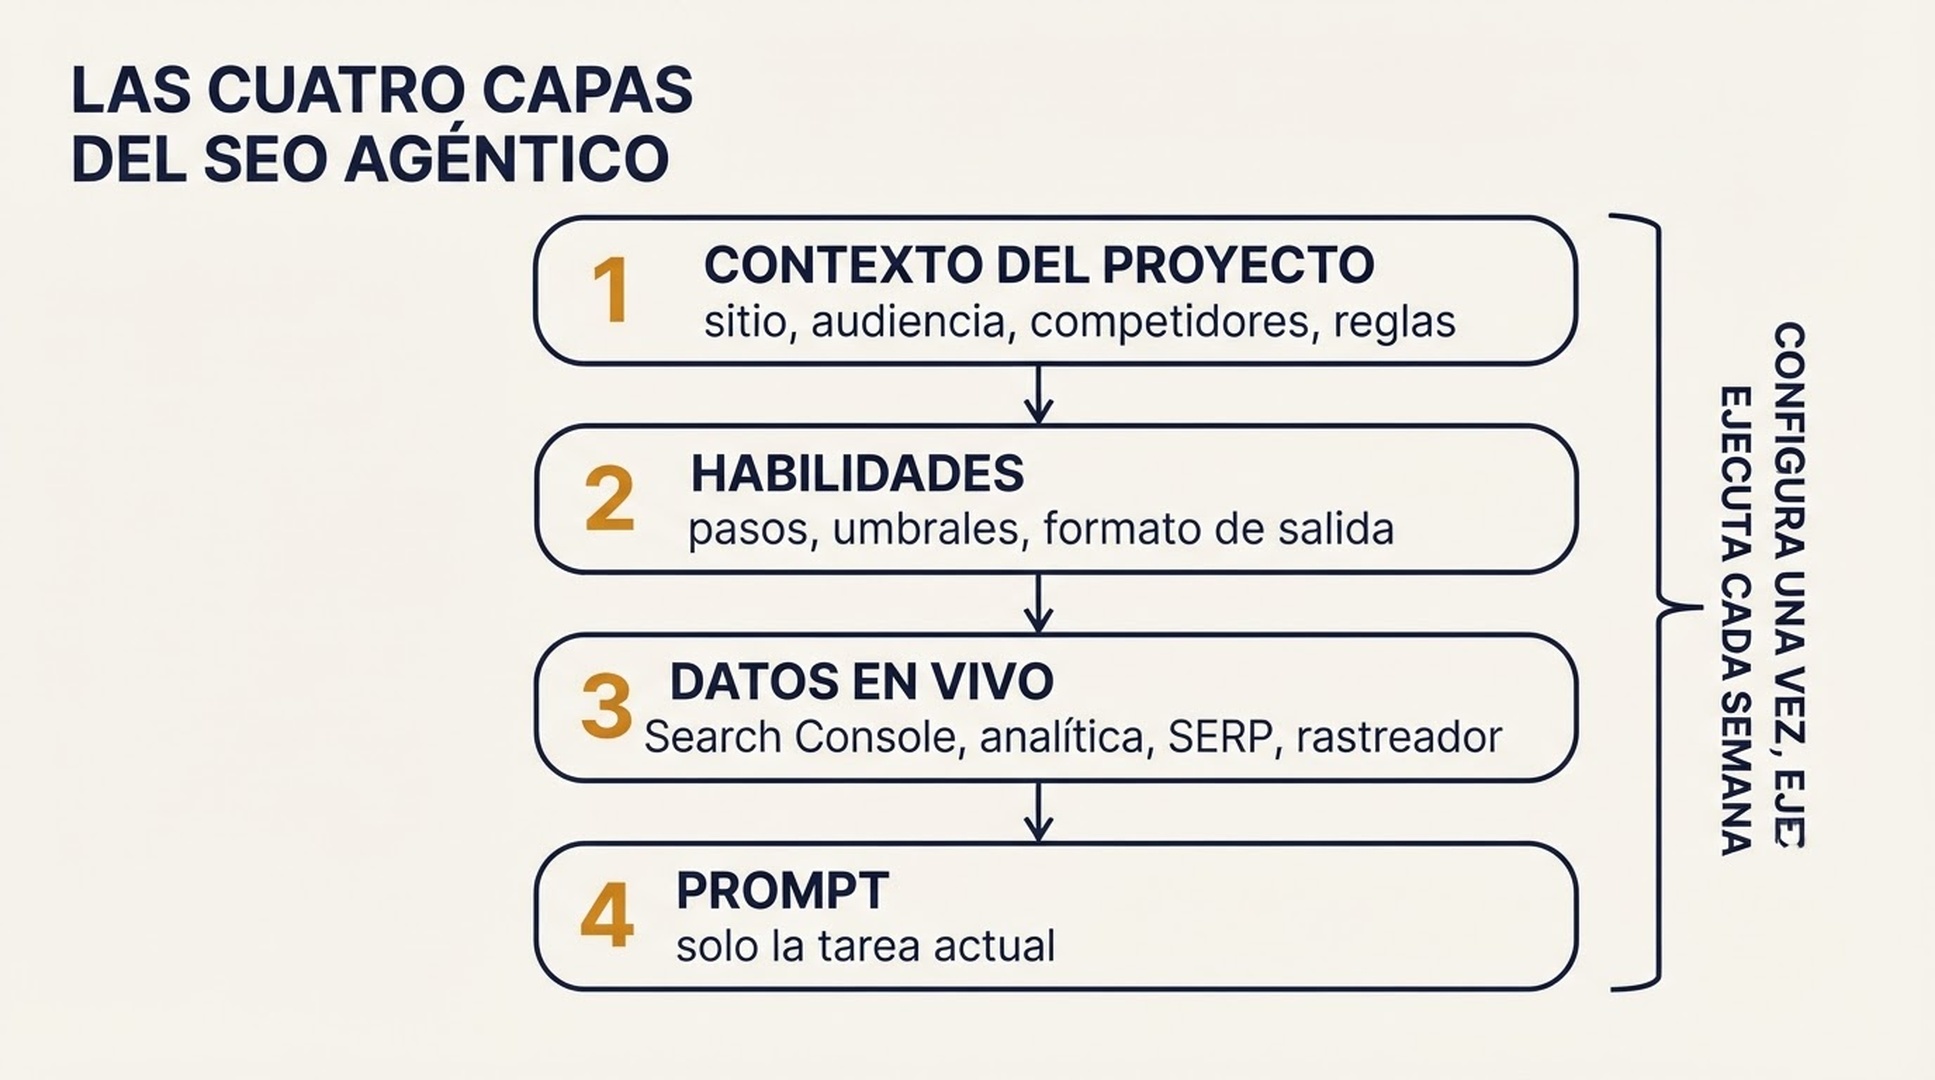
Configura las cuatro capas una vez y la ejecución semanal se reduce a una línea. Cuando el resultado sale mal, revisa qué capa falló antes de reescribir el prompt.
La postura de Auspia: el modelo de cuatro capas es la idea más útil de esta categoría y, a la vez, el punto donde la mayoría de los equipos se detiene demasiado pronto. Crean la carpeta de contexto, se saltan las habilidades y acaban con un chatbot bien informado. El producto es la habilidad. Todo lo demás es fontanería.
Qué agente para qué tarea
Es la pregunta que más nos hacen, y la respuesta honesta es que las diferencias importan menos que la configuración. Todos los de la lista pueden hacer casi cualquier trabajo de SEO si insistes lo suficiente. Lo que los separa es dónde resultan menos incómodos, y eso decide si sigues usándolos en la tercera semana.
Agente | En qué destaca | Modelo de acceso | Primera tarea de SEO sensata |
|---|---|---|---|
Codex | Trabajo sobre repositorios, ejecuciones programadas, cambios revisables | Archivos locales, terminal, git, automatización | Guardar los cortes semanales en un repositorio y abrir un pull request con el informe |
Claude Code | Revisión de contexto largo contra una política escrita explícita | Terminal, archivo de memoria del proyecto, conectores MCP | Leer exportaciones de Search Console y el código de la página y emitir un veredicto documentado |
Hermes Agent | Habilidades repetibles con memoria entre sesiones | Agente de código abierto con sistema de habilidades y memoria persistente | Instalar una habilidad y ejecutar el mismo flujo con la misma cadencia |
OpenClaw | Recogida de evidencia en navegador bajo permisos estrictos | Primero el navegador, después los archivos locales | Capturar qué devuelve realmente la búsqueda en móvil y detenerse ahí |
Pi Agent | Mantenerse pequeño y predecible durante meses | Núcleo mínimo, habilidades en Markdown como punto de extensión | Ejecutar un procedimiento acotado y legible donde quieras auditar todo lo que puede hacer |
Dos advertencias. Esta categoría cambia cada mes, así que antes de asignar un equipo a una herramienta, verifica los límites y precios actuales en la documentación oficial del proveedor. Y esta tabla es un punto de partida, no un techo.
Para cada uno tenemos una guía de inicio segura: Codex, Claude Code, Hermes Agent y OpenClaw. Las cuatro siguen la misma forma: primero solo lectura, un cambio aprobado a la vez, verificar antes de publicar.
La regla práctica de elección depende de dónde vive ya tu trabajo. Si el sitio está en un repositorio de git y los cambios de página son cambios de código, empieza por Codex o Claude Code. Si el trabajo es sobre todo exportaciones, conversaciones y criterio, empieza por un agente basado en habilidades. Si necesitas ver qué devuelve un navegador real, necesitas acceso a navegador y un límite de permisos estricto. Si quieres la superficie más pequeña posible que puedas leer de principio a fin de una sentada, el núcleo mínimo de Pi Agent está diseñado justo para eso, y el precio es que todo lo que necesites vive en una habilidad que añades tú.
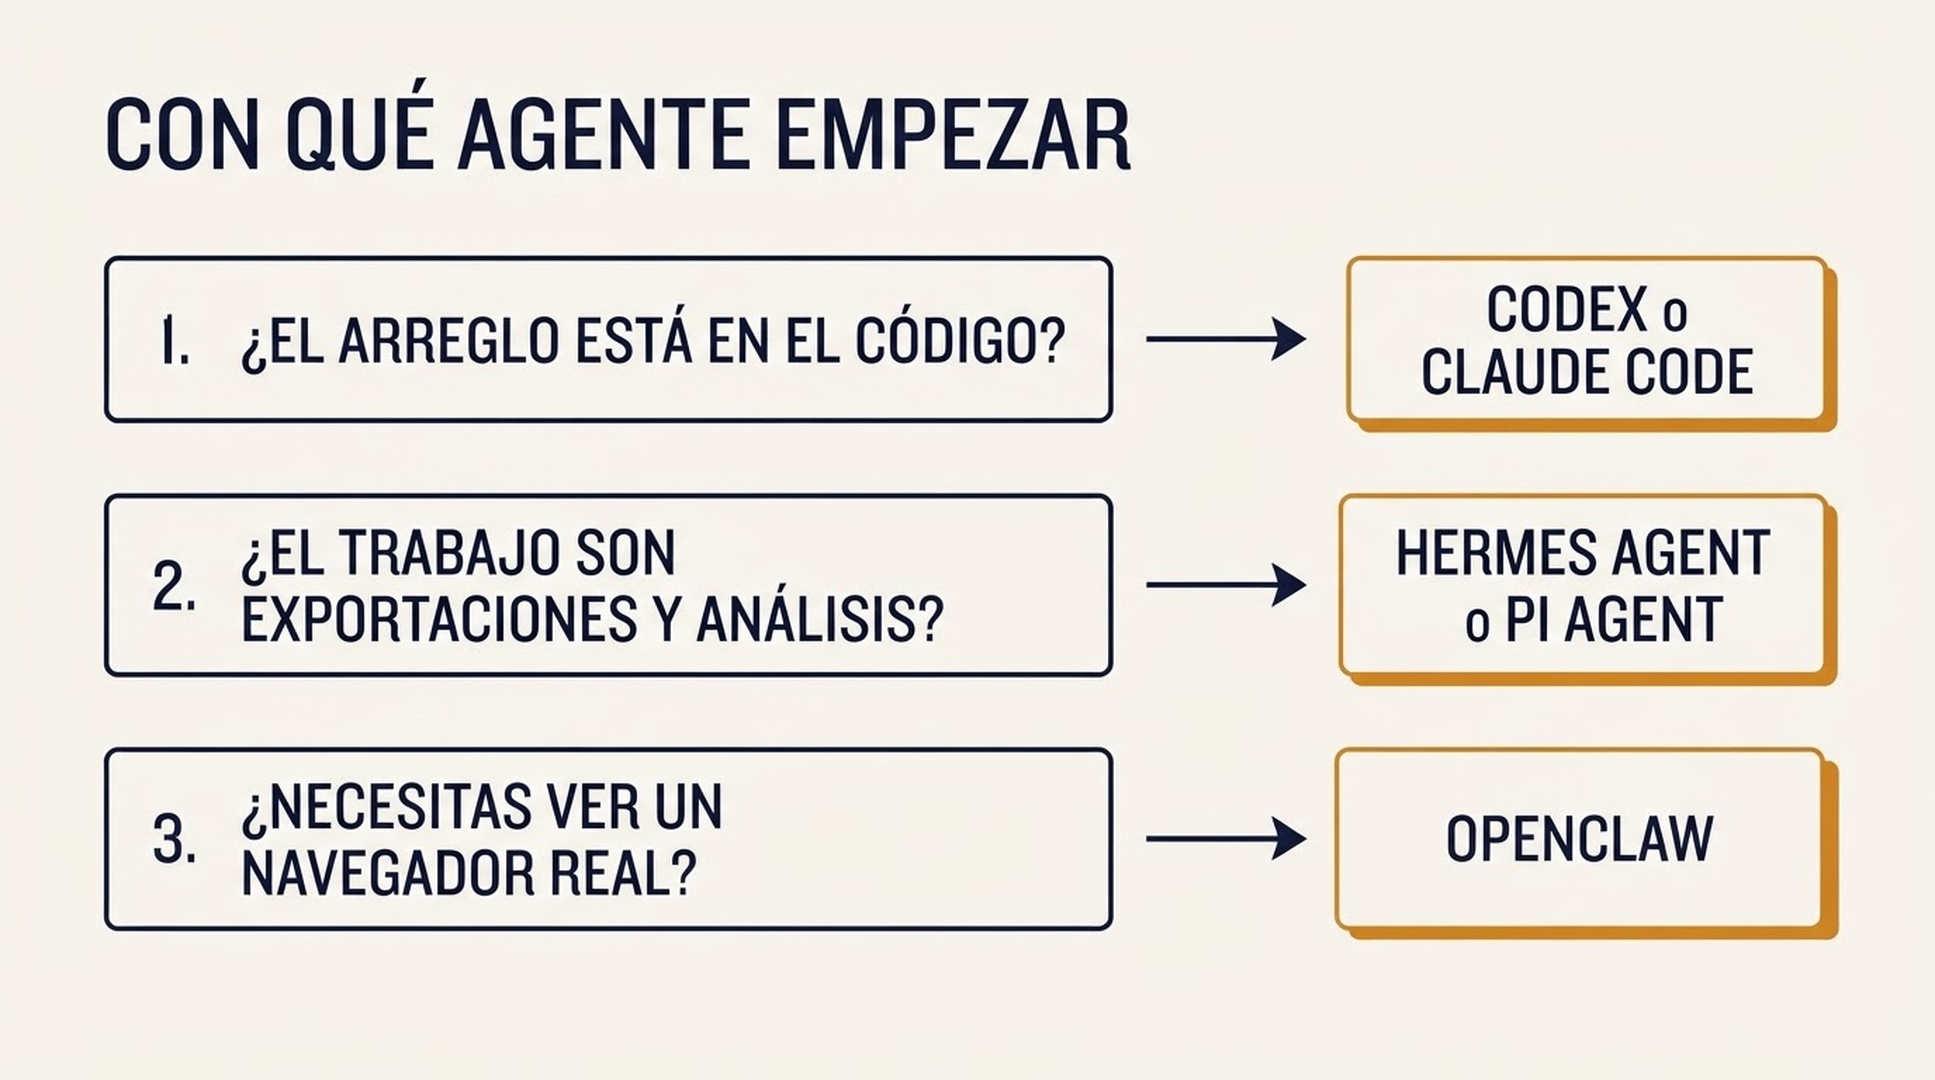
Tres preguntas reducen cinco agentes a uno. Respóndelas antes de comparar listas de funciones.
Las tareas que conviene delegar primero
No empieces por la interesante. Empieza por la aburrida que se repite según un calendario y produce algo que alguien lee. Esas se amortizan más rápido.
Triaje del deterioro de contenido. Toma el rendimiento periodo contra periodo, descarta todo lo que esté por debajo del umbral de materialidad, comprueba la indexación antes que nada y luego mira posiciones, demanda, enlaces y canibalización. Obtienes una tabla de URL con los clics perdidos, la causa probable, la evidencia y una acción principal y otra de reserva. Una página que perdió posiciones necesita reescritura. Una que perdió demanda no necesita nada. Una que perdió su canonical se arregla en cinco minutos. Los equipos confunden estos tres casos constantemente, y la confusión no sale barata.
Triaje de problemas técnicos. Agrupa los problemas por causa raíz y no por tipo, cruza las URL afectadas con tráfico y posiciones, puntúa el impacto frente al esfuerzo y verifica los primeros puntos en páginas reales antes de escribir la lista de arreglos. El valor está en esa agrupación. Diez filas de "redirección temporal" suelen tener una sola causa raíz, y arreglar una plantilla es mejor que arreglar diez URL.
Movimientos de la competencia. Aísla las páginas y palabras clave detrás de un cambio de tráfico, separa lo de marca de lo que no lo es y contrasta cada cambio con un factor con nombre: contenido nuevo, mejora de posiciones, estacionalidad, una migración o un artefacto de datos. La respuesta son el factor y el nivel de confianza. Un número grande con poca confianza es motivo para mirar más de cerca, no para reaccionar.
Enlazado interno y páginas huérfanas. Construye un grupo de candidatas a partir de páginas que ya posicionan o reciben enlaces, encuentra los pasajes directamente relacionados con cada destino y aplica una prueba de valor para el lector: ¿alguien a mitad de esta frase querría ir allí? La mitad estructural del resultado suele valer más que los enlaces. Descubrir que la segunda página más grande no tiene ni un enlace interno apuntándole es un arreglo de cinco minutos con un efecto desproporcionado.
Mapeo de brechas de citas. Agrupa los prompts por tema y etapa de compra, encuentra los dominios y páginas más citados, separa los tipos de fuente y lee las páginas citadas para deducir qué conseguiría realmente una mención. Cuenta con que buena parte del resultado sean fuentes donde la respuesta correcta es no contactar a nadie. Los foros y las propiedades de la competencia no son objetivos de outreach.
Comprobación de regresiones tras un despliegue. Compara un rastreo previo<|placeholdermmspan0442|> con otro posterior con la misma configuración, confirma que son comparables antes de diferenciar nada y clasifica cada diferencia como esperada, esperada pero mal implementada o no planificada. Esa clasificación es lo que hace utilizable el informe. Sin ella solo tienes un muro de diferencias y ninguna decisión.
De las que más aparecen tenemos guías más detalladas: informes semanales de posiciones, monitorización diaria, trabajo de perfil de enlaces y diseño de alertas que no te ahoguen.
Empieza con una habilidad, no con un departamento
El fallo más común es montar ocho habilidades, siete conexiones y un programador de tareas antes de haber ejecutado nada una sola vez. Luego nada funciona y no queda claro cuál de las dieciséis piezas tiene la culpa.
Hazlo en este orden.
Elige una tarea con un resultado visible. La que se valida más rápido es el triaje de problemas técnicos, porque puedes apuntarla a un rastreo que ya tengas y juzgar el resultado en minutos. El deterioro de contenido es la segunda más fácil si tienes historial en Search Console.
Escribe la habilidad antes de conectar nada. El archivo de la habilidad debe caber en una página y responder a seis preguntas: cuándo usarla, qué datos necesita, el orden de los pasos, las reglas de puntuación o umbrales, el formato de salida y qué acciones requieren aprobación. Si no cabe en una página, la tarea aún no está definida con la suficiente claridad para automatizarla.
Conecta una sola fuente de datos. La que la habilidad necesita de verdad. Los conectores que no usas solo amplían la superficie sin aportar valor.
Ejecútala en solo lectura y revisa el resultado a mano. Toma dos hallazgos y verifícalos tú mismo contra los datos de origen. Si la explicación del agente no coincide con lo que ves, el problema está en la habilidad, no en el modelo.
Añade la puerta de aprobación antes de añadir la segunda habilidad. Toda acción de escritura (publicar, redirigir, borrar, editar código, fusionar, enviar mensajes externos) debe detenerse y esperar. Crea ese hábito mientras la apuesta es una sola habilidad.
Las salvaguardas que evitan que se rompa
Estas son las reglas que pondríamos en las instrucciones del proyecto el primer día. Son aburridas a propósito, y de eso se trata.
- Mantén las herramientas de producción en solo lectura hasta que apruebes una acción de escritura.
- Exige un plan antes de empezar cualquier flujo de varios pasos.
- Obtén la evidencia con las herramientas conectadas en lugar de apoyarte en suposiciones.
- Sigue la habilidad correspondiente cuando exista, en vez de improvisar.
- Si una llamada a una herramienta falla, reintenta una vez y luego muestra el error en lugar de rodearlo.
- Exige que cada hallazgo explique su evidencia en una frase.
- Separa los hallazgos confirmados de las hipótesis, en la propia salida.
- Señala los datos que faltan y las conclusiones de baja confianza en lugar de rellenar el hueco.
- Detente cuando el flujo supere un límite acordado de URL, filas o unidades de API.
- Pide aprobación antes de publicar, redirigir, borrar, editar código, fusionar o enviar algo al exterior.
Dos de ellas hacen más trabajo que el resto. Separar los hallazgos confirmados de las hipótesis es lo que hace que la salida sea lo bastante fiable para actuar sobre ella. El límite de gasto es lo que impide que un bucle mal configurado queme el presupuesto de API en una noche.
Dónde se rompe
Datos de conversión escasos. Un motor de decisiones de cartera de contenido que clasifica cada URL como mantener, actualizar, consolidar, redirigir, eliminar o investigar necesita datos de conversión para decidir. Si el seguimiento no está bien configurado, devolverá muchos ceros y el informe no sirve hasta que eso se arregle. El agente hizo su trabajo. La entrada estaba mal.
Juicio estructural. Un agente puede encontrar cuatro cosas que un brief humano pasó por alto, incluida una palabra clave que trae un tipo de resultado completamente distinto y por eso no debería estar en esa página. Pero no puede decidir cómo estructurar el artículo. Esa decisión se queda en una persona, y fingir lo contrario produce contenido que se lee como si lo hubieran ensamblado por piezas.
Errores silenciosos de explicación. Los agentes fallan ruidosamente en la fase de datos y en silencio en la de explicación. Una exportación que falta lanza un error. Una causa equivocada dicha con seguridad, no. Por eso la regla de la evidencia por hallazgo importa más de lo que parece.
Huecos de herramientas que no previste. Hay datos que sencillamente no son accesibles a través de un conector. Un conector de datos de posiciones puede no ser capaz de crear un proyecto de rastreo, lanzar un rastreo o exportar el conjunto completo de URL rastreadas. Diseña el flujo en torno a lo que la conexión puede devolver de verdad, o la habilidad se atascará a mitad de camino.
Verifica el resultado antes de confiar en el bucle
Ejecuta esta comprobación las tres primeras veces y, después, una vez al mes.
- Elige dos hallazgos al azar y verifícalos a mano contra los datos de origen.
- Confirma que el agente citó una fuente y una fecha en cada afirmación que dependa de datos.
- Comprueba que al menos un hallazgo esté etiquetado como de baja confianza. Un agente seguro de todo no está discriminando.
- Confirma que la forma de la salida coincide con la ejecución anterior. Si se ha desviado, cambió el archivo de la habilidad o el agente dejó de seguirlo.
- Confirma que nada se escribió, publicó ni envió sin que se activara una puerta de aprobación.
Si las cinco pasan tres ejecuciones seguidas, tienes un flujo de trabajo. Si falla alguna, arregla la capa que lo causó en lugar de reescribir el prompt.
Preguntas frecuentes
¿Qué es el SEO agéntico? El SEO agéntico es entregar un flujo de trabajo de SEO definido a un agente de IA que obtiene sus propios datos, sigue un método escrito y devuelve un análisis con la misma forma en cada ejecución. El rasgo decisivo no es la autonomía, sino la repetibilidad: el método vive fuera de la conversación, así que las mismas comprobaciones se aplican te hayas acordado de pedirlas o no.
¿En qué se diferencia del SEO asistido por IA? La diferencia está en quién decide qué ocurre después. En el SEO asistido por IA eliges los pasos en cada conversación y pegas los datos. En el SEO agéntico defines el método una vez, el agente obtiene sus propios datos y, ante una entrada inesperada, sigue una regla escrita. La automatización de flujos es una tercera cosa: consistencia perfecta sin adaptabilidad.
¿Necesito un agente de programación? No. Agentes como Codex y Claude Code encajan mejor cuando el arreglo es un cambio de código o el sitio vive en un repositorio. Si tu trabajo es sobre todo exportaciones, análisis y criterio, un agente basado en habilidades lo cubre sin tocar la terminal.
¿Cuántas habilidades debería crear primero? Una. Elige una tarea con un resultado visible, escribe la habilidad para que quepa en una página, conecta solo la fuente de datos que necesita y ejecútala en solo lectura hasta que la salida sea fiable. Los<|placeholdermmspan0442|> equipos que crean ocho habilidades sin haber ejecutado ninguna suelen abandonar el proyecto.
¿Puede un flujo de SEO agéntico publicar contenido por su cuenta? Puede, y no debería. Mantén la publicación, las redirecciones, el borrado, la edición de código, las fusiones y los mensajes externos detrás de una puerta de aprobación explícita. El valor del flujo está en la evidencia que reúne, no en el permiso que tiene.
¿Cuánto cuesta ejecutarlo? Depende de las fuentes de datos, no del agente. Search Console es gratis para tu propio dominio. El costo recurrente está en los datos de posiciones, los datos de SERP y los servicios de rastreo, y la mayoría tiene planes gratuitos suficientes para validar un flujo antes de comprometerte.
Autor: Aaron Wolfe, Diseñador de sistemas de crecimiento orgánico en Auspia con 15 años de experiencia en SEO/GEO. Escribe sobre cómo los equipos integran agentes de IA, datos y pasos de revisión en flujos de búsqueda que sobreviven a un ciclo de planificación trimestral.