Una API de rank tracking no es una sola cosa. El desarrollador que busca "rank tracking API" normalmente quiere un único endpoint que devuelva posiciones, y el mercado responde con listas de proveedores. La respuesta honesta es que necesitas dos fuentes, y responden a preguntas distintas.
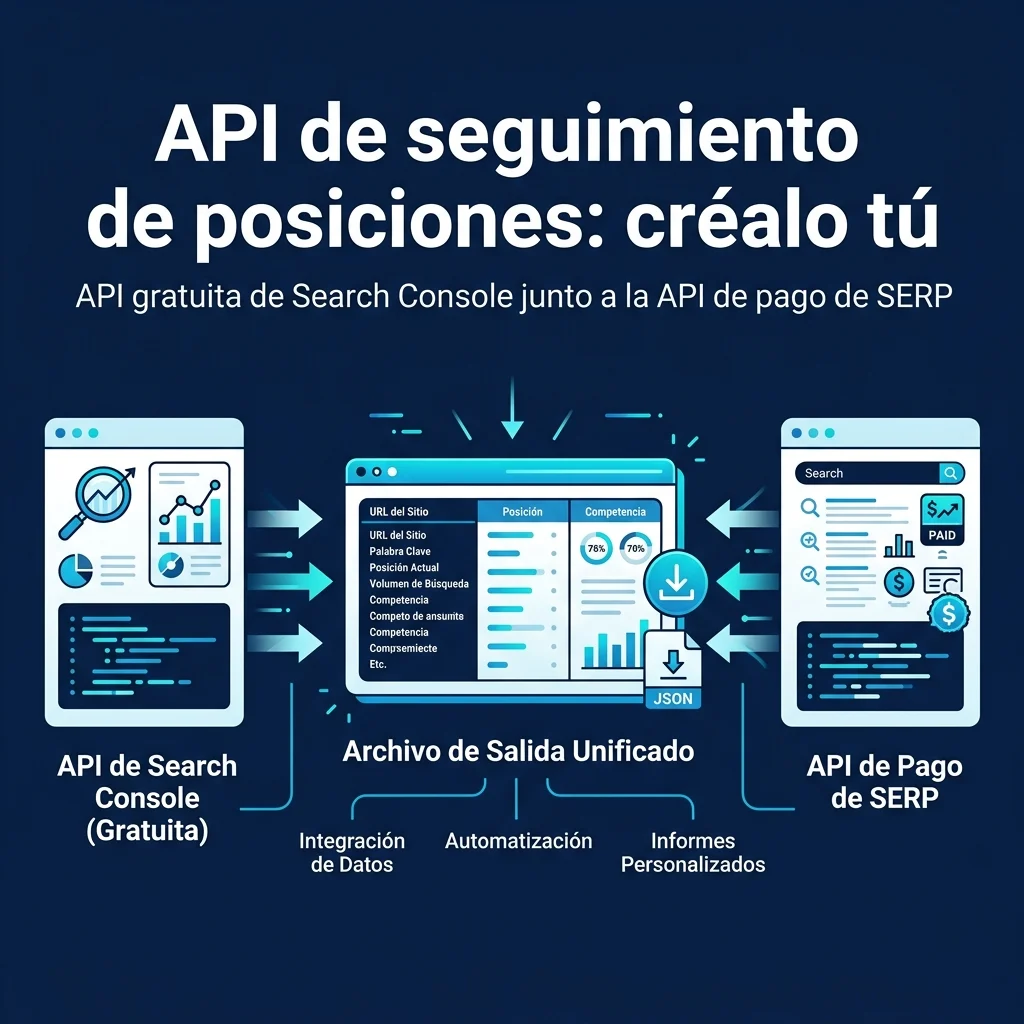
La API de Search Console es gratuita, oficial y está permanentemente limitada a las propiedades que puedes verificar. Una API de SERP es de pago, no oficial y puede comprobar cualquier palabra clave en cualquier lugar, incluidas palabras clave para las que nunca te has posicionado. Ninguna de las dos por separado es un rank tracker. Juntas son unas 120 líneas de Python y una entrada de cron.
Esta es la construcción. Asume que sabes ejecutar un script y guardar un archivo. No asume que quieras construir un producto.
Con qué terminas
Para quién es: un desarrollador o un profesional de marketing técnico que ya tiene acceso a Search Console y quiere posiciones con una periodicidad sin pagar por asiento.
Qué tendrás al terminar: dos funciones de extracción funcionando, un archivo de salida combinado por ejecución y una regla de comparación que impide que los números te mientan.
Tiempo: unos 90 minutos para la primera construcción, después unos 10 minutos de revisión por ejecución.
Cómo se ve el final: un archivo JSON con fecha que contiene tus posiciones por consulta y dispositivo, más capturas de SERP en vivo para una lista congelada de palabras clave, y un diff corto contra la ejecución anterior.
Antes de empezar: qué puede y qué no puede hacer cada fuente
Acierta con este reparto y el resto de la construcción será mecánico. Fállalo y pasarás un mes construyendo algo inútil o caro.
API de Search Console | API de SERP | |
|---|---|---|
Posiciones de quién | Solo tus propiedades verificadas | Cualquiera, incluidos competidores |
Palabras clave | Consultas en las que ya apareces | Cualquier palabra clave que escribas |
Coste | Gratuito | Facturado por petición |
Desglose por dispositivo | Sí, como dimensión | Sí, por petición |
Ubicación | Países en los que te posicionas | Cualquier ubicación que soporte el proveedor |
Tipo de dato | Clics, impresiones y posición agregados | Página de resultados en un instante |
Profundidad histórica | El rango que solicites | Solo desde el día en que empiezas a guardar |
Carácter oficial | Datos del propio Google | Lectura de un tercero sobre una página pública |
Las dos fuentes van a discrepar, y esa discrepancia es informativa, no un fallo. Search Console promedia cada impresión a lo largo del rango de fechas y de todos los dispositivos. Una extracción de SERP es una página de resultados en un momento concreto. Si las comparas directamente, perseguirás caídas fantasma, y por eso el paso cinco define una regla de comparación.
Tres números que conviene conocer antes de escribir código. La API de Search Console acepta un límite de filas de entre 1 y 25.000 por petición y usa 1.000 por defecto, así que un sitio de tamaño medio puede extraer tres meses de datos de consulta y dispositivo en una sola llamada. Permite 1.200 consultas por minuto por sitio y por usuario. Y aplica cuotas de carga medidas en tramos de 10 minutos, donde un rango de fechas largo cuesta más que uno corto, que es justo la razón por la que la propia guía de Google dice que evites volver a consultar los mismos datos.
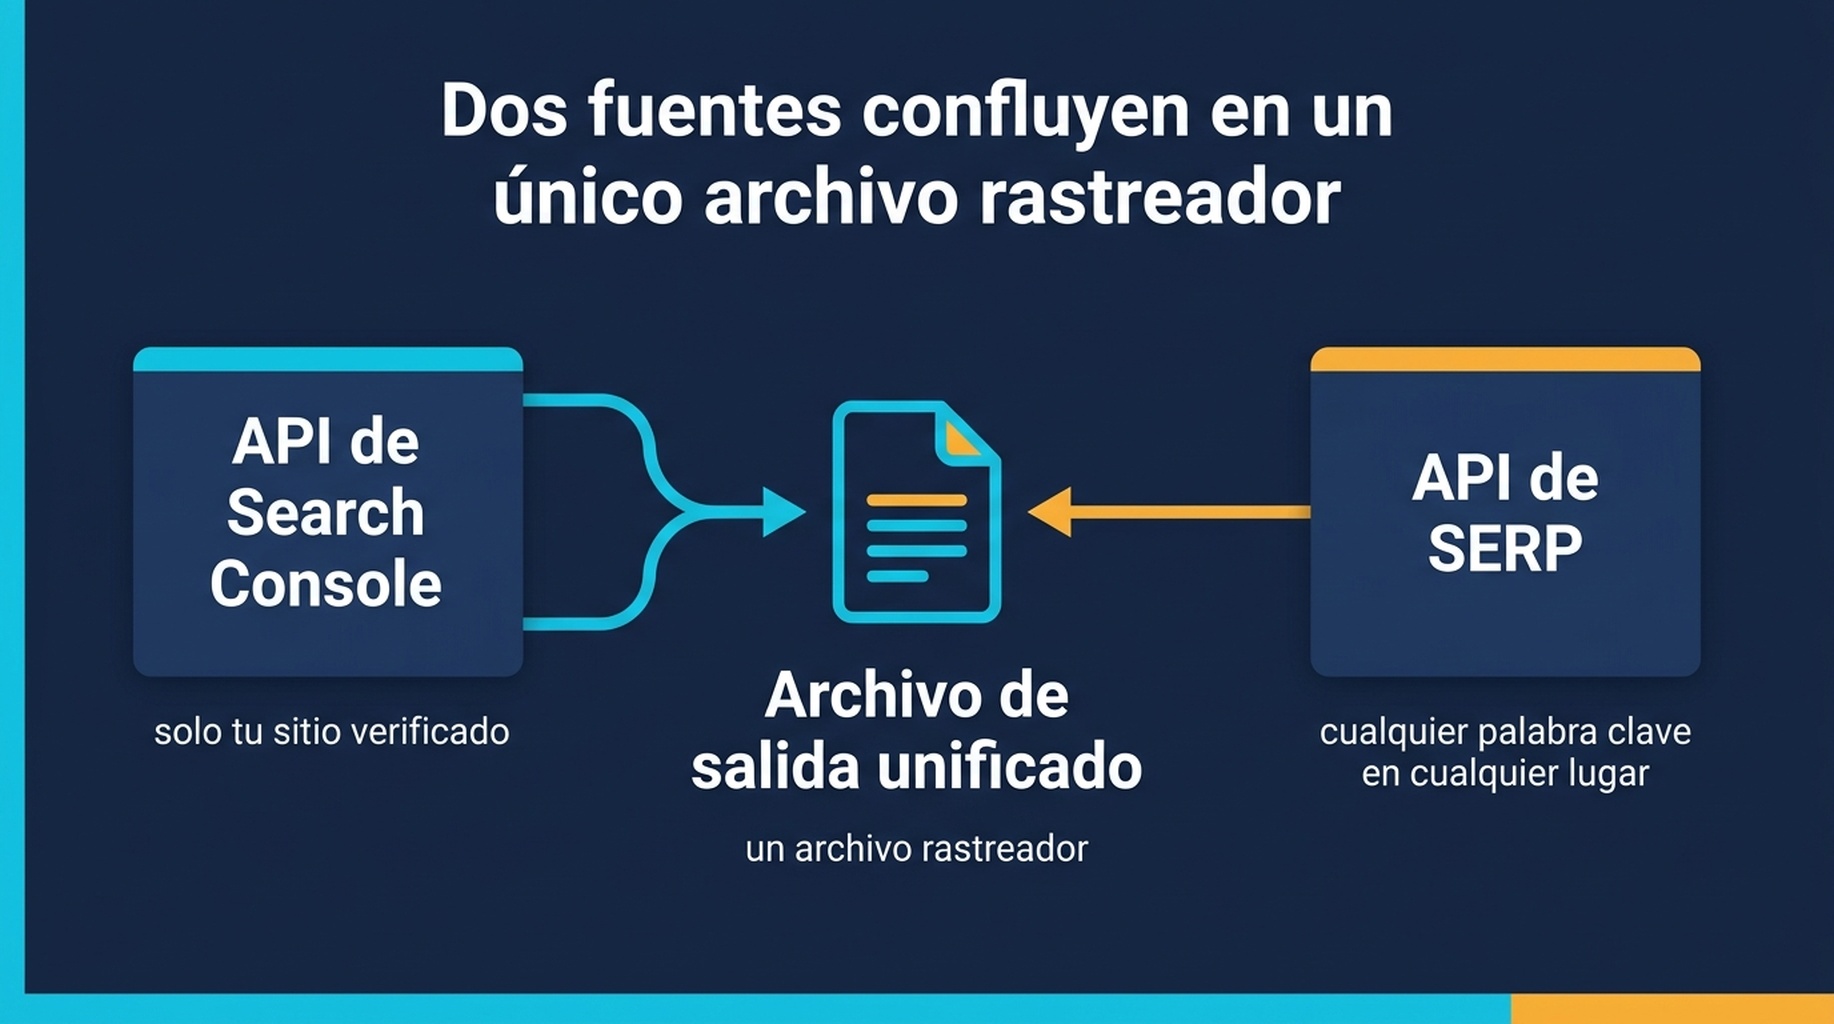
Dos fuentes, una salida. Search Console responde "dónde aparezco", una API de SERP responde "cómo se ve la página".
Paso 1: congela el conjunto de palabras clave antes de escribir código
Un tracker que extrae una lista de palabras clave distinta en cada ejecución no puede responder si algo cambió. Elige la lista primero y mantenla un trimestre.
Tres grupos, y vienen de fuentes distintas.
- De Search Console: cada consulta con al menos 20 impresiones en los últimos 90 días. Estas no las eliges tú; las eligen tus impresiones. Es el grupo donde el movimiento significa algo, porque ya tiene demanda asociada.
- Del negocio: las diez a veinte consultas que se corresponden con ingresos, tanto si te posicionas para ellas como si no.
- De los competidores: las consultas para las que se posiciona un competidor y tú no. Estas necesitan una API de SERP, porque Search Console nunca las mostrará.
Escribe la lista en un archivo, versiónala y trata las adiciones como un cambio deliberado y no como una deriva.
Paso 2: extrae tus propias posiciones gratis
Esta mitad es oficial, gratuita y te da desglose por dispositivo y datos de clics que ninguna API de SERP tiene.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
Dos detalles de esa petición hacen casi todo el trabajo.
dataState: "final" excluye los datos recientes que Google todavía puede revisar. Sin él, los dos o tres días más nuevos bailan entre ejecuciones y tu diff muestra movimientos que nunca ocurrieron.
dimensions: ["query", "device"] es lo que hace útil la salida más adelante. Añadir dispositivo ahora no cuesta nada. Volver a extraer tres meses de historial después cuesta una ejecución completa y no te da nada por los días que ya te saltaste.
Salida esperada: una fila por consulta y dispositivo, con clics, impresiones, CTR y posición media.
Comprobación de calidad: el recuento de filas debería estar por debajo de 25.000. Si da exactamente 25.000, estás truncado y necesitas una segunda llamada con startRow: 25000.
Si falla: un 403 normalmente significa que el correo de la cuenta de servicio nunca se añadió como usuario en la propiedad. Añádelo en Search Console, espera unos minutos y reintenta.
Paso 3: extrae las SERP que no ves en tus propios datos
La segunda mitad cubre todo lo que Search Console estructuralmente no puede hacer. Esta es una llamada mínima que funciona.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
Pon `depth` en 100, no en 200. Lo probamos en septiembre de 2026 pidiendo 200 resultados en seis consultas. Google devolvió entre 83 y 128 resultados orgánicos y se detuvo, con la posición más profunda de toda la prueba en 142. La prueba completa está aquí. Pedir 200 no te da 200 resultados, y según el proveedor puede que te siga facturando la profundidad solicitada. Pide 100 y casi siempre recibirás todo lo que exista.
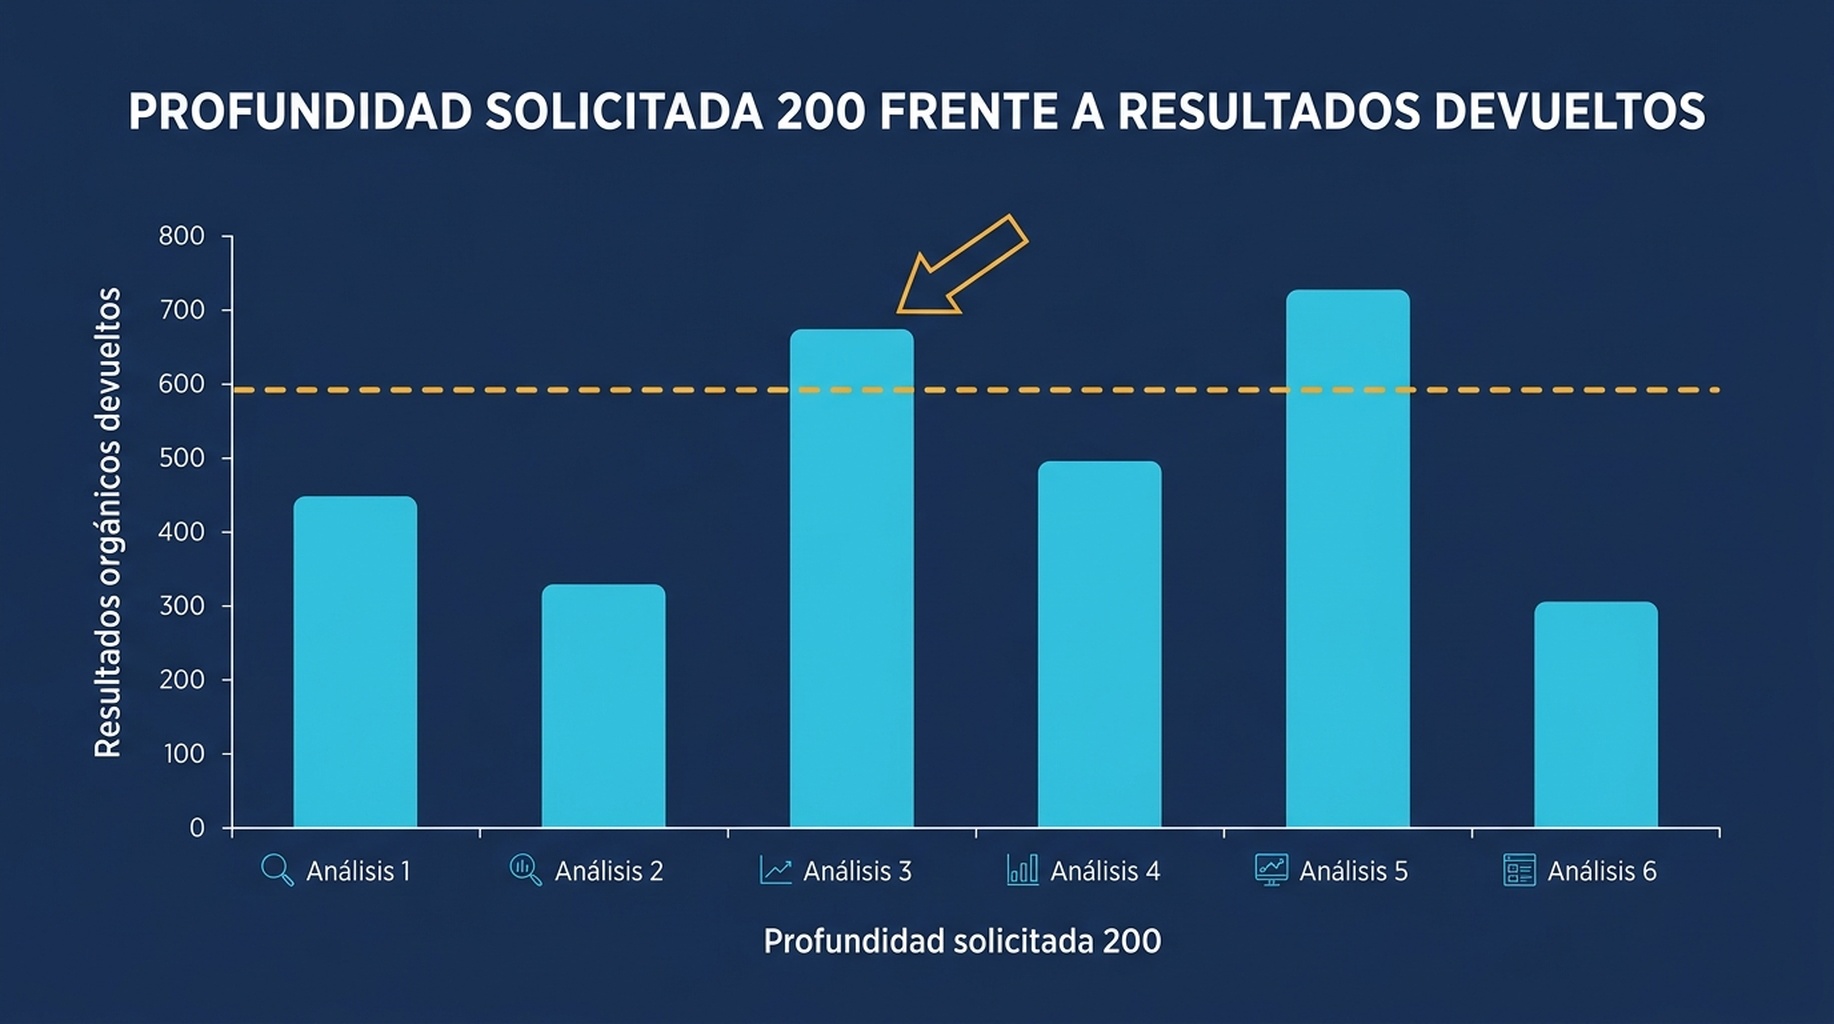
Pedir 200 resultados y recibir entre 83 y 128. Una profundidad por encima de unos 140 no compra nada en la mayoría de las consultas comerciales.
Salida esperada: un payload JSON con elementos orgánicos que incluyen posición, URL, título y dominio.
Comprobación de calidad: confirma que el payload contiene un tipo de elemento ai_overview cuando lo haya. Si solo extraes elementos organic, te perderás por qué una página perdió clics manteniendo la posición.
Si falla: un 401 es un error de base64 o de credenciales. Un código tipo 40200 significa que el saldo de tu cuenta está vacío, que es el fallo más común el primer mes.
Paso 4: guarda el payload en bruto, no el resumen
Esta es la decisión de la que la gente se arrepiente de haber prescindido.
Guardar una tabla de posiciones funciona hasta que necesitas hacer una pregunta que no previste: si la SERP se alargó, si el vídeo se hizo con el control, si entró un competidor, si apareció un AI Overview por encima del pliegue. Un resumen no responde a eso. El payload en bruto sí, con cero coste adicional.
La versión práctica: escribe un archivo por ejecución, nombrado por fecha y hora, con la salida combinada. Conserva los últimos 90 días. Es lo bastante pequeño para vivir en un repositorio y lo bastante completo para volver a responder preguntas antiguas.
Paso 5: escribe la regla de comparación antes de programar nada
Un tracker que compara la última ejecución con esta produce una falsa alarma casi todos los días. Nuestros propios números muestran por qué: en 124 consultas con al menos 30 impresiones, la consulta media se movió 4,57 posiciones de un día para otro. Una caída de cuatro posiciones es un martes.
Así que la regla necesita un umbral y una dirección.
Informa de una consulta solo cuando:
  - el cambio absoluto de posición frente a la ejecución anterior sea 5 o más, Y
  - la consulta tuviera al menos 20 impresiones en la ventana de comparación, Y
  - el cambio no se explique por un cambio en la mezcla de dispositivos

Agrupa la salida por clase de consulta: money, comparison, brand, informational.
No sugieras correcciones.
La cláusula de dispositivo no es decorativa. La misma consulta puede estar a 11 posiciones de distancia entre móvil y escritorio, y si la mezcla de dispositivos se mueve entre ejecuciones, el número combinado también se mueve. Lo medimos por separado y es lo bastante grande como para falsear una tendencia.
Cuánto cuesta
Los precios de los proveedores cambian, así que construye el modelo en vez de perseguir un presupuesto.
- Una palabra clave comprobada una vez al día durante 30 días son 30 peticiones al mes.
- Un conjunto de 200 palabras clave comprobado a diario son 6.000 peticiones al mes.
- El mismo conjunto comprobado semanalmente son unas 860 peticiones al mes.
- La mitad de Search Console es gratuita y es una petición por vista, sin importar cuántas palabras clave haya dentro.
Esa multiplicación es toda la decisión. Casi cualquier pregunta de "¿debería comprar una herramienta?" se reduce a ella: calcula peticiones al mes, multiplícalas por tu precio por petición y compáralas con la licencia por asiento. El seguimiento diario de un conjunto grande suele ser más barato como suscripción. El seguimiento semanal de un conjunto pequeño suele ser más barato como API. Sigue una lista congelada y el lado de la API se mantendrá pequeño.
Cuándo comprar en vez de construir
Construye esto si quieres posiciones en tu propio pipeline, si ya tienes una credencial de API de SERP o si necesitas la página de resultados en bruto por razones más allá de la posición.
Compra en su lugar si necesitas posiciones históricas anteriores a hoy, si necesitas diez ubicaciones y cinco dispositivos para las mismas palabras clave, o si nadie en el equipo va a mantener un cron. Las listas de proveedores merecen leerse exactamente por esto, y tiene un coste real poseer infraestructura que deja de funcionar cuando quien la construyó cambia de equipo.
Si la salida que de verdad necesitas es un informe semanal escrito y no un archivo JSON, el flujo de informes en Codex parte de las mismas dos fuentes y termina en un documento. Para alertas sobre el archivo, la guía de diseño de monitorización cubre los umbrales.
Visión de Auspia: la pregunta sobre la API de rank tracking es en realidad una pregunta sobre propiedad de los datos. Search Console te da datos oficiales sobre tu propiedad gratis y siempre lo hará. Todo lo demás es una captura que pagas. Construye primero la mitad gratuita y añade la mitad de pago solo donde responda a una pregunta que de verdad tengas.
Preguntas frecuentes
¿Ofrece Google una API de rank tracking? No una pública. La API de Search Console devuelve tu posición media para consultas en las que ya apareces, lo cual se acerca pero no es lo mismo. No puede comprobar una palabra clave para la que no te posicionas, ni comprobar a un competidor.
¿Hasta qué profundidad llega una API de SERP? Los proveedores aceptan valores de profundidad muy por encima de 200, pero Google deja de servir resultados en algún punto entre 100 y 140 en la mayoría de las consultas comerciales. Pedir más no produce más resultados.
¿Debería usar comprobaciones diarias o semanales? Semanales para un conjunto normal de palabras clave. Diarias solo para una lista corta de consultas de dinero. Las comprobaciones diarias sobre un conjunto grande multiplican el coste por siete y miden sobre todo ruido, ya que el movimiento diario medio en nuestros datos fue de 4,57 posiciones.
¿Por qué mi número de la API difiere de mi rank tracker? Dispositivos distintos, ubicaciones distintas, momentos distintos y, a menudo, fuentes de datos distintas. El número es una muestra. Fija la ubicación y el dispositivo en tu petición y vuelve a extraer antes de concluir que algo cambió.
¿Puede un agente ejecutar esto por mí? Sí, y encaja bien porque la tarea tiene la misma forma en cada ejecución. Para el cuadro más amplio de lo que un agente puede asumir en el trabajo de posiciones, consulta la guía de campo del agente de SEO. Mantén la regla de comparación en un archivo de instrucciones escrito y deja que el agente produzca el diff; mantén la decisión de comprar o construir en manos de una persona.
Autor: Rowan Blake, analista de automatización de contenido para más de 100 pipelines de publicación en Auspia. Rowan escribe sobre pipelines de datos automatizados, informes programados y el coste de mantenimiento de sistemas que funcionan sin ti.