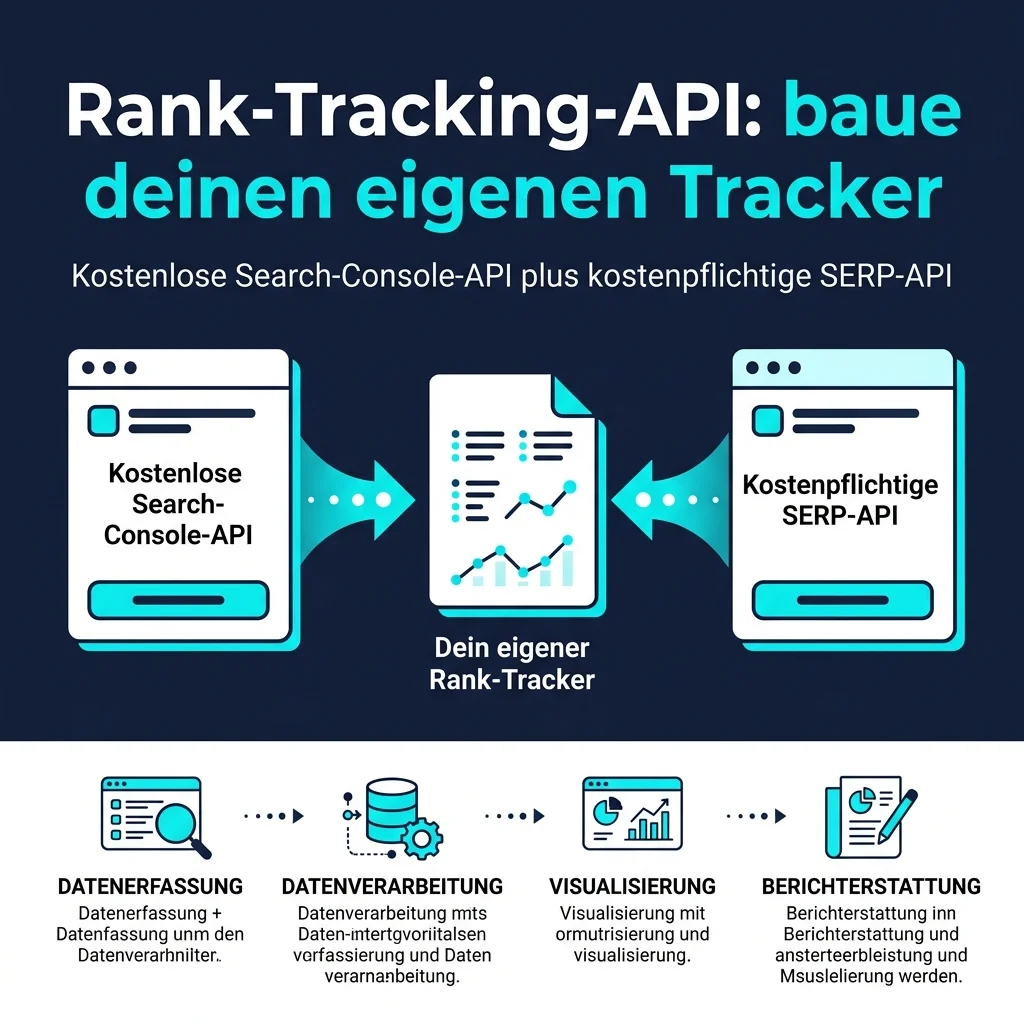
Eine Rank-Tracking-API ist nicht eine Sache. Wer nach "rank tracking API" sucht, will meist einen einzigen Endpunkt, der Positionen zurückgibt, und der Markt antwortet mit Anbieter-Listen. Die ehrliche Antwort ist, dass man zwei Quellen braucht, und sie beantworten unterschiedliche Fragen.
Die Search Console API ist kostenlos, offiziell und dauerhaft auf Properties beschränkt, die Sie verifizieren können. Eine SERP-API ist kostenpflichtig, nicht offiziell und kann jedes Keyword überall prüfen, auch Keywords, für die Sie nie gerankt haben. Keine von beiden allein ist ein Rank Tracker. Zusammen sind es etwa 120 Zeilen Python und ein Cron-Eintrag.
Das ist der Bau. Er setzt voraus, dass Sie ein Skript ausführen und eine Datei speichern können. Er setzt nicht voraus, dass Sie ein Produkt bauen wollen.
Was am Ende steht
Für wen das ist: Entwickler oder technische Marketingverantwortliche, die bereits Zugang zur Search Console haben und Positionen nach Zeitplan wollen, ohne pro Sitzplatz zu zahlen.
Was Sie am Ende haben: zwei funktionierende Abruffunktionen, eine zusammengeführte Ausgabedatei pro Lauf und eine Vergleichsregel, die verhindert, dass die Zahlen Sie belügen.
Zeit: etwa 90 Minuten für den ersten Bau, danach rund 10 Minuten Durchsicht pro Lauf.
So sieht fertig aus: eine datierte JSON-Datei mit Ihren eigenen Positionen nach Suchanfrage und Gerät, dazu Live-SERP-Momentaufnahmen für eine eingefrorene Keyword-Liste und ein kurzer Diff gegen den vorherigen Lauf.
Vor dem Start: was jede Quelle kann und was nicht
Bringen Sie diese Aufteilung richtig hin, und der Rest des Baus ist mechanisch. Bringen Sie sie falsch hin, und Sie verbringen einen Monat mit etwas Nutzlosem oder Teurem.
Search Console API | SERP-API | |
|---|---|---|
Wessen Positionen | Nur Ihre verifizierten Properties | Jeder, auch Wettbewerber |
Keywords | Suchanfragen, für die Sie bereits erscheinen | Jedes Keyword, das Sie eingeben |
Kosten | Kostenlos | Pro Anfrage abgerechnet |
Geräteaufteilung | Ja, als Dimension | Ja, pro Anfrage |
Standort | Länder, in denen Sie ranken | Jeder Standort, den der Anbieter unterstützt |
Datentyp | Aggregierte Klicks, Impressionen, Position | Ergebnisseite zu einem Zeitpunkt |
Historische Tiefe | Der angefragte Bereich | Erst ab dem Tag, an dem Sie zu speichern beginnen |
Offizieller Status | Googles eigene Daten | Die Lesart eines Dritten einer öffentlichen Seite |
Die beiden Quellen werden sich widersprechen, und dieser Widerspruch ist informativ und kein Fehler. Die Search Console mittelt jede Impression über den Datumsbereich und über alle Geräte. Ein SERP-Abruf ist eine Ergebnisseite zu einem Moment. Vergleichen Sie sie direkt, jagen Sie Phantom-Rückgängen nach — genau deshalb definiert Schritt fünf eine Vergleichsregel.
Drei Zahlen, die man vor dem Code kennen sollte. Die Search Console API akzeptiert ein Zeilenlimit zwischen 1 und 25.000 pro Anfrage und verwendet standardmäßig 1.000, sodass eine mittelgroße Website drei Monate Anfrage- und Gerätedaten in einem einzigen Aufruf ziehen kann. Sie erlaubt 1.200 Anfragen pro Minute pro Website und pro Nutzer. Und sie erzwingt Lastkontingente in 10-Minuten-Abschnitten, wobei ein langer Datumsbereich mehr kostet als ein kurzer — genau deshalb rät Googles eigene Anleitung davon ab, dieselben Daten erneut abzufragen.
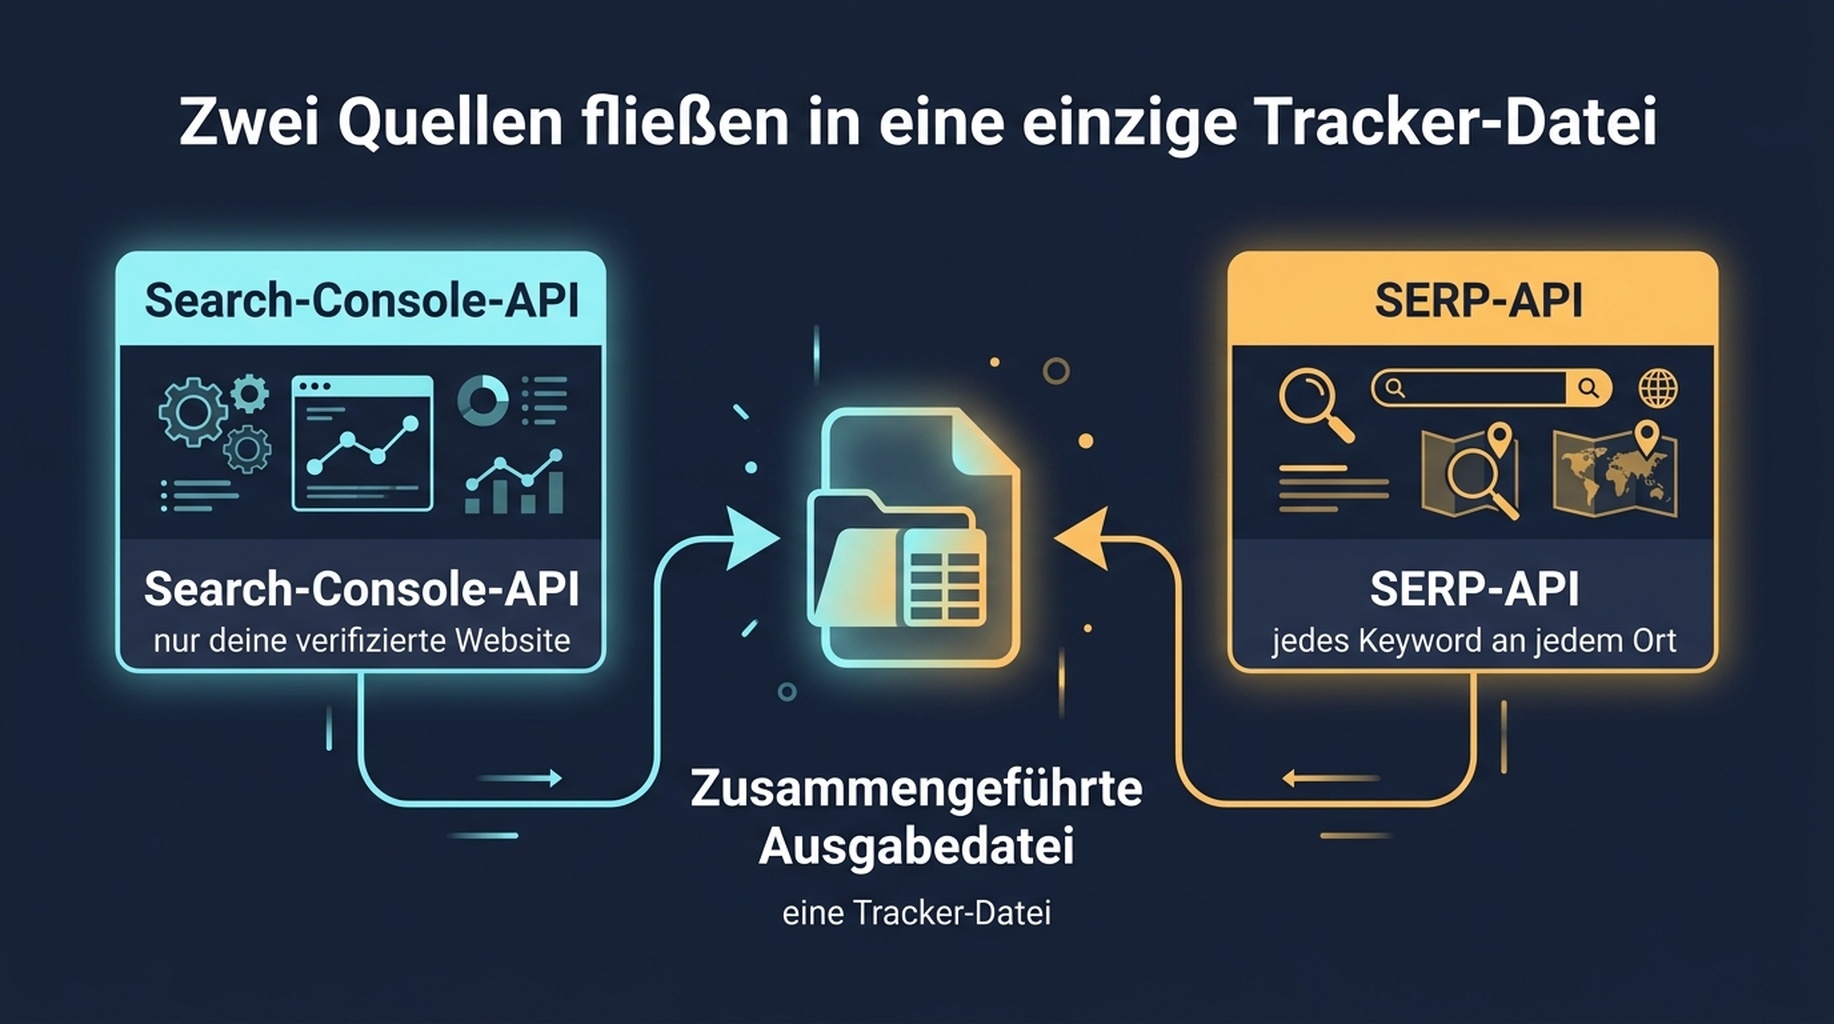
Zwei Quellen, eine Ausgabe. Die Search Console beantwortet "wo erscheine ich", eine SERP-API beantwortet "wie sieht die Seite aus".
Schritt 1: Frieren Sie das Keyword-Set ein, bevor Sie Code schreiben
Ein Tracker, der in jedem Lauf eine andere Keyword-Liste zieht, kann nicht beantworten, ob sich etwas geändert hat. Wählen Sie die Liste zuerst und behalten Sie sie ein Quartal lang.
Drei Gruppen, und sie kommen aus verschiedenen Quellen.
- Aus der Search Console: jede Suchanfrage mit mindestens 20 Impressionen in den letzten 90 Tagen. Diese wählen nicht Sie; Ihre Impressionen wählen sie. Das ist die Gruppe, in der Bewegung etwas bedeutet, weil bereits Nachfrage daran hängt.
- Aus dem Geschäft: die zehn bis zwanzig Suchanfragen, die auf Umsatz abbilden, ob Sie dafür ranken oder nicht.
- Aus dem Wettbewerb: die Suchanfragen, für die ein Wettbewerber rankt und Sie nicht. Diese brauchen eine SERP-API, weil die Search Console sie nie zeigen wird.
Schreiben Sie die Liste in eine Datei, versionieren Sie sie, und behandeln Sie Ergänzungen als bewusste Änderung statt als Drift.
Schritt 2: Ziehen Sie Ihre eigenen Positionen kostenlos
Diese Hälfte ist offiziell, kostenlos und liefert Ihnen Geräteaufteilung und Klickdaten, die keine SERP-API hat.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
Zwei Details in dieser Anfrage erledigen fast die ganze Arbeit.
dataState: "final" schließt frische Daten aus, die Google noch überarbeiten kann. Ohne das schwanken die neuesten zwei oder drei Tage zwischen den Läufen, und Ihr Diff zeigt Bewegungen, die nie stattgefunden haben.
dimensions: ["query", "device"] ist das, was die Ausgabe später nützlich macht. Das Gerät jetzt hinzuzufügen kostet nichts. Drei Monate Historie später erneut zu ziehen kostet einen vollen Lauf und bringt Ihnen nichts für die Tage, die Sie bereits übersprungen haben.
Erwartete Ausgabe: eine Zeile pro Suchanfrage und Gerät, mit Klicks, Impressionen, CTR und durchschnittlicher Position.
Qualitätsprüfung: die Zeilenzahl sollte unter 25.000 liegen. Wenn sie genau 25.000 beträgt, sind Sie abgeschnitten und brauchen einen zweiten Aufruf mit startRow: 25000.
Wenn es fehlschlägt: ein 403 bedeutet meist, dass die E-Mail des Dienstkontos nie als Nutzer zur Property hinzugefügt wurde. Fügen Sie sie in der Search Console hinzu, warten Sie ein paar Minuten, versuchen Sie es erneut.
Schritt 3: Ziehen Sie die SERPs, die Sie in Ihren eigenen Daten nicht sehen
Die zweite Hälfte deckt alles ab, was die Search Console strukturell nicht kann. Dies ist ein minimaler funktionierender Aufruf.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
Setzen Sie `depth` auf 100, nicht auf 200. Wir haben das im September 2026 getestet, indem wir über sechs Suchanfragen 200 Ergebnisse angefragt haben. Google lieferte 83 bis 128 organische Ergebnisse und hörte auf, wobei die tiefste Position im gesamten Test bei 142 lag. Der vollständige Test steht hier. 200 anzufragen bringt keine 200 Ergebnisse, und je nach Anbieter wird Ihnen die angefragte Tiefe trotzdem berechnet. Fragen Sie 100 an, und Sie bekommen fast immer alles, was existiert.
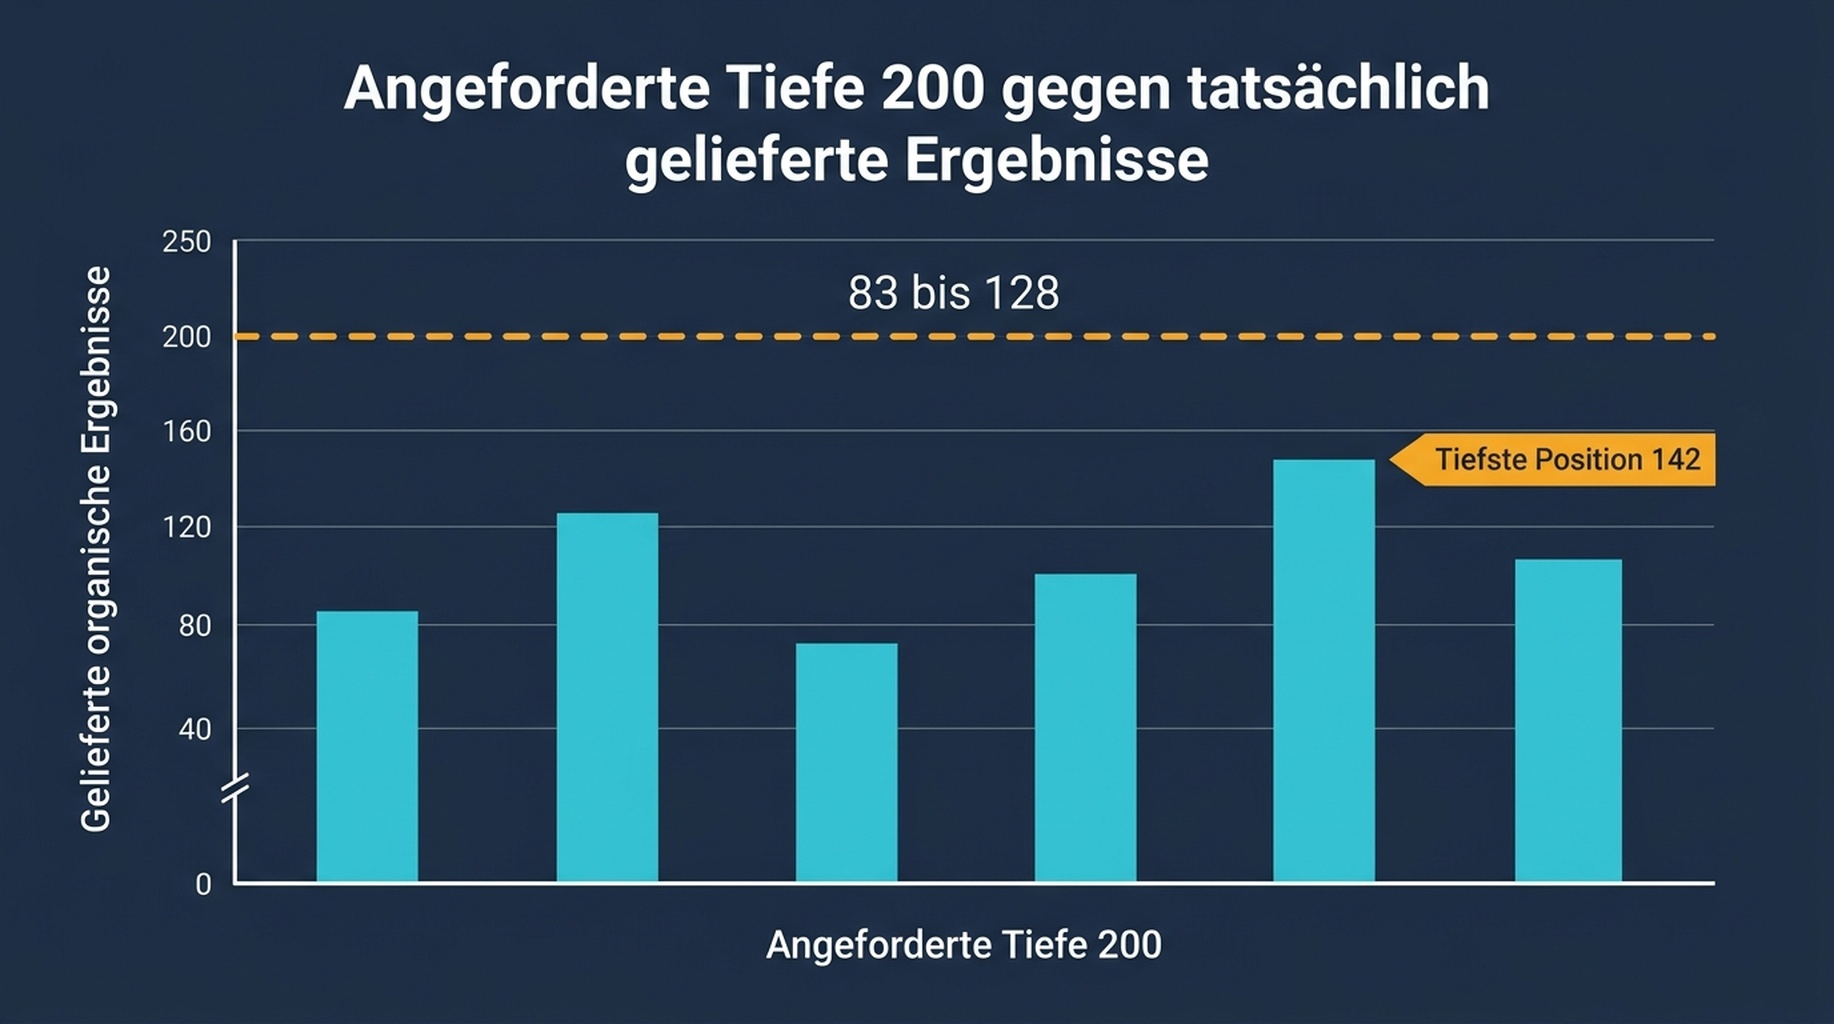
200 Ergebnisse anfragen und 83 bis 128 erhalten. Tiefe über etwa 140 kauft bei den meisten kommerziellen Suchanfragen nichts.
Erwartete Ausgabe: eine JSON-Nutzlast mit organischen Einträgen samt Position, URL, Titel und Domain.
Qualitätsprüfung: prüfen Sie, dass die Nutzlast einen Eintragstyp ai_overview enthält, wenn einer vorhanden ist. Wenn Sie nur organic-Einträge extrahieren, verpassen Sie, warum eine Seite Klicks verloren hat, während sie ihre Position hielt.
Wenn es fehlschlägt: ein 401 ist ein base64- oder Anmeldedatenfehler. Ein Code der Art 40200 bedeutet, dass Ihr Kontoguthaben leer ist — der häufigste Fehlschlag im ersten Monat.
Schritt 4: Speichern Sie die Rohdaten, nicht die Zusammenfassung
Das ist die Entscheidung, deren Auslassung Menschen bereuen.
Eine Tabelle mit Positionen zu speichern funktioniert, bis Sie eine Frage stellen müssen, die Sie nicht vorhergesehen haben: wurde die SERP länger, hat Video übernommen, ist ein Wettbewerber eingetreten, ist ein AI Overview über dem Falz erschienen. Eine Zusammenfassung kann das nicht beantworten. Die Rohdaten können es, zu null Zusatzkosten.
Die praktische Fassung: schreiben Sie eine Datei pro Lauf, benannt nach Datum und Uhrzeit, mit der zusammengeführten Ausgabe. Behalten Sie die letzten 90 Tage. Das ist klein genug für ein Repository und vollständig genug, um alte Fragen erneut zu beantworten.
Schritt 5: Schreiben Sie die Vergleichsregel, bevor Sie irgendetwas planen
Ein Tracker, der den letzten Lauf mit diesem vergleicht, erzeugt an den meisten Tagen Fehlalarm. Unsere eigenen Zahlen zeigen, warum: über 124 Suchanfragen mit mindestens 30 Impressionen bewegte sich die durchschnittliche Anfrage um 4,57 Positionen von einem Tag auf den nächsten. Ein Rückgang um vier Positionen ist ein Dienstag.
Die Regel braucht also eine Schwelle und eine Richtung.
Melde eine Suchanfrage nur, wenn:
  - die absolute Positionsänderung gegenüber dem vorherigen Lauf 5 oder mehr beträgt UND
  - die Suchanfrage mindestens 20 Impressionen im Vergleichsfenster hatte UND
  - die Änderung nicht durch eine Verschiebung des Gerätemixes erklärt wird

Gruppiere die Ausgabe nach Anfrageklasse: money, comparison, brand, informational.
Schlage keine Korrekturen vor.
Die Geräteklausel ist keine Zierde. Dieselbe Suchanfrage kann mobil und auf dem Desktop 11 Positionen auseinanderliegen, und wenn sich der Gerätemix zwischen Läufen verschiebt, verschiebt sich die gemischte Zahl ebenfalls. Wir haben das separat gemessen, und es ist groß genug, um einen Trend vorzutäuschen.
Was es kostet
Anbieterpreise ändern sich, also bauen Sie das Modell, statt einem Angebot nachzujagen.
- Ein Keyword, einmal täglich über 30 Tage geprüft, sind 30 Anfragen pro Monat.
- Ein Set aus 200 Keywords, täglich geprüft, sind 6.000 Anfragen pro Monat.
- Dasselbe Set, wöchentlich geprüft, sind etwa 860 Anfragen pro Monat.
- Die Search-Console-Hälfte ist kostenlos und ist eine Anfrage pro Ansicht, egal wie viele Keywords darin stecken.
Diese Multiplikation ist die ganze Entscheidung. Fast jede Frage nach "sollte ich ein Tool kaufen" fällt darauf zusammen: Anfragen pro Monat ausrechnen, mit Ihrem Preis pro Anfrage multiplizieren und mit der Sitzplatzlizenz vergleichen. Tägliches Tracking eines großen Keyword-Sets ist als Abonnement meist günstiger. Wöchentliches Tracking eines kleinen Sets ist als API meist günstiger. Verfolgen Sie eine eingefrorene Liste, und die API-Seite bleibt klein.
Wann kaufen statt bauen
Bauen Sie das, wenn Sie Positionen in Ihrer eigenen Pipeline wollen, wenn Sie bereits eine SERP-API-Zugangsdaten besitzen oder wenn Sie die rohe Ergebnisseite aus Gründen jenseits der Position brauchen.
Kaufen Sie stattdessen, wenn Sie historische Positionen von vor heute brauchen, wenn Sie zehn Standorte und fünf Geräte für dieselben Keywords brauchen oder wenn niemand im Team einen Cron-Job pflegen wird. Anbieter-Listen sind genau deshalb lesenswert, und es hat echte Kosten, Infrastruktur zu besitzen, die stehenbleibt, wenn die Person, die sie gebaut hat, das Team wechselt.
Wenn die Ausgabe, die Sie wirklich brauchen, ein geschriebener Wochenbericht und keine JSON-Datei ist, startet der Reporting-Workflow in Codex bei denselben zwei Quellen und endet in einem Dokument. Für Alarmierung über der Datei behandelt der Leitfaden zum Monitoring-Design die Schwellen.
Auspia-Sicht: Die Frage nach der Rank-Tracking-API ist eigentlich eine Frage des Datenbesitzes. Die Search Console gibt Ihnen offizielle Daten über Ihre eigene Property kostenlos und wird das immer tun. Alles andere ist eine Momentaufnahme, die Sie bezahlen. Bauen Sie zuerst die kostenlose Hälfte und fügen Sie die bezahlte Hälfte nur dort hinzu, wo sie eine Frage beantwortet, die Sie tatsächlich haben.
Häufige Fragen
Bietet Google eine Rank-Tracking-API an? Keine öffentliche. Die Search Console API gibt Ihre durchschnittliche Position für Suchanfragen zurück, für die Sie bereits erscheinen, was nah dran, aber nicht dasselbe ist. Sie kann kein Keyword prüfen, für das Sie nicht ranken, und sie kann keinen Wettbewerber prüfen.
Wie tief kann eine SERP-API gehen? Anbieter akzeptieren Tiefenwerte weit über 200, aber Google hört bei den meisten kommerziellen Suchanfragen irgendwo zwischen 100 und 140 auf, Ergebnisse auszuliefern. Mehr anzufragen erzeugt nicht mehr Ergebnisse.
Sollte ich täglich oder wöchentlich prüfen? Wöchentlich für ein normales Keyword-Set. Täglich nur für eine kurze Liste von Geld-Keywords. Tägliche Prüfungen eines großen Sets vervielfachen die Kosten mit sieben und messen überwiegend Rauschen, da die durchschnittliche Tagesbewegung in unseren Daten 4,57 Positionen betrug.
Warum weicht meine API-Zahl von meinem Rank Tracker ab? Andere Geräte, andere Standorte, andere Zeitpunkte und oft andere Datenquellen. Die Zahl ist eine Stichprobe. Fixieren Sie Standort und Gerät in Ihrer Anfrage und ziehen Sie erneut, bevor Sie schließen, dass sich etwas geändert hat.
Kann ein Agent das für mich laufen lassen? Ja, und es passt gut, weil die Aufgabe in jedem Lauf dieselbe Form hat. Für das größere Bild, was ein Agent in Ranking-Arbeit übernehmen kann, siehe den Field Guide zum SEO-Agenten. Halten Sie die Vergleichsregel in einer geschriebenen Anweisungsdatei und lassen Sie den Agenten den Diff erzeugen; die Entscheidung bauen-oder-kaufen bleibt bei einem Menschen.
Autor: Rowan Blake, Analyst für Content-Automatisierung für über 100 Publishing-Pipelines bei Auspia. Rowan schreibt über automatisierte Datenpipelines, geplantes Reporting und die Wartungskosten von Systemen, die ohne Sie laufen.