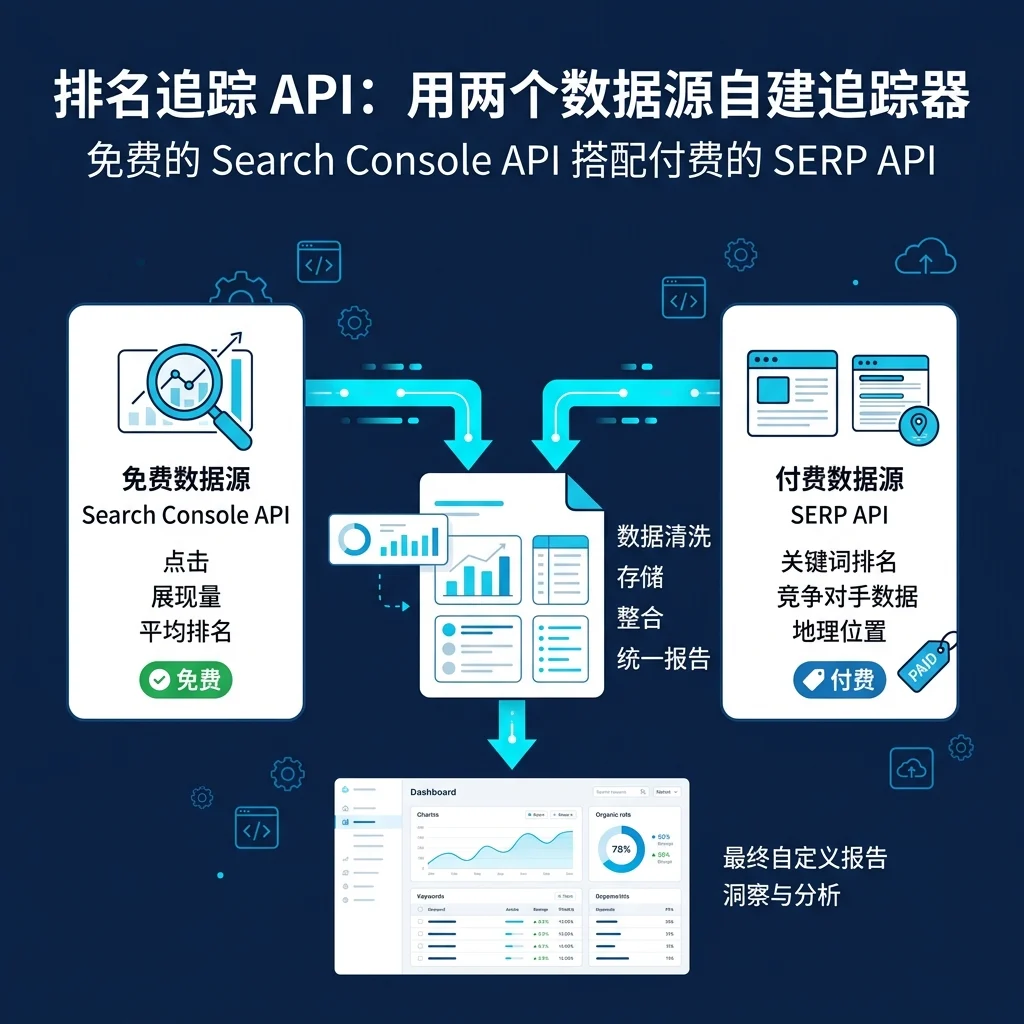
「排名追踪 API」不是一个东西。开发者搜索 “rank tracking API” 时,通常想要一个返回排名的单一端点,而市场用供应商的清单文章来回应。诚实的答案是:你需要两个数据源,它们回答不同的问题。
Search Console API 免费、官方,并且永久限定于你能验证的资源。SERP API 付费、非官方,可以查询任何地方的任何关键词,包括你从未排上过的关键词。两者单独都不是排名追踪器。合在一起,大约就是 120 行 Python 加一条 cron。
这就是那套搭建方案。它假设你能跑脚本、能存文件,不假设你想做一款产品。
完成后你会得到什么
适合谁: 已经拥有 Search Console 权限,想按计划拿到排名、又不想按席位付费的开发者或技术营销人员。
完成时你手上会有什么: 两个能用的拉取函数,每次运行一个合并输出文件,以及一条让数字无法对你说谎的比较规则。
时间: 首次搭建约 90 分钟,之后每次运行约 10 分钟复核。
完成的样子: 一个带日期的 JSON 文件,包含按查询和按设备划分的自有排名、一份冻结关键词列表的实时 SERP 快照,以及与上一次运行的简短差异。
开始之前:每个数据源能做什么、不能做什么
把这个分工做对,剩下的搭建就是机械劳动。做错了,你会花一个月造出要么没用、要么很贵的东西。
Search Console API | SERP API | |
|---|---|---|
谁的排名 | 仅你已验证的资源 | 任何人,包括竞争对手 |
关键词 | 你已经出现过的查询 | 你输入的任何关键词 |
成本 | 免费 | 按请求计费 |
设备拆分 | 有,作为维度 | 有,按请求 |
地区 | 你有排名的国家 | 供应商支持的任何地区 |
数据类型 | 点击、展示、平均排名的汇总 | 某一时刻的结果页 |
历史深度 | 你请求的区间 | 仅从你开始存储那天起 |
官方性 | Google 自己的数据 | 第三方对公开页面的读取 |
两个数据源会互相矛盾,而这种矛盾是信息而不是缺陷。Search Console 对区间内每一次展示、每一台设备取平均。SERP 拉取是某一刻的一个结果页。直接把两者相比,你会去追根本不存在的下跌。所以第 5 步定义了一条比较规则。
写代码前值得知道的三个数字。 Search Console API 每次请求接受 1 到 25,000 的行数上限,默认 1,000,所以一个中型站点可以在一次调用里拉取三个月的查询和设备数据。它允许每站点、每用户每分钟 1,200 次查询。它还按 10 分钟一段来计量负载配额,长区间比短区间更贵——这正是 Google 自己的指南说要避免重复查询同一批数据的原因。
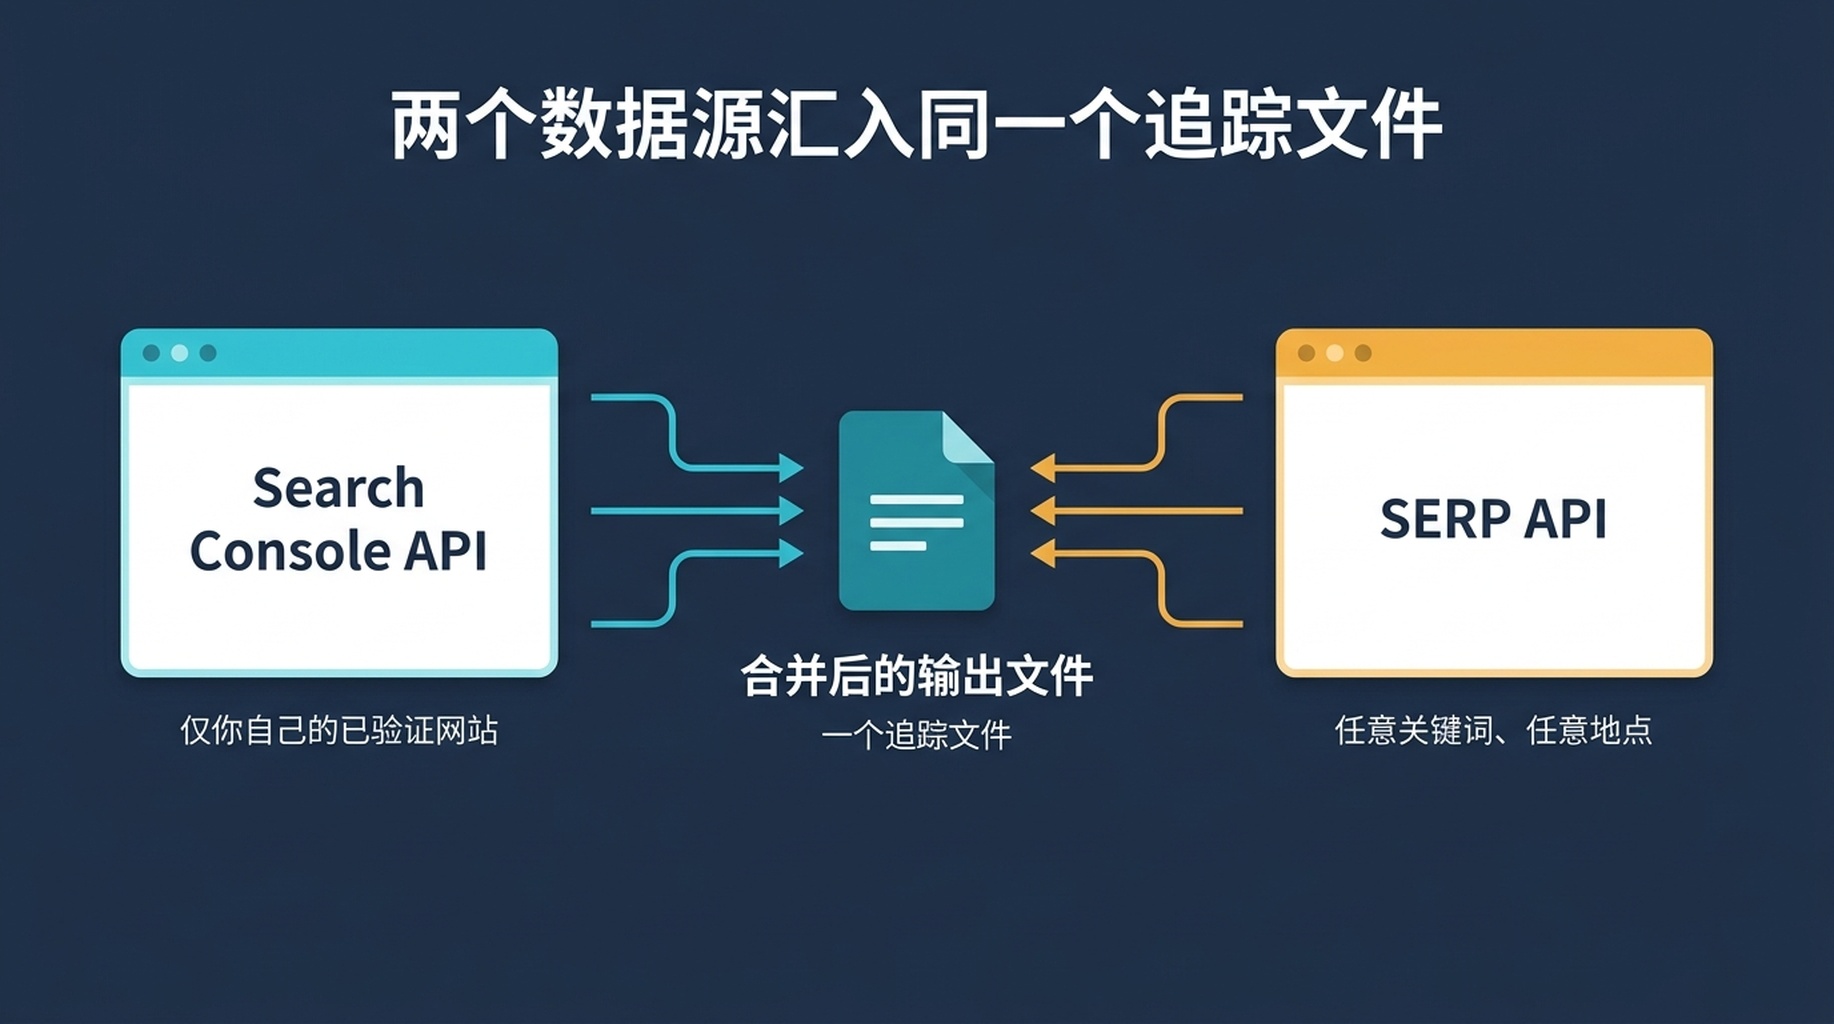
两个数据源,一个输出。Search Console 回答「我出现在哪里」,SERP API 回答「页面长什么样」。
第 1 步:写任何代码之前先冻结关键词集合
一个每次运行都拉取不同关键词列表的追踪器,无法回答是否有任何变化。先把列表定下来,然后保持一个季度。
分三组,来源各不相同。
- 来自 Search Console: 过去 90 天展示量至少 20 的每一个查询。这些不是你选的,是你的展示量选的。这一组的变动才有意义,因为背后已经挂着真实需求。
- 来自业务: 对应收入的 10 到 20 个查询,无论你现在有没有排名。
- 来自竞争对手: 竞争对手排上而你没排上的查询。这些需要 SERP API,因为 Search Console 永远不会展示它们。
把列表写进文件,纳入版本管理,把新增当作一次有意的变更,而不是慢慢漂移。
第 2 步:免费拉取你自己的排名
这一半是官方的、免费的,并且给你任何 SERP API 都没有的设备拆分和点击数据。
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
这个请求里有两个细节承担了大部分工作。
dataState: "final" 排除 Google 可能还会修订的新鲜数据。没有它,最近两三天的数据会在每次运行之间变动,你的差异里就会出现从未发生过的波动。
dimensions: ["query", "device"] 是让输出在日后有用的那一项。现在加上设备不花任何代价。日后再去重拉三个月历史,要花一整次运行,而且对你已经跳过的那些天什么也补不回来。
预期输出: 每个查询与设备的组合一行,含点击、展示、CTR 和平均排名。
质量检查: 行数应低于 25,000。如果正好是 25,000,说明被截断了,需要用 startRow: 25000 再调一次。
如果失败: 403 通常意味着服务账号邮箱从未被添加为该资源的用户。在 Search Console 里加上,等几分钟,重试。
第 3 步:拉取你在自有数据里看不到的 SERP
后半部分覆盖 Search Console 在结构上做不到的一切。这是一个最小可用的调用。
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
把 `depth` 设为 100,不要设 200。 我们在 2026 年 9 月用六个查询请求 200 条来测过这件事。Google 返回了 83 到 128 条自然结果就停止了,整个测试中最深的排名是 142。完整测试在这里。请求 200 并不会拿到 200 条,而且视供应商而定,它可能仍按你请求的深度计费。请求 100,你几乎总能收到存在的全部结果。
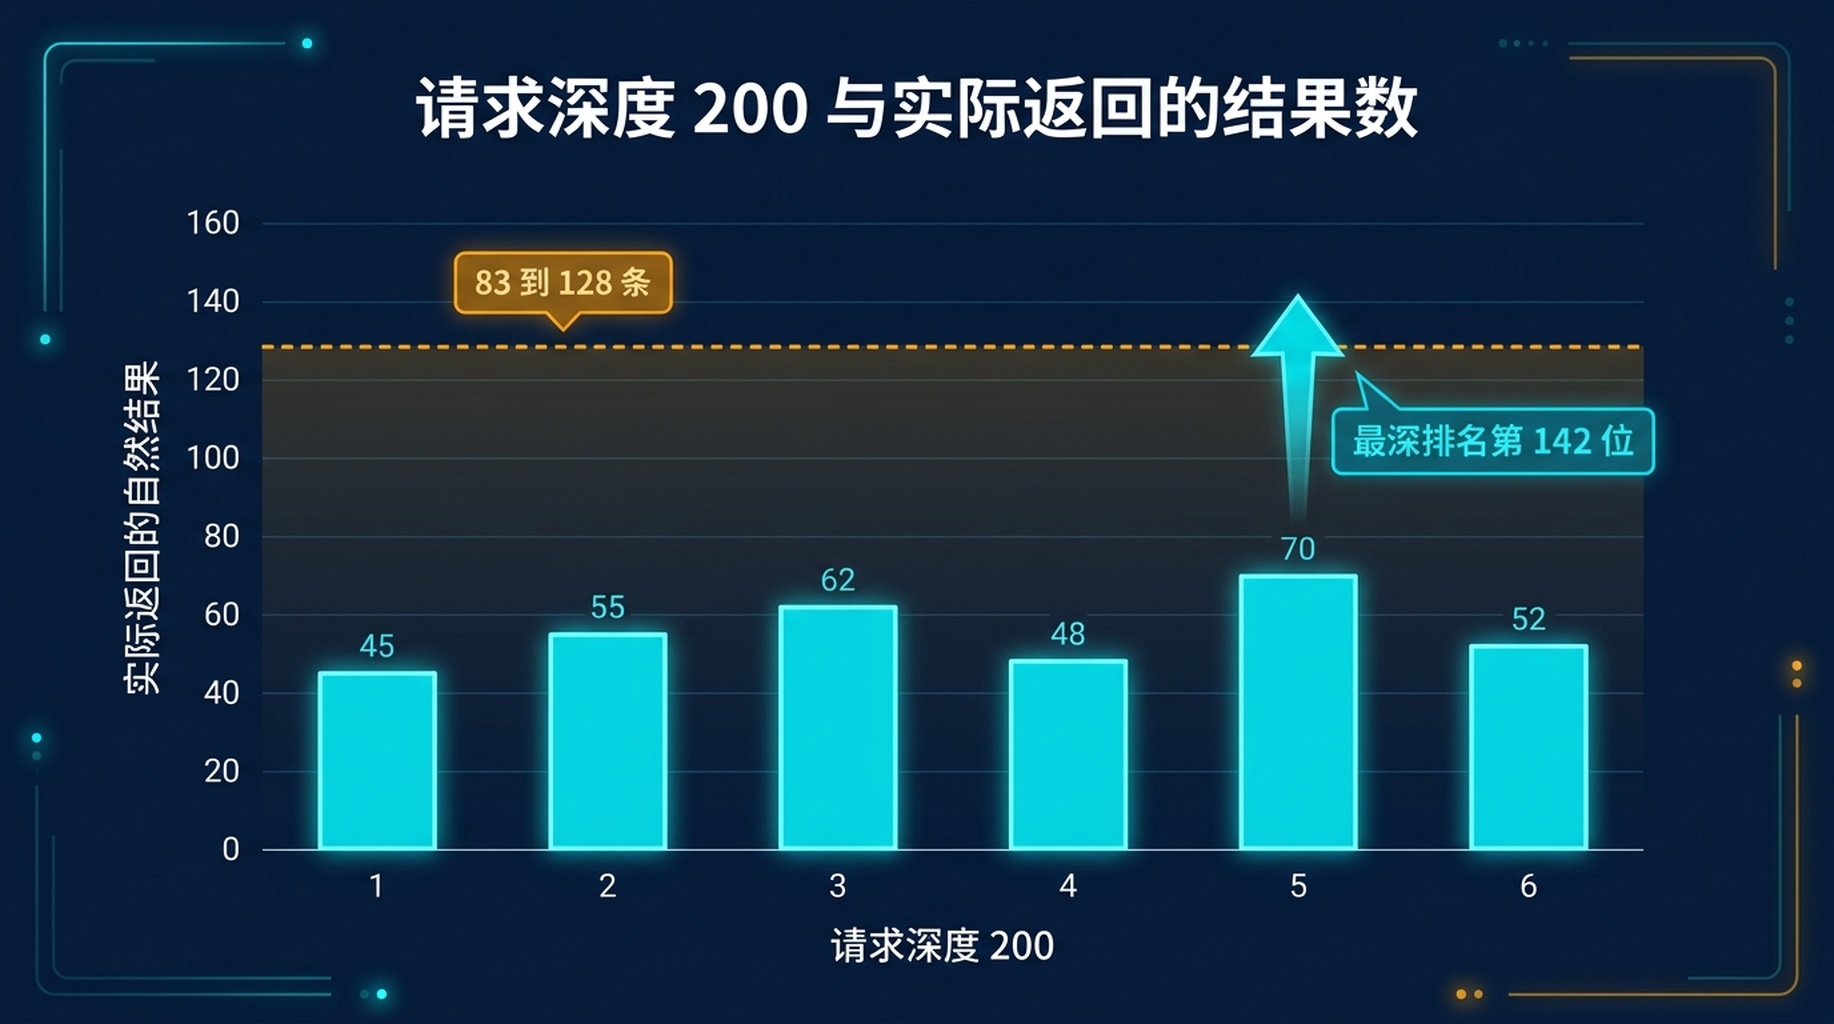
请求 200 条,实际收到 83 到 128 条。在多数商业查询上,超过约 140 的深度买不到任何东西。
预期输出: 一个 JSON 载荷,其中自然结果条目含排名、URL、标题和域名。
质量检查: 确认载荷在存在 AI Overview 时含有 ai_overview 条目类型。如果你只提取 organic 条目,就会漏掉一个页面保住排名却丢掉点击的原因。
如果失败: 401 是 base64 或凭据错误。40200 一类代码表示账户余额为空,这是第一个月最常见的失败。
第 4 步:存原始载荷,而不是摘要
这是人们跳过之后会后悔的决定。
存一张排名表格,直到你需要问一个没预料到的问题时就不够用了:SERP 是不是变长了、视频是不是占了上风、竞争对手是不是进场了、AI Overview 是不是出现在首屏上方。摘要回答不了这些。原始载荷可以,而且零额外成本。
务实版本是:每次运行写一个文件,以日期和时间命名,装上合并后的输出。保留最近 90 天。小到可以放进代码仓库,完整到能重新回答旧问题。
第 5 步:排期之前先写下比较规则
一个把上次运行和这次运行相比的追踪器,大多数日子都会发出误报。我们自己的数字说明了原因:在 124 个展示量至少 30 的查询中,平均每个查询隔一天移动 4.57 个名次。掉四个名次,不过是又一个星期二。
所以规则需要一个阈值和一个方向。
仅在以下条件全部满足时报告某个查询:
  - 与上次运行相比的名次变化绝对值达到 5 或以上,并且
  - 该查询在比较窗口内展示量至少 20,并且
  - 该变化无法由设备构成的变化解释

按查询类别分组输出:money、comparison、brand、informational。
不要提出修复建议。
设备那一条不是装饰。同一个查询在移动端和桌面端可以相差 11 个名次,如果两次运行之间设备构成发生变化,混合后的数字也会变。我们另外测过这件事,幅度大到足以伪造出一种趋势。
成本
供应商价格会变,所以建模,别追报价。
- 一个关键词每天查一次、查 30 天,是每月 30 次请求。
- 200 个关键词的集合每天查,是每月 6,000 次请求。
- 同一个集合每周查,是每月约 860 次请求。
- Search Console 那一半是免费的,无论里面装多少个关键词,每次视图都是一次请求。
这个乘法就是整个决策。「我该不该买个工具」几乎总能坍缩成它:算出每月请求数,乘以你的单次请求价格,再和席位授权比一比。大关键词集合每天追踪,通常订阅更便宜。小集合每周追踪,通常 API 更便宜。追踪一份冻结的列表,API 这一侧就会一直很小。
什么时候该买而不是自己搭
如果你想把排名放进自己的管道、已经持有 SERP API 凭据,或者出于排名之外的 reasons 需要原始结果页,那就自己搭。
如果你需要今天之前的历史排名、需要同一批关键词的十个地区和五种设备,或者团队里没人愿意维护一个 cron 任务,那就买。供应商的清单文章正是因为这个原因值得一读,而拥有一套「搭它的人换团队后就停摆」的基础设施,是有真实成本的。
如果你真正需要的输出是一份写好的周报而不是 JSON 文件,Codex 报表工作流从同样的两个数据源出发,最终落到一份文档。要在文件之上做告警,监控设计指南讲了阈值。
Auspia 观点:排名追踪 API 这个问题,本质上是数据所有权问题。Search Console 免费给你自有资源的官方数据,而且永远会给。其余一切都是你付费买来的快照。先把免费的一半搭起来,付费的一半只加在它确实回答了你真实问题的地方。
常见问题
Google 提供排名追踪 API 吗? 没有公开的。Search Console API 返回你已经出现过的查询的平均排名,接近但不是同一回事。它查不了你没有排名的关键词,也查不了竞争对手。
SERP API 能挖多深? 供应商会接受远高于 200 的深度值,但 Google 在多数商业查询上大约到 100 至 140 之间就不再提供结果。要求更多并不会产生更多结果。
我该用每日还是每周检查? 普通关键词集合用每周。每日只用于一小串收入关键词。对大集合做每日检查会把成本乘以七,而且大多是在测量噪声,因为我们自己数据里的日均移动是 4.57 个名次。
为什么我的 API 数字和我的排名工具不一样? 设备不同、地区不同、时刻不同,数据源往往也不同。那个数字是个样本。在得出任何变化结论之前,先把请求里的地区和设备固定下来重拉一次。
智能体能替我做这件事吗? 能,而且很合适,因为这项任务每次运行的形状都一样。关于智能体在排名工作中能承担的范围,见 SEO 智能体实战指南。把比较规则写进一份指令文件,让智能体产出差异,而买还是搭的决定留给人。
作者:Rowan Blake,Auspia 内容自动化分析师,负责 100 多条发布管道。Rowan 撰写关于自动化数据管道、定时报表,以及在你不在时仍自行运转的系统的维护成本。