กฎที่ Google เพิ่งเขียนลงไป
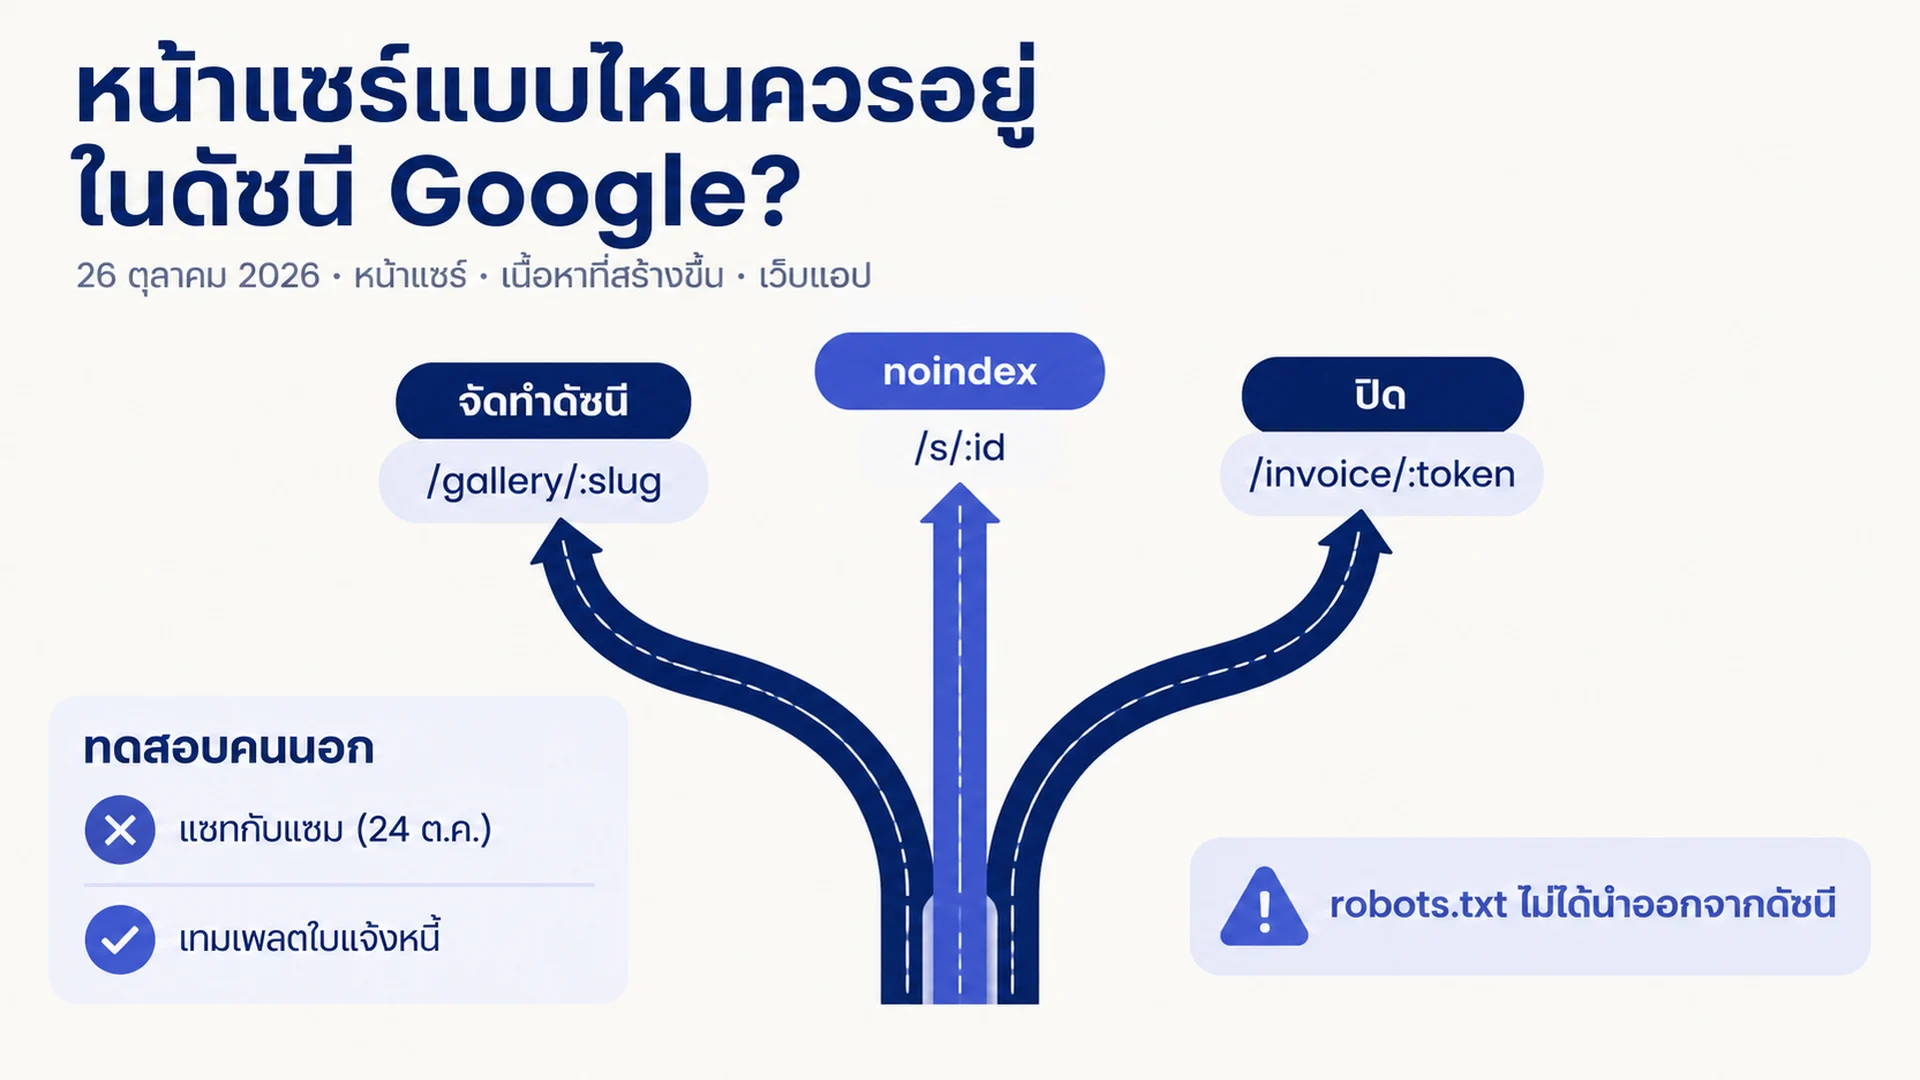
เมื่อวันที่ 26 ตุลาคม 2026 Google ได้เพิ่มหัวข้อความยาวสองย่อหน้าลงในคู่มือการป้องกันสแปมที่ผู้ใช้สร้างขึ้น นี่คือส่วนที่สั้นที่สุดของหน้า และน่าจะเป็นส่วนที่จะเปลี่ยนโรดแมปผลิตภัณฑ์มากที่สุด เพราะมันถามคำถามที่ทีมส่วนใหญ่ไม่เคยเอาไปขึ้นสไลด์ นั่นคือ URL นี้ควรอยู่ในดัชนีของ Google หรือไม่
หัวข้อนี้ชื่อ "Only index content meant for Search" หรือจัดทำดัชนีเฉพาะเนื้อหาที่มีไว้สำหรับการค้นหา เนื้อหาเต็มมีดังนี้
หากบริการของคุณให้ผู้ใช้สร้างหน้าที่แชร์ได้ ผลลัพธ์ที่สร้างขึ้น หรือเครื่องมือแบบโต้ตอบ โปรดพิจารณาว่าเนื้อหาเหล่านั้นมีไว้ให้ค้นพบผ่านเสิร์ชเอนจิน หรือมีไว้ให้เฉพาะคนที่มีลิงก์เข้าถึงโดยตรง
เมื่อหน้าเหล่านั้นถูกสร้างขึ้นเพื่อการแชร์โดยตรง การทำงานร่วมกัน หรือประโยชน์ใช้สอย มากกว่าการให้ค้นพบในผลการค้นหาสาธารณะ ให้ใช้กฎ noindex (ผ่านแท็ก meta robots หรือเฮดเดอร์ HTTP ชื่อ X-Robots-Tag) หรือบล็อกการรวบรวมข้อมูลใน robots.txt โดยค่าเริ่มต้น
บันทึกการเปลี่ยนแปลงของ Google ในวันเดียวกันระบุเจตนาได้ตรงกว่าเดิม คือคู่มือได้รับการอัปเดตด้วย "คำแนะนำเรื่องการบล็อกการจัดทำดัชนีเนื้อหาที่แชร์ผ่านลิงก์ และการเฝ้าระวังการใช้งานในทางที่ผิดใน Search Console" เพื่อให้แพลตฟอร์ม "กันหน้าที่ผู้ใช้สร้างซึ่งไม่ได้มีไว้สำหรับการค้นหาออกจากดัชนี และตรวจจับสแปมได้เร็วขึ้น"
แค่นั้น ไม่มีการประกาศมาตรการลงโทษแบบmanual ใหม่ ไม่มีการประกาศระบบจัดอันดับ และไม่มีรายการบทลงโทษ สิ่งที่ถูกแนะนำคือ "ค่าเริ่มต้น" และอุบัติเหตุด้านดัชนีส่วนใหญ่ก็มาจากค่าเริ่มต้นนี่เอง
บทความนี้เหมาะกับใคร ทีมที่ปล่อย URL ใดก็ตามที่ผู้ใช้สร้างได้ ทั้งลิงก์แชร์ แชทที่บันทึกไว้ แดชบอร์ดสาธารณะ ตัวอย่างเทมเพลต แอปที่ builล์เสร็จ รายงานที่สร้างขึ้น กระทู้ฟอรัม หน้าโปรไฟล์ หน้ารีวิว และหน้าประกาศ
สิ่งที่คุณจะได้เมื่ออ่านจบ คำตัดสินระดับเส้นทางสำหรับ URL ที่สร้างขึ้นแต่ละประเภท วิธีควบคุมที่นำออกจากดัชนีได้จริง และกฎการเฝ้าระวังที่จับรูปแบบการใช้งานในทางที่ผิดที่ Google อธิบายไว้
เวลา 45 ถึง 90 นาทีสำหรับการสำรวจรอบแรกในผลิตภัณฑ์เดียว ทั้งวันหากมีตัวสร้าง URL หลายตัวและยังไม่มีรายการเส้นทาง
นิยามของคำว่าเสร็จ ทุกเส้นทางที่สร้างขึ้นถูกกำกับว่า index, noindex หรือ private เส้นทาง noindex ส่งคำสั่งจากฝั่งเซิร์ฟเวอร์ ไม่ใช่หลัง JavaScript ทำงาน และ Search Console แสดง URL เหล่านั้นว่า "ถูกตัดออกด้วยแท็ก noindex" ไม่ใช่ "จัดทำดัชนีแล้ว แต่ถูกบล็อกโดย robots.txt"
อะไรเปลี่ยนไป และอะไรแค่ดูเหมือนใหม่
การแก้ไขที่มีนัยสำคัญมีสี่จุด ส่วนอื่นของหน้าไม่ได้เปลี่ยน รวมถึงคำแนะนำจากธันวาคม 2025 ที่ยังใช้ได้
สิ่งที่ Google เปลี่ยน | ข้อความจริง | ทำไมถึงสำคัญกับคุณ |
|---|---|---|
ขอบเขตของคู่มือ | ระบุชื่อ "แพลตฟอร์มโฮสติ้งและเครื่องมือที่ให้ผู้ใช้เผยแพร่หน้าที่แชร์ได้ เนื้อหาที่สร้างขึ้น หรือเว็บแอป" | อ่านตามตัวอักษรแล้ว ครอบคลุมการส่งออกแชท AI หน้า artifact ตัวสร้างแอป และเครื่องมือ no-code ไม่ใช่แค่ฟอรัมกับช่องคอมเมนต์ |
หน่วยของการใช้ในทางที่ผิด | ผู้ส่งสแปมอาจสร้าง "หน้าหรือไซต์จำนวนมาก" | Google พูดถึงปริมาณ ไม่ใช่ความแนบเนียน บัญชีที่ละเมิดหนึ่งบัญชีสามารถผลิต URL ได้หลายพัน |
หัวข้อใหม่ | "Only index content meant for Search" | ถ้อยแถลงที่ชัดที่สุดเท่าที่มีมาว่า noindex เป็นค่าเริ่มต้นที่สมเหตุสมผลสำหรับเนื้อหาที่เข้าถึงด้วยลิงก์เท่านั้น |
การเฝ้าระวัง | ยืนยันไซต์หรือซับโดเมนใน Search Console จับตาการพุ่งของรายงานการจัดทำดัชนีหน้าและประสิทธิภาพการค้นหา แจ้งเตือนเมื่อ "ผู้ใช้จำนวนน้อย" สร้าง "สัดส่วนมากของ URL ที่จัดทำดัชนีได้" | การบวมของดัชนีมีวิธีตรวจจับที่ถูกเรียกชื่อแล้ว และปกติเมื่อมีชื่อก็มักตามมาด้วยกระบวนการตรวจสอบ |
ส่วนที่ไม่ได้เปลี่ยน คือ noindex สำหรับโพสต์ของผู้ใช้ใหม่จนกว่าจะสร้างชื่อเสียงได้ และ nofollow หรือ ugc สำหรับลิงก์ในเนื้อหาที่ไม่น่าเชื่อถือ หากคุณทำทั้งสองอย่างอยู่แล้ว คุณนำหน้าการอัปเดตนี้อยู่แล้ว
ขอพูดตรง ๆ เพราะปฏิกิริยาบน X วิ่งนำเอกสารไปแล้ว นี่คือคำแนะนำสำหรับแพลตฟอร์มเกี่ยวกับปริมาณ URL ของตัวเอง ไม่ได้สร้างการละเมิดใหม่ให้กับเว็บไซต์การตลาดทั่วไป และไม่ได้เปลี่ยนอันดับของหน้าใด ๆ สิ่งที่เปลี่ยนคืออะไรควรมีอยู่ในดัชนี
บริบทอีกชิ้นอธิบายจังหวะเวลาได้ เมื่อปลายเดือนกรกฎาคม 2026 ลิงก์แชร์และหน้า artifact ของ Claude ปรากฏในดัชนี Google และรายงานข่าวขณะนั้นระบุถึงเวชระเบียน คีย์ API และข้อมูลส่วนตัวอื่น ๆ ที่ถูกเปิดเผยก่อน Anthropic จะปิดช่องโหว่ภายในไม่กี่วัน รายงานเดียวกันชี้ไปที่ URL แอปสาธารณะบนตัวสร้างอย่าง Replit และ Lovable Google แทบไม่เขียนหัวข้อใหม่สำหรับเรื่องสมมติ หัวข้อนี้เขียนถึงเรื่องที่เกิดขึ้นแล้ว
คำถามที่ตัดสินทุก URL ที่สร้างขึ้น
แบบทดสอบของ Google เขียนไว้ประโยคเดียว และนำไปใช้ได้โดยไม่ต้องเดาเจตนา เนื้อหานี้มีไว้ให้ค้นพบผ่านเสิร์ชเอนจิน หรือมีไว้ให้เฉพาะคนที่ถือลิงก์เข้าถึง
ในทางปฏิบัติมีสี่สัญญาณที่ตอบคำถามนี้ ให้คะแนนที่เส้นทาง ไม่ใช่ที่หน้าแต่ละหน้า
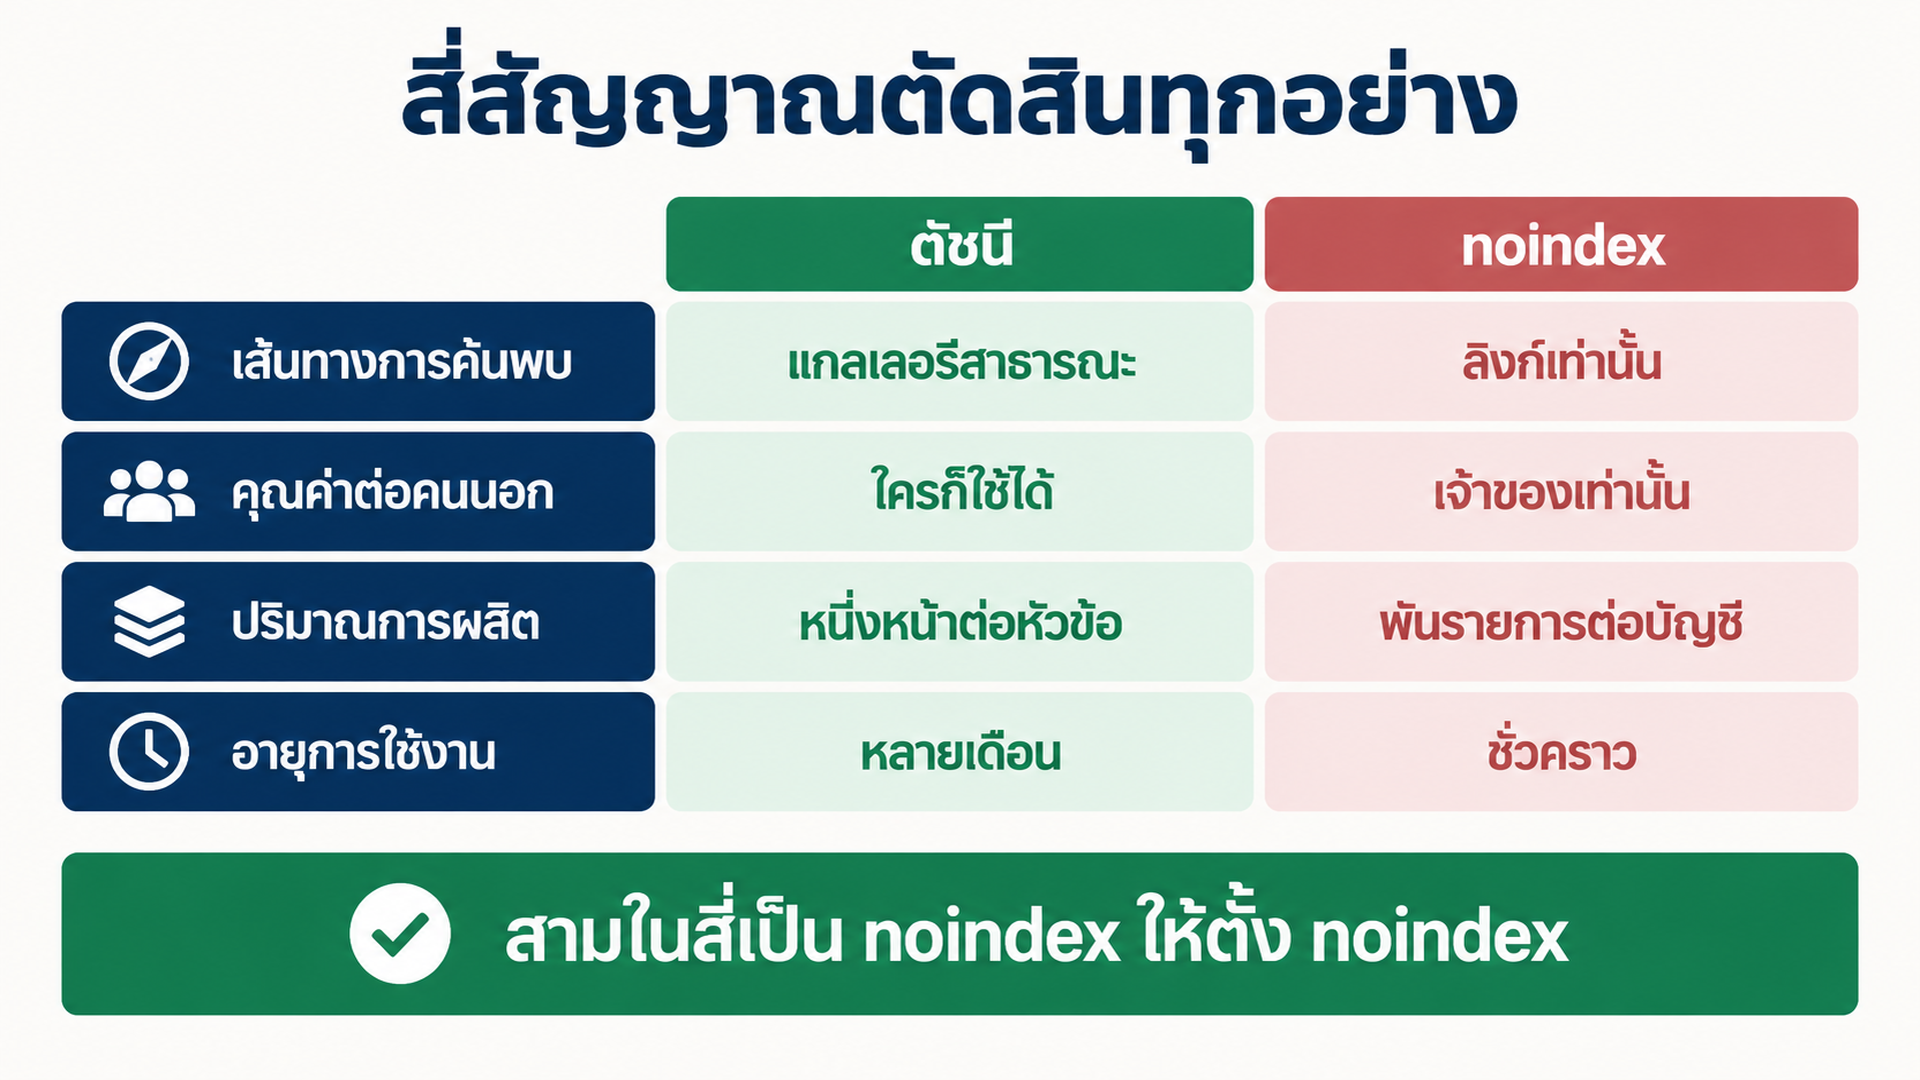
สัญญาณ | เอนไปทางจัดทำดัชนี | เอนไปทาง noindex |
|---|---|---|
เส้นทางการค้นพบ | มีลิงก์จากแกลเลอรีสาธารณะ sitemap หน้าหมวดหมู่ หรือโปรไฟล์ | เข้าถึงได้จากลิงก์ที่คัดลอกมาหรือปุ่มแชร์เท่านั้น |
คุณค่าต่อคนนอก | มีประโยชน์โดยไม่ต้องรู้จักคนที่สร้าง | มีความหมายเฉพาะกับผู้สร้าง ทีมของเขา หรือผู้รับ |
ปริมาณการผลิต | หนึ่งหน้าต่อหัวข้อ หรือชุดที่คัดสรร | URL หลายพันจากบัญชีเดียว ส่วนใหญ่ซ้ำกันเกือบทั้งหมด |
อายุการใช้งาน | ยังถูกต้องเป็นเวลาหลายเดือน | ชั่วคราว แชท การ builล์ ฉบับร่าง หรือการส่งออกชั่วคราว |
ถ้าสามในสี่ชี้ไปที่ noindex ก็ชัดเจน ผลที่ก้ำกึ่งมักหมายความว่าเส้นทางนั้นต้องถูกแยก เป็นแกลเลอรีสาธารณะที่จัดทำดัชนีได้ บวกกับผลลัพธ์แต่ละชิ้นที่จัดทำดัชนีไม่ได้ การแยกนี้คือคำตอบที่ถูกต้องซึ่งพบบ่อยที่สุด และเป็นคำตอบที่ทีมส่วนใหญ่ข้ามไป เพราะต้องใช้เทมเพลตสองชุดแทนที่จะเป็นแฟล็กเดียว
มีแบบทดสอบการปฏิเสธที่ใช้ได้จริง คือถ้าคนนอกเห็น URL นี้ในผลการค้นหาโดยไม่มีบริบทใด ๆ ชื่อเรื่องและสั้นเซ็ปต์จะยังเข้าใจได้ไหม "แชทกับแซม 24 ต.ค." ตกเกณฑ์ "เทมเพลตใบแจ้งหนี้สำหรับนักออกแบบอิสระ" ผ่านเกณฑ์ การตกเกณฑ์ไม่เกี่ยวกับคุณภาพ แต่เกี่ยวกับว่าหน้านั้นถูกสร้างมาให้ถูกค้นพบ หรือให้ถูกส่งต่อ
เลือกวิธีควบคุมที่นำ URL ออกได้จริง
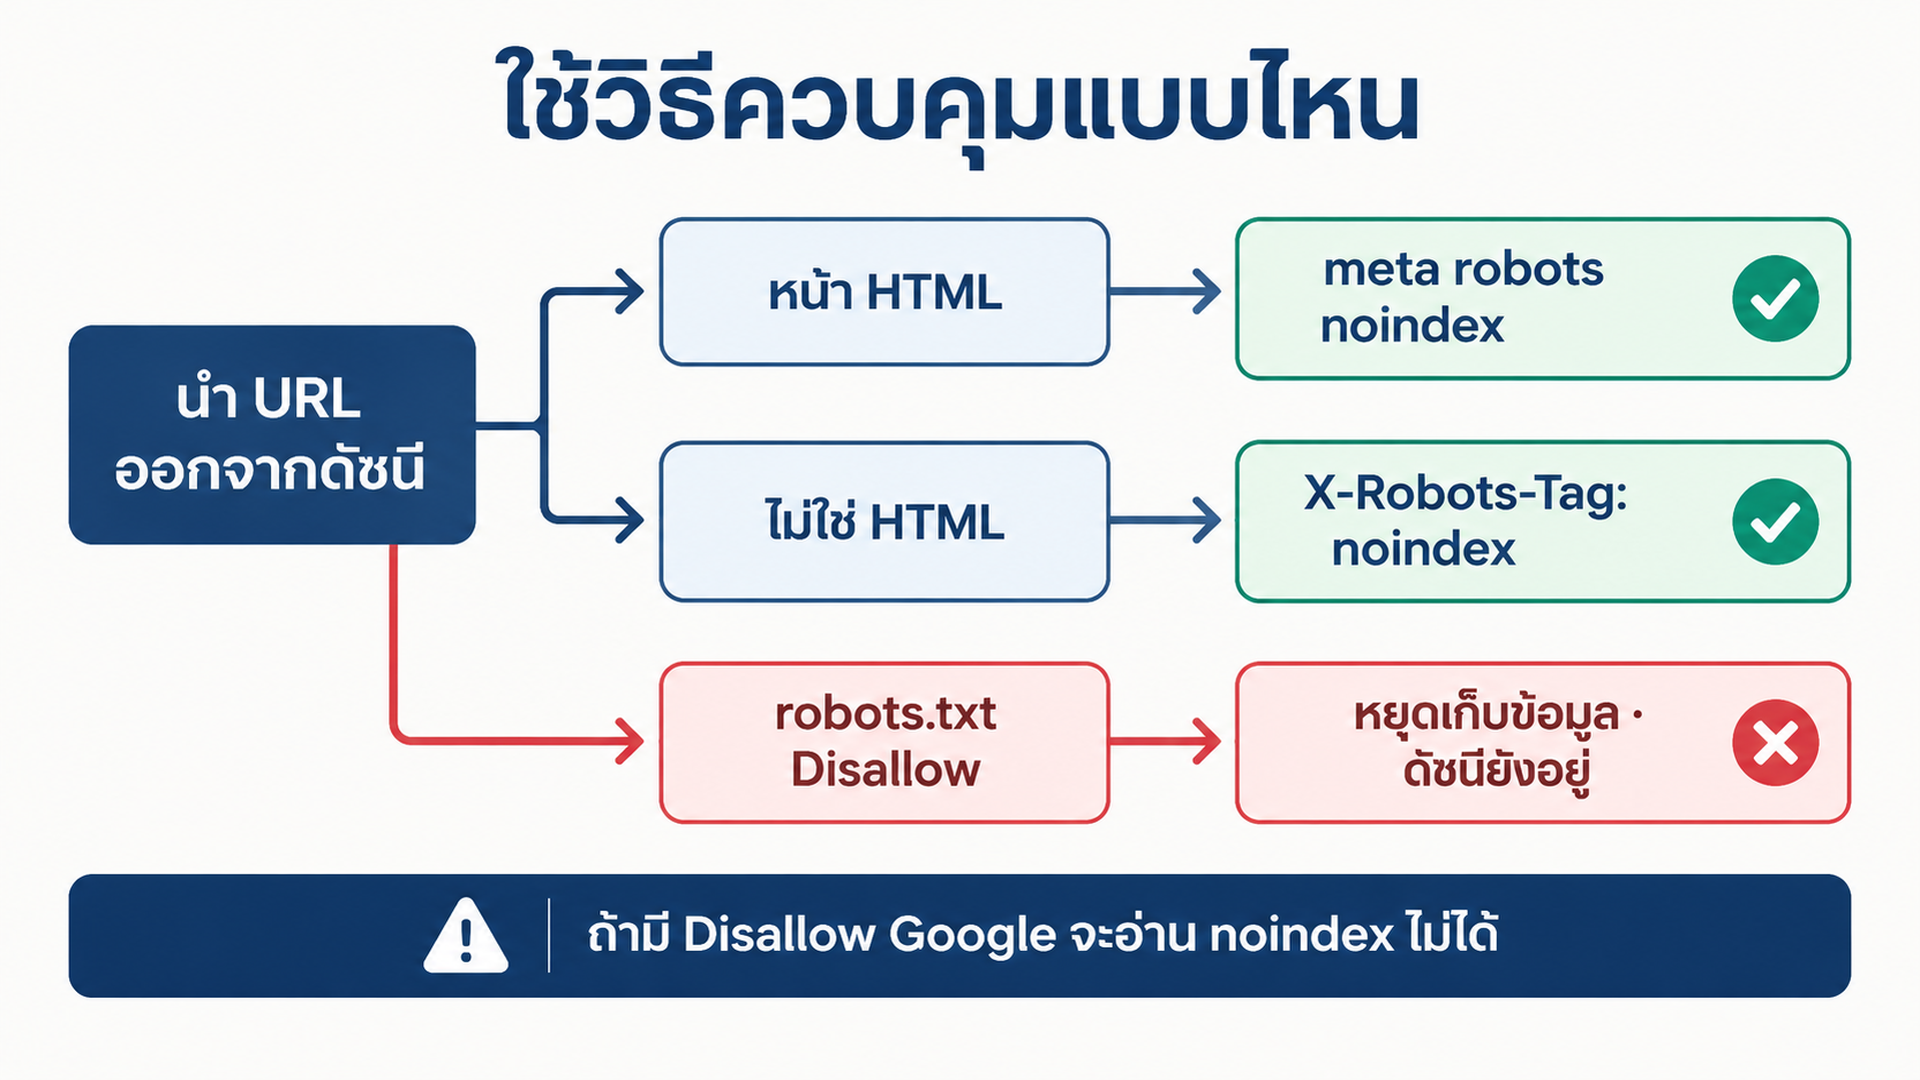
นี่คือจุดที่ทำตามคำแนะนำใหม่อย่างเคร่งครัดแล้วยังล้มเหลวได้ Google เสนอสองทางเลือกในประโยคเดียวกัน และสองทางนั้นไม่เท่ากัน
robots.txt ควบคุมการรวบรวมข้อมูล ไม่ได้นำ URL ออกจากดัชนี และ Google เองก็บอกไว้ในบทนำของ robots.txt ว่าหน้าที่ถูก Disallow ไว้ "ยังถูกจัดทำดัชนีได้หากมีลิงก์จากไซต์อื่นมาหา" ซึ่งในกรณีนั้น URL และข้อความแองเคอร์ที่ชี้มาอาจปรากฏในผลการค้นหาโดยไม่มีคำอธิบาย
noindex ควบคุมการจัดทำดัชนี แต่ต้องให้ Google ดึงหน้าได้และอ่านคำสั่งได้ เอกสาร noindex ของ Google ระบุชัดว่า กฎจะทำงานได้ หน้าต้องไม่ถูกบล็อกด้วย robots.txt มิฉะนั้น "ตัวรวบรวมข้อมูลจะไม่เห็นกฎ noindex เลย"
เมื่อรวมสองข้อนี้เข้าด้วยกัน ลำดับจึงสำคัญ
วิธีควบคุม | นำ URL ออกจากดัชนีได้ไหม | ล้มเหลวตรงไหน | ใช้กับอะไร |
|---|---|---|---|
เฮดเดอร์ตอบกลับ | ได้ หลังจาก Google รวบรวมข้อมูลและอ่านแล้ว | สิ่งที่ถูกบล็อกด้วย robots.txt หรืออยู่หลังการล็อกอิน | การตอบกลับที่ไม่ใช่ HTML (PDF, JSON, รูปภาพ) และกฎระดับ edge หรือ CDN ที่ครอบหลายเส้นทาง |
| ได้ หลังจาก Google รวบรวมข้อมูลและอ่านแล้ว | แท็กที่ JavaScript ใส่เข้ามาหลังโหลด; หน้าที่ถูกบล็อกด้วย robots.txt | หน้าที่แชร์แบบ HTML ที่เรนเดอร์จากฝั่งเซิร์ฟเวอร์ |
Disallow ใน | ไม่ได้ | URL ที่มีลิงก์มาหาอาจอยู่ในดัชนีโดยไม่มีสั้นเซ็ปต์ | ลดภาระการรวบรวมข้อมูล ไม่ใช่ปกป้องความเป็นส่วนตัว |
การล็อกอินหรือ URL ที่ลงนาม | ได้ โดยการกันการเข้าถึง | ต้องให้หน้าเป็นส่วนตัวจริง ๆ | ทุกอย่างที่มีข้อมูลของคนอื่น |
410 หลังหมดอายุ | ได้ เมื่อเวลาผ่านไป | ช้ากว่า 404 และไม่ทำอะไรเลยระหว่างที่ URL ยังเข้าถึงได้ | การแชร์และการ builล์ชั่วคราว |
ทางลัดที่ควรหลีกเลี่ยงข้อแรก X-Robots-Tag: none ไม่ใช่ค่าที่เป็นกลาง Google ตีความว่าเป็น noindex บวก nofollow บางครั้งก็เป็นสิ่งที่คุณต้องการจริง ๆ แต่ทีมมักคัดลอกมาจากคอนฟิกพร็อกซีโดยไม่รู้เรื่องนี้
ทางลัดที่ควรหลีกเลี่ยงข้อสอง แท็ก canonical canonical เป็นเพียงคำใบ้ หากหน้านั้นไม่ควรอยู่ในดัชนี ให้เขียน noindex
ขั้นที่ 1 ทำบัญชีเส้นทางที่ผลิต URL
คุณจำแนกสิ่งที่ยังไม่ได้ระบุรายการไม่ได้ และทีมส่วนใหญ่ประเมินจำนวนต่ำไปเพราะคิดเป็นฟีเจอร์ ไม่ใช่รูปแบบเส้นทาง
เปิดเราเตอร์หรือแผนที่ URL แล้วระบุทุกส่วนที่เปลี่ยนแปลงได้ รายการที่มักเป็นปัญหามีดังนี้:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
จากนั้นตรวจสอบกับสิ่งที่ Google รู้อยู่แล้ว เพราะโค้ดกับดัชนีจะไม่ตรงกัน
จาก sitemap ดึงมาแล้วนับ:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
คำสั่งที่สองให้ฮิสโตแกรมคร่าว ๆ ของคำนำหน้าเส้นทาง หากเส้นทางที่สร้างขึ้นปรากฏใน sitemap นั่นคือบั๊กในตัวเอง เพราะ sitemap คือรายการหน้าที่คุณขอให้ Google จัดทำดัชนี
จาก Search Console เปิดรายงานการจัดทำดัชนีหน้า กรองตามคำนำหน้า URL ของแต่ละเส้นทางที่สงสัย แล้วบันทึกจำนวน นี่คือแหล่งเดียวที่บอกคุณว่า Google ทำอะไรกับ URL เหล่านั้นจริง ๆ
จากล็อกเซิร์ฟเวอร์ จัดกลุ่มคำขอของ Googlebot ตามคำนำหน้า:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20ผลลัพธ์ที่คาดหวัง รายการรูปแบบเส้นทางพร้อมจำนวน URL ข้าง ๆ แต่ละเส้นทาง จากอย่างน้อยสองแหล่ง
การตรวจคุณภาพ ทุกเส้นทางที่ตอบ 200 ให้ผู้เยี่ยมชมที่ไม่ใช่พนักงานได้ ต้องอยู่ในรายการ หากจำนวนใน sitemap กับใน Search Console ต่างกันเกินสองสามเปอร์เซ็นต์ในคำนำหน้าเดียวกัน ให้หาสาเหตุก่อนที่จะแก้อะไร
ถ้าไม่พบอะไรเลย คุณน่าจะใช้เราเตอร์ฝั่งไคลเอนต์ ให้ค้นหานิยามเส้นทางในฟรอนต์เอนด์แทนแบ็กเอนด์ และดูแท็บเครือข่ายบนลิงก์แชร์จริง
ขั้นที่ 2 จำแนกแต่ละเส้นทางในตาราง ไม่ใช่ในที่ประชุม
เขียนคำตัดสินไว้ในที่ที่ตรวจทานได้ หนึ่งแถวต่อรูปแบบเส้นทางก็พอ
เส้นทาง | ใครสร้าง | เส้นทางการค้นพบ | คุณค่าต่อคนนอก | คำตัดสิน | วิธีควบคุม | เจ้าของ |
|---|---|---|---|---|---|---|
| ผู้ใช้ทุกคน | ลิงก์เท่านั้น | ไม่มี | noindex | เฮดเดอร์ | แพลตฟอร์ม |
| คัดสรร | ลิงก์ภายใน, sitemap | สูง | index | ไม่มี | เนื้อหา |
| ผู้ใช้ทุกคน | ลิงก์จากโปรไฟล์ | ต่ำจนกว่าจะ active | noindex จนกว่าจะมีชื่อเสียง | meta | ความน่าเชื่อถือและความปลอดภัย |
| ผู้ใช้ทุกคน | ลิงก์เท่านั้น | ไม่มี | noindex | เฮดเดอร์ | แพลตฟอร์ม |
| บรรณาธิการ | sitemap | สูง | index | ไม่มี | เนื้อหา |
ตารางนี้ใช้ได้ก็ต่อเมื่อสามข้อนี้เป็นจริง
กำหนดเจ้าของหนึ่งคนต่อหนึ่งแถว ความเป็นเจ้าของที่คลุมเครือคือเหตุผลที่เส้นทางที่สร้างขึ้นยังถูกจัดทำดัชนีได้เป็นปี ๆ
เขียนวิธีควบคุมข้างคำตัดสิน ไม่ใช่ค่อยมาเขียนทีหลัง "noindex" ไม่ใช่การตัดสินใจจนกว่าจะมีคนรู้ว่ามันหมายถึงเฮดเดอร์ การแก้เทมเพลต หรือกฎ CDN
บันทึกข้อยกเว้น หากเส้นทางเป็น noindex แต่มีส่วนเล็ก ๆ ที่ควรเปิดสาธารณะ ให้เขียนเงื่อนไขของส่วนนั้นลงไปตอนนี้ การมาเติมข้อยกเว้นทีหลังในอีกหกเดือนคือเส้นทางที่กฎ noindex ถูกถอดออกทั้งดุ้นอย่างเงียบ ๆ
ขั้นที่ 3 ปล่อยวิธีควบคุมที่ระดับเทมเพลต
การแก้ทีละหน้าอยู่ไม่รอดถึงการ deploy ครั้งถัดไป ให้ใช้วิธีควบคุมตรงจุดที่เส้นทางถูกเรนเดอร์
สำหรับหน้า HTML ใส่แท็กใน head ที่เรนเดอร์จากฝั่งเซิร์ฟเวอร์ ใน Next.js App Router นี่คือ metadata ใน Astro คือ head ของ layout ใน Rails หรือ Django คือเทมเพลต layout ไวยากรณ์ที่แน่นอนสำคัญน้อยกว่าตำแหน่ง มันต้องอยู่ใน HTML ที่ Google ได้รับ ไม่ใช่ถูกเพิ่มด้วย effect ฝั่งไคลเอนต์
<meta name="robots" content="noindex">สำหรับสิ่งที่ไม่ใช่ HTML ไม่มีแท็ก meta จึงต้องใช้เฮดเดอร์
X-Robots-Tag: noindexครอบคลุมการส่งออก PDF การตอบกลับ JSON รูปภาพที่สร้างขึ้น และการดาวน์โหลด CSV หากไฟล์เหล่านั้นให้บริการผ่าน CDN ให้ตั้งเฮดเดอร์ที่ edge เพื่อให้เส้นทางใหม่รับไปด้วย
สำหรับทั้งกลุ่มเส้นทาง กฎในมิดเดิลแวร์มักสะอาดกว่าการแตะทุกเทมเพลต
// ตัวอย่าง Express: ตั้ง noindex ให้ทุก URL แชร์ที่สร้างขึ้น
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
ผลลัพธ์ที่คาดหวัง การ deploy ที่ทุกเส้นทางซึ่งกำกับว่า noindex ส่งคำสั่งมาพร้อมไบต์แรก สำหรับคำขอแบบไม่ระบุตัวตน
การตรวจคุณภาพ รัน curl -sI กับ URL จริง คุณควรเห็น x-robots-tag: noindex ในเฮดเดอร์ตอบกลับ และ curl -s ควรเห็นแท็ก meta ในซอร์สก่อนสคริปต์ใด ๆ ทำงาน
เส้นทางกู้คืน หากแท็กปรากฏเฉพาะหลัง JavaScript ทำงาน ให้ย้ายไปที่การเรนเดอร์ฝั่งเซิร์ฟเวอร์ หากเฟรมเวิร์กของคุณเรนเดอร์แท็ก head ตามเส้นทางไม่ได้ ให้ใช้เฮดเดอร์แทน อย่าปล่อย noindex ที่ JavaScript ใส่เข้าไปแล้วสมมติว่ามันได้ผล เพราะ Google ระบุว่าพฤติกรรมของ noindex ที่ถูกเรนเดอร์ยังนิยามได้ไม่ชัดเจน
มีอีกสองอย่างที่ควรอยู่ใน pull request เดียวกัน นำเส้นทาง noindex ออกจาก sitemap เพราะการส่ง URL ที่คุณไม่ต้องการให้จัดทำดัชนีคือความขัดแย้งที่ Google แก้ให้เป็นประโยชน์กับตัวเอง และเพิ่มกฎการหมดอายุ เมื่อลิงก์แชร์ตาย ให้ตอบ 410 แทนที่จะปล่อยหน้า 200 ที่ว่างเปล่า
ขั้นที่ 4 ตรวจสอบว่า Googlebot เห็นคำสั่ง
ทุกอย่างข้างต้นยังไม่ได้รับการยืนยันจนกว่าคุณจะตรวจแบบเดียวกับที่ Google ตรวจ
ตรวจเฮดเดอร์ตอบกลับก่อน:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagจากนั้นตรวจ HTML เริ่มต้นก่อนสคริปต์จะมีโอกาสทำงาน:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'สุดท้าย ยืนยันว่า robots.txt ไม่บล็อกเส้นทางนั้น หากบล็อก Google จะไม่ดึงหน้าและไม่อ่านคำสั่งเลย:
curl -s https://example.com/robots.txtSearch Console คือการตรวจขั้นสุดท้าย ขอตรวจ URL ใน URL Inspection แล้วอ่านคำตัดสิน
ผลที่ถูกต้องคือ "หน้าถูกตัดออกจากการจัดทำดัชนี: ถูกตัดออกด้วยแท็ก noindex" ผลที่แปลว่าคุณติดกับคือ "จัดทำดัชนีแล้ว แต่ถูกบล็อกโดย robots.txt" ซึ่งหมายความว่า Google มี URL อยู่ อ่านคำสั่งไม่ได้ และอาจยังคงแสดงมันต่อไป หากเห็นแบบนี้ ให้เอากฎใน robots.txt ออก แล้วปล่อยให้ noindex ทำงาน
คุณยังดึงหน้าที่ Googlebot เห็นได้ด้วยตัวจำลองตัวรวบรวมข้อมูล ซึ่งเร็วกว่าการรอเก็บข้อมูลใหม่เมื่อต้องตรวจยี่สิบเส้นทาง: Googlebot Spider Simulator
ผลลัพธ์ที่คาดหวัง ทุกเส้นทาง noindex แสดงสถานะถูกตัดออกด้วย noindex ภายในไม่กี่วันหลังการรวบรวมข้อมูลครั้งถัดไป เส้นทางที่สร้างหลังการเปลี่ยนแปลงไม่ควรปรากฏในดัชนีเลย
เส้นทางกู้คืน หาก URL ยังอยู่ในดัชนีหลังสองสัปดาห์ ให้ตรวจว่า Google ดึงมันได้หรือไม่ หน้าตอบ 200 ให้ Googlebot หรือไม่ และมีแท็ก canonical หรือ hreflang ชี้เสิร์ชเอนจินไปที่อื่นหรือไม่ ใช้เครื่องมือลบเพื่อบล็อกชั่วคราวระหว่างแก้ต้นเหตุเท่านั้น ไม่ใช่ใช้แทนคำสั่ง
เมื่อหน้าแชร์คือช่องทางเติบโต
มีหน้าที่สร้างขึ้นบางประเภทที่ควรถูกจัดทำดัชนี และการตั้ง noindex ทั้งหมดจะเป็นการทำร้ายตัวเอง สิ่งที่ควรปกป้องมีดังนี้
รูปแบบ | ทำไมจึงควรอยู่ในดัชนี | ราวกัน |
|---|---|---|
แกลเลอรีเทมเพลตสาธารณะ | ผู้ใช้เผยแพร่ดีไซน์ คนอื่นนำไปใช้ซ้ำ ผลลัพธ์มีเอกลักษณ์และคงทน | ตรวจสอบผลงานใหม่ |
ตัวสร้างแอปที่มีหน้าสาธารณะ | ผลงานจริงพร้อมเครดิต "built with" คือช่องทางกระจายตัว | แยกเทมเพลตหน้าโชว์เคสออกจากหน้าการตลาด |
เอกสารที่เติบโตจากกระทู้ผู้ใช้ | คำถามที่เกิดซ้ำสมควรได้คำตอบถาวรที่ผ่านการแก้ไข | จัดทำดัชนีคำตอบที่คัดสรร ไม่ใช่บทสนทนาดิบ |
หากคุณอยู่ในกลุ่มใดกลุ่มหนึ่งข้างต้น คำแนะนำเดิมของ Google ยังใช้ได้และเป็นคันโยกที่ดีกว่า นั่นคือตั้ง noindex ให้เนื้อหาของผู้ใช้ที่ยังไม่มีชื่อเสียง แล้วปลดออกเมื่อบัญชีมีประวัติ ซึ่งให้ทั้งภูมิต้านสแปมโดยไม่ต้องแลกวงจรการเติบโต และเป็นรูปแบบที่คู่มือแนะนำมาก่อนการอัปเดตนี้
แบบทดสอบของทั้งสามกลุ่มเหมือนกัน หากหน้าได้รับการแสดงผลในรายงานประสิทธิภาพการค้นหาจากคำค้นที่คนนอกจะพิมพ์ แสดงว่ามันควรอยู่ในดัชนี หากได้รับจากสตริง URL ของตัวเองเท่านั้น ก็ไม่ควร
ยังมีผลลัพธ์ระดับที่สองที่ควรเอ่ยถึง URL แชร์สาธารณะเป็นพื้นผิวสำหรับลิงก์ราคาถูกมาหลายปี สร้างหน้าในแพลตฟอร์มที่โดเมนแข็งแรง วางลิงก์กลับมาที่ไซต์ของตัวเอง แล้วทำซ้ำบนยี่สิบแพลตฟอร์ม Patrick Stox นับได้มากกว่า 20 ลิงก์จากต่างแพลตฟอร์มในกระทู้เดียวกัน หากแพลตฟอร์มทำตามคำแนะนำ พื้นผิวนี้จะแคบลง หากไม่ทำ Google ก็มีเอกสารให้อ้างอิงในครั้งหน้าที่ตัดสินว่าหน้าเหล่านั้นเป็นสแปม
ขั้นที่ 5 วัดรูปแบบที่ Google อธิบายไว้
ส่วนการเฝ้าระวังคือส่วนที่ทีมส่วนใหญ่จะข้าม และเป็นส่วนที่จับเหตุการณ์จริงได้ก่อนที่มันจะกลายเป็นมาตรการลงโทษ
สี่จุดตรวจ แต่ละจุดมีที่ให้ดู
ความเป็นเจ้าของ Search Console ยืนยันไซต์หรือซับโดเมน เพื่อให้การแจ้งเตือนมาตรการลงโทษและความปลอดภัยมาถึงทางอีเมล หากคุณดูแลแพลตฟอร์มที่แยกซับโดเมนต่อผู้เช่า ให้ยืนยันพร็อพเพอร์ตี้แม่และอย่างน้อยตัวอย่างของพร็อพเพอร์ตี้ลูก การแจ้งเตือนที่ไปไม่ถึงใครไม่ใช่การเฝ้าระวัง
แนวโน้มการจัดทำดัชนีหน้า ตั้งเส้นฐานจำนวน URL ที่จัดทำดัชนีแล้วต่อเส้นทางวันนี้ แล้วจับตาการเปลี่ยนแปลงแบบขั้นบันได ไม่ใช่สัญญาณรบกวน การที่จำนวน URL ที่จัดทำดัชนีเพิ่มเป็นสองเท่าในหนึ่งสัปดาห์บนเส้นทางที่ควรอยู่นิ่งคือสัญญาณ
ความผิดปกติของประสิทธิภาพการค้นหา กรองคำค้นที่ไม่เกี่ยวกับผลิตภัณฑ์ หน้าสแปมดึงคำค้นสแปมเข้ามานานก่อนที่ใครจะร้องเรียน
อัตราส่วนการสร้างต่อการจัดทำดัชนี นี่คือตัวชี้วัดที่ Google ระบุชื่อ และเป็นตัวที่แทบไม่มีใครติดตาม คือบัญชีเดียวสร้าง URL ที่จัดทำดัชนีได้กี่รายการต่อวัน และ URL ที่จัดทำดัชนีได้ใหม่นั้นมีสัดส่วนเท่าไรมาจากบัญชี 1% แรก การตั้งสัญญาณเตือนที่ 3 เท่าของค่ามัธยฐานเจ็ดวันย้อนหลังสำหรับบัญชีเดียวนั้นเป็นเกณฑ์ตามอำเภอใจแต่ใช้ได้ ปรับตามทราฟฟิกของคุณเอง
อัตราส่วนเดียวกันใช้เป็นราวกันระดับผลิตภัณฑ์ได้ด้วย หากฟีเจอร์หนึ่งทำให้ผู้ใช้คนเดียวสร้าง URL ที่จัดทำดัชนีได้พันรายการต่อวัน มันคือฟีเจอร์ที่ทำให้ดัชนีบวม ไม่ว่าจะมีใครใช้ในทางที่ผิดแล้วหรือยัง
สิ่งที่การอัปเดตนี้กำลังบอกจริง ๆ
ถ้าปัดถ้อยคำออก Google กำลังโต้แย้งเรื่องปริมาณการผลิต
ยี่สิบปีที่ผ่านมา นโยบายสแปมอธิบายหน้าเป็นรายหน้า ทั้งบาง คัดลอกมา ของปลอม และยัดคำค้น หมวดหมู่เหล่านั้นตั้งอยู่บนสมมติฐานว่ามนุษย์หรือสคริปต์ตัดสินใจสร้างหน้า และ Google ตัดสินว่ามันควรได้อันดับหรือไม่ ผลลัพธ์ที่สร้างขึ้นทำให้โมเดลนั้นพังทลาย การตัดสินใจระดับผลิตภัณฑ์ครั้งเดียวสร้าง URL ได้เป็นล้าน ทุกอันมีเอกลักษณ์ทางเทคนิค ทุกอันตอบ 200 ทางเทคนิค และส่วนใหญ่ไร้ค่าสำหรับใครก็ตามที่ไม่ใช่คนสร้าง Google ประเมินทีละอันไม่ได้ และเลิกแกล้งทำว่าได้
ปฏิกิริยาแบ่งเป็นสองค่าย ค่ายแรกอ่านเป็นการยิงเตือน Marie Haynes ถามว่าจะมีมาตรการลงโทษใหม่ตามมาสำหรับเครื่องมือ AI และตัวสร้างแอปหรือไม่ ส่วน Lily Ray มองหัวข้อนี้เป็นสัญญาณถึงสิ่งที่ Google กำลังต่อสู้ในระดับมหาศาลอยู่แล้ว โดยระบุชื่อ artifact ของ Claude หน้าแชร์ของ ChatGPT และโพสต์โซเชียล ค่ายที่สองยักไหล่ ทีมที่ระมัดระวังตั้ง noindex ให้รายงานที่ผู้ใช้สร้างมานานหลายปีแล้ว หลายความเห็นโต้แย้ง และหน้าที่ Google สร้างเองคือปัญหาที่ใหญ่กว่า ทั้งสองการอ่านอาจเป็นจริงได้ สิ่งที่ทำให้คำแนะนำนี้สำคัญไม่ใช่เพราะคำแนะนำใหม่ แต่เพราะตอนนี้มันถูกเขียนไว้ในที่ที่การบังคับใช้ชี้ไปได้
ดังนั้นคำแนะนำจึงเลื่อนการตัดสินใจขึ้นไปต้นน้ำ แพลตฟอร์มถูกคาดหวังให้ตัดสินที่ระดับเทมเพลตว่า URL กลุ่มหนึ่งควรอยู่ในดัชนีหรือไม่ นี่คือคำถามเรื่องธรรมาภิบาล ไม่ใช่คำถาม SEO และเป็นเหตุผลที่คำแนะนำอยู่ในคู่มือสแปม ไม่ใช่ในเอกสารการจัดทำดัชนี
สำหรับ AI search ตรรกะเดียวกันใช้ได้ทั้งสองทาง ฟีเจอร์ AI ของ Google ดึงจากดัชนี Google คำสั่ง noindex จึงนำหน้าออกจากทั้งลิงก์สีน้ำเงินและจากพูลนั้น หากหน้าที่สร้างขึ้นเคยได้รับการอ้างอิงใน AI Overview คาดว่ามันจะหยุด สำหรับลิงก์แชร์โดยทั่วไปถูกต้อง และสำหรับหน้าเทมเพลตโดยทั่วไปผิด ตัวรวบรวมข้อมูล AI ตัวอื่นมีกฎของตัวเอง จึงต้องแยกตัดสินว่าคุณต้องการให้ตัวไหนดึงหน้าเหล่านั้นได้
ข้อสรุปเชิงปฏิบัติคือประโยคหนึ่งที่เอาไปใส่ใน design review ได้เลย ทุก URL ที่ผู้ใช้สร้างได้คือพื้นผิวของผลิตภัณฑ์หรือภาระต่อดัชนี และเทมเพลตเป็นตัวกำหนดว่าคืออย่างไหน
คำถามที่พบบ่อย
ใช้กับเว็บไซต์การตลาดทั่วไปหรือไม่
ไม่ใช้ เว้นแต่ไซต์ของคุณสร้าง URL จากข้อมูลที่ผู้ใช้ป้อน เว็บไซต์การตลาดเผยแพร่ชุดหน้าที่มีคนตัดสินว่าควรมีอยู่ ซึ่งตรงข้ามกับปัญหาที่คู่มืออธิบาย ประโยคขอบเขตระบุชื่อแพลตฟอร์มโฮสติ้งและเครื่องมือที่ให้ผู้ใช้เผยแพร่หน้าที่แชร์ได้ เนื้อหาที่สร้างขึ้น หรือเว็บแอป หากคุณมีระบบคอมเมนต์ ฟอรัม หรือโปรไฟล์สมาชิก คำแนะนำเดิมใช้ได้ คือ nofollow หรือ ugc สำหรับลิงก์จากบัญชีที่ไม่น่าเชื่อถือ และ noindex สำหรับผู้ใช้ใหม่จนกว่าจะสร้างชื่อเสียงได้
ควรใช้ robots.txt หรือแท็ก noindex
ใช้ noindex และใช้เพียงอย่างใดอย่างหนึ่งบนเส้นทางเดียวกัน ประโยคของ Google ระบุทั้งสองทางเลือก แต่สองอย่างทำงานต่างกัน Disallow ใน robots.txt หยุดการรวบรวมข้อมูล และ URL ที่ถูกบล็อกแต่มีลิงก์จากที่อื่นอาจอยู่ในผลการค้นหาโดยไม่มีสั้นเซ็ปต์ noindex ทำงานเฉพาะเมื่อ Google ดึงหน้าและอ่านได้ ในทางปฏิบัติคือแท็ก meta หรือเฮดเดอร์ตอบกลับ และไม่ควรมีกฎ robots.txt บนเส้นทางเดียวกันเลย
การตั้ง noindex ให้หน้าแชร์จะทำให้เสียทราฟฟิกไหม
ตรวจเส้นทางก่อนตัดสิน ไม่ใช่หลังตัดสิน หากหน้าได้รับการแสดงผลเฉพาะจากสตริง URL ของตัวเอง มันไม่ได้สร้างทราฟฟิกออร์แกนิก และการเอาออกไม่ได้ทำให้เสียอะไร รูปแบบที่เสียทราฟฟิกจริงคือการรื้อแกลเลอรีสาธารณะพร้อมผลลัพธ์ที่อยู่ข้างใน ให้แกลเลอรีคงจัดทำดัชนีได้ ตั้ง noindex ให้สิ่งที่อยู่ข้างหลัง และดูประสิทธิภาพการค้นหาสำหรับคำค้นของแกลเลอรีทั้งก่อนและหลัง
เสิร์ชเอนจิน AI เคารพ noindex ไหม
ฟีเจอร์ AI ของ Google เคารพ เพราะ AI Overview และ AI Mode ดึงจากดัชนีเดียวกัน คำสั่งจึงนำหน้าออกจากทั้งลิงก์สีน้ำเงินและคำตอบ AI ตัวรวบรวมข้อมูล AI ตัวอื่นเป็นการตัดสินคนละเรื่อง พฤติกรรมของผู้ให้บริการแตกต่างกันและเปลี่ยนได้โดยไม่มีบันทึกการเปลี่ยนแปลง จึงควรอ่านเอกสารของแต่ละตัวและดึงหน้าด้วย user agent ของตัวนั้น แทนที่จะสมมติว่าคำสั่งเดียวครอบคลุมทั้งหมด
ผู้เขียน: Grace Miller นักวิเคราะห์ความเสี่ยง AI Search ที่ Auspia ติดตามการเปลี่ยนแปลงนโยบายมากกว่า 200 กรณี เธอเขียนเกี่ยวกับกฎของแพลตฟอร์ม ความเสี่ยงของเนื้อหา และการปรับแต่งที่คำนึงถึงนโยบาย