Правило, которое Google только что записал
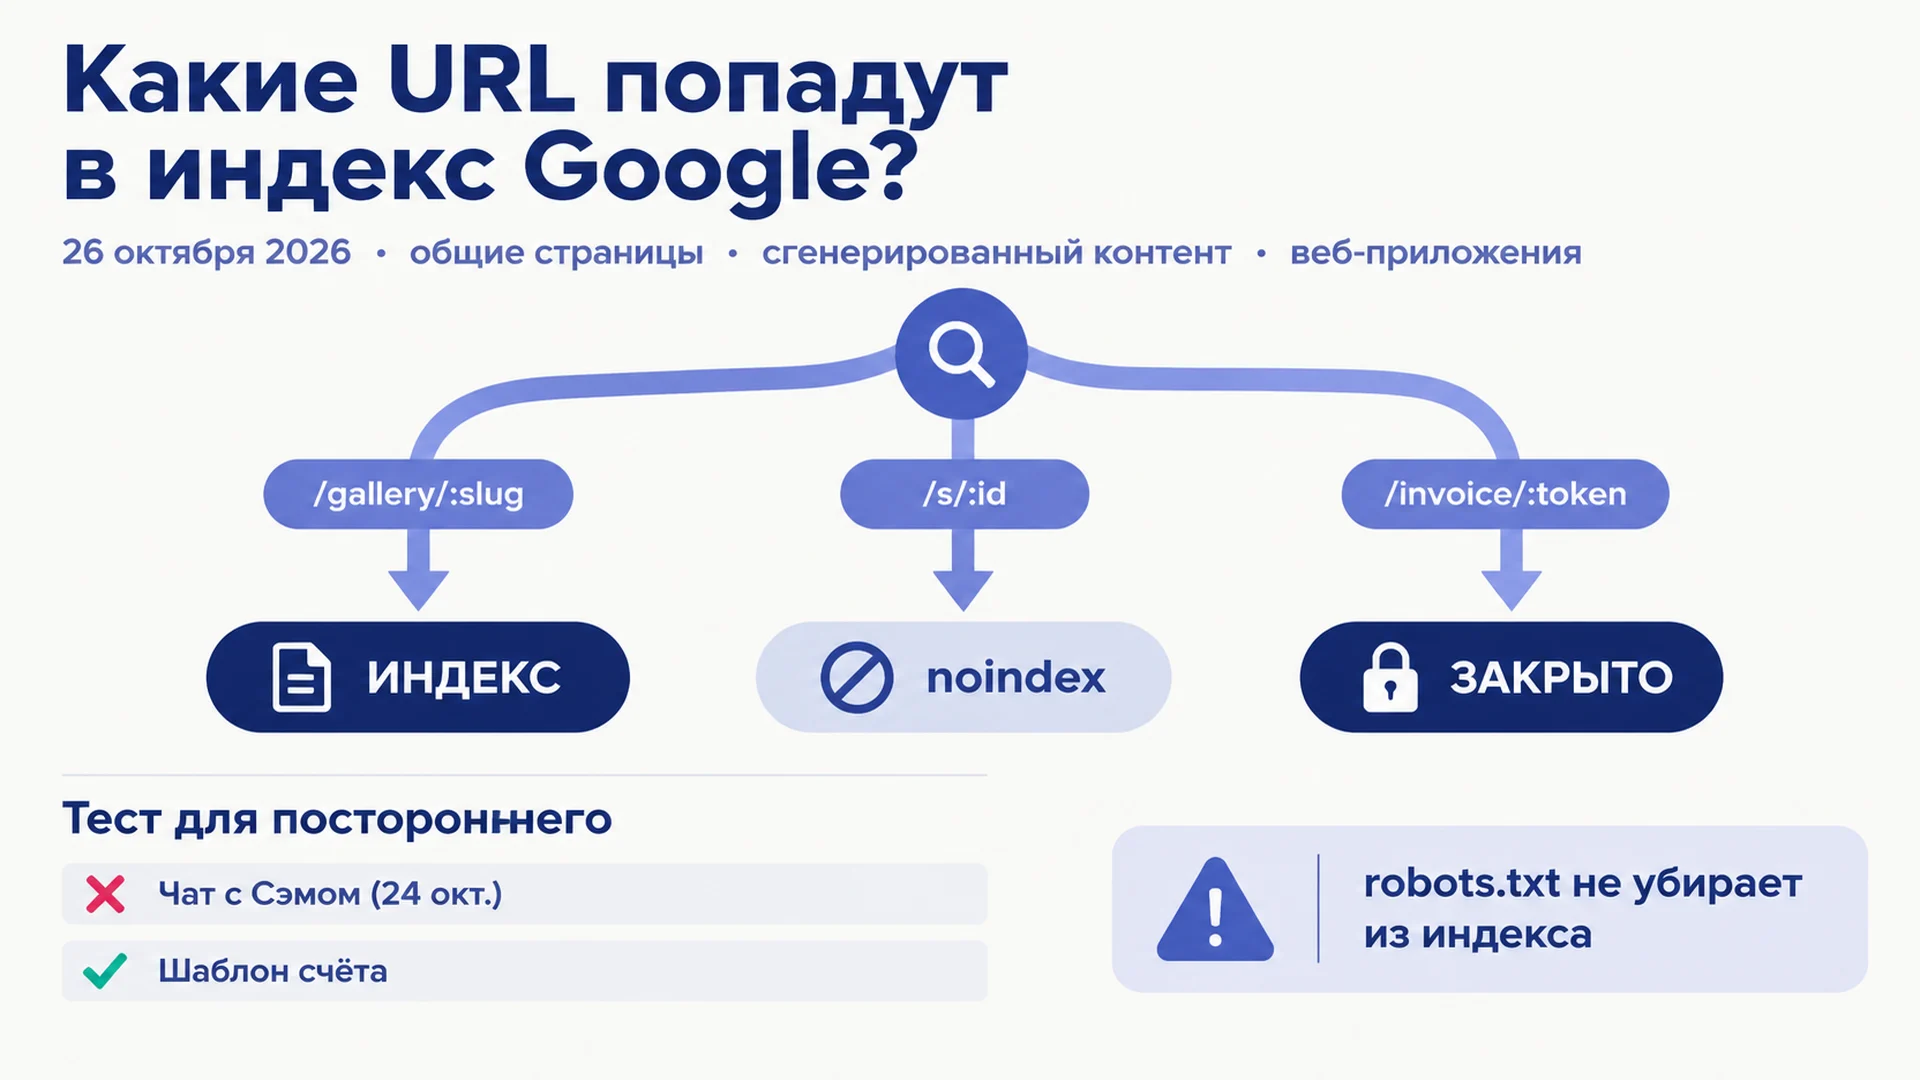
26 октября 2026 года Google добавил в руководство по борьбе с пользовательским спамом раздел из двух абзацев. Это самая короткая часть страницы и, вероятно, та, что сильнее всего изменит продуктовые планы, потому что в ней задан вопрос, который большинство команд никогда не выносило на слайд: должен ли этот URL вообще находиться в индексе Google?
Раздел называется "Only index content meant for Search" — индексируйте только то, что предназначено для поиска. Вот он полностью:
Если ваш сервис позволяет пользователям создавать страницы общего доступа, сгенерированные результаты или интерактивные инструменты, подумайте, предназначен ли этот контент для обнаружения через поисковые системы или только для прямого доступа тех, у кого есть ссылка.
Когда страницы создаются для прямого обмена, совместной работы или утилитарных задач, а не для обнаружения в открытом поиске, применяйте правило noindex (через meta-тег robots или HTTP-заголовок X-Robots-Tag) либо по умолчанию блокируйте сканирование в robots.txt.
Журнал изменений Google за тот же день говорит о намерении прямее: руководство обновлено, чтобы добавить «рекомендации по блокировке индексирования контента, распространяемого по ссылке, и по мониторингу злоупотреблений в Search Console», чтобы платформы могли «держать пользовательские страницы, не предназначенные для поиска, вне индекса и раньше выявлять спам».
И это всё. Ни нового ручного воздействия, ни анонса системы ранжирования, ни списка санкций. Рекомендовано значение по умолчанию — а именно из значений по умолчанию и возникает большинство проблем с индексированием.
Для кого это. Для команд, которые выпускают любой URL, создаваемый пользователем: ссылки общего доступа, сохранённые чаты, публичные дашборды, предпросмотр шаблонов, сборки приложений, сгенерированные отчёты, ветки форумов, страницы профилей, страницы отзывов, страницы объявлений.
Что вы получите на выходе. Вердикт на уровне маршрута для каждого типа создаваемых URL, способ контроля, который действительно убирает страницу из индекса, и правило мониторинга, ловящее описанный Google паттерн злоупотребления.
Время. 45–90 минут на первый проход по одному продукту. День, если генераторов URL несколько, а инвентаризации маршрутов нет.
Что значит «готово». Каждый создаваемый маршрут помечен как index, noindex или private. Маршруты noindex отдают директиву на сервере, а не после выполнения JavaScript. В Search Console эти URL показаны как исключённые по noindex, а не как «проиндексировано, несмотря на блокировку в robots.txt».
Что изменилось, а что только кажется новым
Важных правок четыре. Остальная страница не изменилась, включая рекомендации от декабря 2025 года, которые по-прежнему действуют.
Что изменил Google | Фактический текст | Почему это важно вам |
|---|---|---|
Область действия руководства | Теперь названы платформы хостинга «и инструменты, позволяющие пользователям публиковать общие страницы, сгенерированный контент или веб-приложения» | При буквальном чтении это охватывает выгрузки из AI-чатов, страницы артефактов, конструкторы приложений и no-code инструменты, а не только форумы и комментарии |
Единица злоупотребления | Спамеры могут создавать «большое количество страниц или сайтов» | Google говорит об объёме, а не о хитрости. Один злонамеренный аккаунт может наплодить тысячи URL |
Новый раздел | "Only index content meant for Search" | Самое ясное на сегодня заявление, что noindex — разумное значение по умолчанию для контента, доступного только по ссылке |
Мониторинг | Подтвердить сайт или поддомен в Search Console, следить за скачками в отчётах по индексированию страниц и эффективности поиска, подавать сигнал, когда «небольшое число пользователей» создаёт «большую долю индексируемых URL» | У разрастания индекса появился названный метод обнаружения, а обычно после появления названия подтягивается и порядок проверки |
Что не изменилось: noindex для публикаций новых пользователей до получения репутации, а также nofollow или ugc для ссылок внутри недоверенного контента. Если вы уже делаете и то и другое, вы впереди этого обновления.
Стоит сказать прямо, потому что реакция в X обогнала документ: это рекомендации платформам об их собственном запасе URL. Они не создают нового нарушения для обычного маркетингового сайта и не меняют ранжирование ни одной страницы. Меняется то, что вообще должно существовать в индексе.
Ещё один контекст объясняет выбор момента. В конце июля 2026 года ссылки общего доступа Claude и страницы артефактов появились в индексе Google, и тогдашние публикации описывали раскрытие медицинских записей, API-ключей и других приватных материалов, прежде чем Anthropic закрыла брешь за несколько дней. Те же материалы указывали на публичные URL приложений в конструкторах вроде Replit и Lovable. Google редко пишет новый раздел ради гипотетической ситуации. Этот уже случился.
Вопрос, который решает судьбу любого создаваемого URL
Тест Google сформулирован одним предложением, и его можно применить, не угадывая намерения: этот контент предназначен для обнаружения через поисковые системы или только для доступа того, у кого есть ссылка?
На практике на него отвечают четыре сигнала. Оценивайте маршрут, а не отдельную страницу.
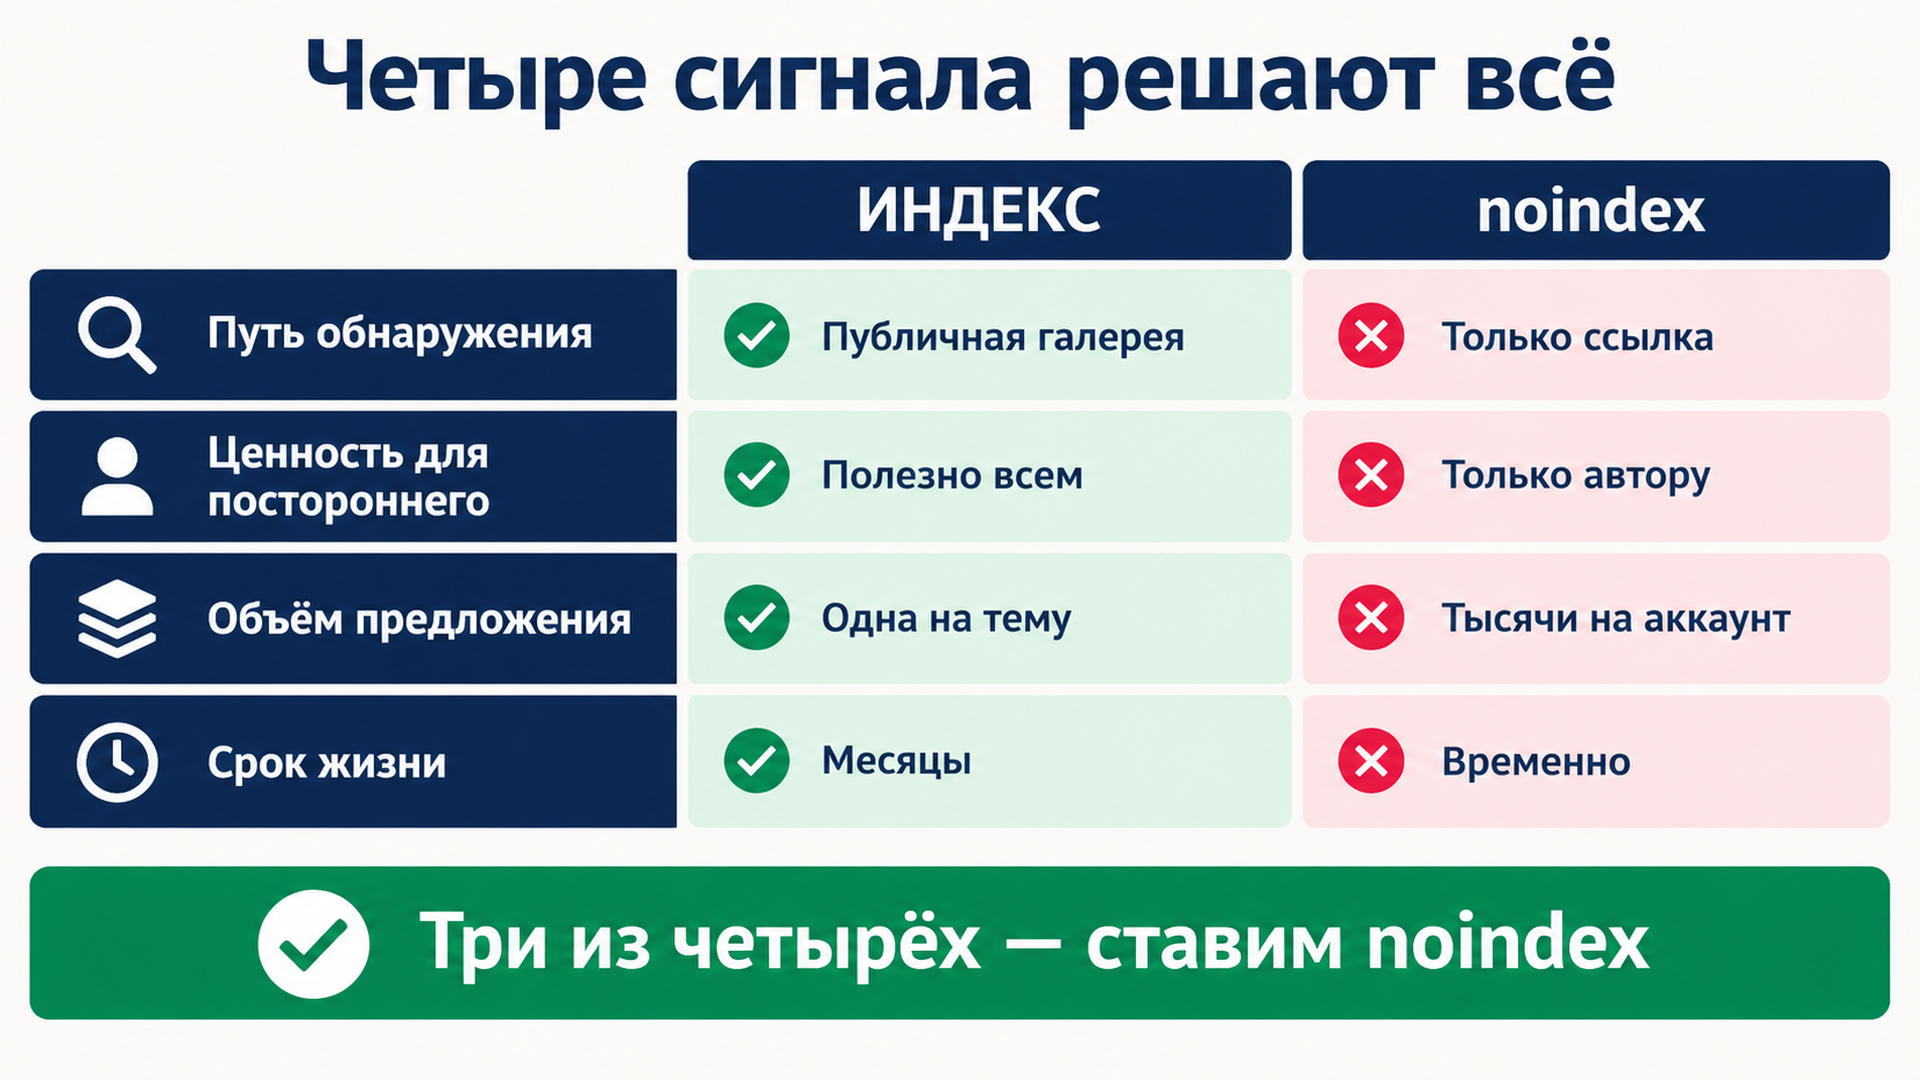
Сигнал | Указывает на индексацию | Указывает на noindex |
|---|---|---|
Путь обнаружения | Есть ссылка из публичной галереи, карты сайта, рубрики или профиля | Доступен только по скопированной ссылке или через кнопку «поделиться» |
Ценность для постороннего | Полезен без знания автора | Имеет смысл только для создателя, его команды или получателя |
Объём предложения | Одна страница на тему или отобранный набор | Тысячи URL из одного аккаунта, в основном почти дубли |
Срок жизни | Остаётся точным месяцами | Временный: чат, сборка, черновик, разовая выгрузка |
Три из четырёх в сторону noindex — ясное решение. Размытый результат обычно означает, что маршрут нужно разделить: индексируемая публичная галерея плюс отдельные результаты, которые не индексируются. Это разделение — самый частый правильный ответ и одновременно тот, который чаще всего пропускают, потому что он требует двух шаблонов вместо одного флага.
Полезный тест на отказ: если посторонний увидит этот URL в результатах поиска без всякого контекста, будут ли заголовок и сниппет осмысленными? «Чат с Сэмом, 24 октября» — не проходит. «Шаблон счёта для дизайнеров-фрилансеров» — проходит. Провал здесь не про качество. Он про то, создавалась ли страница, чтобы её находили, или чтобы её отправляли.
Выберите контроль, который действительно убирает URL
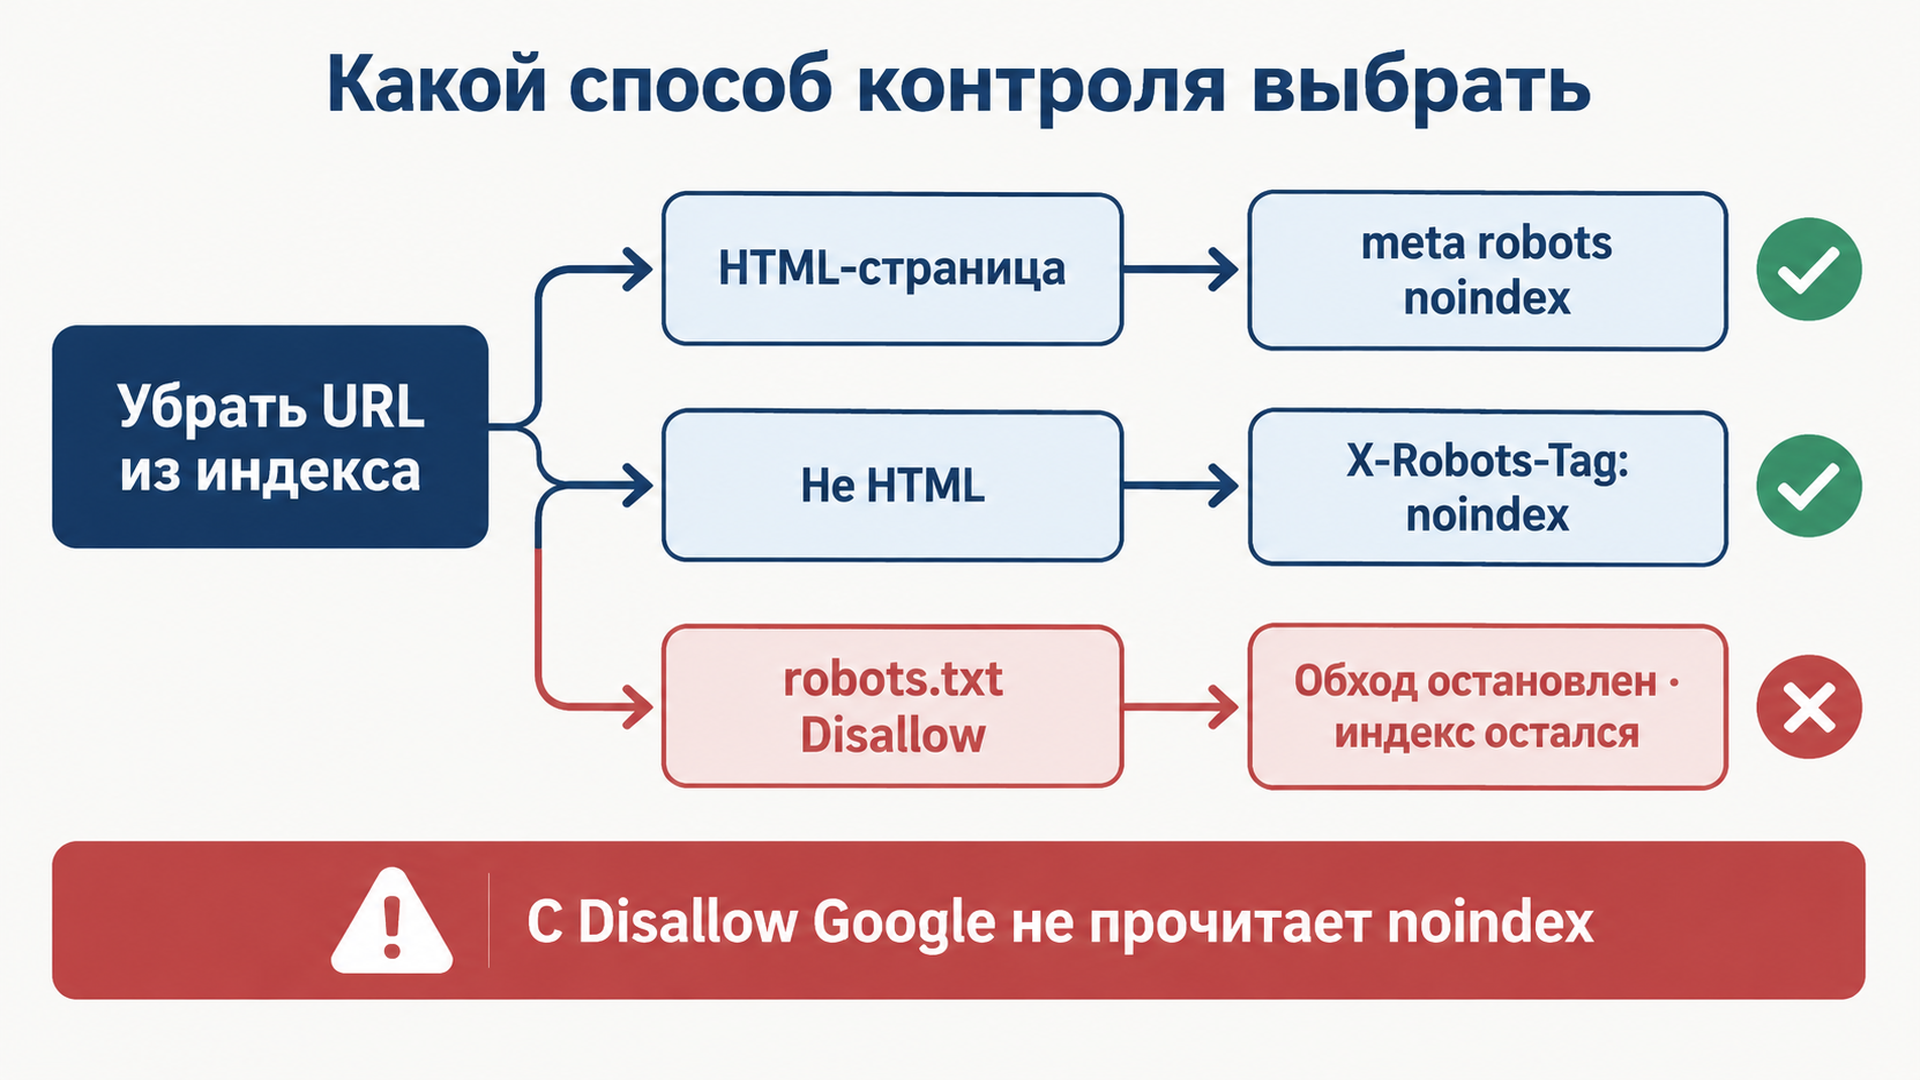
Именно здесь можно буквально последовать новым рекомендациям и всё равно потерпеть неудачу. Google предлагает два варианта в одном предложении, и они не равноценны.
robots.txt управляет сканированием. Он не удаляет URL из индекса, и Google сам говорит об этом во введении к robots.txt: страница, закрытая там, «всё равно может быть проиндексирована, если на неё ссылаются другие сайты», и тогда URL, а возможно и текст анкора, может появляться в результатах без описания.
noindex управляет индексированием, но только если Google может получить страницу и прочитать директиву. Документация Google по noindex прямо указывает: чтобы правило работало, страница не должна быть закрыта в robots.txt, иначе «сканер никогда не увидит правило noindex».
Сложите эти два факта — и порядок становится важным.
Способ контроля | Убирает URL из индекса | Где не работает | Для чего применять |
|---|---|---|---|
Заголовок ответа | Да, после того как Google просканирует и прочитает | Всё, что закрыто в robots.txt или находится за логином | Не-HTML ответы (PDF, JSON, изображения) и правила на edge или CDN для множества маршрутов |
| Да, после того как Google просканирует и прочитает | Теги, вставленные JavaScript после загрузки; страницы, закрытые в robots.txt | HTML-страницы общего доступа с серверным рендерингом |
Disallow в | Нет | URL со ссылками может остаться в индексе без сниппета | Снижение нагрузки на сканирование, а не приватность |
Логин или подписанный URL | Да, за счёт запрета доступа | Требует, чтобы страница действительно была приватной | Всё, что содержит чужие данные |
410 после истечения срока | Да, со временем | Медленнее 404; ничего не делает, пока URL ещё резолвится | Временные ссылки и сборки |
Один короткий путь, которого стоит избегать: X-Robots-Tag: none — не нейтральное значение. Google трактует его как noindex плюс nofollow. Иногда это именно то, что нужно, но команды копируют его из конфигурации прокси, не зная об этом.
Второй короткий путь: canonical. Canonical — это подсказка. Если страницы не должно быть в индексе, пишите noindex.
Шаг 1. Инвентаризируйте маршруты, которые плодят URL
Нельзя классифицировать то, что не перечислено, а большинство команд недооценивают количество, потому что думают функциями, а не шаблонами маршрутов.
Откройте роутер или карту URL и перечислите каждый динамический сегмент. Типичные нарушители выглядят так:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Затем сверьтесь с тем, что Google уже знает, потому что код и индекс будут расходиться.
Из карты сайта. Скачайте и посчитайте:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
Вторая команда даёт грубую гистограмму по префиксам путей. Если создаваемый маршрут присутствует в карте сайта, это само по себе ошибка: карта сайта — это список страниц, которые вы просите Google проиндексировать.
Из Search Console. Откройте отчёт по индексированию страниц, отфильтруйте по префиксу URL для каждого кандидата и запишите числа. Это единственный источник, который говорит, что Google реально сделал с этими URL.
Из серверных логов. Сгруппируйте запросы Googlebot по префиксу:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Ожидаемый результат. Список шаблонов маршрутов с количеством URL рядом с каждым, минимум из двух источников.
Проверка качества. Каждый маршрут, который может вернуть 200 для посетителя не из числа сотрудников, должен быть в списке. Если по одному префиксу число в карте сайта и в Search Console расходятся больше чем на несколько процентов, выясните причину, прежде чем что-либо менять.
Если ничего не нашли. Скорее всего, у вас клиентский роутер. Ищите определения маршрутов во фронтенде, а не в бэкенде, и смотрите сетевую панель на настоящей ссылке общего доступа.
Шаг 2. Классифицируйте маршруты в таблице, а не на совещании
Запишите вердикт туда, где его можно проверить. Одной строки на шаблон маршрута достаточно.
Маршрут | Кто создаёт | Путь обнаружения | Ценность для постороннего | Вердикт | Контроль | Ответственный |
|---|---|---|---|---|---|---|
| Любой пользователь | Только ссылка | Нет | noindex | Заголовок | Платформа |
| Отобранный контент | Внутренние ссылки, карта сайта | Высокая | index | Нет | Контент |
| Любой пользователь | Ссылки из профиля | Низкая до активности | noindex до появления репутации | Meta | Доверие и безопасность |
| Любой пользователь | Только ссылка | Нет | noindex | Заголовок | Платформа |
| Редакторы | Карта сайта | Высокая | index | Нет | Контент |
Таблица работает, только если верны три вещи.
На каждую строку — один ответственный. Размытая ответственность и есть причина, по которой создаваемые маршруты годами остаются индексируемыми.
Пишите способ контроля рядом с вердиктом, а не потом. «Noindex» не является решением, пока никто не знает, означает ли это заголовок, правку шаблона или правило CDN.
Фиксируйте исключение. Если маршрут noindex, но небольшая часть должна быть публичной, запишите условие этой подгруппы сейчас. Приделывать исключение через полгода — типичный путь, по которому правило noindex тихо отменяют целиком.
Шаг 3. Внедряйте контроль на уровне шаблона
Постраничные правки не переживают следующий деплой. Применяйте контроль там, где рендерится маршрут.
Для HTML-страниц ставьте тег в head, отрендеренный на сервере. В Next.js App Router это metadata, в Astro — head макета, в Rails или Django — шаблон макета. Точный синтаксис менее важен, чем место: тег должен быть в HTML, который получает Google, а не добавлен клиентским эффектом.
<meta name="robots" content="noindex">Для всего, что не является HTML, meta-тега не существует, поэтому используйте заголовок:
X-Robots-Tag: noindexЭто покрывает экспорт в PDF, JSON-ответы, сгенерированные изображения и выгрузки CSV. Если эти файлы отдаются через CDN, задайте заголовок на edge, чтобы новые маршруты его наследовали.
Для целого семейства маршрутов правило в middleware обычно чище, чем правка каждого шаблона:
// Пример для Express: noindex для каждого созданного URL общего доступа
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Ожидаемый результат. Деплой, в котором каждый помеченный noindex маршрут отдаёт директиву с первого байта для анонимных запросов.
Проверка качества. Выполните curl -sI для живого URL. В заголовках ответа должен быть x-robots-tag: noindex, а curl -s должен показывать meta-тег в исходном коде до запуска любых скриптов.
Путь восстановления. Если тег появляется только после выполнения JavaScript, перенесите его в серверный рендеринг. Если ваш фреймворк не умеет рендерить head-теги для каждого маршрута, используйте заголовок. Не выпускайте noindex, вставленный через JS, в расчёте, что он сработает: Google описывает поведение отрендеренного noindex как недостаточно определённое.
В тот же pull request стоит добавить ещё две вещи. Убрать маршруты noindex из карты сайта, потому что отправлять URL, который вы не хотите индексировать, — противоречие, и Google разрешает его в свою пользу. И добавить правило истечения срока: когда ссылка общего доступа умирает, возвращайте 410, а не оставляйте страницу 200 с пустым состоянием.
Шаг 4. Проверьте, что Googlebot видит директиву
Всё вышеперечисленное не проверено, пока вы не проверите это так, как это сделает Google.
Сначала заголовки ответа:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagЗатем исходный HTML до того, как у скриптов появится шанс выполниться:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'И наконец, убедитесь, что robots.txt не закрывает путь. Если закрывает, Google никогда не получит страницу и не прочитает директиву:
curl -s https://example.com/robots.txtПоследняя проверка — Search Console. Запросите URL в «Проверке URL» и прочитайте вердикт.
Правильный результат — «Страница не проиндексирована: исключена тегом noindex». Результат, означающий, что вы попали в ловушку, — «Проиндексировано, несмотря на блокировку в robots.txt»: Google знает URL, не может прочитать директиву и может продолжать его показывать. Если видите это, уберите правило из robots.txt и дайте noindex сделать работу.
Ещё можно получить страницу в том виде, в каком её видит Googlebot, с помощью симулятора сканера — это быстрее, чем ждать переобхода, когда вы проверяете двадцать маршрутов: Googlebot Spider Simulator.
Ожидаемый результат. Каждый маршрут noindex показывает состояние «исключено по noindex» в течение нескольких дней после следующего обхода. Маршруты, созданные после изменения, вообще не должны появляться в индексе.
Путь восстановления. Если URL остаётся в индексе спустя две недели, проверьте, может ли Google его вообще получить, возвращает ли страница 200 для Googlebot и не указывают ли canonical или hreflang на другое место. Инструмент удаления используйте только для временной блокировки на время исправления причины, а не как замену директиве.
Когда страница общего доступа сама является каналом роста
Некоторые создаваемые страницы индексировать нужно, и сплошной noindex был бы выстрелом в ногу. Вот те, что стоит защищать:
Паттерн | Почему заслуживает индекса | Ограничитель |
|---|---|---|
Публичные галереи шаблонов | Пользователи публикуют дизайн, другие его переиспользуют; результат уникален и долговечен | Модерировать новые публикации |
Конструкторы с публичными витринами | Реальный результат со ссылкой «built with» сам является каналом распространения | Держать шаблон витрины отдельно от маркетинговой страницы |
Документация, выросшая из веток пользователей | Повторяющийся вопрос заслуживает постоянного отредактированного ответа | Индексировать отобранный ответ, а не сырой диалог |
Если вы попадаете в одну из этих категорий, прежний совет Google по-прежнему применим и работает лучше: ставить noindex контенту пользователей без репутации и снимать его, когда у аккаунта появляется история. Это даёт устойчивость к спаму, не отказываясь от цикла привлечения, и именно этот паттерн руководство рекомендовало ещё до обновления.
Тест для всех трёх одинаков. Если страница получает показы в отчёте по эффективности поиска по запросам, которые ввёл бы посторонний, ей место в индексе. Если показы приходят только по её собственной строке URL и ни по чему больше — не место.
Есть и эффект второго порядка, который стоит назвать. Публичные URL общего доступа годами были дешёвой поверхностью для ссылок: создать страницу на платформе с сильным доменом, поставить ссылку на свой сайт, повторить на двадцати ресурсах. Патрик Стокс в той же ветке насчитал более 20 ссылок с разных платформ. Если платформы последуют рекомендациям, эта поверхность сузится. Если нет — у Google теперь есть документ, на который можно сослаться в следующий раз, когда он решит, что эти страницы являются спамом.
Шаг 5. Измеряйте паттерн, который описал Google
Раздел о мониторинге — та часть обновления, которую большинство команд пропустит, и одновременно та, что ловит настоящий инцидент до того, как он станет ручным воздействием.
Четыре проверки, у каждой есть место, куда смотреть.
Права в Search Console. Подтвердите сайт или поддомен, чтобы уведомления о ручных воздействиях и проблемах безопасности приходили на почту. Если вы управляете платформой с поддоменами для каждого арендатора, подтвердите родительский ресурс и хотя бы выборку дочерних: уведомление, которое никуда не приходит, не является мониторингом.
Динамика индексирования страниц. Зафиксируйте сегодняшнее количество проиндексированных URL по каждому создаваемому маршруту, а затем следите за ступенчатыми изменениями, а не за шумом. Удвоение проиндексированных URL за неделю на маршруте, который должен быть статичным, — это сигнал.
Аномалии эффективности поиска. Фильтруйте запросы, не связанные с продуктом. Спам-страницы притягивают спам-запросы задолго до того, как кто-нибудь пожалуется.
Соотношение создания и индексации. Это метрика, которую называет Google, и почти никто её не отслеживает: сколько индексируемых URL может произвести один аккаунт в день и какую долю новых индексируемых URL даёт топ-1% аккаунтов. Стартовый порог в 3 раза выше медианы за последние семь дней для одного аккаунта произволен, но работоспособен; настройте его под свой трафик.
То же соотношение работает и как продуктовый ограничитель. Если функция позволяет одному пользователю генерировать тысячу индексируемых URL в день, это функция разрастания индекса, даже если пока никто ею не злоупотребляет.
Что на самом деле говорит обновление
Уберите формулировки, и Google ведёт спор о предложении.
Двадцать лет спам-политика описывала страницы: тонкие, спарсенные, замаскированные, переполненные ключевыми словами. Эти категории предполагают, что человек или скрипт решает создать страницу, а Google решает, заслуживает ли она ранжирования. Сгенерированные результаты ломают эту модель. Одно продуктовое решение способно создать миллион URL, все технически уникальные, все технически отдающие 200, и большинство бесполезны для всех, кроме их создателя. Google не может оценивать их по одному и перестал делать вид, что может.
Реакция оформилась в два лагеря. Первый прочитал это как предупредительный выстрел: Мари Хейнс спросила, последуют ли новые ручные воздействия для AI-инструментов и конструкторов приложений, а Лили Рэй восприняла раздел как сигнал о том, с чем Google уже борется в масштабе, назвав артефакты Claude, страницы общего доступа ChatGPT и посты в соцсетях. Второй лагерь пожал плечами. Аккуратные команды годами закрывают пользовательские отчёты в noindex, возражали в ответах, а сгенерированные страницы самого Google — проблема крупнее. Верны могут быть оба прочтения. Значение рекомендаций не в том, что совет нов, а в том, что теперь он записан там, куда может указать правоприменение.
Итак, рекомендации переносят решение выше по потоку. От платформ теперь ожидают решения на уровне шаблона: относится ли класс URL к индексу. Это вопрос управления, а не SEO, и именно поэтому совет находится в руководстве по спаму, а не в документации по индексированию.
Для AI-поиска та же логика работает в обе стороны. Функции Google опираются на индекс Google, поэтому директива noindex убирает страницу и из этого пула, и из синих ссылок. Если сгенерированная страница получала упоминания в AI Overviews, ожидайте, что они прекратятся. Для ссылки общего доступа это обычно правильно, для страницы шаблона — обычно неправильно. Другие AI-сканеры следуют своим правилам, поэтому отдельно решите, каким из них вы хотите разрешить забирать эти страницы.
Практический вывод — фраза, которую можно положить в дизайн-ревью: каждый URL, который может создать пользователь, — либо часть продукта, либо долг перед индексом, и шаблон решает, что именно.
Вопросы и ответы
Применимо ли это к обычному маркетинговому сайту?
Нет, если ваш сайт не создаёт URL из пользовательского ввода. Маркетинговый сайт публикует набор страниц, которые человек решил, что они должны существовать, — это противоположность описанной в руководстве проблеме. Строка об области действия называет платформы хостинга и инструменты, позволяющие пользователям публиковать общие страницы, сгенерированный контент или веб-приложения. Если у вас есть комментарии, форум или профили участников, действует прежний совет: nofollow или ugc для ссылок из недоверенных аккаунтов и noindex для новых пользователей, пока они не наработают репутацию.
Что использовать: robots.txt или noindex?
Noindex, и на любом конкретном маршруте — только одно из двух. Предложение Google перечисляет оба варианта, но они делают разное. Disallow в robots.txt останавливает сканирование, и URL, закрытый, но связанный извне, может остаться в результатах без сниппета. Noindex работает только тогда, когда Google может получить страницу и прочитать её. На практике это meta-тег или заголовок ответа и никогда — правило robots.txt на том же пути.
Потеряю ли я трафик, закрыв страницы общего доступа в noindex?
Проверьте маршрут до решения, а не после. Если страница получает показы только по собственной строке URL, она не приносит органического трафика, и её удаление ничего не стоит. Трафик теряется в другом паттерне: когда вместе с результатами снимают и публичную галерею. Оставьте галерею индексируемой, закройте в noindex то, что за ней, и сравните эффективность поиска по запросам галереи до и после.
Учитывают ли AI-поисковики noindex?
Функции Google — да, потому что AI Overviews и AI Mode опираются на тот же индекс, поэтому директива убирает страницу и из синих ссылок, и из AI-ответов. Другие AI-сканеры — отдельное решение. Поведение вендоров различается и меняется без журнала изменений, поэтому читайте документацию каждого сканера и проверяйте страницу с его user agent, а не предполагайте, что одна директива покрывает всех.
Автор: Грейс Миллер, аналитик по рискам AI-поиска в Auspia. Отслеживает более 200 изменений политик. Пишет о правилах платформ, рисках контента и оптимизации с учётом политик.