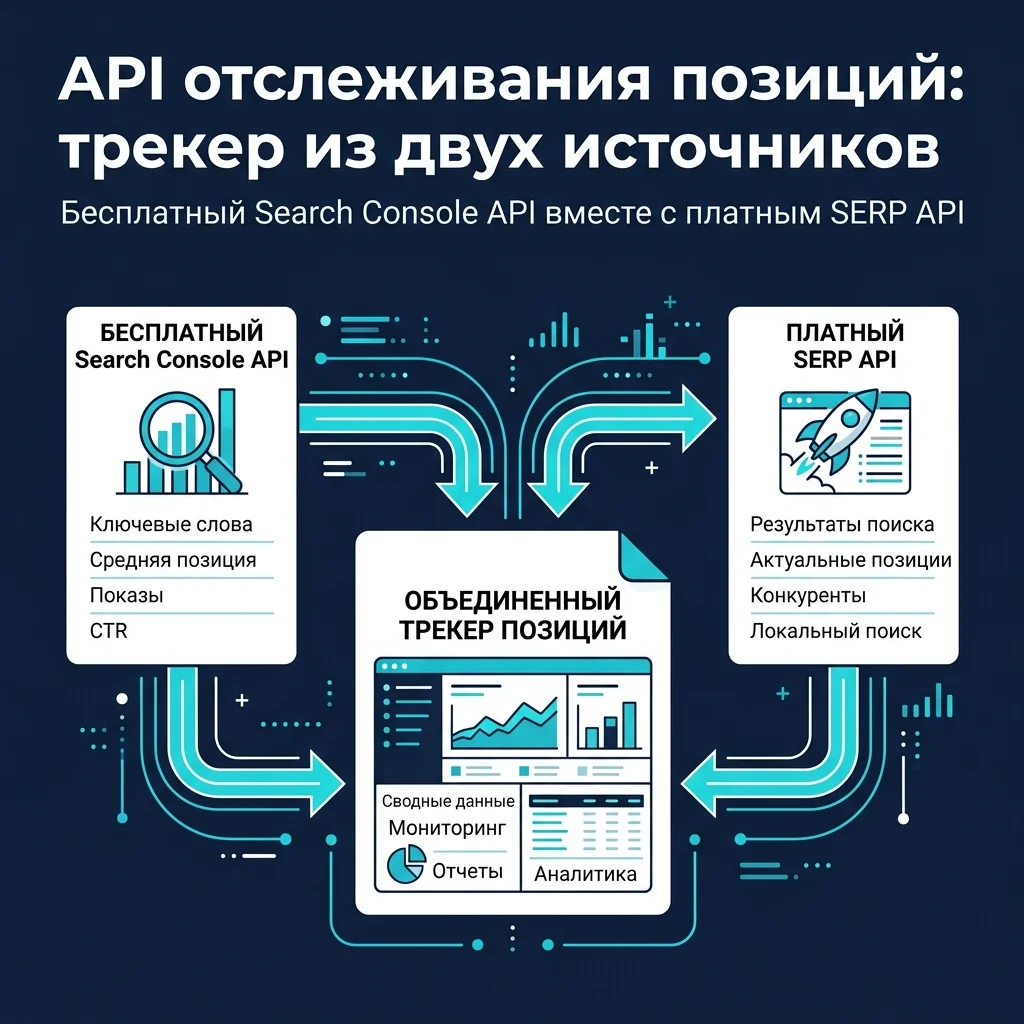
«API отслеживания позиций» — это не одна вещь. Разработчик, ищущий "rank tracking API", обычно хочет один эндпоинт, возвращающий позиции, а рынок отвечает подборками от вендоров. Честный ответ: нужны два источника, и они отвечают на разные вопросы.
Search Console API бесплатен, официальный и навсегда ограничен ресурсами, которые вы можете подтвердить. SERP API платный, неофициальный и может проверить любой запрос где угодно, включая запросы, по которым вы никогда не ранжировались. Ни один из них по отдельности не является трекером позиций. Вместе это примерно 120 строк Python и одна строка в cron.
Вот эта сборка. Она предполагает, что вы умеете запустить скрипт и сохранить файл. Она не предполагает, что вы хотите делать продукт.
Что у вас будет на выходе
Для кого это: для разработчика или технического маркетолога, у которого уже есть доступ к Search Console и который хочет получать позиции по расписанию, не платя за место.
Что будет у вас на руках по завершении: две рабочие функции выборки, один объединённый файл вывода на каждый запуск и правило сравнения, которое не даёт числам вам врать.
Время: около 90 минут на первую сборку, затем примерно 10 минут на разбор каждого запуска.
Как выглядит готовый результат: датированный JSON-файл с вашими позициями по запросам и устройствам, плюс живые снимки SERP для замороженного списка запросов, плюс короткий дифф к предыдущему запуску.
Перед началом: что каждый источник может и чего не может
Разделите правильно — и вся остальная сборка механическая. Разделите неверно — и вы потратите месяц на что-то либо бесполезное, либо дорогое.
Search Console API | SERP API | |
|---|---|---|
Чьи позиции | Только ваши подтверждённые ресурсы | Любые, включая конкурентов |
Запросы | Запросы, по которым вы уже показываетесь | Любой запрос, который вы введёте |
Стоимость | Бесплатно | Оплата за запрос |
Разбивка по устройствам | Есть, как измерение | Есть, на каждый запрос |
Локация | Страны, где вы ранжируетесь | Любая локация, которую поддерживает вендор |
Тип данных | Сводные клики, показы, позиция | Страница результатов на момент времени |
Историческая глубина | Запрошенный диапазон | Только с того дня, как вы начали хранить |
Официальный статус | Данные самого Google | Прочтение публичной страницы третьей стороной |
Два источника будут расходиться, и это расхождение — информация, а не баг. Search Console усредняет каждый показ по диапазону дат и по всем устройствам. Выборка SERP — это одна страница результатов в один момент. Если сравнивать их напрямую, вы будете гоняться за призрачными просадками. Именно поэтому шаг пятый определяет правило сравнения.
Три числа, которые стоит знать до того, как писать код. Search Console API принимает лимит строк от 1 до 25 000 на запрос и по умолчанию ставит 1 000, так что сайт среднего размера может вытащить три месяца данных по запросам и устройствам за один вызов. Он допускает 1 200 запросов в минуту на сайт и на пользователя. И он применяет квоты нагрузки, измеряемые десятиминутными отрезками, где длинный диапазон дат стоит дороже короткого — ровно поэтому руководство самого Google советует не запрашивать одни и те же данные повторно.
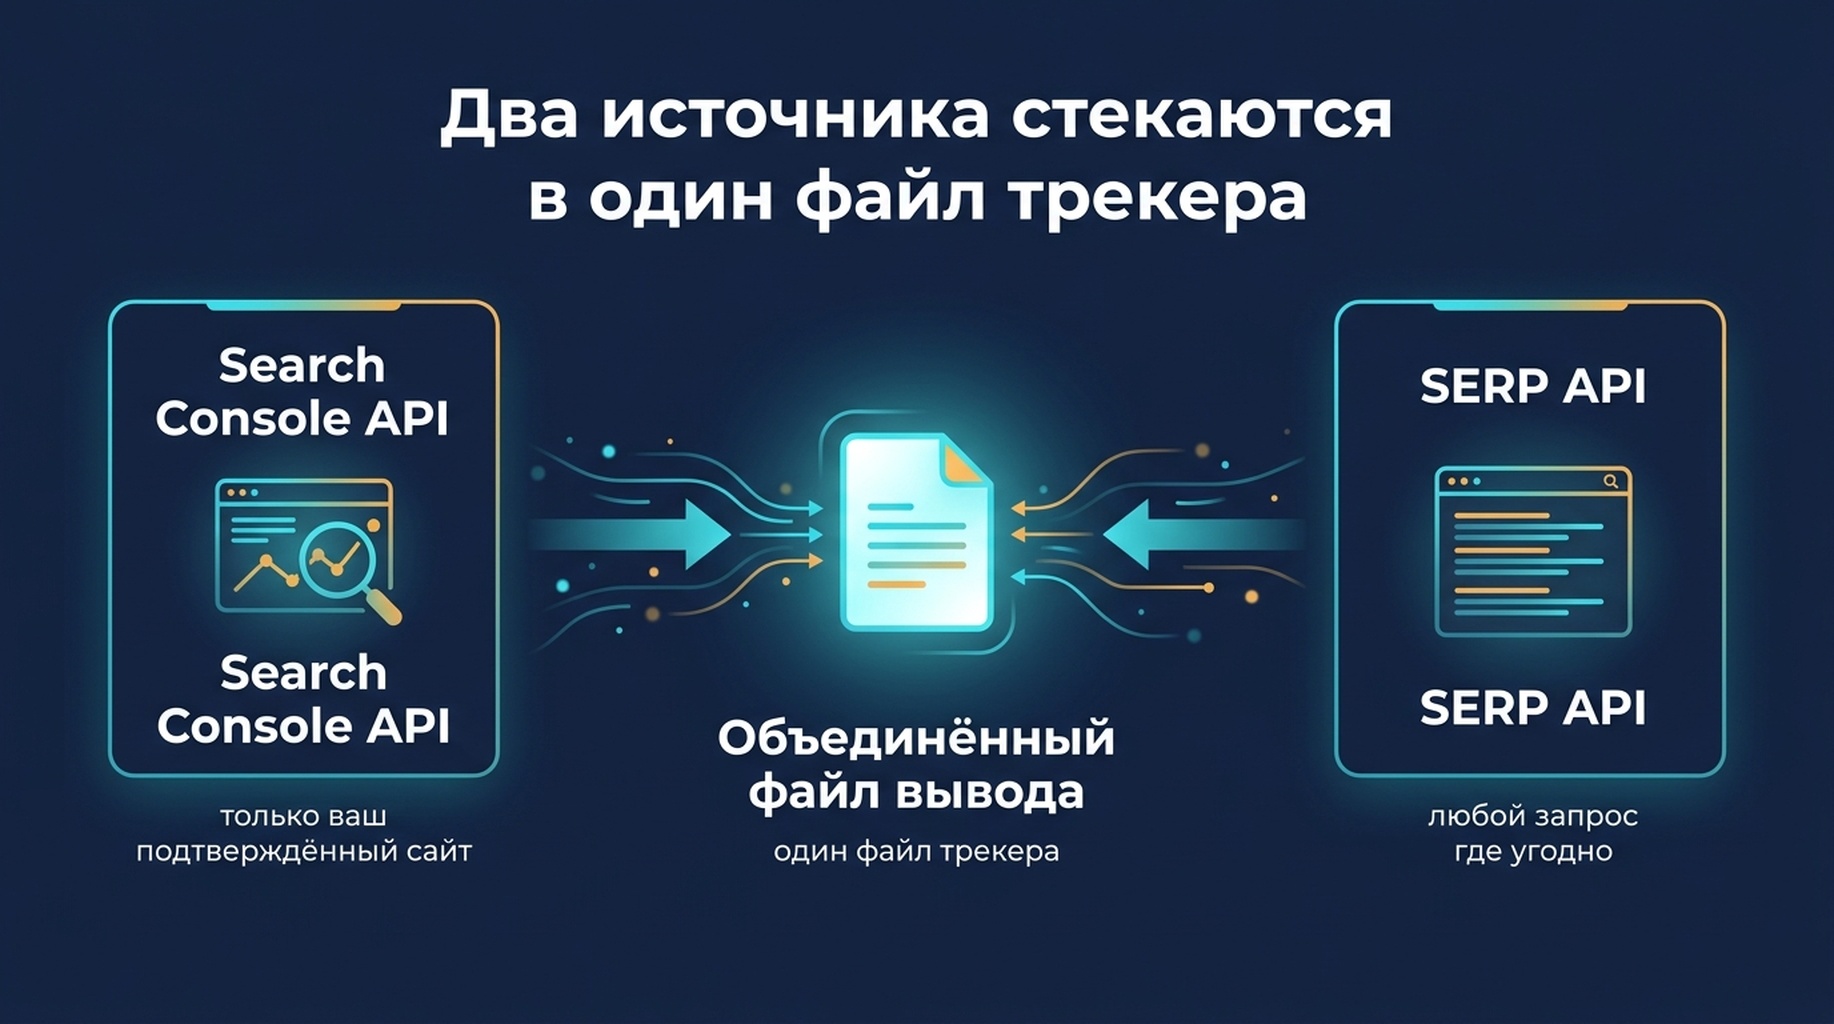
Два источника, один вывод. Search Console отвечает «где я показываюсь», SERP API отвечает «как выглядит страница».
Шаг 1: заморозьте набор запросов до того, как писать код
Трекер, который тянет разный список запросов в каждом запуске, не может ответить, изменилось ли что-нибудь. Сначала выберите список и держите его квартал.
Три группы, и берутся они из разных мест.
- Из Search Console: каждый запрос минимум с 20 показами за последние 90 дней. Их выбираете не вы; их выбирают ваши показы. Это группа, где движение что-то значит, потому что за ней уже стоит спрос.
- Из бизнеса: десять-двадцать запросов, которые связаны с выручкой, независимо от того, ранжируетесь вы по ним или ещё нет.
- Из конкурентов: запросы, по которым ранжируется конкурент, а вы нет. Для них нужен SERP API, потому что Search Console их никогда не покажет.
Запишите список в файл, ведите его версии и относитесь к добавлениям как к осознанному изменению, а не как к дрейфу.
Шаг 2: заберите свои позиции бесплатно
Эта половина официальная, бесплатная и даёт разбивку по устройствам и данные о кликах, которых нет ни у одного SERP API.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
Две детали в этом запросе делают почти всю работу.
dataState: "final" исключает свежие данные, которые Google может ещё пересмотреть. Без него последние два-три дня гуляют между запусками, и в вашем диффе появляются движения, которых не было.
dimensions: ["query", "device"] — это то, что делает вывод полезным позже. Добавить устройство сейчас не стоит ничего. Повторно тянуть три месяца истории потом стоит полного запуска и не даёт ничего за те дни, которые вы уже пропустили.
Ожидаемый вывод: по одной строке на запрос и устройство, с кликами, показами, CTR и средней позицией.
Проверка качества: число строк должно быть меньше 25 000. Если оно ровно 25 000, вас обрезали и нужен второй вызов с startRow: 25000.
Если не получилось: 403 обычно означает, что письмо сервисного аккаунта так и не добавили пользователем на ресурс. Добавьте его в Search Console, подождите несколько минут, повторите.
Шаг 3: заберите SERP, которых не видно в ваших данных
Вторая половина покрывает всё, чего Search Console структурно не может. Это минимальный рабочий вызов.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
Ставьте `depth` в 100, а не в 200. Мы проверили это в сентябре 2026 года, запросив по 200 результатов для шести запросов. Google вернул от 83 до 128 органических результатов и остановился, а самая глубокая позиция за весь тест была 142. Полный тест здесь. Запрос на 200 не даёт 200 результатов, и в зависимости от вендора вам, возможно, всё равно выставят счёт за запрошенную глубину. Запросите 100 — и вы почти всегда получите всё, что существует.
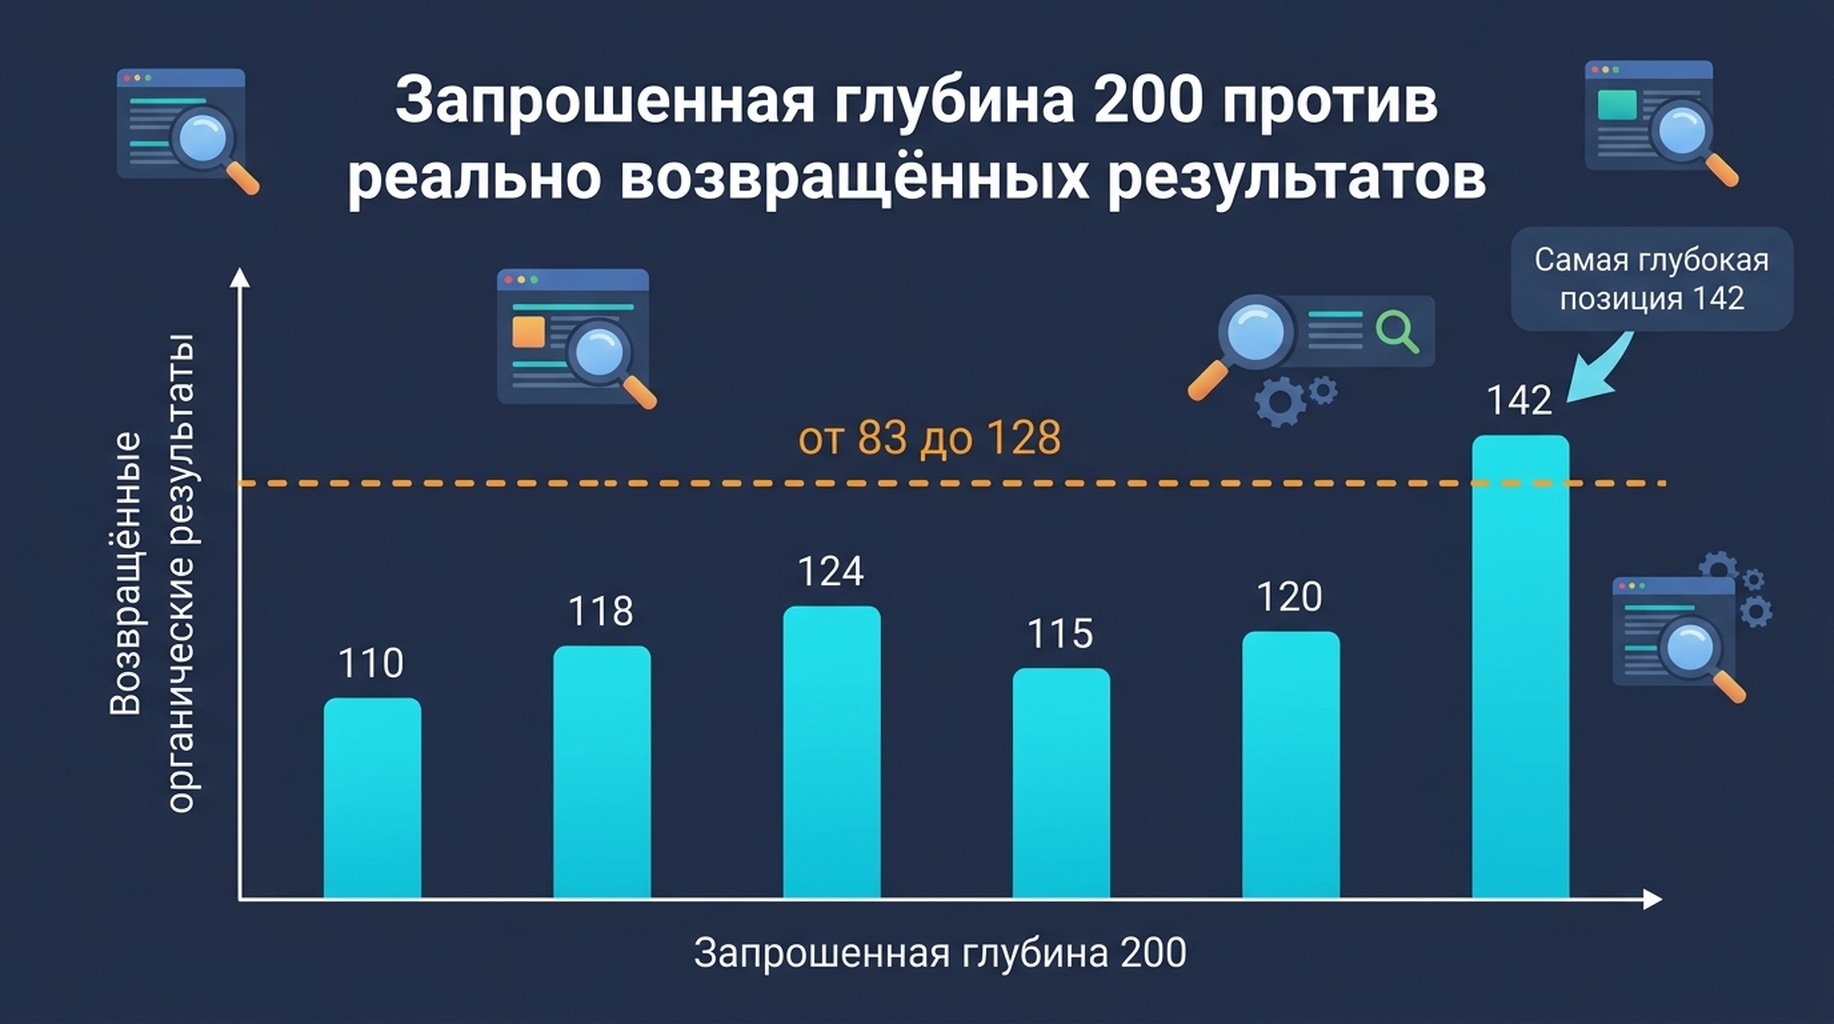
Запрашиваем 200 результатов, получаем от 83 до 128. Глубина выше примерно 140 на большинстве коммерческих запросов не покупает ничего.
Ожидаемый вывод: JSON-полезная нагрузка с органическими элементами, содержащими позицию, URL, заголовок и домен.
Проверка качества: убедитесь, что нагрузка содержит тип элемента ai_overview, когда он есть. Если извлекать только элементы organic, вы пропустите причину, по которой страница потеряла клики, удержав позицию.
Если не получилось: 401 — это ошибка base64 или учётных данных. Код вида 40200 означает, что баланс аккаунта пуст, и это самый частый сбой в первый месяц.
Шаг 4: храните сырую нагрузку, а не сводку
Это то решение, о пропуске которого люди жалеют.
Хранение таблицы позиций работает, пока вам не понадобится задать вопрос, которого вы не предвидели: стала ли выдача длиннее, забрало ли всё видео, вошёл ли конкурент, появился ли AI Overview выше линии сгиба. Сводка на это не ответит. Сырая нагрузка ответит, при нулевых дополнительных затратах.
Практический вариант: пишите по одному файлу на запуск, с именем по дате и времени, содержащему объединённый вывод. Храните последние 90 дней. Этого достаточно мало, чтобы жить в репозитории, и достаточно полно, чтобы заново отвечать на старые вопросы.
Шаг 5: напишите правило сравнения до того, как что-то планировать
Трекер, который сравнивает прошлый запуск с текущим, в большинстве дней выдаёт ложную тревогу. Наши собственные числа показывают почему: по 124 запросам минимум с 30 показами средний запрос смещался на 4.57 позиции за сутки. Падение на четыре позиции — это вторник.
Значит, правилу нужны порог и направление.
Сообщать о запросе только когда:
  - абсолютное изменение позиции к предыдущему запуску равно 5 или больше, И
  - у запроса было минимум 20 показов в окне сравнения, И
  - изменение не объясняется сдвигом в составе устройств

Группировать вывод по классу запроса: money, comparison, brand, informational.
Не предлагать исправления.
Оговорка про устройства — не украшение. Один и тот же запрос может стоять на 11 позиций по-разному на мобильном и десктопе, и если состав устройств между запусками сдвинется, смешанное число тоже сдвинется. Мы измерили это отдельно, и величина достаточно велика, чтобы подделать тренд.
Сколько это стоит
Цены вендоров меняются, так что стройте модель, а не гоняйтесь за коммерческим предложением.
- Один запрос, проверяемый раз в день 30 дней, — это 30 запросов в месяц.
- Набор из 200 запросов, проверяемый ежедневно, — это 6 000 запросов в месяц.
- Тот же набор, проверяемый еженедельно, — около 860 запросов в месяц.
- Половина Search Console бесплатна и представляет собой один запрос на представление, сколько бы запросов внутри него ни было.
Это умножение и есть всё решение. Почти любой вопрос «стоит ли покупать инструмент» сводится к нему: посчитайте запросы в месяц, умножьте на свою цену за запрос и сравните с лицензией за место. Ежедневное отслеживание большого набора обычно дешевле по подписке. Еженедельное отслеживание небольшого набора обычно дешевле через API. Отслеживайте замороженный список — и сторона API останется небольшой.
Когда покупать, а не строить
Стройте, если хотите позиции в собственном пайплайне, если у вас уже есть учётные данные SERP API или если сырая страница результатов нужна вам по причинам помимо позиции.
Покупайте, если нужны исторические позиции до сегодняшнего дня, если нужны десять локаций и пять устройств для одних и тех же запросов, или если в команде никто не будет поддерживать cron. Подборки вендоров стоит читать ровно по этой причине, и у владения инфраструктурой, которая останавливается, когда её автор переходит в другую команду, есть реальная цена.
Если нужный вам результат — письменный недельный отчёт, а не JSON-файл, отчётный процесс в Codex начинается с тех же двух источников и заканчивается документом. Для оповещений поверх файла руководство по проектированию мониторинга разбирает пороги.
Мнение Auspia: вопрос про API отслеживания позиций на самом деле вопрос владения данными. Search Console даёт официальные данные о вашем ресурсе бесплатно и всегда будет давать. Всё остальное — снимок, за который вы платите. Сначала постройте бесплатную половину, а платную добавляйте только там, где она отвечает на вопрос, который у вас действительно есть.
Частые вопросы
Предлагает ли Google API для отслеживания позиций? Публичного — нет. Search Console API возвращает вашу среднюю позицию по запросам, по которым вы уже показываетесь; это близко, но не то же самое. Он не может проверить запрос, по которому вы не ранжируетесь, и не может проверить конкурента.
Насколько глубоко может зайти SERP API? Вендоры примут значения глубины намного выше 200, но Google перестаёт отдавать результаты где-то между 100 и 140 на большинстве коммерческих запросов. Запрос большего не даёт большего числа результатов.
Что использовать — ежедневные или еженедельные проверки? Еженедельные для обычного набора запросов. Ежедневные — только для короткого списка денежных запросов. Ежедневные проверки большого набора умножают стоимость на семь и в основном измеряют шум, поскольку среднее суточное смещение в наших данных было 4.57 позиции.
Почему моё число из API отличается от моего трекера позиций? Другие устройства, другие локации, другие моменты и часто другие источники данных. Число — это выборка. Зафиксируйте локацию и устройство в запросе и перетяните данные, прежде чем делать вывод, что что-то изменилось.
Может ли агент запускать это за меня? Да, и это хорошо подходит, потому что у задачи одна и та же форма в каждом запуске. Более широкая картина того, что агент может взять на себя в работе с позициями, — в практическом руководстве по SEO-агенту. Держите правило сравнения в письменном файле инструкций и позвольте агенту создавать дифф; решение «строить или покупать» оставьте человеку.
Автор: Rowan Blake, аналитик по автоматизации контента в Auspia, отвечает за более чем 100 издательских пайплайнов. Пишет об автоматизированных пайплайнах данных, отчётности по расписанию и стоимости поддержки систем, которые работают без вас.