A maioria das equipes que dizem "fazer SEO agêntico" na verdade cola um prompt longo em uma janela de chat. Na primeira vez funciona. O problema começa na segunda: a estrutura da resposta muda, os dados têm uma semana de atraso e ninguém consegue dizer se os números se moveram ou se o prompt derivou.
A versão que aguenta se diferencia em um único ponto: o método mora em um arquivo, não na sua mensagem. Você escreve o procedimento uma vez, entrega a um agente e, a partir daí, as mesmas verificações rodam em toda execução, tenha você lembrado de pedi-las ou não.
É essa a ideia inteira. O que vem a seguir é como montar isso, qual agente combina com cada tarefa e onde tudo quebra em silêncio.
O que o "agêntico" realmente muda
Há três coisas que dá para automatizar, e elas não são a mesma coisa.
Automação de fluxo | SEO assistido por IA | SEO agêntico | |
|---|---|---|---|
Quem escolhe as etapas | Você, com antecedência | Você, a cada conversa | Você, uma vez, em um método escrito |
De onde vêm os dados | Integrações já conectadas | O que você cola | O agente busca sozinho |
Diante de uma entrada inesperada | Quebra | Depende da sua formulação | Segue uma regra ou escala o caso |
Consistência entre execuções | Perfeita e rígida | Baixa | Alta e, ainda assim, adaptável |
Melhor para | Tarefas em massa e sem variação | Exploração e perguntas pontuais | Análise recorrente que exige julgamento |
A diferença prática aparece no que você deixa de fazer. Em um fluxo de chat, você reexplica o site, o público, as regras de prioridade e o formato de saída toda vez. Cada reexplicação é uma chance de esquecer alguma coisa. Em um fluxo agêntico, tudo isso vive em arquivos que o agente lê a cada execução, e seu prompt encolhe para uma linha: rode a checagem de degradação de conteúdo de setembro.
Isso também tem um custo. Se a tarefa é realmente diferente toda vez, não há método a escrever, e montar tudo é esforço sem retorno. Verificar o código de status de 50.000 URLs é trabalho de script, não de agente. A linha divisória são duas perguntas: a tarefa se repete e ela exige julgamento? Se sim para as duas, o agêntico ganha. Se uma delas falhar, não vale a pena.
As quatro camadas e o papel de cada uma
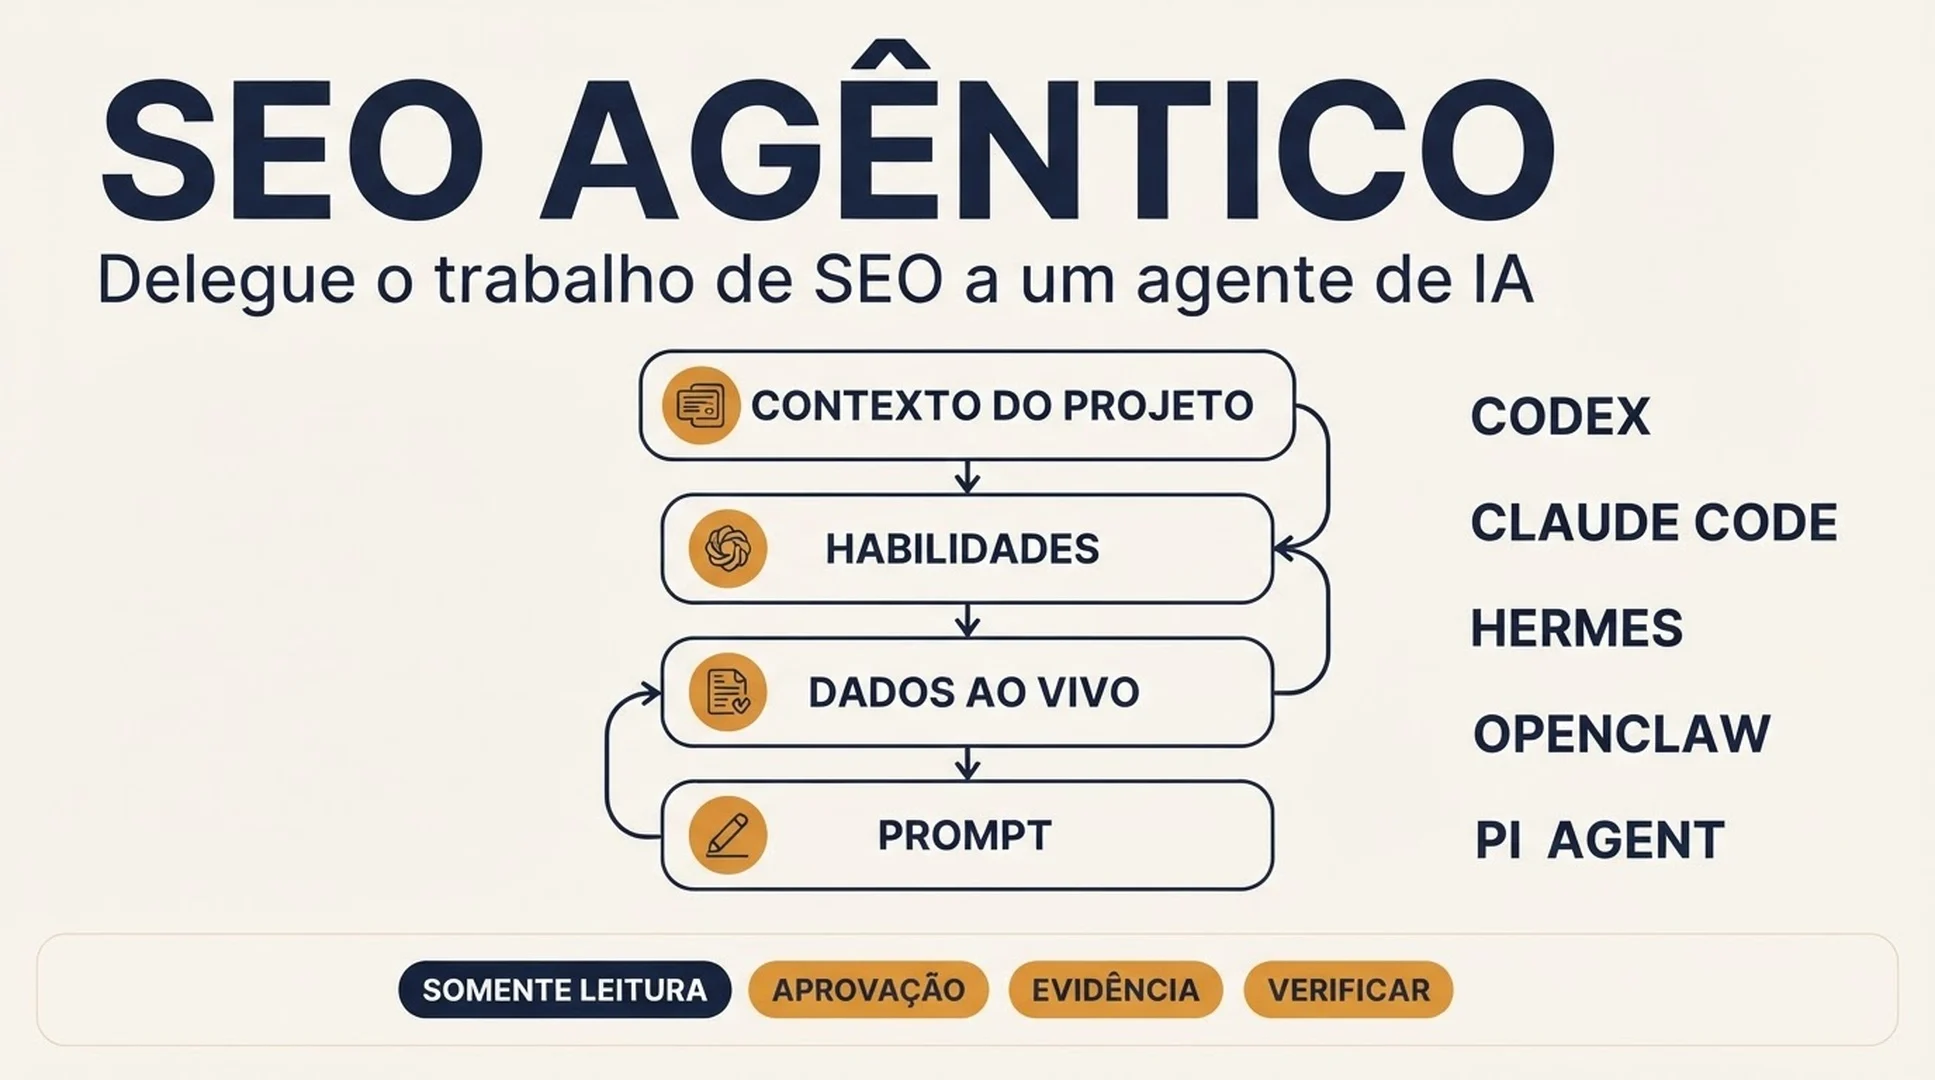
Toda configuração de SEO agêntico que sobrevive tem as mesmas quatro peças. Tire uma e você obtém um tipo previsível de falha.
Contexto do projeto. Uma pasta com o que não muda: o site, os mercados atendidos, quem compra e por quê, o que conta como conversão, quem são os concorrentes reais, as regras editoriais. É isso que impede o agente de escrever conselhos genéricos para um negócio que ele não entende. Pule essa camada e você recebe uma saída confiante, plausível e inútil.
Habilidades. Procedimentos escritos. Cada uma diz quando usar, de quais dados precisa, a ordem das etapas, as regras de pontuação, o formato de saída e quais ações exigem sua aprovação. É essa camada que torna o fluxo repetível, e é a que a maioria das equipes pula.
Acesso a dados ao vivo. Conexões que permitem ao agente buscar os números atuais em vez de esperar você exportar e colar. Search Console para o seu próprio desempenho. Analytics para o comportamento. Uma fonte de posições ou de SERP para o que você não vê no próprio domínio. Um crawler ou uma conexão com o CMS para fatos no nível da página. Sem essa camada, você tem um analista excelente trabalhando com a planilha do mês passado.
O prompt. A tarefa atual, nada mais. Se o seu prompt carrega contexto ou método, eles pertencem à primeira e à segunda camada.
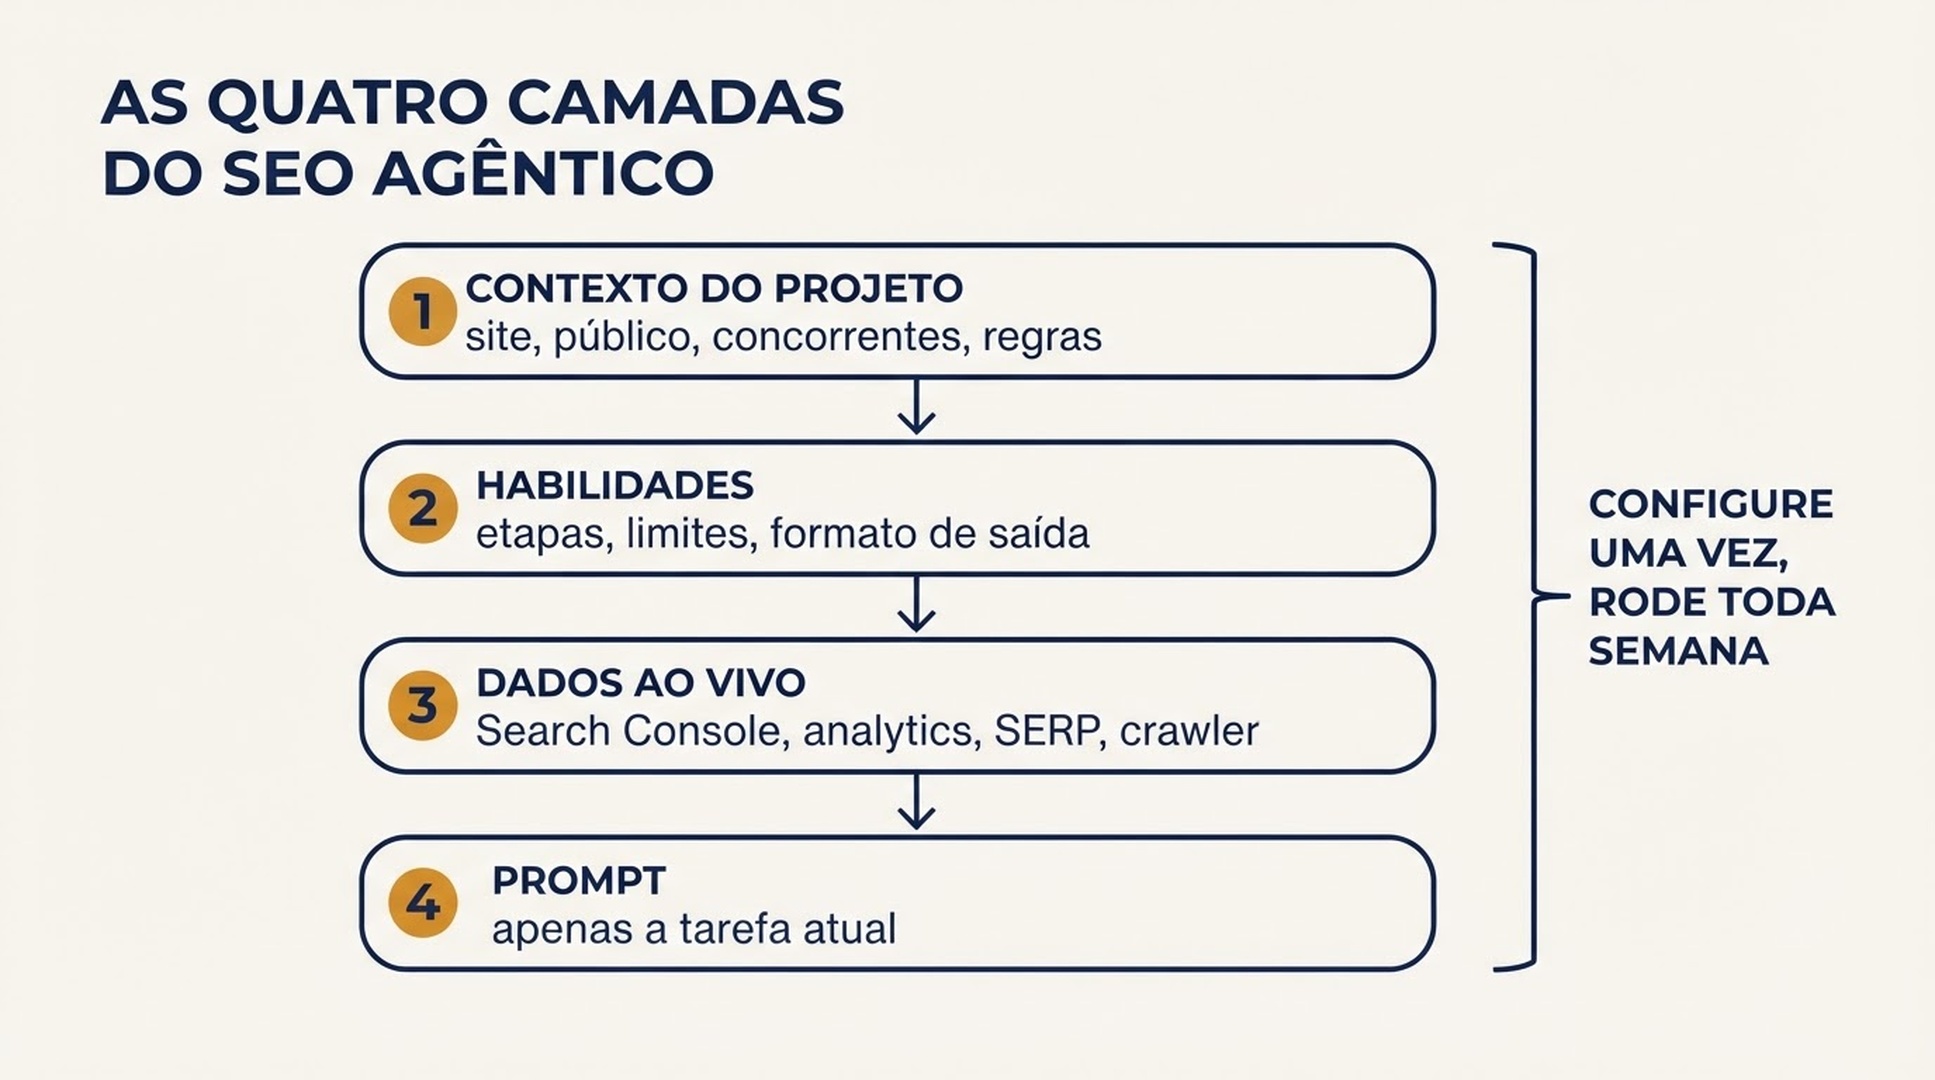
Configure as quatro camadas uma vez e a execução semanal se resume a uma linha. Quando o resultado sai errado, verifique qual camada falhou antes de reescrever o prompt.
A visão da Auspia: o modelo de quatro camadas é a ideia mais útil desta categoria e, ao mesmo tempo, o ponto onde a maioria das equipes para cedo demais. Elas criam a pasta de contexto, pulam as habilidades e terminam com um chatbot bem informado. O produto é a habilidade. Todo o resto é encanamento.
Qual agente para qual tarefa
É a pergunta que mais recebemos, e a resposta honesta é que as diferenças importam menos do que a configuração. Tudo o que está aqui dá conta da maioria das tarefas de SEO se você insistir o suficiente. O que os separa é onde cada um é menos desajeitado, e isso decide se você ainda vai estar usando na terceira semana.
Agente | Mais forte em | Modelo de acesso | Primeira tarefa de SEO sensata |
|---|---|---|---|
Codex | Trabalho em repositório, execuções agendadas, mudanças revisáveis | Arquivos locais, terminal, git, automação | Guardar os instantâneos semanais em um repositório e abrir um pull request com o relatório |
Claude Code | Revisão de contexto longo contra uma política escrita explícita | Terminal, arquivo de memória do projeto, conectores MCP | Ler exportações do Search Console e o código da página e emitir um veredito documentado |
Hermes Agent | Habilidades repetíveis com memória entre sessões | Agente de código aberto com sistema de habilidades e memória persistente | Instalar uma habilidade e rodar o mesmo fluxo na mesma cadência |
OpenClaw | Coleta de evidências no navegador sob permissões rígidas | Navegador primeiro, arquivos locais depois | Capturar o que a busca realmente devolve no celular e parar por aí |
Pi Agent | Continuar pequeno e previsível por meses | Núcleo mínimo, habilidades em Markdown como ponto de extensão | Rodar um procedimento estreito e legível onde você quer auditar tudo o que ele faz |
Duas ressalvas. Esta categoria muda todo mês, então verifique os limites e preços atuais na documentação oficial de cada fornecedor antes de comprometer uma equipe. E esta tabela é um ponto de partida, não um<|placeholdermmspan0442|> teto.
Para cada um, temos um guia de início seguro: Codex, Claude Code, Hermes Agent e OpenClaw. Os quatro seguem o mesmo formato: primeiro somente leitura, uma mudança aprovada por vez, verificar antes de publicar.
A regra prática de escolha depende de onde o seu trabalho já está. Se o site está em um repositório git e as mudanças de página são mudanças de código, comece pelo Codex ou pelo Claude Code. Se o trabalho é sobretudo exportações, conversas e julgamento, comece por um agente baseado em habilidades. Se você precisa ver o que um navegador real devolve, precisa de acesso a navegador e um limite de permissões rígido. Se quer a menor superfície possível, que dá para ler do começo ao fim de uma sentada, o núcleo mínimo do Pi Agent foi desenhado exatamente para isso, e o preço é que tudo o que você precisa vive em uma habilidade que você mesmo adiciona.
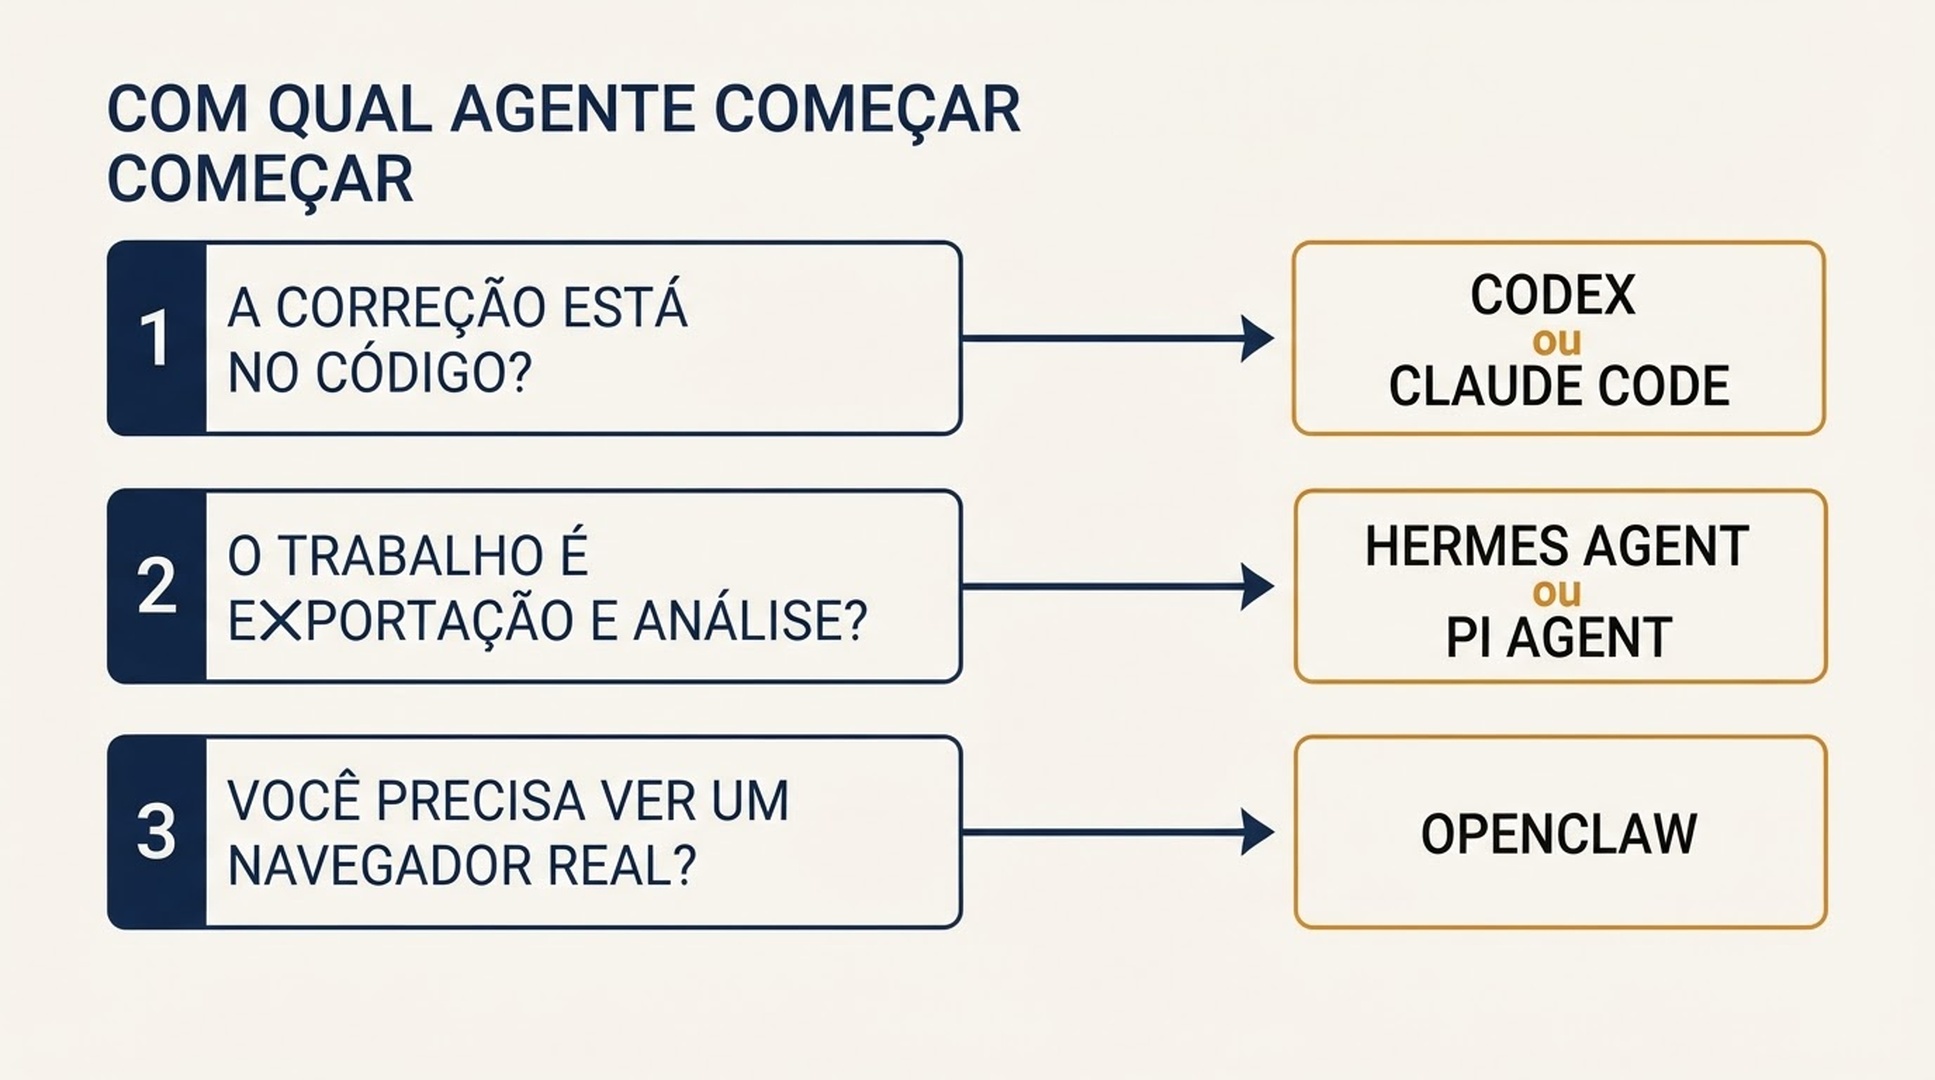
Três perguntas reduzem cinco agentes a um. Responda a elas antes de comparar listas de recursos.
As tarefas que valem delegar primeiro
Não comece pela interessante. Comece pela chata, que se repete em um calendário e produz algo que alguém lê. Essas se pagam mais rápido.
Triagem de degradação de conteúdo. Pegue o desempenho período contra período, descarte tudo abaixo do limite de materialidade, verifique a indexação antes de qualquer outra coisa e depois olhe posições, demanda, links e canibalização. Você recebe uma tabela de URLs com cliques perdidos, a causa provável, a evidência e uma ação principal e uma alternativa. Uma página que perdeu posições precisa de reescrita. Uma que perdeu demanda não precisa de nada. Uma que perdeu o canonical se resolve em cinco minutos. As equipes confundem esses três casos o tempo todo, e a confusão não sai barata.
Triagem de problemas técnicos. Agrupe os problemas por causa raiz em vez de por tipo, cruze as URLs afetadas com tráfego e posições, pontue o impacto contra o esforço e verifique os primeiros itens em páginas reais antes de escrever a lista de correções. O valor está nesse agrupamento. Dez linhas de "redirecionamento temporário" costumam ter uma única causa raiz, e consertar um template vale mais do que consertar dez URLs.
Movimentos da concorrência. Isolar as páginas e palavras-chave por trás de uma variação de tráfego, separar o que é marca do que não é e testar cada mudança contra um fator nomeado: conteúdo novo, posições melhores, sazonalidade, uma migração ou um artefato de dados. A resposta são o fator e o nível de confiança. Um número grande com confiança baixa é motivo para olhar de perto, não para reagir.
Links internos e páginas órfãs. Monte um conjunto de candidatas a partir de páginas que já ranqueiam ou ganham links, encontre os trechos diretamente relacionados a cada destino e aplique um teste de valor para o leitor: alguém no meio desta frase realmente iria querer ir até lá? A metade estrutural do resultado costuma valer mais do que os próprios links. Descobrir que a segunda maior página não tem nenhum link interno apontando para ela é uma correção de cinco minutos com efeito desproporcional.
Mapeamento de lacunas de citação. Agrupe os prompts por tema e estágio de compra, encontre os domínios e páginas mais citados, separe os tipos de fonte e leia as páginas citadas para deduzir o que realmente renderia uma menção. Conte com uma boa parte do resultado sendo fontes onde a resposta certa é não procurar ninguém. Fóruns e propriedades da concorrência não são alvos de outreach.
Checagem de regressão pós-lançamento. Compare um crawl antes e outro depois com as mesmas configurações, confirme que são comparáveis antes de diferenciar qualquer coisa e classifique cada diferença como esperada, esperada mas mal implementada ou não planejada. É essa classificação que torna o relatório utilizável. Sem ela, sobra uma parede de diferenças e nenhuma decisão.
Sobre as que mais aparecem, temos guias mais detalhados: relatórios semanais de posições, monitoramento diário, trabalho de perfil de links e desenho de alertas que não afogam você.
Comece com uma habilidade, não com um departamento
A falha mais comum é montar oito habilidades, sete conexões e um agendador antes de ter executado qualquer coisa uma única vez. Aí nada funciona e não fica claro qual das dezesseis peças é a culpada.
Faça nesta ordem.
Escolha uma tarefa com resultado visível. A mais rápida de validar é a triagem de problemas técnicos, porque você pode apontá-la para um crawl que já tem e julgar o resultado em minutos. A degradação de conteúdo é a segunda mais fácil se você tiver histórico no Search Console.
Escreva a habilidade antes de conectar qualquer coisa. O arquivo da habilidade deve caber em uma página e responder a seis perguntas: quando usar, de quais dados precisa, a ordem das etapas, as regras de pontuação ou limites, o formato de saída e quais ações exigem aprovação. Se não couber em uma página, a tarefa ainda não está definida com clareza suficiente para ser automatizada.
Conecte uma única fonte de dados. A que a habilidade realmente precisa. Conectores que você não usa só aumentam a superfície sem agregar valor.
Rode em modo somente leitura e confira a saída na mão. Pegue dois achados e verifique você mesmo contra os dados de origem. Se a explicação do agente não bate com o que você vê, o problema está na habilidade, não no modelo.
Adicione o portão de aprovação antes de adicionar a segunda habilidade. Toda ação de escrita (publicar, redirecionar, excluir, editar código, fazer merge, enviar mensagens externas) deve parar e esperar. Crie esse hábito enquanto a aposta é uma única habilidade.
As salvaguardas que evitam que dê errado
Estas são as regras que colocaríamos nas instruções do projeto no primeiro dia. São chatas de propósito, e é esse o ponto.
- Mantenha as ferramentas de produção somente leitura até você aprovar uma ação de escrita.
- Exija um plano antes de começar qualquer fluxo de várias etapas.
- Obtenha evidência com as ferramentas conectadas em vez de se apoiar em suposições.
- Siga a habilidade correspondente quando ela existir, em vez de improvisar.
- Se uma chamada de ferramenta falhar, tente uma vez e depois mostre o erro em vez de contorná-lo.
- Exija que cada achado justifique sua evidência em uma frase.
- Separe achados confirmados de hipóteses, na própria saída.
- Sinalize dados ausentes e conclusões de baixa confiança em vez de preencher a lacuna.
- Pare quando o fluxo ultrapassar um limite acordado de URLs, linhas ou unidades de API.
- Peça aprovação antes de publicar, redirecionar, excluir, editar código, fazer merge ou enviar algo para fora.
Duas delas fazem mais trabalho que o resto. Separar achados confirmados de hipóteses é o que torna a saída confiável o bastante para agir sobre ela. O limite de gasto é o que impede um loop mal configurado de queimar o orçamento de API durante a noite.
Onde isso quebra
Dados de conversão escassos. Um motor de decisão de portfólio de conteúdo que classifica cada URL como manter, atualizar, consolidar, redirecionar, remover ou investigar precisa de dados de conversão para decidir. Se o rastreamento não estiver bem configurado, ele devolve muitos zeros, e o relatório não serve até isso ser corrigido. O agente fez o trabalho dele. A entrada estava errada.
Julgamento estrutural. Um agente consegue encontrar quatro coisas que um briefing humano deixou passar, incluindo uma palavra-chave que traz um tipo completamente diferente de resultado e por isso não deveria estar naquela página. Mas ele não consegue decidir como estruturar o artigo. Essa decisão fica com uma pessoa, e fingir o contrário produz conteúdo que parece montado a partir de peças.
Erros silenciosos de explicação. Agentes falham alto na etapa de dados e baixo na etapa de explicação. Uma exportação ausente gera erro. Uma causa errada dita com confiança, não. É por isso que a regra da evidência por achado importa mais do que parece.
Lacunas de ferramenta que você não previu. Alguns dados simplesmente não são acessíveis por um conector. Um conector de dados de posição pode não conseguir criar um projeto de crawl, disparar um crawl ou exportar o conjunto completo de URLs rastreadas. Projete o fluxo em torno do que a conexão consegue realmente devolver, ou a habilidade trava no meio do caminho.
Verifique o resultado antes de confiar no loop
Rode esta checagem nas três primeiras vezes e, depois, uma vez por mês.
- Escolha dois achados ao acaso e verifique-os na mão contra os dados de origem.
- Confirme que o agente citou uma fonte e uma data em cada afirmação que depende de dados.
- Verifique se ao menos um achado está marcado como de baixa confiança. Um agente confiante em tudo não está discriminando.
- Confirme que a forma da saída bate com a execução anterior. Se derivou, o arquivo da habilidade mudou ou o agente parou de segui-lo.
- Confirme que nada foi escrito, publicado ou enviado sem que um portão de aprovação tenha disparado.
Se os cinco passarem três execuções seguidas, você tem um fluxo de trabalho. Se algum falhar, conserte a camada que causou isso em vez de reescrever o prompt.
Perguntas frequentes
O que é SEO agêntico? SEO agêntico é entregar um fluxo de trabalho de SEO definido a um agente de IA que busca os próprios dados, segue um método escrito e devolve uma análise com a mesma forma em toda execução. A característica decisiva não é a autonomia, e sim a repetibilidade: o método vive fora da conversa, então as mesmas verificações se aplicam tenha você lembrado de pedi-las ou não.
Como isso difere do SEO assistido por IA? A diferença está em quem decide o que acontece em seguida. No SEO assistido por IA, você escolhe as etapas em cada conversa e cola os dados. No SEO agêntico, você define o método uma vez, o agente busca os próprios dados e, diante de uma entrada inesperada, segue uma regra documentada. A automação de fluxo é uma terceira coisa: consistência perfeita sem adaptabilidade.
Preciso de um agente de programação? Não. Agentes como Codex e Claude Code se encaixam melhor quando a correção é uma mudança de código ou o site vive em um repositório. Se o seu trabalho é sobretudo exportações, análise e julgamento, um agente baseado em habilidades cobre isso sem tocar no terminal.
Quantas habilidades devo criar primeiro? Uma. Escolha uma tarefa com resultado visível, escreva a habilidade para caber em uma página, conecte apenas a fonte de dados de que ela precisa e rode em somente leitura até a saída ser confiável. Equipes que criam oito habilidades sem ter executado nenhuma costumam abandonar o projeto.
Um fluxo de SEO agêntico pode publicar conteúdo sozinho? Pode, e não deveria. Mantenha publicação, redirecionamentos, exclusão, edição de código, merges e mensagens externas atrás de um portão de aprovação explícito. O valor do fluxo está na evidência que ele reúne, não na permissão que ele tem.
Quanto custa rodar isso? Depende das fontes de dados, não do agente. O Search Console é gratuito para o seu próprio domínio. O custo recorrente está nos dados de posição, nos dados de SERP e nos serviços de crawl, e a maioria tem planos gratuitos suficientes para validar um fluxo antes de você se comprometer.
Autor: Aaron Wolfe, Designer de Sistemas de Crescimento Orgânico na Auspia, com 15 anos de experiência em SEO/GEO. Ele escreve sobre como as equipes integram agentes de IA, dados e etapas de revisão em fluxos de busca que sobrevivem a um ciclo de planejamento trimestral.