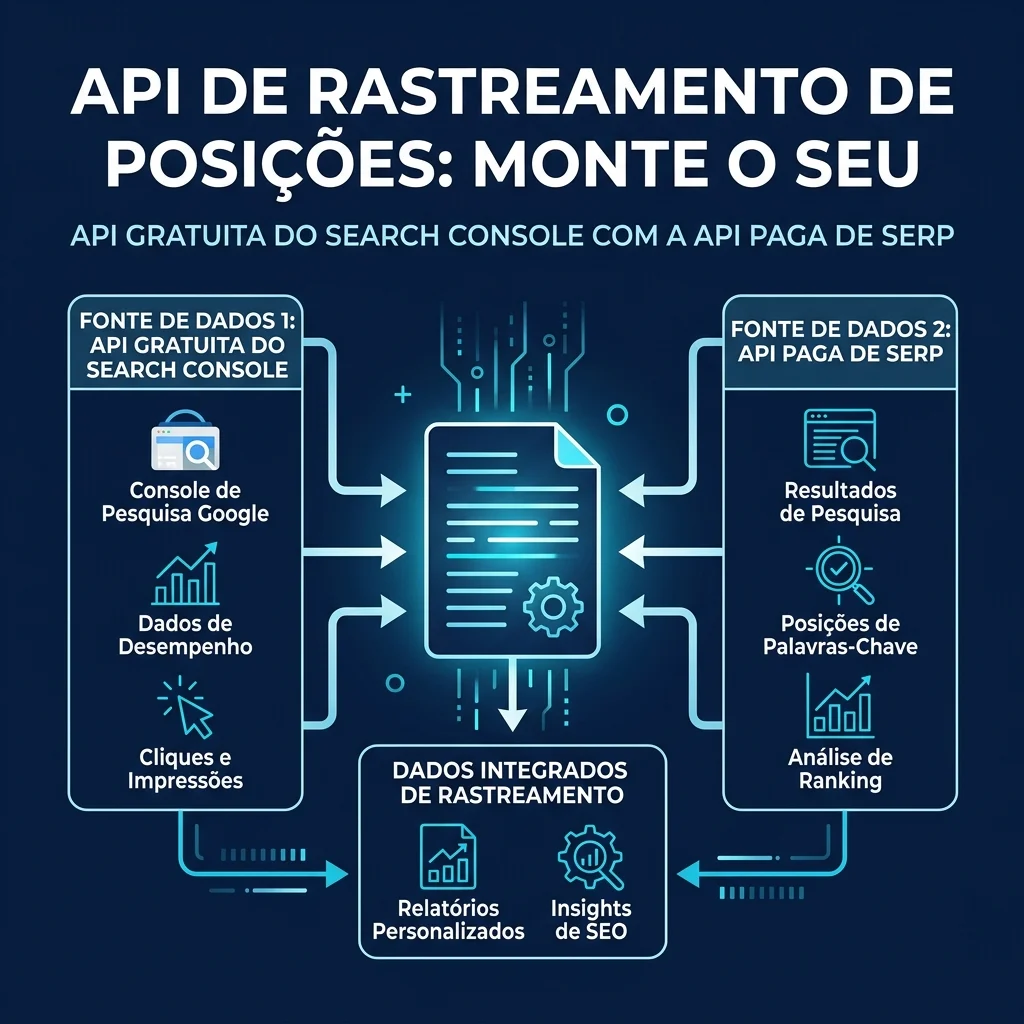
Uma API de rank tracking não é uma coisa só. O desenvolvedor que pesquisa "rank tracking API" normalmente quer um único endpoint que devolva posições, e o mercado responde com listas de fornecedores. A resposta honesta é que você precisa de duas fontes, e elas respondem a perguntas diferentes.
A API do Search Console é gratuita, oficial e permanentemente limitada às propriedades que você consegue verificar. Uma API de SERP é paga, não oficial e consegue checar qualquer palavra-chave em qualquer lugar, inclusive palavras-chave para as quais você nunca ranqueou. Nenhuma das duas sozinha é um rank tracker. Juntas, são cerca de 120 linhas de Python e uma entrada no cron.
Esta é a construção. Ela pressupõe que você consegue rodar um script e guardar um arquivo. Não pressupõe que você queira construir um produto.
Com o que você termina
Para quem é: um desenvolvedor ou profissional de marketing técnico que já tem acesso ao Search Console e quer posições em uma periodicidade sem pagar por assento.
O que você terá ao terminar: duas funções de coleta funcionando, um arquivo de saída mesclado por execução e uma regra de comparação que impede os números de mentirem para você.
Tempo: cerca de 90 minutos na primeira montagem, depois aproximadamente 10 minutos de revisão por execução.
Como é o pronto: um arquivo JSON datado contendo suas posições por consulta e dispositivo, mais capturas ao vivo de SERP para uma lista congelada de palavras-chave, e um diff curto contra a execução anterior.
Antes de começar: o que cada fonte pode e não pode fazer
Acerte essa divisão e o resto da construção será mecânico. Erre e você vai passar um mês construindo algo inútil ou caro.
API do Search Console | API de SERP | |
|---|---|---|
Posições de quem | Apenas suas propriedades verificadas | Qualquer um, inclusive concorrentes |
Palavras-chave | Consultas em que você já aparece | Qualquer palavra-chave que você digitar |
Custo | Gratuito | Cobrado por requisição |
Divisão por dispositivo | Sim, como dimensão | Sim, por requisição |
Local | Países em que você ranqueia | Qualquer local que o fornecedor suporte |
Tipo de dado | Cliques, impressões e posição agregados | Página de resultados em um instante |
Profundidade histórica | O intervalo que você pedir | Apenas desde o dia em que começou a armazenar |
Status oficial | Dados do próprio Google | Leitura de terceiro sobre uma página pública |
As duas fontes vão discordar, e essa discordância é informativa, não um bug. O Search Console faz a média de toda impressão ao longo do intervalo de datas e de todos os dispositivos. Uma coleta de SERP é uma página de resultados em um momento. Se você comparar as duas diretamente, vai caçar quedas fantasma, e é por isso que o passo cinco define uma regra de comparação.
Três números que vale conhecer antes de escrever código. A API do Search Console aceita um limite de linhas entre 1 e 25.000 por requisição e usa 1.000 como padrão, então um site de porte médio consegue puxar três meses de dados de consulta e dispositivo em uma única chamada. Ela permite 1.200 consultas por minuto por site e por usuário. E aplica cotas de carga medidas em blocos de 10 minutos, em que um intervalo de datas longo custa mais que um curto — exatamente por isso a orientação do próprio Google diz para evitar reconsultar os mesmos dados.
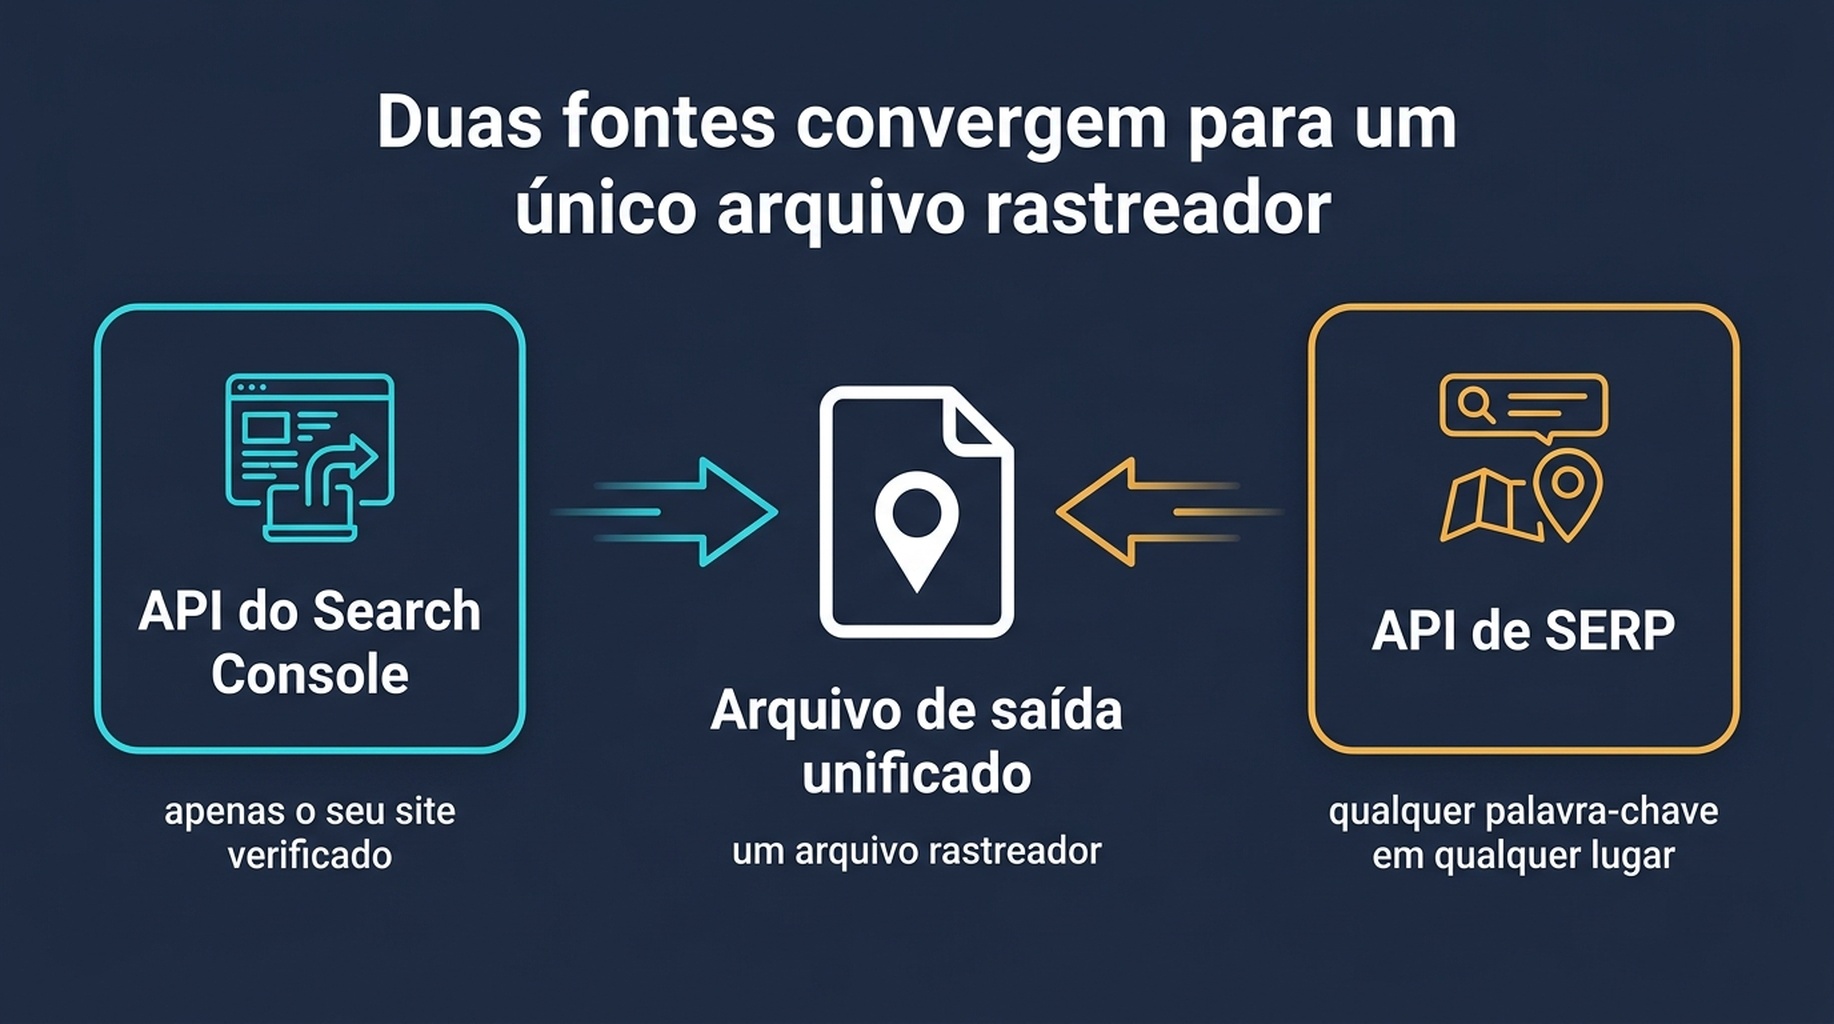
Duas fontes, uma saída. O Search Console responde "onde eu apareço", uma API de SERP responde "como a página se parece".
Passo 1: congele o conjunto de palavras-chave antes de escrever qualquer código
Um tracker que puxa uma lista de palavras-chave diferente a cada execução não consegue responder se algo mudou. Escolha a lista primeiro e mantenha-a por um trimestre.
Três grupos, e eles vêm de fontes diferentes.
- Do Search Console: toda consulta com pelo menos 20 impressões nos últimos 90 dias. Você não escolhe essas; suas impressões escolhem. É o grupo em que movimento significa algo, porque já existe demanda atrelada.
- Do negócio: as dez a vinte consultas que se ligam a receita, ranqueando você para elas ou não.
- Dos concorrentes: as consultas para as quais um concorrente ranqueia e você não. Essas exigem uma API de SERP, porque o Search Console nunca vai mostrá-las.
Escreva a lista em um arquivo, versione-a e trate adições como mudança deliberada, não como deriva.
Passo 2: puxe suas próprias posições de graça
Essa metade é oficial, gratuita e entrega divisão por dispositivo e dados de clique que nenhuma API de SERP tem.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
Dois detalhes nessa requisição fazem quase todo o trabalho.
dataState: "final" exclui dados recentes que o Google ainda pode revisar. Sem ele, os dois ou três dias mais novos oscilam entre execuções e seu diff mostra movimentos que nunca aconteceram.
dimensions: ["query", "device"] é o que torna a saída útil depois. Adicionar dispositivo agora não custa nada. Repuxar três meses de histórico depois custa uma execução inteira e não entrega nada pelos dias que você já pulou.
Saída esperada: uma linha por consulta e dispositivo, com cliques, impressões, CTR e posição média.
Verificação de qualidade: a contagem de linhas deve ficar abaixo de 25.000. Se bater exatamente 25.000, você foi truncado e precisa de uma segunda chamada com startRow: 25000.
Se falhar: um 403 normalmente significa que o e-mail da conta de serviço nunca foi adicionado como usuário na propriedade. Adicione no Search Console, espere alguns minutos e tente de novo.
Passo 3: puxe as SERPs que você não enxerga nos seus próprios dados
A segunda metade cobre tudo que o Search Console estruturalmente não consegue. Esta é uma chamada mínima que funciona.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
Defina `depth` como 100, não 200. Testamos isso em setembro de 2026 pedindo 200 resultados em seis consultas. O Google devolveu de 83 a 128 resultados orgânicos e parou, com a posição mais profunda de todo o teste em 142. O teste completo está aqui. Pedir 200 não entrega 200 resultados, e dependendo do fornecedor você ainda pode ser cobrado pela profundidade solicitada. Peça 100 e você quase sempre receberá tudo que existe.
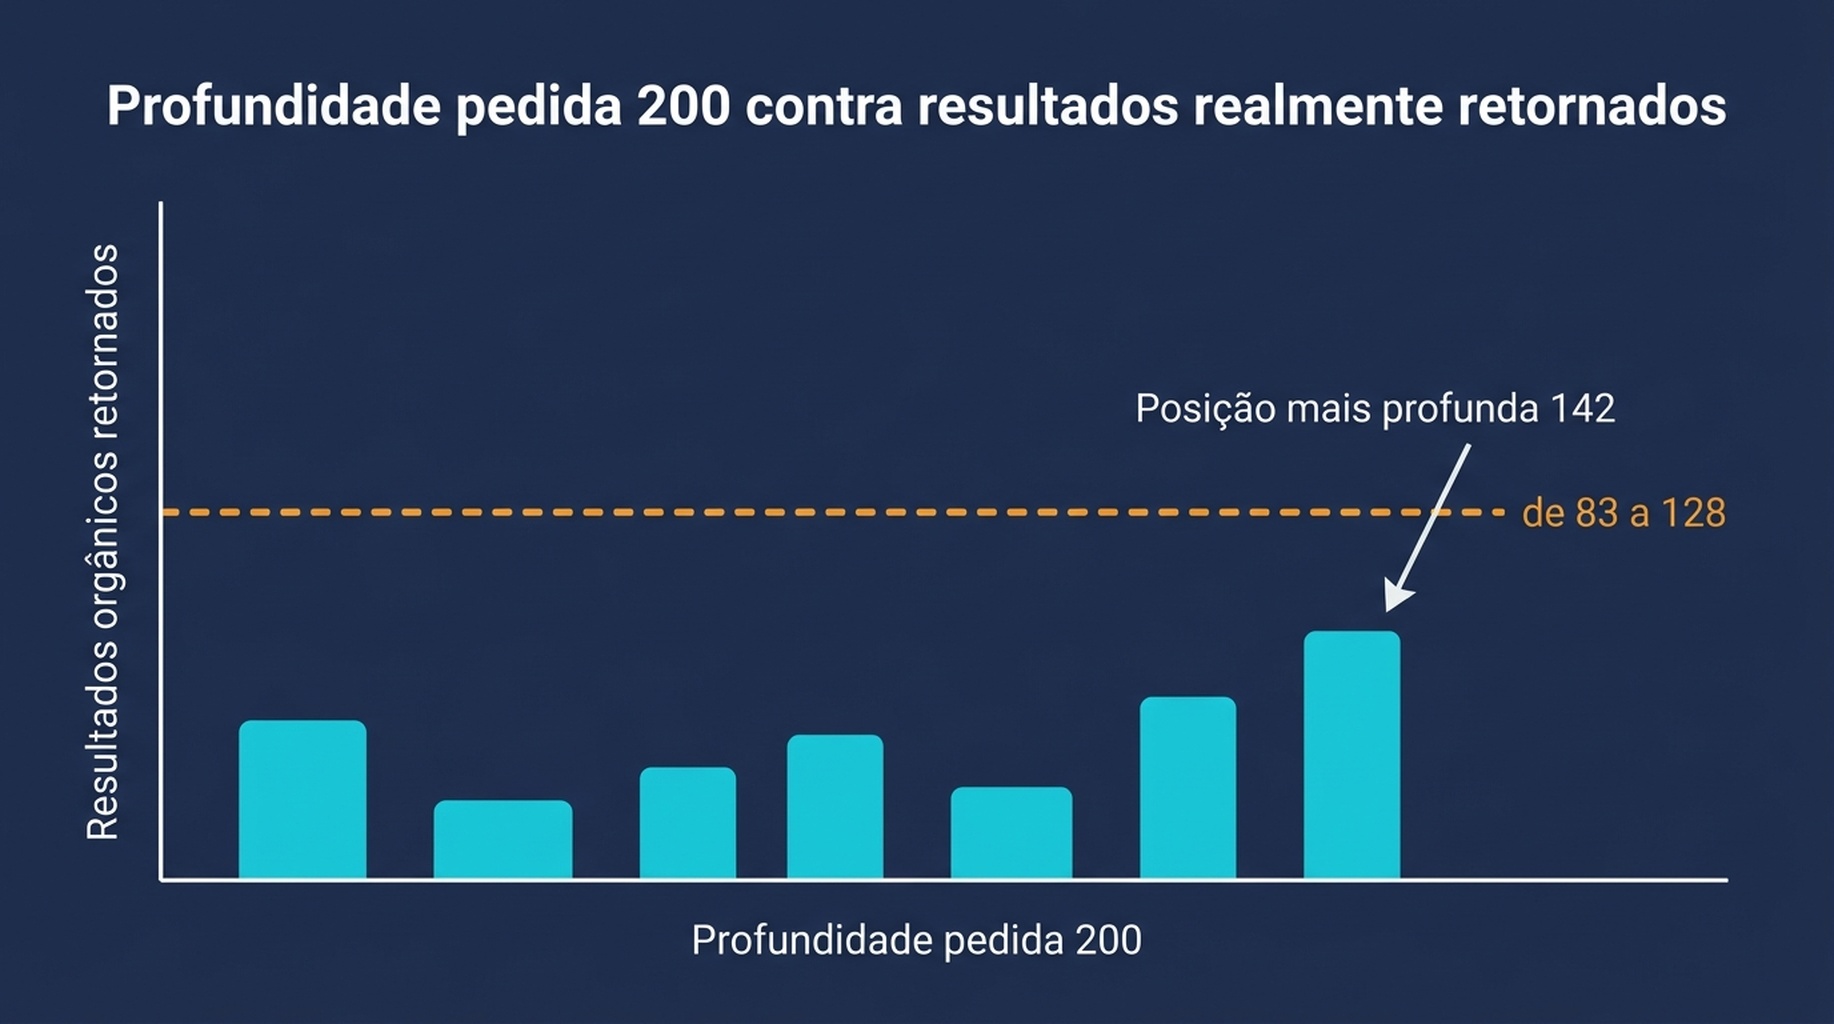
Pedir 200 resultados e receber de 83 a 128. Profundidade acima de aproximadamente 140 não compra nada na maioria das consultas comerciais.
Saída esperada: um payload JSON contendo itens orgânicos com posição, URL, título e domínio.
Verificação de qualidade: confirme que o payload contém um tipo de item ai_overview quando houver um. Se você extrair apenas itens organic, vai perder por que uma página perdeu cliques mantendo a posição.
Se falhar: um 401 é erro de base64 ou de credencial. Um código no estilo 40200 significa que o saldo da conta está vazio, que é a falha mais comum no primeiro mês.
Passo 4: armazene o payload bruto, não o resumo
Essa é a decisão que as pessoas se arrependem de pular.
Armazenar uma tabela de posições funciona até você precisar fazer uma pergunta que não previu: a SERP ficou mais longa, o vídeo tomou conta, um concorrente entrou, um AI Overview apareceu acima da dobra. Um resumo não responde a isso. O payload bruto responde, a custo extra zero.
A versão prática: escreva um arquivo por execução, nomeado pela data e hora, contendo a saída mesclada. Guarde os últimos 90 dias. É pequeno o bastante para viver em um repositório e completo o bastante para responder de novo a perguntas antigas.
Passo 5: escreva a regra de comparação antes de agendar qualquer coisa
Um tracker que compara a última execução com esta produz alarme falso na maioria dos dias. Nossos próprios números mostram por quê: em 124 consultas com pelo menos 30 impressões, a consulta média se moveu 4,57 posições de um dia para o outro. Uma queda de quatro posições é uma terça-feira.
Então a regra precisa de um limiar e de uma direção.
Relate uma consulta apenas quando:
  - a mudança absoluta de posição contra a execução anterior for 5 ou mais, E
  - a consulta tiver pelo menos 20 impressões na janela de comparação, E
  - a mudança não for explicada por uma mudança na mistura de dispositivos

Agrupe a saída por classe de consulta: money, comparison, brand, informational.
Não sugira correções.
A cláusula de dispositivo não é enfeite. A mesma consulta pode ficar 11 posições distante entre celular e desktop, e se a mistura de dispositivos mudar entre execuções, o número combinado também muda. Nós medimos isso separadamente e é grande o suficiente para forjar uma tendência.
Quanto custa
Os preços dos fornecedores mudam, então construa o modelo em vez de correr atrás de uma cotação.
- Uma palavra-chave checada uma vez por dia por 30 dias são 30 requisições por mês.
- Um conjunto de 200 palavras-chave checado diariamente são 6.000 requisições por mês.
- O mesmo conjunto checado semanalmente são cerca de 860 requisições por mês.
- A metade do Search Console é gratuita e é uma requisição por visualização, não importa quantas palavras-chave haja dentro dela.
Essa multiplicação é a decisão inteira. Quase toda pergunta do tipo "devo comprar uma ferramenta" se reduz a ela: calcule requisições por mês, multiplique pelo seu preço por requisição e compare com a licença por assento. O acompanhamento diário de um conjunto grande costuma sair mais barato como assinatura. O acompanhamento semanal de um conjunto pequeno costuma sair mais barato como API. Acompanhe uma lista congelada e o lado da API continua pequeno.
Quando comprar em vez de construir
Construa se você quer posições no seu próprio pipeline, se já tem uma credencial de API de SERP ou se precisa da página de resultados bruta por razões além da posição.
Compre se você precisa de posições históricas anteriores a hoje, se precisa de dez locais e cinco dispositivos para as mesmas palavras-chave, ou se ninguém no time vai manter um cron. As listas de fornecedores valem a leitura exatamente por isso, e existe um custo real em possuir infraestrutura que para de rodar quando quem a construiu muda de time.
Se a saída de que você realmente precisa é um relatório semanal escrito e não um arquivo JSON, o fluxo de relatórios no Codex parte das mesmas duas fontes e termina em um documento. Para alertas em cima do arquivo, o guia de design de monitoramento cobre os limiares.
Visão da Auspia: a pergunta sobre API de rank tracking é, na verdade, uma pergunta sobre propriedade de dados. O Search Console entrega dados oficiais sobre a sua propriedade de graça e sempre entregará. Todo o resto é uma captura que você paga. Construa primeiro a metade gratuita e adicione a metade paga apenas onde ela responde a uma pergunta que você realmente tem.
Perguntas frequentes
O Google oferece uma API de rank tracking? Não uma pública. A API do Search Console devolve sua posição média para consultas em que você já aparece, o que é próximo, mas não a mesma coisa. Ela não consegue checar uma palavra-chave para a qual você não ranqueia, nem checar um concorrente.
Até que profundidade uma API de SERP vai? Os fornecedores aceitam valores de profundidade bem acima de 200, mas o Google para de servir resultados em algum ponto entre 100 e 140 na maioria das consultas comerciais. Pedir mais não produz mais resultados.
Devo usar checagens diárias ou semanais? Semanais para um conjunto normal de palavras-chave. Diárias apenas para uma lista curta de consultas de dinheiro. Checagens diárias em um conjunto grande multiplicam o custo por sete e medem principalmente ruído, já que o movimento diário médio nos nossos dados foi de 4,57 posições.
Por que meu número da API difere do meu rank tracker? Dispositivos diferentes, locais diferentes, momentos diferentes e, muitas vezes, fontes de dados diferentes. O número é uma amostra. Fixe o local e o dispositivo na sua requisição e repuxe antes de concluir que algo mudou.
Um agente pode rodar isso para mim? Pode, e é um bom encaixe porque a tarefa tem sempre o mesmo formato a cada execução. Para o quadro mais amplo do que um agente pode assumir em trabalho de ranking, veja o guia de campo do agente de SEO. Mantenha a regra de comparação em um arquivo de instruções escrito e deixe o agente produzir o diff; mantenha a decisão de comprar ou construir com uma pessoa.
Autor: Rowan Blake, analista de automação de conteúdo para mais de 100 pipelines de publicação na Auspia. Rowan escreve sobre pipelines de dados automatizados, relatórios agendados e o custo de manutenção de sistemas que rodam sem você.